编程智能体接管已登录 Chrome:六种方案的原理、配置与取舍
教程2026年10月26日
Claude Code、Codex、Gemini CLI、Cursor 如何使用你日常已登录的 Chrome?对比 Claude in Chrome、Playwright MCP、Chrome DevTools MCP、Browser Harness 等六种方案的配置与安全边界。
Claude Code、Codex、Gemini CLI、Cursor 如何使用你日常已登录的 Chrome?对比 Claude in Chrome、Playwright MCP、Chrome DevTools MCP、Browser Harness 等六种方案的配置与安全边界。
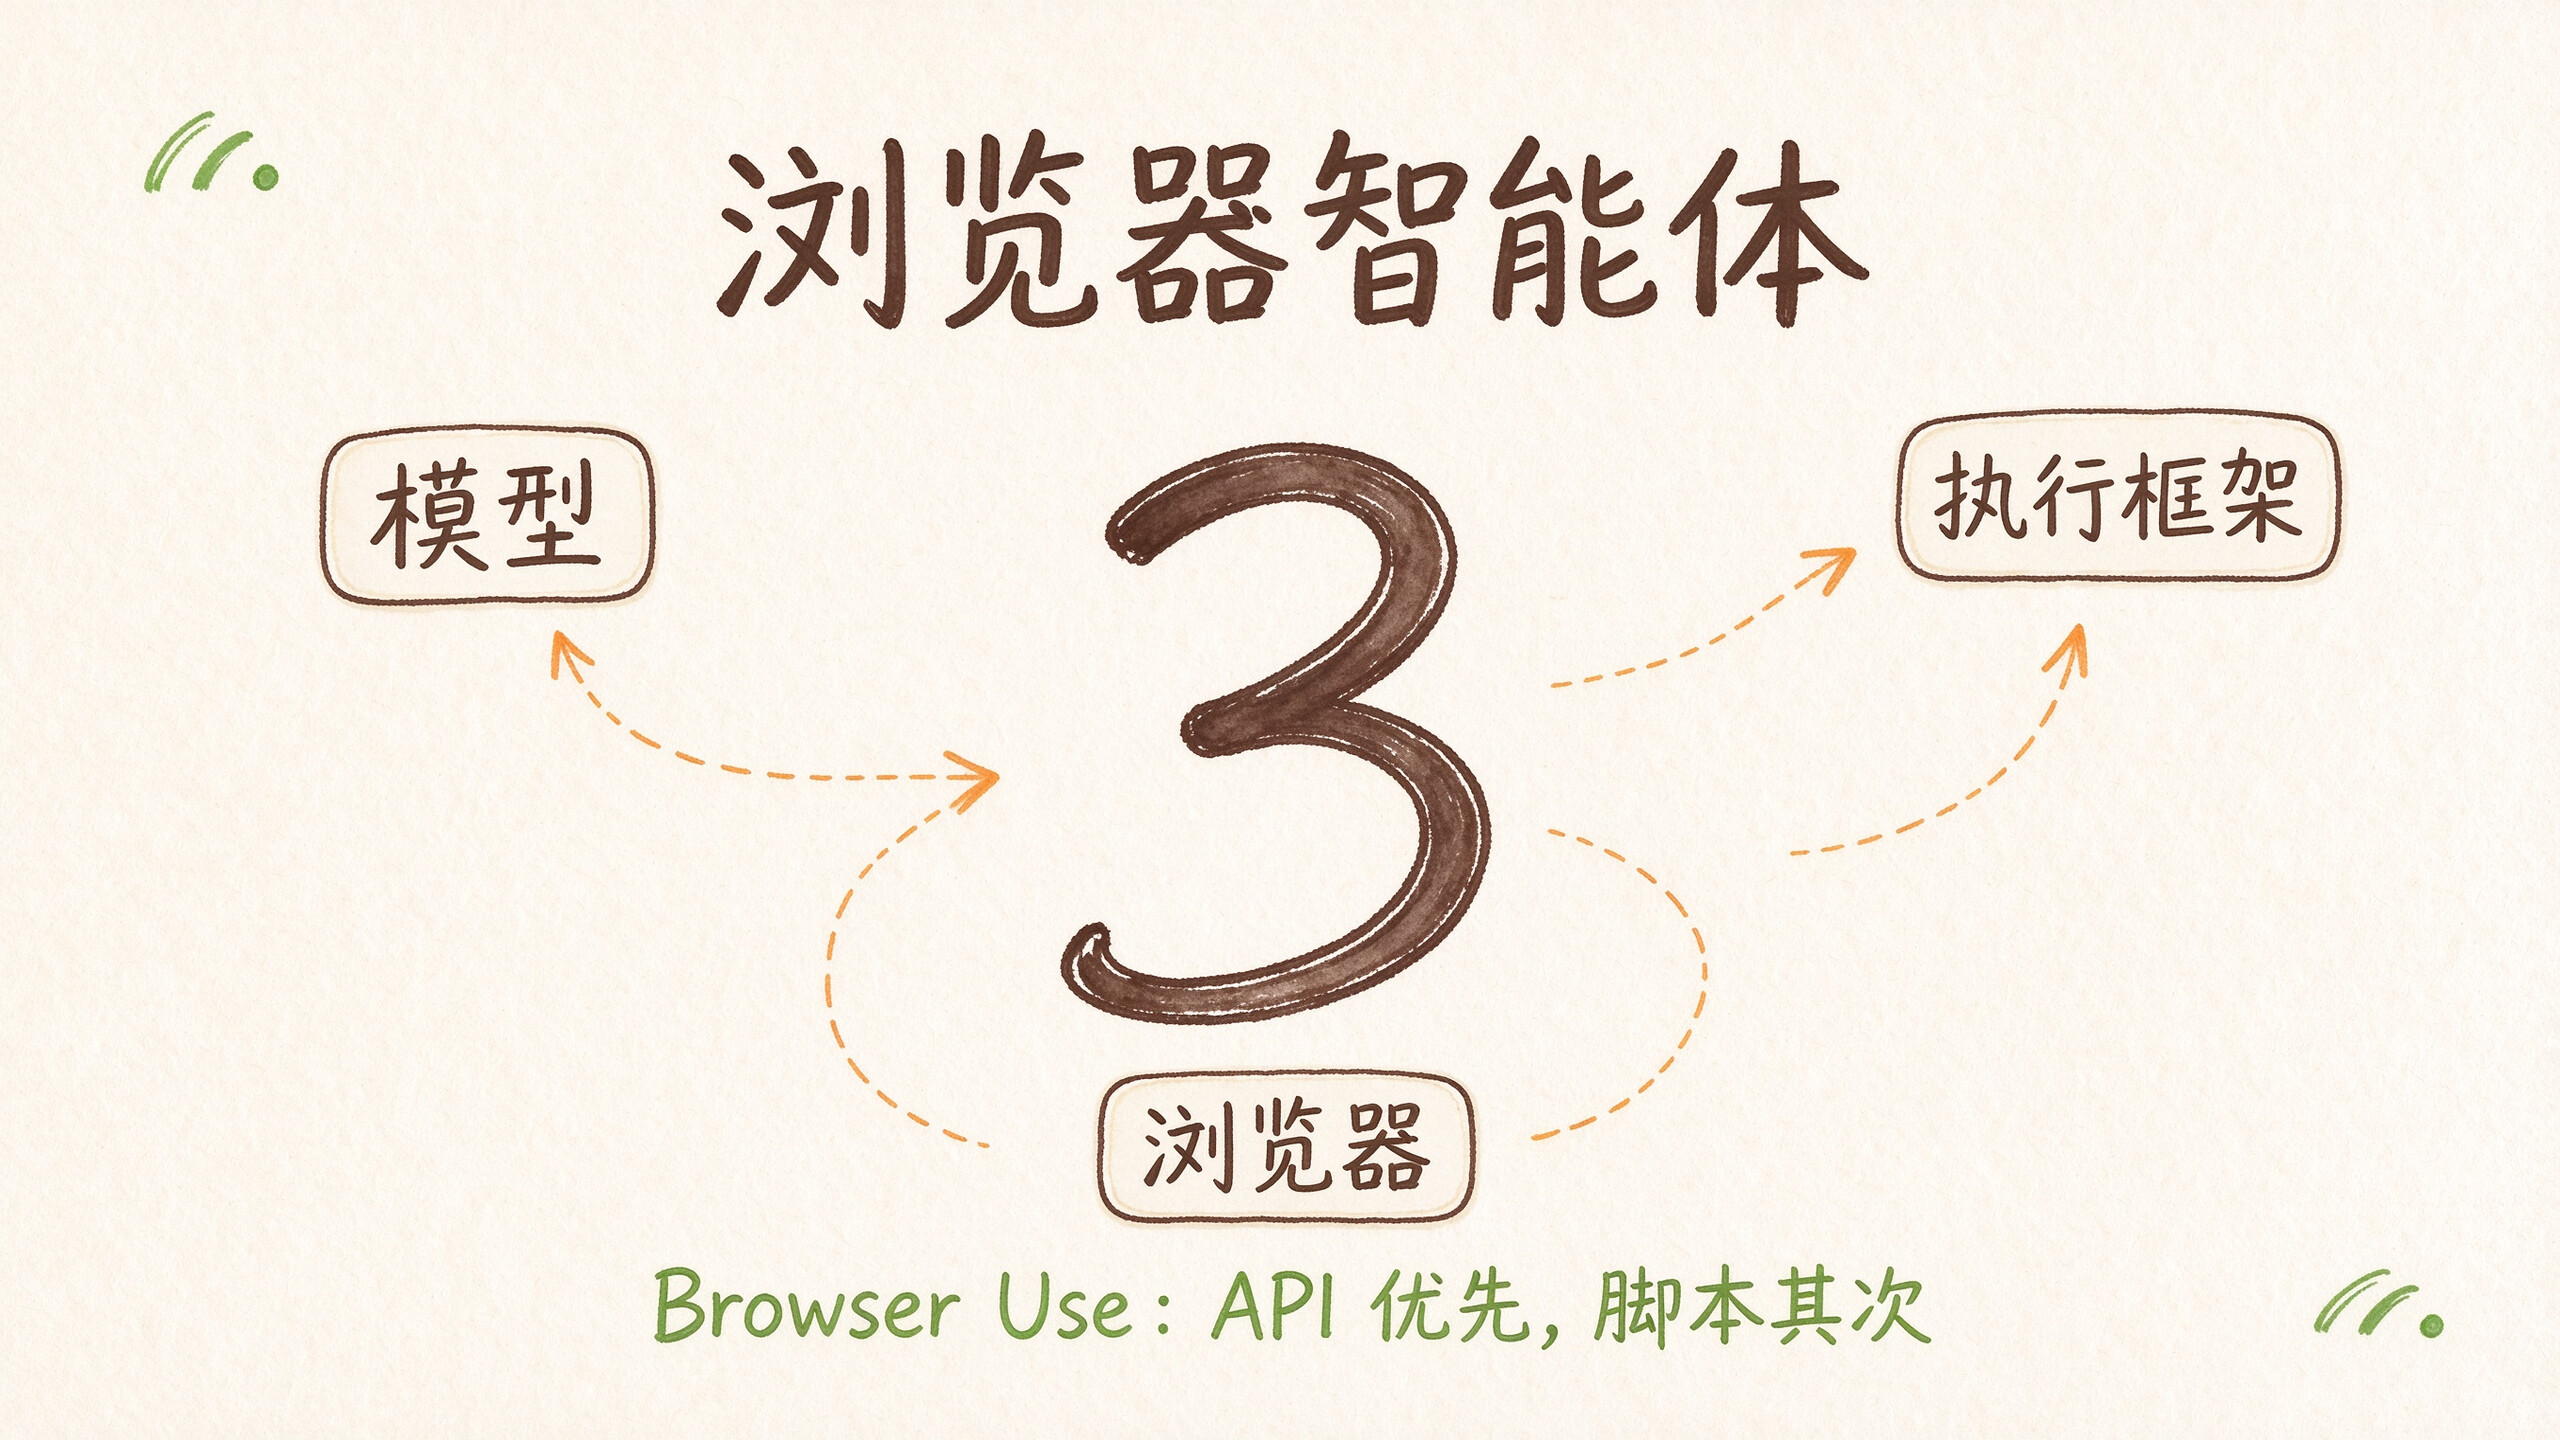
Browser Use 发文拆解浏览器智能体:模型决策、执行框架跑循环、浏览器持有会话;并给出「API 优先、脚本其次、智能体最后」的选型顺序与五类失效模式。
Anthropic 用 Claude Managed Agents 搭了一个每日简报智能体,并总结出按书签读书、读取失败要如实报告、发布前复核、预算封顶等六条规则。
YOLO 模式让编程智能体不再逐步征求同意。梳理 12 款主流智能体的开启方式、折中档位,以及它真正关掉的东西。
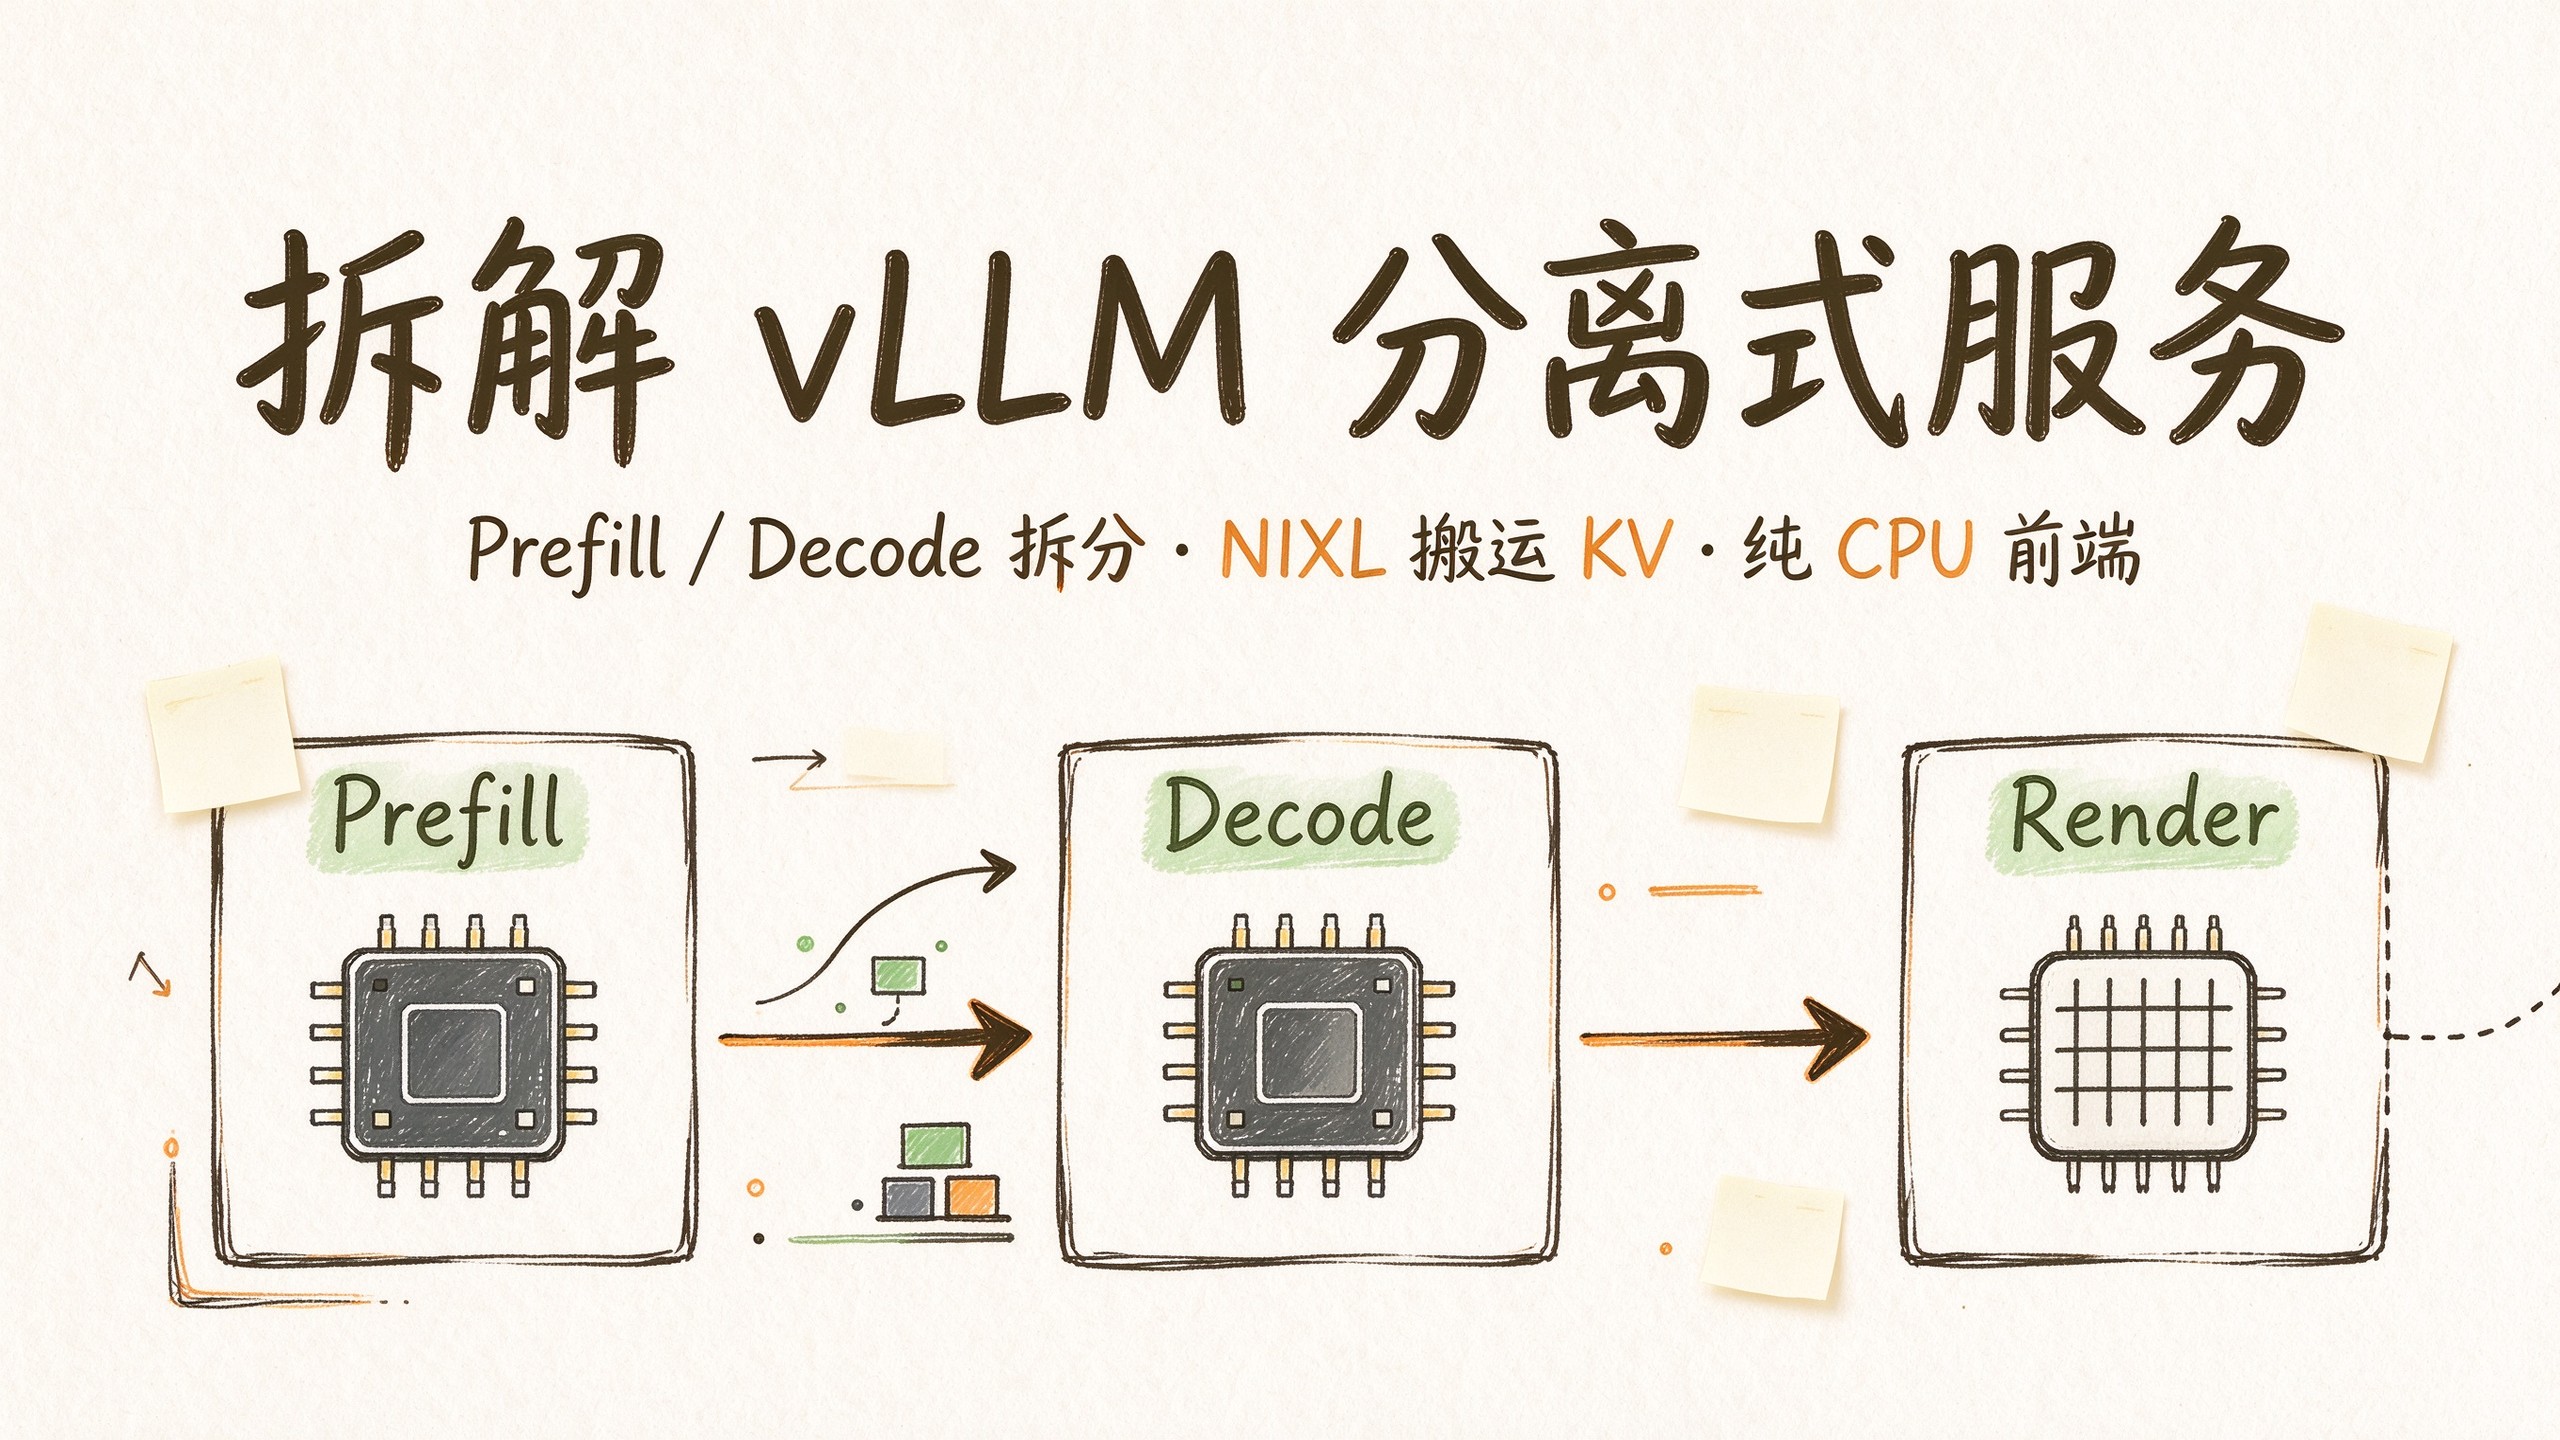
vLLM 官方指南详解分离式服务:如何把 prefill 与 decode 拆成独立实例、用 KV Connector 搬运缓存,并把分词与解析下沉到无 GPU 前端。
沙箱不是容器:从程序化降权、文件描述符即能力,到 Capsicum、seccomp 与 Landlock 的取舍,一篇讲清软件沙箱的底层机制。
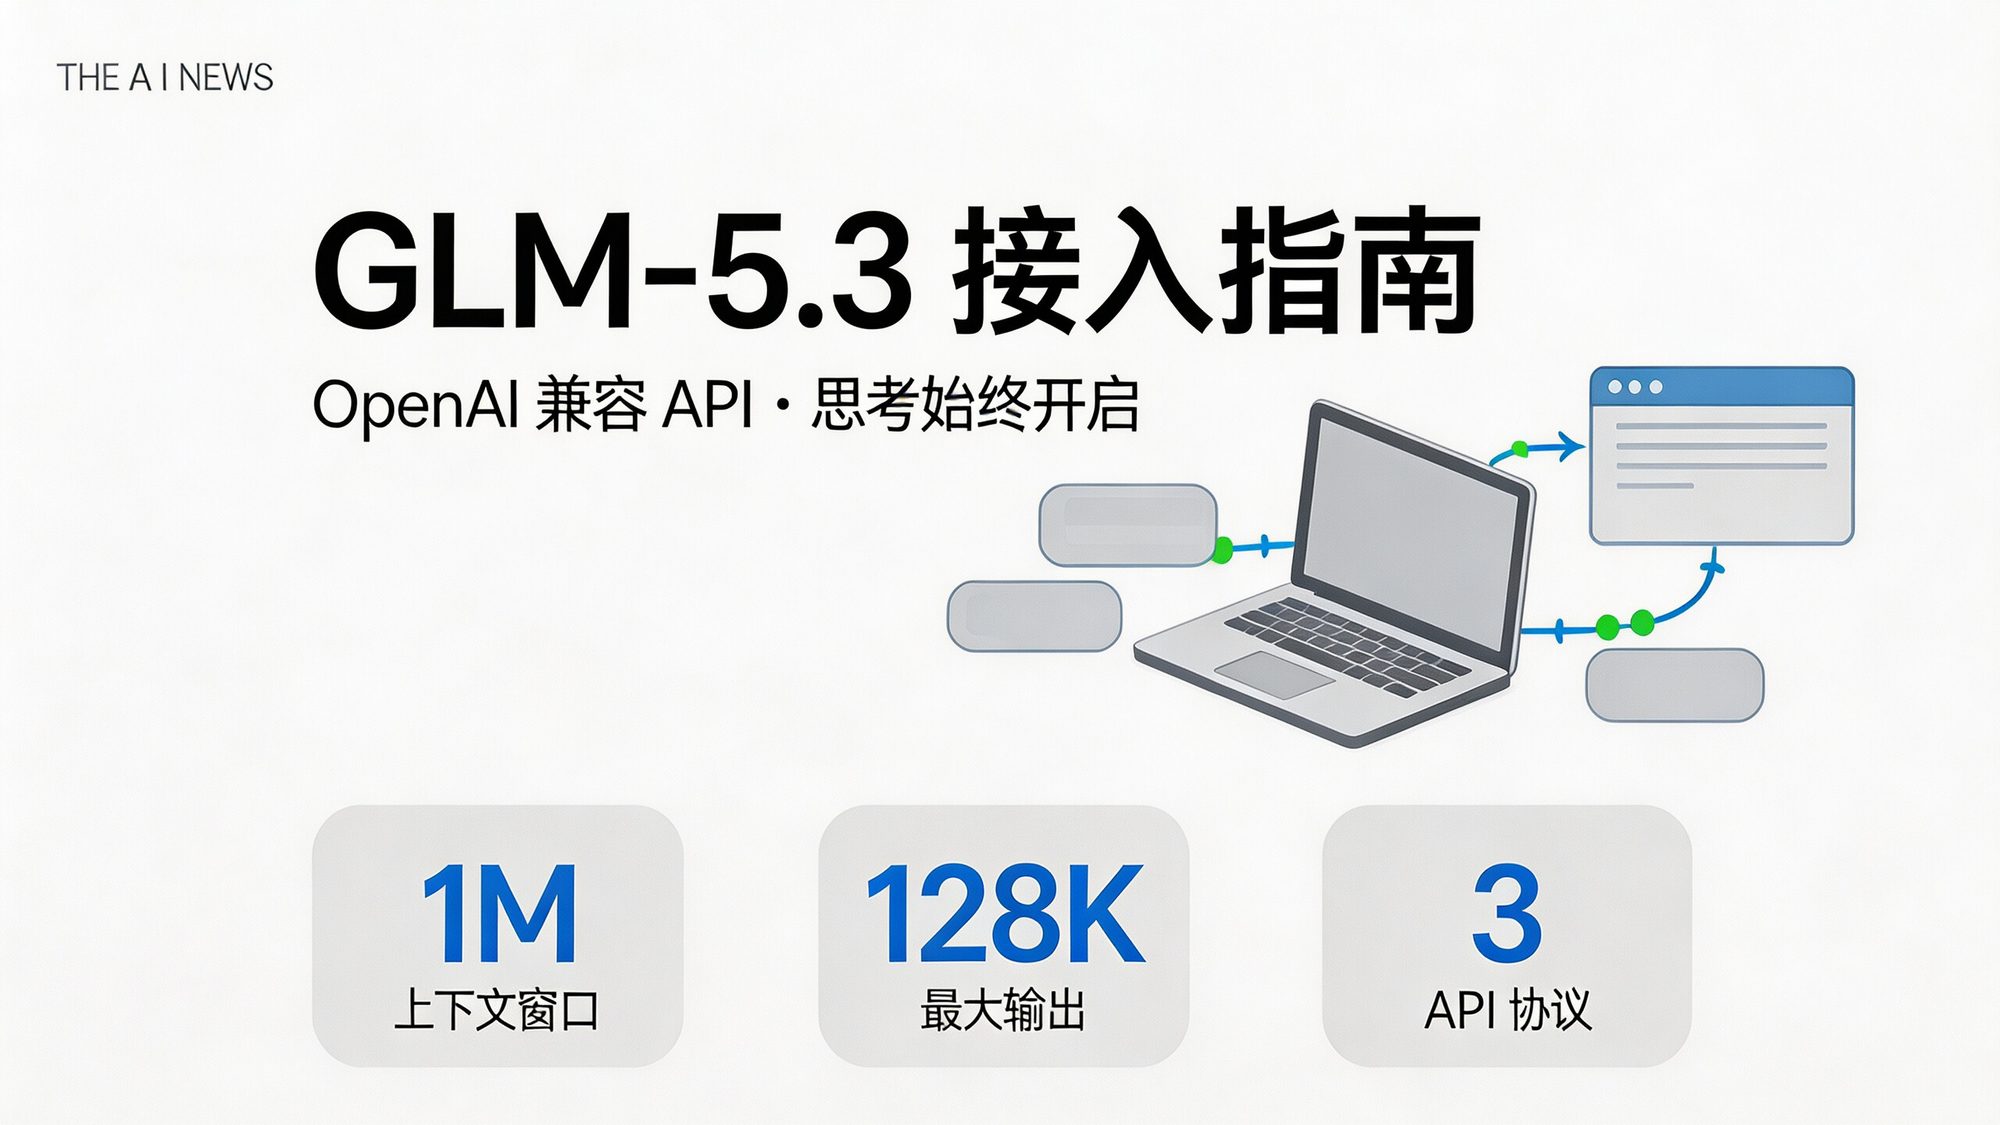
GLM-5.3 已全量开放:1M 上下文、128K 输出、思考模式始终开启。一文理清 API 协议、迁移要点与调用示例。
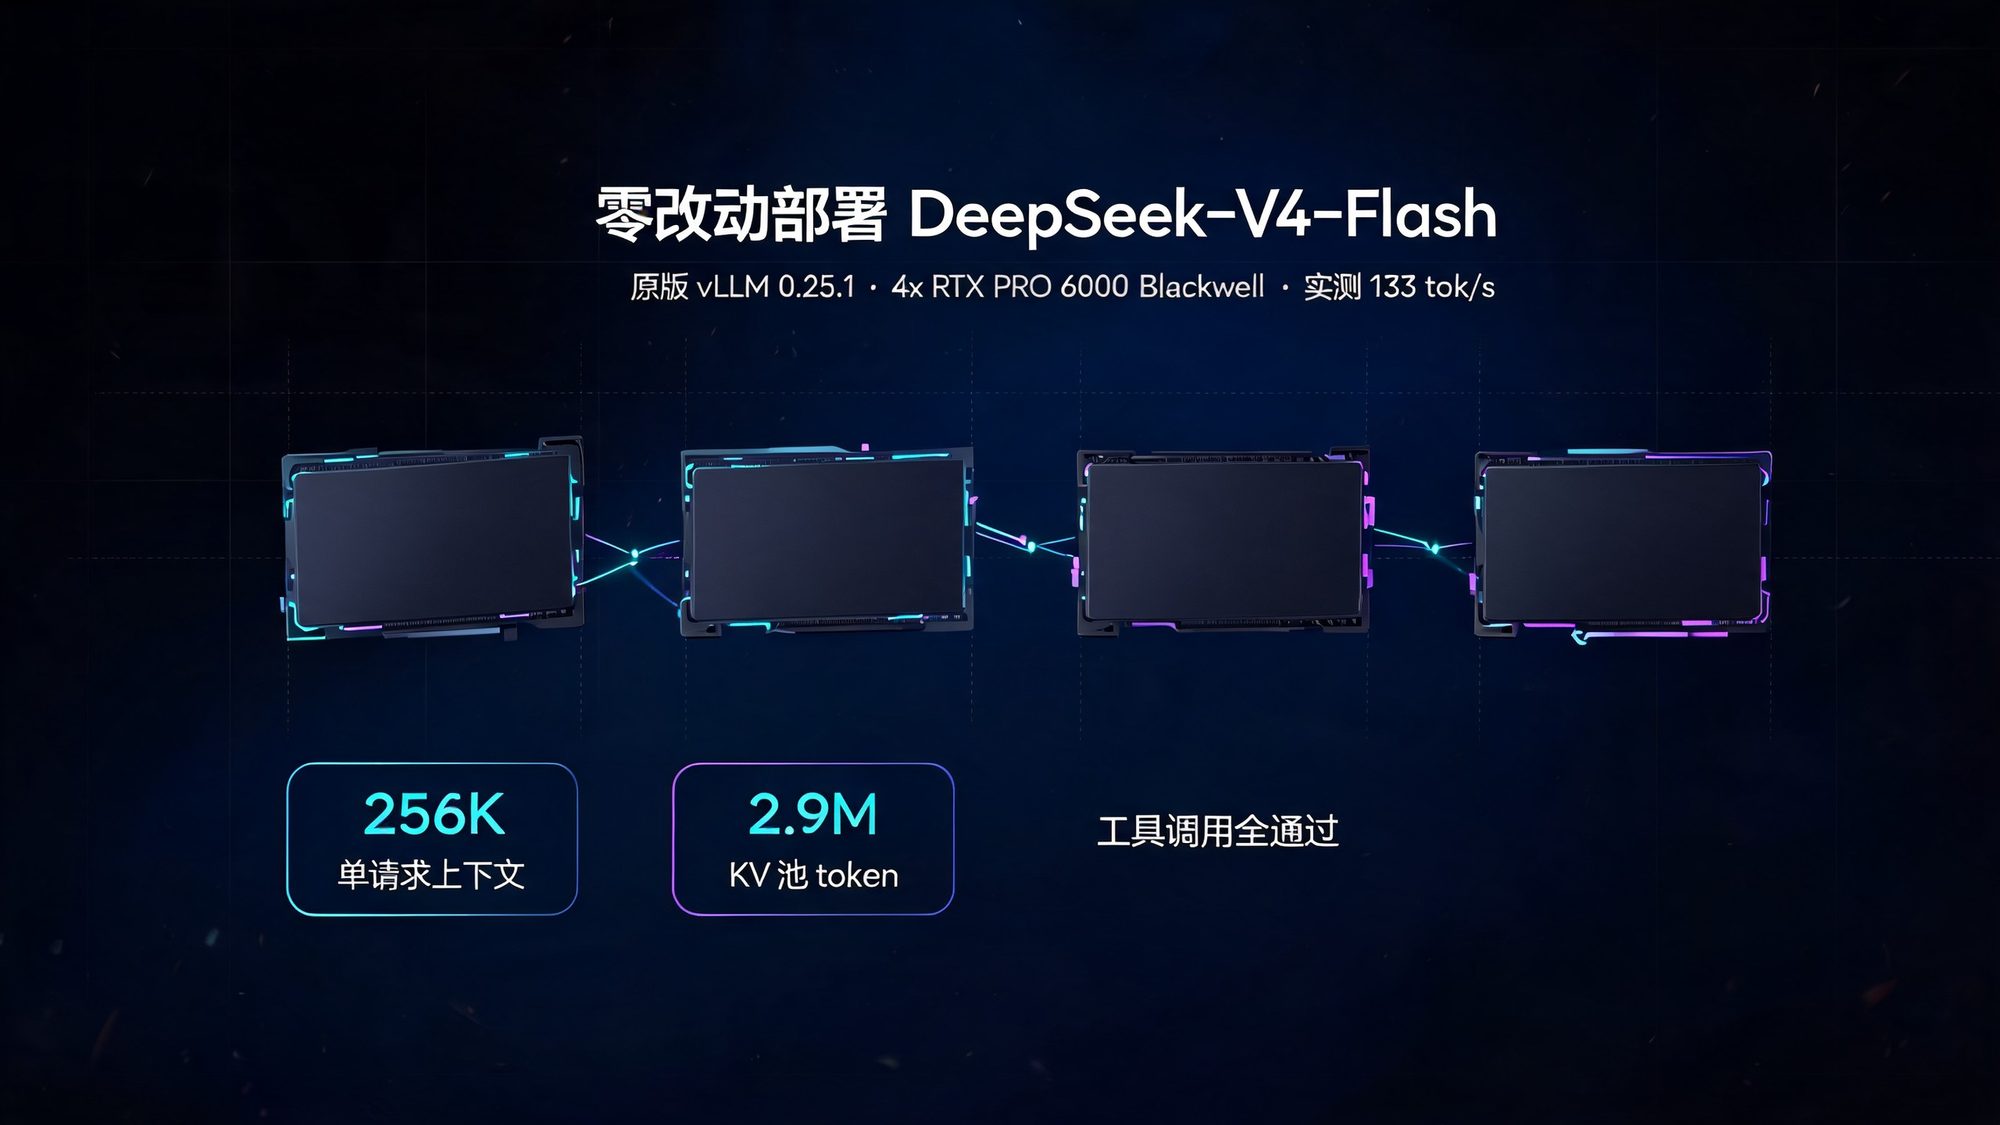
原版 vLLM 0.25.1 在 4× RTX PRO 6000 上部署 DeepSeek-V4-Flash:不 fork、不打补丁,256K 上下文、约 133 tok/s、完整工具调用;并如实记录两条官方上限。
用 200GbE 直连的双 DGX Spark 以 vLLM 部署 DeepSeek-V4-Flash-0731(TP=2、百万上下文),单流 60–70 tok/s,本文梳理关键注意事项与实测数据。
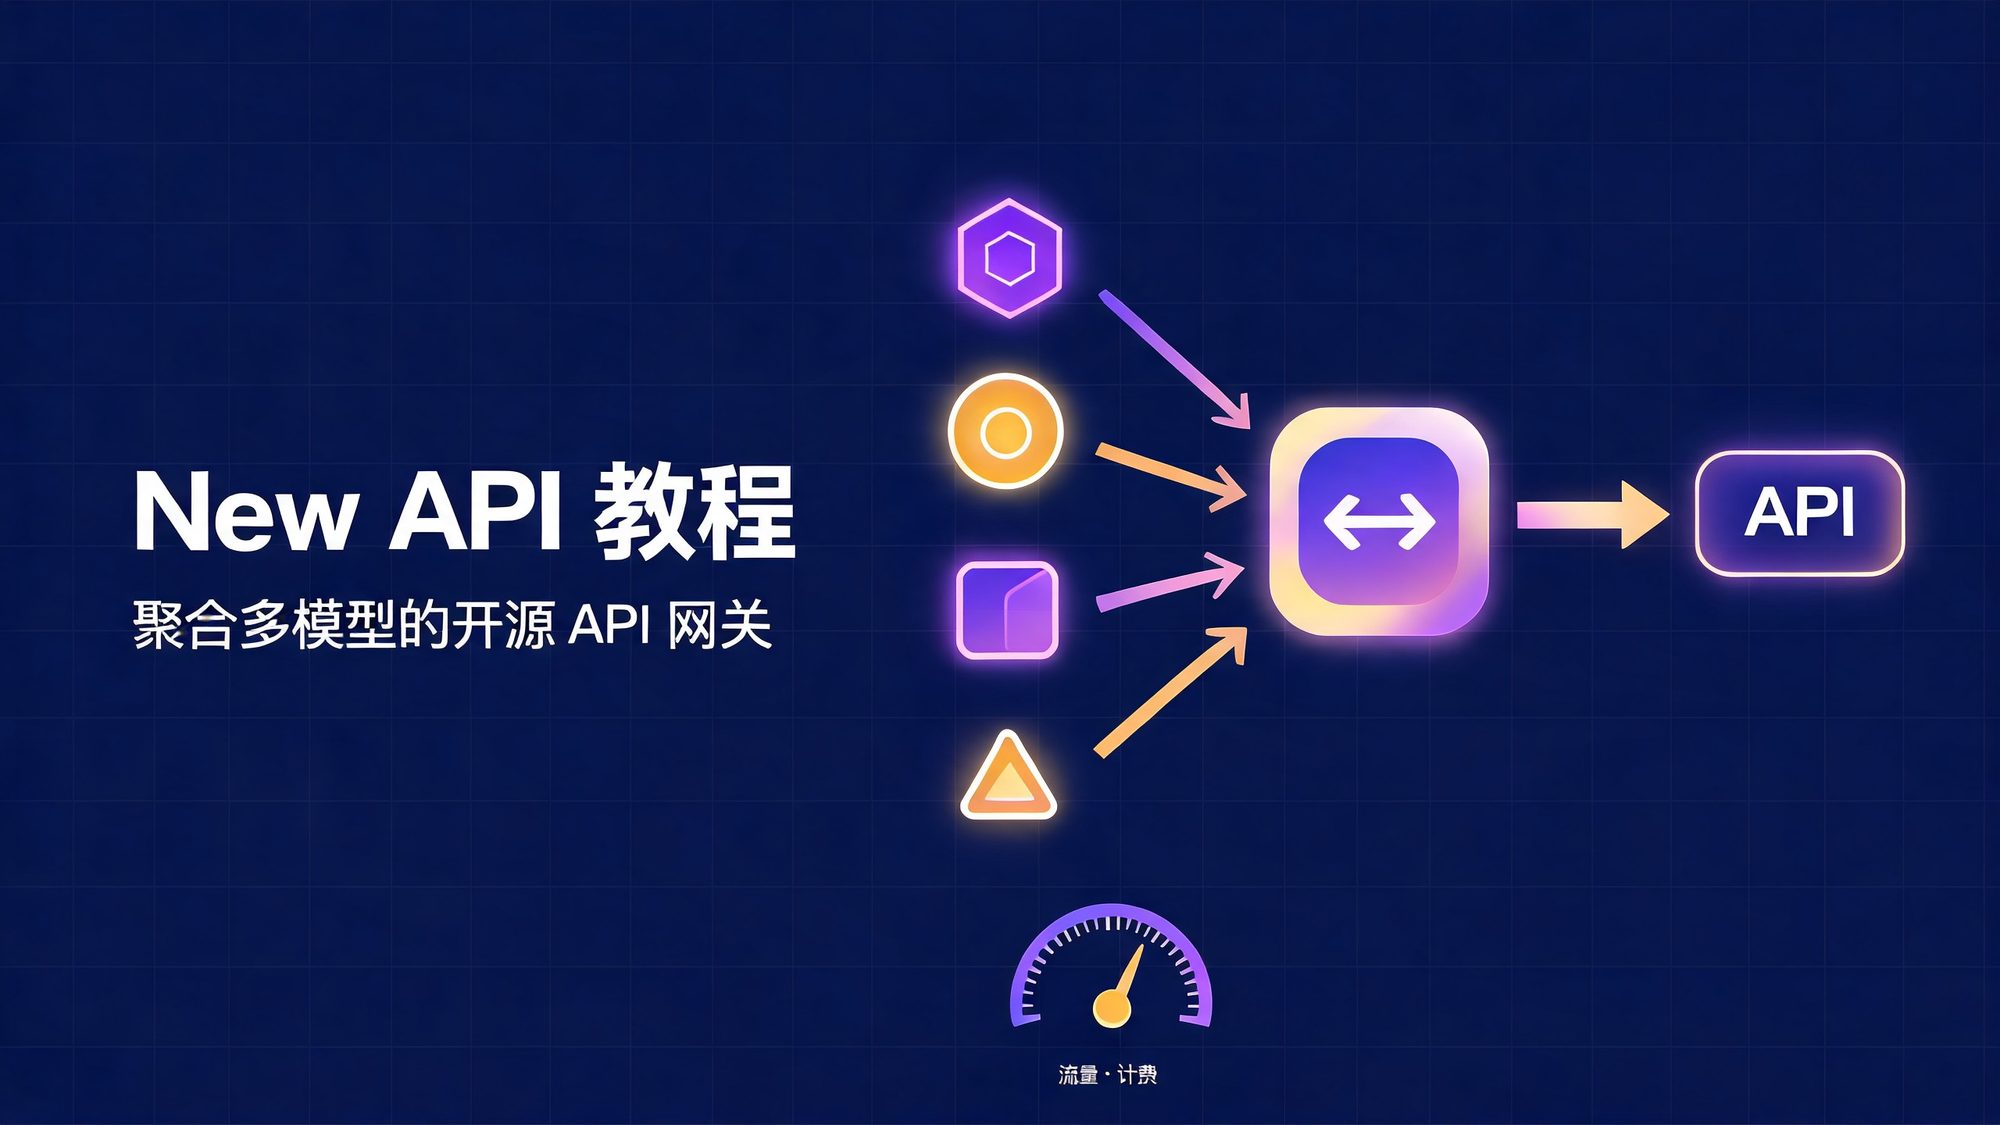
New API 是聚合多厂商大模型的开源 API 网关,支持 OpenAI、Claude、Gemini 格式互转与计费管理,本文介绍其特性与 Docker 部署配置。
开源生产栈在单块 MI300X 部署 DeepSeek-V4-Flash:FNUZ FP8 修复、DSpark-7 投机解码,单流 168.6 tok/s。
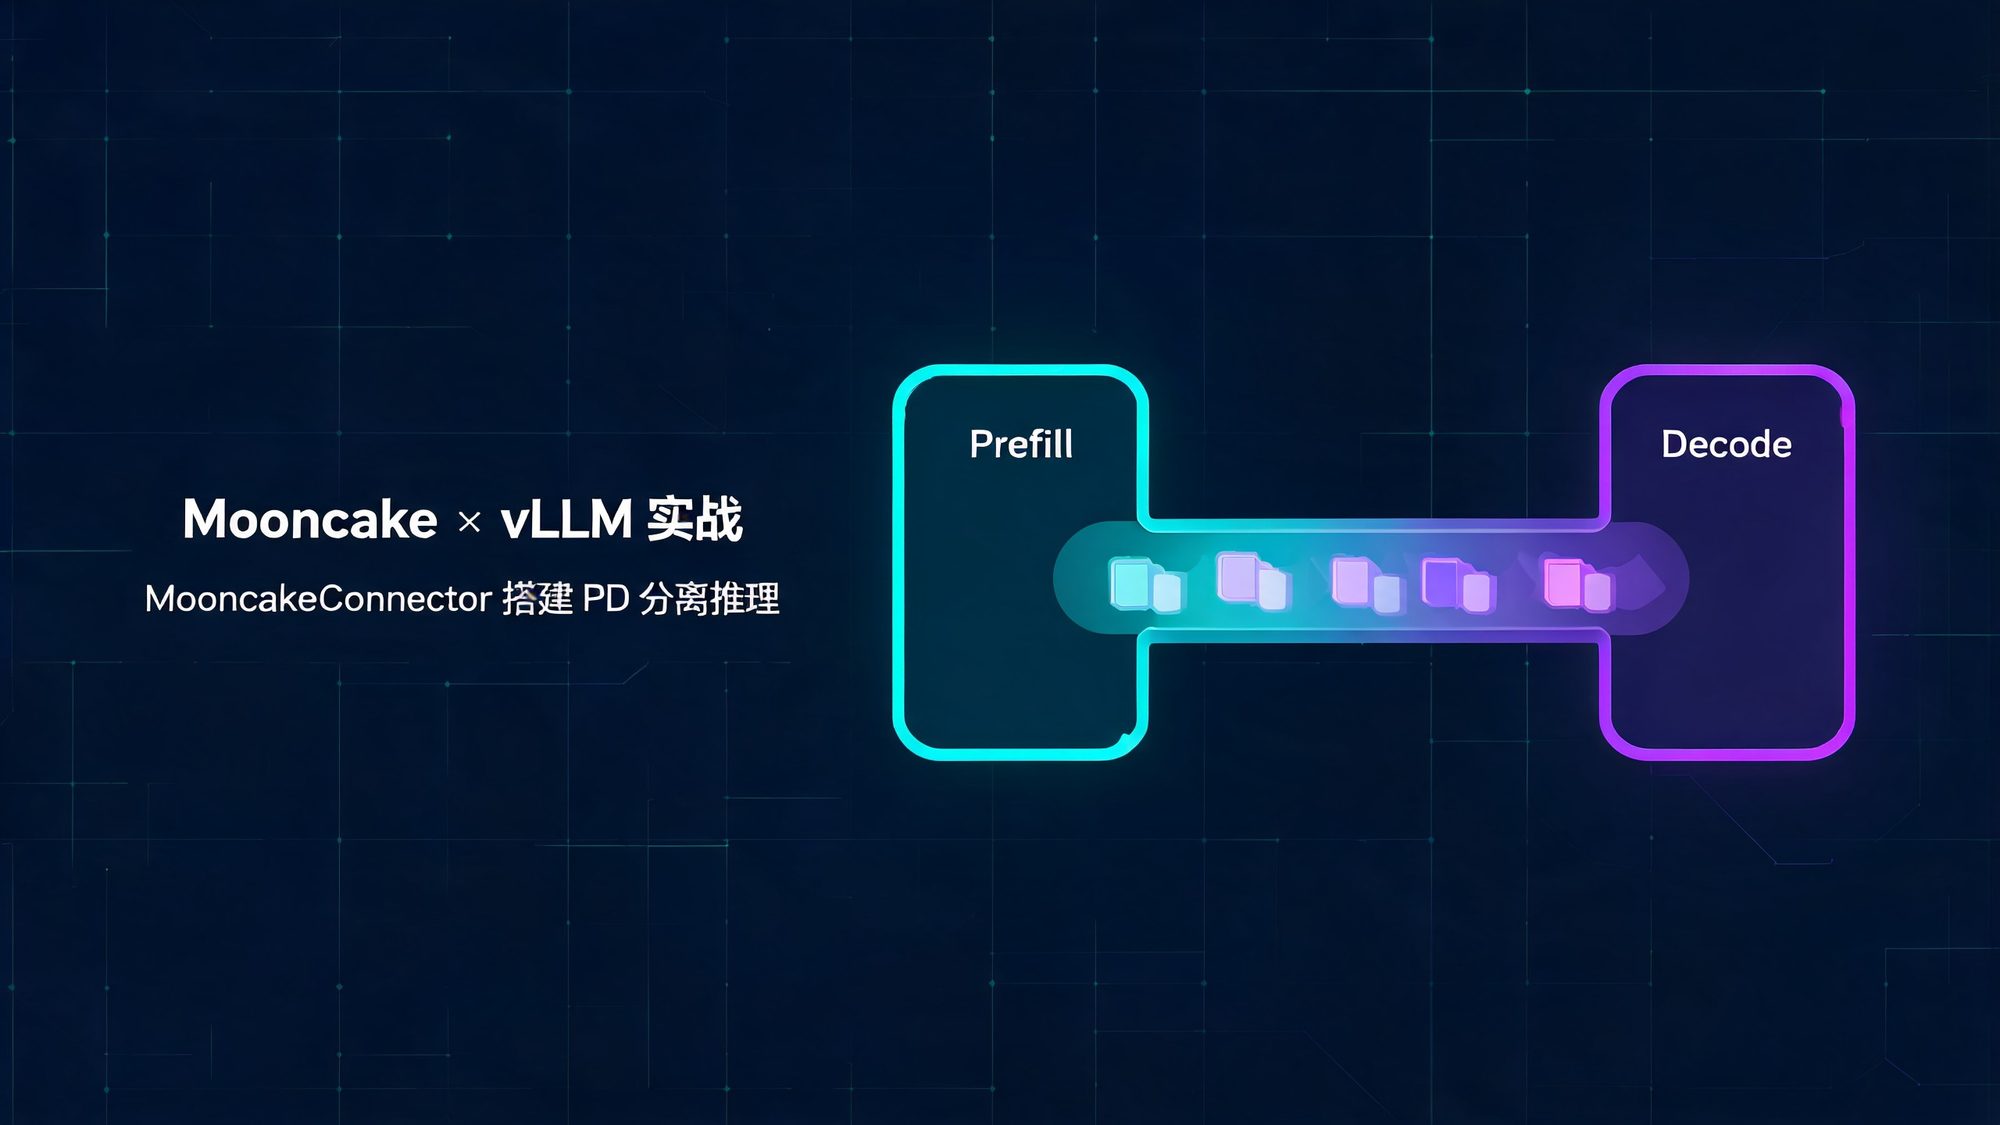
手把手部署 vLLM 与 Mooncake 的 PD 分离推理:MooncakeConnector 通过 RDMA 跨节点直传 KV 缓存,峰值带宽 142.25 GB/s,覆盖 V1 与 V0 两种后端。
手把手部署 vLLM + MooncakeStore 分布式 KV 缓存池:CPU/SSD 卸载、跨实例前缀缓存共享、XpYd 灵活编排,覆盖 V1 与 V0 两种后端。
CUDA Graph 强大但限制不少:捕获期间不能同步、图拓扑与参数静态冻结、流捕获必须自包含、内存生命周期等九类约束详解。
一份面向深度学习开发者的 CUDA Graph 中文介绍:启动开销从哪来、图如何定义与执行,以及 PyTorch 里怎么用。
DeepSeek 官方提供一键脚本和手动配置两种方式接入 Codex,CLI、ChatGPT 桌面端、VS Code 插件共用一份配置。
Simon Willison 的轻量评测套件 smevals:目录即评测、YAML 配任务、脚本当裁判,还能让编码智能体自己搭评测。