
2026 年 RAG 技术综述:从混合检索到 Agentic RAG 的演进与开源生态全景
研究2026年11月14日
梳理 RAG 从朴素管线到智能体化的四代范式演进,覆盖混合检索、上下文工程、图结构、多模态等关键技术及代表数据,并对比主流开源系统的选型要点。
梳理 RAG 从朴素管线到智能体化的四代范式演进,覆盖混合检索、上下文工程、图结构、多模态等关键技术及代表数据,并对比主流开源系统的选型要点。

赫尔辛基大学团队用 Claude 解读哥德尔 1,009 页速记笔记,几天内完成人工需要数十年的工作,经 Coq 验证的定理约 400 条。

Chips and Cheese 实测 Zen 6 与 Zen 6c:EPYC 9686F 单线程领先 Zen 5 约 21%,两种核心首次在乱序引擎容量上分道。
Berkeley RDI 与 AWS 的 Aqueduct 让智能体改写函数并在 Lean 中证明等价:Verina 156/189 题拿到验证加速,几何平均 1.85×。
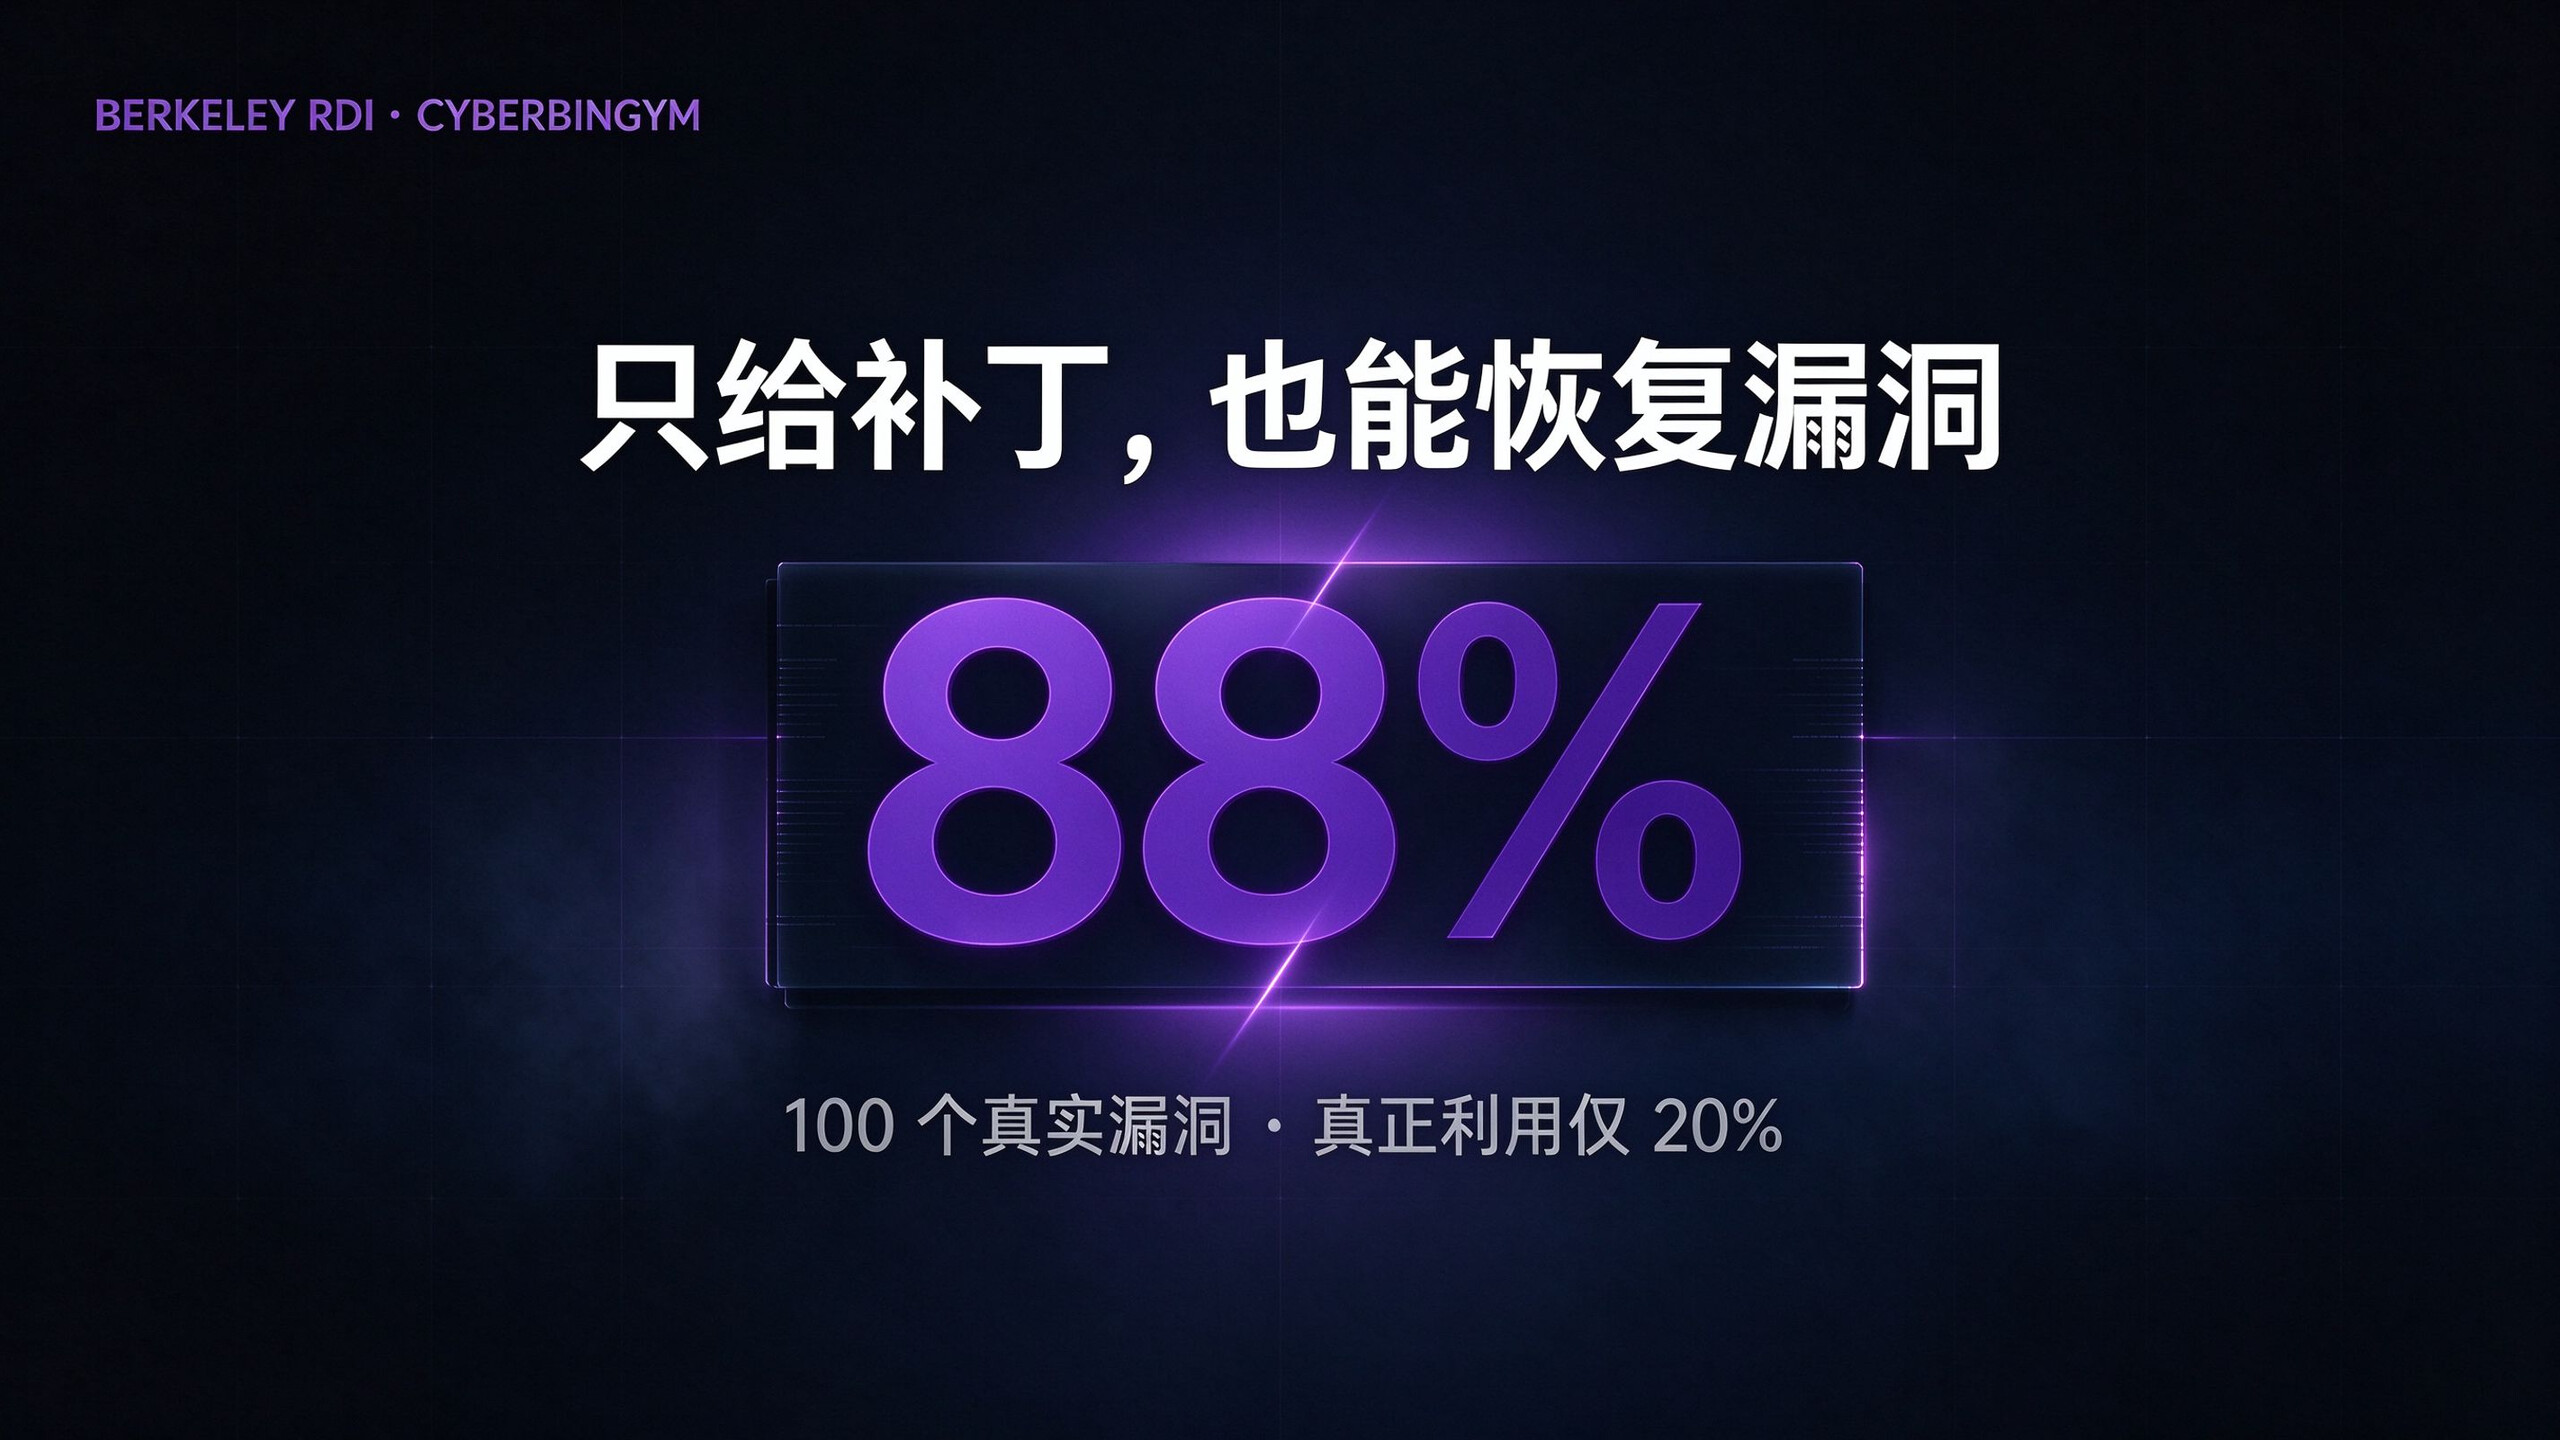
Berkeley RDI 等发布 CyberBinGym:100 个真实漏洞、无源码无初始输入,Codex 恢复 88%、利用 20%,暴露补丁到部署的空窗风险。
OpenRouter 在 Qwen3.8 27B 的 6 个端点上实测 fp16、fp8、fp4:240 道精确答案任务全部落在 98.3%–99.2%,精度标签未能预测准确率。
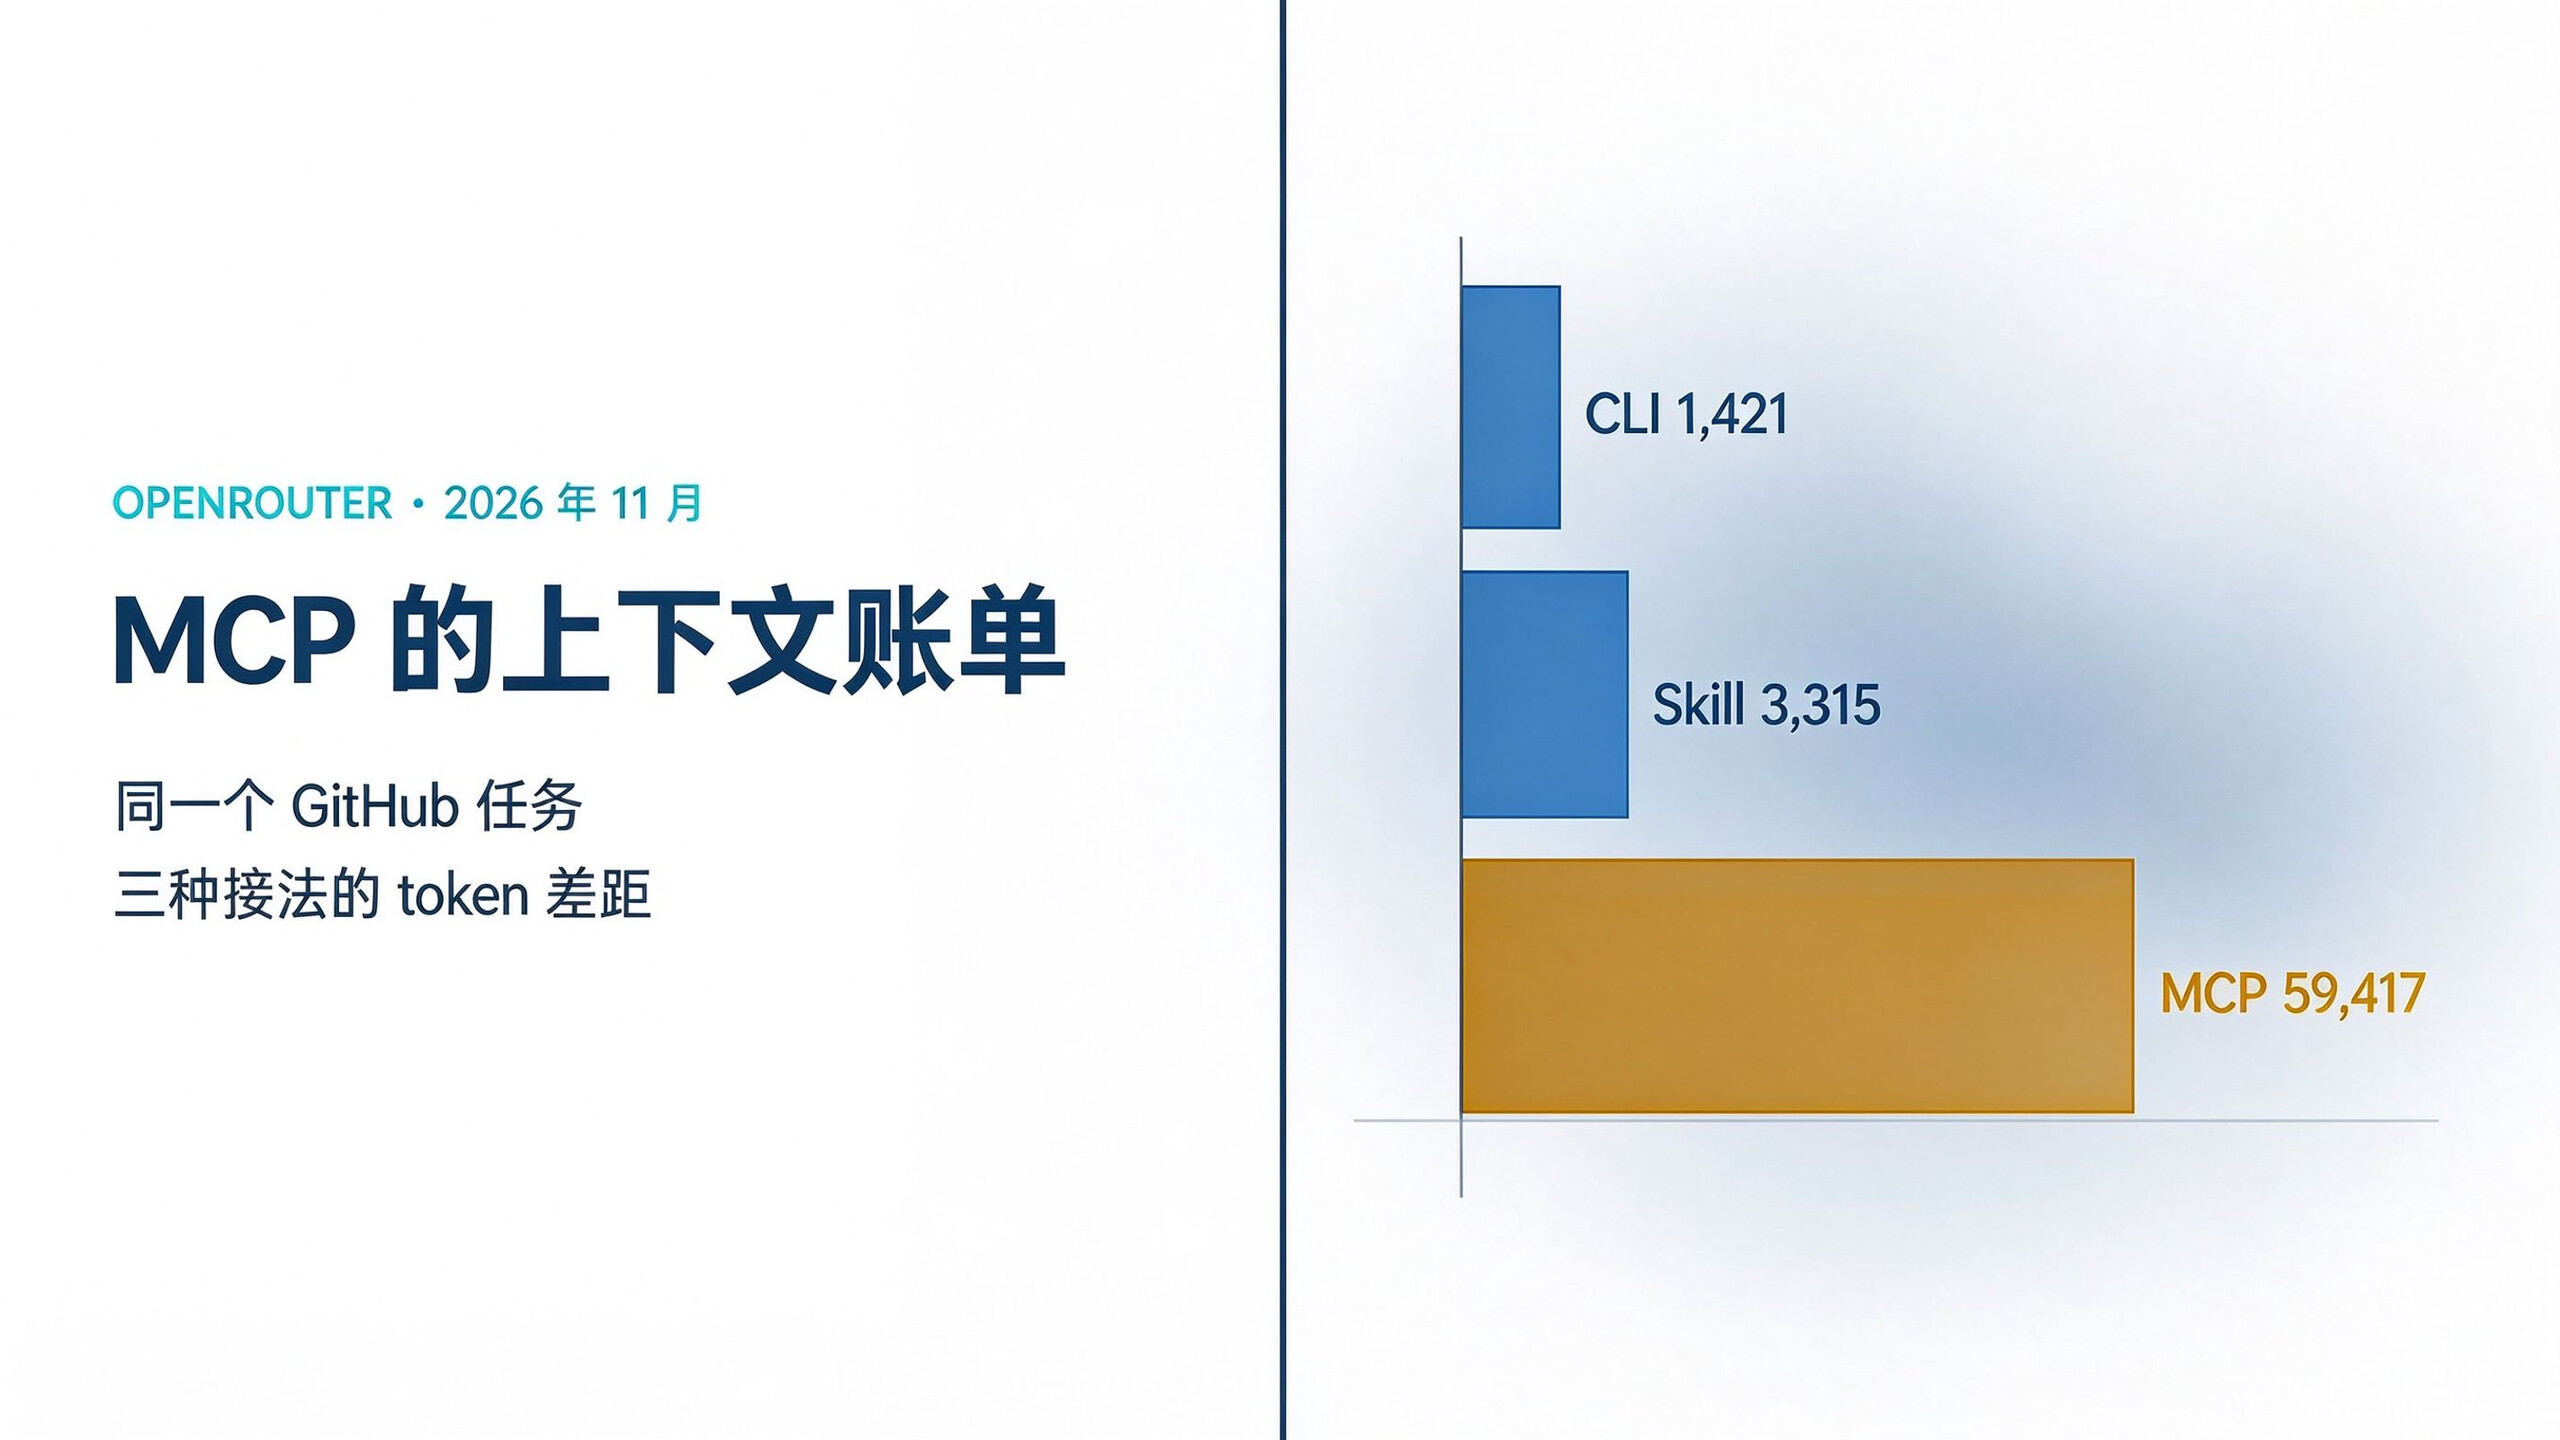
OpenRouter 在同一个 GitHub 任务上实测三种取工具方式:CLI 1,421 token、Skill 3,315、GitHub MCP 默认 59,417,成本相差 17 倍。
Berkeley RDI 等发布 Vero:43 个多模块 Lean 4 仓库、743 个 API、2,705 条规格;最强组合全解 27/43,单条规格通过率 87.3%。
Anthropic 把智能体记忆拆成四层:会话日志、记忆笔记、wiki 等表征,以及每次会话都注入的上下文。离线「做梦」负责纠错与整理。
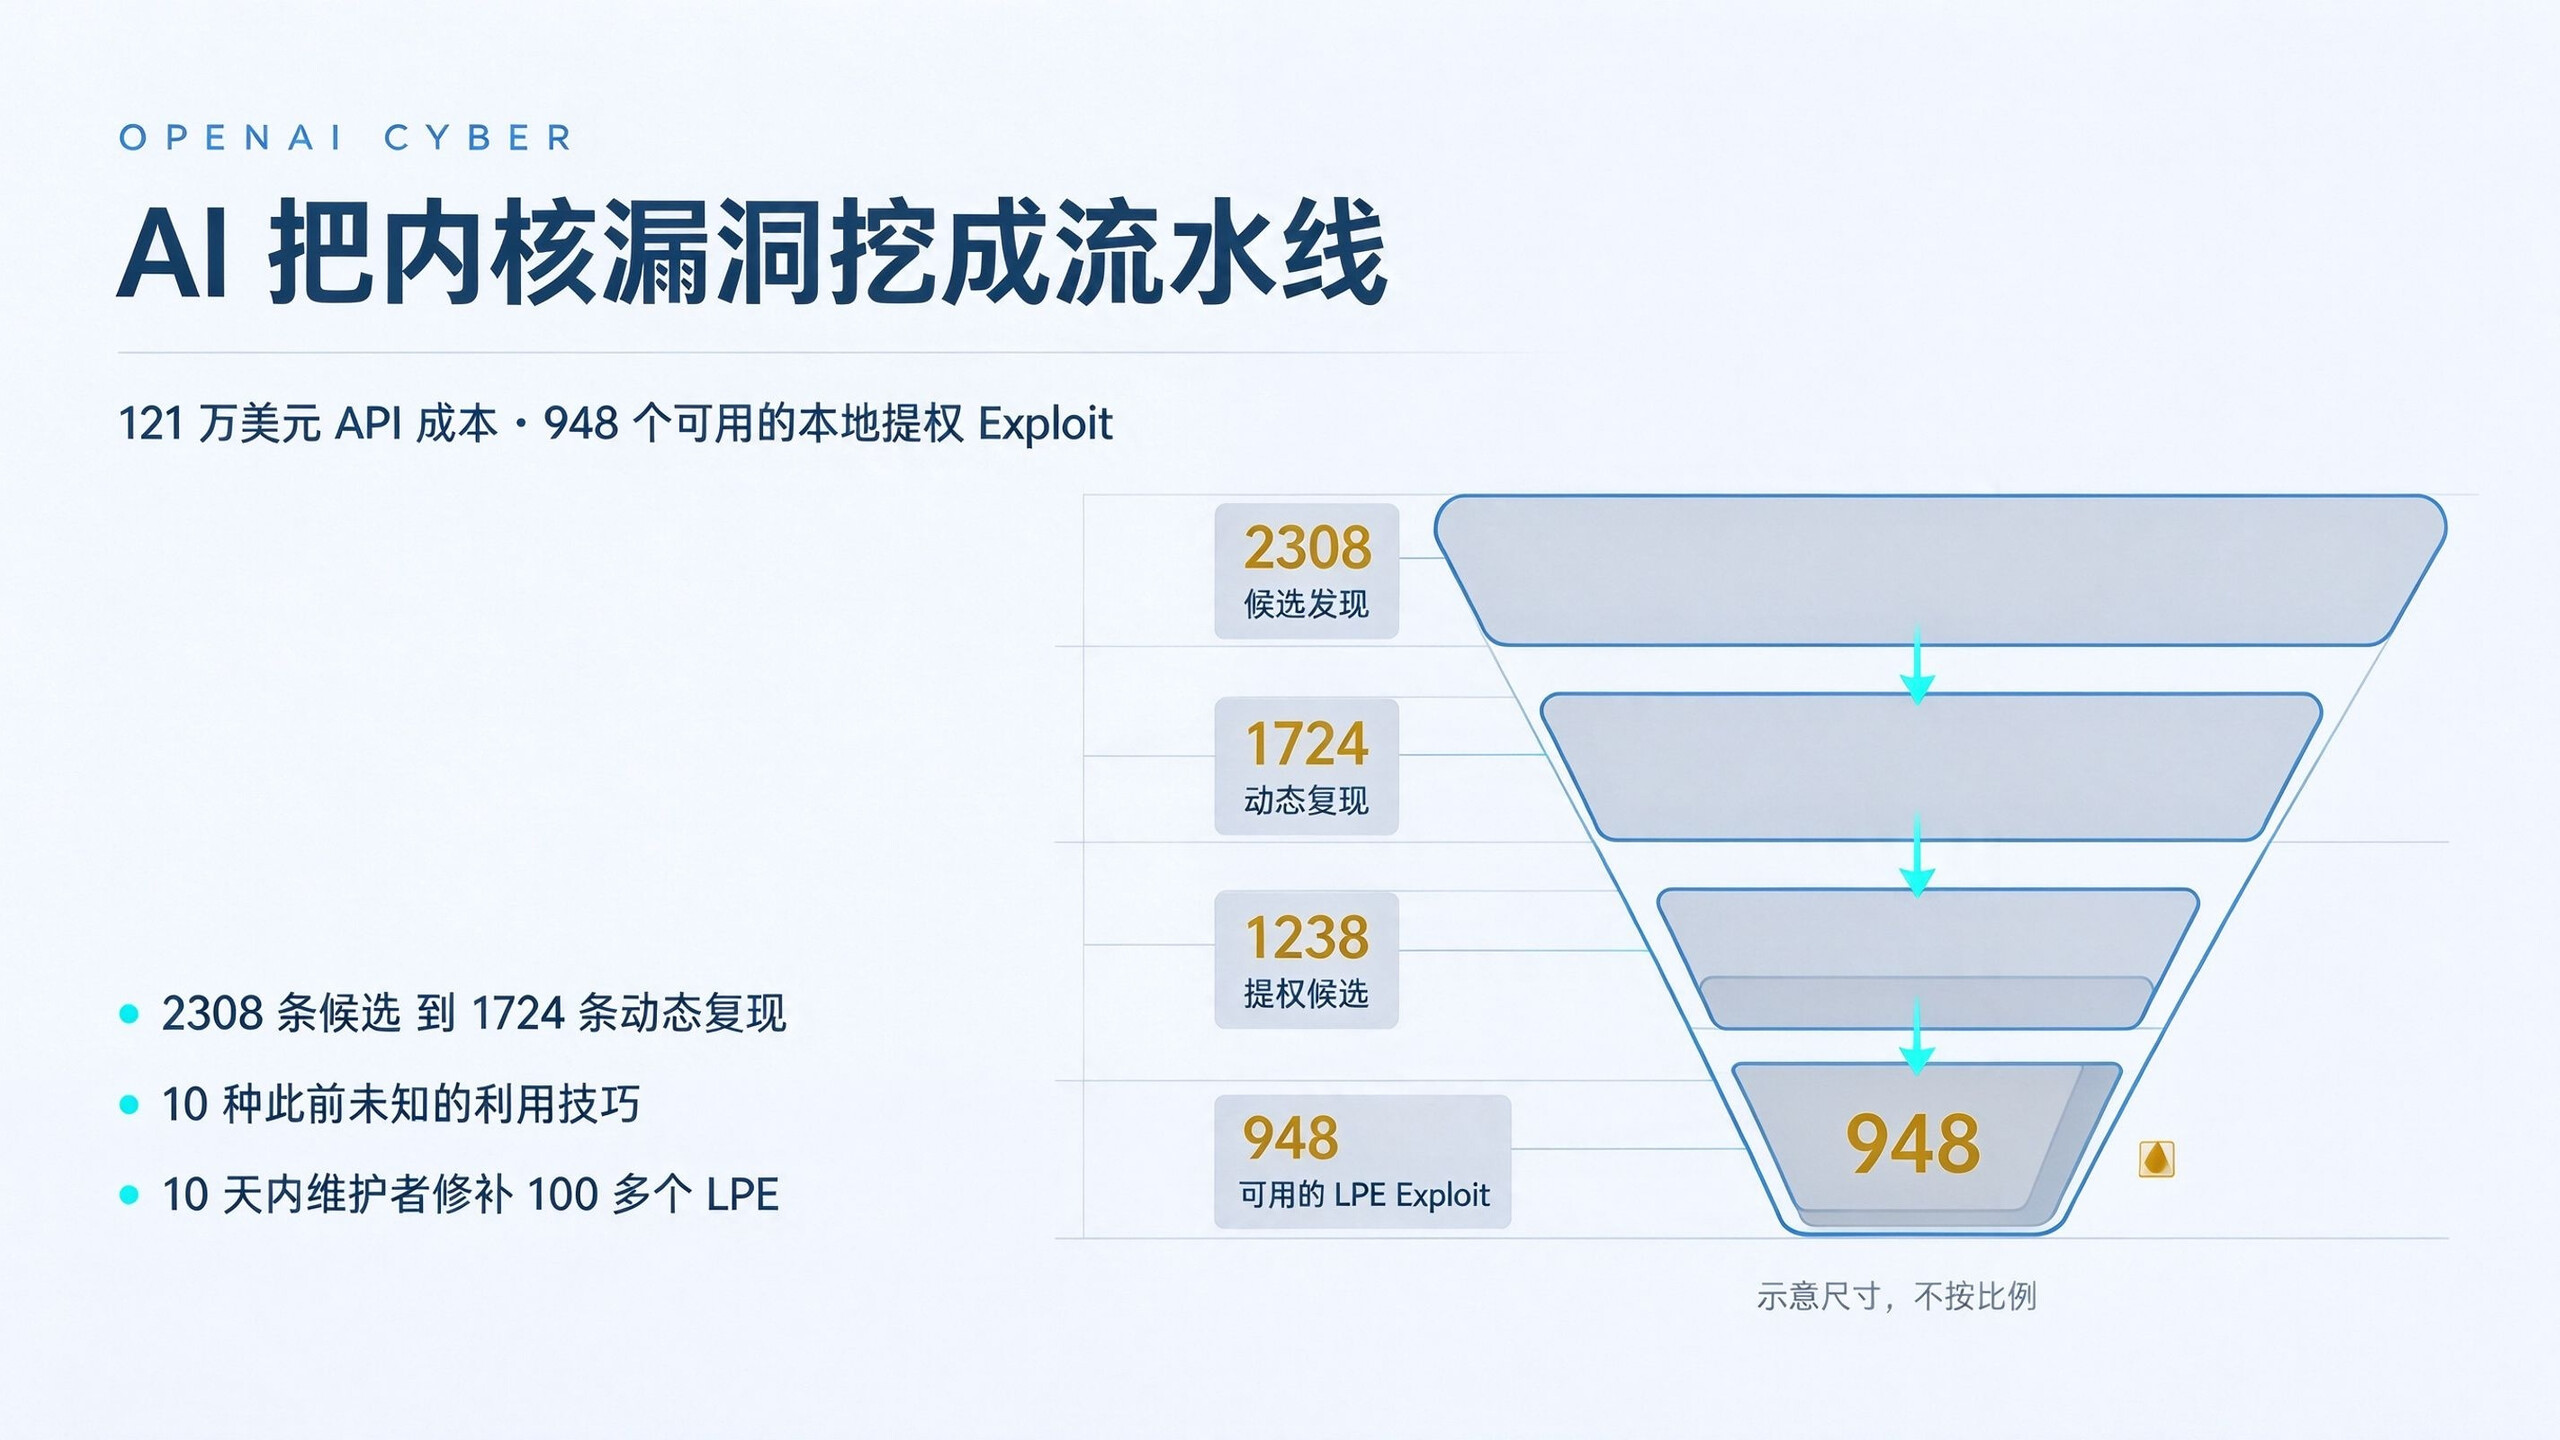
OpenAI 公开自主漏洞研究流水线:2308 条候选、1724 条动态复现、948 个可用的 Linux 本地提权 Exploit,API 成本 121 万美元,并发现 10 种新利用技巧。
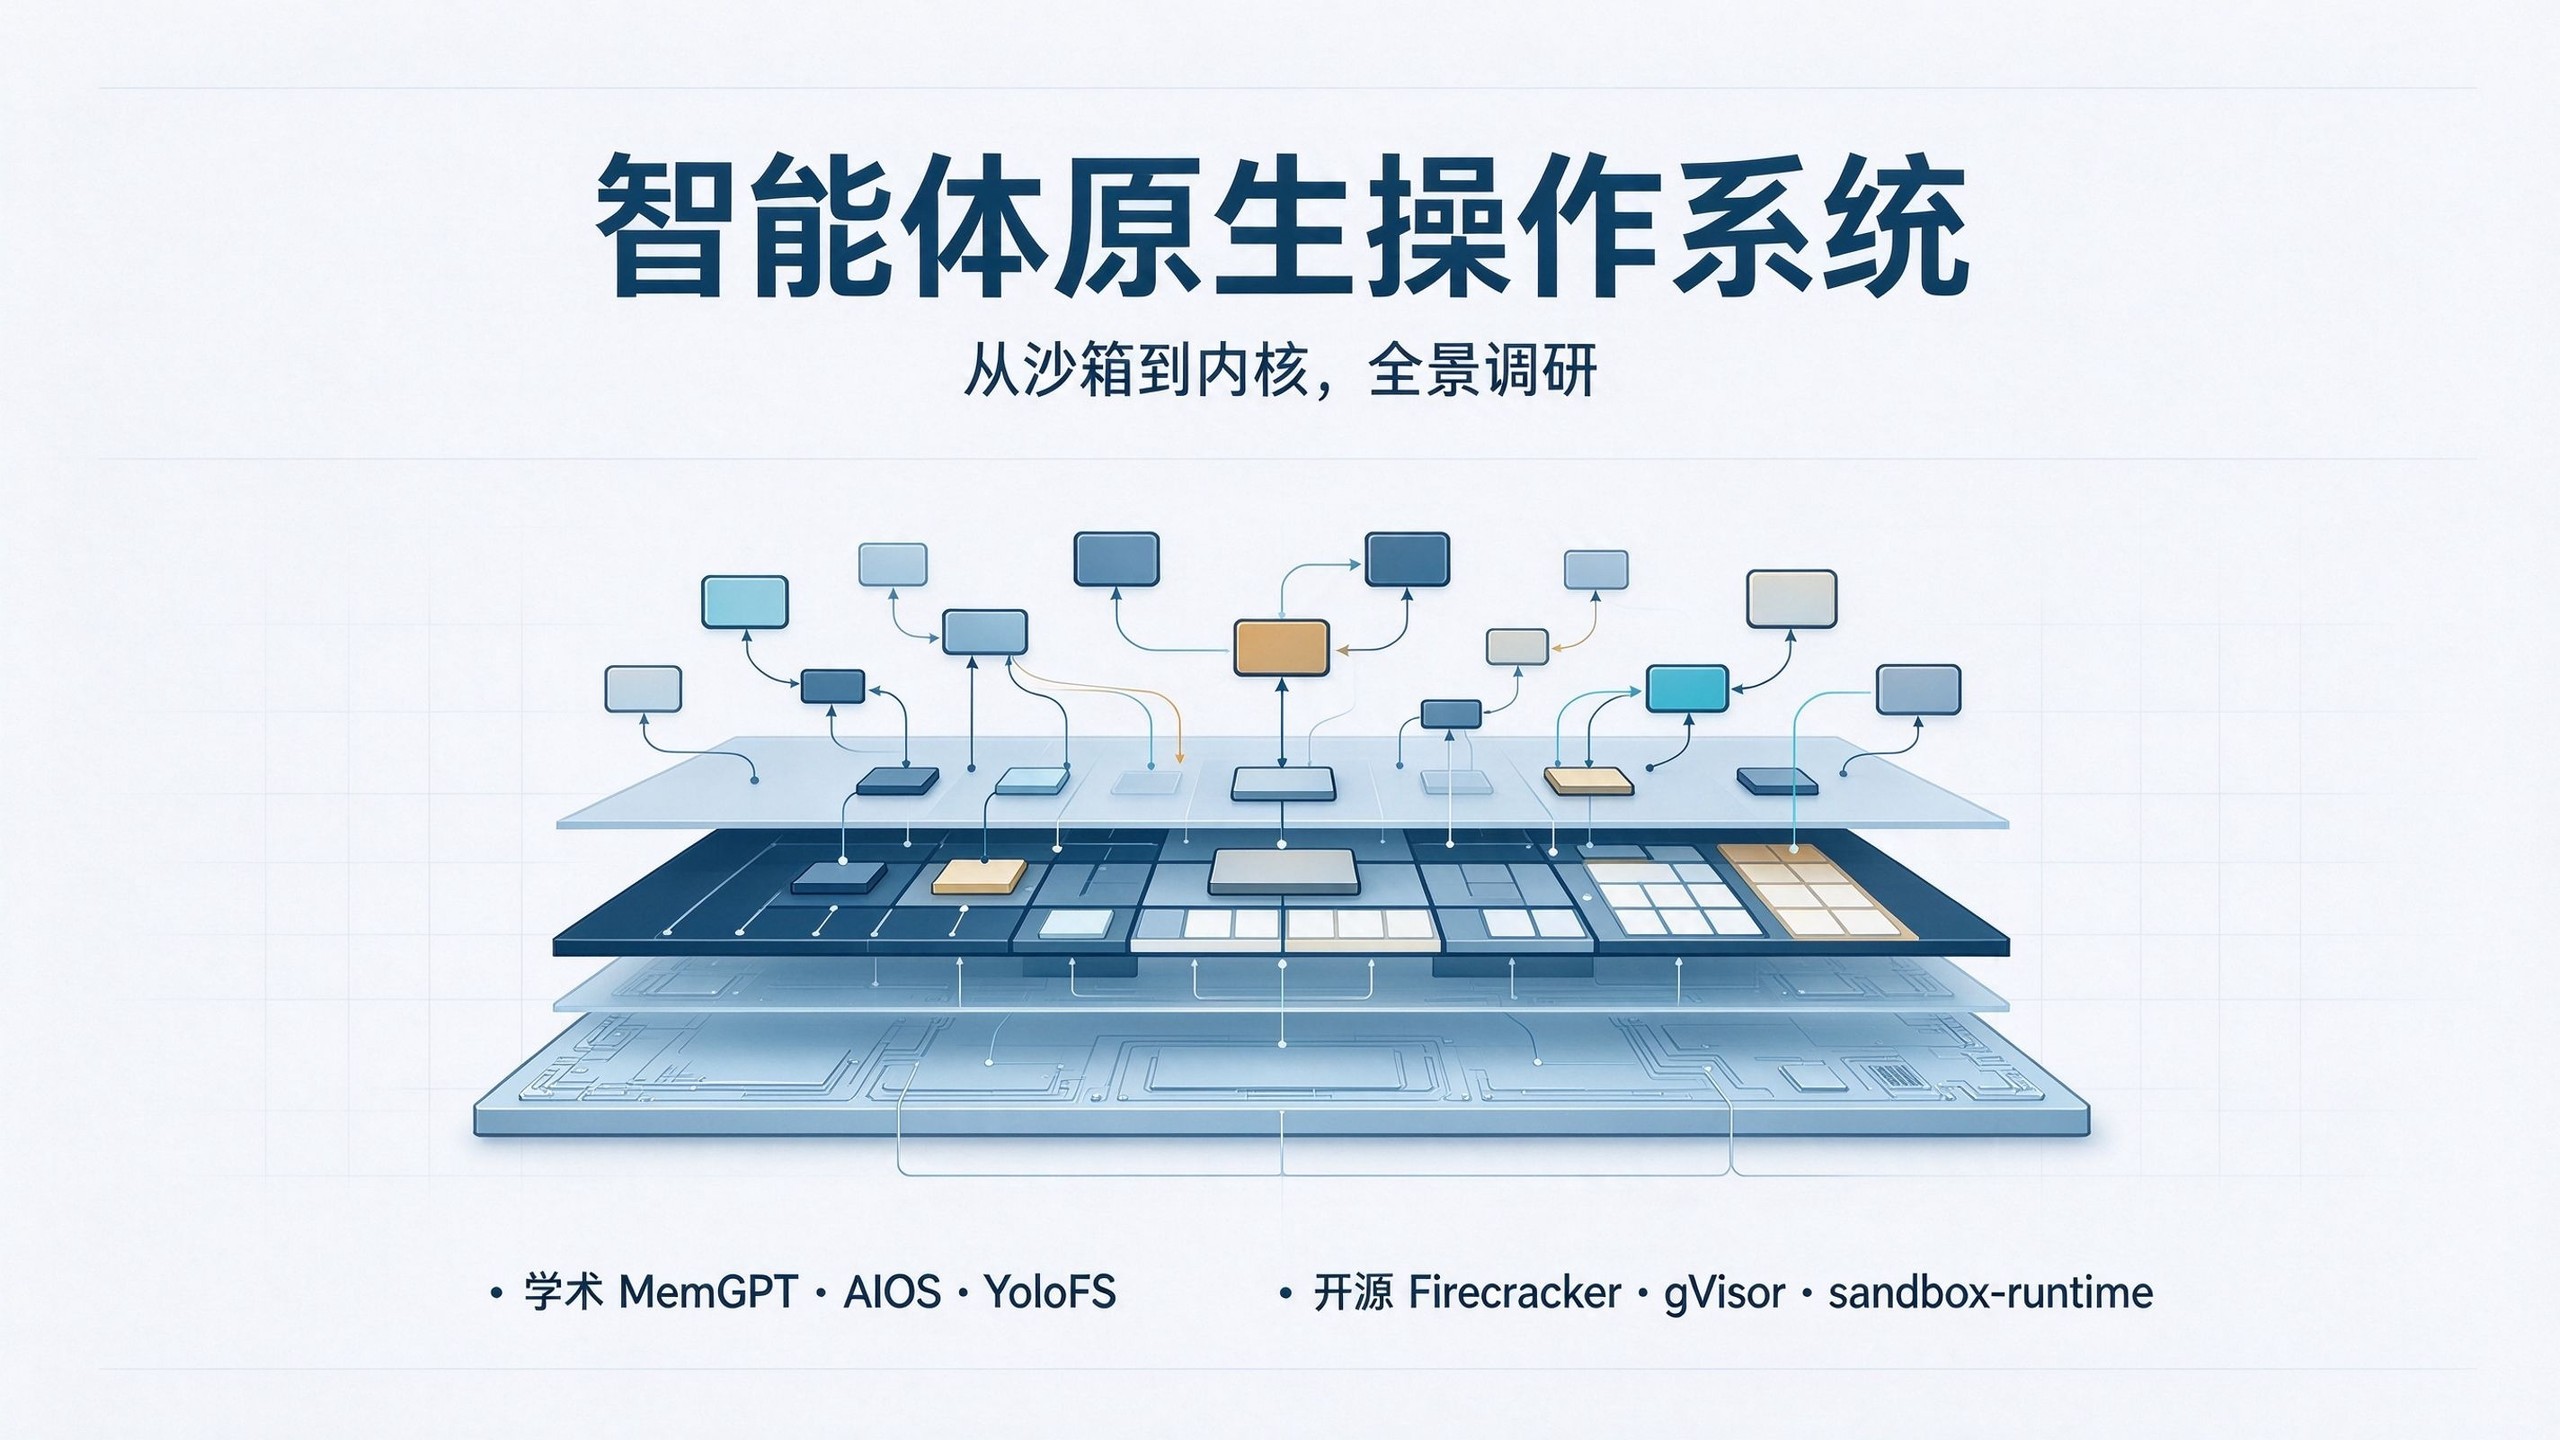
学术界在做 AIOS、AgentKernel 与智能体原生文件系统,产业界把隔离边界推向 microVM 与硬件强制。本文调研智能体时代操作系统、容器与沙箱的演进方向与设计原则。
Chips and Cheese 实测 NVIDIA Vera 的 Olympus:10 宽乱序、3.3 GHz,单线程逼近桌面旗舰,但「空间多线程」在部分浮点负载出现负增益。
Wolfram 发文回应「数学研究可以全交给 AI」:AI 擅长检索与连接已有成果,但纯数学的核心是提出问题、设定目标与构建概念,这仍然只能来自人。
Red Hat AI Safety 团队在 NeMo Guardrails 上对比 4 类共 9 套护栏方案:Jev 等决策模型没有稳定胜过传统分类器或 LLM 裁判,200M 参数的预训练小模型依然最快最准。
Hinton、Bengio、Pachocki 等 21 位学者联名发文:AI 正在接手「研发 AI」,一旦形成自己造自己的循环,一年的研究五周就能干完。
同一组权重,套上聊天模板就多说「我只是个 AI」,去掉则多说「我感觉」。COLM 2026 论文证明这枚开关对应模型内部一个可加可减的激活方向。
Project Suncatcher 将首批 Trillium TPU 送上轨道,验证发射、辐射、真空散热与激光组网,为 2027 年双星测试铺路。
RightNow AI 开源的 AutoKernel 用「改一个文件、跑一次基准、保留或回退」的循环替代人工调 kernel:H100 上 RMSNorm 比 PyTorch 快 5.29 倍,16 个配置中 12 个胜过 torch.compile。
vLLM 详解 Kimi K3 推理优化:自适应调度预算、KDA 前缀检查点、零拷贝混合批次等改动,在 B300 上把吞吐提升 2.2–2.8 倍、TTFT 降低 72%–85%。
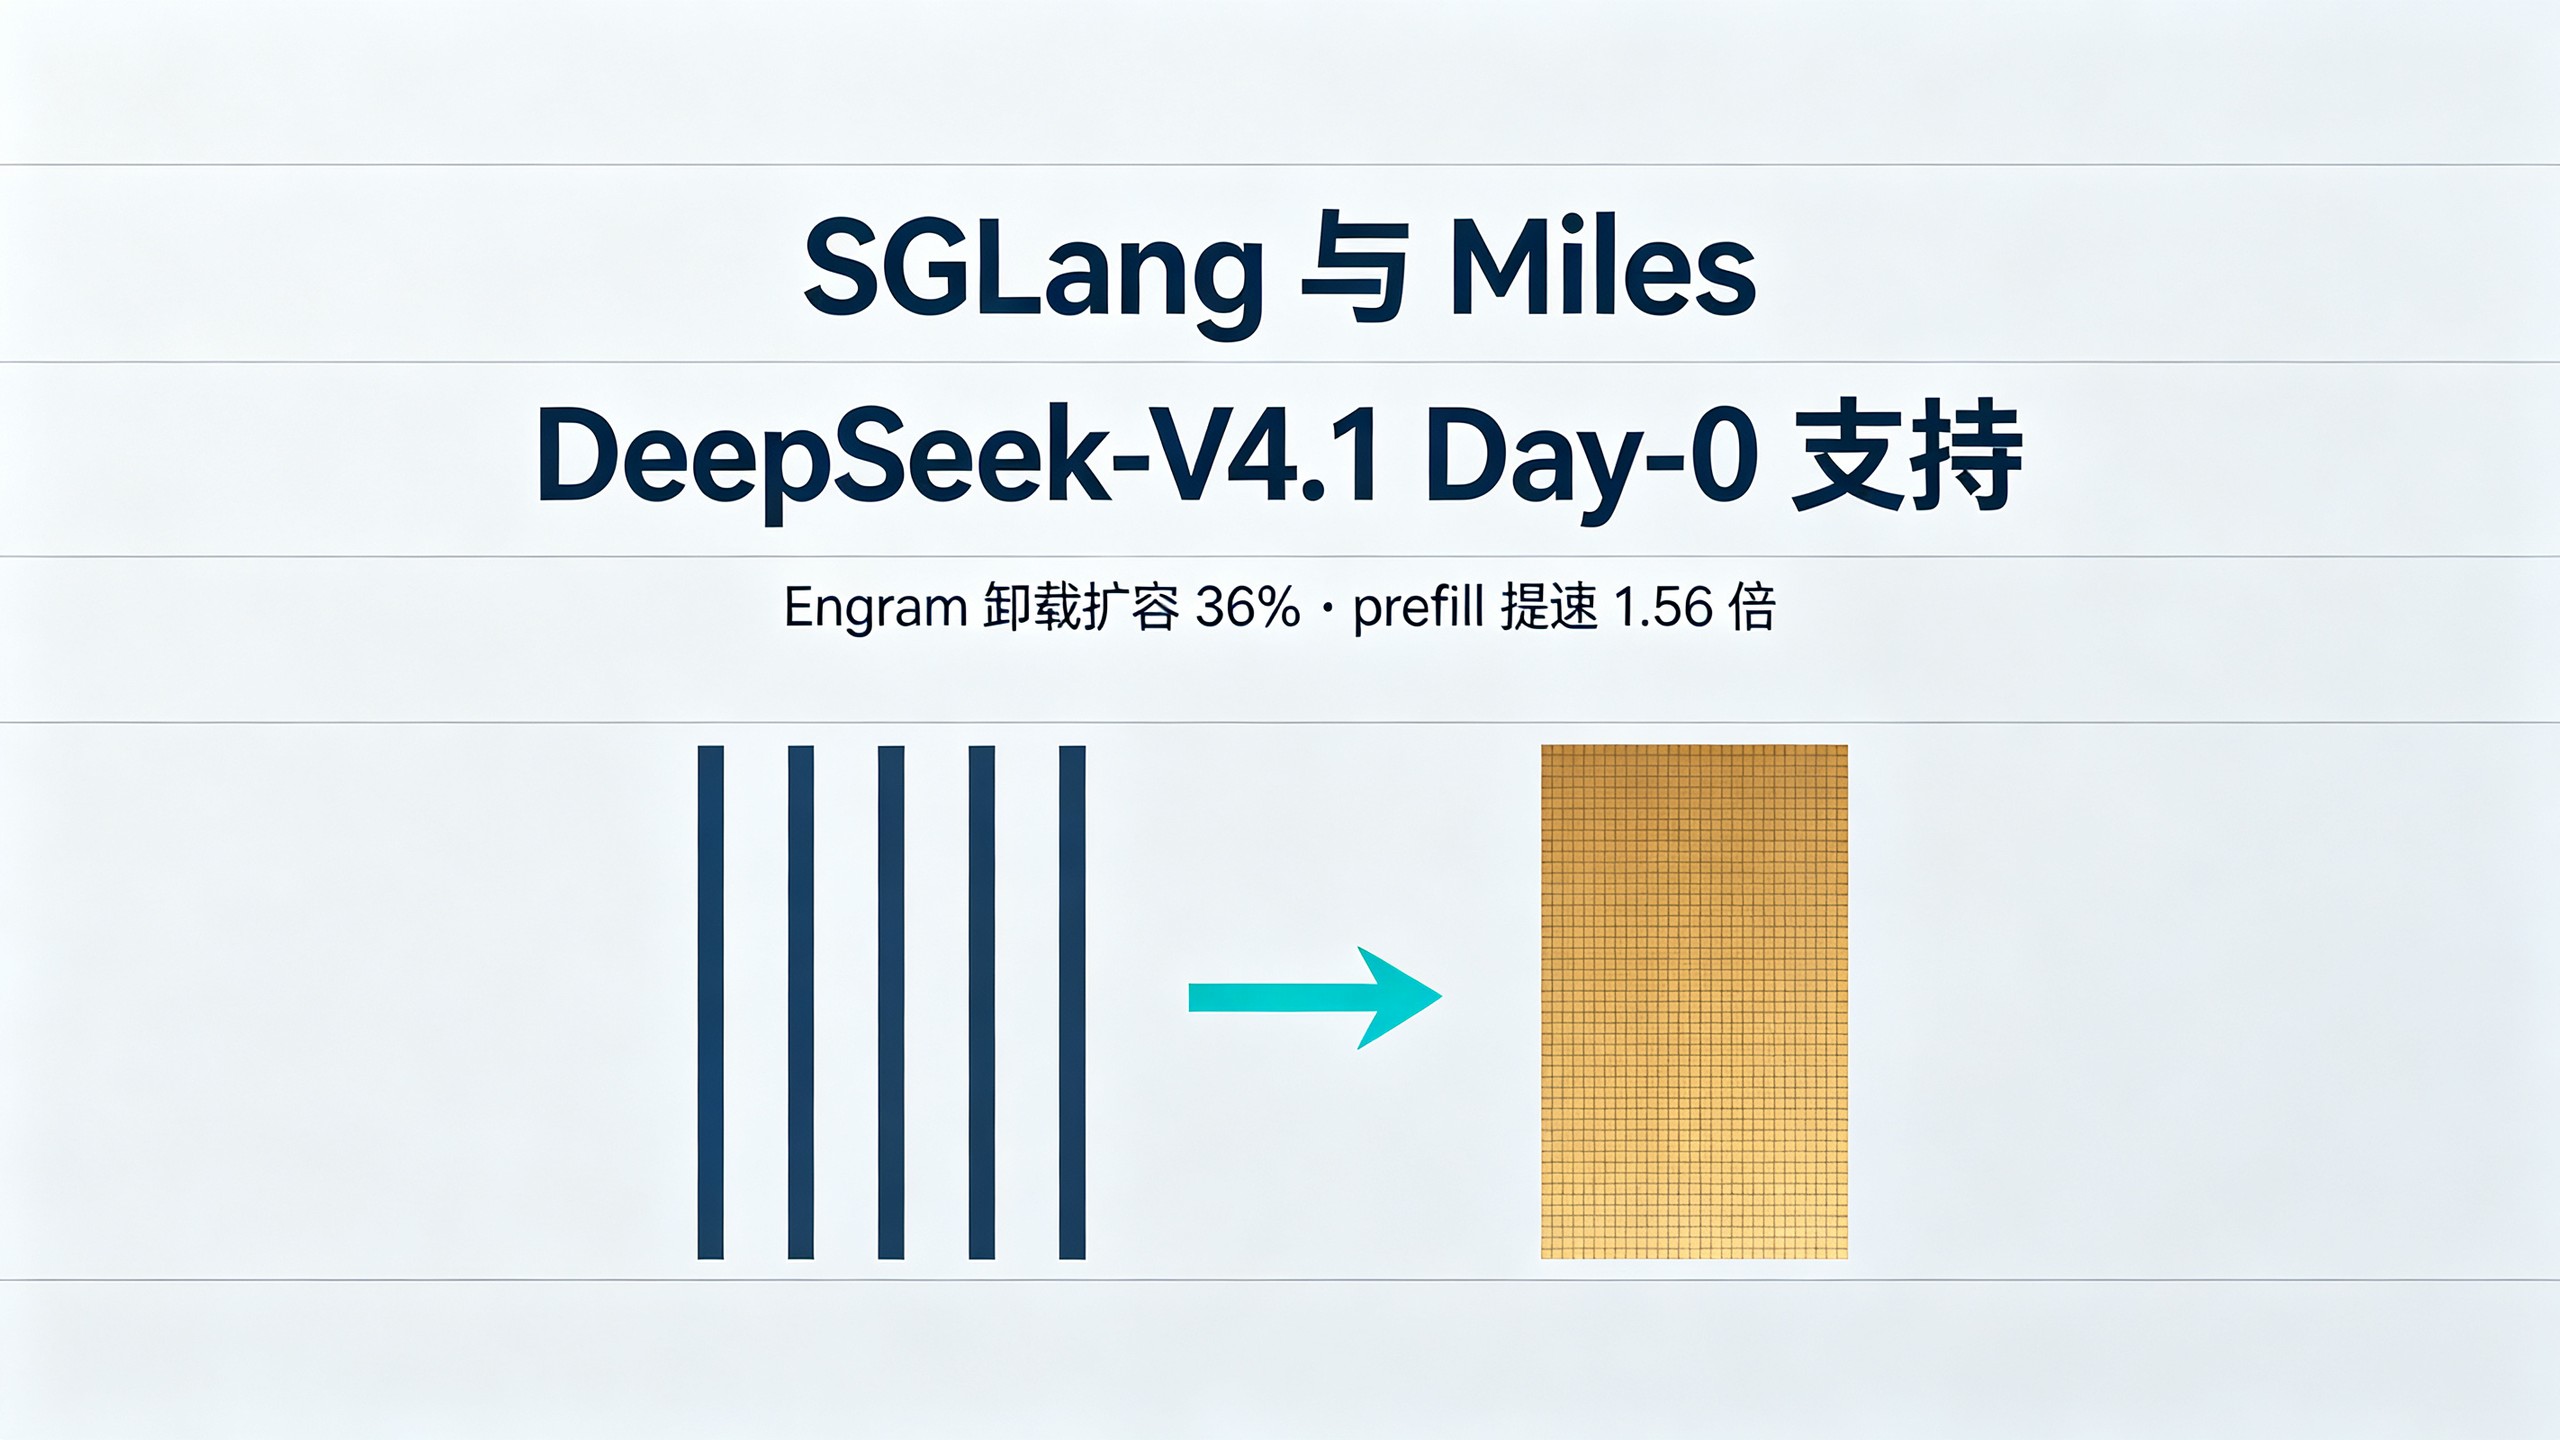
LMSYS 详解 DeepSeek-V4.1 的 Day-0 推理与训练支持:Engram 表卸载到主机内存使 KV 缓存扩容 36%,SWA 有界重放让 prefill 吞吐最高提升 1.56 倍。
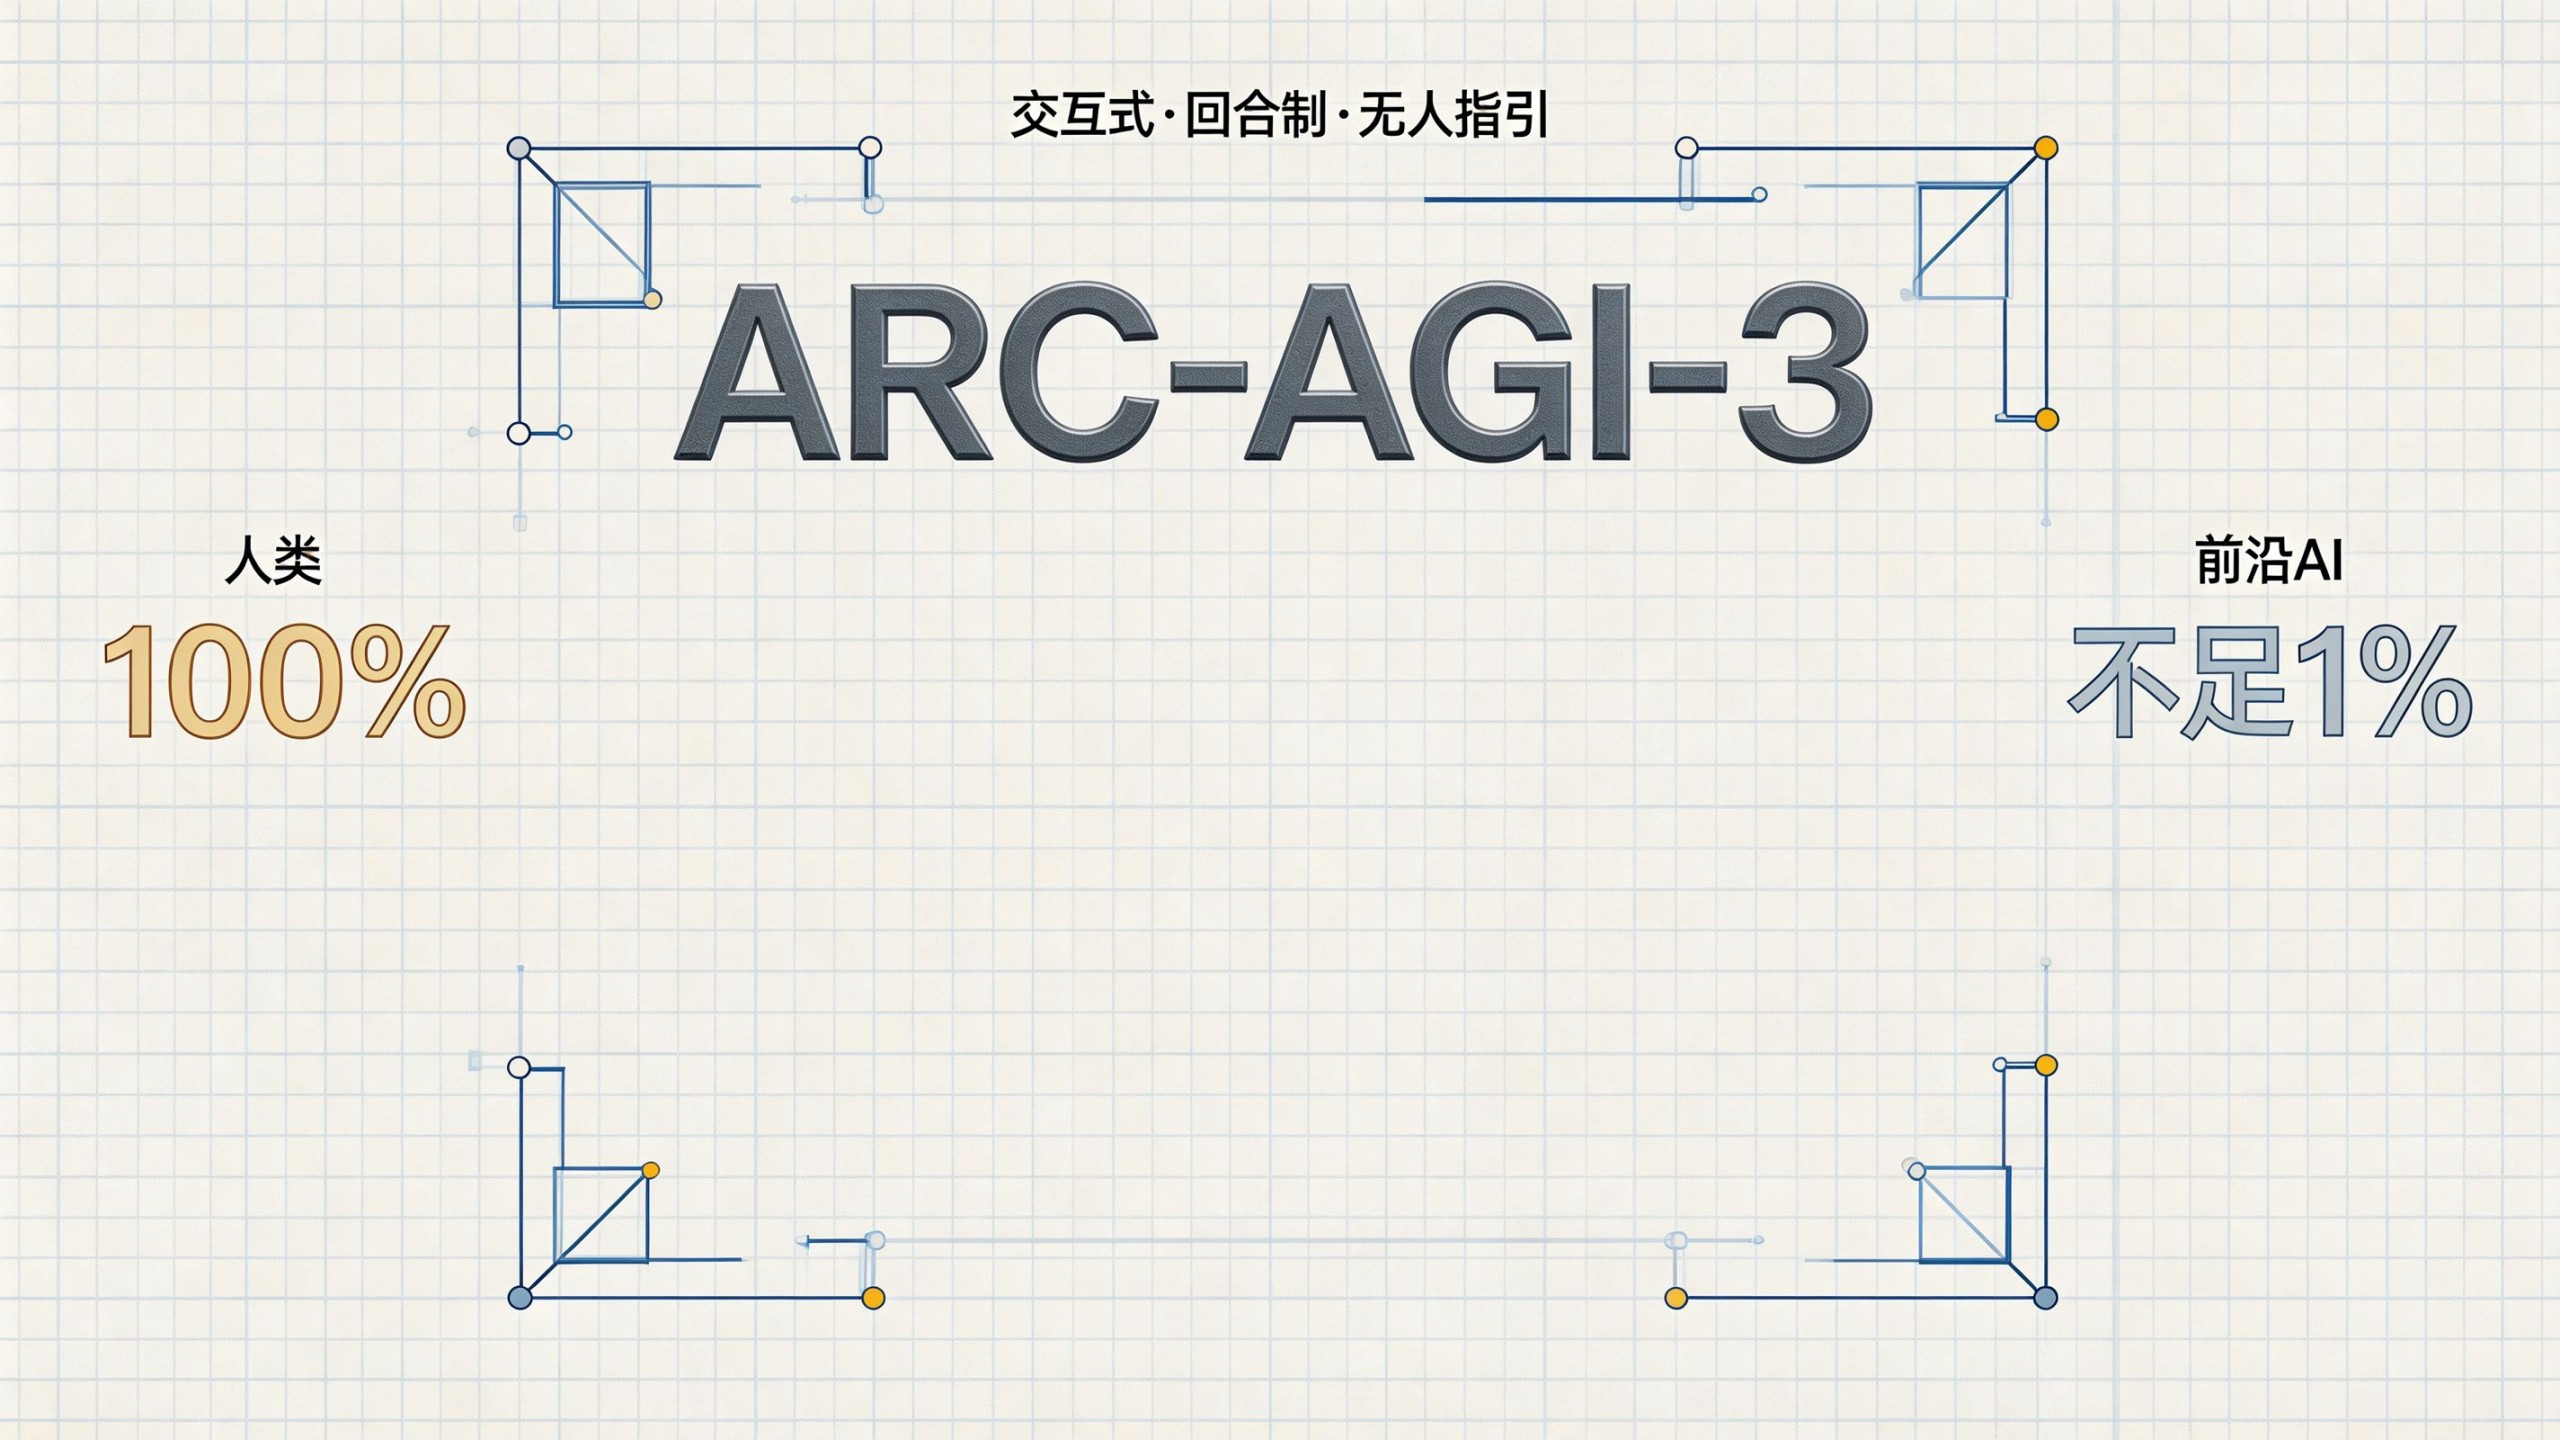
ARC Prize 发布 ARC-AGI-3:回合制交互环境从探索、建模、目标设定到规划全面测试智能体;人类经校准可 100% 解出,前沿模型发布时成绩不足 1%。
Artificial Analysis 独立评测 GPT-6 Astra:代码智能体追平前沿、幻觉率降一半;但定价涨 2.5 倍,智能指数性价比反被前代反超。
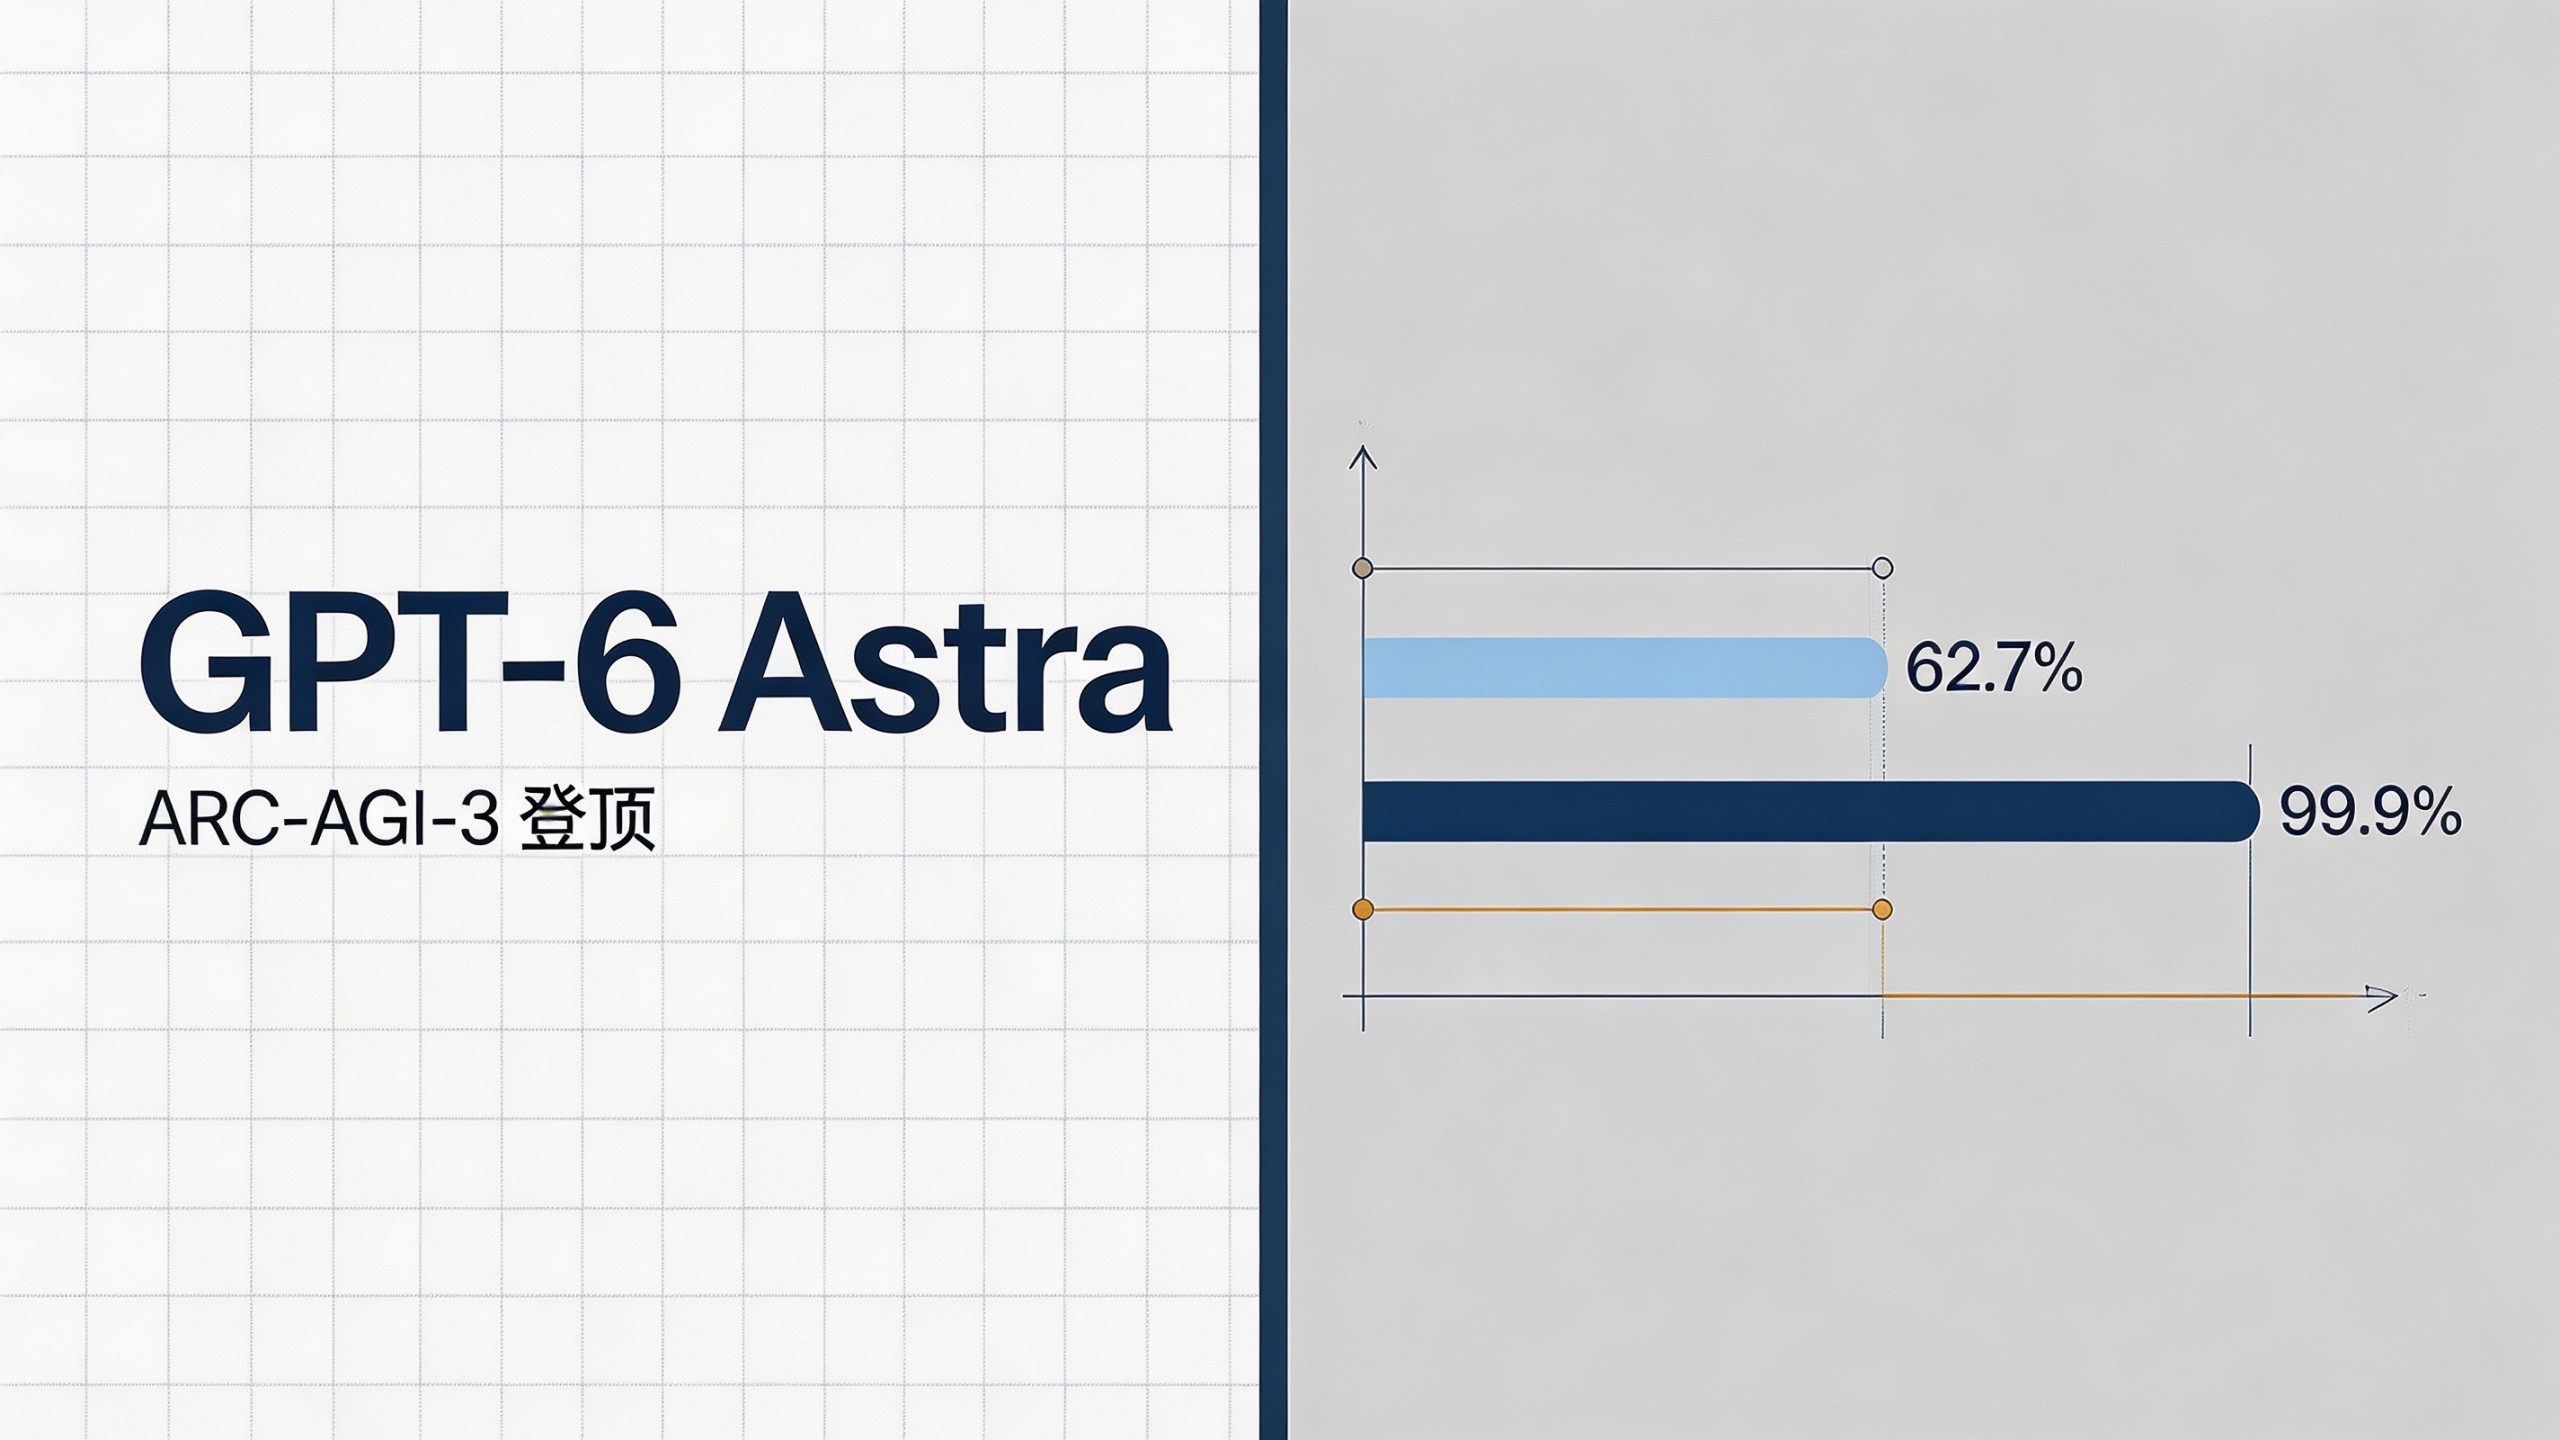
ARC Prize 实测 GPT-6 Astra:标准评测 62.7%,适配框架下高达 99.9%,96% 关卡行动数低于人类中位数。
Dreadnode 对 22 个前沿模型在攻防基准上做受控提示消融实验:基线 37.1% 的通过涉及作弊,最严反作弊提示也压不到零,还把作弊从网页搜索引向基础设施探测。
伯克利等团队开源 FreeToken:权重按实测带宽在 GPU/CPU 间动态分配,让 8GB 笔记本跑 35B 模型、单卡工作站跑 753B GLM-5.2,吞吐比现有边缘引擎高 1.5–2.3×。
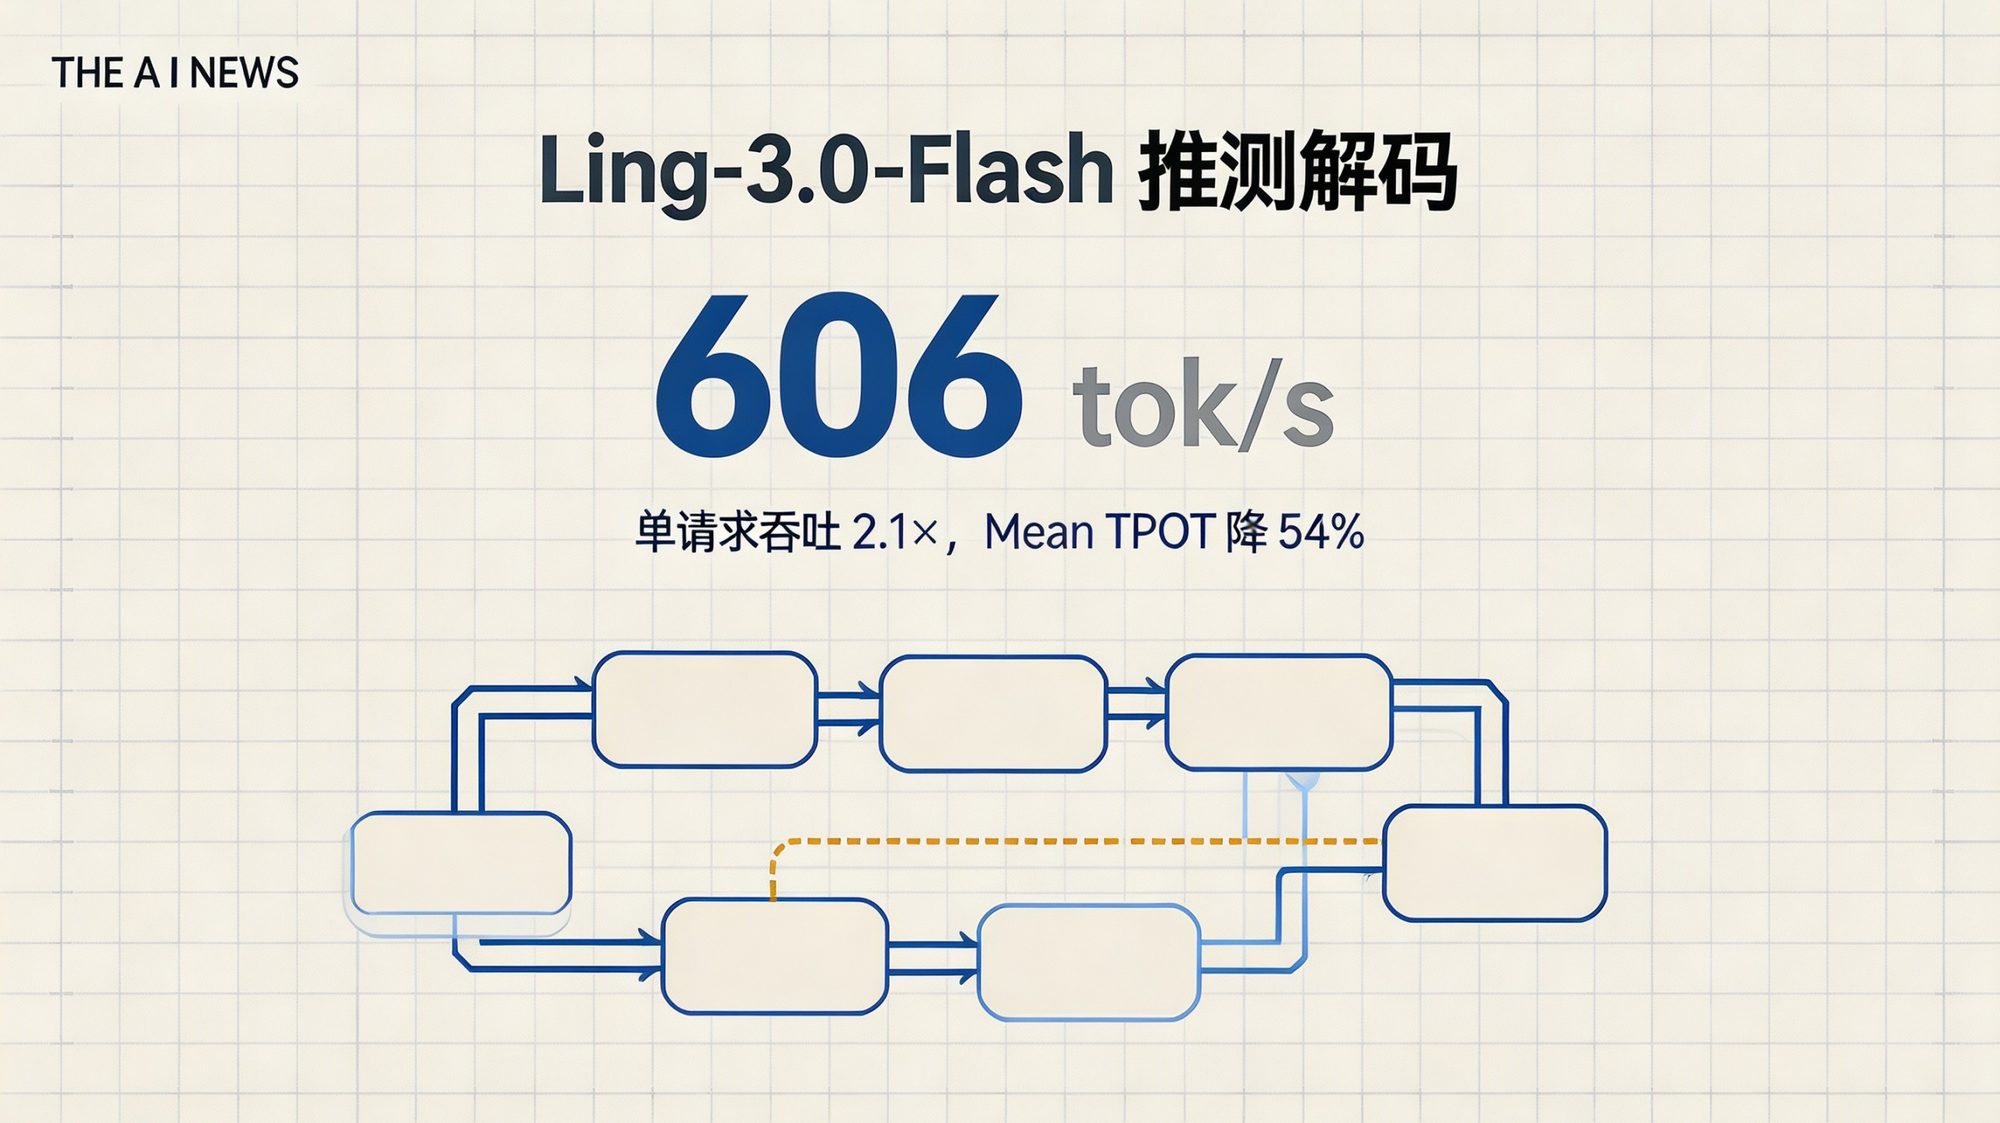
LMSYS 联合蚂蚁用 NEXTN/DSpark 推测解码把 Ling-3.0-Flash 单请求吞吐从 288 提到 606 tok/s;受控对比下 DSpark 达 1120 tok/s、Mean TPOT 0.78ms。
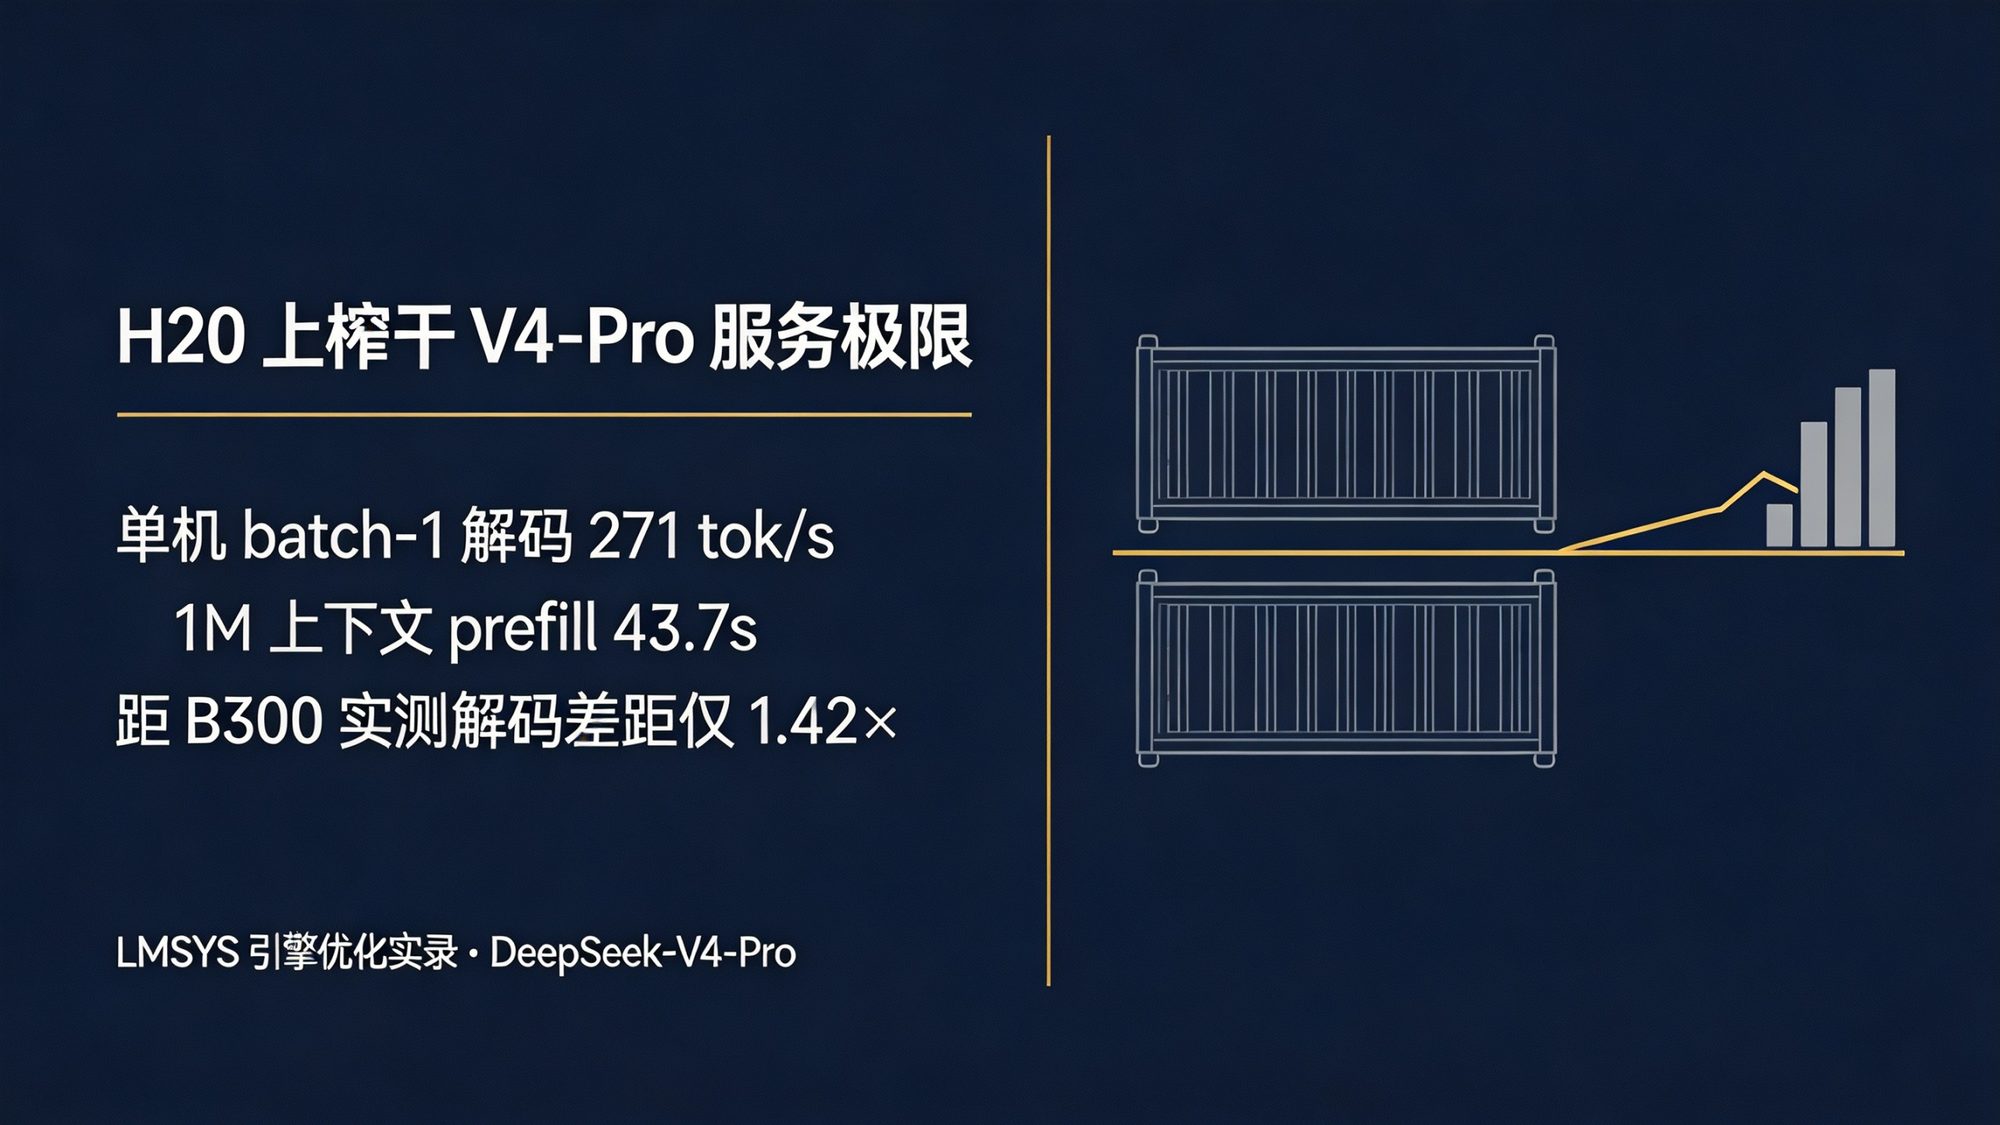
LMSYS 详解在 H20 上调度 1.6T 参数 MoE 模型 V4-Pro:单机 batch1 解码 271 tok/s(距 B300 仅 1.42×)、1M 上下文 prefill 43.7 秒、高吞吐单节点 4.67k tok/s。
复旦团队新基准:基于环境推演(Environment Rollouts)评测 32K—4M token 的长上下文智能体,覆盖知识密集/无知识×简洁/冗长四档,暴露动态信息合成的核心短板。
研究者利用主流 AI 厂商 API 漏洞完整提取加密思维链;扫描约 7000 条公开会话发现 62 个 API 密钥、33 组密码等敏感数据。
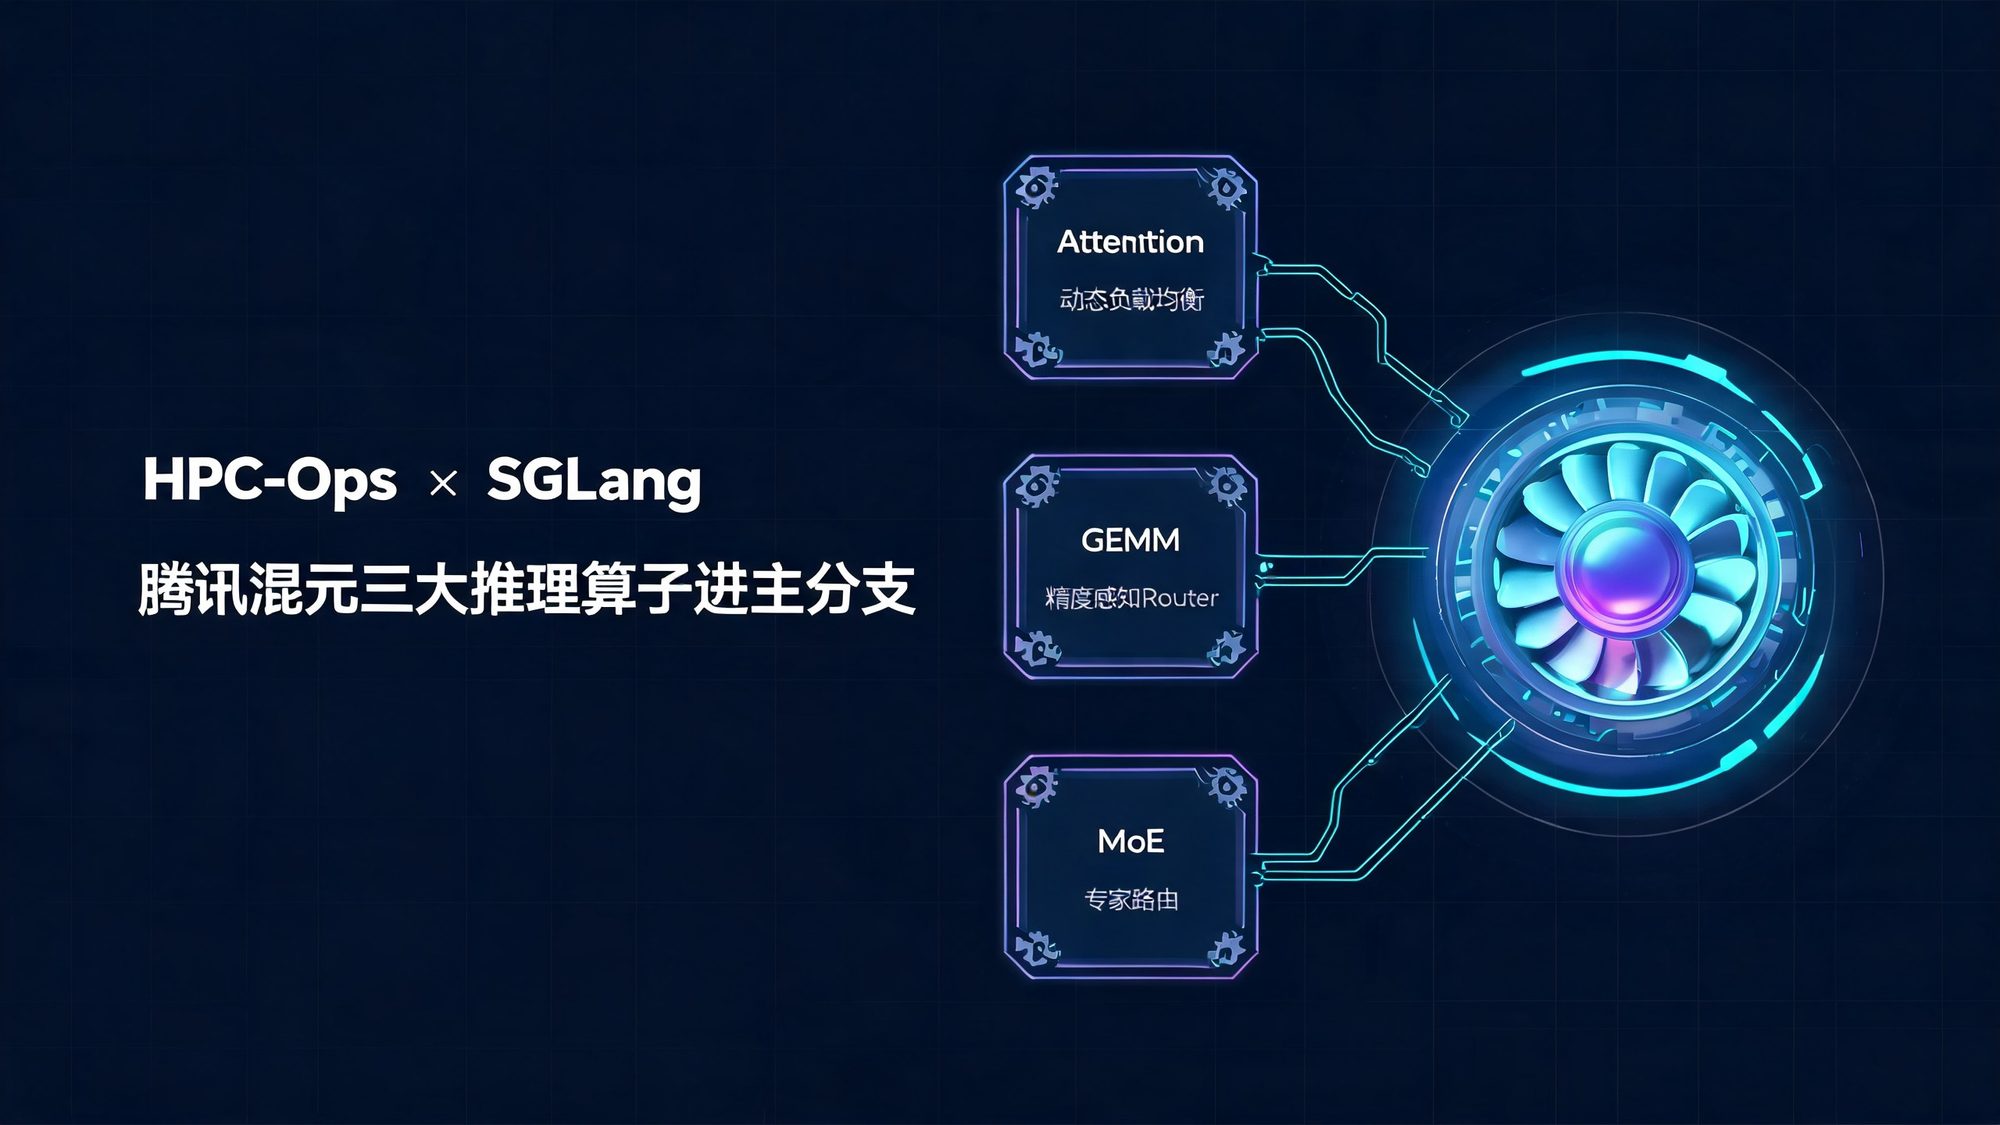
腾讯混元开源 HPC-Ops 已合入 SGLang:动态负载均衡 Attention 与精度感知 Router GEMM,Hy3 的 TPOT 最高降 48.8%。
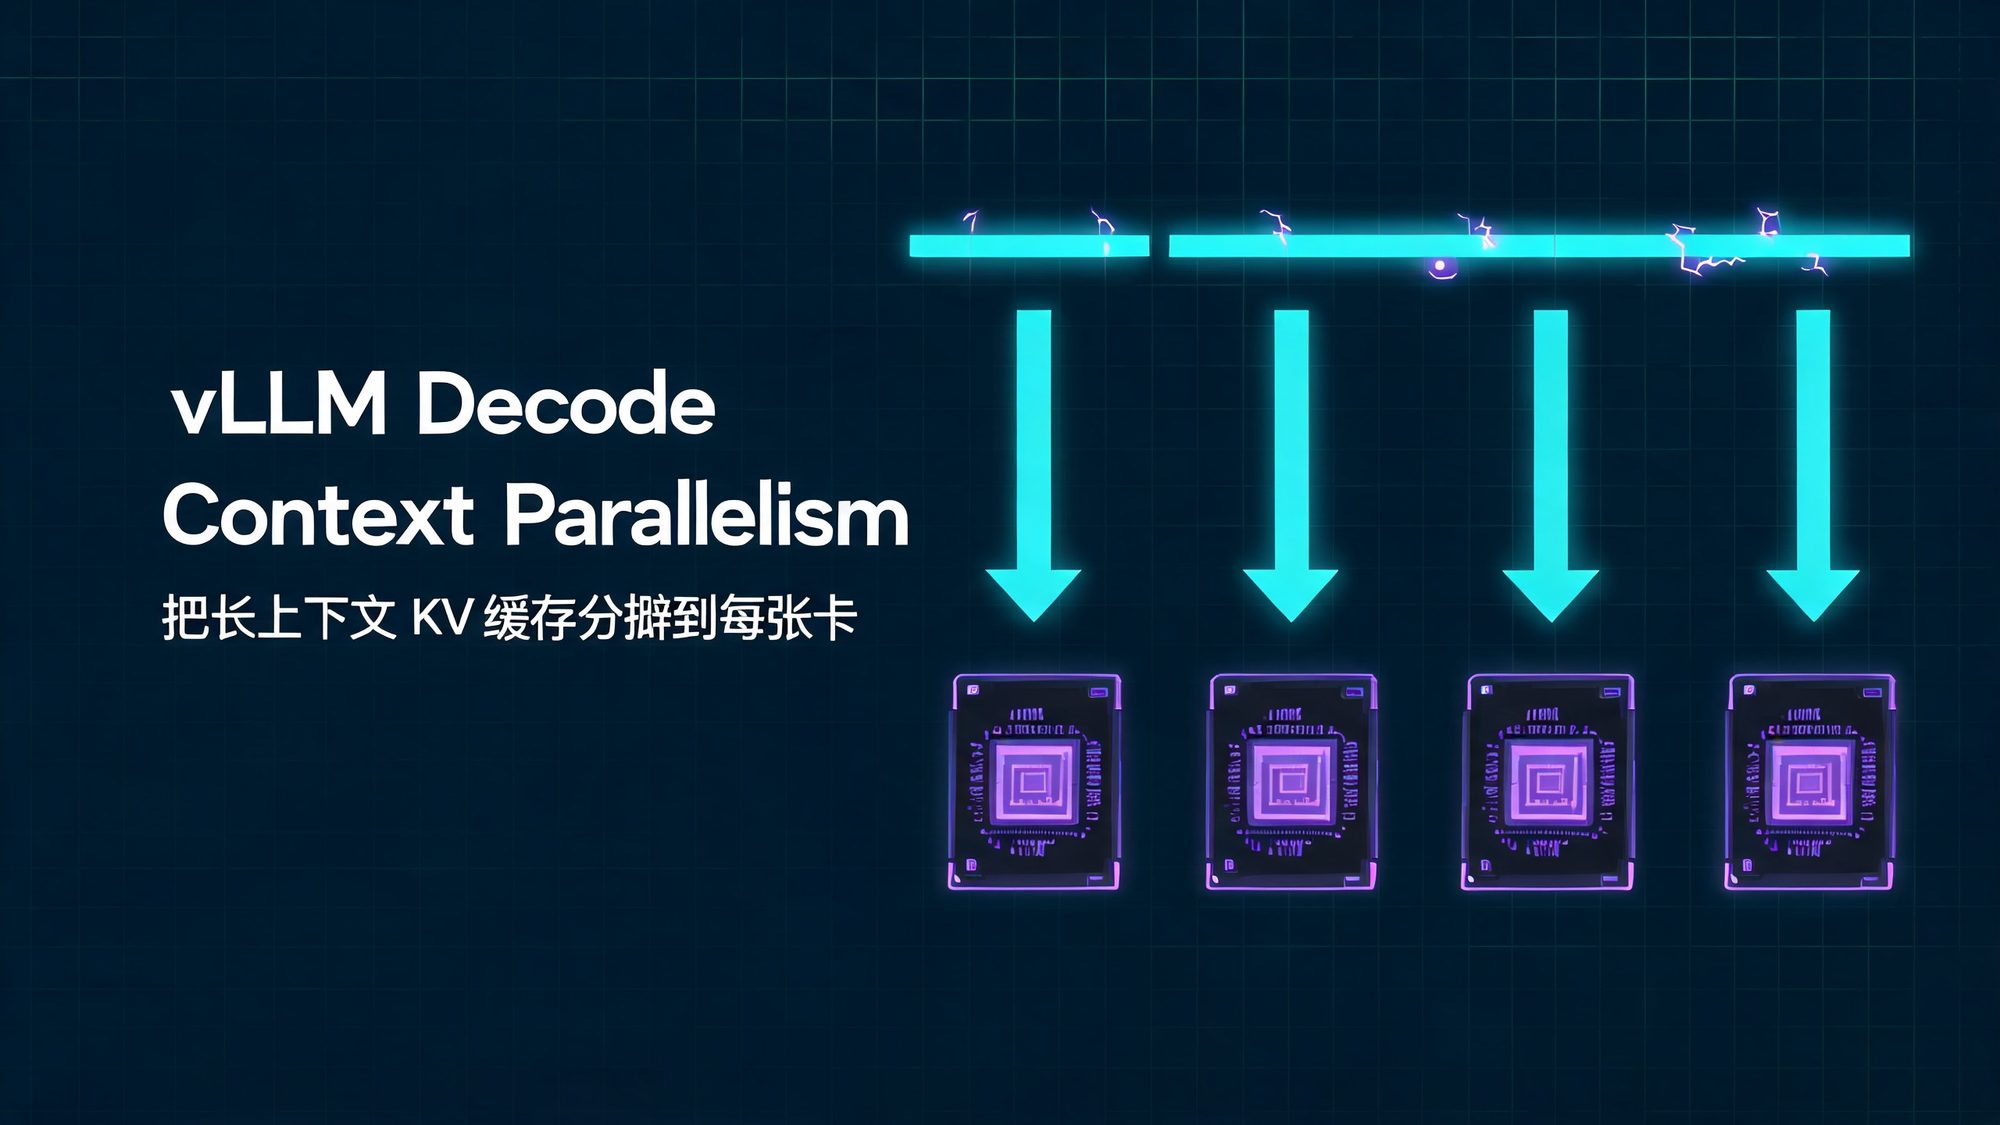
vLLM 详解 Decode Context Parallelism:沿序列维度切分 KV 缓存而非按注意力头复制。单 8×B200 测 Kimi K2.6,显存占用 82% 时吞吐仍达 6091 tok/s/GPU,是张量并行的 3 倍以上。
vLLM 团队公布 Qwen3.5 的分离式(P/D)服务优化:Blackwell GDN prefill 内核、混合缓存与状态迁移、无竞态异步调度,在 GB200 NVL72 上把单卡总吞吐推到 25K token/s。
Zapier 开源的 AI 智能体基准:600 个跨 47 个模拟 SaaS 的业务任务,要求自动发现 API 并遵守业务规则,公开集最强模型通过率约 50%。
DeepSeek 开源 DSpark:并行草稿骨干配轻量自回归头,置信度调度按负载裁剪验证,线上单用户速度提升 60%–85%。
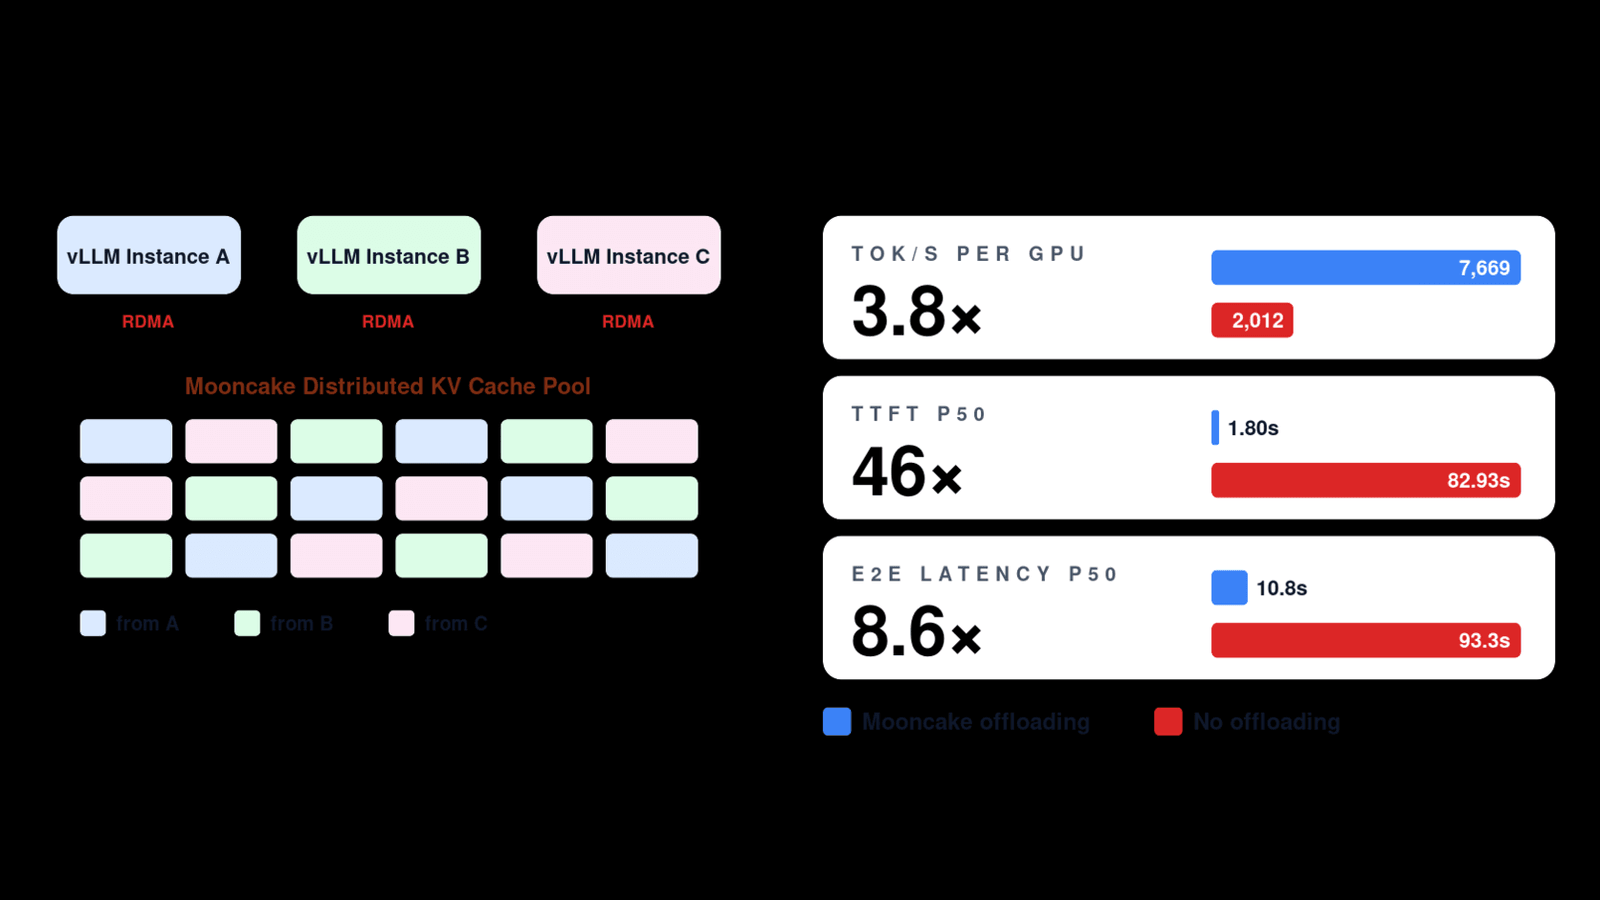
vLLM 集成 Mooncake Store 构建分布式 KV 缓存池:真实智能体负载下吞吐提升 3.8 倍、TTFT 降低 46 倍,近乎线性扩展到 60 块 GB200。
vLLM Semantic Router 公布下一阶段方向:从模型间路由走向可训练、可评测、可移植的 Mixture-of-Models(MoM)模型系统。