
Fireworks 发布 Ember-1:在 Kimi K3 上训练,token 用量减少约 40%
模型2026年9月28日
Fireworks Research 发布专用模型 Ember-1:以 Kimi K3 为基座训练,同等质量下 token 用量减少约 40%,成本最多降半,已在 Serverless 上线 Research Preview。
Fireworks Research 发布专用模型 Ember-1:以 Kimi K3 为基座训练,同等质量下 token 用量减少约 40%,成本最多降半,已在 Serverless 上线 Research Preview。
基于官方发布数据对比 DeepSeek V4 Flash、V4.1 Flash、GLM-5.3 Flash、MiMo-V2.6 Flash 的参数规模、架构路线、主流评测成绩与 API 价格。
小米开源全模态 MiMo-V2.6 系列:Pro 以 46.32 的智能指数登顶开源第一,六天完成 30 步 RL 训练并全程直播,API 价格与 V2.5 持平。
阶跃星辰发布 Step 5 Preview:600B MoE、每 token 激活 27B、支持 1M 上下文与视觉输入;AA 智能指数 44,DeepSWE v1.1 拿到 67.7,金融基准亮眼,10 月 15 日开源权重。
阿里通义千问开源 Qwen-Image-2.1:视觉生成部分仅 7B 参数,把文生图与图像编辑合一,原生支持透明图像生成与编辑,最多支持 10 张参考图,并提升文字排版与人像质感。
TypeSafe AI 发布首个 System One 模型 Jev:在 System One 任务上智能水平与现有 LLM 相当,却快两个数量级;放弃字符串生成,输出带类型的概率化决策,且不可能产生类型错误。
GPT-6 Astra 破解一条百年未解的一战德军 ADFGVX 密电,用密钥 TRUPPENVERSCHIEBUNG 还原 1918 年塞瓦斯托波尔情报,并与 HMS Canterbury 航海日志吻合。
DeepSeek 发布 V4.1 Flash:552B MoE、非对称 CED 仅激活 8B/16B,KV 缓存累计压缩 437 倍,多项 Agent 基准反超 Opus-5,API 降价。
智谱上线 GLM-5.3-Flash:320B 参数、18B 激活,混合稀疏与线性注意力,原生多模态、1M 上下文,AA 智能指数看齐 Claude Opus 4.8,定价仅为其 1/40。
阿里开源 Qwen3.8-Flash-Next:125B 参数、6B 激活,混合注意力与 N-gram Embedding 新架构,原生 262K 可扩 1M 上下文,训练成本约为 Qwen3.7-Plus 的 1/9。
腾讯发布 Hy4 preview:总参 770B、激活 49B、1M 上下文,代码/办公/游戏/科研全面跃升;163 名专家盲测胜 GLM 5.3 与 Kimi K3;API 输入 6 元/百万 token(命中缓存 0.3 元)。
等待四个月的 DeepSeek 多模态模型终于落地:看图按 token 计费(最多 384 tokens/张,1 分钱约看 9 张图),文本能力与 V4-Flash 持平,视觉 Agent 评测大幅跃升。
LMSYS Chatbot Arena 团队宣布 Qwen 最大开源模型 Qwen3.8-2.4T-A95B 获 SGLang 与 Miles 发布日即全面支持,涵盖混合注意力状态管理、PD 分离与 Day-0 RL。
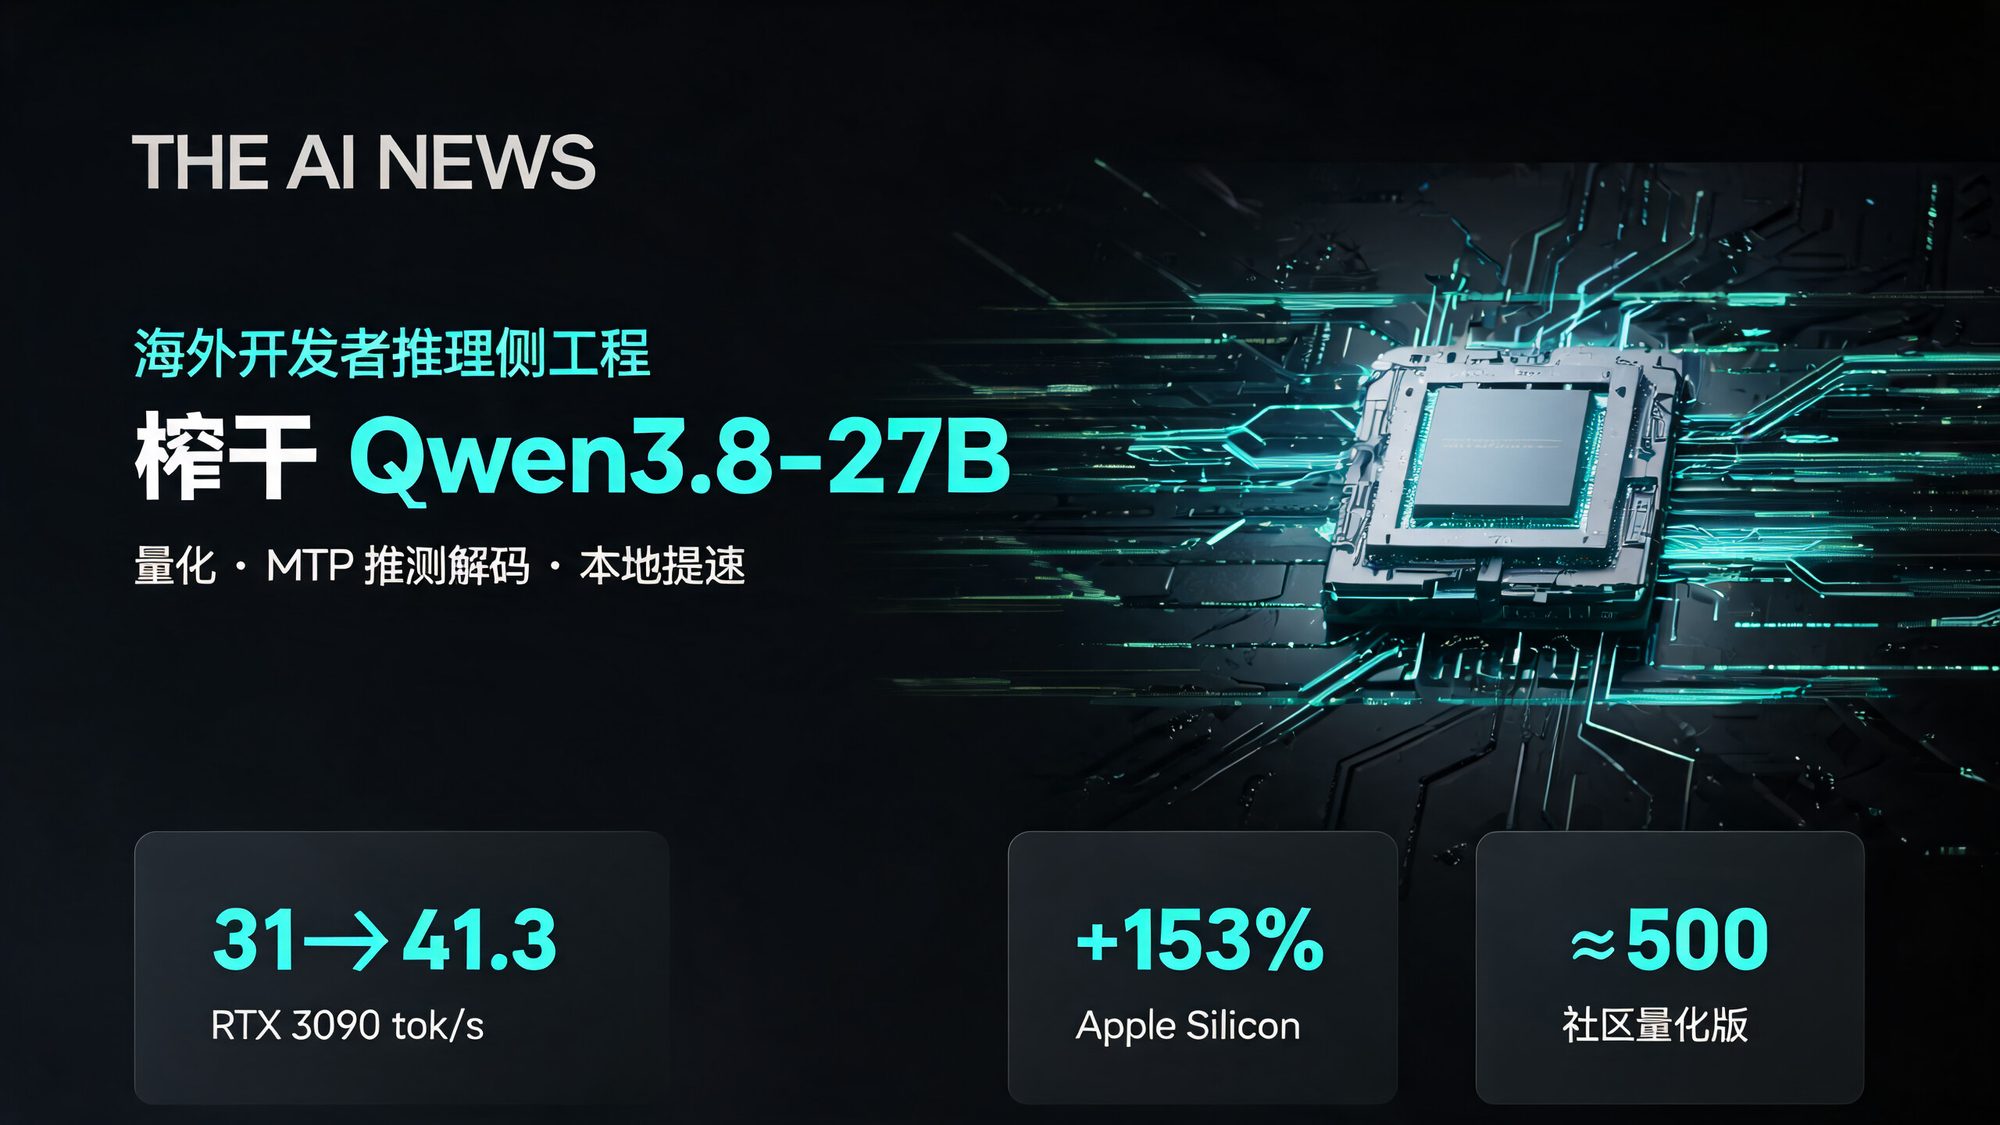
Qwen3.8-27B 开源不到 12 小时登上 Hugging Face 历史最受欢迎 TOP4,两天下载破百万。开发者围绕量化精度、推理配置与 MTP 推测解码展开优化:RTX 3090 解码从 31 提到 41.3 tokens/s,Apple Silicon 挑战 16 小时内提升 153%。
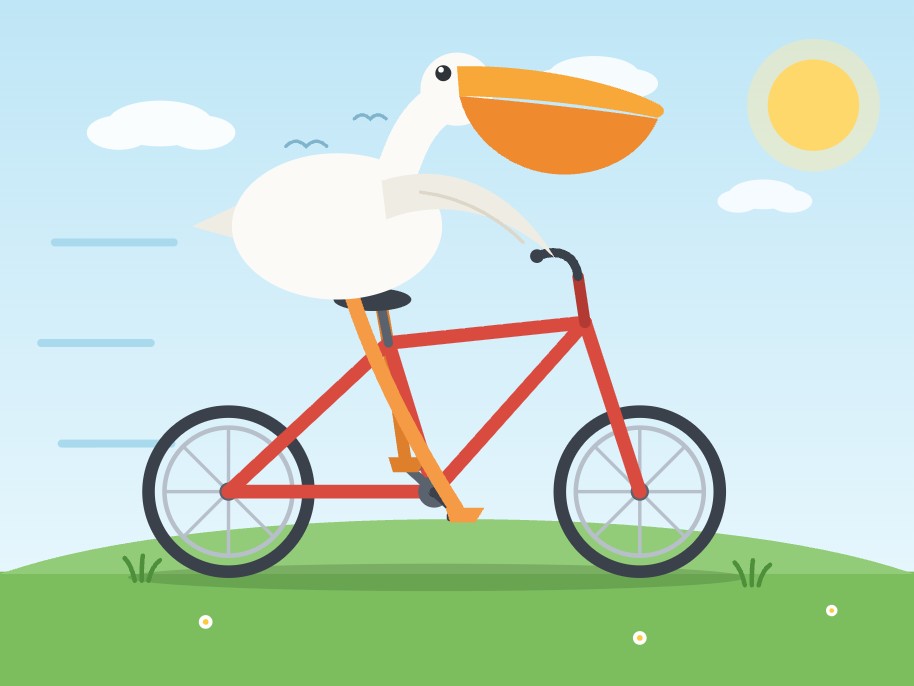
Simon Willison 实测 Qwen3.8-27B:17GB 量化模型可在笔记本本地运行,但默认 xhigh 推理档位常耗尽 8K 上下文,生成一幅鹈鹕骑自行车 SVG 竟思考了 21 分钟。
DeepSeek V4 Pro 0813 发布不到 24 小时被撤下:Hugging Face 配置一度与 Flash 相同,权重重传、API 指纹热切换,疑为发版流程事故。
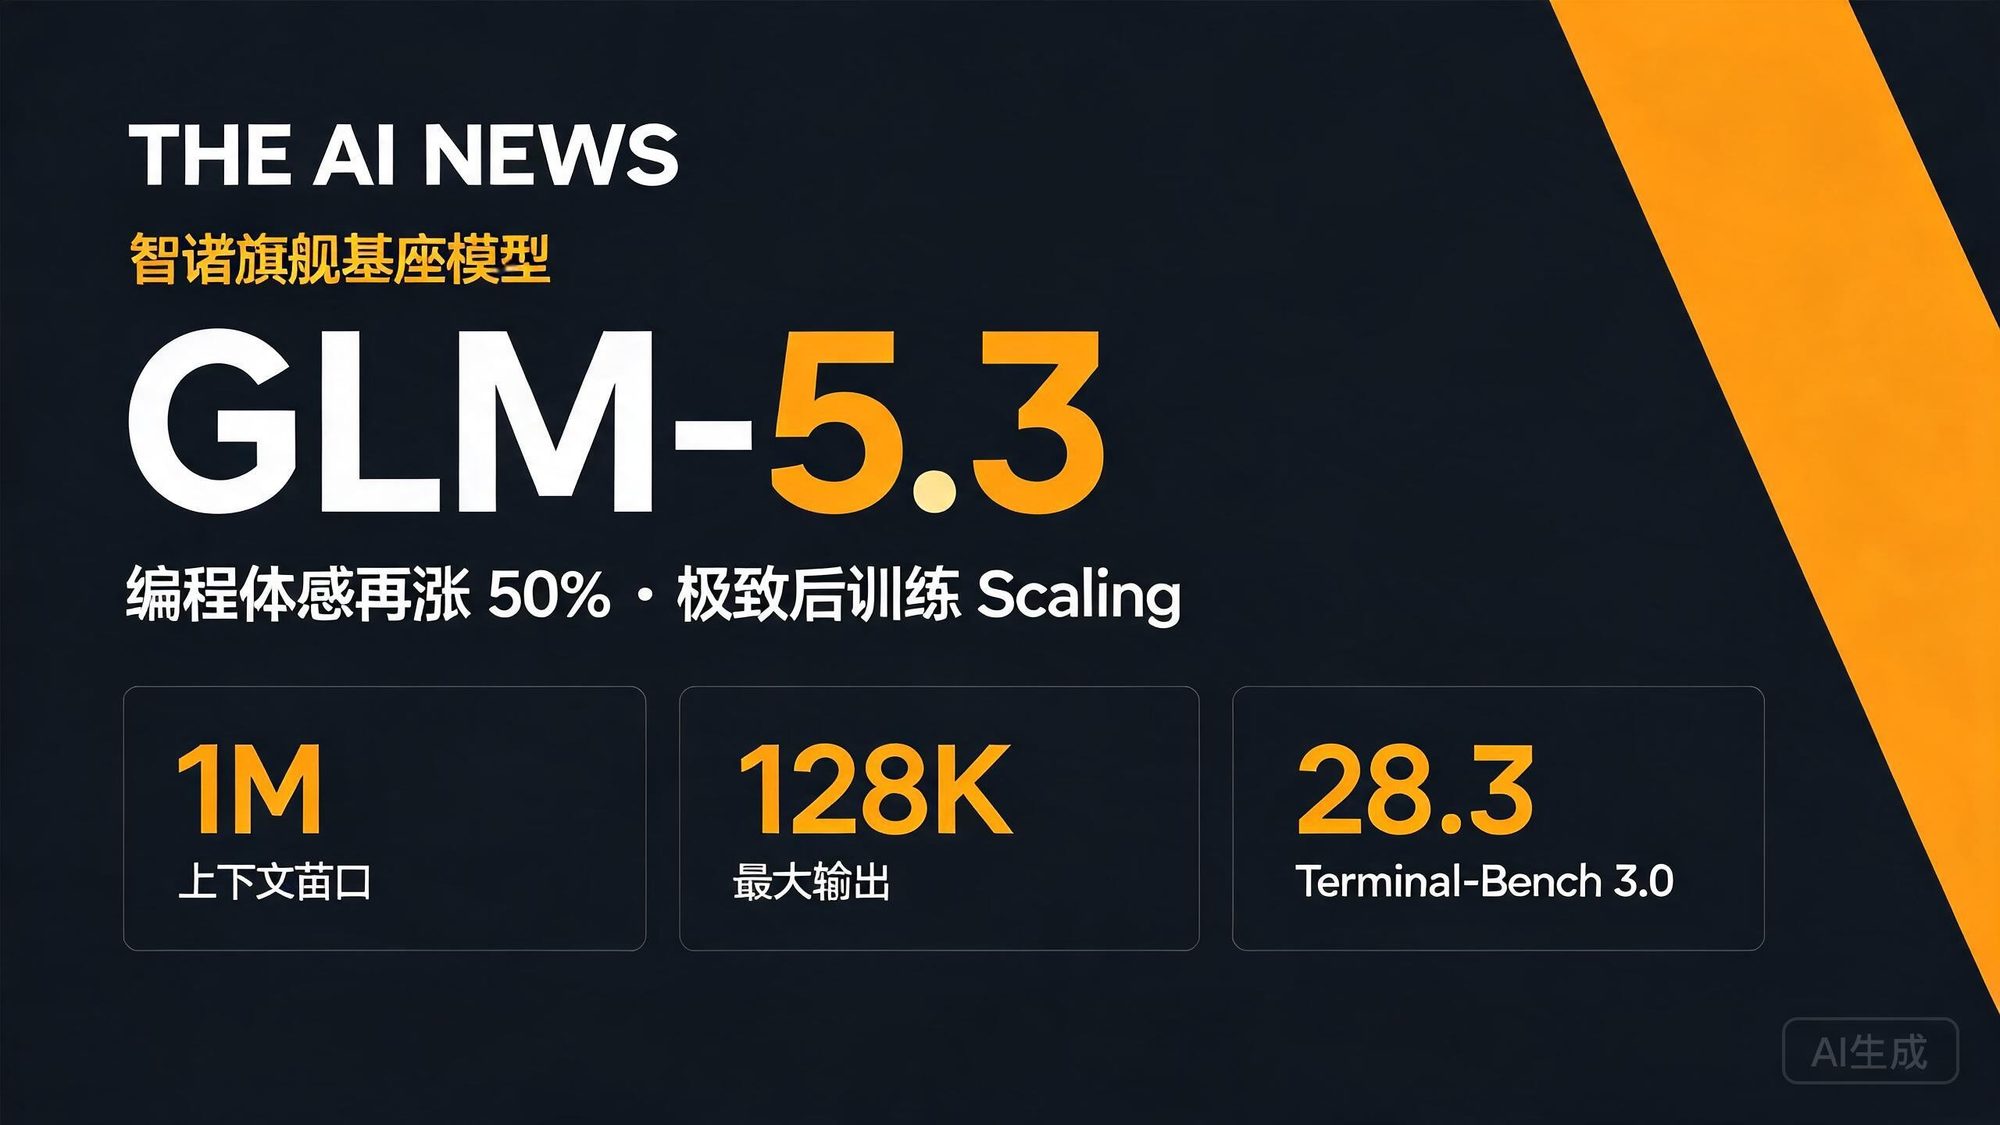
智谱发布旗舰基座模型 GLM-5.3:1M 上下文、128K 输出,后训练 Scaling 让编程体感提升 50%,Terminal-Bench 3.0 跃升至 28.3,API 即将上线。
MiniMax 开源 Music 3.0 音乐生成模型:给定创意与可选歌词,单次生成即可完成作曲、编曲、演奏与制作,输出最长五分钟的完整歌曲。
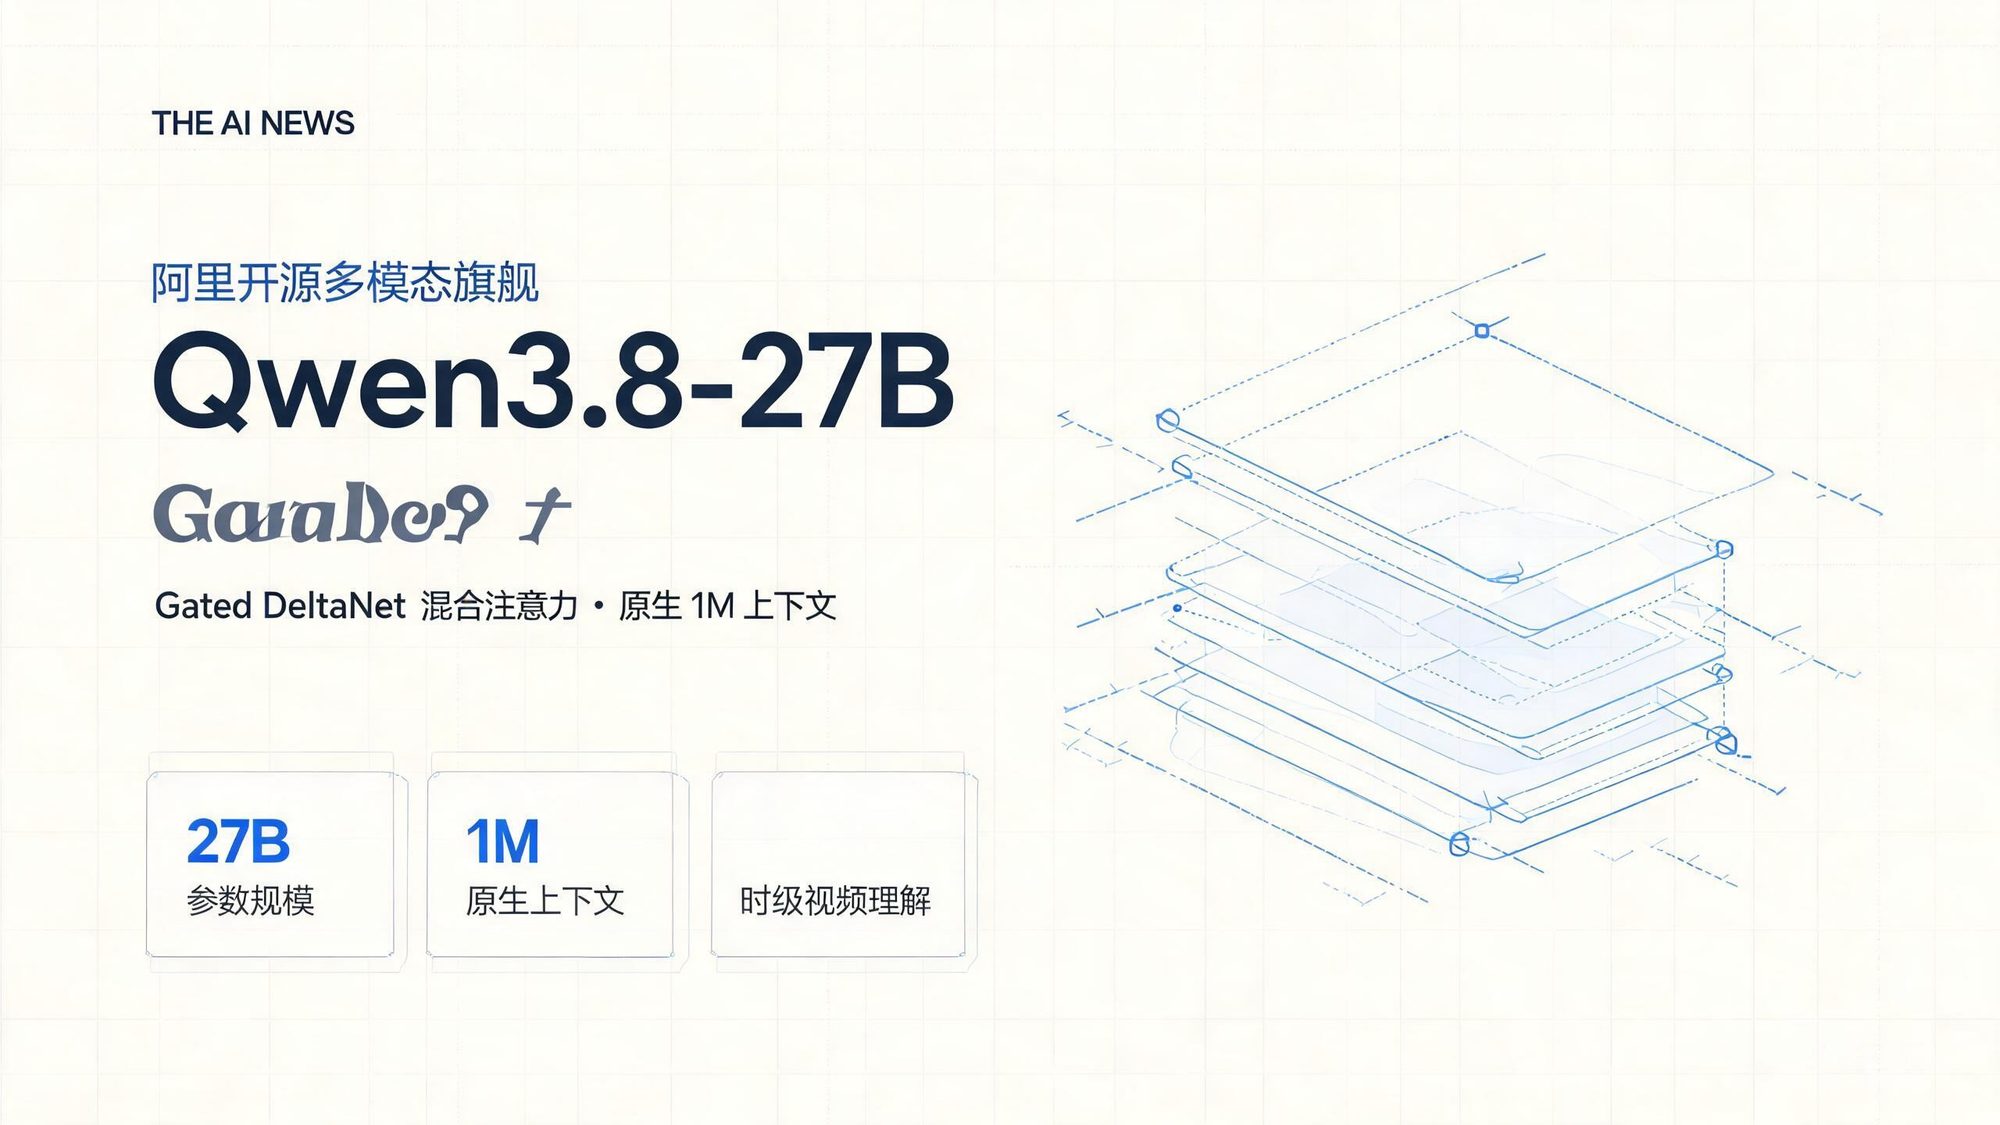
阿里开源 Qwen3.8-27B 多模态模型:Gated DeltaNet 线性注意力的混合架构、27B 参数、原生 262K 可扩至 1M 上下文,支持图像与小时级视频理解,Apache 2.0 协议。
英伟达开源 Nemotron 3.5 Lightning:30B MoE 仅激活 3B 参数,面向长时智能体高频执行,输出速度最高达同级 4 倍。
DeepSeek-V4-Flash-0731 的 Gilded Gnosis r16 镜像通过全部门禁:内置 DSpark K5 投机解码、InstantTensor 加载与可选原生 CPU KV 卸载。
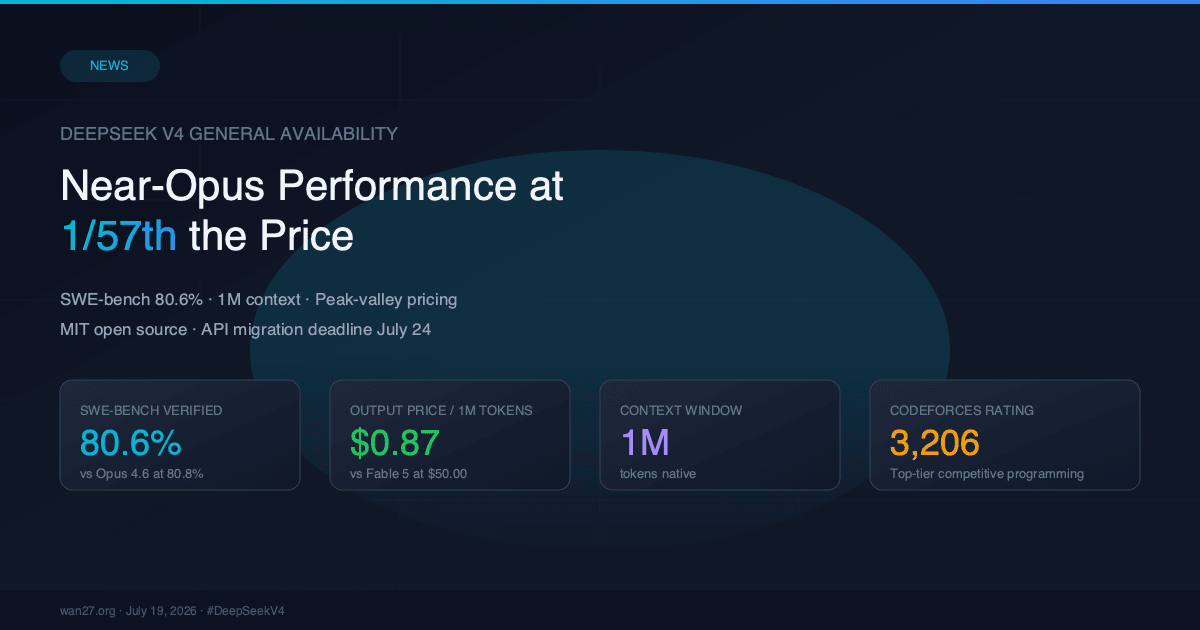
DeepSeek V4 GA 正式版上线:Pro/Flash 双版本、百万上下文与峰谷计费,SWE-bench 80.6% 逼近 Opus 4.8,附旧 API 迁移指南。
MiniMax 正式发布通用多模态生成模型 H3,可统一理解文本、图像、视频与音频,生成最高 2K 分辨率、15 秒的原生立体声视频,并计划开放权重。
OpenAI 首次确认下一代模型家族 Astra:内部版本解出十个十年未解的数学难题,Lean 形式化验证全部通过,算力成本约 2000 美元。
vLLM 宣布对 2.8 万亿参数的 MoE 模型 Kimi K3 提供 Day-0 支持,配合 DSpark 投机解码,单用户吞吐最高达 370 tok/s。