MiniMax 今日正式发布通用多模态生成模型 H3。H3 能够统一理解文本、图像、视频与音频构成的上下文,并生成最高 2K 分辨率、长达 15 秒、带原生立体声的视频。
早期测试显示,H3 已可用于广泛的商业内容创作场景,在指令遵循、文本与品牌元素精准渲染以及 V2V(视频到视频)动作迁移上表现出色。凭借精确可控的多模态生成与编辑能力,H3 面向广告、品牌营销、电商、产品设计、UI/UX、游戏等领域打造。
H3 依托 Contextual Omni Representation(上下文全模态表示)、H3-VAE、H3-Omni Transformer 与 In-Context Regeneration 等核心技术,实现了业界领先的性价比。H3 默认提供 2K 分辨率:在 2K 下,其每秒价格不到主流模型的三分之一;在 768p 下,价格不到主流模型 720p 的一半。
视频生成领域长期由闭源模型主导,迭代速度较慢,生态开放程度也不如大语言模型。为了支持开源社区、加速与更广泛 AI 硬件的兼容,并方便用户构建自己的定制版本,MiniMax 计划在未来几天内开放 H3 权重(须遵守适用的法律法规)。硬件兼容性从 H3 设计的最早期就被列为关键考量。
多模态上下文理解
真正的创意工作需要融合跨模态的复杂信息,把图像、音频、视频等作为输入来源。例如,下图的提示词是:“参考视频 1 中的希区柯克式运镜,让图像 2 中的角色演唱,人声与音频 3 匹配。“只需用文字描述上下文与目标视频之间的关系,H3 就能自行完成复杂的全模态理解。
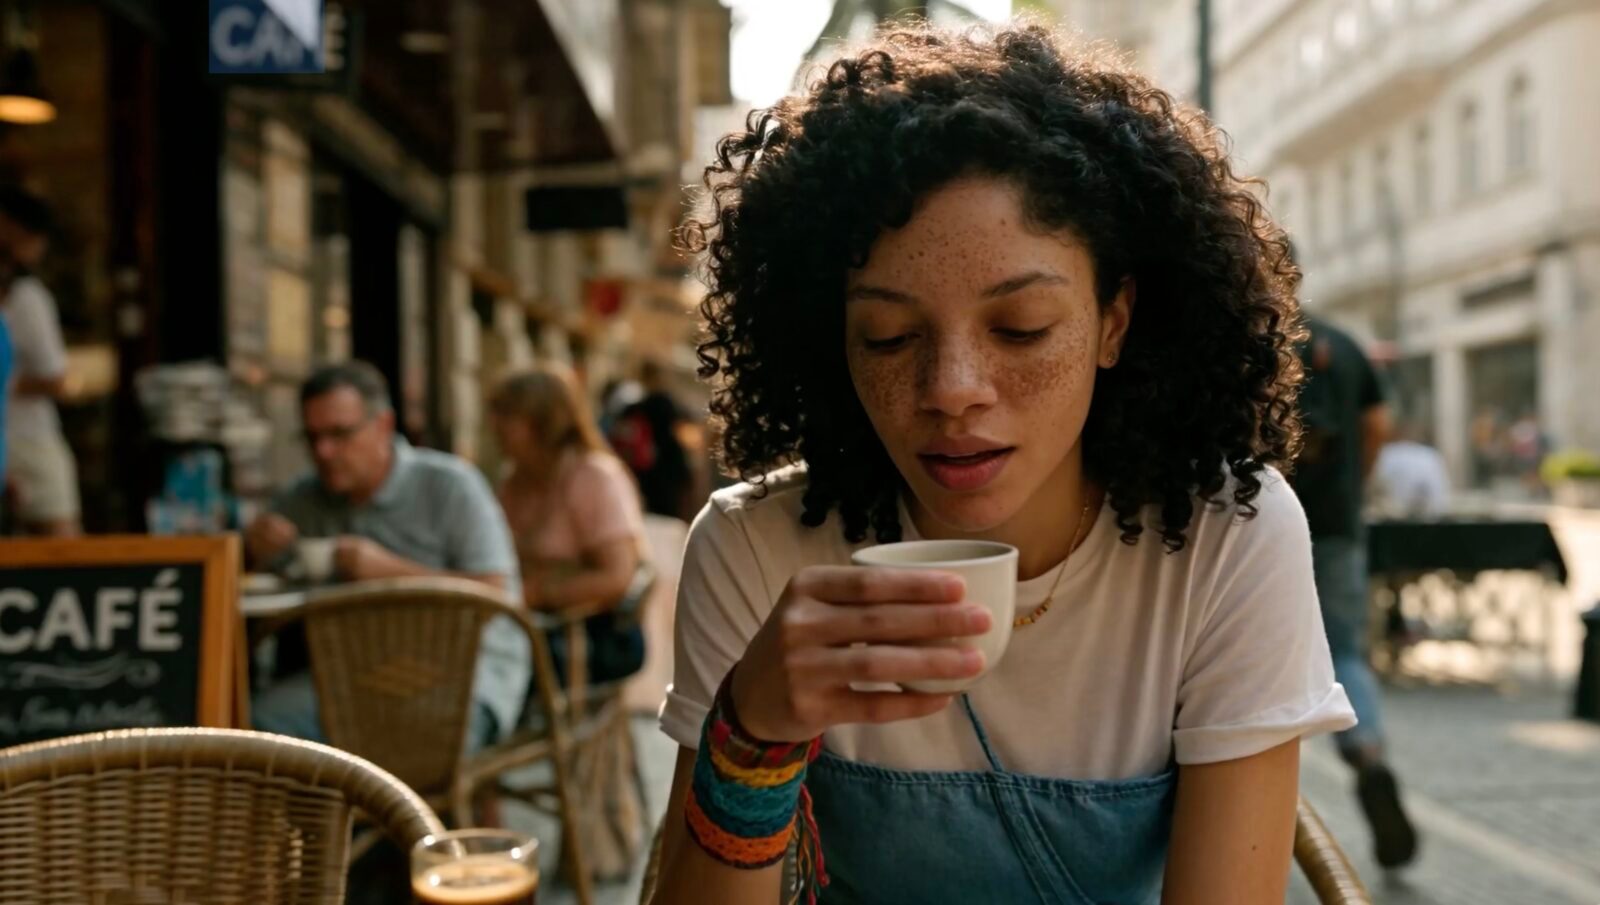
示例输入包括视频 1、图像 2、音频 3,H3 生成的输出视频支持 2K 画质与原生立体声。
H3 的典型用例
- 电影片头
- 产品网站
- 动态海报
- 广告与电商
设计理念:从专用走向通用
MiniMax 此前开发过两代模型:Hailuo 01 从零搭建了整个系统,Hailuo 02 则专注于改进核心组件,如架构效率、数据质量与规模。在设计 H3 时,团队意识到此前生成模型围绕任务边界的局限:图像生成通常按文生图、编辑、主体参考、动作参考、风格参考拆分为多个专家模型;音频生成中的语音、音效与音乐基本被当作独立领域;视频生成更是进一步碎片化为文生视频、图生视频、首尾帧、主体参考、动作参考、声音参考、视频编辑等任务,图像、视频与音频之间界限分明。
这些彼此割裂的任务、能力与模态在实践中限制了创作自由,在训练侧也限制了模型的泛化能力。两者都指向应用范式与训练范式的巨大变革空间。因此 H3 开发的首要原则,就是跨任务地统一与泛化。
基于这一原则,H3 的预训练范式概览如下:
- 数据与任务:文生图、文生视频;联合生成的音频全部为原生立体声;原生多镜头建模;文生音频;语音、音效与音乐不再分离,统一联合建模;广义参考与编辑,包括图生图、图生视频、音频生音频、音视频生音视频的参考与编辑
- “广义参考与编辑”的设计含义:完全基于真实自然数据构建,具备强大的数据扩展性;参考与编辑关系通过自然语言表达,而非局限于固定任务集——语言(更广泛地说是智能结构)是通往泛化的桥梁
- 架构:尽早融合多样化的数据类型与任务,正确的混合比例是关键
- 训练策略:在训练早期就融合多样化的数据类型与任务,正确的混合比例是关键
这些选择指向同一个目标:从预训练阶段起,就让 H3 具备广泛的多模态上下文理解与生成能力。
除了训练范式的转变,视频模型的应用格局也在变化:创作者开始直接用自然语言描述意图,而不是只输入简单的视觉提示。随着多模态理解、指令遵循与复杂任务执行能力的持续提升,视频模型将能把握更完整的创作意图,处理更复杂的内容需求,逐步从”生成一段片段”走向真正参与整个内容生产流程。
H3 的技术选择
H3 建立在简单的设计理念之上,但落地过程极为复杂。从 Hailuo 01、Hailuo 02 到 H3,每一代的构建复杂度都比上一代高一个数量级。以下是 H3 的核心技术:
H3-Contextual Omni Representation(上下文全模态表示)
H3 工程上最重要的工作之一是强化其描述(captioning)能力:
- 多模态上下文的引入大幅拓宽了”描述”需要覆盖的范围——不仅要描述目标视频本身,还要描述上下文与目标视频的关系,甚至上下文内部元素之间的关系
- 需要联合描述视频与音频,而跨多个镜头的音视频关系更加复杂
- 这本质上是一种上下文全模态表示:语言充当可泛化的桥梁与解释器,把”任务”统一为开放的描述形式,这也是 H3 强大指令遵循能力的根源
- 为此,团队构建了专用模型与全模态理解流水线:多数源素材需要约 10 万 token 的推理,蒸馏后平均压缩至约 4K token
H3-VAE:架构效率的大幅提升
H 系列一直在推进 tokenizer 技术。H3 彻底重构了此前的 tokenizer,在重建质量与可学习性上全面提升,为 H3 带来效率优势。其高压缩率使有效序列长度提升 4 倍,大幅降低了训练与推理成本,也是原生 2K 分辨率支持的关键技术。
H3-Omni Transformer:面向任务泛化设计的架构
秉持”架构服务于任务”的理念,通用性与效率是 H3 架构仅有的两个目标。值得注意的是,团队放弃了 Hailuo-02 架构——尽管它曾带来显著的架构优势——因为它会为以任务泛化为核心的模型引入不必要的复杂度。团队认为任务泛化是不可逆的趋势,架构技巧应当让位于模型本身的定义方式。
在 H3 中,多模态上下文的引入使序列长度方差增加了三倍,理解与生成的算力负载也变得高度异构。团队采用了将理解与生成负载分离的训练架构,分别为两者调优硬件利用率,同时联合平衡样本内异构计算与样本间负载均衡,端到端训练吞吐量提升了近 30%。
H3-In-context Regeneration(上下文内再生成)
对于 2K 输出,H3 没有使用传统的专用超分模块,而是让 H3 基座模型在上下文中自行再生成低分辨率输出。这带来两个优势:其一,再生成过程最大程度复用了基座模型已有的生成能力;其二,上下文内方式可以再次利用原始多模态上下文生成高分辨率输出,恢复传统超分只能”猜测”且往往无法还原的细节,如小字号文字与精细纹理。
MiniMax 表示,完整版 H3 技术报告将很快发布。
愿景与下一步
语言、图像、视频与音频是人类经验的基本模态,它们深度互联,是我们与世界交互的主要界面。它们共同构成能够高效传达海量信息的多模态上下文——而表达与分享信息的能力本身就是一种生产力。
对于多模态理解与生成,MiniMax 将语言视为一种可泛化、可扩展的计算系统,因此认为多模态智能应深深扎根于语言之中。
H3 仍有成长空间,未来版本的优先级如下:
- 强大的多模态理解是高质量生成的基础,仍有显著提升空间;下一代 H 系列计划整合 M 系列模型的能力
- H3 当前的模型规模在多项能力上仍有提升余地,规模化是明确的路径,更强的任务泛化将充分释放其潜力
- 某些场景下的视觉细节仍可改进,将继续向更高分辨率与更高视觉保真度推进
原文:MiniMax H3: An Open Model Breaking the Boundaries Between Tasks and Modalities(MiniMax Research,2026-07-31)


