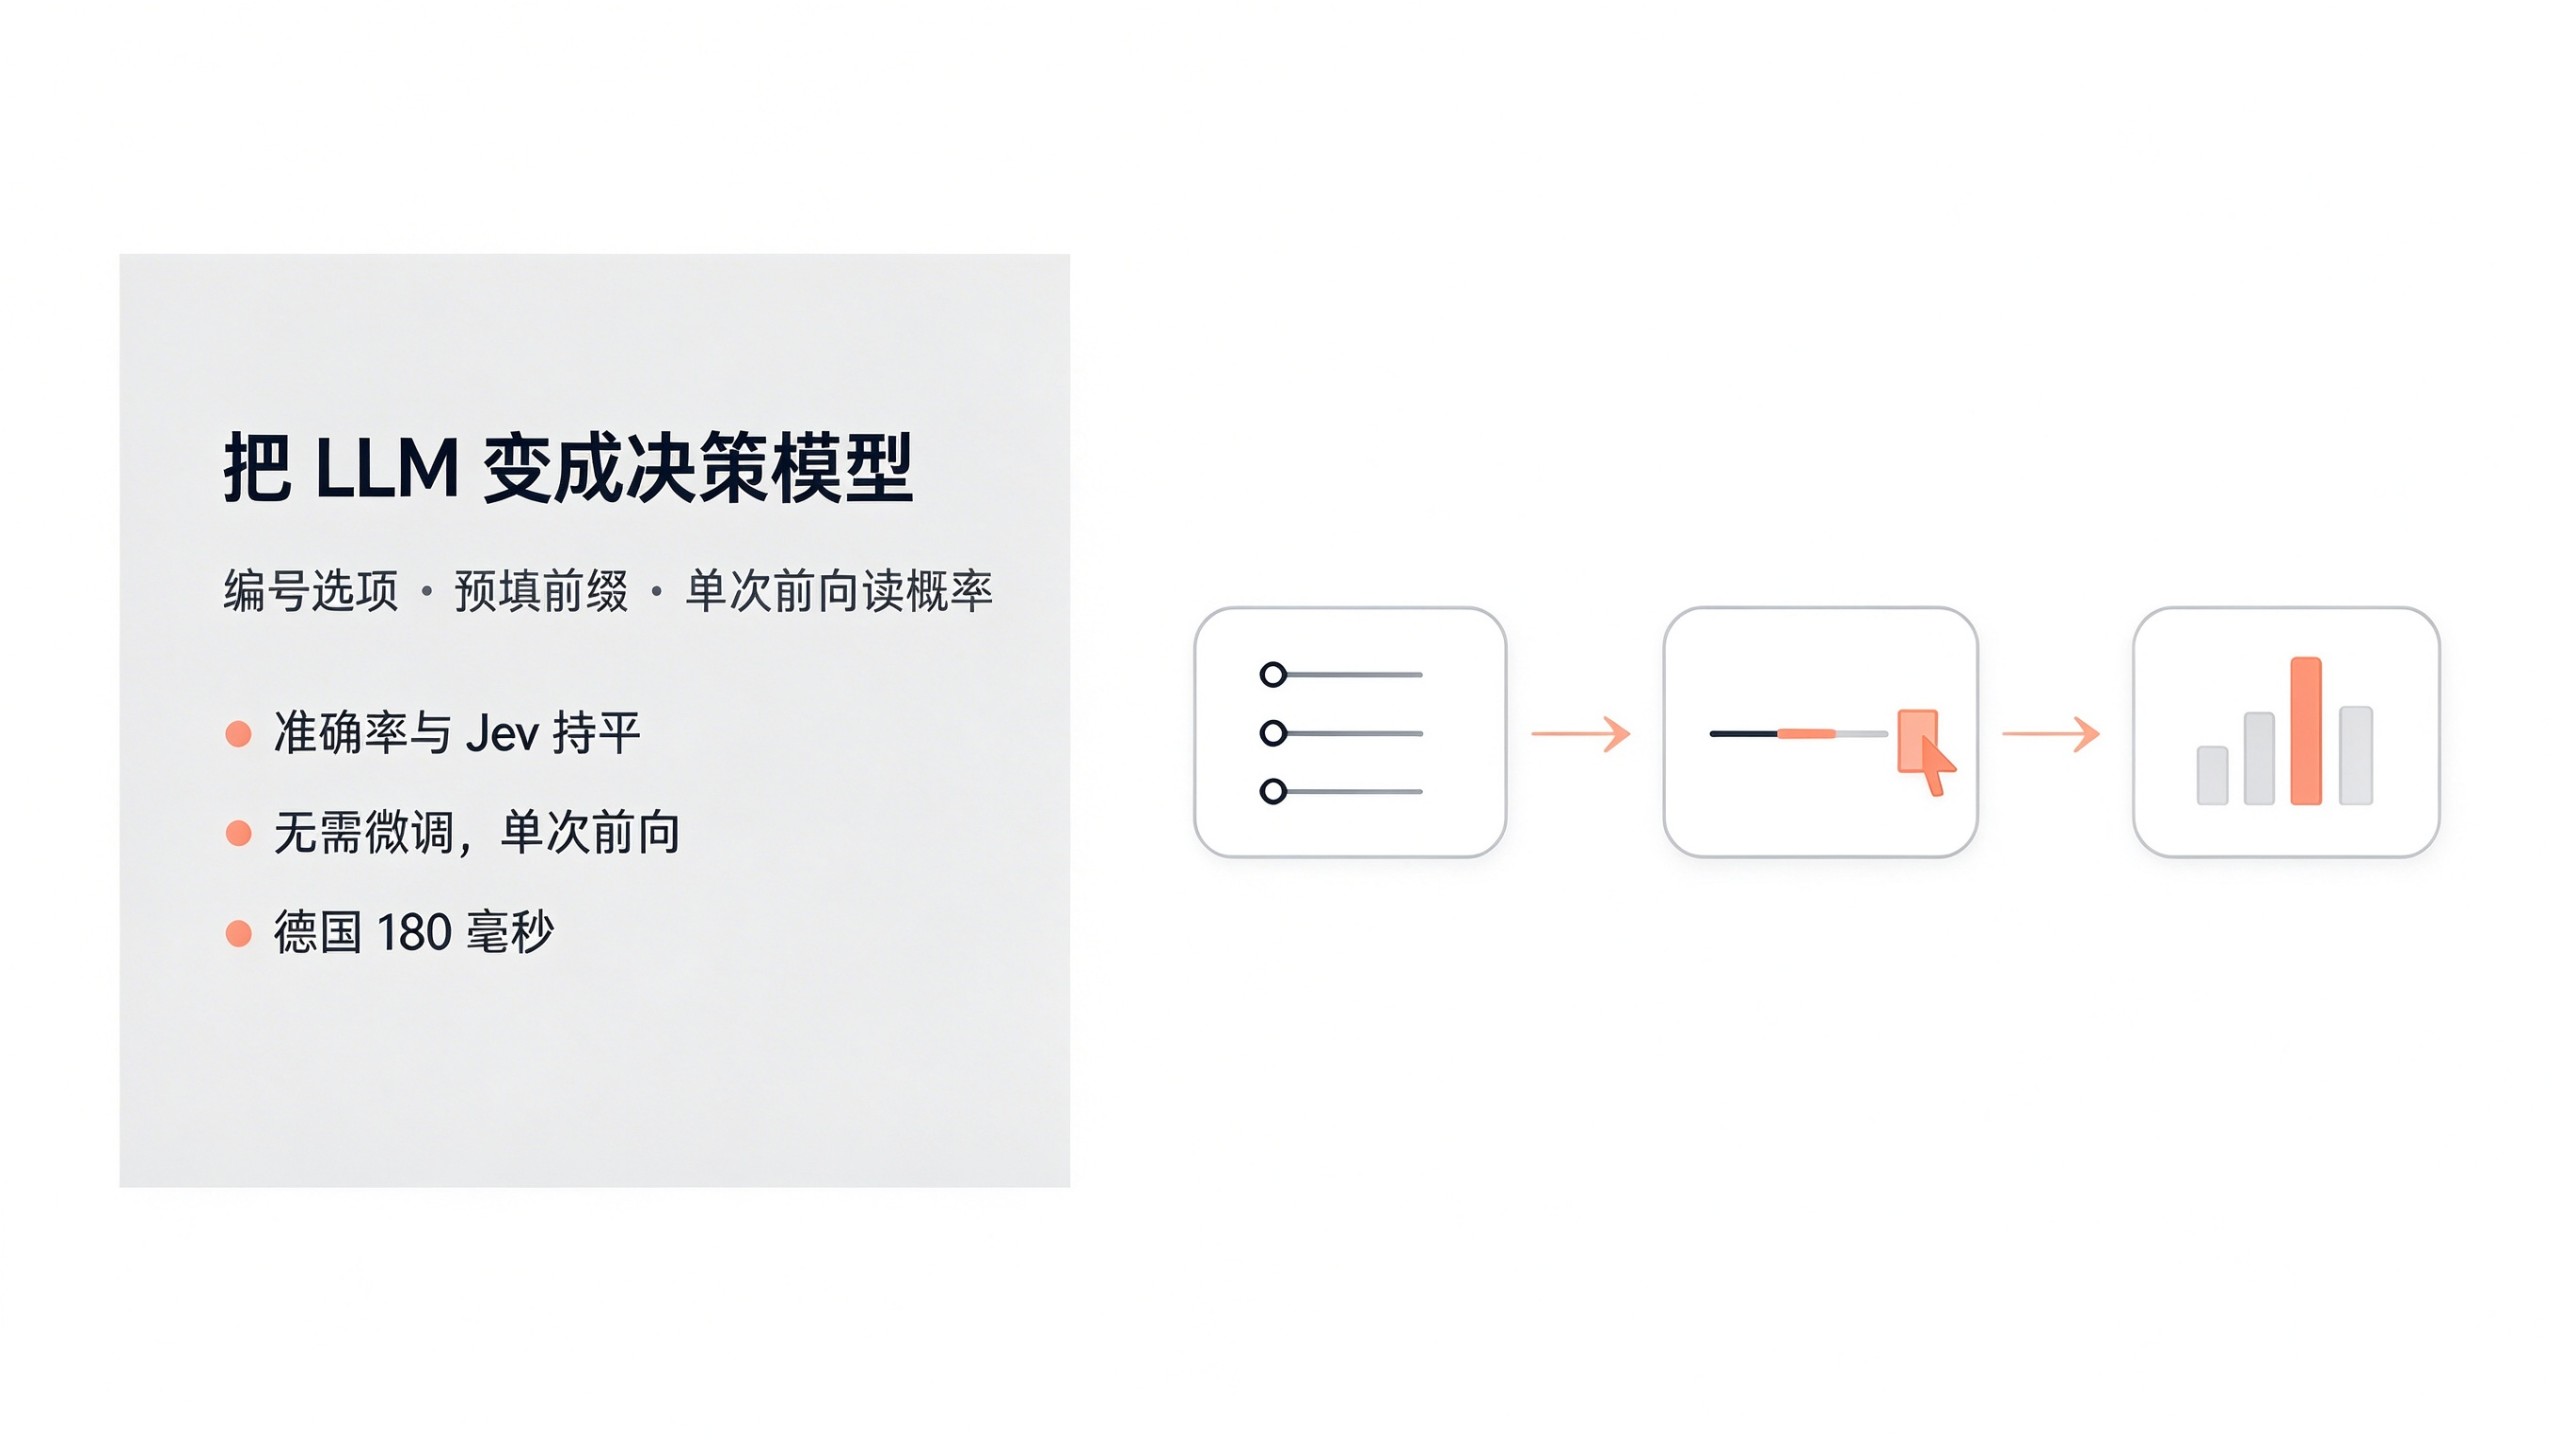
2026 年 9 月 24 日,Edgeless Systems 旗下机密计算推理服务 Privatemode 发布技术文章,展示了一种无需微调即可把通用大模型改造成「System One」决策模型的方法。作者 Johannes Hötter 与 Marko Rosenmüller 用 GLM-5.3-Flash 在自建基准上与 TypeSafe 的专用决策模型 Jev 对比,结论是两者在决策准确率上没有统计显著差异,而 GLM-5.3-Flash 这一侧还额外支持图像输入。
为什么需要「类型化决策」
软件向大模型提出的问题里,很大一部分本质是决策:这张工单该派给哪个团队?这段合同条款属于责任条款吗?这类请求通常要求模型输出符合固定格式、且落在预定义选项集合内。
大模型本身能做到,但常规做法代价很高:每次决策都要完整写出一个 JSON 对象,推理模型还可能先思考几百个 token;而且除非显式要求,调用方拿不到模型的置信度。在日均百万次的高吞吐场景里,这些开销会直接决定方案是否可行。Jev 与 Laya 这类专用决策模型正是为此设计:输入一段状态加一组命名选项,返回被选中的选项以及每个选项的概率。
三步把 LLM 变成决策模型
核心洞察是:既然输出结构已知,就不必让模型把整个 JSON 预测出来,只需要它对输入的类型化判断。
- 给选项编号:把状态、问题与选项以 JSON 形式放进提示词,每个选项带索引,并指示模型以
choice_index:加索引作答 - 预填答案前缀:提示词以
choice_index:结尾,于是模型产生的第一个 token 必然指向某个选项 - 读取输出分布:不采用模型实际吐出的 token,而是读取该位置上模型赋予各选项索引的概率,归一化后取最大者
实现上,作者用 vLLM 的 OpenAI 兼容接口,通过 allowed_token_ids 把词表掩码限制在选项索引上,再用 logprob_token_ids 取回对数概率,配合 continue_final_message、add_generation_prompt: false(以及 max_tokens: 1、temperature: 0)让模型「续写」这个已开始的回答。全程不做任何微调,用的是模型出厂状态。
基准测试:与 Jev 打平
评测覆盖 29 个公开标注数据集,选项数从 2 到 151,囊括意图路由、情感分析、主题分类、内容审核、蕴含判断、问答、法律文本与扫描文档,语料含英语与德语。三个系统接收完全相同的状态、同序选项名与同一指令。
在 28 个文本数据集上,GLM-5.3-Flash 与 Jev 各有 10 个数据集更准,其余 8 个差距在 1 个百分点以内;中位差距为 0.7 个百分点、略偏 Jev,但不具统计显著性(p = 0.64)。本地运行的 4.21 亿参数模型 Laya 明显落后,中位差距 13 至 15 个百分点(p < 0.001)。
作者也做了控制实验:在同一批数据集上允许 GLM-5.3-Flash 先推理再作答,各选项数区间准确率都更高(2 个选项时 89.9% 对 85.5%,21 至 80 个选项时 82.0% 对 79.2%),但每次决策要写数百个 token,成本从每百万次约 62 欧元涨到约 350 欧元。纯 Embedding 相似度的无模型基线则只有 45.9% 至 72.8%。
延迟与成本:取决于机房位置
计时在单请求、非并发条件下测量,避免把排队时间算进模型耗时。Privatemode 部署在欧盟、Jev 部署在美国,因此结论随访问位置翻转:从德国发起,Privatemode 中位 180 毫秒、Jev 264 毫秒;从美国发起,Jev 164 毫秒、Privatemode 299 毫秒。
成本上 Jev 更便宜:按各自列表价,每百万次决策约 16 欧元,而 GLM-5.3-Flash 约 62 欧元。差异主要来自输入 token 单价与打包方式——Jev 约固定多 270 个 token、每个选项再约 10 个;GLM-5.3-Flash 固定开销只约 55 个 token,但每个选项约 20 个,两者在约 21 个选项处成本交叉。
图像决策与能力边界
GLM-5.3-Flash 具备视觉能力,图像可以放进同一提示词,答案仍是带概率的单个 token;Jev 只处理文本、Laya 是文本编码器,都无法接收图像。在 1600 份、16 类扫描商业文档的 RVL-CDIP 上,GLM-5.3-Flash 取得 70.2% 的准确率,是三者中唯一能作答的系统——代价是每张图约增加 1350 个输入 token,每百万次文档决策约 270 欧元。
能力上限也已探明:Privatemode 的部署单次最多返回 128 个 logprob_token_ids,因此 151 个选项的 CLINC150 会被拆成两次相同请求拼接,准确率 87.5%(Jev 78.4%),但单次决策耗时 719 毫秒、Jev 为 249 毫秒。再往上,天花板是 GLM-5.3-Flash 能以单 token 表示的 191 个选项索引。
核心总结
- 方法:给选项编号、预填
choice_index:、只读一次前向传播的 logits,无需微调即可获得每个选项的校准概率 - 准确率:28 个文本数据集上与 Jev 中位差距 0.7 个百分点,统计上不显著;Laya 落后 13 至 15 个百分点
- 成本:每百万次决策约 62 欧元对 Jev 的 16 欧元,交叉点约在 21 个选项
- 延迟:德国 180 毫秒、美国 299 毫秒,快慢取决于服务部署位置与调用方距离
- 差异化:唯一支持图像决策的系统,RVL-CDIP 扫描文档准确率 70.2%,但每张图约多 1350 个输入 token
- 可复现:Python 库适配任意 vLLM 后端,基准仓库公开方法论、数据集规格、测试框架与全部原始运行结果
原文:Turn GLM-5.3-Flash into a Jev-like System One model(Privatemode / Edgeless Systems,2026-09-24)


