9 月 8 日,NVIDIA 开发者博客发布《Introducing CUDA Rust: Two Tracks for Writing GPU Kernels》,作者为 Sri Koundinyan、Melih Elibol 与 Jonathan Bentz。文章宣布 NVIDIA 正式投入 Rust 原生 GPU 编程,并给出两条并行路线:cuda-oxide 沿用 SIMT 线程模型,自研 rustc 代码生成后端把 Rust 函数直接编译成 PTX;cutile-rs 采用较新的 Tile 分块模型,在 stable Rust 上通过 CUDA Tile IR 即时编译。两者都不是对别处代码的包装,而是真正用 Rust 写内核本身。官方同时明确,CUDA C++ 与 CUDA Python 仍是成熟的企业级工具链,CUDA Rust 会持续投入并成熟到 2027 年及以后。
为什么是 Rust,为什么是现在
AI 的系统层——推理引擎、服务基础设施、驱动、agent 运行时——变化极快,而其中越来越多的部分正在改用 Rust:Rust 能在编译期拦下一整类 bug,同时不牺牲性能。NVIDIA 自身也是这股迁移的一部分,Nova Linux 驱动用 Rust 编写,NVIDIA Dynamo 建立在 Rust 内核之上,NVTX 也提供了 Rust 绑定。
唯一的例外是 GPU 内核。开发者可以从 Rust 启动内核,但内核主体往往还得用另一种语言写。CUDA Rust 要补的正是这一环:内核用 Rust 写,原生编译到 PTX,而不是包装别处的代码。
两条路线的区别
NVIDIA 把 Rust 的支持方式对齐 CUDA 本身已有的两种编程模型:
| 维度 | SIMT(cuda-oxide) | Tile(cutile-rs) |
|---|---|---|
| 编程抽象 | 描述单个线程做什么,然后启动成千上万个线程 | 描述一个数据分块(tile)做什么 |
| 线程与内存映射 | 由开发者自己管理 | 由编译器决定,源码不含架构相关选择 |
| 工具链要求 | 固定版本的 nightly 工具链 + 自备 LLVM | stable Rust 1.89+,无需自定义 LLVM |
| 其他依赖 | Linux、计算能力 8.0+、CUDA toolkit 12.x+、clang 及 libclang 头文件 | 计算能力 8.0+、CUDA 13.3、Linux |
| 成熟度 | 早期 alpha | 已发布到 crates.io,有外部项目在用 |
官方给出的选择建议很明确:优先用 Tile。因为编译器负责把分块映射到具体架构,源码不必编码架构相关的取舍;当你需要更精细的控制、想自己管理内存与线程时,再下沉到 SIMT。用哪种语言则取决于既有技术栈,而 NVIDIA 计划支持跨语言互操作,因此这个选择不会把开发者锁死在某一个生态里。
cuda-oxide:自研 rustc 代码生成后端
cuda-oxide 是一个自定义的 rustc 代码生成后端。它拦截编译过程,把标了 #[kernel] 的函数经由 Rust MIR、社区 IR 框架 Pliron 与 LLVM IR 一路降到 PTX,其余代码仍交给标准后端处理。Pliron 之上的 GPU dialect 由 NVIDIA 自己实现,这些 dialect 和所有变换在交给标准 LLVM 后端之前都保持用 Rust 编写。
安装与运行只需几条命令,模板就是一个完整的向量加法程序:
cargo +nightly-2026-04-03 install --git https://github.com/NVlabs/cuda-oxide.git cargo-oxide

cargo oxide new vecadd_demo
cd vecadd_demo
cargo oxide doctor   # 检查环境:GPU、CUDA toolkit、clang、nightly 工具链
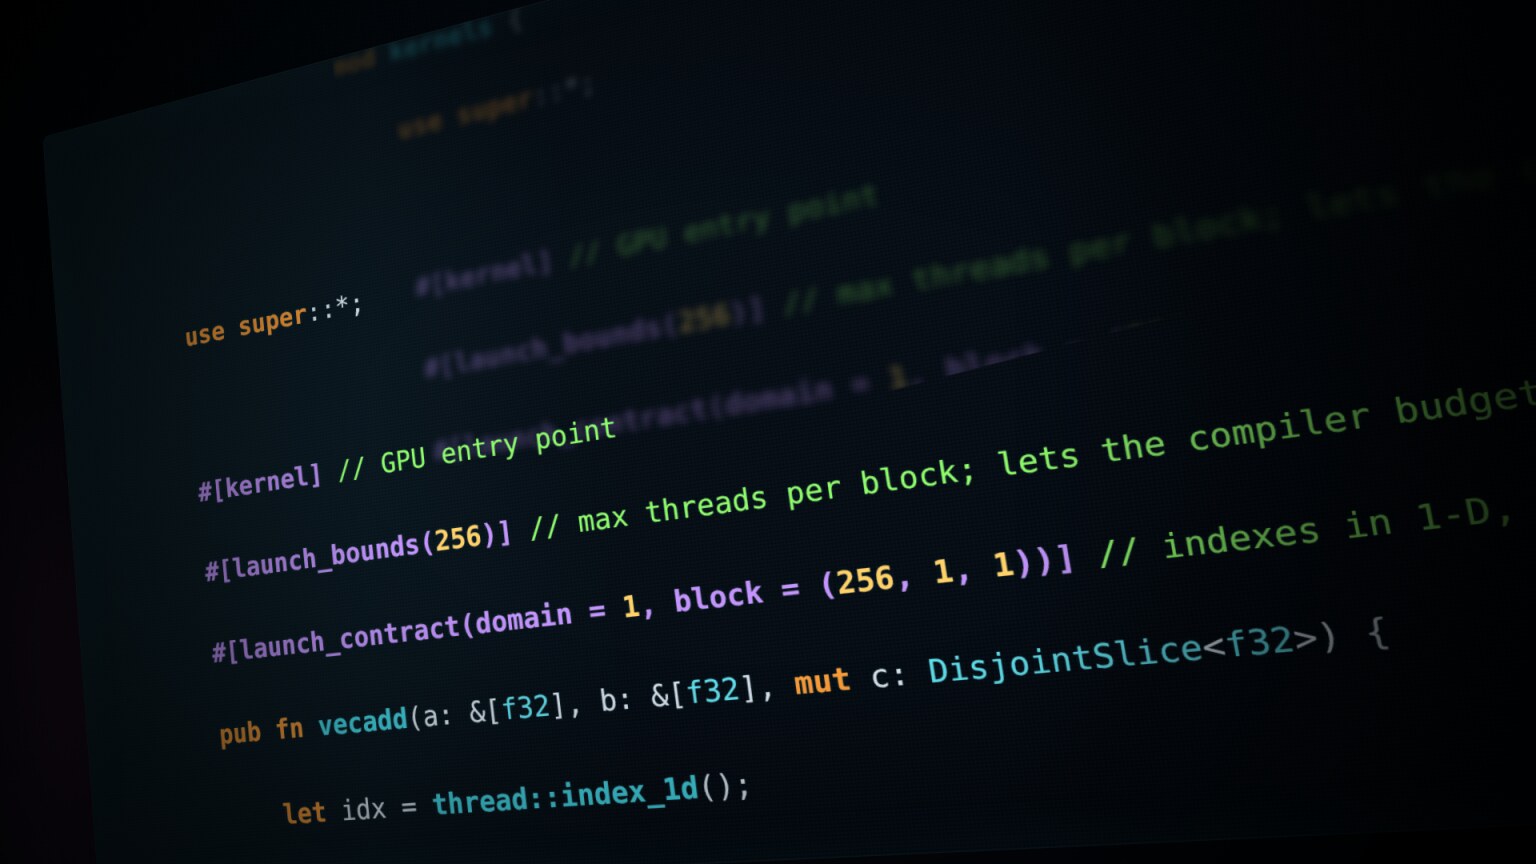
cargo oxide run # 首次运行会编译代码生成后端,耗时较长,之后走缓存内核签名承载了整套安全论证。a 和 b 是普通的共享切片,所有线程都可读;输出 c 则是 DisjointSlice<f32>,它把一次可变借用拆成每线程一块的独占访问权——因为 &mut [f32] 并不适合这个场景,所有线程都需要同一个 &mut,Rust 会正确地拒绝它。
#[kernel]                                            // GPU 入口
#[launch_bounds(256)]                                // 每块最大线程数,便于编译器分配寄存器
#[launch_contract(domain = 1, block = (256, 1, 1))]  // 一维索引,256 线程的块
pub fn vecadd(a: &[f32], b: &[f32], mut c: DisjointSlice<f32>) {
    let idx = thread::index_1d();
    let idx_raw = idx.get();                          // 取出普通 usize 用于读输入
    if let Some(c_elem) = c.get_mut(idx) {
        *c_elem = a[idx_raw] + b[idx_raw];
    }
}
thread::index_1d() 返回的是一个索引类型而非裸整数,c.get_mut(idx) 也只接受这种类型,返回的 Option 把越界变成需要显式处理的分支,而不是事后才发现的访存错误。启动同样是「被检查」而非「被信任」的:#[launch_contract] 声明该内核按一维索引、使用 256 线程的块,prepare_vecadd 会拿它对照实时设备限制做校验,并返回一个凭证,安全的 vecadd 方法必须拿到这个凭证才能启动。没有声明契约的内核只暴露原始的 unsafe 启动接口,因为一个裸的 LaunchConfig 说明不了它到底在启动什么。
cutile-rs:面向 Tile 的编程
cutile-rs 工作在高一层。你运算的对象是 tile 而不是标量:每个 tile block 以单个逻辑线程的身份,对一个子张量执行一次内核主体,实际由多少个 GPU 线程支撑由编译器决定。#[cutile::module] 宏把内核的 AST 嵌进宿主二进制,在首次真正需要该内核时经 CUDA Tile IR(NVIDIA 的分块级编译器 IR)即时编译。
它的依赖更轻,没有 nightly,也不需要自备 LLVM,cutile 已发布到 crates.io,直接加依赖即可:
cargo new vecadd_demo
cd vecadd_demo
cargo add cutile
同样的逐元素加法,用 tile 写出来是这样:
#[cutile::module]
mod kernel {
    use cutile::core::*;

    #[cutile::entry()]
    fn add<const B: i32>(
        z: &mut Tensor<f32, { [B] }>,  // 独占输出,一段 B 元素的子张量
        x: &Tensor<f32, { [-1] }>,     // 共享输入;-1 是动态维度,启动时确定
        y: &Tensor<f32, { [-1] }>,
    ) {
        // 该主体对每个可写子张量运行一次,身份是单个逻辑线程
        let tx = load_tile_like(x, z);  // 与 z 的这个子张量对齐的那一段 x
        let ty = load_tile_like(y, z);
        z.store(tx + ty);               // 整个 tile 上逐元素相加
    }
}

fn main() -> Result<(), Error> {
    let device = Device::new(0)?;
    let stream = device.new_stream()?;

    let x = api::ones::<f32>(&[1024]);   // 全部是惰性的,尚未触碰 GPU
    let y = api::ones::<f32>(&[1024]);
    // 分块同时做三件事:给每个 tile 独占的 128 元素、确定网格为 1024/128 = 8、提供 B
    let z = api::zeros::<f32>(&[1024]).partition([128]);

    let c: Vec<f32> = kernel::add(z, x, y)  // 接管三个张量的所有权
        .first()                            // ……完成后原样返还,取出输出
        .unpartition()                      // 丢掉宿主侧的分块包装,数据不移动
        .to_host_vec()                      // 记录回拷
        .sync_on(&stream)?;                 // 到这里才真正开始执行
    Ok(())
}
这里没有 DisjointSlice:宿主侧的 partition([128]) 只对可变张量必要,它给每个 tile block 一个其他 block 无法重叠的可写子张量,而这种独占性正是 &mut 本身已经保证的。分块还顺带确定了启动几何——1,024 除以 128 得 8 个 tile——网格由分块推导而来,不再另行计算再与内核索引核对;B 也从分块宽度读取,所以可变输出必须先分块才能传入。输入形状里的 -1 是哨兵值而非尺寸,该维度在启动时从张量读出,形状变化无需重新编译。直到 sync_on(&stream) 之前的一切都只是惰性描述,包括 ones、zeros、内核调用乃至回拷,整个程序是一条只有一个同步点的调用链。
编译器能抓住什么
两个内核都给内存做了同一个承诺:输入共享,输出独占。区别只在承诺的层级,以及是否需要为此专门造一个类型。
这很重要,因为成千上万个线程会以不保证顺序的方式访问同一批缓冲区。当两个线程命中同一地址且其中一个在写,结果取决于顺序。这类 bug 极少能稳定复现,往往能通过测试,却在生产环境中失败。
把 SIMT 内核的输出缓冲区同时当作它自己的输入,无论该内核是否真的会竞争,都无法通过编译:
module.vecadd(&stream, &prepared, &c_dev, &b_dev, &mut c_dev)?;
// error[E0502]: cannot borrow `c_dev` as mutable
//                  because it is also borrowed as immutable
Tile 侧同样的别名冲突同样编译不过:
let z = api::zeros::<f32>(&[1024]);
kernel::add(z.partition([128]), z, y)
// error[E0382]: use of moved value: `z`
两个例子都在编译期抓住了经典的别名错误,只是划线位置不同:cuda-oxide 在每次启动调用处检查,cutile-rs 的所有权则跨越启动边界跟随张量,属于更强的承诺。Tile 路线里没有共享内存,也没有线程索引可以弄错,因为这两者都由编译器掌管——一个 tile block 就是一个逻辑线程,根本不存在可竞争的线程。这既是它「天然安全」的原因,也是代价所在。SIMT 保留了那份控制权,而今天其中的共享内存路径仍需 unsafe;共享内存是高性能 SIMT 内核的基石,让这条路径安全是正在进行的工作。
现状与生态
两个项目都处于早期阶段,均未达到生产可用:cuda-oxide 是早期 alpha;cutile-rs 进度更靠前,已发布到 crates.io,并在 NVIDIA 之外被用于 HuggingFace 的 Grout 推理引擎与 mistral.rs。覆盖尚不完整,API 还会变动,官方表示欢迎反馈遇到的问题。
文章坦言,Cargo 与 crates 让开发者对「上手很容易」抱有期待,而 GPU 编程历来相反,缩短这段距离正是工作的一部分。SIMT 路线目前仍需固定版本的 nightly 工具链,官方称这正是他们最想取消的一类要求。
Rust 写 GPU 并不新鲜,这个领域有不少早于 NVIDIA 且仍在并行推进的优秀工作。cuda-oxide 手册里的生态附录标注了它相对 Rust-GPU、rust-cuda、CubeCL 等项目的位置,NVIDIA 也在两个项目成熟过程中与 rust-cuda 维护者保持合作。官方还提到一篇论文《Fearless Concurrency on the GPU》,作者之一 Melih Elibol 也将在 9 月 8 日至 11 日于蒙特利尔举行的 RustConf 2026 上就此演讲。真正新的是 NVIDIA 投入的工程力量,以及一个明确的走向:官方计划支持 CUDA Rust、CUDA C++ 与 CUDA Python 之间的跨语言互操作。
核心总结
- 两条路线:cuda-oxide 走 SIMT,自研 rustc 代码生成后端经 MIR、Pliron IR、LLVM 直达 PTX;cutile-rs 走 Tile,在 stable Rust 上经 CUDA Tile IR 即时编译
- 选型建议:优先 Tile,让编译器决定分块到架构的映射;需要精细控制线程与内存时再下沉到 SIMT
- 安全边界:cuda-oxide 用
DisjointSlice与启动契约逐次检查;cutile-rs 用分块与所有权保证跨启动边界的独占访问 - 门槛差异:SIMT 需要 pinned nightly 工具链与 LLVM,Tile 只需 stable Rust 1.89+ 与 CUDA 13.3
- 成熟度:cuda-oxide 为早期 alpha,cutile-rs 已在 crates.io 发布并被 Grout、mistral.rs 采用,两者都还不适合生产
- 后续计划:支持 CUDA Rust、C++、Python 之间的互操作,避免前端选择锁定生态
原文:Introducing CUDA Rust: Two Tracks for Writing GPU Kernels(NVIDIA Technical Blog,2026-09-08)


