转载说明:本文转载自 Qwen 官方博客《Qwen-Image-2.1:小模强效,创改一体》(Qwen Team,2026 年 9 月 20 日,原文共 1724 词)。文中配图、视频与结论均来自原文,版权归原作者所有,本站仅作中文技术社区传播,原文链接与开源地址见文末。
我们很高兴地开源 Qwen-Image-2.1,千问图像系列当前兼顾生成效果、推理效率与使用成本的开源图像模型。Qwen-Image-2.1 将文生图与图像编辑整合在同一模型中,视觉生成部分仅有 7B 参数,并原生支持透明图像的生成与编辑。
本次更新的主要特色包括四个方面:
- 小模强效,极致价比:轻量的模型结构与推理优化,在生成质量和计算成本之间取得平衡。
- 原生透明,创改一体:根据提示词生成普通图像或透明图像,并支持透明图层编辑与抠图。
- 全能编辑,多局保全:支持最多 10 张参考图,增强局部编辑、人像与商品保真,并覆盖多种编辑任务。
- 真实质感,字雅人美:提升文字排版、人物光影与细节表现,让生成结果更具美感。
小模强效,极致价比
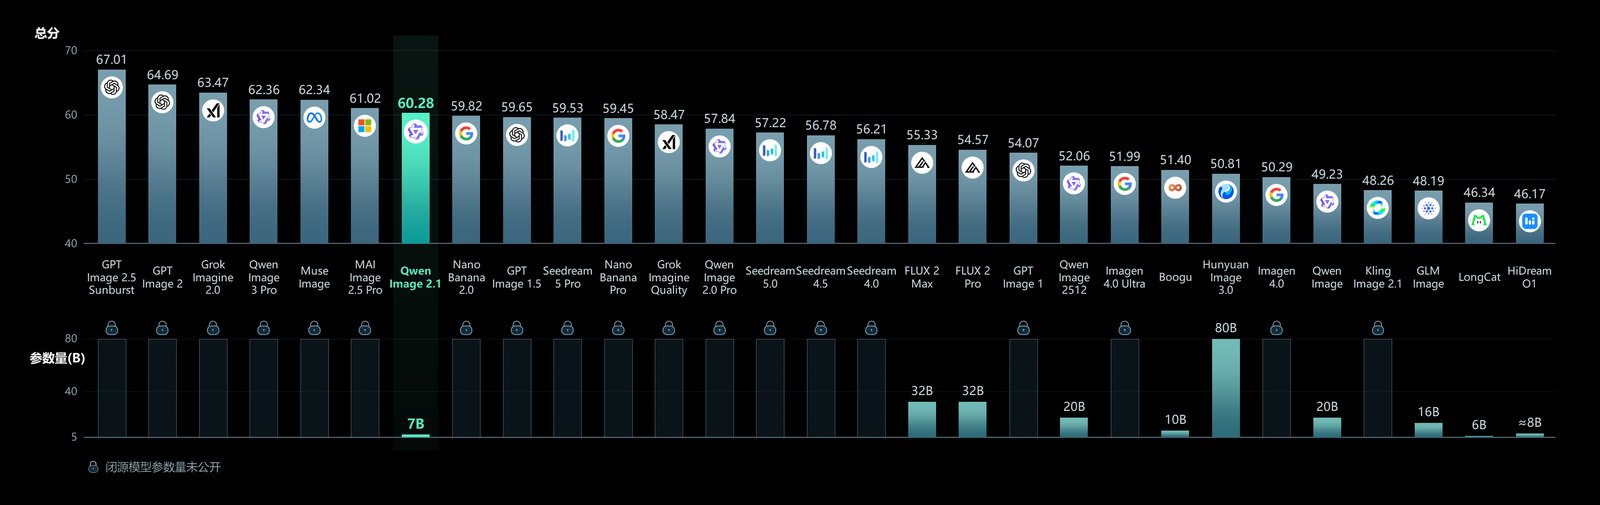
Qwen-Image-2.1 采用轻量简洁的模型结构,视觉生成部分包含 32 层 Single-Stream DiT,参数量为 7B。在较小的模型规模下,Qwen-Image-2.1 依然具备出色的图像生成能力。下方的 Qwen-Image-Bench 公开评测对比展示了它与其他开源、闭源模型的表现。
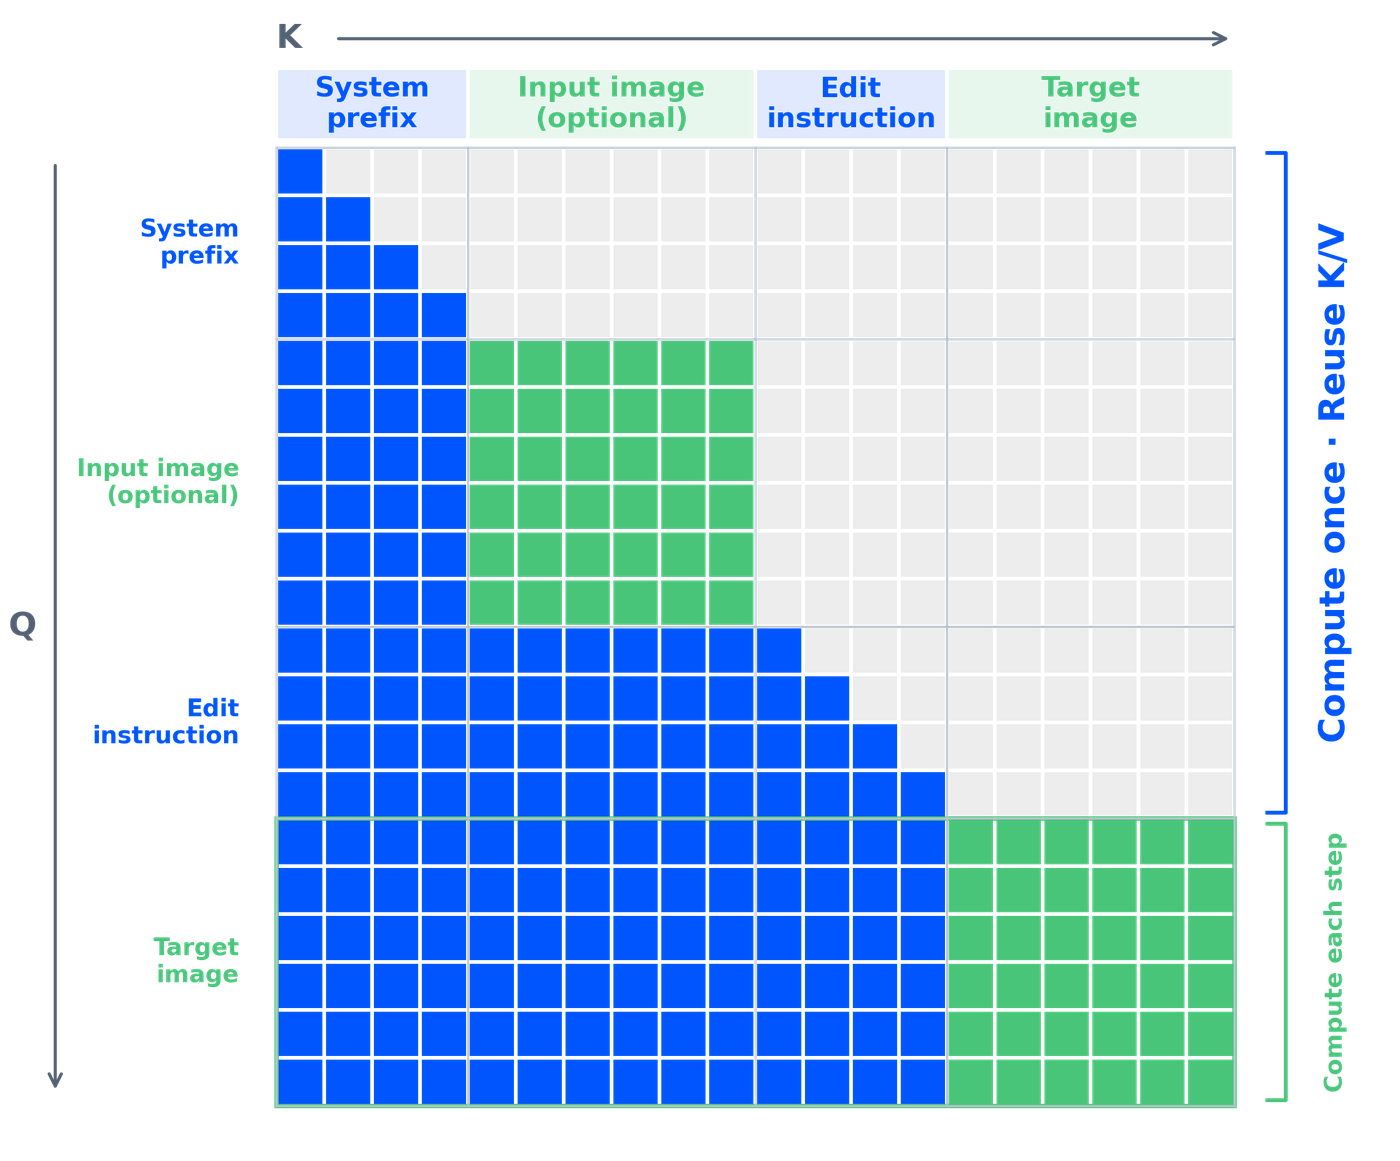
除了生成效果,Qwen-Image-2.1 也着重优化了推理效率,优势在多图输入场景中尤其明显。这一优化来自混合粒度注意力结构。模型对文本和图像采用不同的处理策略:文本部分,包括系统前缀和编辑指令,采用 Token 级因果掩码;图像生成部分采用 Chunk 级掩码。同时,通过 KV Cache 复用机制,模型将输入图像与编辑指令作为静态上下文,在首步预计算并缓存,以提升推理效率、降低显存开销。
原生透明,创改一体
透明图像是本次更新的一项重要能力。我们曾于 2025 年 12 月发布 Qwen-Image-Layered,专门支持透明图像生成。现在,Qwen-Image-2.1 将这项能力整合进统一模型,能够根据提示词描述,自动决定输出普通图像还是带有透明通道的图像。
下面是通过文本直接生成透明图像的示例:
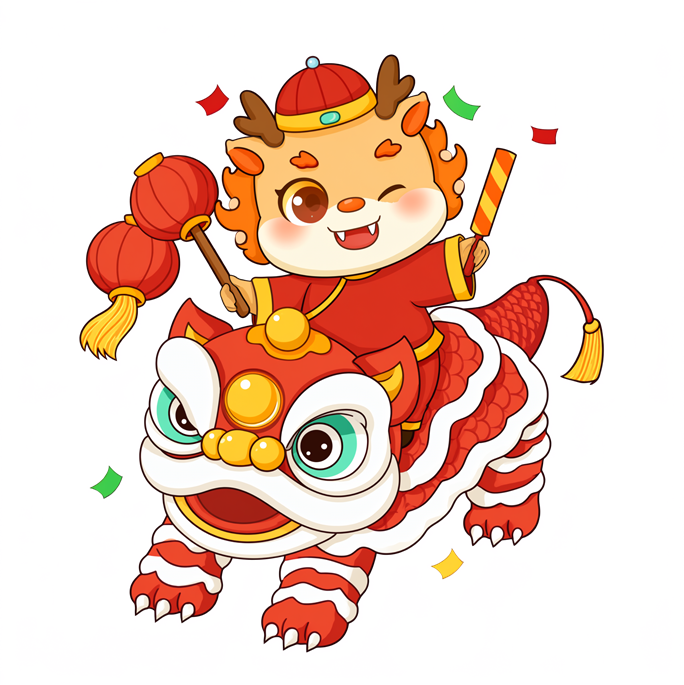
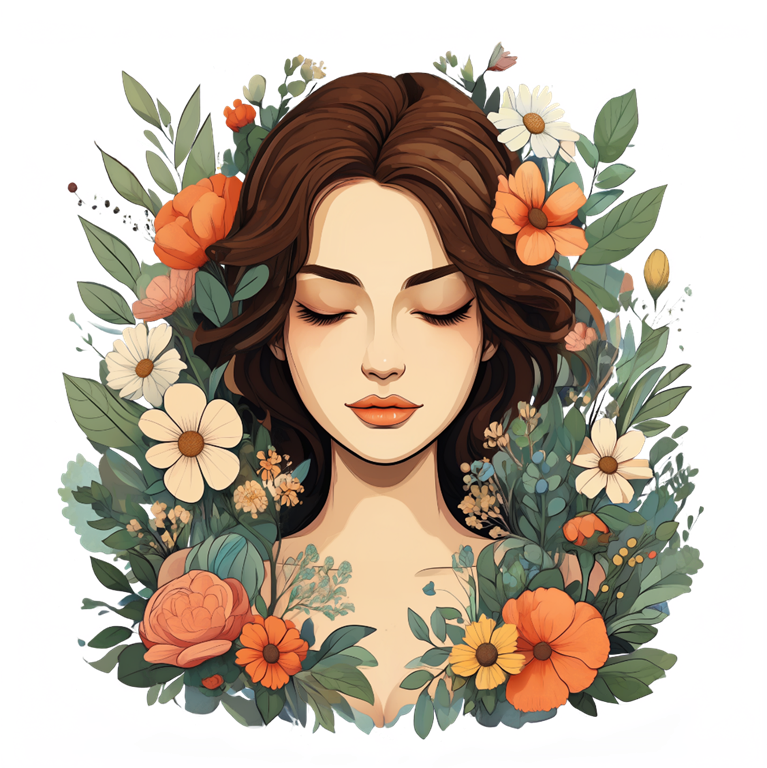
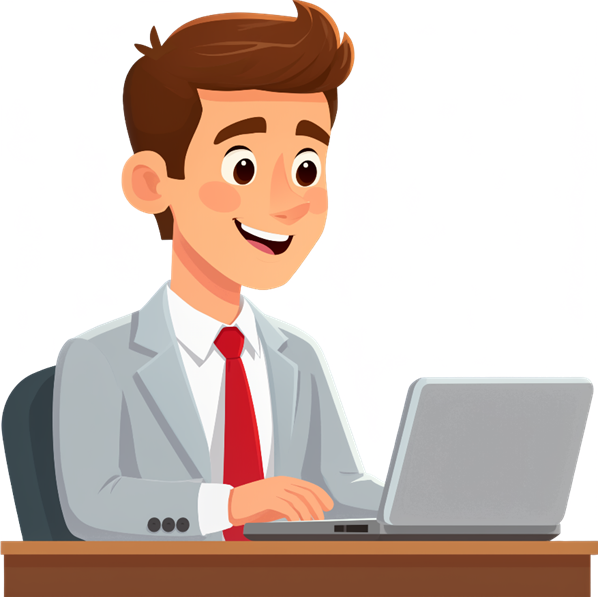
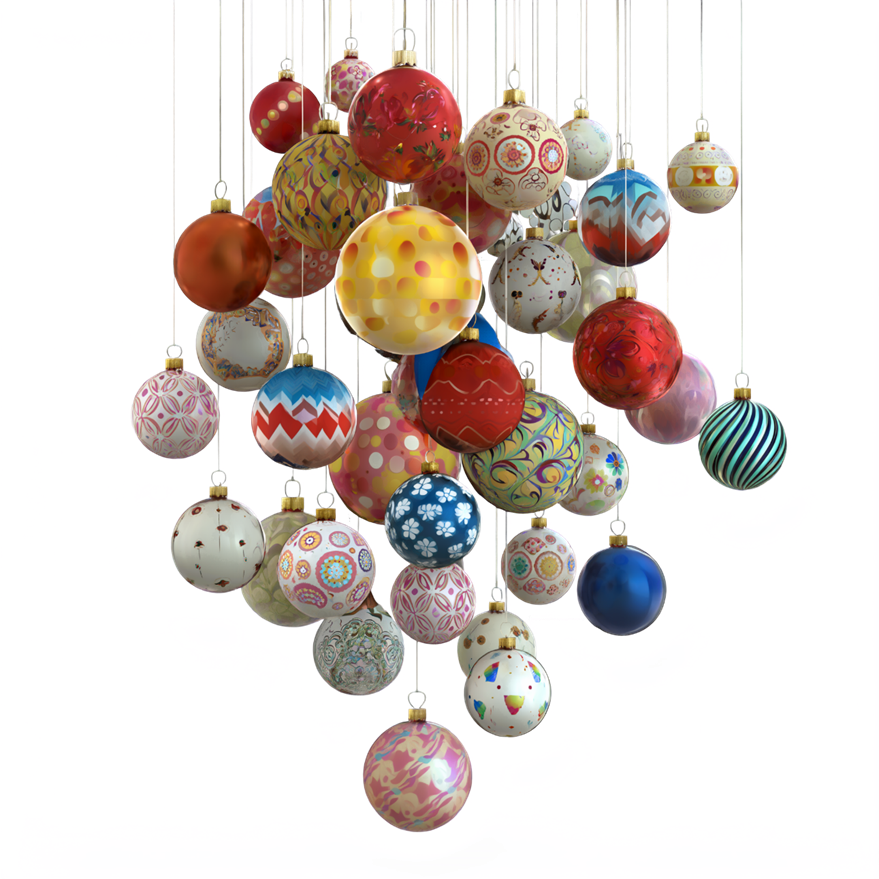
除了单个主体,模型还可以生成由多种元素组成、结构更复杂的透明图像,为设计与素材制作提供更多选择。
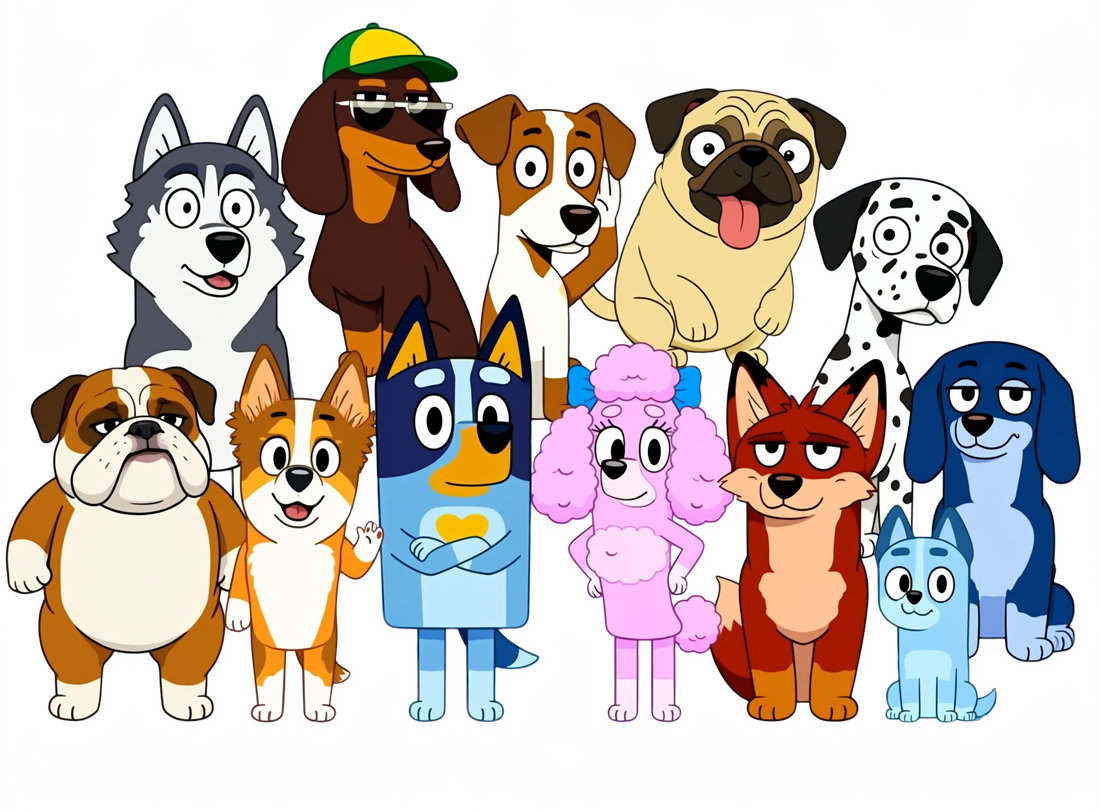
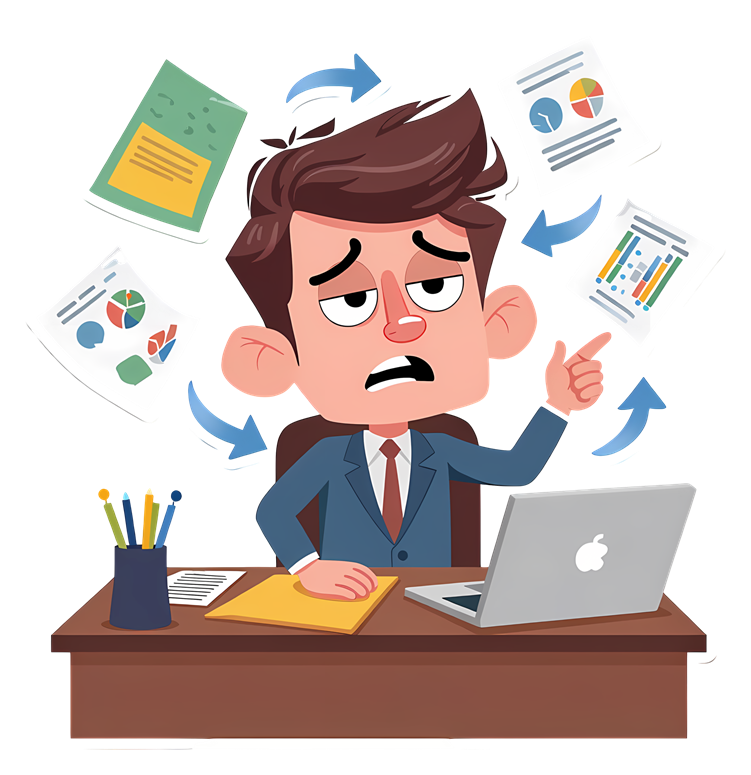
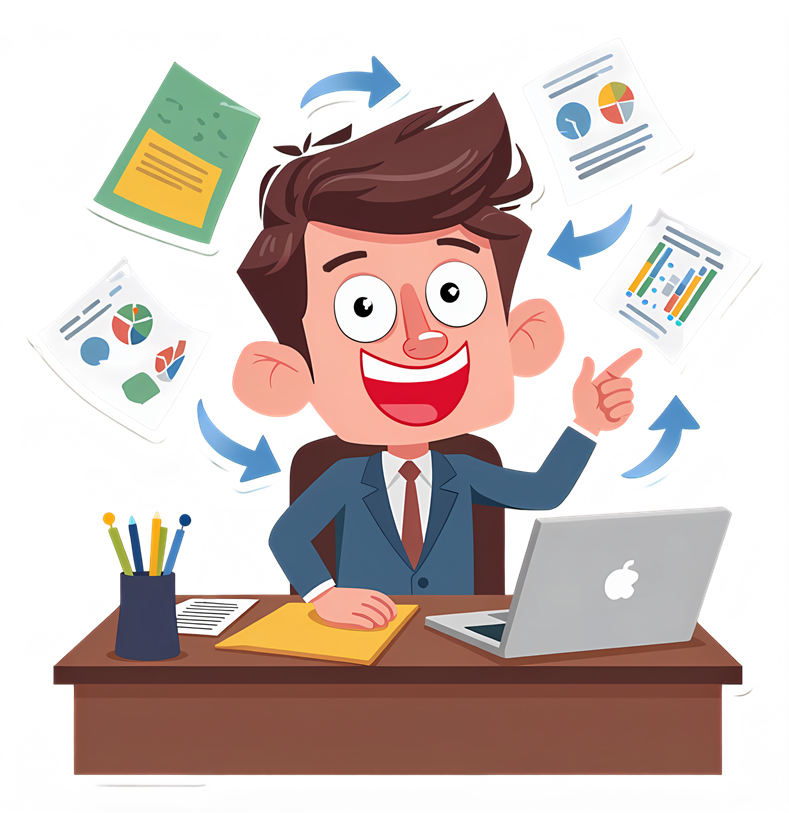
作为文生图与图像编辑二合一的模型,Qwen-Image-2.1 也支持直接编辑透明图像。例如,可以在保留透明背景的同时修改主体表情。下方左侧为输入,右侧为编辑结果。
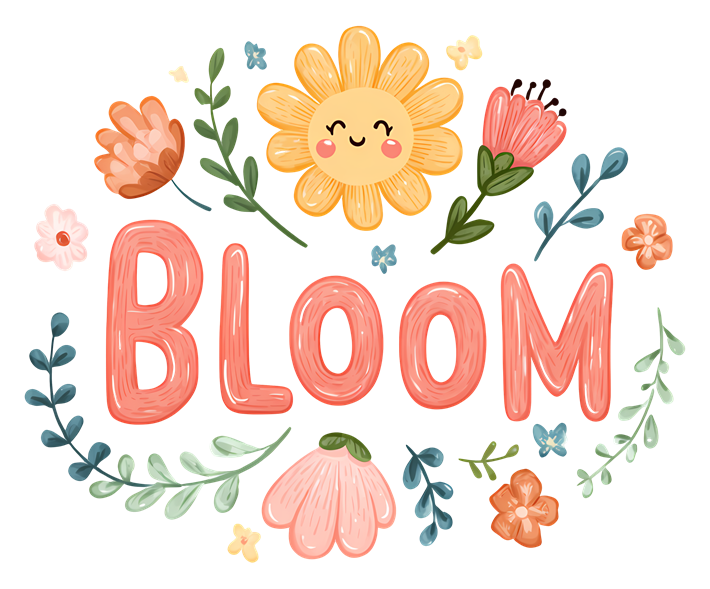
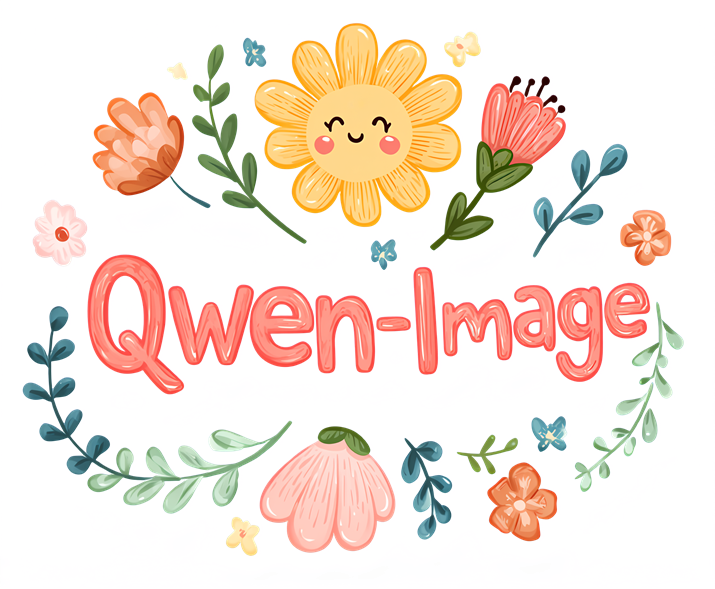
透明图层中的文字同样可以编辑。下面的示例将「BLOOM」修改为「Qwen-Image」。
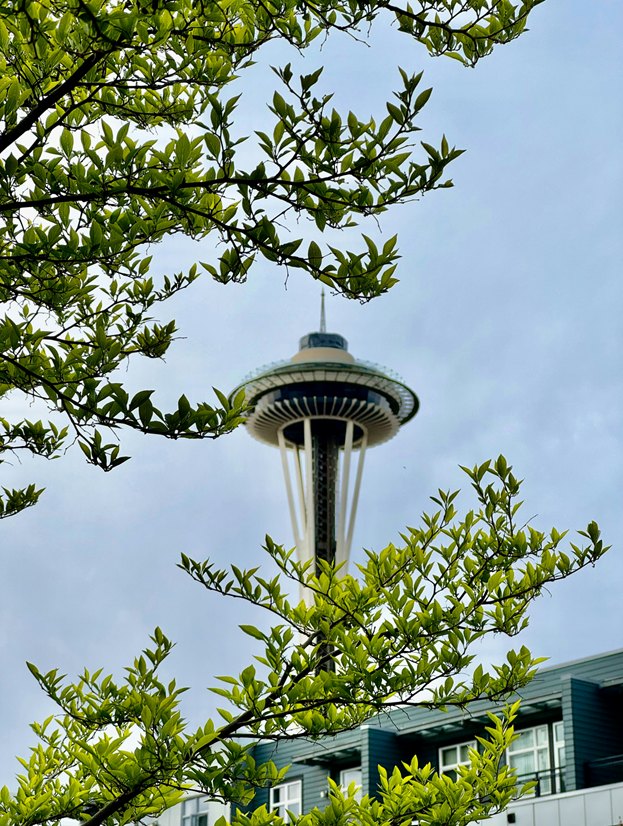
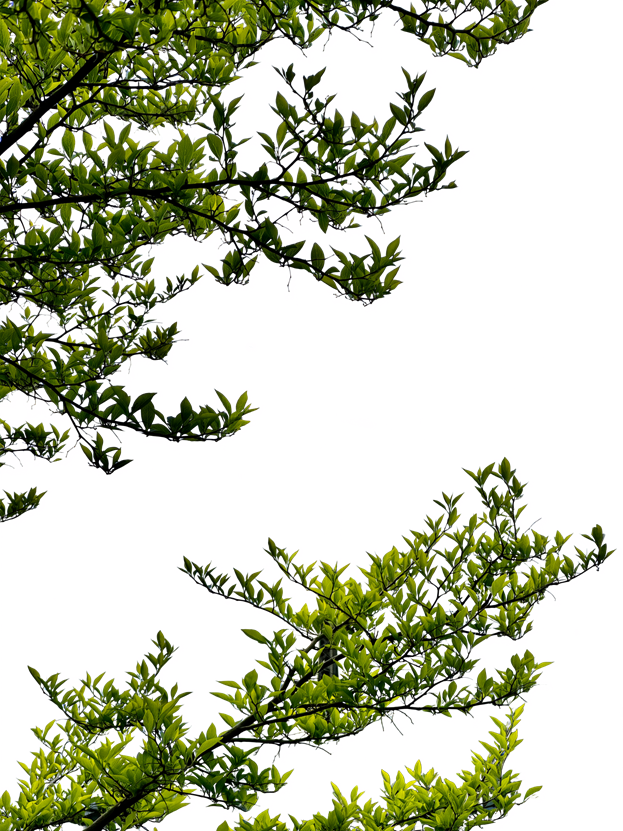
这项能力也适用于真实照片。输入一张 RGB 图像,模型可以提取所需主体,输出带透明通道的 RGBA 图层,让照片中的元素更方便地用于后续设计与合成。
全能编辑,多局保全
Qwen-Image-2.1 的图像编辑能力围绕「多」「局」「保」「全」四个方向提升,分别对应多图编辑、局部编辑、编辑保真与任务全面。
多:最多 10 张参考图
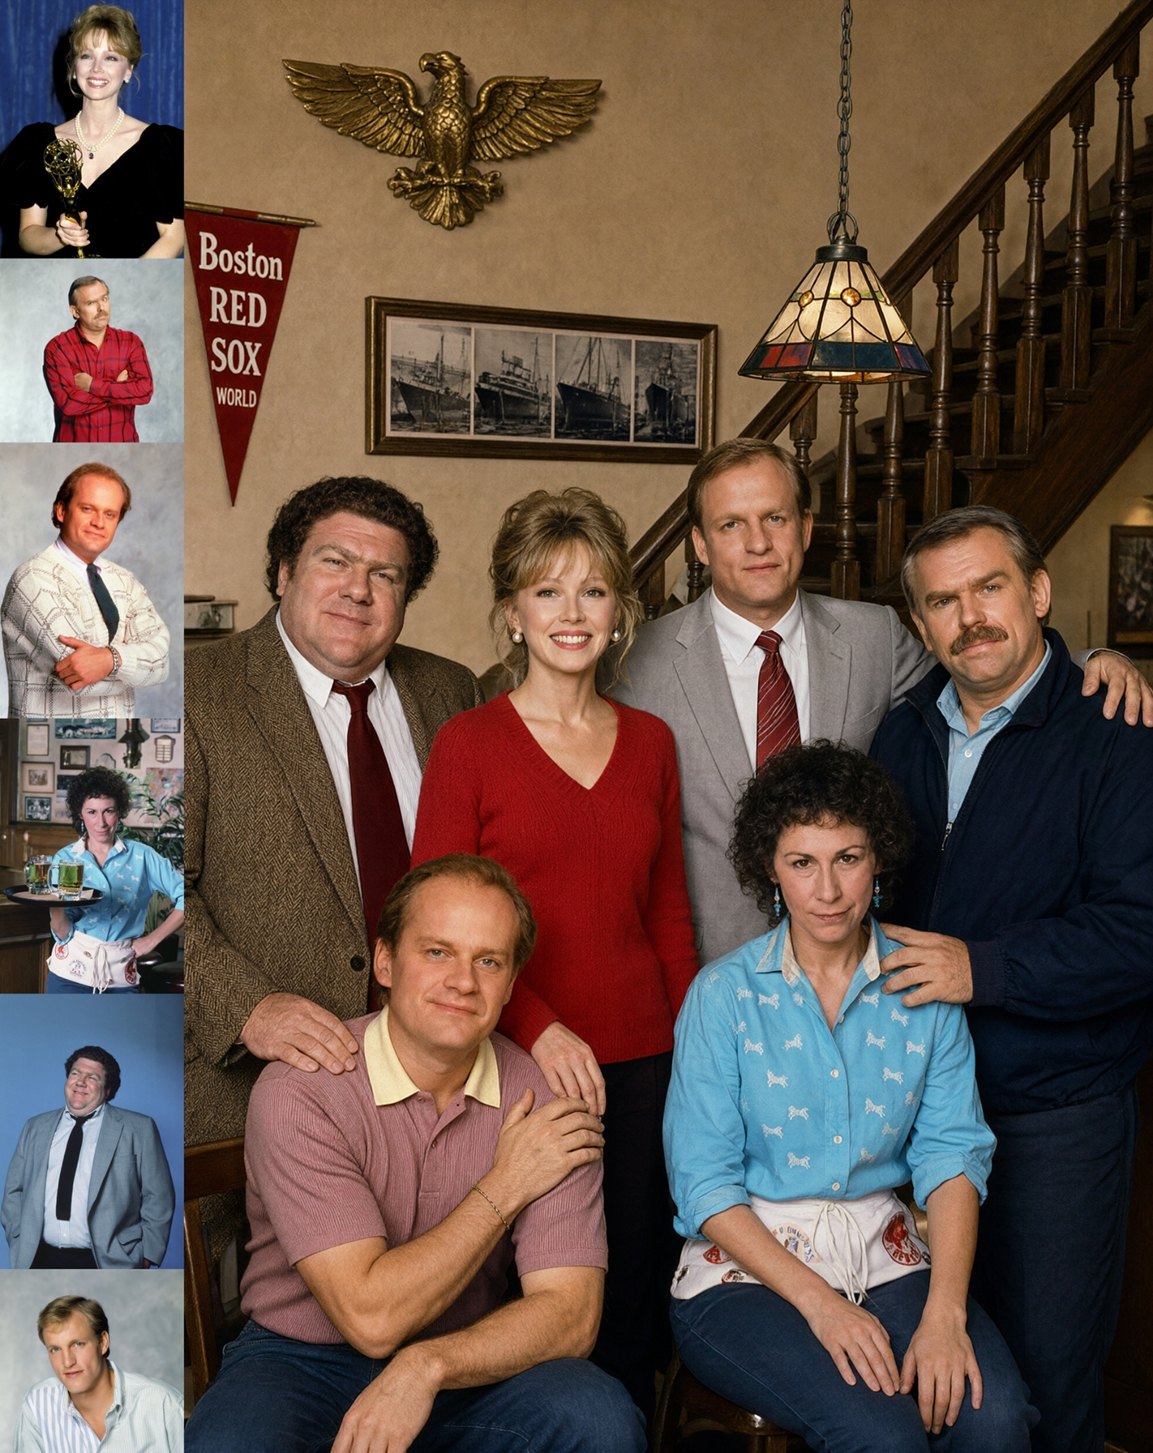
Qwen-Image-2.1 最多支持 10 张参考图输入,可以综合多个主体与素材,生成完整、协调的画面。下面的多人合照示例将左侧 6 张人像整合进同一张照片。
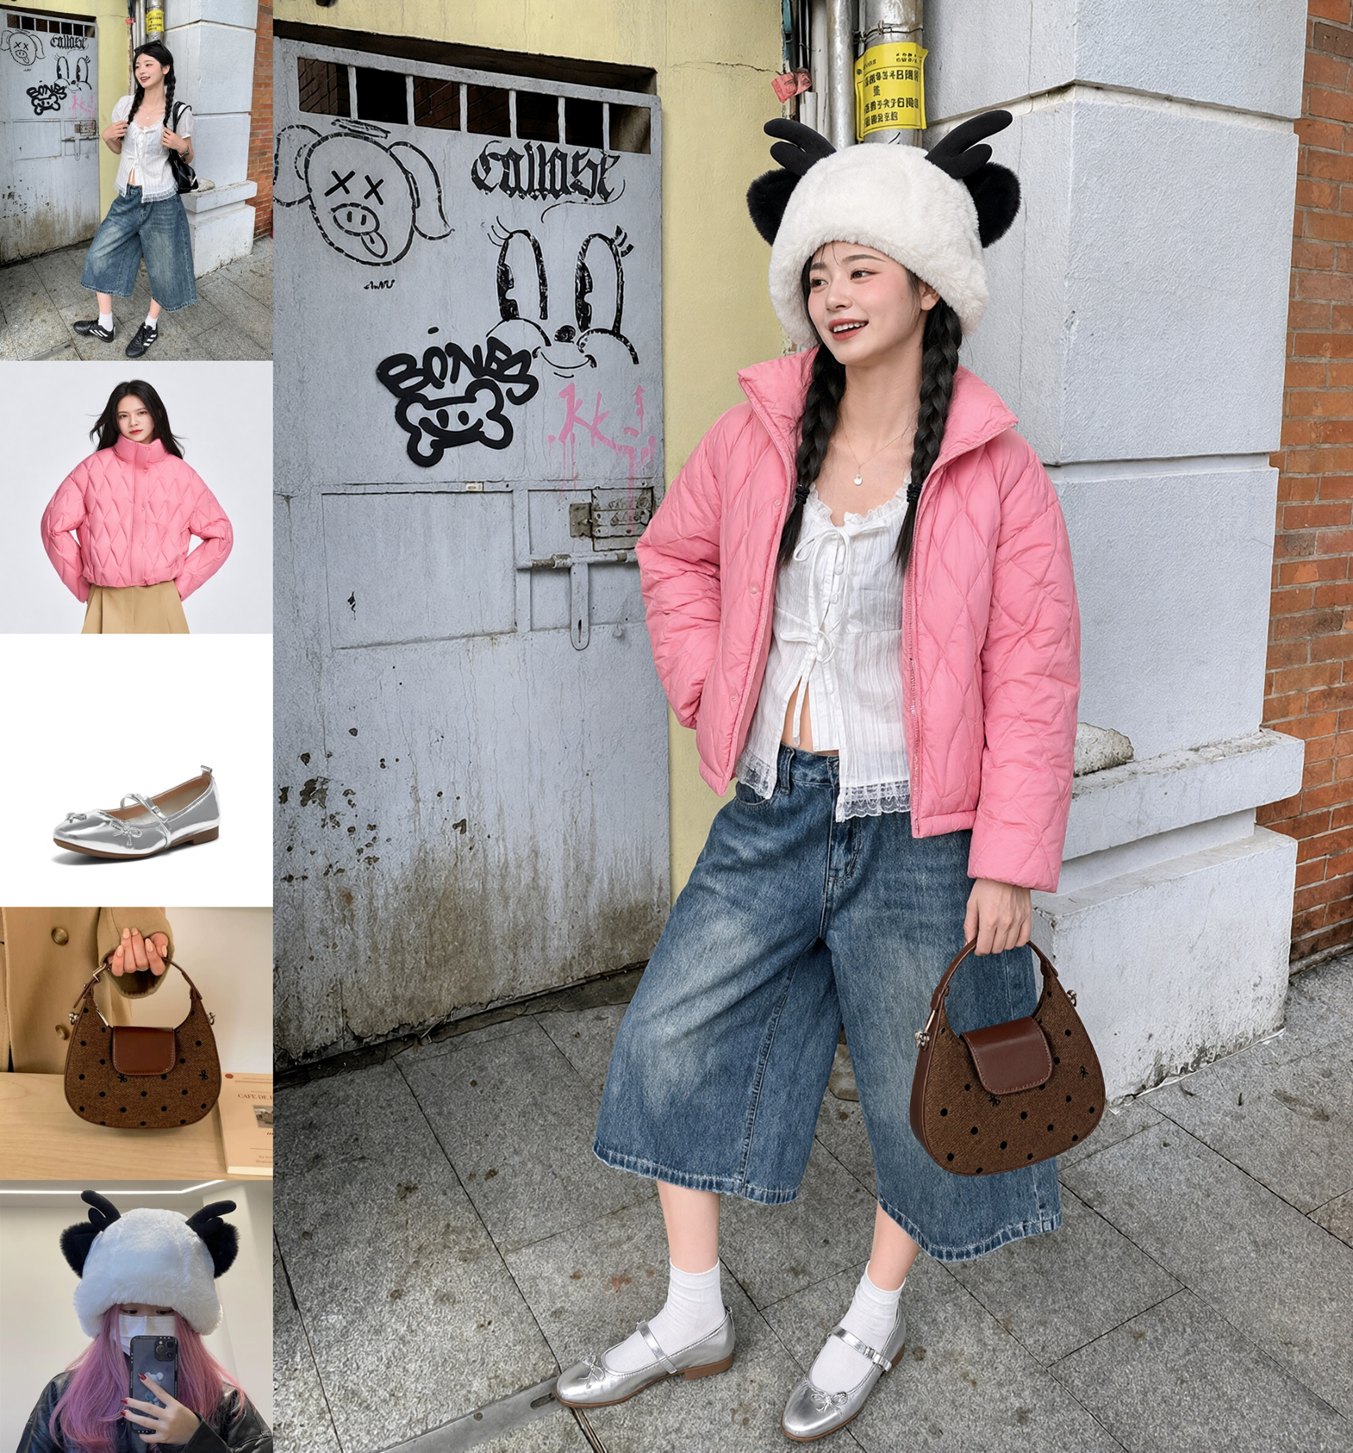
在多品穿戴场景中,输入模特、衣服、鞋子、包包与帽子共 5 张图片,即可生成完整的搭配效果。
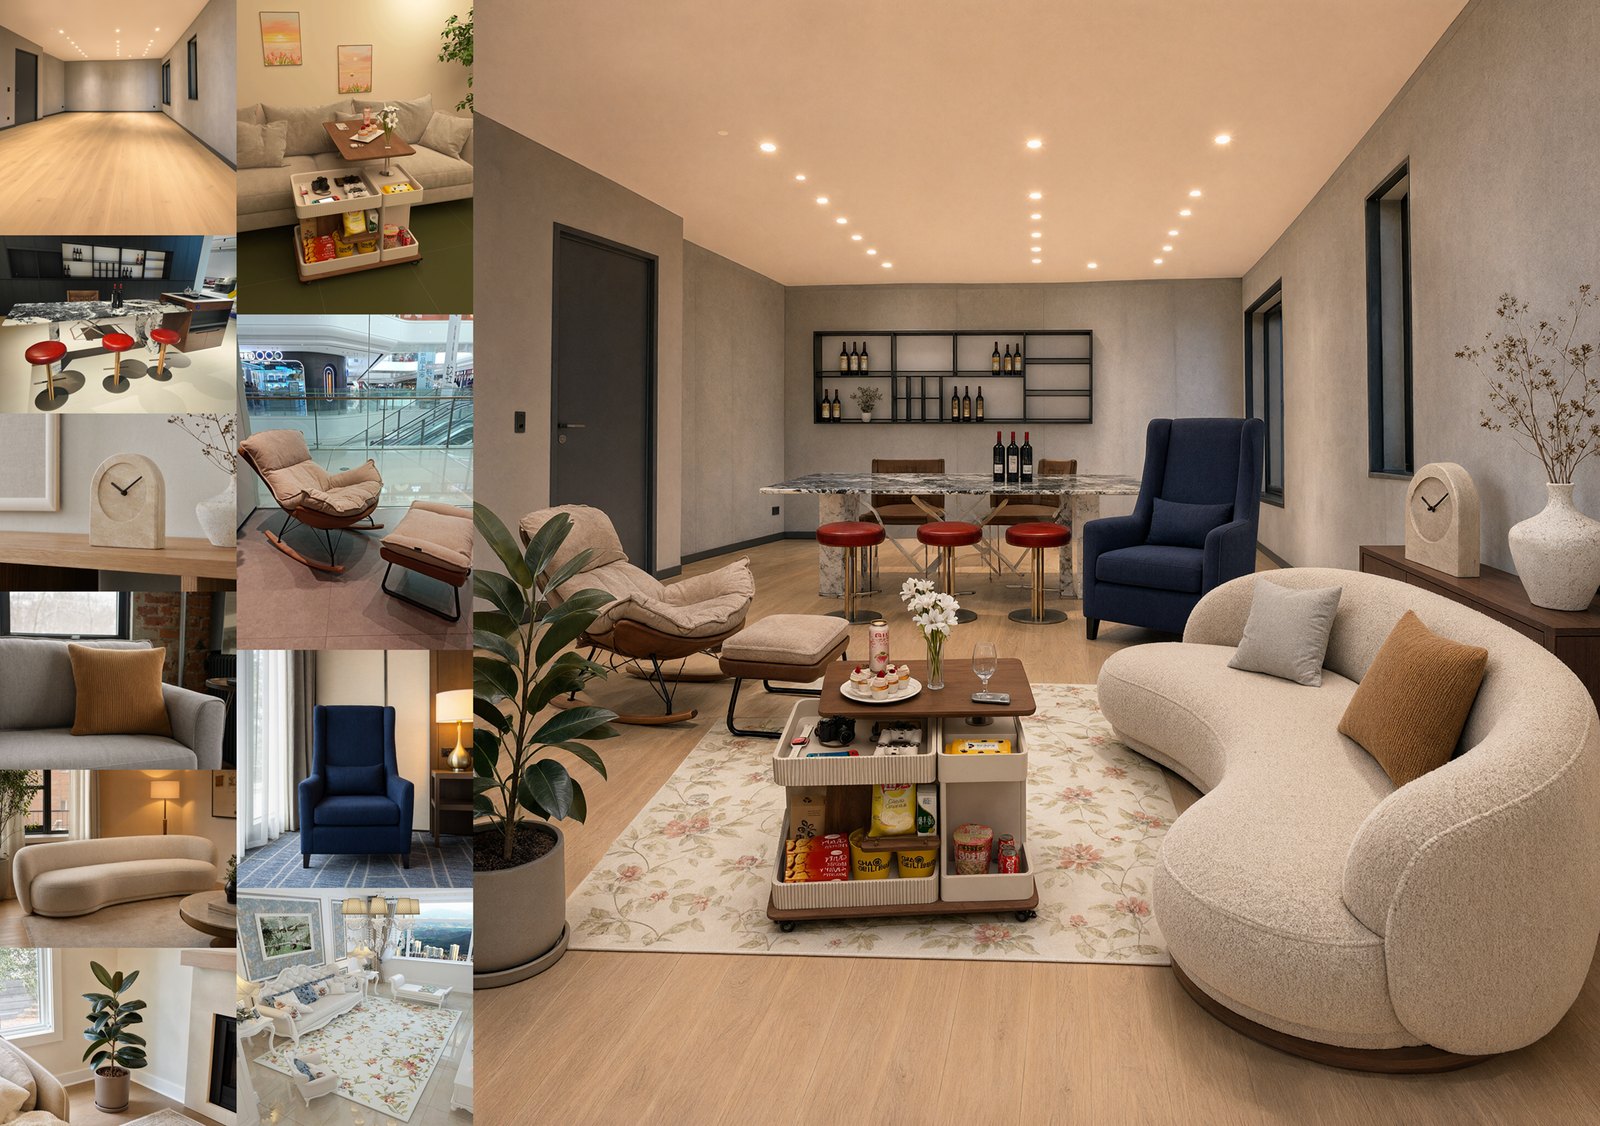
在室内设计场景中,模型可以参考 10 张家居图片,生成完整的室内布置效果。
局:灵活指定编辑区域
Qwen-Image-2.1 支持圈选、涂抹和独立掩码等局部编辑方式,让修改对象与范围更明确。
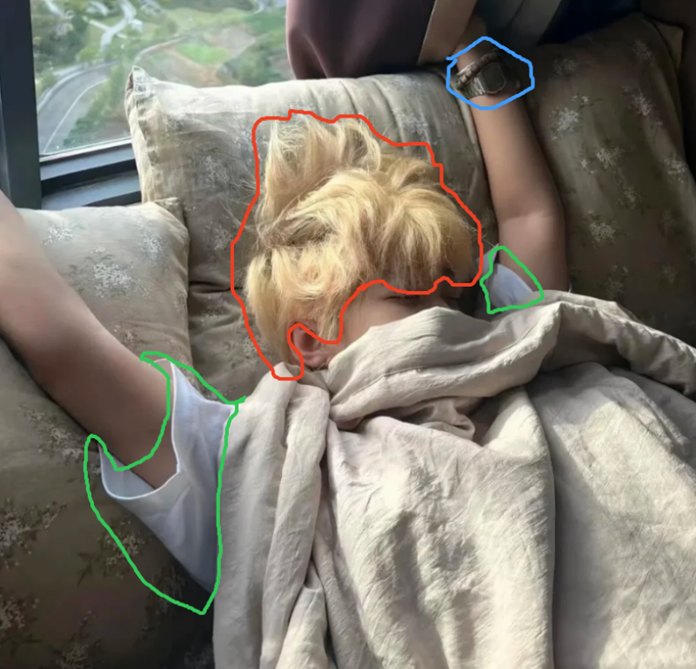
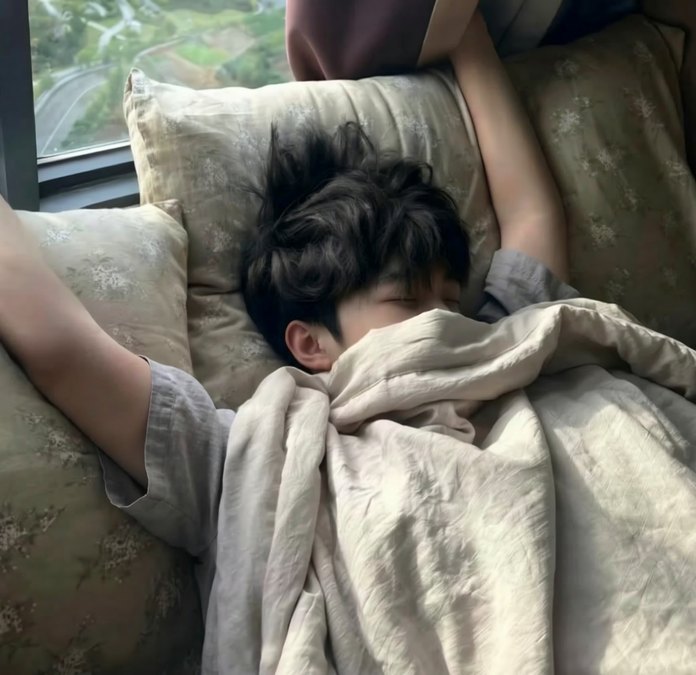
首先是圈选。下方示例通过不同颜色的圆圈同时指定三个区域,要求模型「去掉蓝色圈的金属手表,把红色圈的头发颜色改为黑色,把绿色圈替换为灰色短袖亚麻睡衣」。左侧为标注后的输入,右侧为编辑结果。
模型也支持通过涂抹指定区域。例如,在下图右侧白色标注的区域添加一名潜水员。
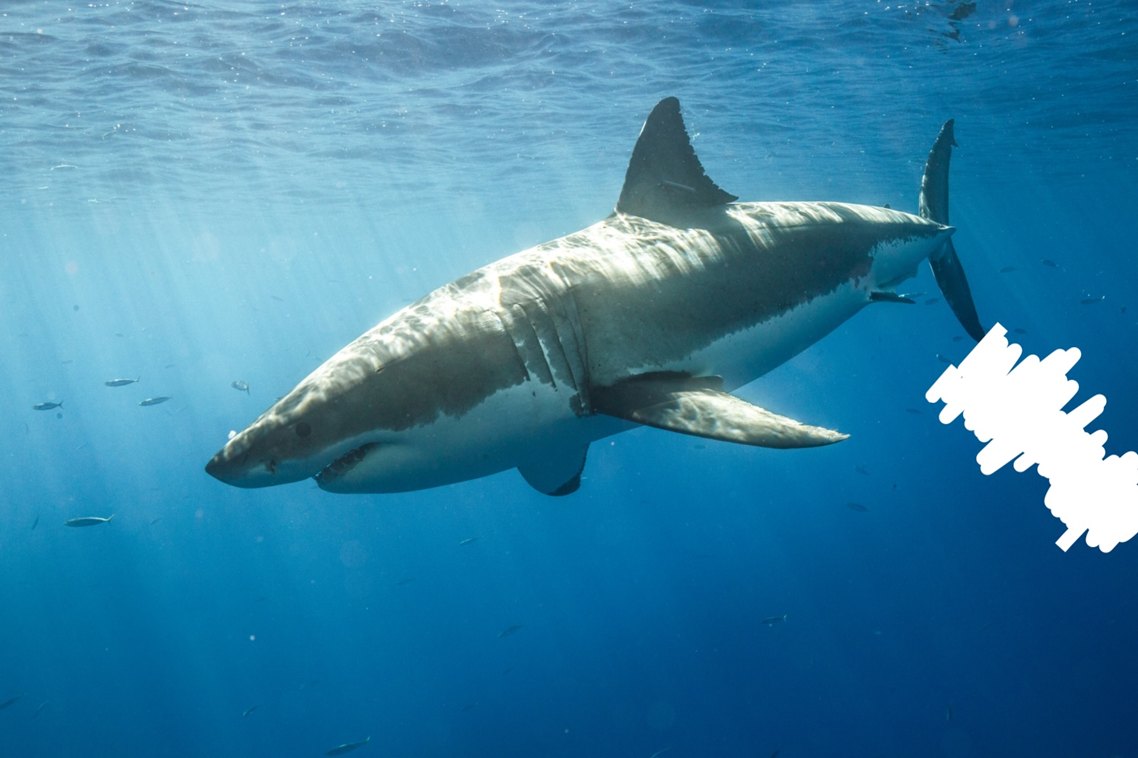
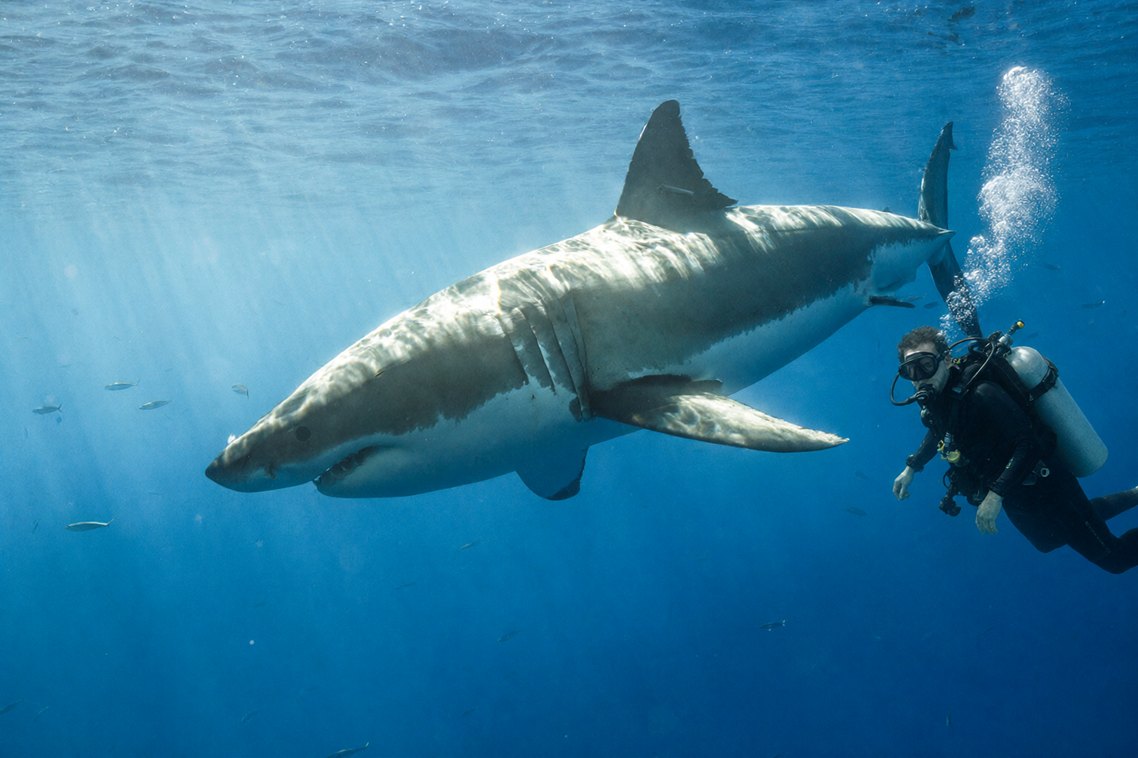
圈选与涂抹会覆盖原图中的部分内容。为保留完整的原始图像信息,Qwen-Image-2.1 还支持将原图和独立掩码作为两张图片输入。下面的示例要求模型生成马背上的牛仔,两张输入图片如下:
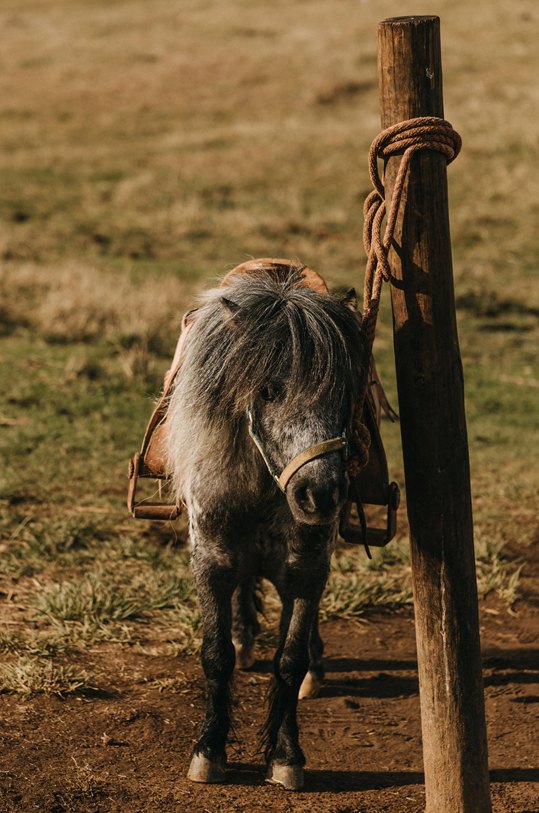
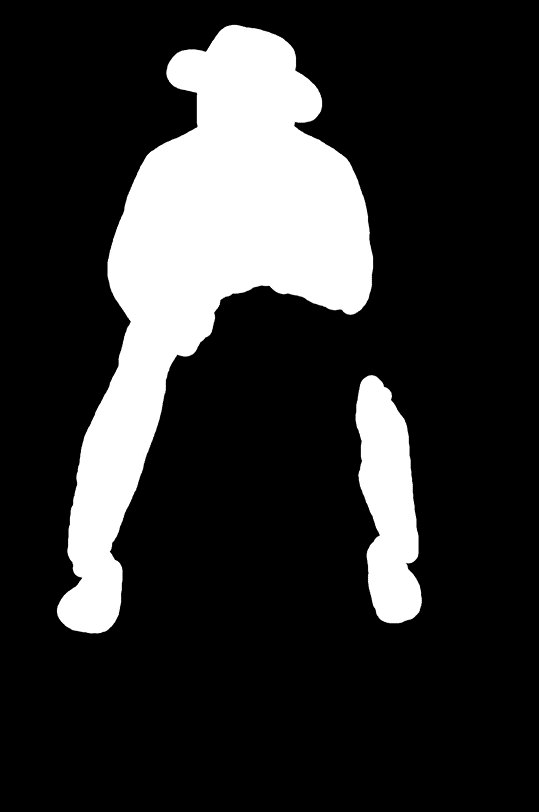
模型根据掩码指定的区域完成编辑,输出结果如下:
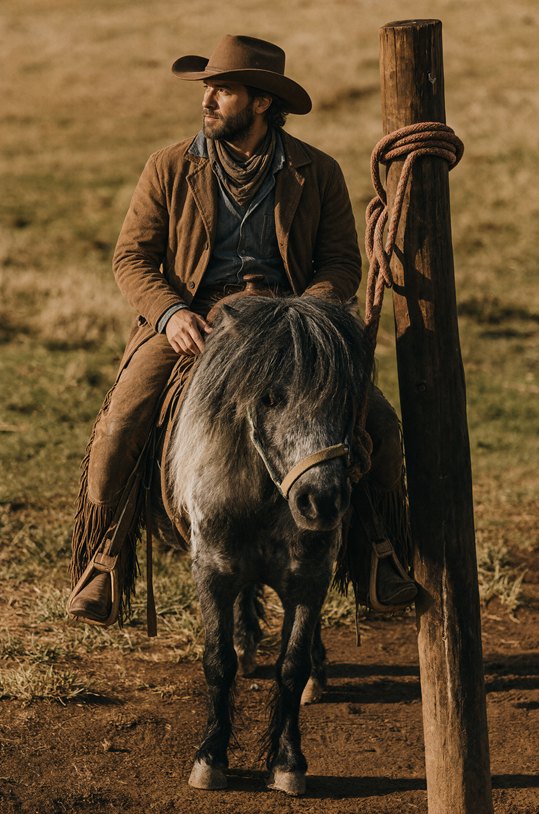
局部编辑也能用于连续创作。通过逐步修改画面并保持其他区域的一致性,可以将编辑结果串联成简单动画,例如下面的卡皮巴拉葫芦娃示例。
保:人像与商品保真
编辑保真重点强化了两类场景:人像一致性与商品一致性。在人像编辑中,模型增强了对面部特征的保留能力,使人物在编辑前后保持更稳定的身份特征。下面每组左侧为输入,右侧为编辑结果。
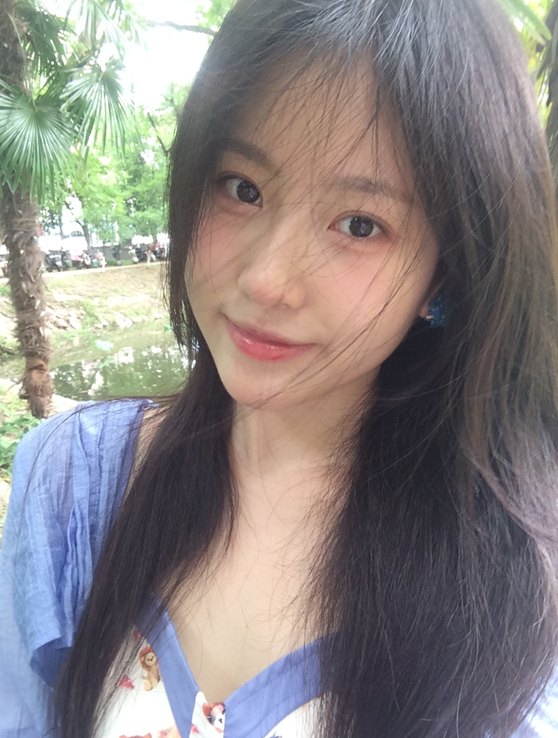
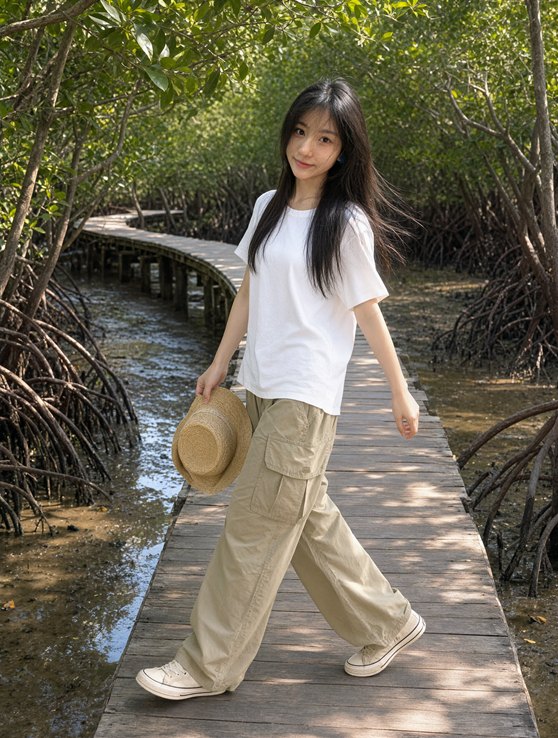
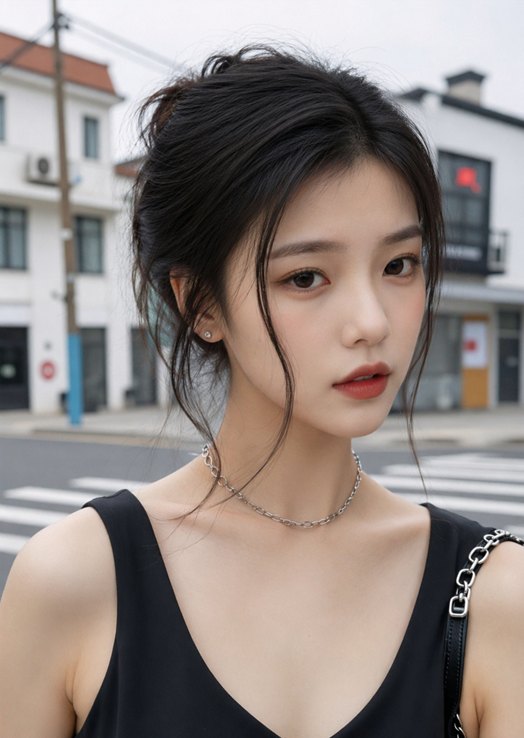
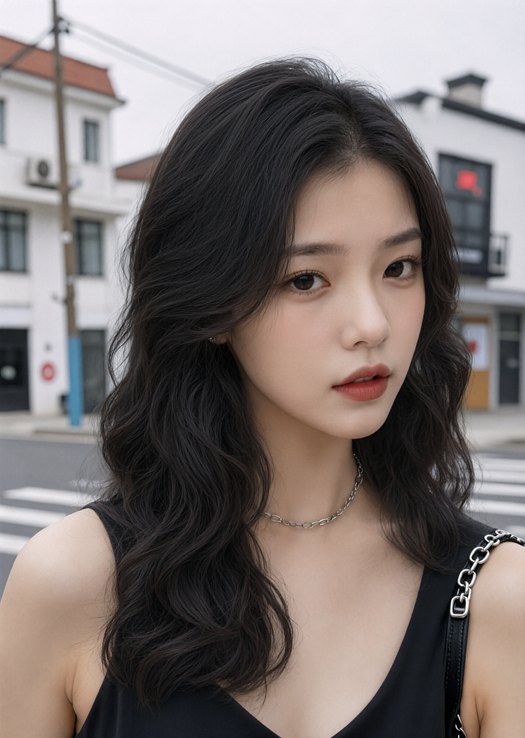
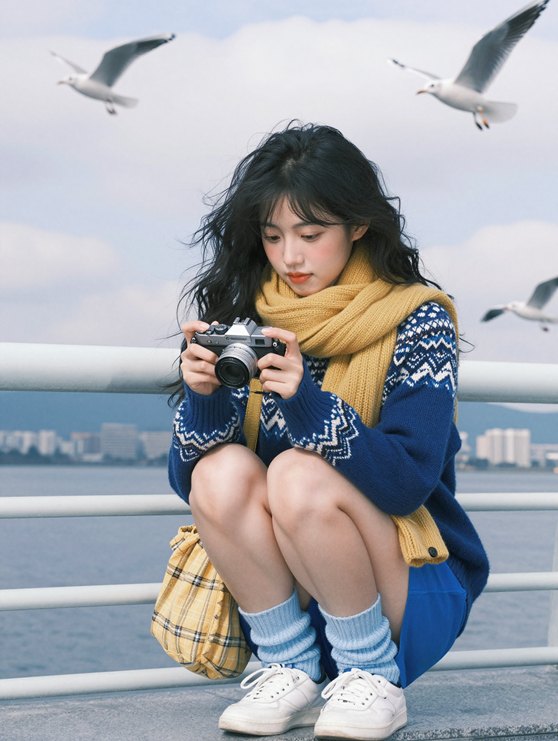
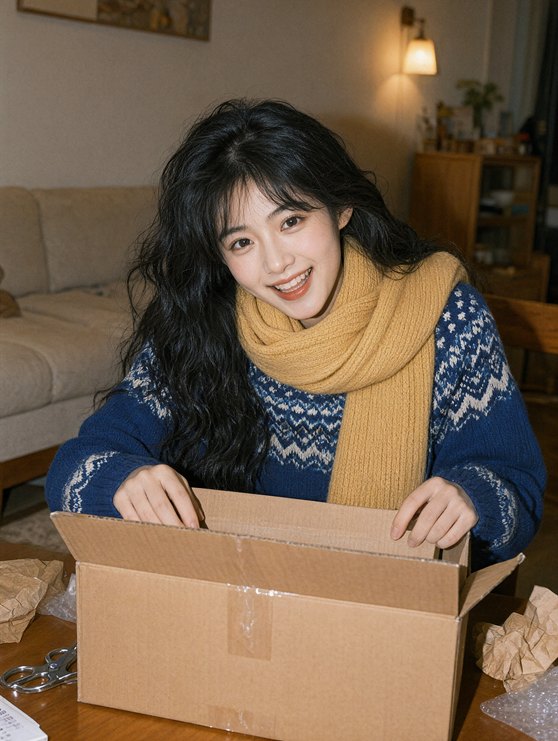
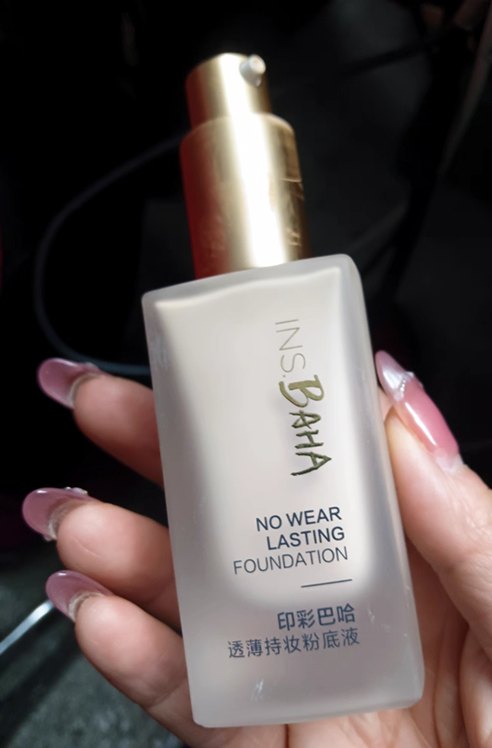
在商品编辑中,模型尽可能保持商品文字、纹理与形态的一致性,让商品在新的画面中仍保有原有特征。
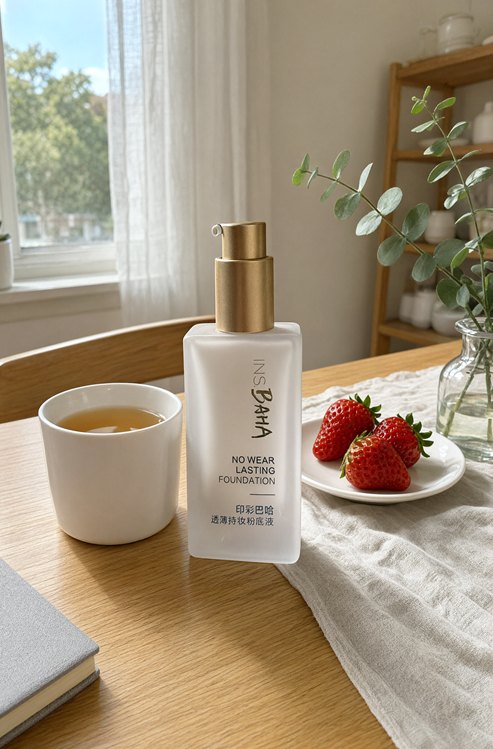
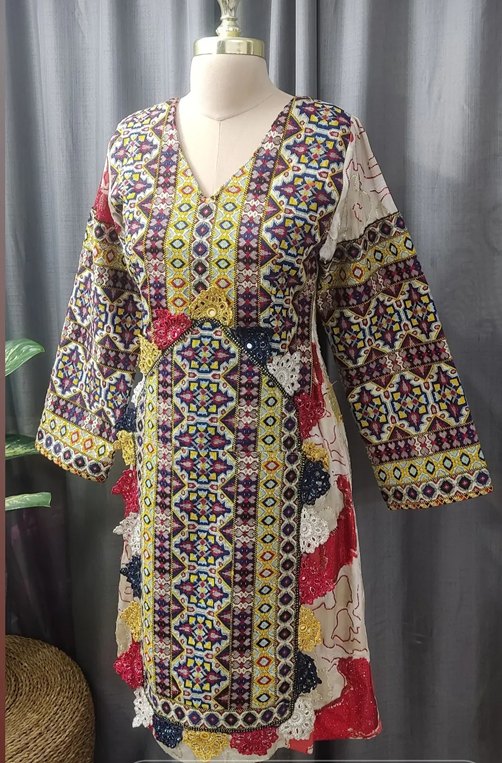
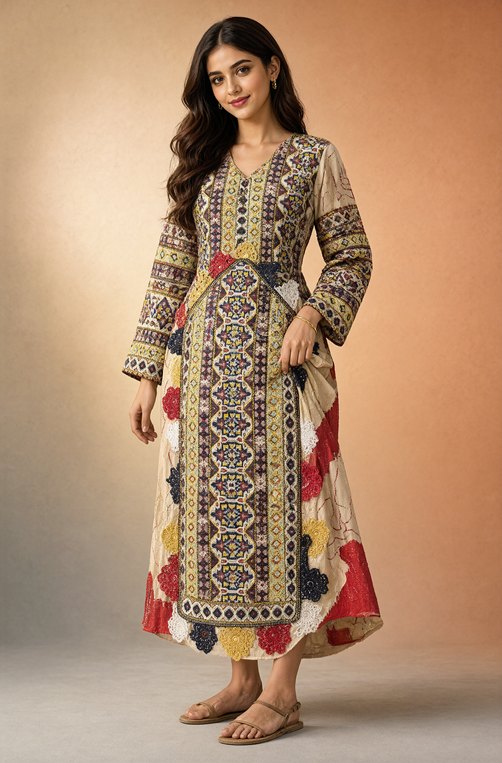
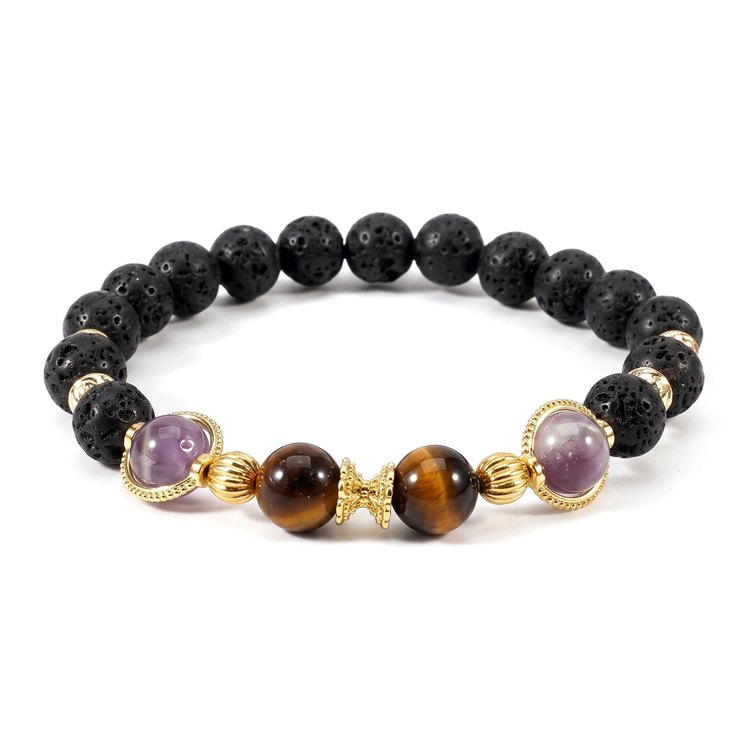
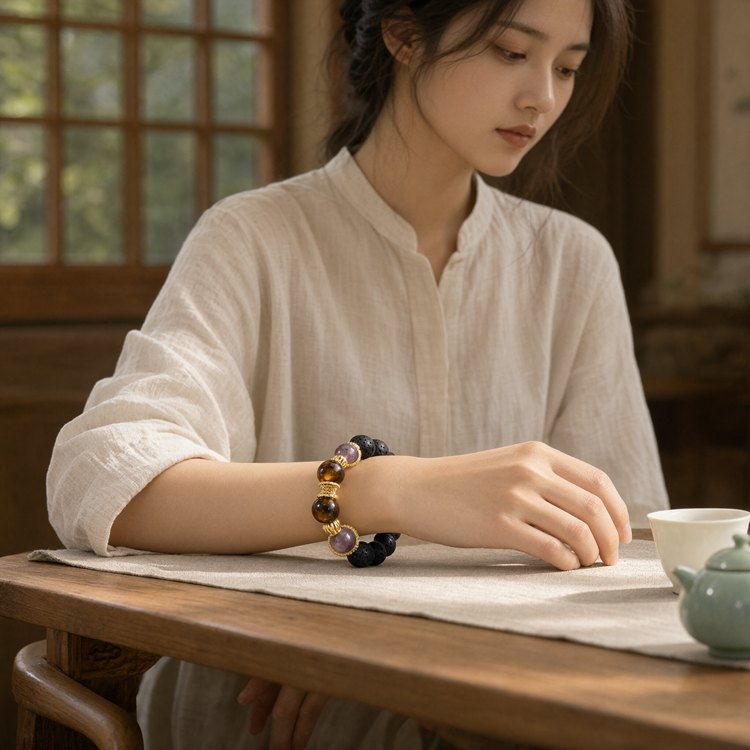
全:覆盖多种编辑任务
Qwen-Image-2.1 同时支持多种编辑任务,包括全景图、信息图与分镜图生成,在不同应用场景之间取得能力平衡。
例如,输入下面这张自拍照:
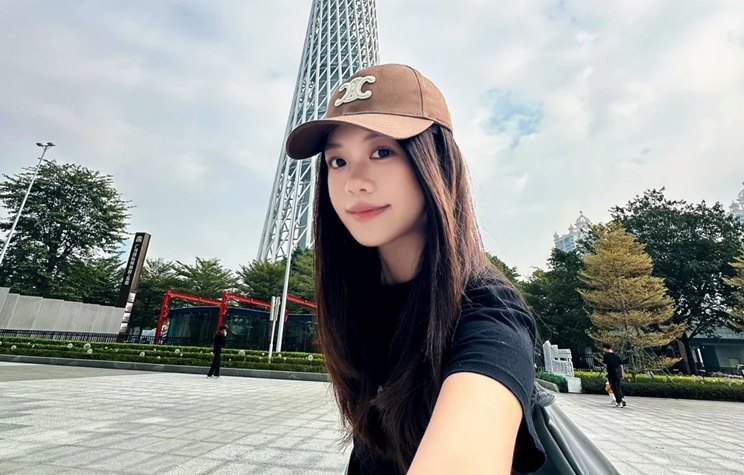
模型可以生成对应的全景图:
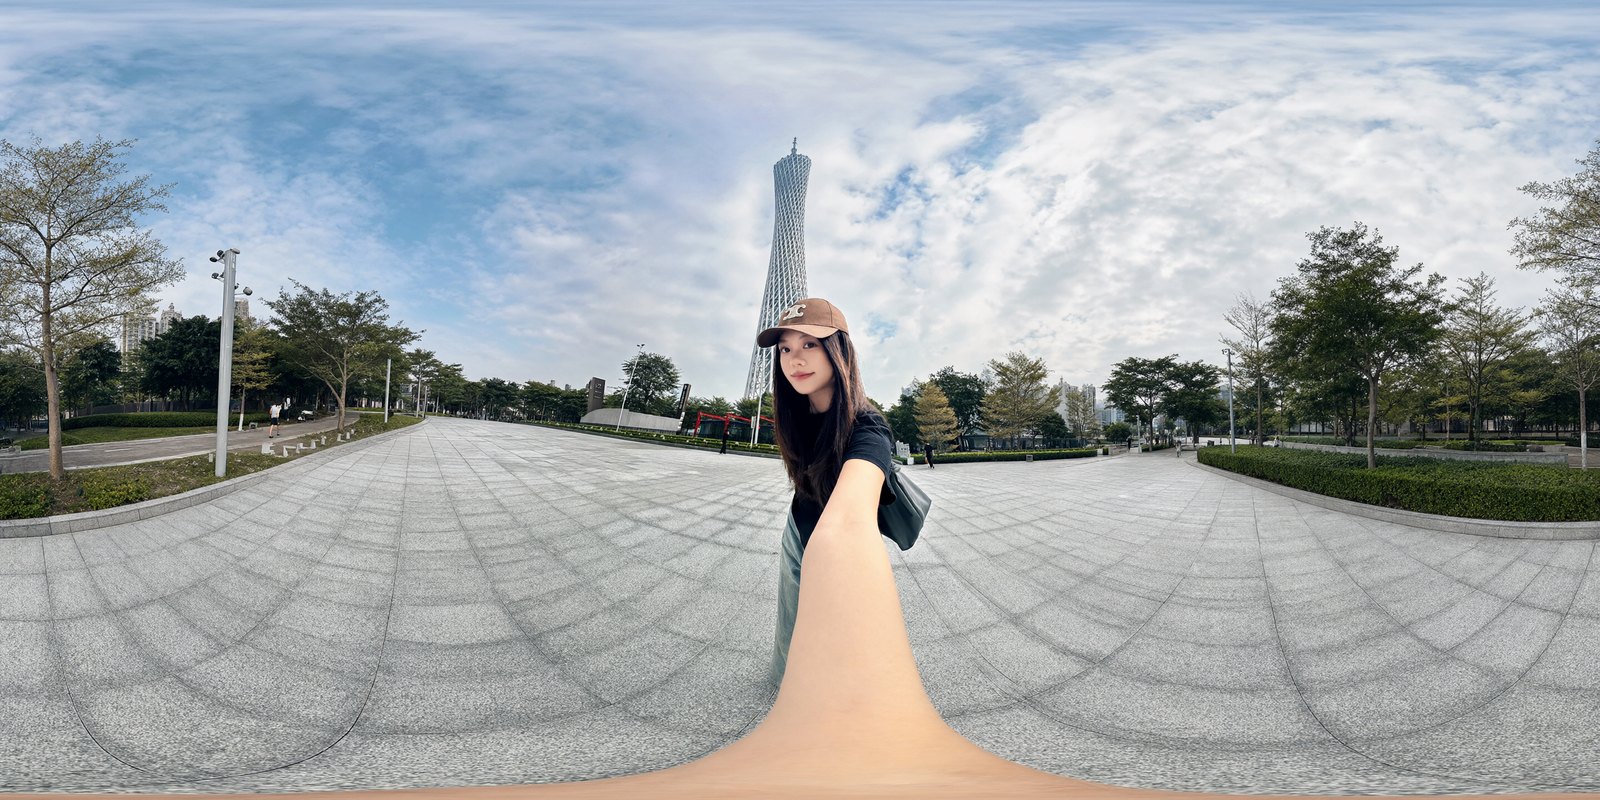
将生成的全景图放入可视化工具,即可从不同视角查看完整场景。
在信息图生成中,输入一张模特照片,模型可以将其扩展为内容丰富的复杂信息图。
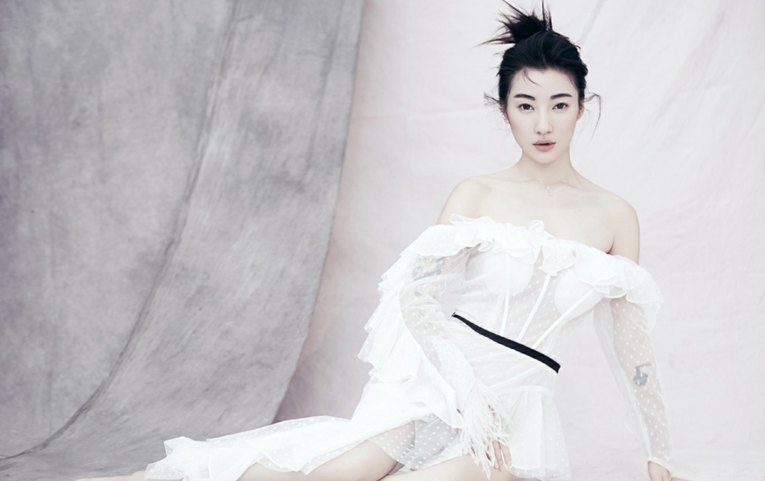
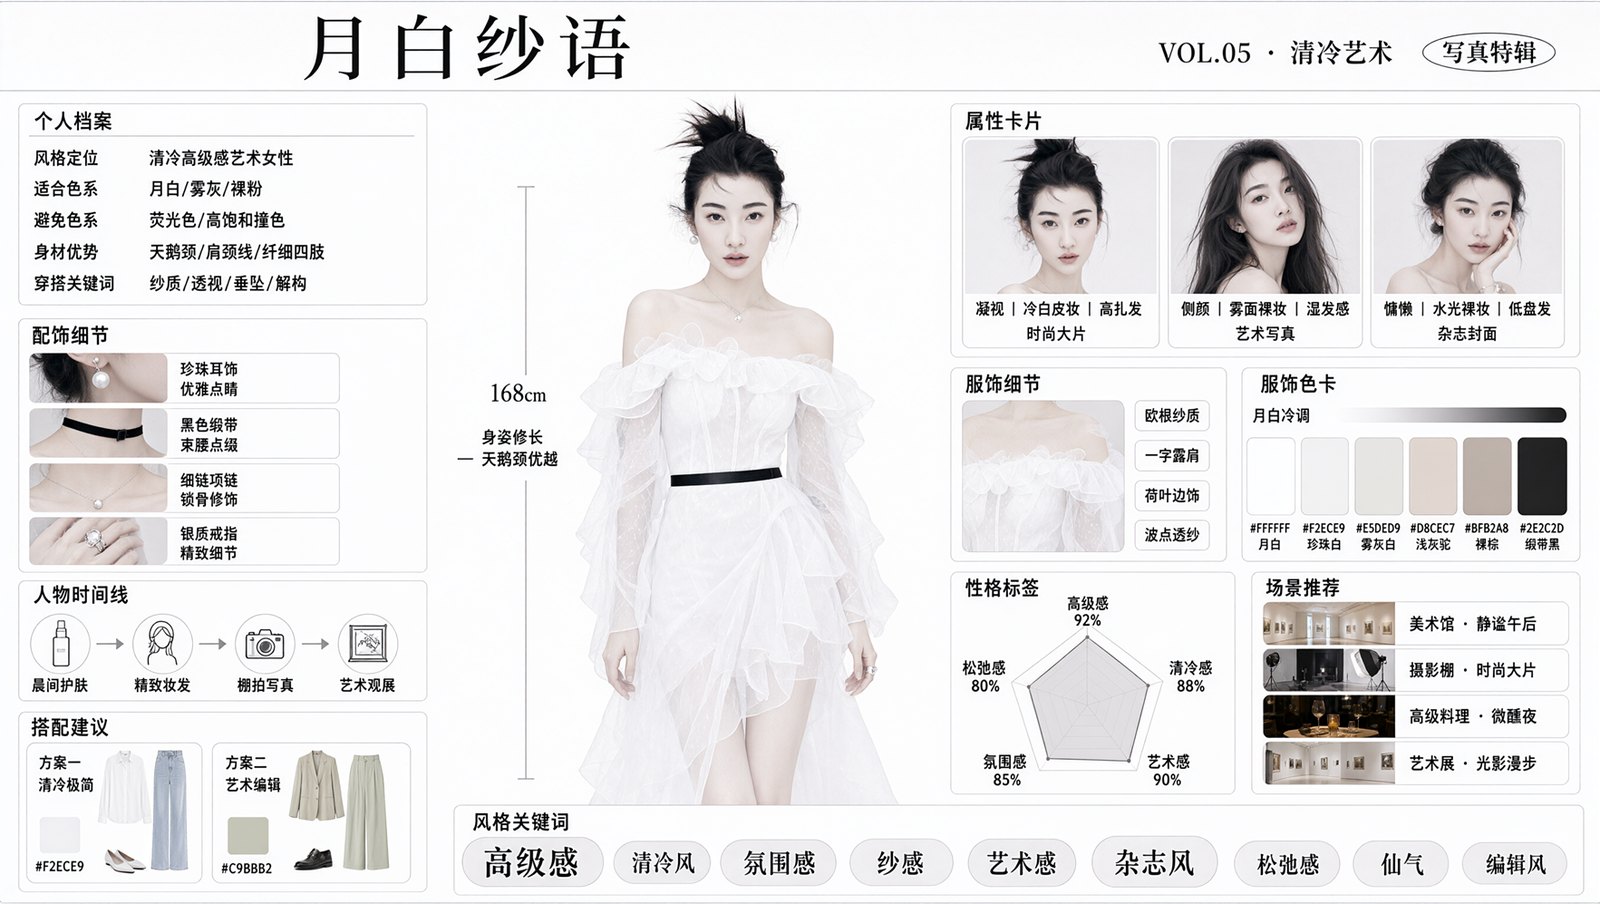
模型还可以根据人物三视图生成完整分镜,为故事创作和视觉叙事提供素材。
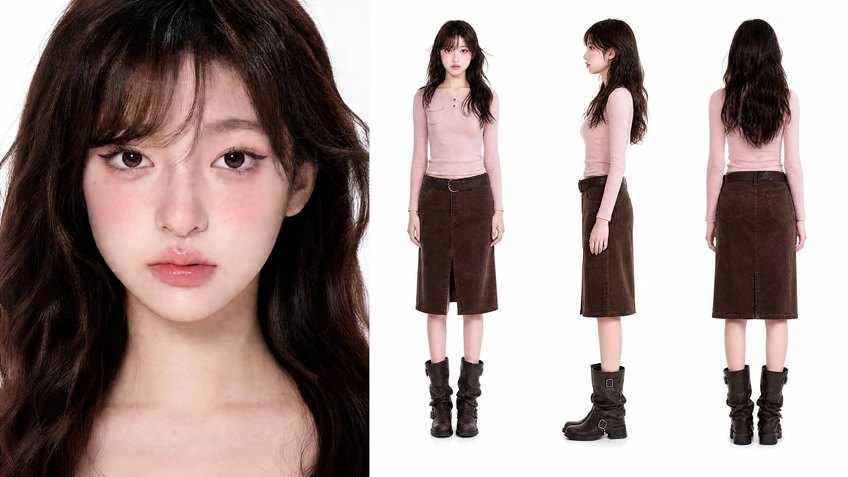
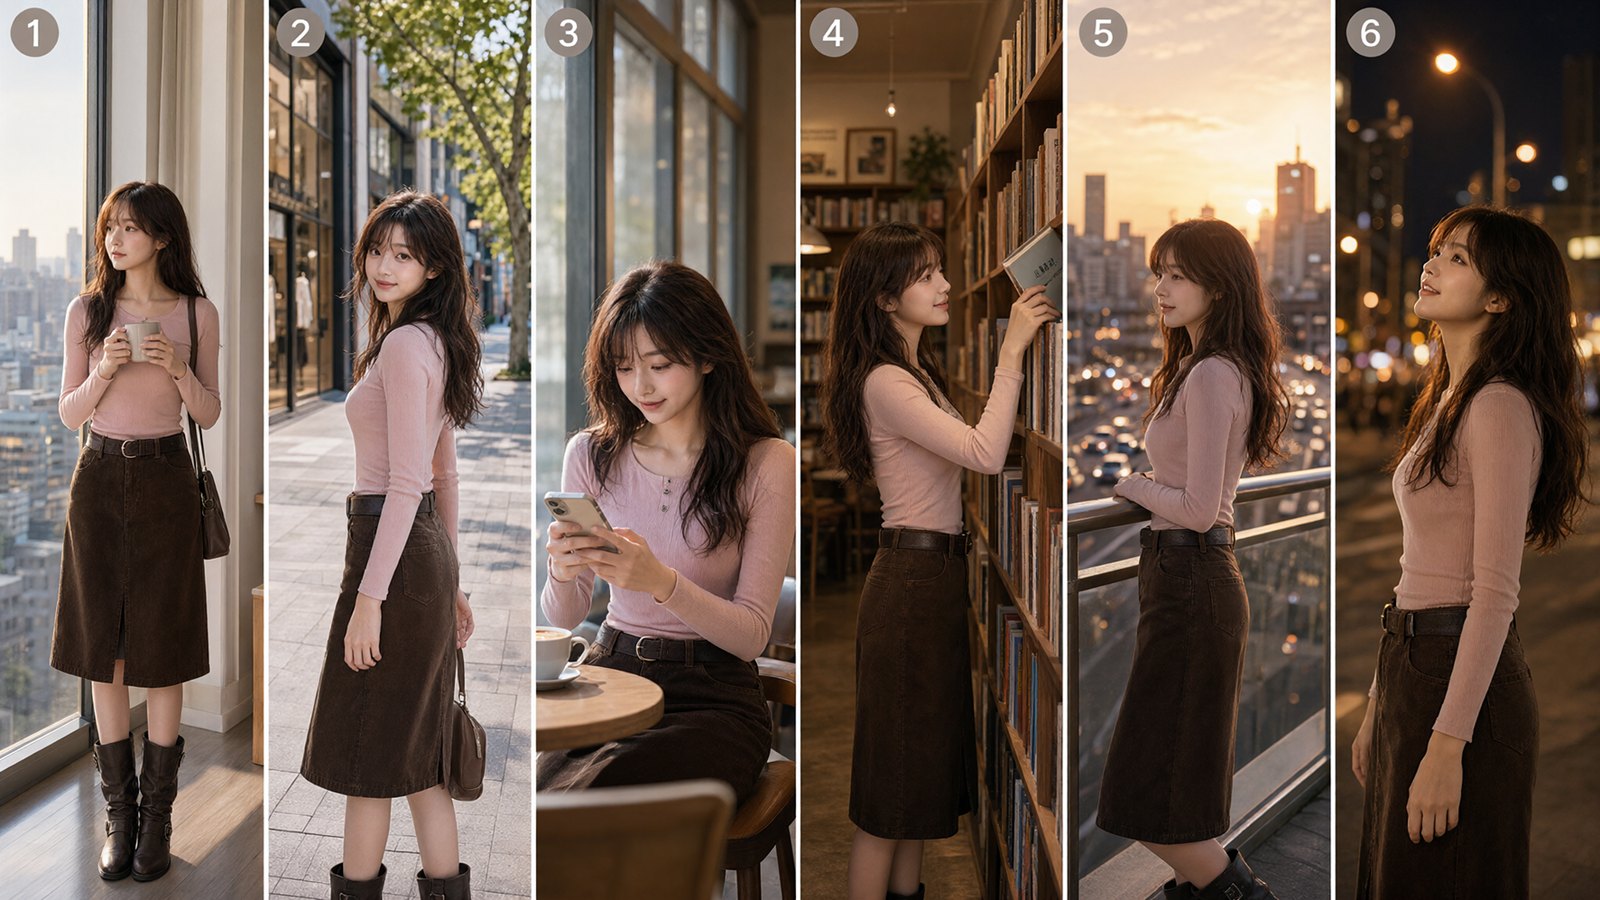
真实质感,字雅人美
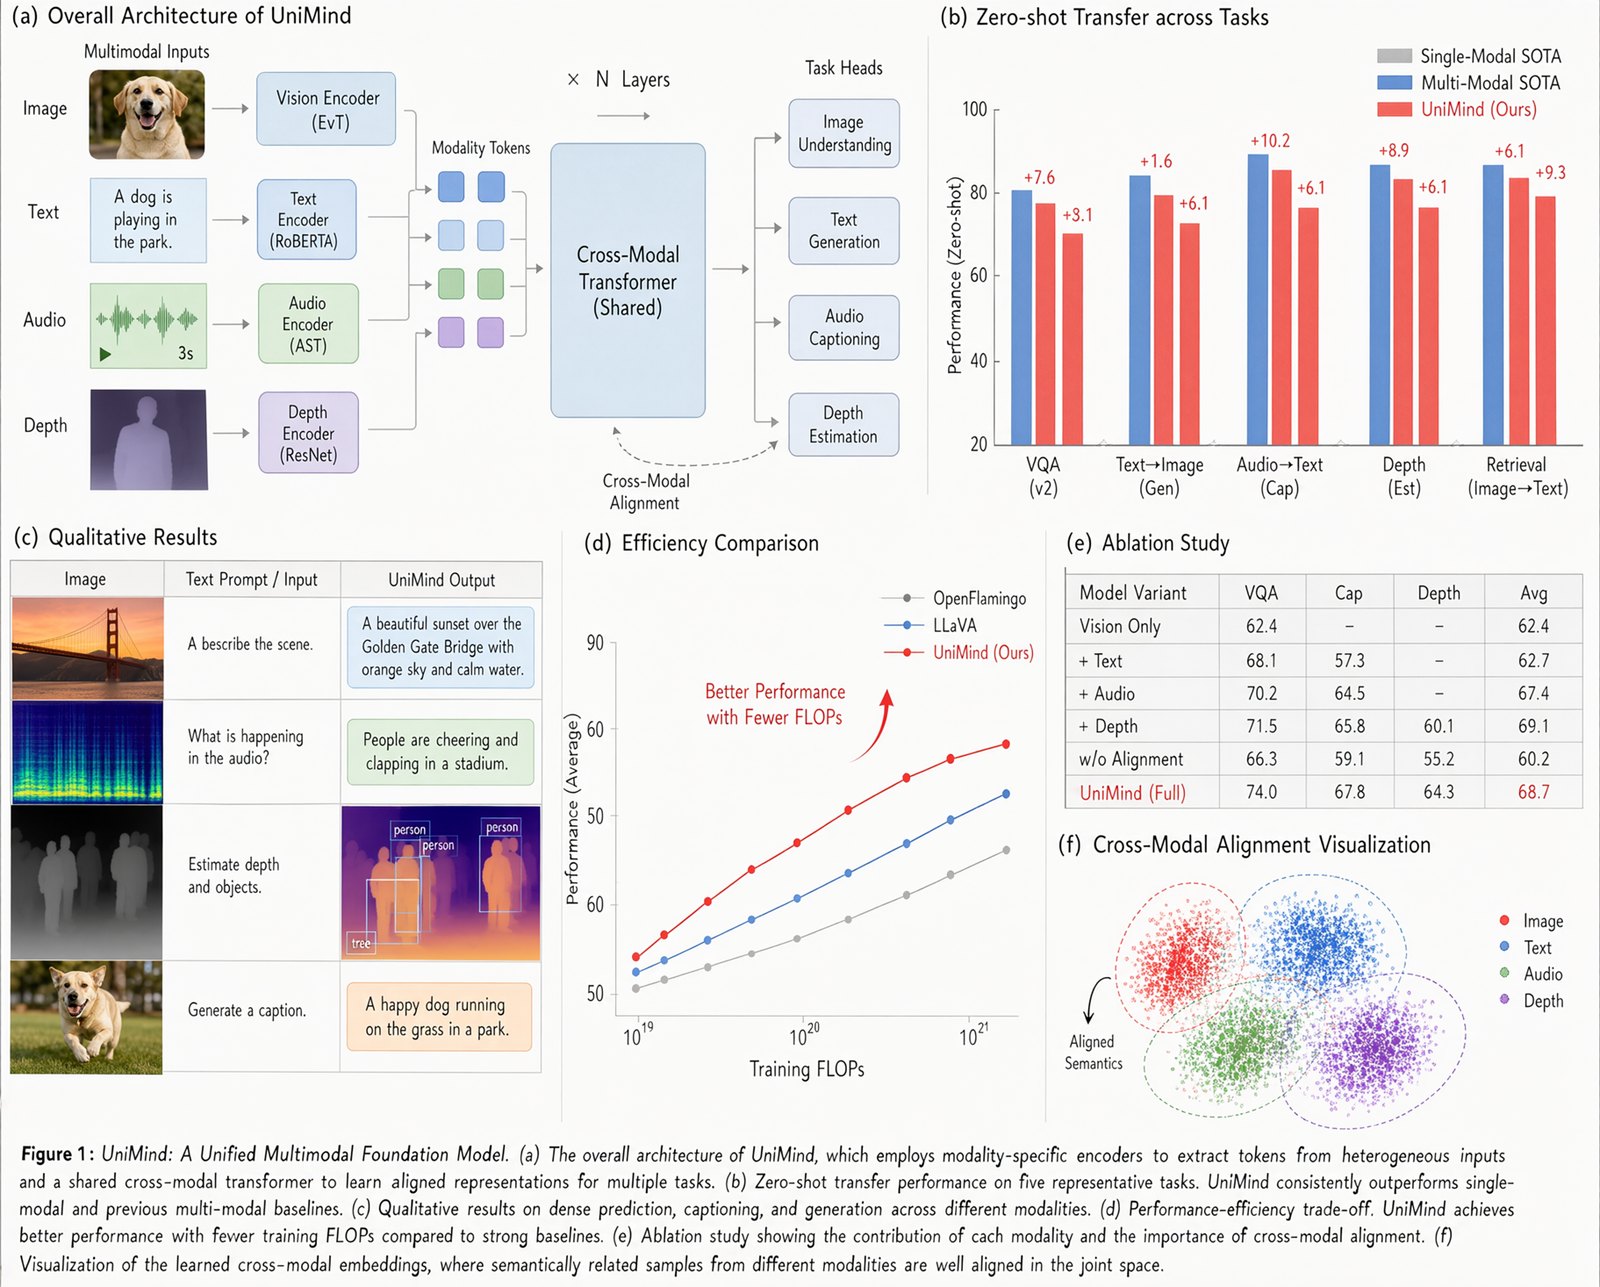
Qwen-Image-2.1 进一步提升了图像质感,尤其关注文字与人物的美学表现。文字生成除了关注内容本身,也注重字体、排版与画面的整体协调。下面展示了不同场景中的文字渲染效果。
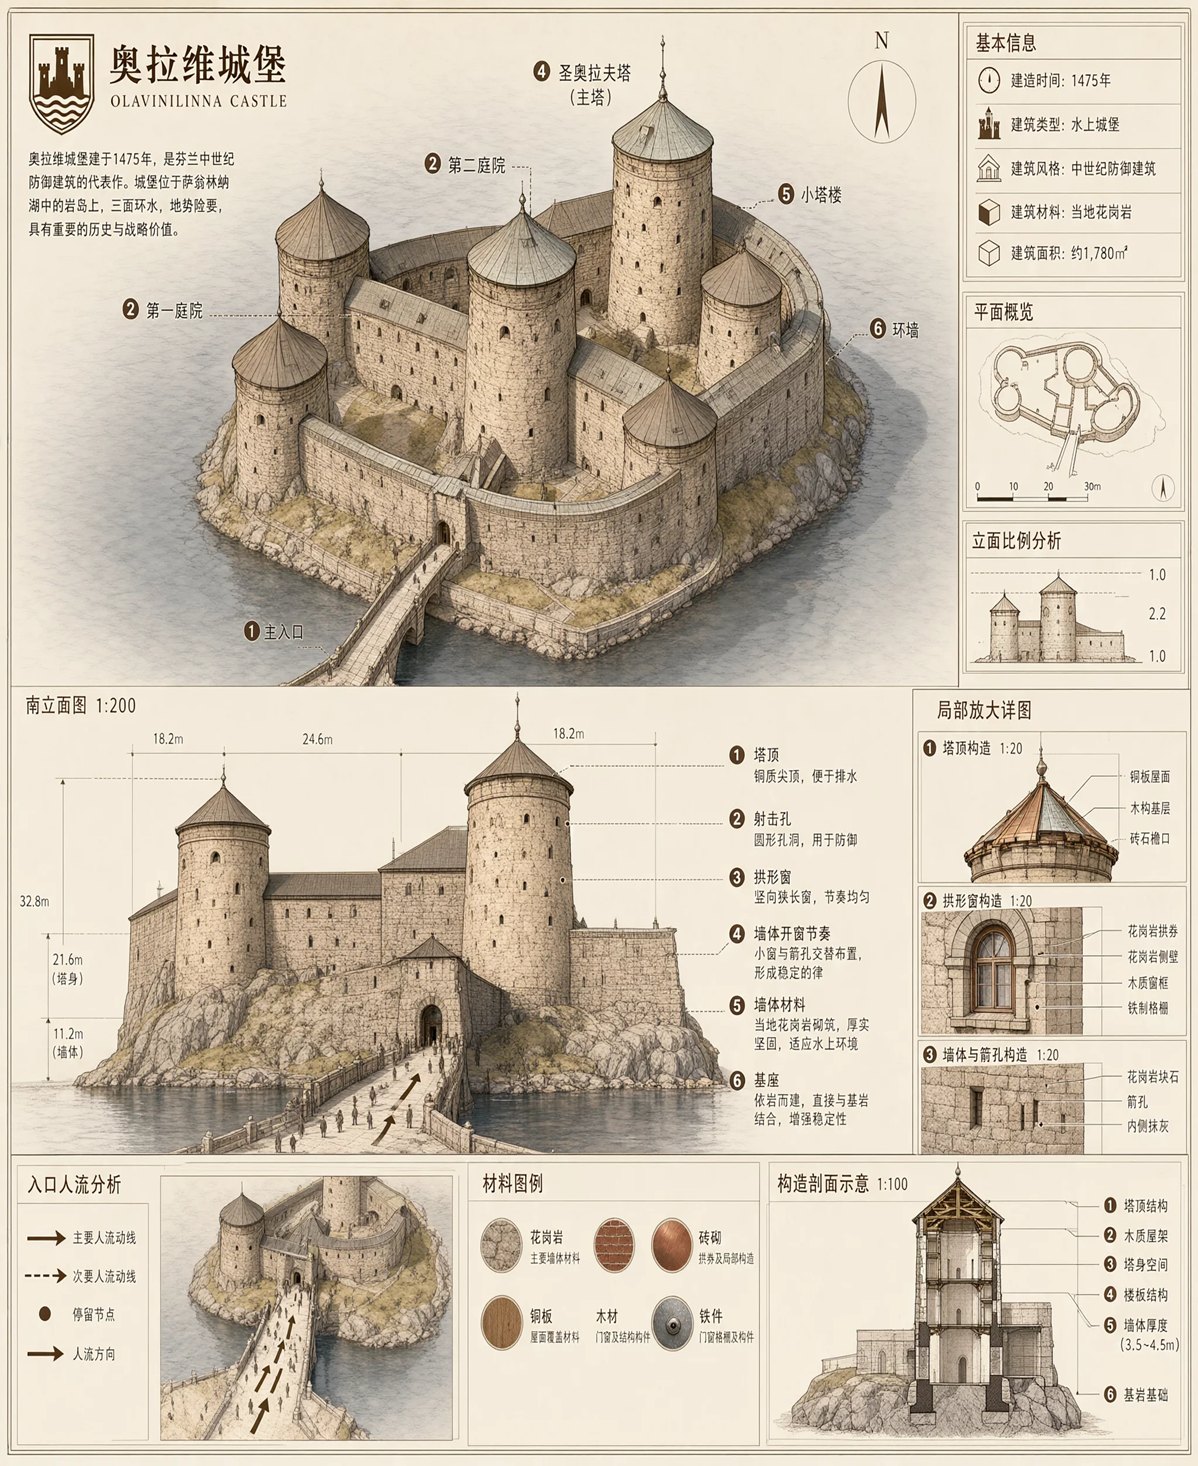
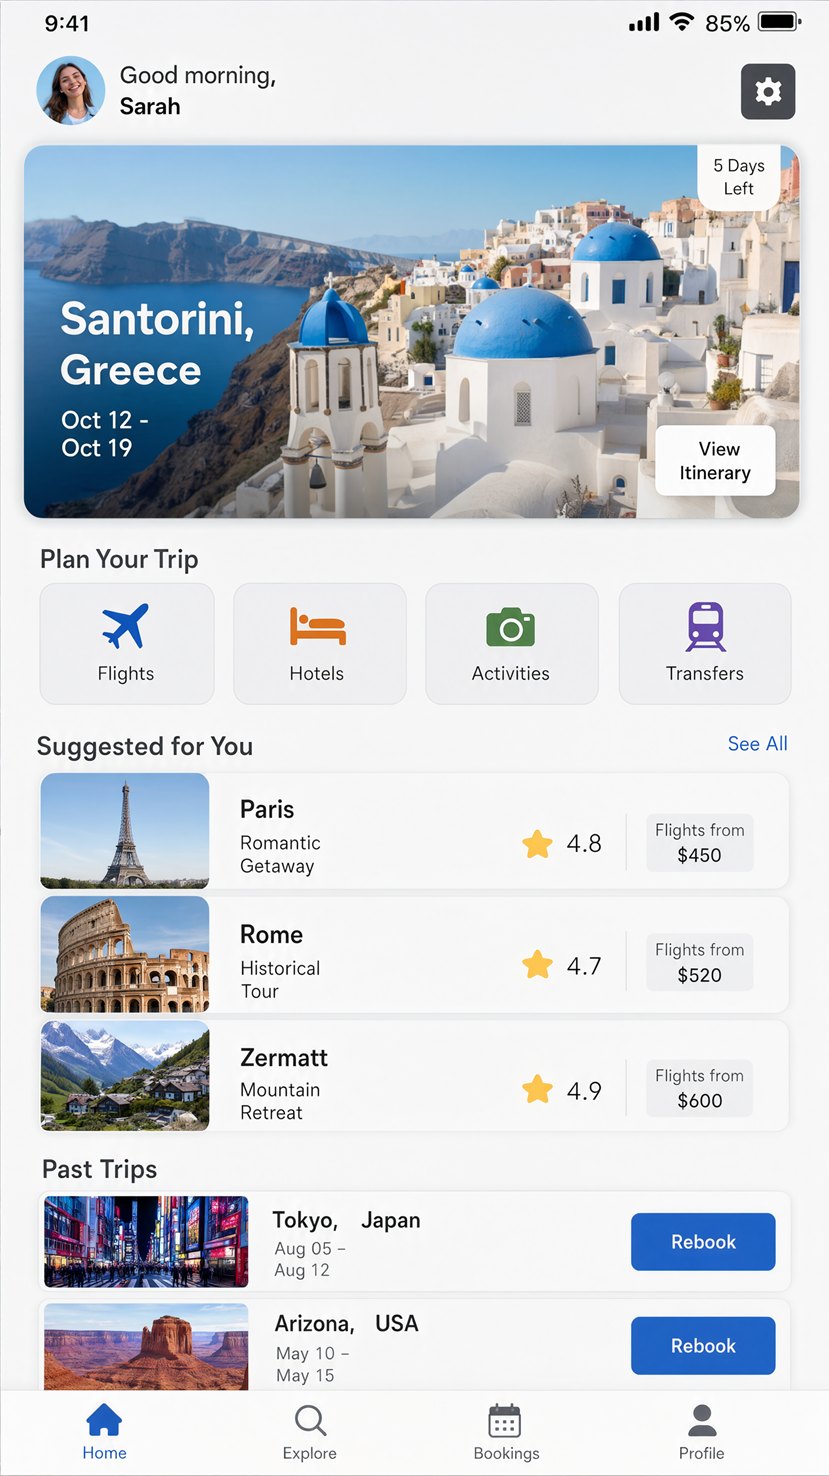
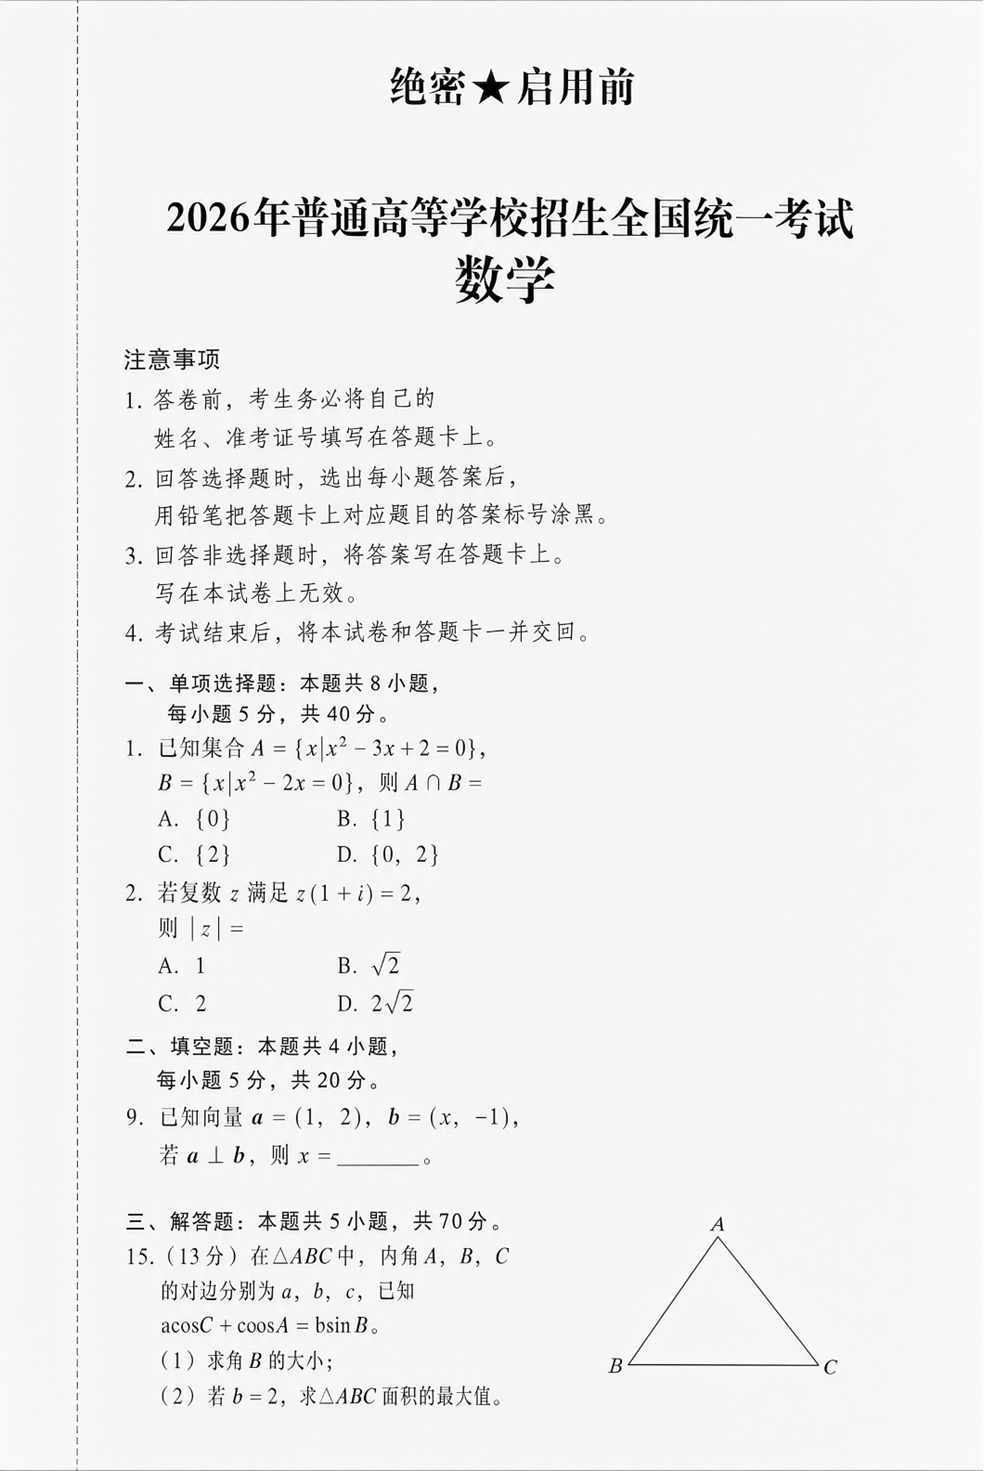
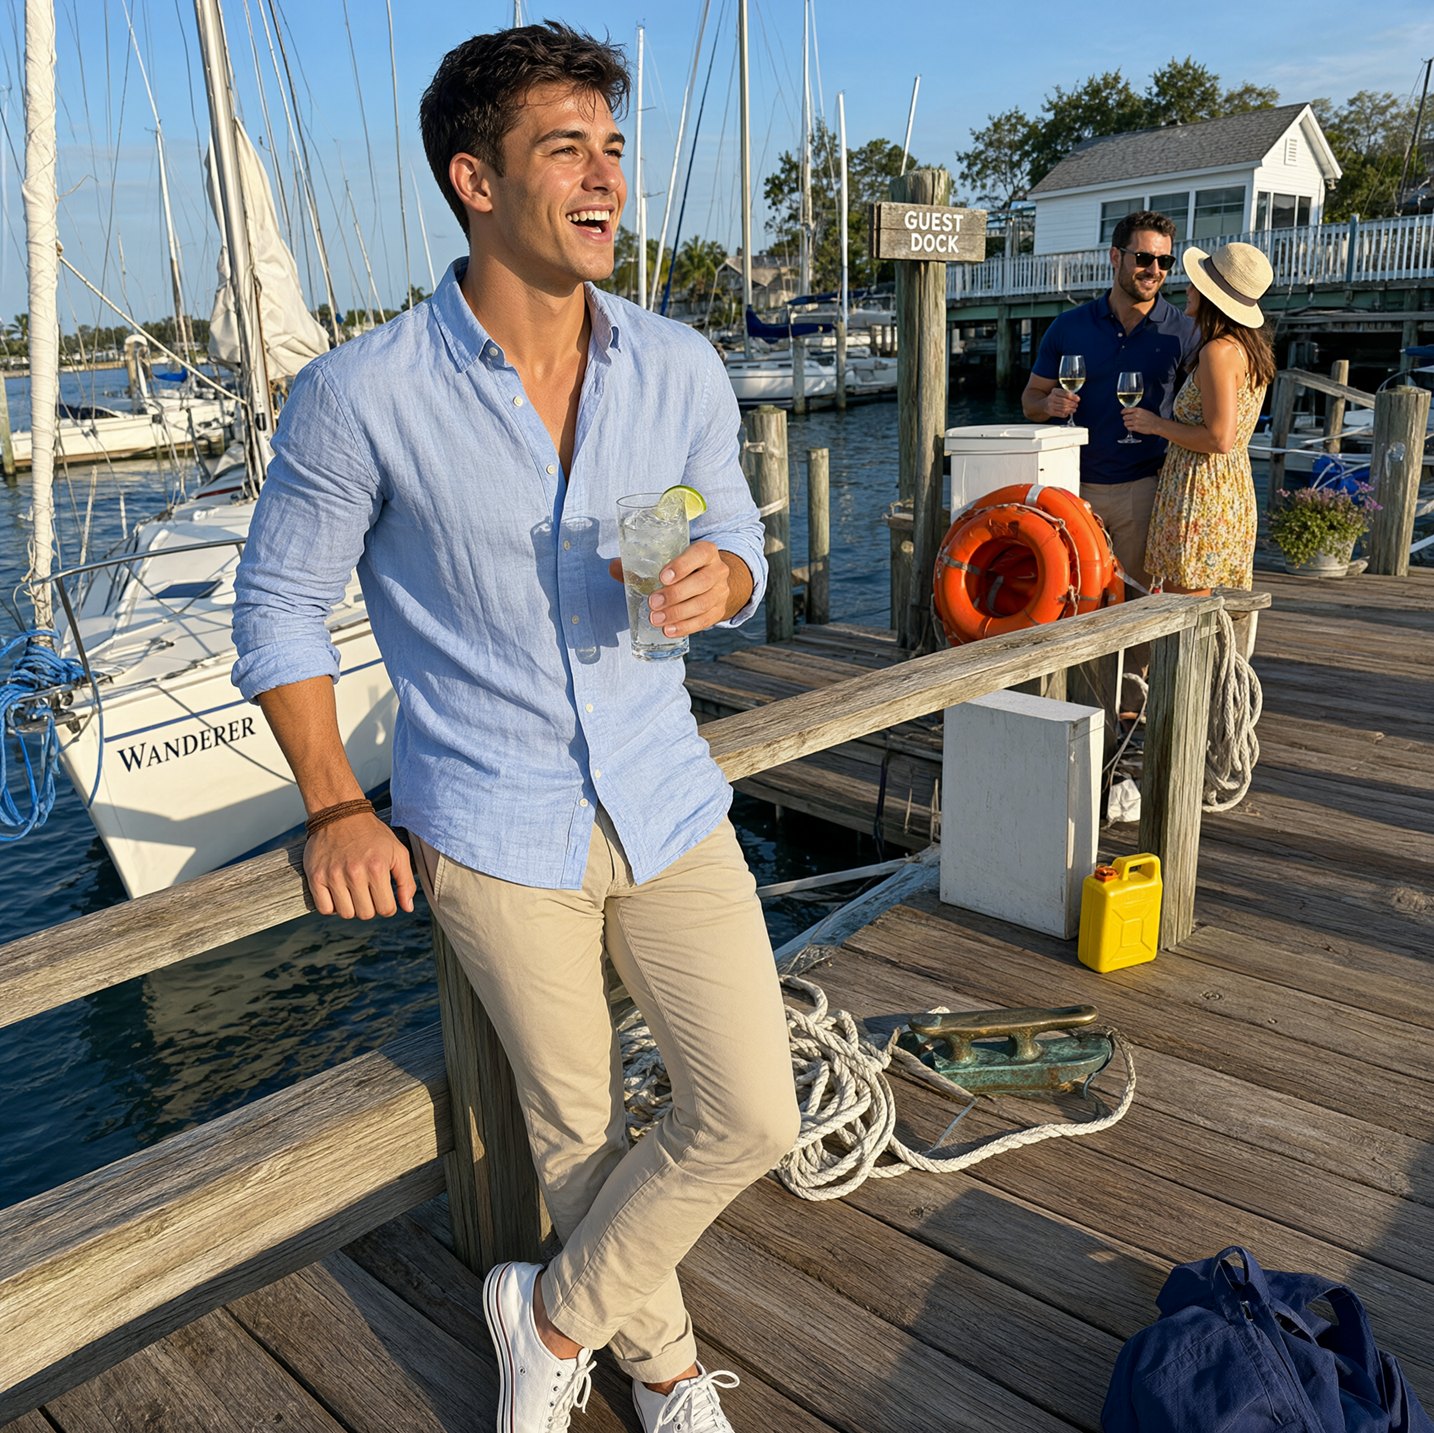
在人物表现上,Qwen-Image-2.1 增强了光影与细节刻画,让人像更具真实质感。
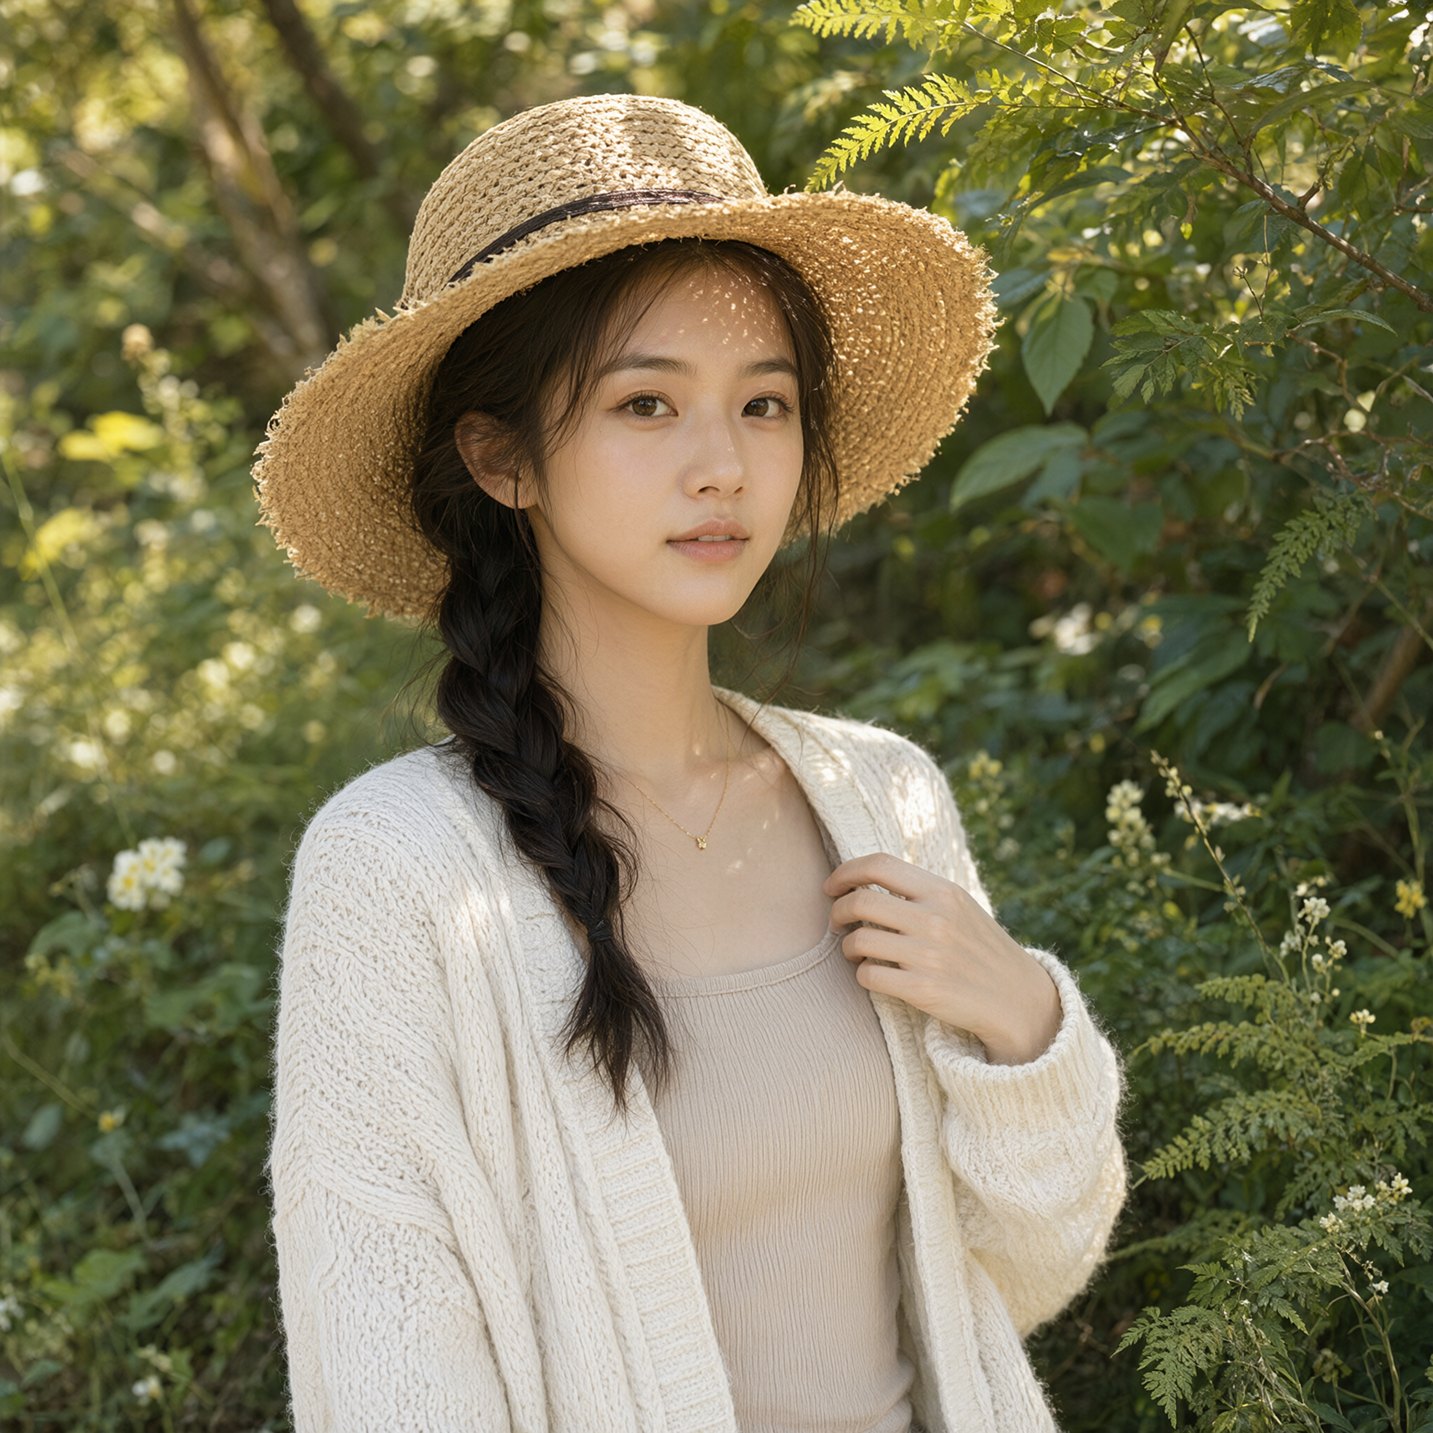
总结
Qwen-Image-2.1 以轻量的 7B 视觉生成模块为基础,将图像生成、透明图像与多种编辑能力整合在同一模型中。通过推理加速、最多 10 张参考图输入、灵活的局部编辑以及更好的人像和商品保真,模型为设计、内容创作、电商与视觉叙事提供了更高效的工具。
以上就是本次更新的主要内容,欢迎体验 Qwen-Image-2.1!
核心总结
- 小模强效:视觉生成部分仅 32 层 Single-Stream DiT、7B 参数,在生成质量与计算成本之间取得平衡;
- 创改一体:文生图与图像编辑合并到同一个模型,原生支持透明图像的生成、编辑与抠图;
- 推理优化:混合粒度注意力(文本 Token 级因果掩码 + 图像 Chunk 级掩码)叠加 KV Cache 复用,多图输入场景提速明显;
- 全能编辑:最多 10 张参考图,支持圈选、涂抹与独立掩码,强化人像与商品一致性,并覆盖全景图、信息图、分镜图等任务;
- 质感提升:细化文字排版与人物光影表现,让生成结果更具美感。
原文:Qwen-Image-2.1:小模强效,创改一体(Qwen Team,2026-09-20)
开源地址:GitHub · Hugging Face · ModelScope


