2026 年 9 月 23 日,卡内基梅隆大学(CMU)教授 Christian Kästner 在其 Substack 专栏《The Last Software Engineer?》撰文,复盘了自己如何改造面向高年级学生的课程《Machine Learning in Production》。他的结论是:当 AI 智能体能完成全部作业时,考核必须从「在家完成的产出」转向「无法外包的现场交互」——而部分改动违背了循证教学的最佳实践,他仍然选择这么做。
五年前的那次提醒,和今天的不得不改
2021 年,早于 ChatGPT 发布,Vincent Hellendoorn 建议他用 GPT-3 试做课程阅读测验。模型在没读过论文的情况下,给出了能通过评分标准的答案。当时他什么也没改。五年后,智能体已经能完成这门课的全部作业,他重新设计了大部分考核,而想让学生学到的东西几乎没有变化。
课程规模通常在 100 至 170 人,学习目标不是写代码或使用特定工具,而是工程权衡、风险预判与团队协作,因此受 AI 冲击相对较小。课堂上学生被允许在任何场景以任何形式使用 AI,无需标注来源,只有笔试与口试除外;他也明确表示,监管 AI 既不可行,学生本来也需要学会负责任地使用这些工具。
AI 正在侵蚀循证教学实践
作者把这一点放在最前面,认为它比具体做法更重要。教育研究的证据更支持频繁、低风险、带反馈的评估(作业、小测验),而非少量高风险考试,但 AI 让低风险场景的练习失去可信度,反而把教学推向考试。
他原本为作业提供「可重交、找回部分分数」的安全网,这是规范评分(specifications grading)与公平评分的核心建议,但该机制被滥用:学生先提交 AI 生成的答案,只看批改意见再重交。现在重交要扣 10%。课堂讨论题也常被整组丢给模型,改用纸笔会带来更高批改负担、更大压力和更慢的反馈,因此他倾向于保留低风险互动,接受「部分学生可能学得不深」的代价。
从书面反思到 15 分钟面谈
所有需要书面文字回答的作业环节都被取消:报告只用于描述方案并链接代码片段,AI 生成的文档可以接受;但「哪些部分最难」「如何改进团队协作」这类反思文档已完全可外包,只要公布评分标准,就没有无法交给模型的部分。
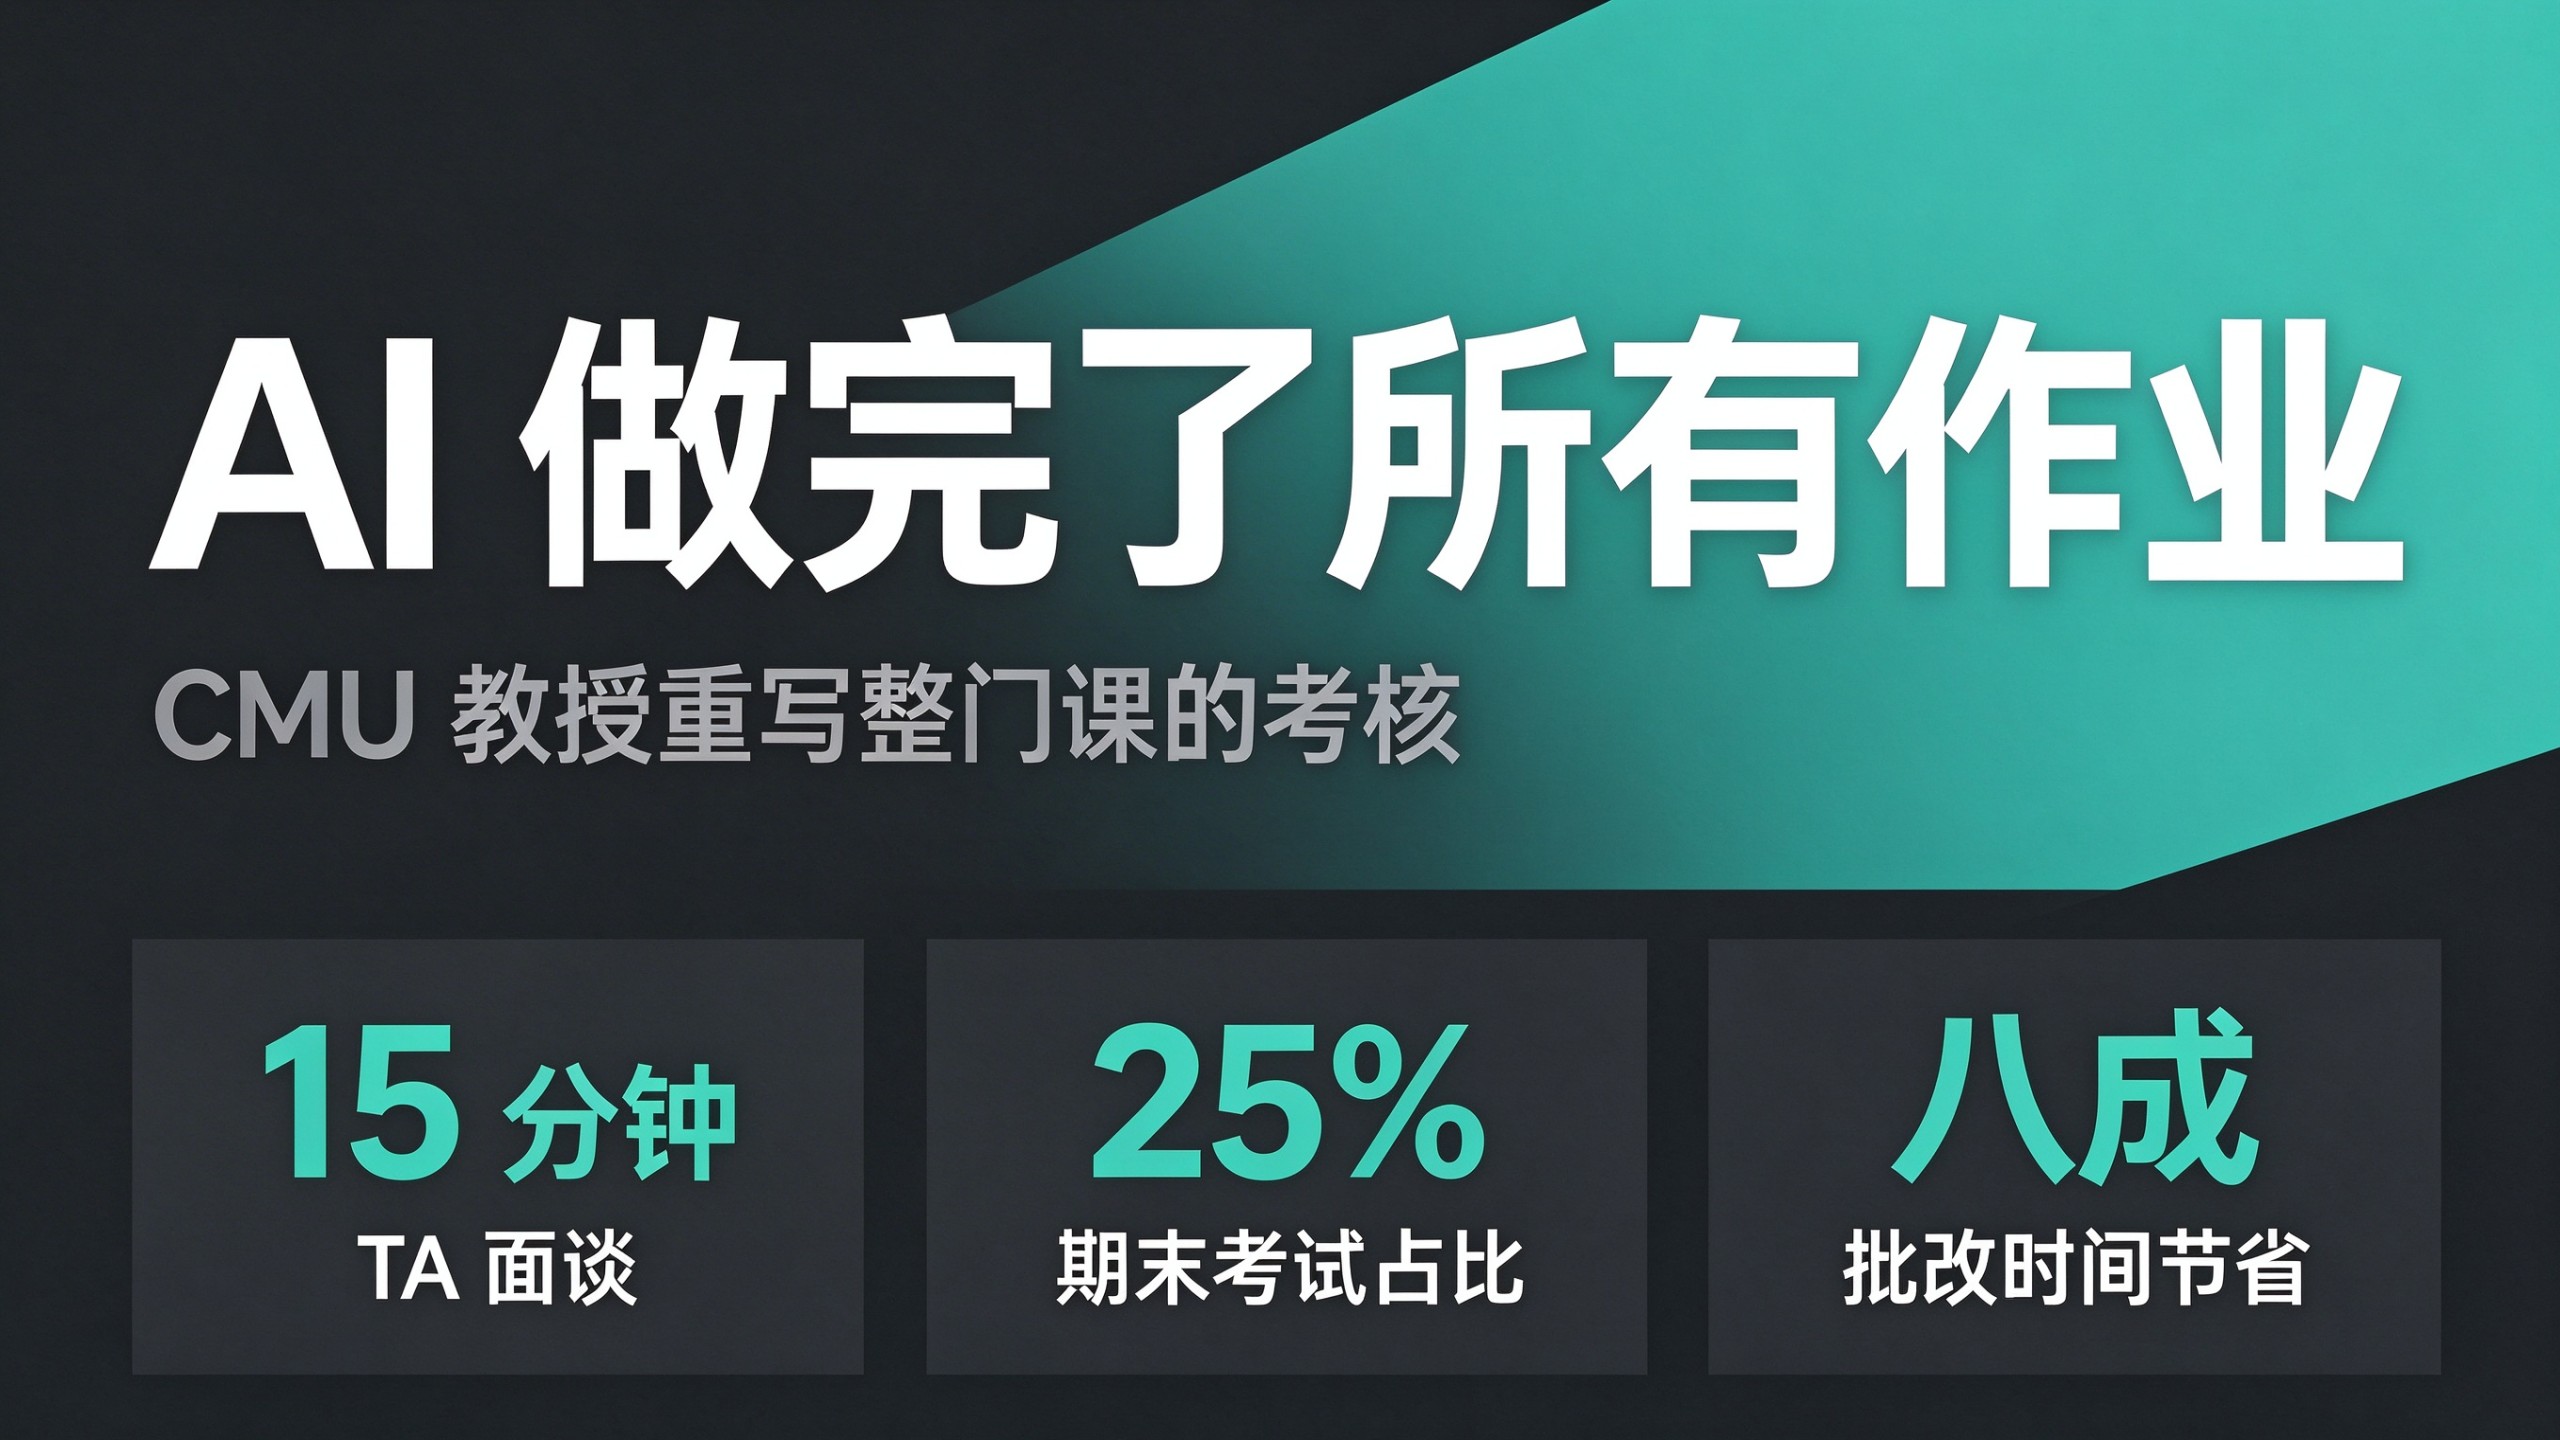
替代方案是每次作业后与 TA 进行 15 分钟面谈,占该次作业分数的 20%,按通过/不通过计分,失败可免费重试,TA 被鼓励保持较高标准;他指出斯坦福 CS221 本学期也在用受控实验评估类似做法。代价是:口语面谈对焦虑学生更不友好,但正式的身心障碍便利安排可提供通路,而且「就技术工作做专业沟通」本身就是学习目标。在 20:1 的师生比与每周约 10 小时 TA 工时下,每两周每人约 300 分钟,规模可行。
阅读测验则被彻底放弃:他仍布置阅读,但数量减半、不计分,改为把论文内容融进课堂讨论。此外,Zoom 线上环节已观察到学生使用 Cluely 之类工具实时作弊,未来的检查很可能只在线下进行。
作业规模随智能体能力上移
旧的第一份作业是给一个 1.2 万行的 Instagram 克隆加上两个 AI 功能,正确解大约 20 行代码,难点在理解代码与依赖;2025 年秋季,Claude Code 仅凭作业说明就能一次做完,连写作与反思一并完成。新作业改为在生产级团队聊天应用 Zulip(超过 50 万行代码)中实现两个 AI 功能,需要数百行前后端改动,智能体必须持续交互才能做对。其他作业也同步加码,例如把手工危害分析改为「为流程写自动化、跑出规模、再筛选结果」。
作者明确不把「如何使用编码智能体」当作教学目标,正如他此前从不教 Python 或 HTML——这是新的默认基线。对于订阅费用带来的公平性担忧,他的类比是:一学期 3 个月约 60 美元,仍低于动辄 100 美元的教材,真正的责任在于学校通过奖学金等方式提供支持。
用 LLM 自动批改,把 TA 时间还给面对面交流
触发点是 TA 的一句抱怨:他看到提交信息里写着「Authored by Claude Code」,觉得自己在徒劳地批改。现在课程用 LLM 作为评审(LLM-as-a-judge)按评分细则自动批改代码与报告,输出「通过」或「需要人工复核」,TA 抽查少量「通过」结果,主要精力放在「需要复核」的答案上;扣分前必须有人类看过。结果是 TA 批改时间减少 50% 至 80%,腾出的时间用于与学生面对面交流。
同样的机制被用于课堂讨论:学生在 Slack 里提交 breakout 讨论答案,自建机器人用不公开的评分维度给出反馈并鼓励修改,随后再给一轮反馈;这套反馈器也开放给学生备考使用。考试占比已从 15% 提高到 25%,面谈与答辩式讨论占作业和小组分的 10% 至 20%,如今分数区分度主要来自考试。
让学生被「自信的错误」烧一次
作者希望在作业中刻意埋下智能体会自信答错的点,实际中已偶然收获几例:ChatGPT 在 Jackson「世界与机器」的划分上把硬件归错位置,即便提供全文也一样;此前约 20% 的学生会犯这个错,引入 ChatGPT 后升到 80%,即使提前明确警告也只降到 50%。Claude Code 则坚持一个听起来漂亮、实际完全不安全的「两阶段确认协议」方案,最初 80% 的学生中招——包括大多数 TA,最终不得不整份作业重新评分。
在他看来,这类失败之后的复盘正是讨论自动化偏见(automation bias)与人类监督难度的好机会。课程设有可重交的安全网,多数学生初次失败不会影响最终成绩。他也坦承无法真正衡量学习效果:成绩分布不是有效信号,能观察到的只是学生接受新形式,同时又会抱怨同学把思考外包给 AI。
核心总结
- 考核重心转移:放弃所有在家完成的书面考核,改为 15 分钟 TA 面谈、课堂考试与功能演示视频
- 被迫取舍:频繁低风险评估、免费重交等循证做法被 AI 削弱,重交改为扣 10%,阅读测验直接取消
- 作业加码:从 1.2 万行玩具项目换到 50 万行的 Zulip,要求智能体必须交互才能完成任务
- 批改自动化:LLM 按细则初判「通过/需复核」,TA 批改时间减少 50% 至 80%,但扣分必须经人工确认
- 分数结构:考试占比 15% → 25%,课堂环节权重上升,区分度主要来自考试
- 持续衰减:Cluely 作弊、能绊倒智能体的问题随模型升级失效,每学期都要重新检查哪些考核还能存活
原文:How I changed teaching after AI managed to do all my homework assignments(The Last Software Engineer?,2026-09-23)


