9 月 10 日,SGLang 与 Miles 团队在 LMSYS 博客联合发布技术文章,详解 DeepSeek-V4.1 上线当天完成的 Day-0 支持。DeepSeek-V4.1 在注意力结构、残差连接和记忆机制上都做了大幅改动,推理栈与训练栈都必须跟着重做:SGLang 侧围绕 Engram 表的放置、滑动窗口注意力的前缀复用、以及一系列内核融合展开优化;Miles 侧则用 Megatron-Core 插件把共享注意力状态、mHC 与 Engram 记忆落到训练后端,并把重点放在缩小训练器与 rollout 之间的 log-probability 差异上。
1. 架构总览
DeepSeek-V4.1 引入了若干影响服务栈设计的架构选择。
低压缩比与滑动窗口注意力(SWA)。 每一层都为最近 128 个位置维护一份 fp8 滑动窗口缓存,同时由部分「源层」为长程注意力产出 fp4 的压缩表示。从第三层开始,每个 query 会同时关注自己的局部窗口,以及由 indexer 选出的最多 512 个压缩位置。第 2–19 层使用成对(pairwise)压缩,因此 KV 源层必须在解码步之间保留不完整的配对。
压缩 KV 与检索结果的选择在层间共享,详见第 2 节。
流形超连接(mHC, manifold hyper-connections)。 每个子层通过依赖 token 的混合系数,从四条并行残差流中读取并写回。一个子层消费其前驱产出的系数,从而让下一组系数投影与当前的注意力或 FFN 计算重叠。
Engram 记忆。 第 1 层与第 14 层从两张大型 fp8 表中,按哈希后的 token n-gram 检索行,并把选中的行门控进残差流。每一步只读取少量行,因此表的放置位置与查找开销比稠密计算更关键。
2. 跨层共享与稀疏检索
共享 KV 与 indexer key。 四个 KV 源层负责产出压缩 KV 与 indexer key,消费层直接从最近的 KV 源读取,避免在每个消费层单独存储和生成。窗口 KV 仍然为各层独有。
两级选择的共享候选。 第 20 层为每个 query 选出最多 2,048 个「每块 8 个位置」的块,并总是保留包含最新位置的那一块。它把这些候选发布给后续的 index 源层,同时从所有可达位置中选出自己的 top-512。后续 index 源层则把 top-512 限制在共享候选之内。当所有可达位置都落在 16,384 的预算内时,候选过滤不会排除任何位置。
跨层复用选择结果。 八个 index 源层用自己的 query 给 indexer key 打分,为每个 query 选出最多 512 个压缩位置。其余压缩注意力层则直接复用最近一次的选择结果,不再运行 indexer。
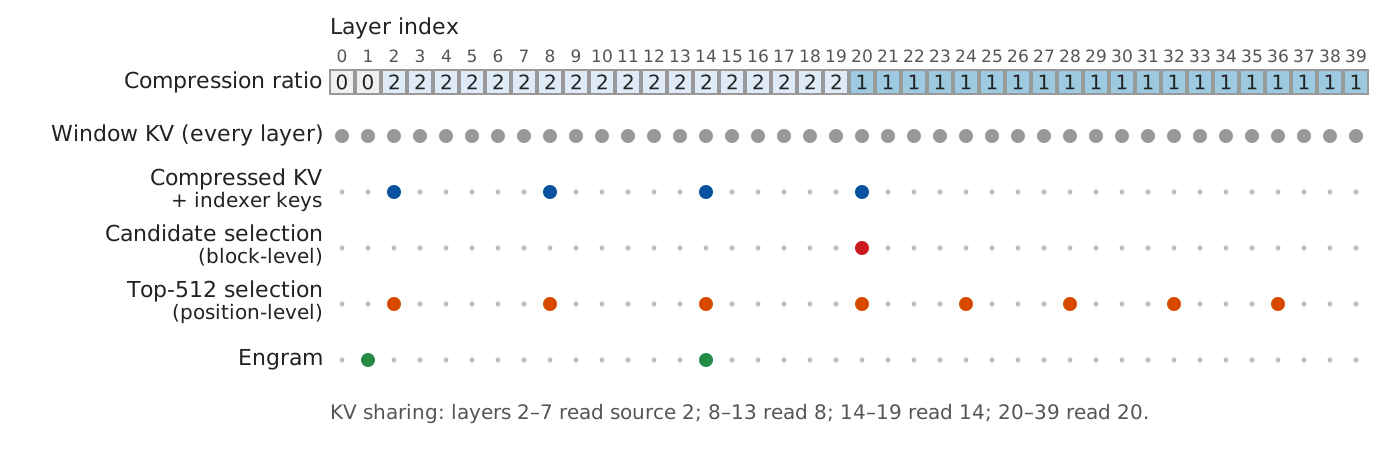
图 1:层角色与跨层共享。
3. Engram 优化
Engram 是 DeepSeek-V4.1 的核心组件。它的两张 fp8 表包含 189 GiB 权重,但每个解码步只读取少量行。SGLang 支持把这些表放在 GPU 或主机内存中。把表分片到四张 GPU 上,意味着每张 GPU 的 HBM 各存四分之一,且每次查找都需要一次 all-reduce 来汇总结果。
3.1 主机内存放置
主机卸载(host offload)把 Engram 表移出 GPU 内存,为 KV 缓存释放容量;反量化、门控与 value 投影仍留在 GPU 上。SGLang 支持两种主机布局,通信开销各不相同。
在主机分片布局(host-sharded layout)中,每个 TP rank 在主机内存中持有一个分片,查找仍保留 all-reduce。在共享主机布局(shared host layout)中,所有 TP rank 访问主机内存中完整的一份表,每个 rank 自行收集(gather)所需的所有行,从而消除查找时的 all-reduce。
对大型表做随机访问可能受地址转换限制,用大页(huge page)承载可以降低这部分开销。在被评测的 GB300 容器中,主机分片表使用支持大页的匿名映射(anonymous mappings),而共享映射则不支持。因此自动布局选择挑了主机分片,以保留 all-reduce 为代价换取更快的主机查找。最佳放置方式取决于 CPU–GPU 互联、大页可用性与具体工作负载。
3.2 性能评测
在 4× GB300(TP4/EP4)上的配对测试中,主机卸载把 KV 缓存容量提升了 36%,解码吞吐与 TTFT 基本持平。这些测试使用带大页承载的主机分片表,并保留查找 all-reduce。全部 28 次贪心探测补全都与基线一致。
要把 Engram 表放到主机内存,设置 SGLANG_ENABLE_DSV41_ENGRAM_HOST_TABLE=1。
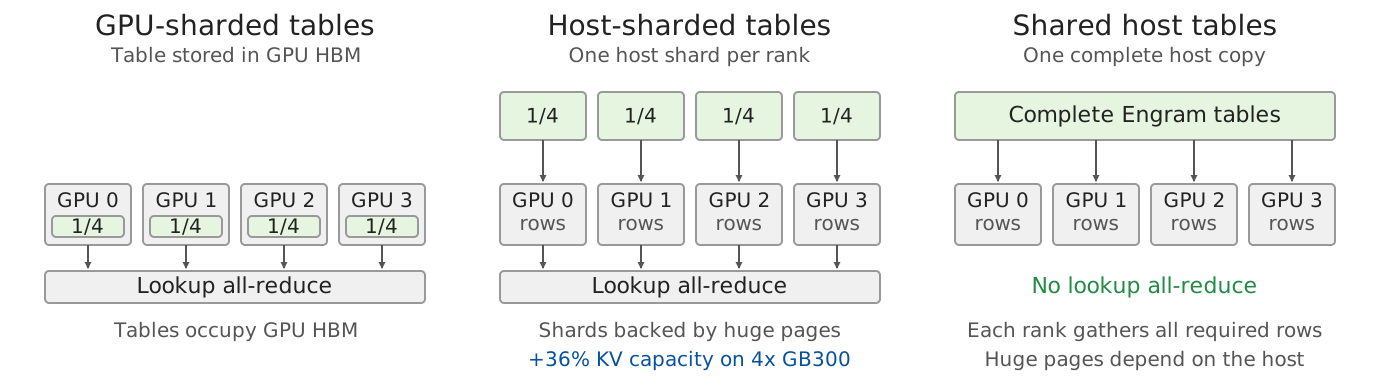
图 2:TP4 下的 Engram 放置与查找通信。
4. SWA 有界重放
滑动窗口 KV 为各层独有。为前缀复用而保留它会消耗缓存容量,而全序列 prefill 又会计算后续解码不再直接访问的窗口状态。模型的部署说明提出了「有界重放(bounded replay)」来降低这些存储与计算成本。
4.1 编码器侧有界重放
标准的前缀复用需要已缓存的压缩 KV、indexer key,以及一个有效的滑动窗口检查点。编码器侧有界重放取消了检查点的要求:前缀缓存保留压缩 KV 与 indexer key,而每个活跃请求各自维护一个 128 位置的窗口。
命中缓存时,SGLang 重新计算已缓存前缀的最后 128 个 token,以重建窗口 KV,而已缓存的压缩 KV 与 indexer key 保持不变。这用有界的重算换来了更低的缓存存储,并让前缀复用不再依赖匹配位置上的窗口检查点。
4.2 解码器侧「只算尾部」
第 20 层是最后一个压缩 KV 源。第 21–39 层复用它产出的压缩 KV 与 indexer key,同时计算自己的窗口 KV。对每个 prefill chunk,SGLang 对全部 token 执行第 0–20 层,而第 21–39 层至多处理每个请求的最后 128 个 token。
第 0–20 层保留全上下文计算。在靠后的层中,由于该边界之前的窗口 KV 不再计算,局部注意力被限制在保留的尾部。
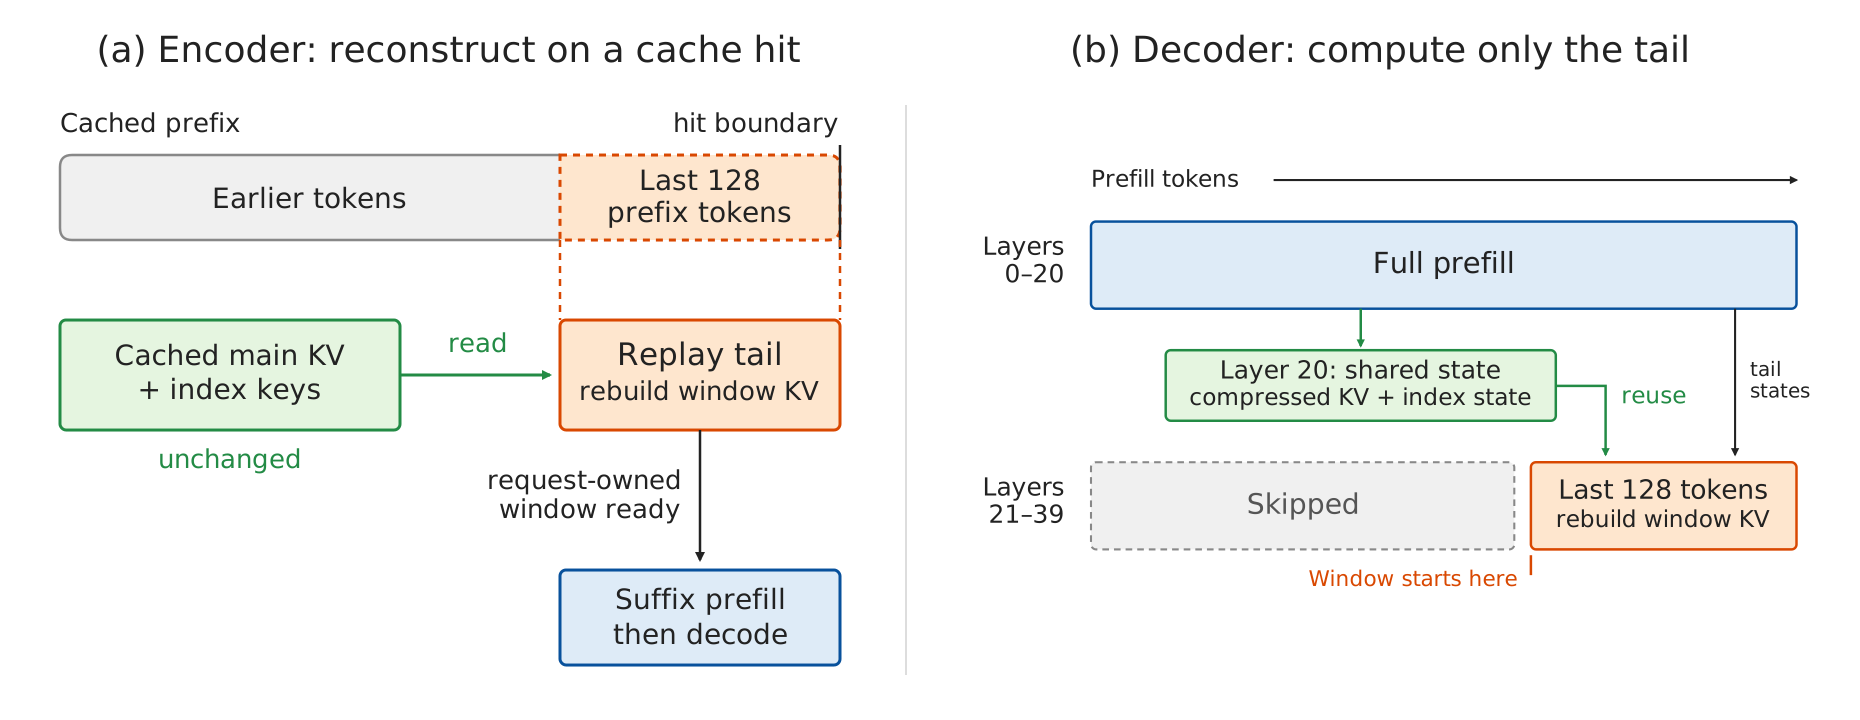
图 3:编码器侧重建与解码器侧「只算尾部」的 prefill。
4.3 正确性边界与结果
两种模式都会在重建边界处截断局部注意力,因此即使已缓存的压缩 KV 没有变化,重算出的隐状态也可能与全量 prefill 不同。有界重放是一种近似,其质量必须实测评估。
在每批 8 条 8K-token 提示词的配对测试中,解码器侧重放把 prefill 吞吐在 8× H200 上提升 1.56 倍、在 4× GB300 上提升 1.37 倍。在 4× GB300 上,配对的 AIME 2026 评测测得重放开与关的 pass@1 相同(均为 453/480 正确样本)。
两种模式都是可选项(--enable-encoder-swa-bounded-replay、--enable-decoder-swa-bounded-replay),且可以组合使用。编码器重放不兼容投机解码;解码器「只算尾部」不支持输入 logprobs 与完整 prompt 隐状态捕获。
5. 内核与执行优化
mHC 执行与数值一致性。 前驱预混合(predecessor pre-mix)让下一个子层的混合系数可以与当前注意力或 FFN 一起计算,SGLang 让这部分工作重叠执行,并把混合统计量的归约与 Sinkhorn 迭代融合。这些归约使用与批大小无关的固定顺序,使每个 token 的混合系数在不同批次组成下保持一致。小批量时,HC=4 的后混合(post-mix)会沿隐藏维度做 tiling,以暴露更多并行工作。
FP4 索引与 TP 布局。 indexer 打分会直接从 FP4 缓存读取。indexer head 在各 TP rank 上复制,因为对这种 MQA 形态的操作做分片并不会减少 key 带宽,反而会引入一次分数 all-reduce,且其规模随上下文长度增长。
保持量化语义的融合。 indexer 把 RoPE、FP4 量化与打包/缓存写入合并进融合内核。融合必须保留原计算中的中间舍入与缩放:去掉一次中间内存写入,不等于可以去掉它的数值影响。这在减少内核启动次数与中间内存流量的同时,保持了量化序列不变。
低压缩比。 压缩器投影使用 BF16 检查点权重,配合 FP32 累加与输出。ratio-2 的解码池化被融合进单个内核,合并每一对已完成位置。压缩与索引在输入就绪后也会与注意力准备工作重叠,并在注意力消费其输出之前完成汇合。
单 token 投影与 Engram 融合。 分组输出投影对单 token 输入使用专门的 BF16 矩阵-向量内核,因为通用矩阵乘法路径在这种情形下 GPU 利用率很低。融合的 Engram 门控减少了 FP32 临时存储,n-gram 哈希也在单个内核中计算。这些优化针对的正是每个解码步都会反复出现的「小型投影 + 稀疏内存操作」。
6. Miles 中的强化学习
Miles 为 DeepSeek-V4.1 提供了 Megatron-Core 插件,并使用 SGLang 做 rollout。训练后端实现了模型的共享注意力状态、mHC 与 Engram 记忆。一个核心目标,是最小化训练器与 rollout 对同一批响应给出的 log-probability 差异。
并行与共享状态。 后端支持 DP、TP、SP、EP、PP 与 CP。TP 和 SP 划分注意力投影与压缩器分组。流水线边界需要携带全部四条 mHC 残差流、前驱混合系数,以及下游消费方仍然需要的注意力状态。这些状态也让重算的层能在本地恢复自己的输入。上下文并行让 query 保持本地,同时跨 rank 收集窗口 KV、压缩 KV 与 indexer key,以完成全局稀疏检索。
量化感知训练。 训练前向复现了服务引擎对压缩 latent、indexer query 与 key 的 FP4 舍入,以及对窗口缓存的 FP8 舍入。直通(straight-through)梯度让优化可以穿过这些离散操作。窗口缓存在前向值上使用引擎的分页缓存内核,同时用一份可微的模拟实现来承载梯度。稀疏注意力与索引复用 DeepSeek-V4 插件的 TileLang 内核;RoPE 与伪量化(fake quantization)遵循服务端的公式。
路由重放(routing replay)。 Rollout Routing Replay 把采样得到的专家分配喂给训练器的 MoE 层,避免路由打平时选中不同的专家路径。indexer top-k 则是重新计算而非存储重放:一旦其量化输入匹配,重放就没有带来可测量的对齐收益,这样也省去了为每个 rollout token 保留逐层选择结果。
数值一致性。 压缩器门控、归一化统计量、mHC 混合、Engram 门控与 attention-sink 累加都使用 FP32,并在操作边界处做类型转换。压缩 KV 投影的梯度 all-reduce 同样使用 FP32。确定性的归约与矩阵乘法设置让重复前向可复现,有助于把执行波动与训练器–rollout 之间持续存在的差异区分开。
训练与 rollout 同机部署。 训练与 rollout 在 16 张 GPU 上交替进行。优化器动量(optimizer moments)流式写入节点本地 NVMe,rollout 引擎恢复前会先卸载训练器状态。更新后的 BF16 权重在每个训练步之后按 bucket 传输。冻结的 FP8 Engram 表使用主机内存承载,并排除在权重同步之外。后端通过其 model bridge 直接加载 Hugging Face 检查点。
6.1 已验证的一次运行
图 4 展示了在 16 张 GB300 GPU(TP4、EP16、每步 128 个样本)上,用 DAPO-Math-17K 数据集、响应上限 2K token 做 DAPO 训练的第 0–80 步。前五个步与后五个步的平均 reward 分别为 0.51 与 0.78。在绘制的区间内,训练器与 rollout 之间的 per-token KL 在 0.0012 至 0.0017 之间,log-probability 的平均绝对差在 0.017 至 0.025 nats 之间。
这次运行中,测得的差异始终很小、没有出现持续增长。不过这些测量并未定位差异的成因,也没有确立数值等价。整个运行完成了 120 步以上且未出现失败。
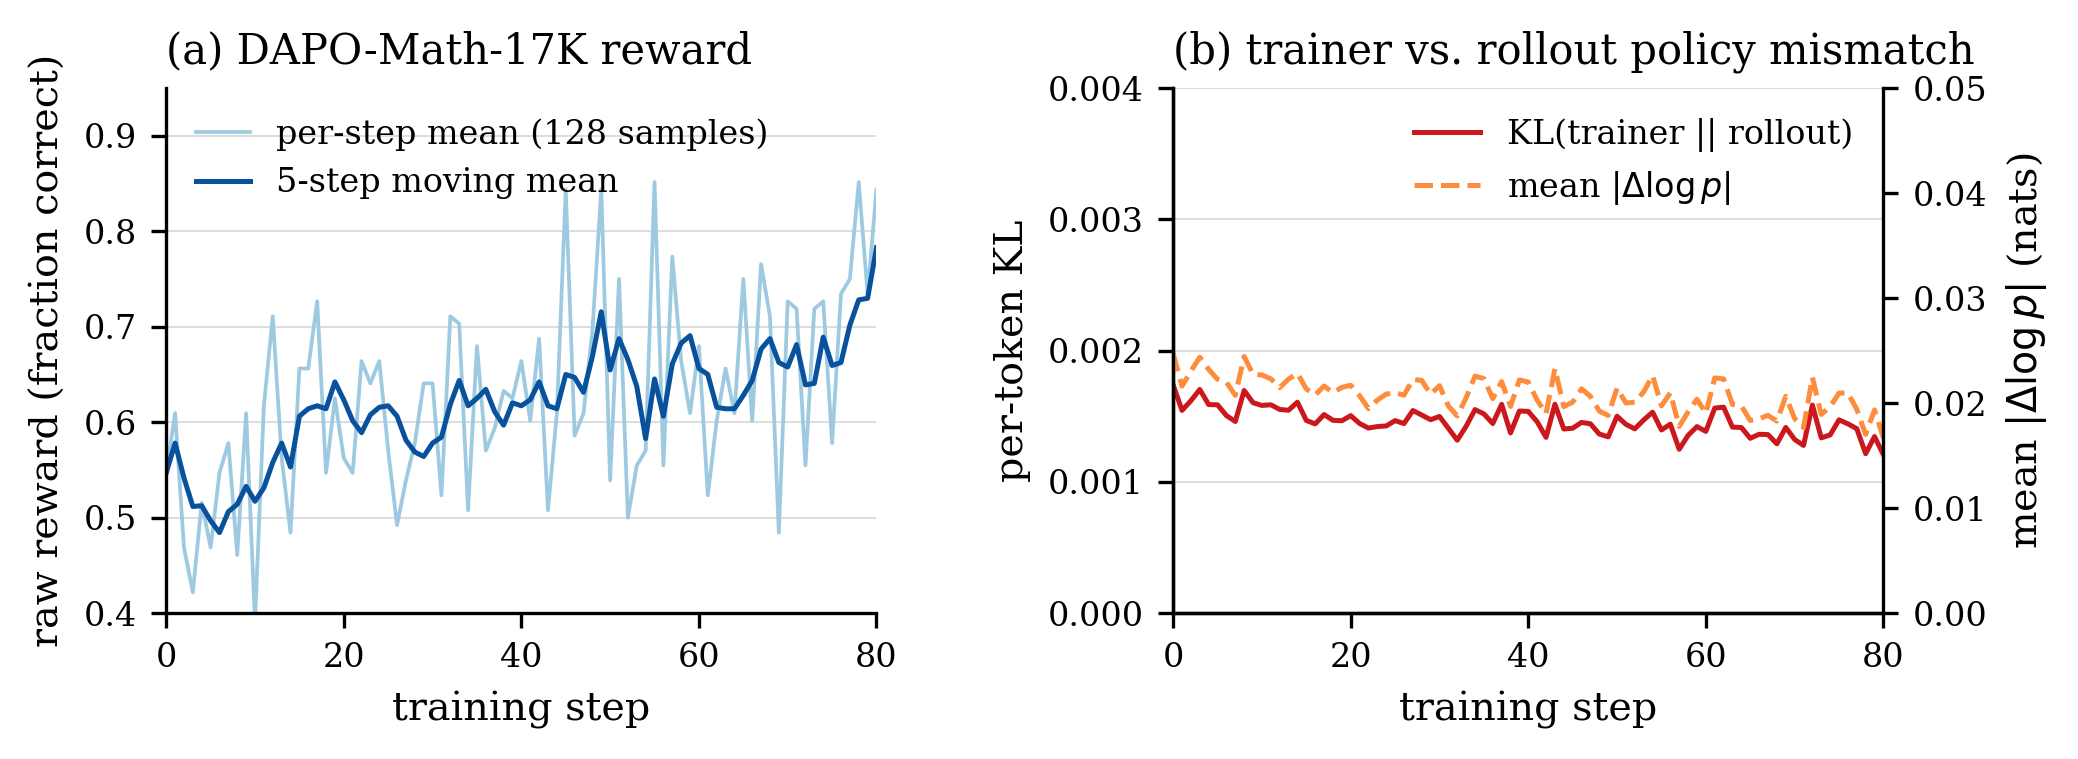
图 4:第 0–80 步的 DAPO reward 与训练器–rollout 差异。
7. 致谢
感谢 DeepSeek 团队带来 DeepSeek-V4.1,也感谢 SGLang 与 Miles 的贡献者与审阅者完成了本文所述的模型集成、优化与验证工作。
核心总结
- 架构:DeepSeek-V4.1 把 fp8 滑动窗口缓存、fp4 长程压缩表示、流形超连接(mHC)与 Engram 记忆揉进同一套服务栈,迫使推理侧重做 KV 与检索的共享策略
- Engram:两张 fp8 表共 189 GiB,主机卸载后 KV 缓存容量提升 36%,解码吞吐与 TTFT 持平;4× GB300 上自动选择了保留 all-reduce 的主机分片布局
- SWA 有界重放:编码器侧重算前缀最后 128 个 token 以重建窗口 KV,解码器侧后 19 层只处理尾部 128 个 token,prefill 吞吐在 8× H200 上提升 1.56 倍、4× GB300 上提升 1.37 倍,AIME 2026 pass@1 持平
- 内核:mHC 预混合重叠、FP4 直接索引、保持量化语义的融合内核、单 token BF16 矩阵-向量内核与 Engram 门控融合
- Miles 训练:量化感知训练复现服务的 FP4/FP8 舍入,路由分配重放、indexer top-k 重算;16 张 GB300 上跑 120+ 步 DAPO 无失败,per-token KL 稳定在 0.0012–0.0017
这次支持的价值在于「发布当天就能跑」:文章里的每一项优化都配了配对测试或正确性检查,有界重放这类近似方案也明确标注了适用边界与不支持的场景。对准备部署 DeepSeek-V4.1 的团队,主机内存与大页的可用性值得提前确认——它直接决定了 Engram 表该放在哪里。
原文:SGLang and Miles Add Day-0 Support for DeepSeek-V4.1(LMSYS Blog · SGLang and Miles Teams,2026 年 9 月 10 日)


