2026 年 3 月 22 日,RightNow AI 在 arXiv 发布论文《AutoKernel: Autonomous GPU Kernel Optimization via Iterative Agent-Driven Search》,并把整套系统以 MIT 协议开源(GitHub 上已获得 1.6k star)。它的主张很直白:写一个能跑满张量核心的矩阵乘法 kernel 要耗掉专家数周时间,但专家的工作流本身其实就是一个循环——写一版、跑基准、留下更好的、丢掉更差的、重复。AutoKernel 把这个循环交给一个编码智能体,配上一套它自己绝对改不动的评测基准,让它在无人值守的情况下整夜迭代。
论文给出的效果是诚实而非营销化的:在 H100 上,RMSNorm 比 PyTorch eager 快 5.29 倍、Softmax 快 2.82 倍、交叉熵快 2.21 倍,16 个代表性配置中有 12 个胜过 torch.compile(max-autotune);但矩阵乘法仍然落后 cuBLAS 数倍,旋转位置编码在两个配置上甚至慢于 torch.compile。社区的两次战果更抢眼:一次整夜运行让一个归约 kernel 拿下 NVIDIA B200 榜首,一次约 3 分钟的单轮提示生成了比 CUTLASS 快 1.63–2.15 倍的 FP4 矩阵乘法。
为什么写 kernel 这件事值得自动化
大模型在 GPU 上的运行时间被一小撮 kernel 支配:注意力和前馈层里的矩阵乘法通常吃掉 60%–80% 的 GPU 时间,归一化、softmax 与位置编码占据剩下的大部分。cuBLAS、cuDNN 这类厂商库覆盖了常见情形,但深度学习架构的迭代速度一直快过库的覆盖速度——分组查询注意力、SwiGLU 激活、旋转位置编码、RMS 归一化,都是先在生产模型里落地、之后才等到专门库支持。
而把默认库性能推向硬件极限,需要的是很深的微架构功底:算术强度与 roofline 模型、访存合并与共享内存 bank conflict、寄存器压力与占用率的权衡、tile 尺寸与 L2 缓存的相互作用、warp 级同步、张量核心指令的选择。一个高性能 matmul 往往有两百多行 CUDA 或 Triton 代码和几十个互相牵制的参数,这种专家稀缺,调优过程也难以规模化。
KernelBench 系统性地问过「大模型到底会不会写 GPU kernel」。答案并不乐观:即便最好的模型,用一次性生成的方式,也只有不到 20% 的情形能追平 PyTorch 基线。后续研究转向多智能体协作、进化搜索、硬件反馈闭环、强化学习等更复杂的架构来抬高这个数字。
AutoKernel 反其道而行:与其搭建多智能体协作,不如承认专家的工作流本来就是一个简单循环。系统由 9,200 多行 Python(14 个核心脚本)、9 个 Triton 加 9 个 CUDA C++ 起步 kernel、4 个自包含模型定义和一份 909 行的智能体指令文档 program.md 组成。
系统怎么组织:三阶段流水线
阶段 A 是唯一需要人参与的部分,大约 15 分钟。1,125 行的 profile.py 用 torch.profiler 记录每个 CUDA kernel 的 GPU 时间,再按名称模式把它们归到九种算子类型。这里有个不起眼但必要的工程细节:分类器要能同时认出 cuBLAS 的 GEMM 变体、CUTLASS kernel、Triton 编译出来的函数和 ATen 算子,它们的命名规则各不相同,却对应同一个算子类型。剖析器还内置了已知 GPU 规格库(NVIDIA 从 H100 到 RTX 3080,AMD 从 MI300X 到 MI355X);遇到不在库里的卡,就用 SM 数量、时钟频率和计算能力估算峰值 FP16 吞吐。ROCm 场景下设备名常常为空,于是改用 gcnArchName(如 gfx942)来识别。
648 行的 extract.py 随后把每个瓶颈抽成一个可独立优化的文件:自带起步实现、模型专属的形状(以及半尺寸与双尺寸变体)、供 roofline 使用的 FLOPS / BYTES 公式,还有按精度分化的容差。
一次迭代 90 秒:循环的全部规则
阶段 B 是整个系统的核心,可以完整地写成下面这段伪码:
k_best, t_best = k, bench(k)                     # 建立基线
n_revert = 0
for i in range(1, INF):
    k_prime = agent.edit(k_best, history, roofline)  # 只改 kernel.py
    git_commit(k_prime)                              # 改了就先提交
    ok, t = bench(k_prime)                           # 五阶段正确性 + 性能
    if ok and t > 1.01 * t_best:
        k_best, t_best, n_revert = k_prime, t, 0     # keep
    else:
        git("reset", "--hard", "HEAD~1")             # revert
        n_revert += 1
    log_tsv(i, t, decision, description)
    if move_on(n_revert, t_best, elapsed):           # 见下文四条移动条件
break单文件不变式是整个设计的地基。智能体每轮只动 kernel.py 一个文件,这使得 diff 足够小、回退足够干净,也避免多处在同一轮里耦合改动、导致回归时无法定位成因。每次实验都对应一个 git 提交:保留就留在分支上,回退就用 git reset --hard 抹掉,实验历史可以直接用标准 git 工具翻阅。这个「可变代码 + 固定评测」的组合还隔绝了一类真实风险——当候选方案的生成者同时掌握打分的权力时,评测被「优化」而不是被通过是很容易发生的事。
90 秒的时间预算被明确地拆成三段:约 30 秒跑五阶段正确性检查,约 30 秒用 Triton 的 do_bench 测性能,约 30 秒留给智能体推理和改代码。每小时约 40 次实验,10 小时的一夜就是 300–400 次实验。
文档里以「硬规则」的口吻列出了十几条约束,违反其中任何一条都算 bug:bench.py、reference.py、prepare.py、verify.py、profile.py、extract.py、orchestrate.py 一律不得修改;不得新增依赖;不得跳过正确性;显存占用不得超过 GPU 的 80%;性能持平时更简单的代码胜出;一次只优化一个 kernel。这些规则的共同目的,是让评测函数在整个搜索过程中保持不可动摇。
五阶段正确性护栏
「快但错的 kernel 会被立刻回退」是整套系统的安全底线。bench.py(1,416 行)把正确性拆成五道关卡,全部通过之后才允许测量吞吐。
| 阶段 | 做什么 | 挡掉什么 |
|---|---|---|
| 1 · 冒烟测试 | 单个小输入(如 128³),容差比常规更紧 | 编译错误、形状不匹配、粗粒度数值 bug;1 秒内即出结论 |
| 2 · 形状扫描 | 8–10 组形状 × 3 种精度(FP16 / BF16 / FP32) | 边界处理与 tile 余数逻辑、只在特定尺寸下出现的错误 |
| 3 · 数值稳定性 | 对抗性输入:上溢、下溢、极端动态范围、混合尺度 | 参考实现干净而候选 kernel 冒出的 NaN / Inf |
| 4 · 确定性 | 同一输入连跑 3 次,要求输出逐位一致 | 并行归约中的竞态、非确定性的原子操作 |
| 5 · 边界用例 | 非 2 的幂尺寸:1023、1537、4097 | 掩码逻辑 bug、tile 余数处理错误 |
以矩阵乘法为例,形状扫描会覆盖从 128³ 的「最小可用」一路到 4096³ 的压力测试,中间夹着 8192×1024×1024 这种非方阵、K=8192 的大归约维度,以及 4096×4096×512(注意力形态)和 4096×11008×4096(前馈层形态)。容差按精度分化:FP16 用 atol=1e-2,BF16 用 2e-2,FP32 用 1e-4;在对抗性输入下再放宽 10 倍。论文报告,全部 34 个配置在五个阶段上零失败。
优化手册:六层 playbook
program.md 里最值钱的部分是一份把专家经验编码成智能体可读文本的优化手册,按收益与风险从低到高排列:
| 层级 | 典型手段 | 论文给出的经验收益 |
|---|---|---|
| 1 · 块大小调优 | 沿 2 的幂扫描 BLOCK_SIZE_M/N/K(16 → 256)、尝试矩形 tile、联动调 num_warps 与 num_stages | 10%–50% |
| 2 · 访存优化 | 合并访存、用 tl.prefetch 做软件预取、L2 swizzle 重排 tile 顺序、共享内存每行加一个元素消 bank conflict | 10%–30% |
| 3 · 计算优化 | tl.dot(..., allow_tf32=True) 走 TF32、把 bias 与激活融进 epilogue、把循环不变量提到外面 | 5%–15% |
| 4 · 高级技术 | split-K 拆分归约维度、persistent kernel 按 SM 数启动、triton.autotune 自动搜索、warp specialization | 5%–20% |
| 5 · 架构特定 | Hopper 上用 TMA 与 WGMMA、Ampere 上用 cp.async、消费级卡收小 tile 与流水级数 | 5%–15% |
| 6 · 算子特定 | 注意力用在线 softmax、归一化用 Welford 单趟算法、tall-skinny matmul 用 split-K | 因算子而异 |
切换到 CUDA C++ 后端时还有另一套对应的六层手册,手法更贴近硬件:用 __launch_bounds__ 控制寄存器分配、用 float4 / half2 做向量化加载、用 wmma 的 16×16×16 张量核心分片、用双缓冲共享内存隐藏访存延迟、用 cp.async 做异步拷贝、用 __shfl_xor_sync 做 warp 内归约。手册同时明确列出一批反模式:512 以上的超大块会因寄存器溢出而崩掉、num_stages 超过 5 会撑爆共享内存、K 循环里的分支会杀死性能、忘了 __restrict__ 会阻断编译器优化。
谁先优化:用 Amdahl 定律当调度器
多 kernel 场景下,orchestrate.py 用 Amdahl 定律分配精力:
S = 1 / ((1 − f) + f / s)其中 f 是该 kernel 占总 GPU 时间的比例,s 是它在自身上的加速比。在占 60% 时间的 kernel 上拿到 1.5 倍,端到端就是 1.25 倍;在占 5% 的 kernel 上拿到 3 倍,端到端只有 1.03 倍。所以一个只占 5% 却已被优化到 5.29 倍的 RMSNorm,价值远不如占 62% 的 matmul 上那个不起眼的 1.3 倍。
调度器在四种情况下判定「该换下一个 kernel」:连续 5 次回退(进入平台期)、已达到理论峰值的 90%、单个 kernel 用满 2 小时、或已经拿到 2 倍加速。它还会给出 what-if 投影——如果前 1 / 3 / 5 / 10 个 kernel 分别达到 1.5×、2×、3×、5×,端到端各自能到多少——供人在阶段 A 确认计划时参考。
双后端:Triton 起步,CUDA C++ 深挖
系统支持 9 种算子类型,每种都有 PyTorch 参考实现作为正确性判据、一个 Triton 起步版和一个 CUDA C++ 起步版:
| kernel | 性能区间 | 起步实现的关键手法 |
|---|---|---|
| matmul | 计算受限 · TFLOPS | 128×128 tile、WMMA 张量核心、共享内存双缓冲 |
| flash_attention | 计算受限 · TFLOPS | 分块在线 softmax、因果掩码提前终止 |
| fused_mlp | 计算受限 · TFLOPS | SwiGLU 的 gate / up 融合 |
| softmax | 访存受限 · GB/s | warp shuffle 归约、half2 向量化加载 |
| layernorm | 访存受限 · GB/s | Welford 单趟均值方差、float4 加载 |
| rmsnorm | 访存受限 · GB/s | warp shuffle 级联、rsqrtf 快速倒数平方根 |
| cross_entropy | 访存受限 · GB/s | 在线 log-sum-exp、融合 NLL |
| rotary_embedding | 访存受限 · GB/s | __sincosf 内建、half2 交错读写 |
| reduce | 访存受限 · GB/s | 分层 warp shuffle + 共享内存 + 原子收尾 |
两个后端导出完全相同的 kernel_fn() 接口,bench.py 在任一后端上跑法一致。选型逻辑很清楚:Triton 用于快速迭代,编译只要 1–5 秒,matmul 常能到 cuBLAS 的 80%–95%;CUDA C++ 用于榨出最后一段性能,代价是编译与调试都更重。CUDA 侧用 load_inline 在运行时编译,带基于哈希的缓存、架构自动探测和文件锁保护的线程安全构建。
实测效果:H100 上的 34 个配置
评测在单张 H100 80GB HBM3(132 个 SM,计算能力 9.0,CUDA 12.8)上进行,全部为 FP16,用 CUDA event 计时,每个配置 200 次迭代取去掉首尾 10% 的截尾均值。对比基线是 PyTorch eager(matmul 走 cuBLAS,其余走 ATen)和 torch.compile(max-autotune)——后者本身就会对多套 Triton 配置做自动调优。完整的 34 个配置跑完不到 10 分钟。
16 个代表性配置的原始数据如下,其中「Ours」是尚未经过自主循环调优的起步 kernel:
| 算子 | 尺寸 | eager(µs) | torch.compile(µs) | AutoKernel(µs) | vs eager | vs compile | 吞吐 |
|---|---|---|---|---|---|---|---|
| matmul | 2048³ | 28.1 | 101.2 | 65.3 | 0.43× | 1.55× | 263 TF/s |
| matmul | 4096³ | 182.8 | 257.8 | 494.2 | 0.37× | 0.52× | 278 TF/s |
| matmul | 8192³ | 1679.5 | 1916.1 | 5773.1 | 0.29× | 0.33× | 190 TF/s |
| softmax | 4096² | 58.9 | 96.1 | 40.1 | 1.47× | 2.40× | 1675 GB/s |
| softmax | 8192² | 270.4 | 330.0 | 95.9 | 2.82× | 3.44× | 2800 GB/s |
| layernorm | 4096×5120 | 45.6 | 105.5 | 42.5 | 1.07× | 2.48× | 1974 GB/s |
| layernorm | 8192×4096 | 64.7 | 166.8 | 51.9 | 1.25× | 3.21× | 2586 GB/s |
| rmsnorm | 4096² | 142.8 | 99.9 | 39.1 | 3.65× | 2.56× | 1716 GB/s |
| rmsnorm | 8192×4096 | 262.4 | 138.1 | 51.2 | 5.12× | 2.70× | 2619 GB/s |
| rmsnorm | 8192² | 509.6 | 272.1 | 96.3 | 5.29× | 2.83× | 2788 GB/s |
| cross_ent | 4096×32000 | 295.6 | 386.3 | 134.9 | 2.19× | 2.86× | 1943 GB/s |
| cross_ent | 8192×32000 | 559.7 | 745.1 | 253.3 | 2.21× | 2.94× | 2070 GB/s |
| reduce | 8192² | 60.7 | 185.2 | 62.2 | 0.98× | 2.98× | 2156 GB/s |
| reduce | 16384×4096 | 50.4 | 185.9 | 52.8 | 0.95× | 3.52× | 2542 GB/s |
| rotary | 2×32×2048×128 | 211.4 | 106.9 | 117.4 | 1.80× | 0.91× | 576 GB/s |
| rotary | 2×32×4096×128 | 394.9 | 136.0 | 223.0 | 1.77× | 0.61× | 607 GB/s |
论文从这组数据里读出四条结论,其中两条对实践者最有价值:
- 访存受限的算子收益最大。 RMSNorm 在最大尺寸上达到 2,788 GB/s,相当于 H100 3,352 GB/s 峰值带宽的 83%;交叉熵到 2,070 GB/s,softmax 到 2,800 GB/s。这些收益的来源是把 ATen 里拆成多个算子的组合融进单趟 Triton kernel,从而把 HBM 往返次数压到最低。
- 通用编译器的自动调优不等于算子专用策略。 尽管
torch.compile(max-autotune)自己在搜索 Triton 配置,起步 kernel 仍在 16 个配置中的 12 个上胜出。TorchInductor 的通用融合与搜索,并不总能发现算子专用实现所利用的那种 tile 与归约策略。 - 矩阵乘法依然很难。 cuBLAS 针对每代 GPU 架构都做过大量手工调优,Triton 起步版只到 278 TFLOPS,是 H100 峰值 989.5 TFLOPS 的 28%。不过在 2048³ 这个尺寸上它反超
torch.compile1.55 倍,说明 TorchInductor 的 matmul 自动调优也并非总在最优解上。 - 正确性是普遍的。 全部 34 个配置在五个阶段上零失败。
论文还描述了一次完整优化的典型轨迹。以访存受限的 RMSNorm 为例:前 5–10 次实验扫描 BLOCK_SIZE(256 → 4096)能拿到 10%–30%;接下来 10–20 次做向量化加载与访存合并再加 10%–20%;再把权重乘法融进归一化 epilogue、省掉一次全局内存往返,又得 5%–10%;到第 30–50 次实验之后,连续回退开始变多,调度器判定进入平台期。计算受限的 matmul 轨迹不同:块大小调优的收益更大,但每一点提升都需要更多次实验,因为 tile 维度、warp 数、流水级数和累加精度的组合空间要大得多。
真实运行日志与社区战绩
仓库首页那张进度图是一次真实的 matmul 运行记录,比论文表格更能说明这个循环实际长什么样。
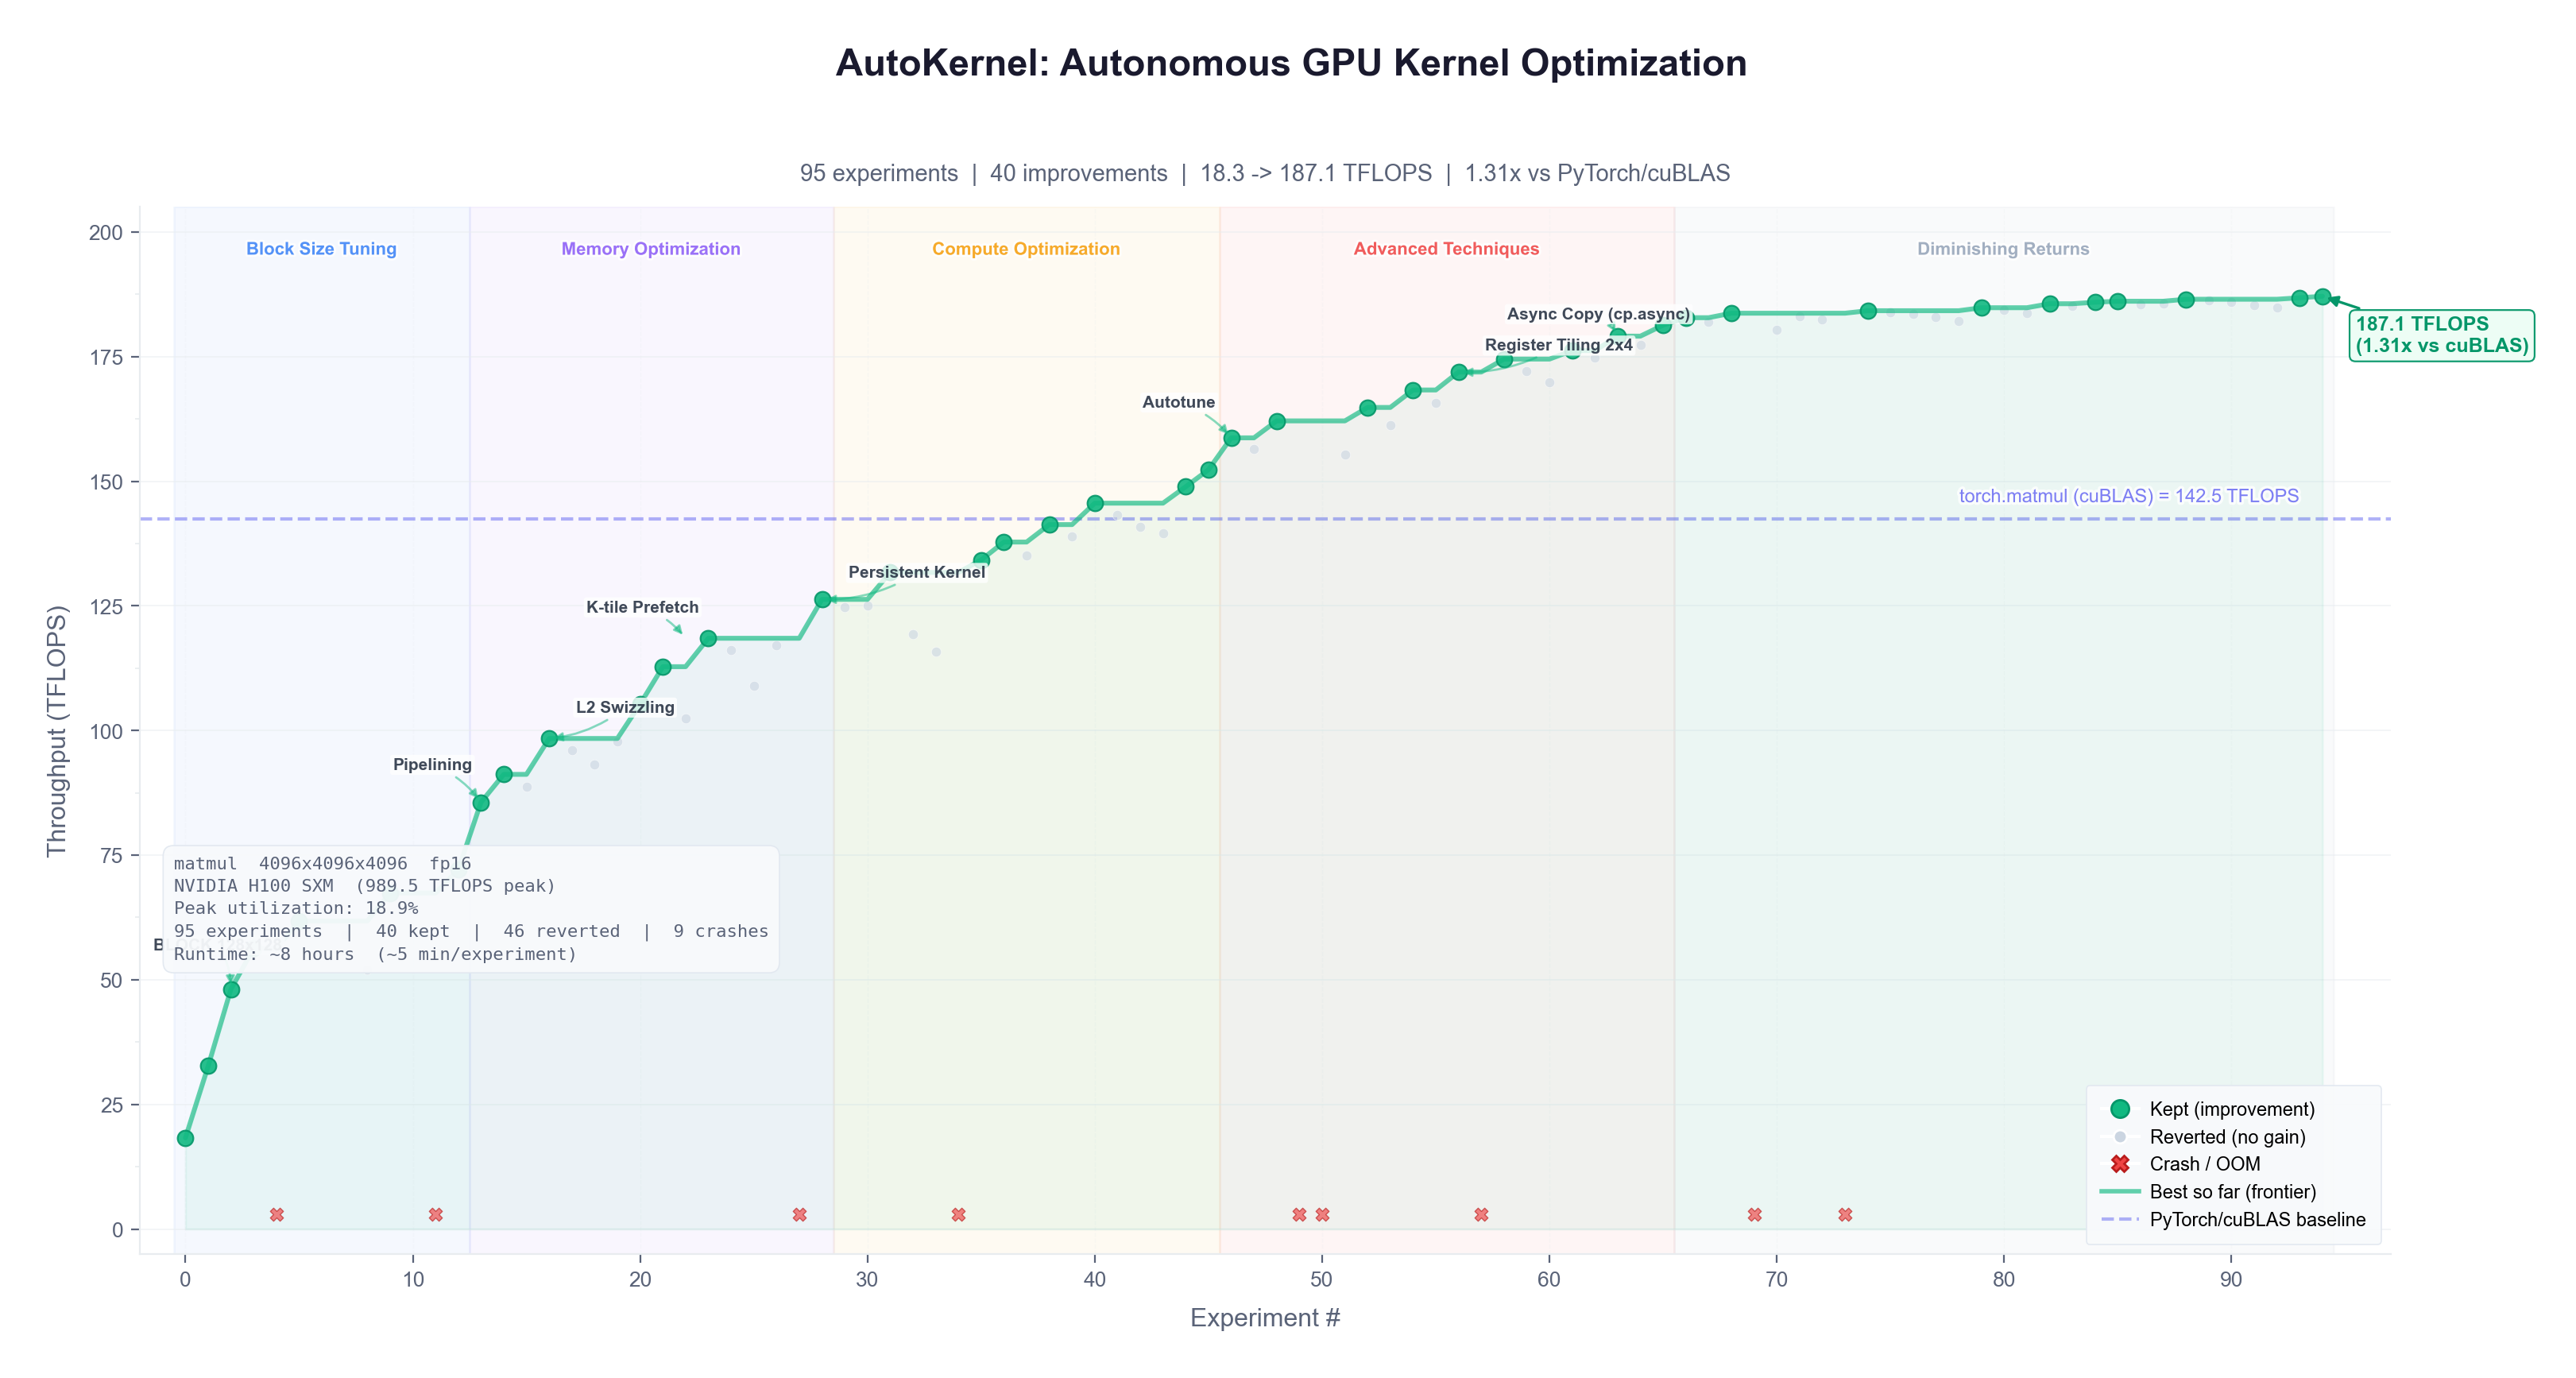
这次运行针对 4096×4096×4096 的 FP16 matmul,在 H100 SXM 上做了 95 次实验,历时约 8 小时(约 5 分钟一次)。吞吐从 18.3 TFLOPS 升到 187.1 TFLOPS,达到了理论峰值的 18.9%;95 次实验里 46 次被保留、46 次被回退、9 次崩溃——保留率不到一半。图上五个阶段标注清晰可见:块大小调优、访存优化、计算优化、高级技术,最后进入收益递减区间。几个被标记的里程碑也很有代表性:流水线、L2 swizzle、K 维预取、persistent kernel、autotune,以及 cp.async 异步拷贝与 2×4 的寄存器分块。
这张图里有两点值得留意。一是失败的实验占了多数,被保留的只是少数派;这正是「保留或回退」这种设计的意义所在——它不需要智能体每次都猜对。二是离硬件极限还有很远,18.9% 的峰值利用率说明在 matmul 这个算子上,循环还有很长的路可走。
社区层面的两次结果更直观:
B200 归约榜首。 在 vectorsum_v2 挑战(对形状为 (N,) 的张量做求和归约,N 可达数百万)上,一个经 AutoKernel 整夜优化循环打磨的 Triton 提交以 44.086 µs 拿下 NVIDIA B200 榜首,第二、三名分别是 44.249 µs 与 46.553 µs。这个 kernel 是循环自主探索块大小、warp 级 shuffle 归约和向量化访存模式的结果。
FP4 矩阵乘法反超 CUTLASS。 一位社区用户报告,单轮 AutoKernel 提示、约 3 分钟的智能体交互,就产出了一个在多个形状上超越 CUTLASS 的 Triton FP4 矩阵乘法 kernel:
| 形状(M × N × K) | Triton(TF/s) | CUTLASS(TF/s) | 加速比 |
|---|---|---|---|
| 128 × 3072 × 3072 | 186 | 100 | 1.86× |
| 128 × 18432 × 3072 | 1105 | 550 | 2.01× |
| 1024 × 3072 × 3072 | 1477 | 686 | 2.15× |
| 1024 × 18432 × 3072 | 2777 | 1609 | 1.73× |
| 2048 × 3072 × 3072 | 1662 | 964 | 1.72× |
| 2048 × 18432 × 3072 | 2898 | 1777 | 1.63× |
| 4096 × 3072 × 3072 | 2443 | 1405 | 1.74× |
CUTLASS 是为 NVIDIA 张量核心手工优化的 C++ 模板库,能用 Triton 在单轮交互里超过它,说明这份优化手册确实把一部分专家直觉变成了可复用的搜索启发。
设计取舍与局限
论文专门用一节解释了几个刻意的取舍。简单优于精巧:带规划者、编码者、评审者、剖析者的多智能体会引入协调开销和额外失败模式,而单个智能体在紧循环里跑能产生线性的实验历史,也避免了「达成共识」带来的延迟。固定评测、可变代码:基准永远不被智能体修改,这道防火墙挡住的是生成者兼裁判者的作弊风险。用 git 当实验追踪:每个实验映射为一个提交,保留的实验推进分支,回退的实验被 git reset 抹掉。用 TSV 而不是数据库:结果写进制表符分隔的纯文本,无依赖、可读、对 git 友好、智能体解析起来毫无负担。
局限同样明确。系统继承底层大模型的代码生成能力,软件流水线、手写 PTX、多 CTA 协作这类复杂技术可能超出当前智能体的能力边界——不过这个天花板会随前沿模型一起抬升。系统目前只在单卡上优化单个 kernel,分布式 kernel 与多设备内存管理不在范围内。矩阵乘法相对 cuBLAS 的差距仍是主要待攻克目标。论文列出的后续方向包括:跨多张 GPU 的群体搜索、用历史实验数据训练的学习型搜索策略、基于 SASS 分析与内存吞吐计数器的剖析引导式变异,以及单算子优化完成之后的跨 kernel 融合发现。
核心总结
- 一句话:AutoKernel 把专家调 kernel 的工作流——写一版、跑基准、留好的丢差的——机械化成一个智能体加一套不可修改的评测基准,整夜跑 300–400 次实验
- 三阶段流水线:
profile.py剖析模型并按 Amdahl 定律排名瓶颈,extract.py抽出独立 kernel,阶段 B 单文件迭代,verify.py换回模型做端到端验证 - 循环规则:一次只改
kernel.py;每轮一处改动;改动前先 git commit;吞吐 > 1.01× 才保留,否则git reset --hard;每次迭代约 90 秒(30 秒正确性 + 30 秒基准 + 30 秒推理) - 五阶段护栏:冒烟测试、8–10 组形状 × 3 种精度的形状扫描、对抗性输入的数值稳定性、3 次逐位一致的确定性、非 2 的幂边界用例;任一失败立即拒绝,吞吐根本不测
- 六层优化手册:块大小(10%–50%)→ 访存(10%–30%)→ 计算(5%–15%)→ 高级技术(5%–20%)→ 架构特定(5%–15%)→ 算子特定
- Amdahl 调度:连续 5 次回退、达到峰值 90%、单 kernel 用满 2 小时、已获 2× 加速,命中任一条就换下一个 kernel
- H100 实测:RMSNorm 比 eager 快 5.29 倍、Softmax 2.82 倍、交叉熵 2.21 倍,34 个配置零失败;16 个代表性配置中 12 个胜过
torch.compile(max-autotune) - 仍未解决:三个 matmul 尺寸全部落后 cuBLAS,起步版只到 H100 峰值的 19%–28%,8192³ 时比 eager 慢 3.4 倍;真实运行里保留率不到一半,离硬件极限还有 5 倍以上距离
- 社区战果:
vectorsum_v2拿下 B200 榜首(44.086 µs);单轮 3 分钟提示生成的 Triton FP4 matmul 比 CUTLASS 快 1.63–2.15 倍
最值得记住的一点是这套系统的诚实之处:它没有宣称智能体能超越 cuBLAS,而是把「一个足够好用的循环加上一道不可绕过的正确性护栏」做扎实。进度图上那 46 次保留、46 次回退和 9 次崩溃,可能比任何加速比数字都更能说明自主搜索在 GPU kernel 这件事上的真实状态——它有效,但仍是靠大量失败堆出来的。
论文:AutoKernel: Autonomous GPU Kernel Optimization via Iterative Agent-Driven Search(RightNow AI,Jaber Jaber 与 Osama Jaber,2026 年 3 月 22 日)
参考:
- RightNow-AI/autokernel 代码仓库(MIT 协议)
- program.md:智能体指令文档与六层优化手册
- KernelBench: Can LLMs Write GPU Kernels?(Ouyang et al., 2025)
- KernelBench 评测套件


