9 月 13 日,vLLM 团队发布《Kimi K3 Performance Optimizations in vLLM: The Road to 2.8× Throughput》,介绍继 Day-0 支持之后,为了让 Kimi K3 真正跑得高效而做的第二轮全栈优化。KDA 循环状态、LatentMoE、MXFP4 专家内核、投机解码与 TP/PP 各自暴露了不同的瓶颈:调度器限制和小的张量拷贝,有时和大 GEMM 一样重要。
文章从端到端结果讲起,然后逐一剖析四处有代表性的改动:自适应投机 token 预算、KDA 内部前缀检查点、零拷贝混合 KDA 批次、延迟的 MXFP4 收尾。此外还覆盖 ReplaySSM、prefill/decode 分离与缓存卸载,以及解码上下文并行。更广泛的优化工作记录在 GitHub issue #50587。
性能
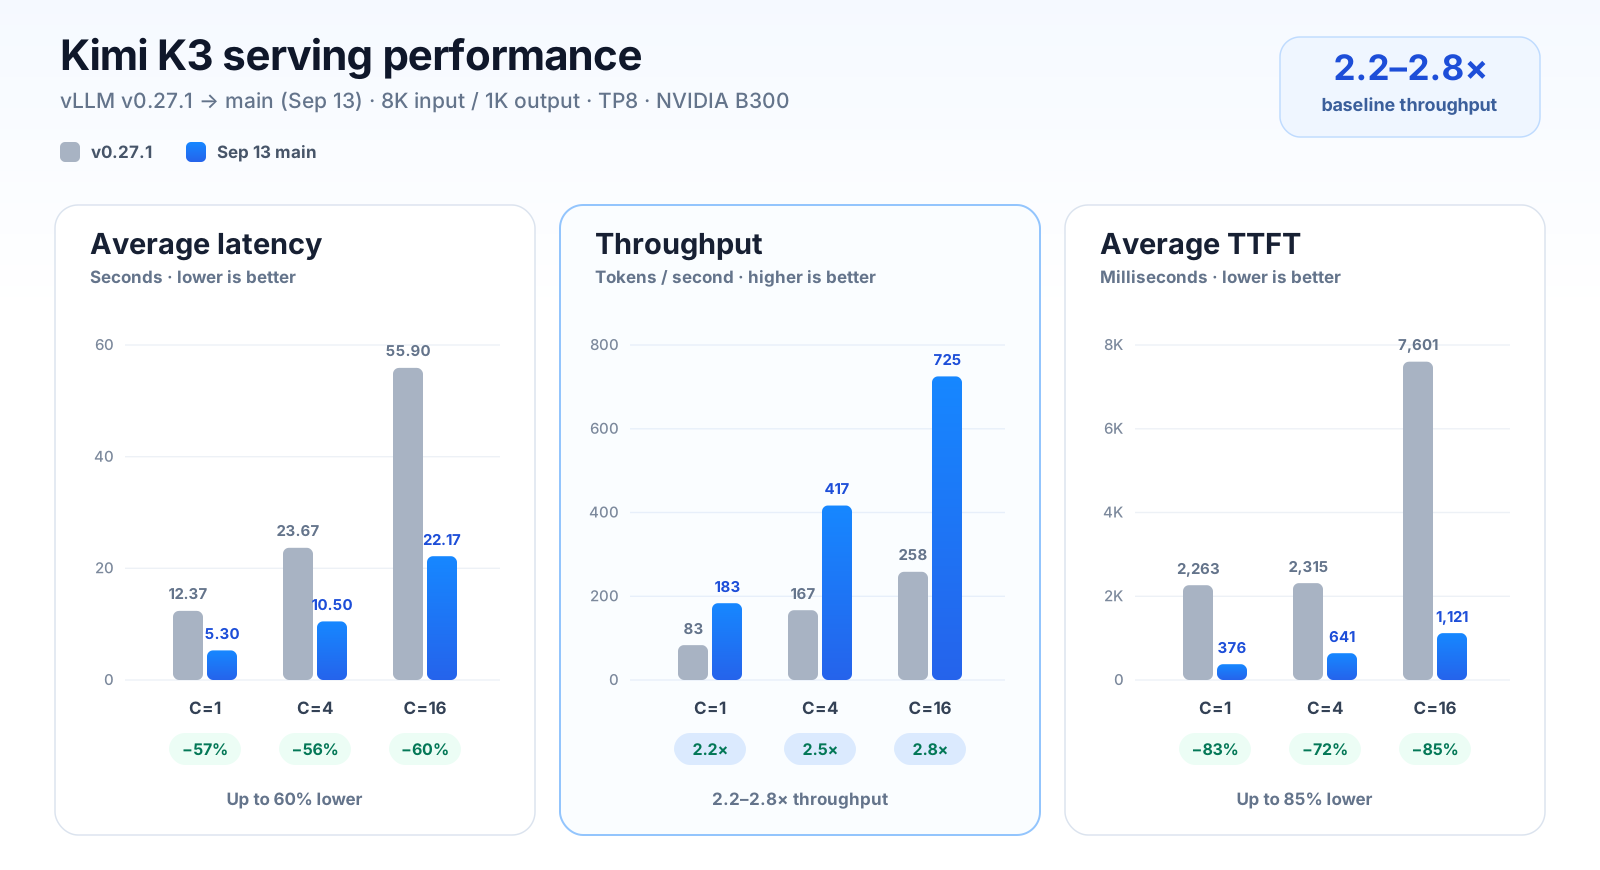
测试使用 8K/1K 工作负载、TP8、8 token 的 DSpark 投机,并发 1、4、16。对比 v0.27.1 与提交 82a85dc1(0913),在 B300 节点(CUDA 13.3)上测试。
启动服务:
vllm serve moonshotai/Kimi-K3 \
--trust-remote-code \
--tensor-parallel-size 8 \
--load-format fastsafetensors \
--gpu-memory-utilization 0.9 \
--reasoning-parser kimi_k3 \
--enable-auto-tool-choice \
--tool-call-parser kimi_k3 \
--host 0.0.0.0 \
--port 30000 \
--max-model-len auto \
--no-enable-prefix-caching \
--speculative-config '{"model":"RedHatAI/Kimi-K3-speculator.dspark","method":"dspark","num_speculative_tokens":8,"draft_sample_method":"probabilistic","rejection_sample_method":"standard"}'
注意:两次运行都禁用了前缀缓存,因为 v0.27.1 存在一个后来才修复的 Kimi K3 前缀缓存问题。
运行基准:
guidellm run \
--backend '{"kind":"openai_http","target":"http://127.0.0.1:30000","model":"moonshotai/Kimi-K3","request_format":"/v1/chat/completions","timeout":100000,"extras":{"body":{"reasoning_effort":"max","temperature":1.0,"top_p":0.95}}}' \
--tokenizer '{"kind":"huggingface_auto","model":"moonshotai/Kimi-K3","load_kwargs":{"trust_remote_code":true}}' \
--data 'kind=synthetic_text,prompt_tokens=8000,output_tokens=1000' \
--profile 'kind=concurrent,warmup=0.1,cooldown=0.1' \
--override profile.streams '1,4,16' \
--constraint 'kind=max_duration,seconds=150' \
--constraint 'kind=max_errors,count=10' \
--seed 'kind=static,value=42' \
--metrics 'kind=generative,sample_size=20' \
--output 'kind=json,path=guidellm-results/output_vllm_kimik3_8k1k.json'| 并发 | 0.27.1 平均延迟(s) | 0913 main 平均延迟(s) | 0.27.1 吞吐(tok/s) | 0913 main 吞吐(tok/s) | 0.27.1 平均 TTFT(ms) | 0913 main 平均 TTFT(ms) |
|---|---|---|---|---|---|---|
| 1 | 12.37 | 5.30(−57.2%) | 83.3 | 183.3(+120.0%) | 2262.9 | 376.3(−83.4%) |
| 4 | 23.67 | 10.50(−55.6%) | 166.7 | 416.7(+150.0%) | 2314.9 | 640.5(−72.3%) |
| 16 | 55.90 | 22.17(−60.3%) | 258.3 | 725.0(+180.6%) | 7601.1 | 1121.0(−85.3%) |
端到端优化实例
自适应调度预算
请求数少时,max_num_batched_tokens 大量闲置。PR #51725 引入自适应调度 token 预算;PR #51726 把高显存 GPU 档位的默认上限从 8,192 提到 16,384。在报告的 8K/1K 工作负载上:TTFT 降低 55%–65%,吞吐最高提升 41.5%。
以 max_num_seqs=1024、max_num_batched_tokens=8192、K=8 为例:
| 实际请求数 | 旧逻辑调度的 token 数 | 现在 |
|---|---|---|
| 1 | 1024(8192 − 1024 ×(8−1)) | 8185(8192 − 7) |
| 32 | 1024 | 7968 |
| 128 | 1024 | 7296 |
| 1024 | 1024 | 1024 |
该 PR 用自适应策略在请求数少时把调度 token 数大幅提高,从而避免单个请求被拆成多次前向调用。
KDA 内部前缀检查点
Mamba 式前缀缓存把 prefill 切在最后一个可缓存块边界上,有时会为了一小段后缀额外增加一次全模型前向。PR #52789 改为在一次 prefill 内部导出检查点,TTFT 降低 9%–25%;PR #53614 补上了部分前缀命中与投机解码,包含 EAGLE 的重放边界对齐。
对 8K 输入:
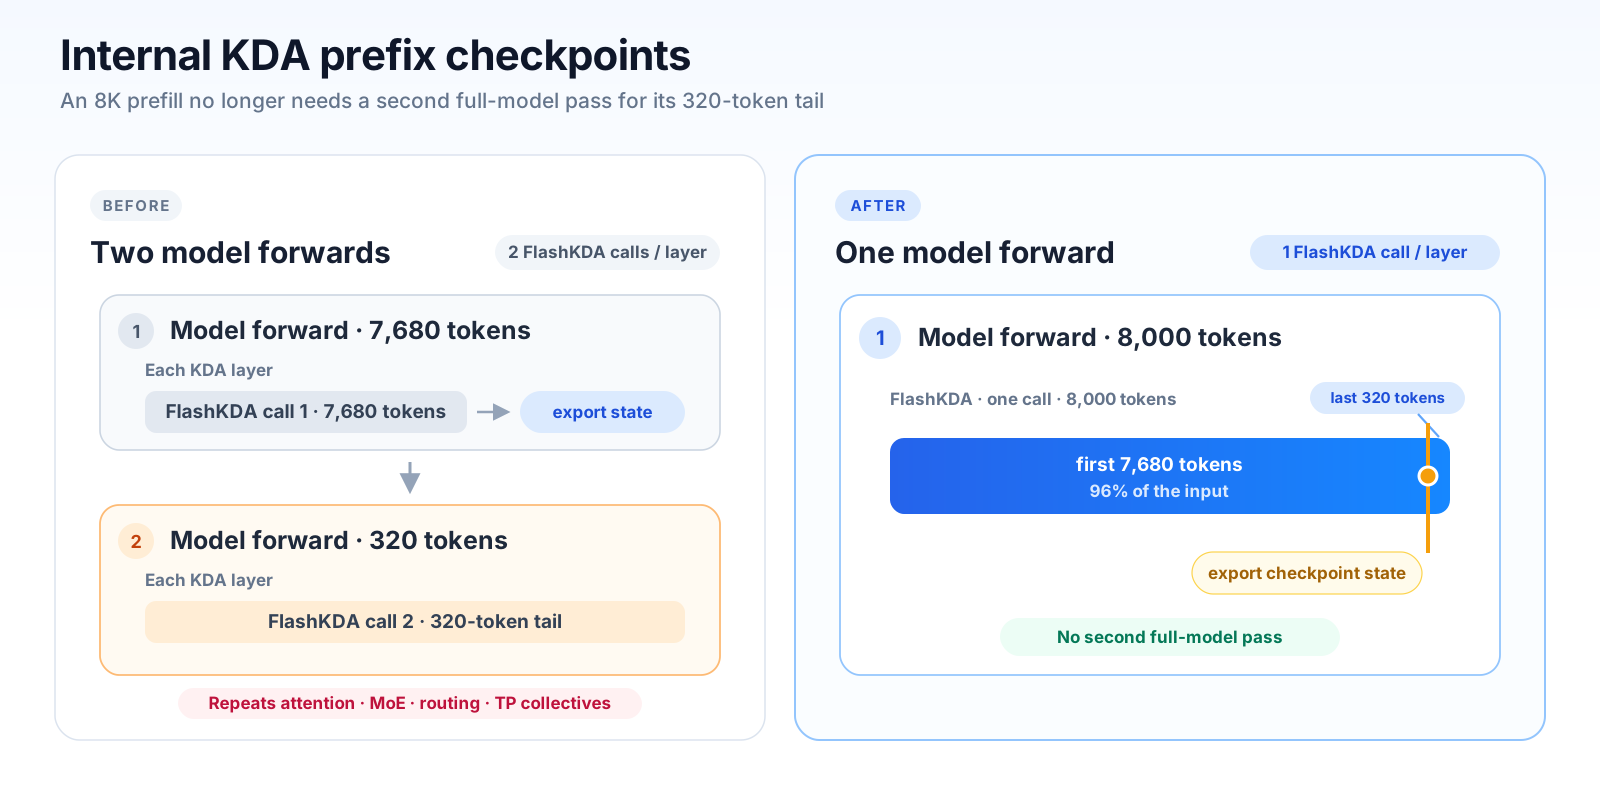
这个 PR 帮助我们避免了第二次全模型前向穿过注意力、MoE、路由与 TP 集合通信。
零拷贝混合 KDA 批次
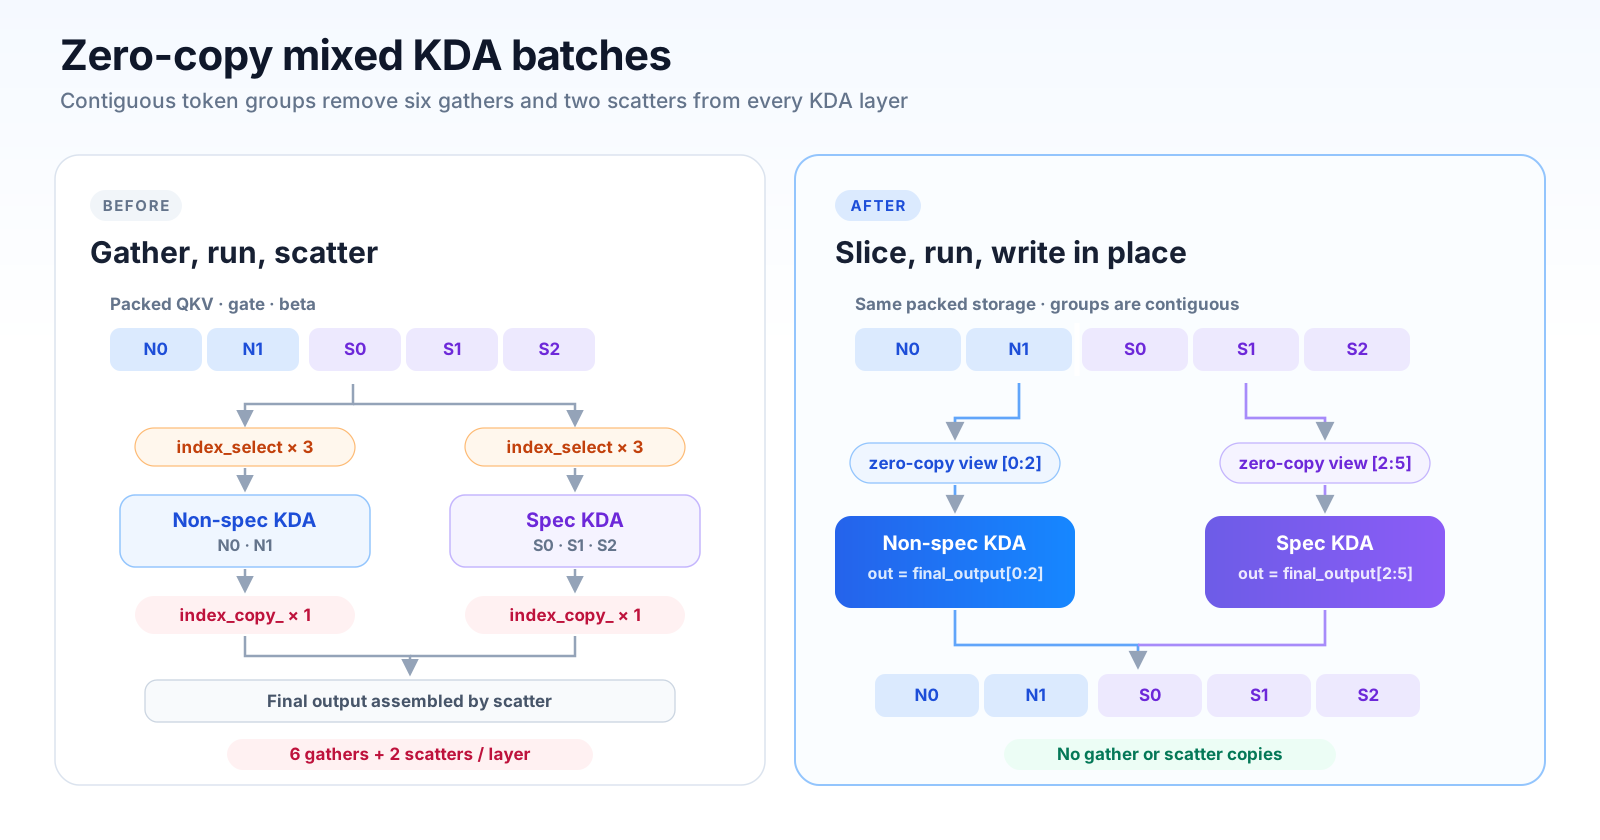
混合的投机与非投机批次每层会用到六次 index_select 与两次 index_copy_ 操作。PR #56159 改用连续的零拷贝切片并直接写出。并发 4 与 16 时吞吐提升 5.2%–7.7%;批量大小为 1 时持平。
延迟的 MXFP4 收尾
PR #53152 把 MXFP4 的 top-k 收尾放进 latent-tail 内核,省掉一次内核启动与一次中间张量的写入和读取,端到端延迟降低约 5%。PR #53327 修复初始化顺序,让这条延迟路径能在权重加载之前就启用。
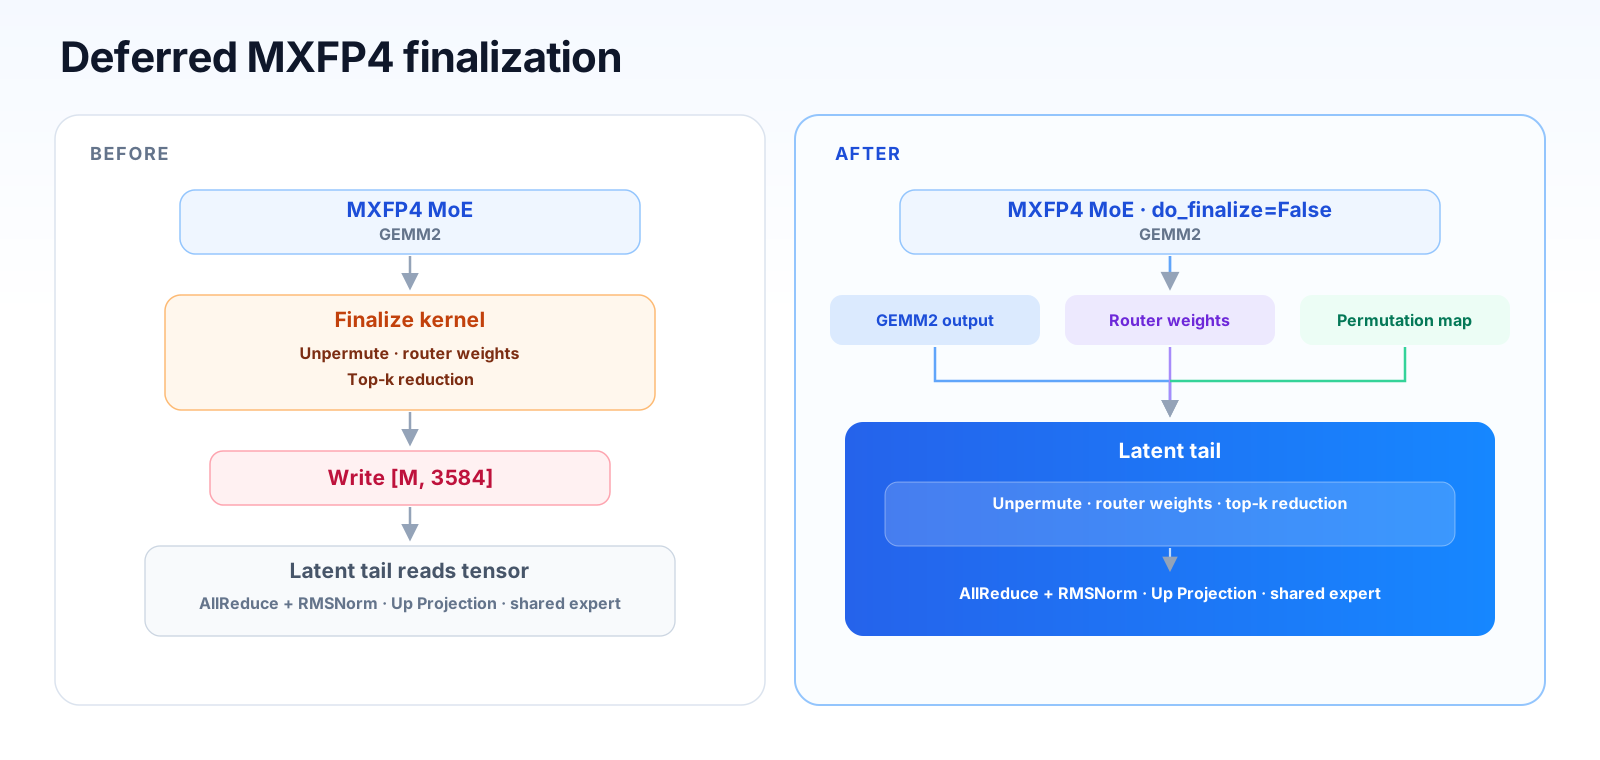
这既省掉了一次内核启动,也避免了写回并重读那份收尾后的中间张量。
ReplaySSM:重建 KDA 状态,而不是存储它
投机解码会在每个 draft 位置写入一份 KDA 循环状态,以便被拒绝的 token 可以回滚。对 T 个 draft 位置来说,这意味着每一步多出 T 次状态写入。ReplaySSM 改为缓冲最近的 SSM 输入,在提交时重建被接受的状态——回滚只需要移动一个缓冲区指针。
PR #51855 在 Model Runner V2 上为 Kimi K3 引入了 ReplaySSM。一个 Triton 内核在 align 模式下同时提交被接受的状态与下一个前缀缓存边界。在同样 46.48 GiB 的缓存预算下,TP8 的有效容量提升 10.97%,且没有精度损失。
Prefill/decode 分离与混合状态卸载
PD 分离与缓存卸载都必须同时传输 MLA KV 和 KDA 状态。MLA KV 在各 TP rank 上复制,而 KDA 状态按 head 和维度分片;Mamba 的 align 块表还可能是稀疏且可变的。纯注意力的传输假设在这里并不适用。
PR #51358 让 Mooncake 存储调度器选出的边界状态,并把它们固定(pin)住,直到所有 rank 上的异步写入完成。PR #50344 规定:只有能够恢复 KDA 状态的 connector,才被允许服务「每组前缀命中各不相同」的情形。
解码上下文并行
TP 会在每个 rank 上复制 MLA latent KV,因此增加 TP rank 并不会增加 KV 缓存的容量。解码上下文并行(DCP)沿序列维度把它切开,对长共享前缀的智能体工作负载很有用。
PR #50484 为 Kimi K3 的融合 MLA 路径实现了 DCP:对称内存 A2A 负责输出/LSE 归约,NVLS multicast 收集 query,multimem 收集分块上下文的 KV;query 分片直接写入消费方的最终缓冲区。在 4×GB200 上,query 交换延迟降低 10.4%–29.9%。
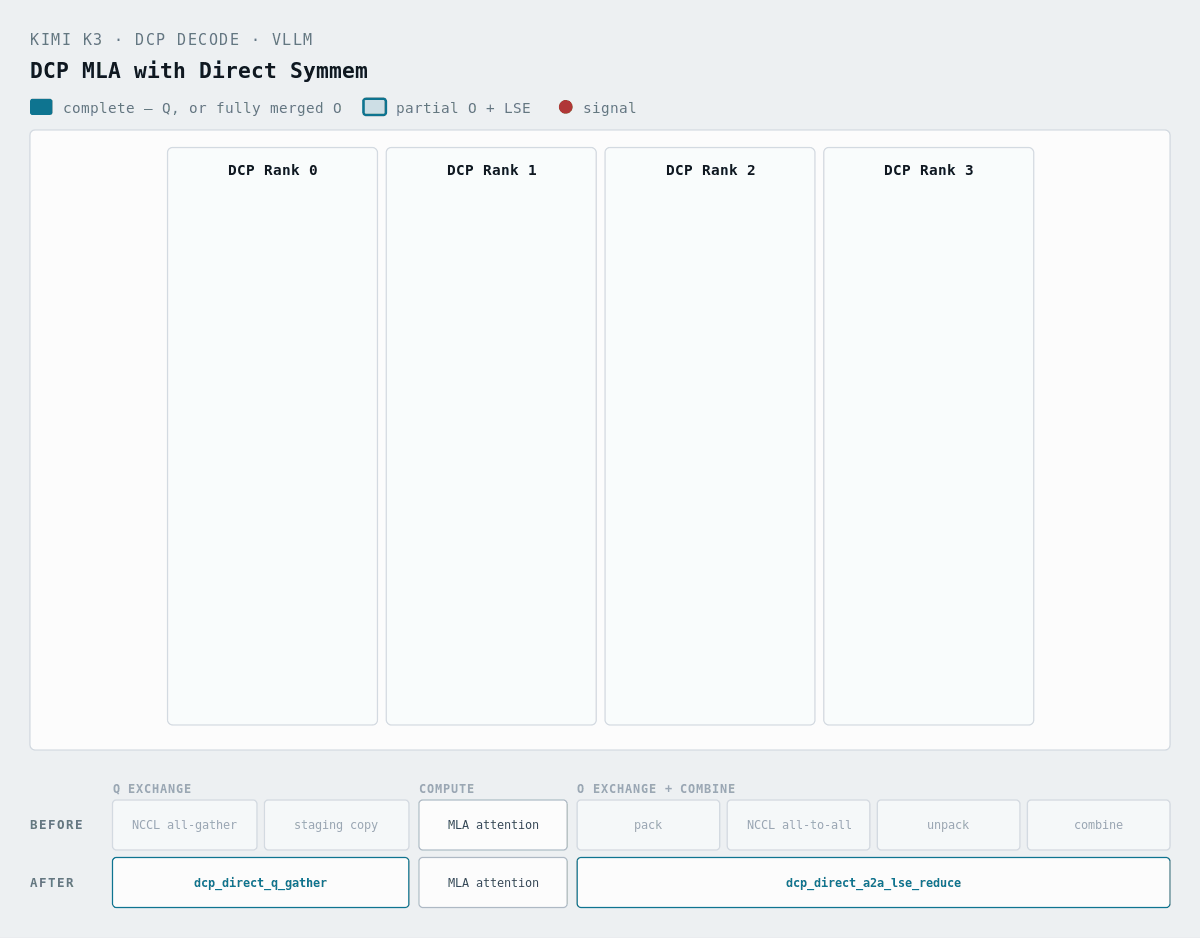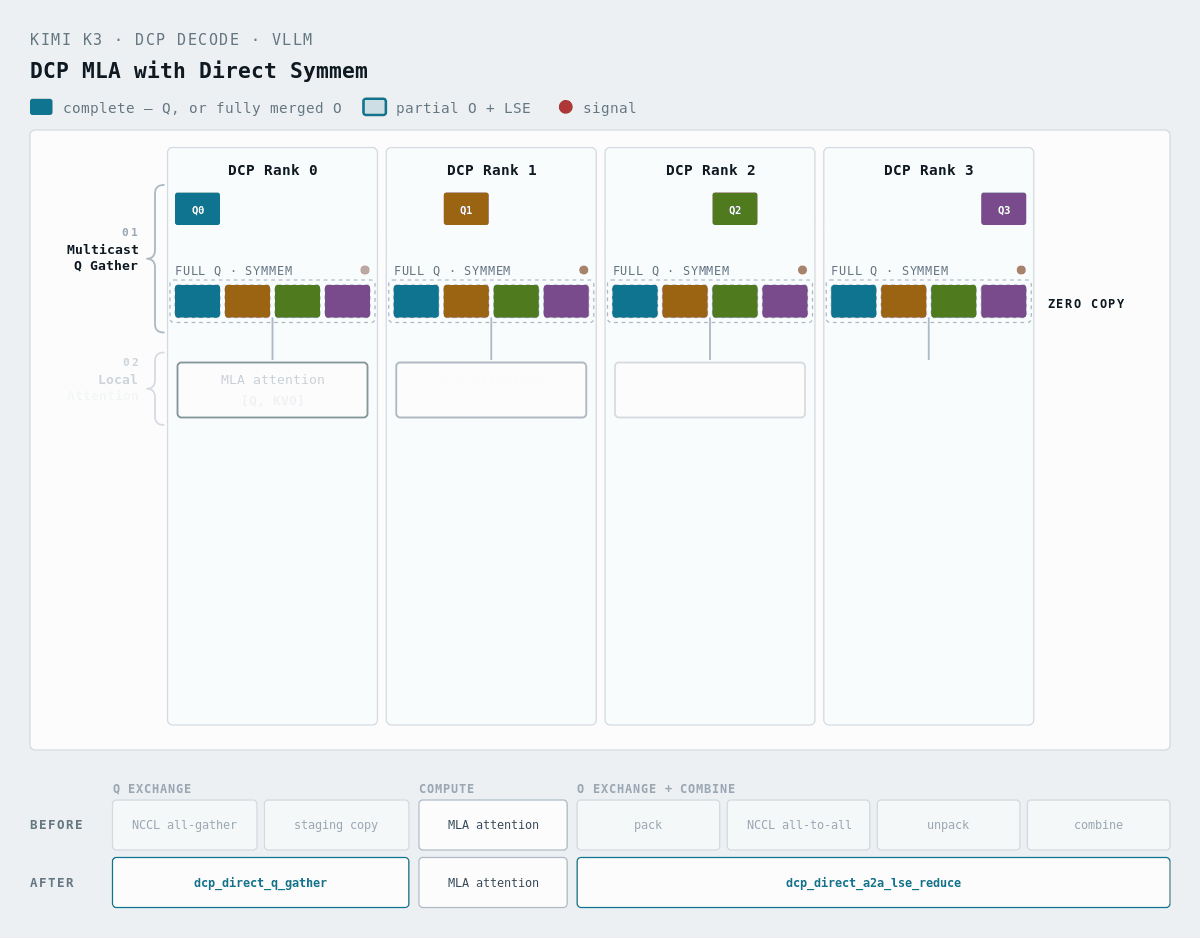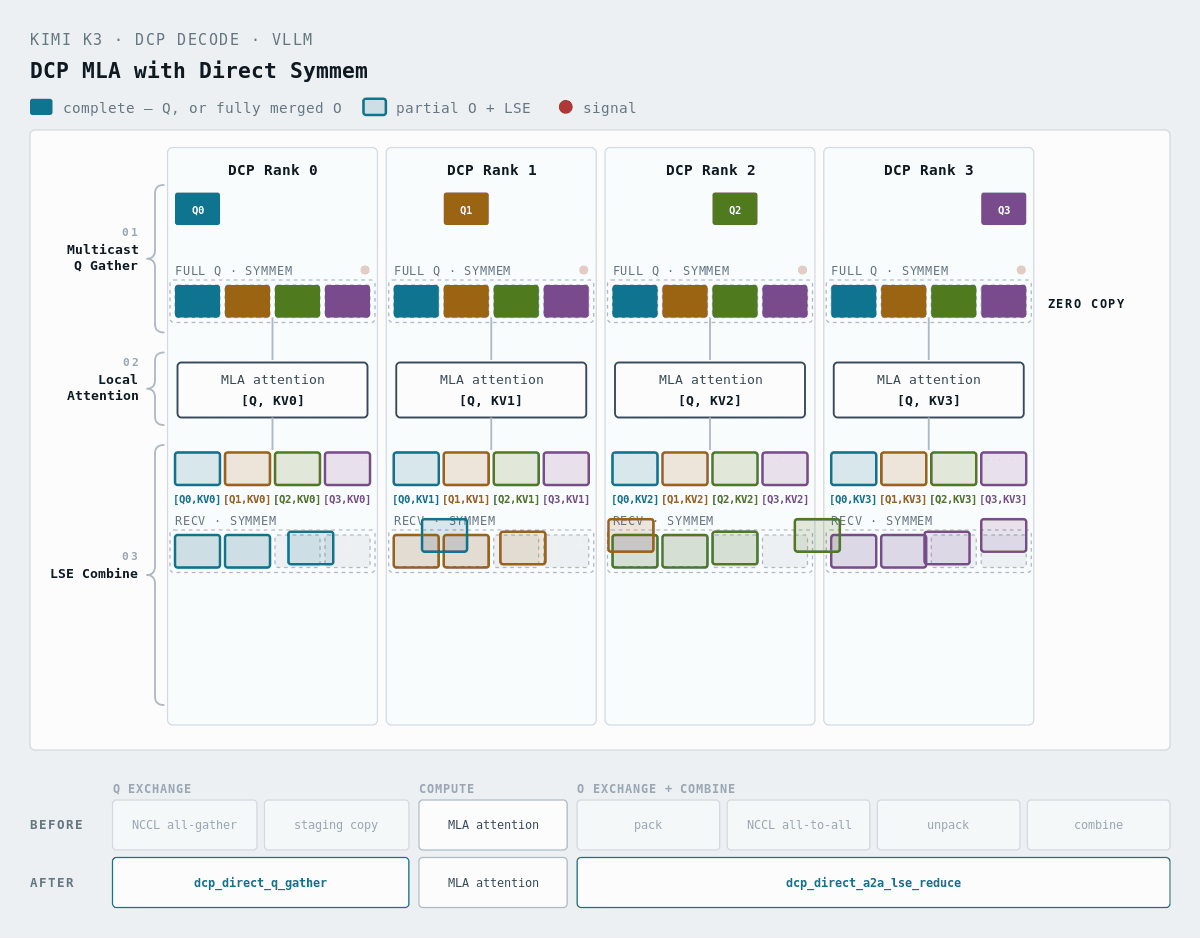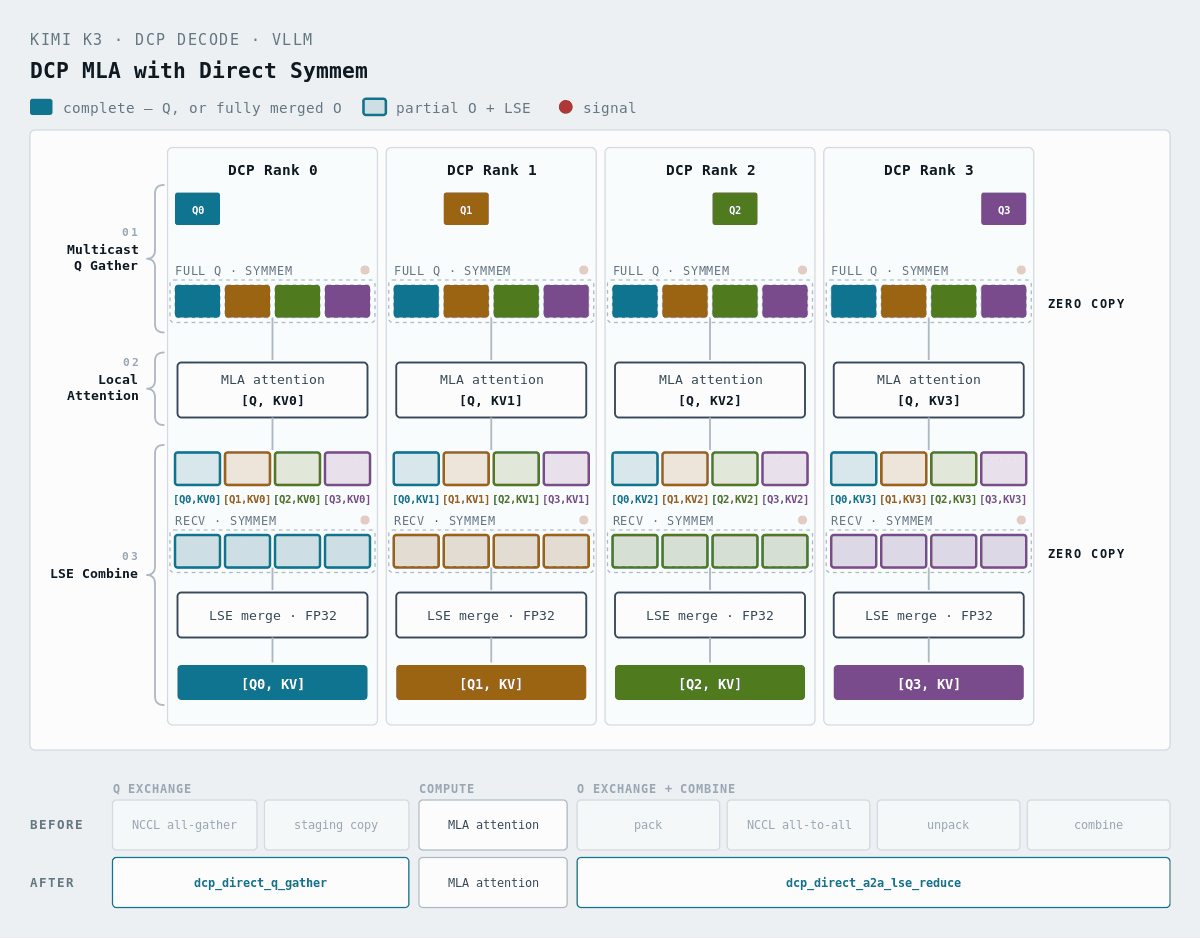
在 120k token 工作负载(114k 共享前缀、6k 后缀、400 输出 token)上,KV 缓存容量从 1.93M 提升到 19.75M token;并发 1 时 TPOT p50 从 13.8 ms 降到 10.5 ms,并发 2 时从 16.2 ms 降到 11.8 ms。GSM8K 上 DCP8 为 96.97%、TP8 为 96.21%,且零请求错误。
实例之外
更广泛的工作覆盖了内存布局、序列与流水线并行、KDA prefill 与循环状态、MLA、MoE 和 GEMM。它切分了大投影与共享专家,减少了集合通信与数据搬运,并收紧了小批量下的 GPU 路径。完整的 PR 列表记录在 issue #50587。
来自社区的 PR 拓展了这项工作:Robert Shaw 与 Summer Yang 贡献了 DeepEPv2 配合 DeepGEMM MXFP4 以及上文的 DCP 支持;Thien Tran 开发了序列并行 GEMM 路径。Nick Hill 与 Xiaolong Xu 则在 PR #51540 与 PR #52458 中收紧了 KDA prefill。
致谢
感谢 Benjamin Chislett、Bolin Sun、Dao Le、Duncan Moss、Harris Nover、Julian Huang、Ming、Nick Hill、Rebecca Lee、Robert Shaw、Summer Yang、Thien Tran、Tyler Michael Smith、Xiaolong Xu 与 Yifan Qiao 提交的 Kimi K3 PR,也感谢各位审阅者、CI 维护者、基准负责人与硬件团队。
核心总结
- 端到端结果:8K/1K 工作负载、TP8、8 token DSpark 投机,在 B300(CUDA 13.3)上从 v0.27.1 到 0913 main,延迟降低 56%–60%、吞吐提升 2.2–2.8 倍、TTFT 降低 72%–85%
- 自适应调度预算:请求数少时按
max_num_seqs与投机 token 数动态放大调度预算,避免请求被拆成多次前向,TTFT 降 55%–65%、吞吐最高 +41.5% - KDA 内部前缀检查点:在一次 prefill 内导出检查点,省掉第二次全模型前向,TTFT 降 9%–25%
- 零拷贝混合 KDA 批次:用连续切片替代六次
index_select与两次index_copy_,并发 4/16 吞吐 +5.2%–7.7% - 延迟 MXFP4 收尾:把 top-k 收尾融进 latent-tail 内核,省一次启动与一次中间张量往返,端到端延迟约 −5%
- ReplaySSM:改为重建 KDA 状态而非逐步存储,回滚只移动指针,同样 46.48 GiB 预算下 TP8 有效容量 +10.97% 且无精度损失
- DCP:120k token 工作负载下 KV 缓存容量从 1.93M 提升到 19.75M token,TPOT p50 在并发 1/2 下分别降到 10.5 ms 与 11.8 ms,GSM8K 精度不降
这篇文章最值得留意的一点是优化重心的分布:在 Kimi K3 这种新架构上,限制吞吐的往往不是那个最大的 GEMM,而是调度器的 token 预算、一次多余的模型前向、几次索引拷贝。每一项改动都给出了明确的加速比与适用边界(批量大小为 1 时零拷贝改动持平、ReplaySSM 需要 Model Runner V2),对准备在自有集群上部署 Kimi K3 的团队,可以直接照着 issue #50587 的 PR 列表逐项核对自己版本覆盖了多少。
原文:Kimi K3 Performance Optimizations in vLLM: The Road to 2.8× Throughput(vLLM Blog,2026 年 9 月 13 日)


