vLLM 团队与 Inferact 联合宣布,Kimi K3——迄今最强大的开源权重模型之一——现已获得高效的 Day-0 vLLM 支持。上周团队预告了 Kimi K3 的生产级集成工作,今天月之暗面(Moonshot AI)的权重正式公开,支持同步上线。
Kimi K3 是一个 2.8 万亿参数的混合专家(MoE)模型(每个 token 激活 896 个专家中的 16 个),基于 Kimi Delta Attention(KDA)与 Attention Residuals(AttnRes)构建,支持 100 万 token 上下文窗口和原生视觉能力。对 vLLM 而言,最大的挑战是让 KDA、MXFP4 MoE、KV 缓存管理、prefill/decode 分离、投机解码与长上下文部署方案在一个可运行的推理引擎中协同工作。
快速开始
最简单的方式是使用 8 块 NVIDIA B300 或 8 块 AMD MI355X GPU,运行下面的命令:
vllm serve moonshotai/Kimi-K3 \
  --tensor-parallel-size 8 \
  --trust-remote-code \
  --load-format fastsafetensors \
  --enable-prefix-caching \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
Inferact 还为 Kimi K3 训练并开源了 DSpark 投机模型,在 serve 命令中追加以下参数即可启用:
--speculative-config '{"model":"Inferact/Kimi-K3-DSpark","method":"dspark","num_speculative_tokens":7,"attention_backend":"FLASHINFER_MLA","draft_sample_method":"probabilistic","rejection_sample_method":"block"}'由于依赖关系复杂(包括若干预发布依赖如 FlashInfer),目前只有 Docker 镜像可以直接使用,更多平台镜像与部署策略见官方 recipes。
核心要点
- 2.8 万亿参数多模态 MoE:Kimi K3 每个 token 激活 896 个专家中的 16 个,支持最高 100 万 token 上下文,基于 KDA、Attention Residuals、LatentMoE 与原生 MXFP4(4-bit)权重构建
- 单用户最高 370 tok/s:在 16 块 NVIDIA GB300 NVL72 GPU 上,vLLM 无投机解码时达 118 tok/s,启用 DSpark 后提升至 370 tok/s(3.14 倍)
- 广泛的生产级特性:支持投机解码、prefill/decode 分离、基于 Mooncake 的智能体 KV 缓存、工具调用、推理输出与结构化输出,发布即支持 NVIDIA(Hopper 与 Blackwell)和 AMD(MI355X)
- 开源 DSpark 支持:vLLM 支持由 Inferact 使用 vLLM 与 TorchSpec 训练并开源的 SOTA 块扩散投机解码算法
- 混合前缀缓存:为服务 Kimi K3 的循环注意力与全注意力混合设计,vLLM 重构了基于循环 KDA 状态的混合前缀缓存,这一改进惠及所有类似的混合线性模型
Kimi K3 的架构与 vLLM 的适配
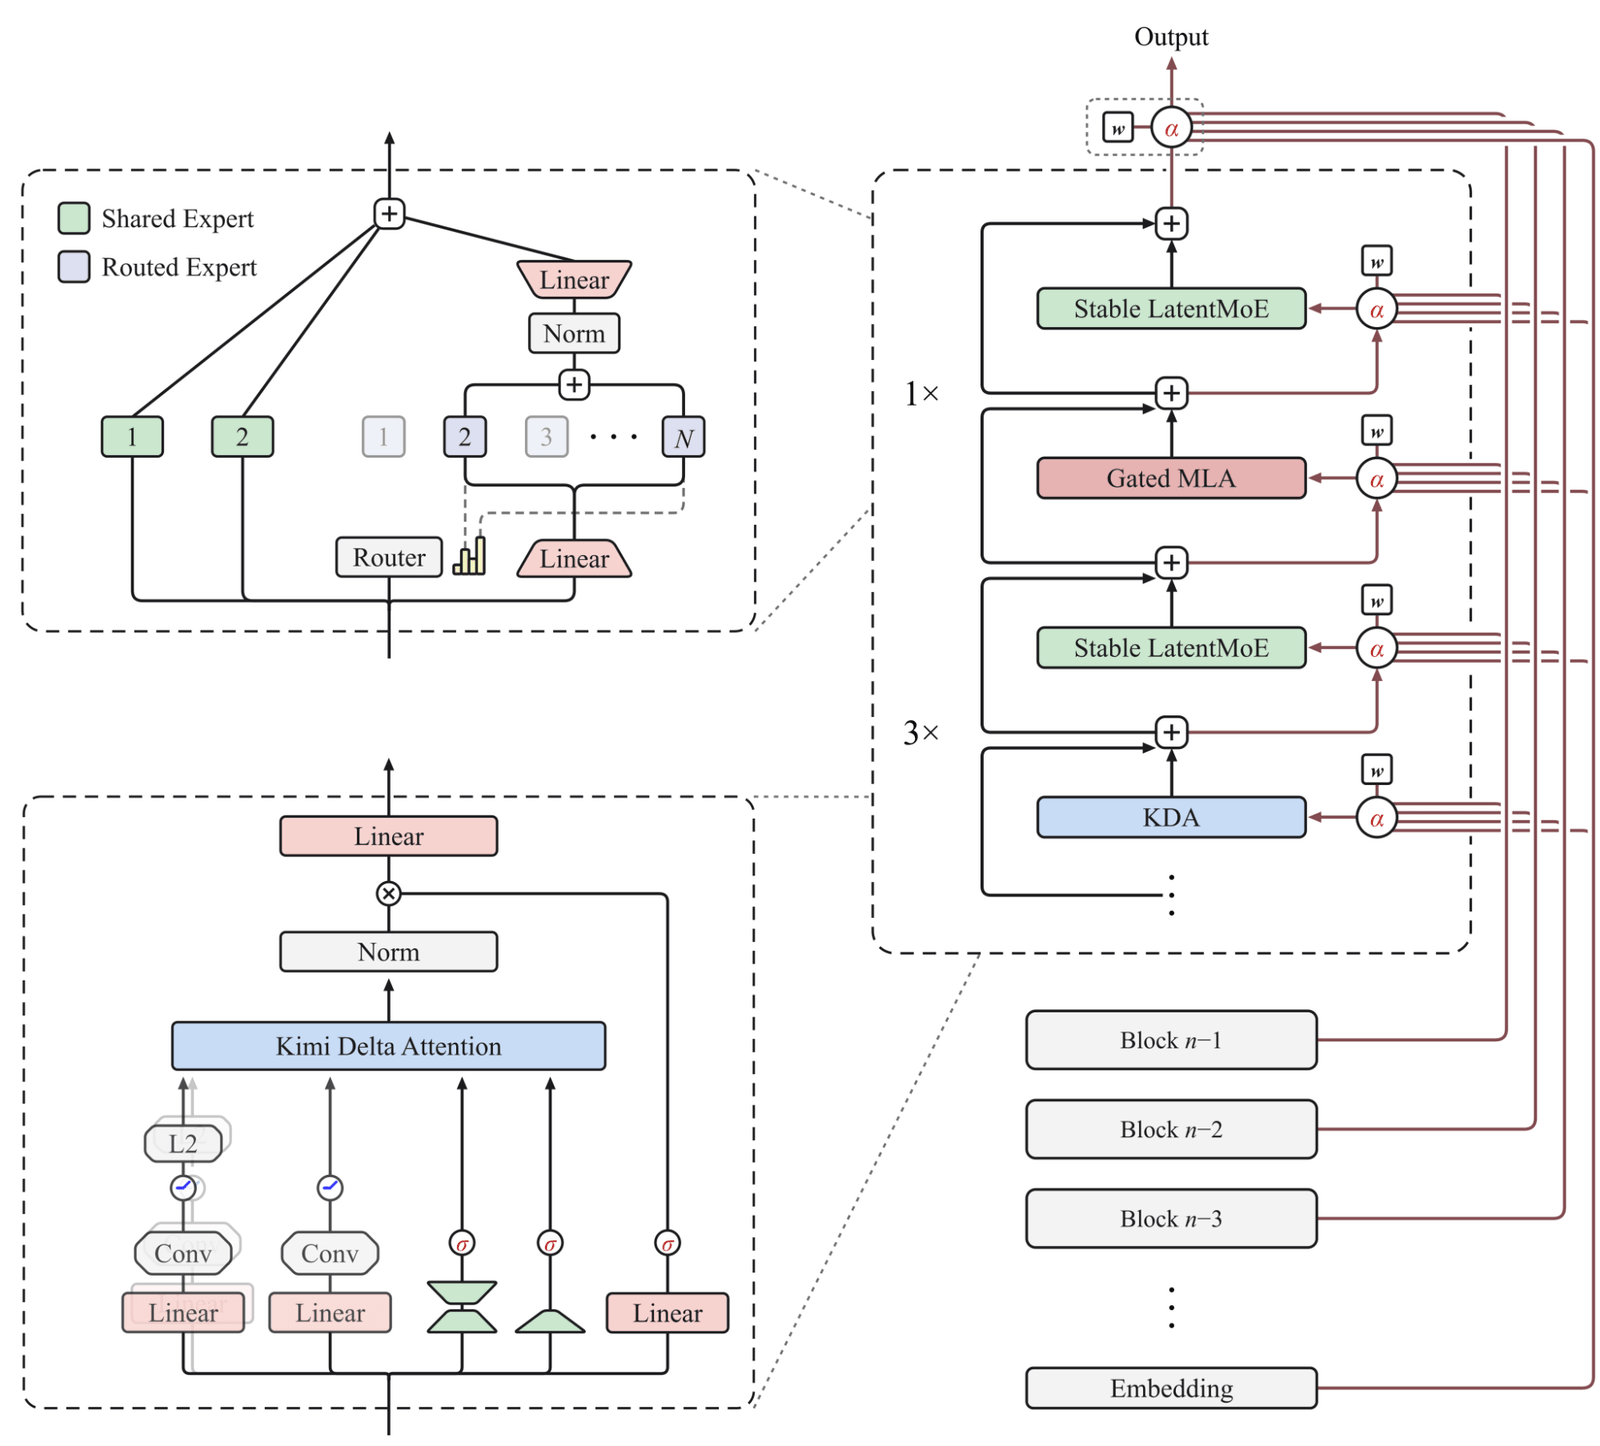
Kimi K3 的架构在几个方面不同于标准 Transformer,而每一处不同都改变了推理引擎的工作方式。以下是 vLLM 的对应适配。
Kimi Delta Attention:混合循环注意力 + 全注意力堆栈
新特性:Kimi K3 的大部分层采用 KDA——一种保持固定大小循环状态(而非不断增长的 KV 缓存)的线性注意力机制——并与周期性的全注意力层交错,以保留精确的全局召回能力。这正是 100 万 token 上下文得以负担得起的原因。
vLLM 的适配:一个混合 KV 缓存管理器在同一调度器下并排管理两类内存:全注意力层的分页 KV 块,以及 KDA 层的紧凑循环状态块。专用的 KDA 注意力后端在 prefill 阶段运行 FlashKDA,在 decode 阶段运行融合 CUDA 内核(运行投机解码时走 Flash-Linear-Attention/Triton 路径)。
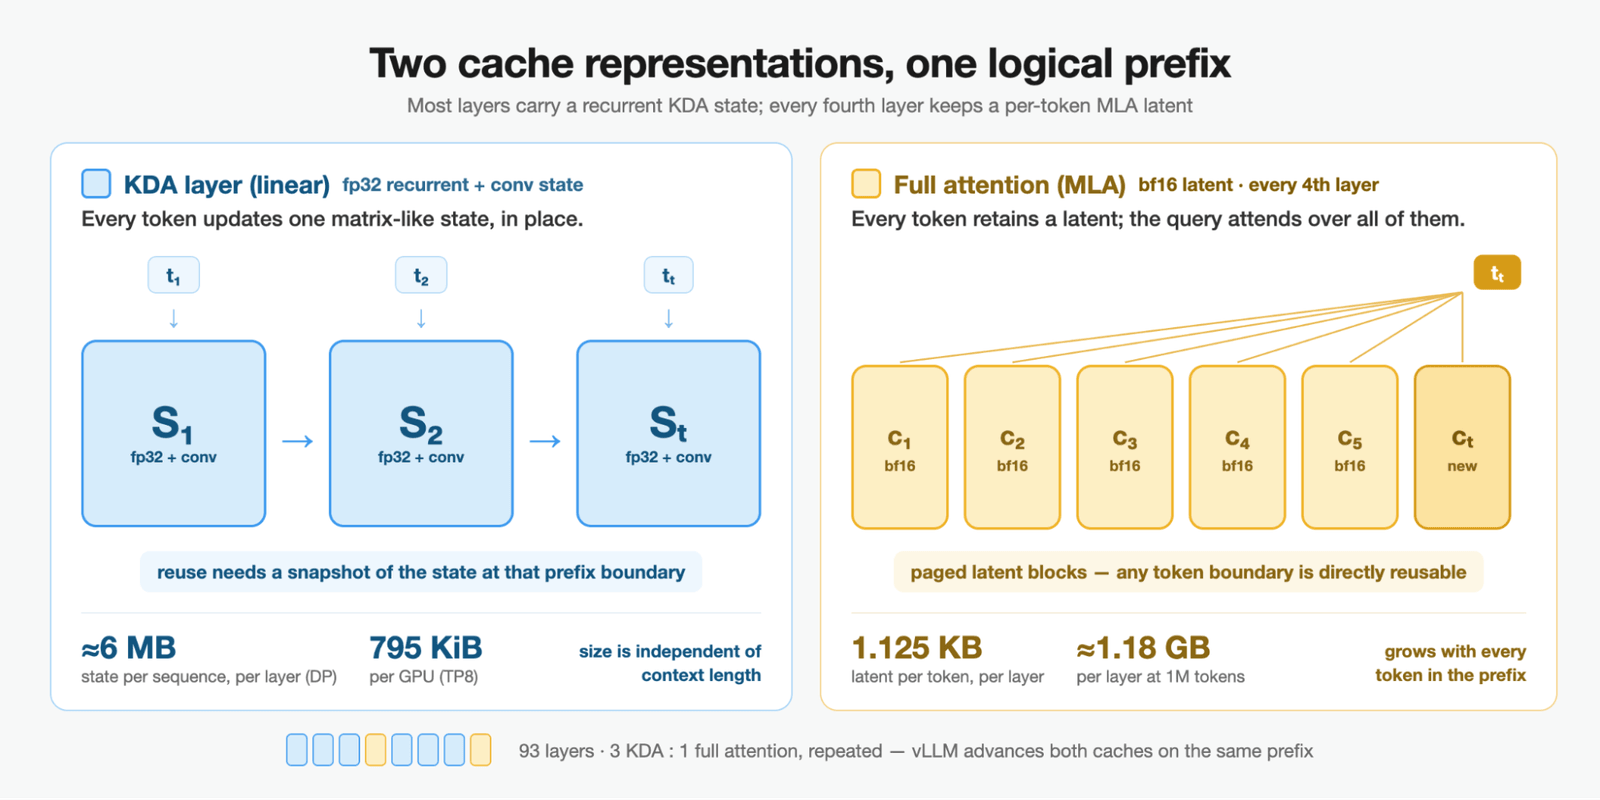
最难的部分是跨 Kimi K3 混合缓存的前缀缓存:全注意力层为每个 token 存储 KV,而 KDA 层在每个 token 上更新循环与卷积状态,却无法负担在每一个可能的前缀边界保留快照。vLLM 将较大的物理 KDA 状态块与细粒度前缀匹配解耦,在这些块内注册状态快照,并在扩展前复制它们,使长共享提示可以同时复用 KDA 状态与分页 KV。这套混合缓存机制是 vLLM 核心的新能力,现在惠及所有与 Kimi K3 类似的混合模型。
Attention Residuals:跨深度的学习式残差混合
新特性:对每个 token,Block AttnRes 用深度维注意力取代普通的残差累加:每个 Transformer 子层使用一个学习到的伪查询,对来自前面层块的 RMS 归一化残差状态加权,再将其加权组合作为输入。
vLLM 的适配:vLLM 使用优化后的 Triton 与 CUDA 内核,在一次融合操作中完成深度维注意力的 logits、softmax 与隐藏状态聚合。在支持的情况下,残差更新与输出 RMSNorm 也折叠进同一内核,减少 prefill 与 decode 阶段的中间内存流量与内核启动开销。
Stable LatentMoE:16/896 稀疏度的分位数平衡潜空间专家
新特性:由 NVIDIA 提出的 LatentMoE 将路由到的 token 激活投影到更窄的潜空间维度进行专家计算,再把合并后的专家输出投影回模型宽度,从而减少专家权重带宽与 all-to-all 流量,使相近推理成本下可容纳更多专家。Kimi K3 的 Stable LatentMoE 将这一设计扩展到 896 个专家(每 token 激活 16 个),并使用 Quantile Balancing 依据路由分数的分位数分配专家,而非启发式的平衡更新。
vLLM 的适配:专家通过专家并行进行分片。vLLM 提供两个面向不同拓扑调优的 MoE 后端:TRT-LLM-Gen(用于张量并行 TP > 1)与 MegaMoE(用于分离/专家并行 DEP),并支持可选的专家并行负载均衡(EPLB)确保各 rank 计算量相近。权重在 MoE 路径上以原生 MXFP4 执行。
Chat 模板:渲染程序,而非 Jinja 模板
新特性:Kimi K3 的 chat 模板必须用精确的控制 token 编码系统、用户与助手消息、多模态内容、工具定义与工具结果。与常见的先渲染成文本再分词的 Jinja 模板不同,Kimi K3 使用 Python 程序直接构建提示 token 序列。其输出同样包含推理、回答文本与工具调用等不同区域,需要解析为 API 响应。
vLLM 的适配:vLLM 在 Python 与 Rust 前端中同时实现了输入渲染器与流式输出解析器,在保留控制 token 边界的同时,把用户与工具提供的文本当作普通内容处理。对于工具调用与结构化输出,vLLM 将 Kimi K3 的格式与 XGrammar 集成,在解码时约束结构化区域,并分别返回推理、内容与工具调用字段。
为生产而生
超低延迟:DSpark 投机解码
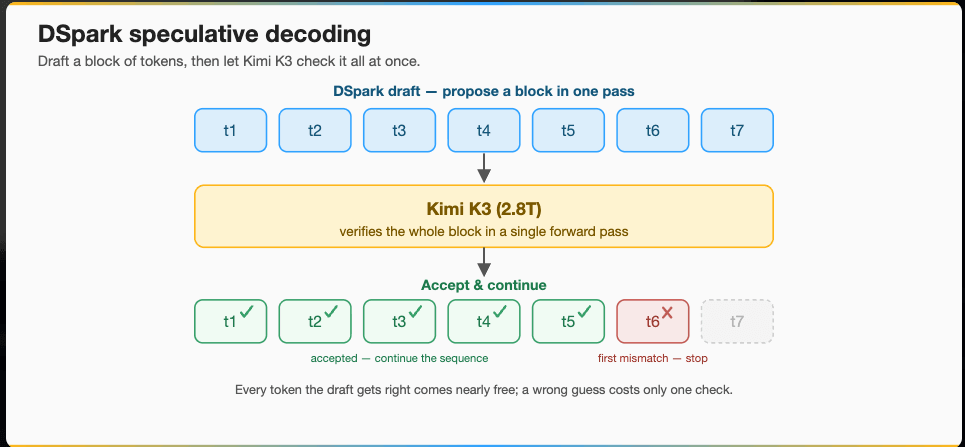
对于 2.8T 参数模型,要在不损失准确率的前提下达到超低延迟,投机解码是自然之选。因此 vLLM 从 Day-0 起就支持 SOTA 的 DSpark 投机解码算法,并使用 TorchSpec 配合 vLLM 训练并发布了 Kimi K3 的 DSpark 草稿模型,实现投机推理与训练之间的完全数值一致性。
DSpark 使用块扩散(block-diffusion)骨干,基于 Kimi K3 丰富的中间状态在一次并行前向中生成多个投机 token,使草稿成本不随块深度增长。低秩 Markov 头提供块内依赖,置信度头预测每个草稿被接受的概率。草稿模型按 MLA 原生设计,镜像 Kimi K3 自身的注意力结构,使草稿与目标共享相似的 KV 布局,最大程度兼容高级 KV 管理与 P/D 分离部署。
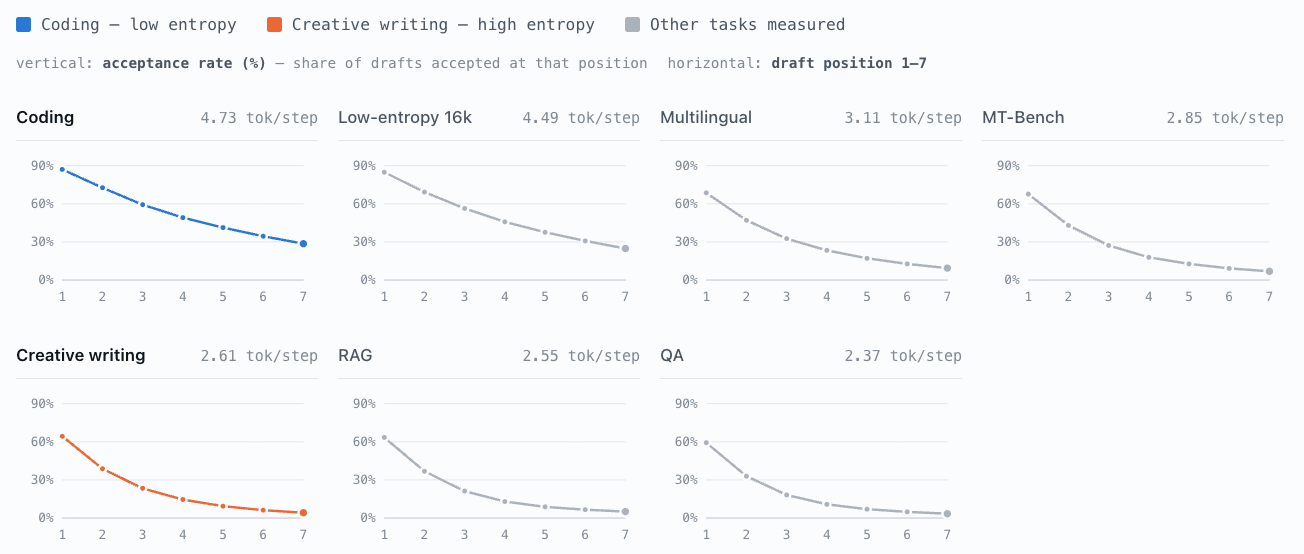
启用 DSpark 后,单用户请求提速 3.14 倍:从 118 tok/s 提升到 370 tok/s(SPEED Bench 测量)。不同任务上,编码等低熵任务每步约接受 4.73 个 token,创意写作等高熵任务约 2.61 个。
基于置信度的调度是 vLLM 中 DSpark 的后续工作:启用后利用 DSpark 模型自带的置信度头预测每个草稿 token 被接受的概率,优先验证强候选、剪掉弱候选,避免在注定被拒绝的 token 上浪费验证算力。草稿模型与推理支持均已开源。
TEP prefill 的序列并行
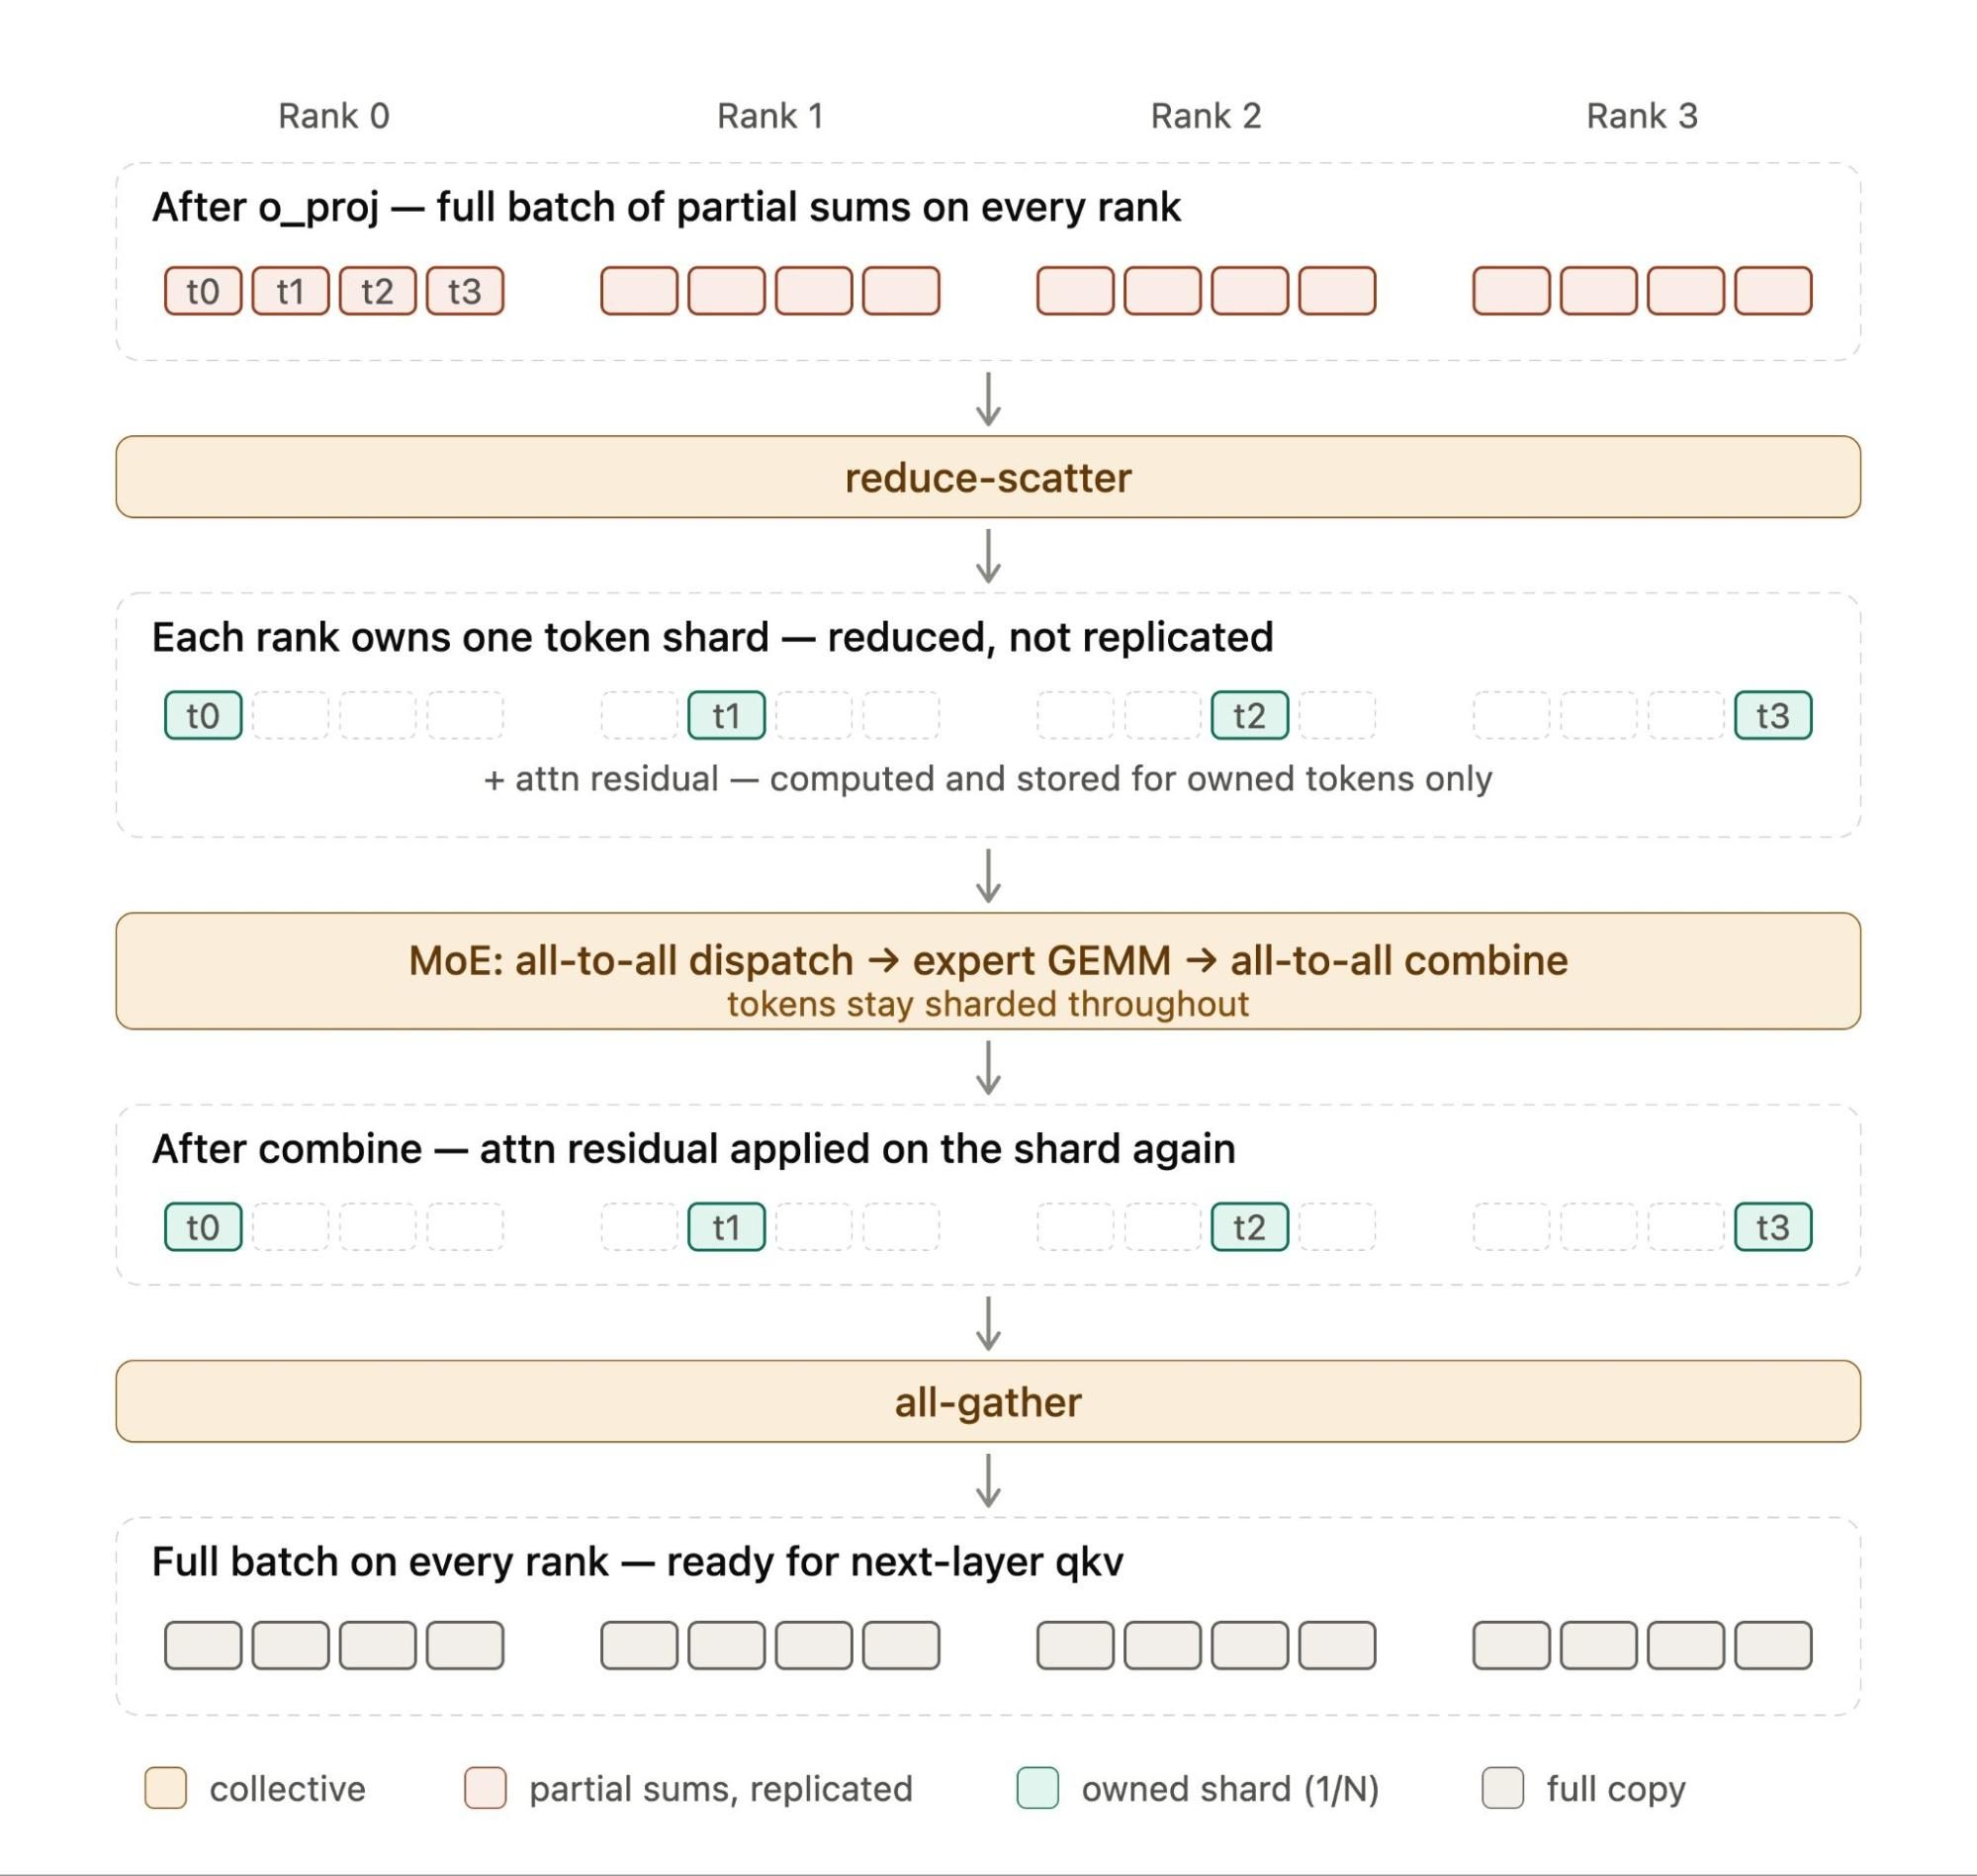
prefill 阶段将注意力张量并行与 MoE 专家并行结合(TEP)。与纯 TP 相比,TEP 降低了通信开销,且每个 rank 保留完整专家,得到更高效的专家 GEMM 形状。朴素的 TEP 实现每层要做两次 all-reduce(注意力输出投影后一次、MoE 后一次),每个 rank 都要实例化完整 batch 并冗余地对全部数据施加注意力残差。
vLLM 的序列并行方案把 o_proj 后的 all-reduce 替换为 reduce-scatter,使每个 rank 拥有部分 token;注意力残差按分片施加;MoE 的 all-to-all 完成 dispatch 与 combine;最后用一个 all-gather 在下一层 QKV 投影前恢复完整 batch。这带来两个关键优势:
- 降低通信开销:reduce-scatter + all-to-all dispatch + combine + all-gather 理论上比两次 all-reduce 更省。由于 NCCL 的 reduce-scatter/all-gather 对 prefill 消息大小未做优化,vLLM 实现了自定义内核,中小消息下比 NCCL 快 1.7–4.5 倍
- 分片注意力残差:残差在整个层内保持跨 rank 分片,每个 rank 只计算和维护自己的 token 分片。这对 Kimi K3 尤其重要——AttnRes 把残差流变成了带独立计算与内存开销的跨层持久状态
在合适场景下(TP + MegaMoE 内核,或 TP + DP + EP 组合)序列并行默认启用,无需额外参数。
大规模服务:prefill/decode 分离
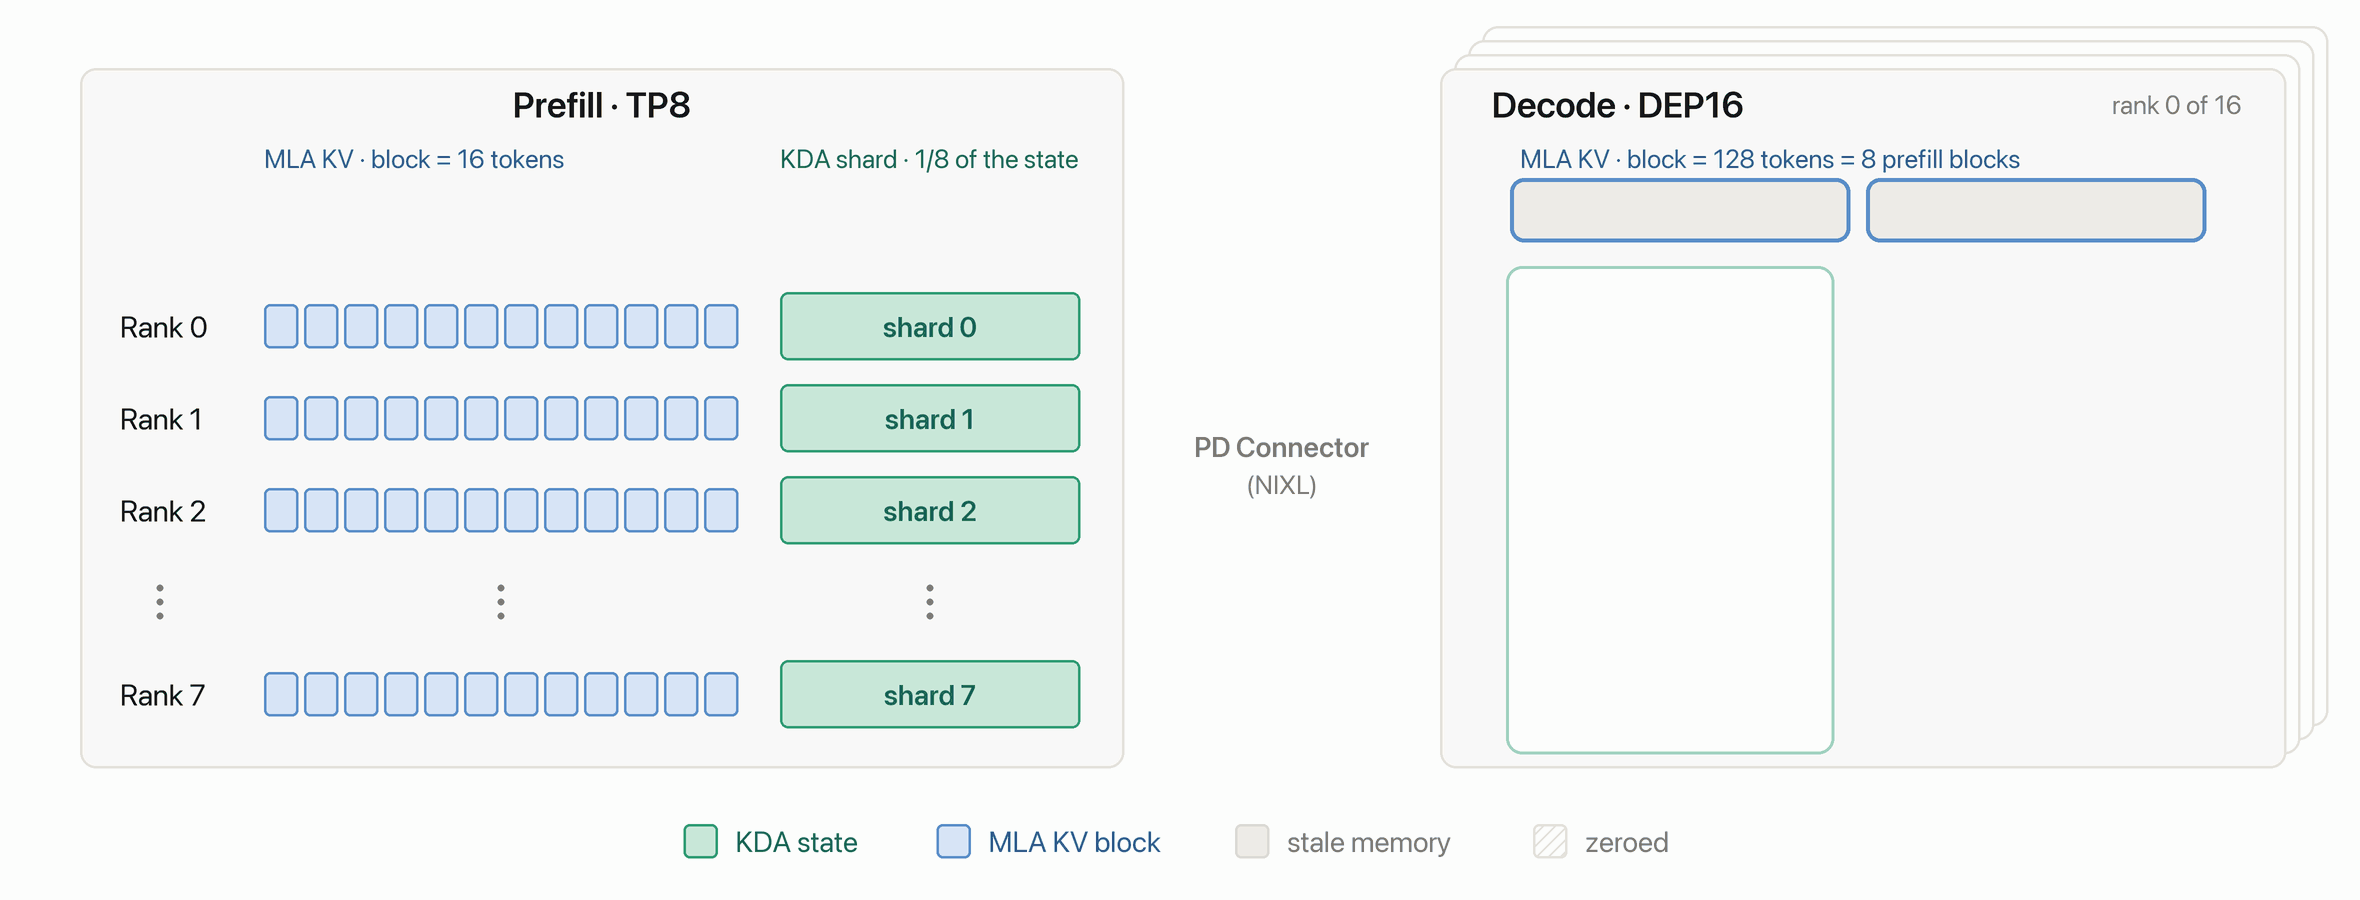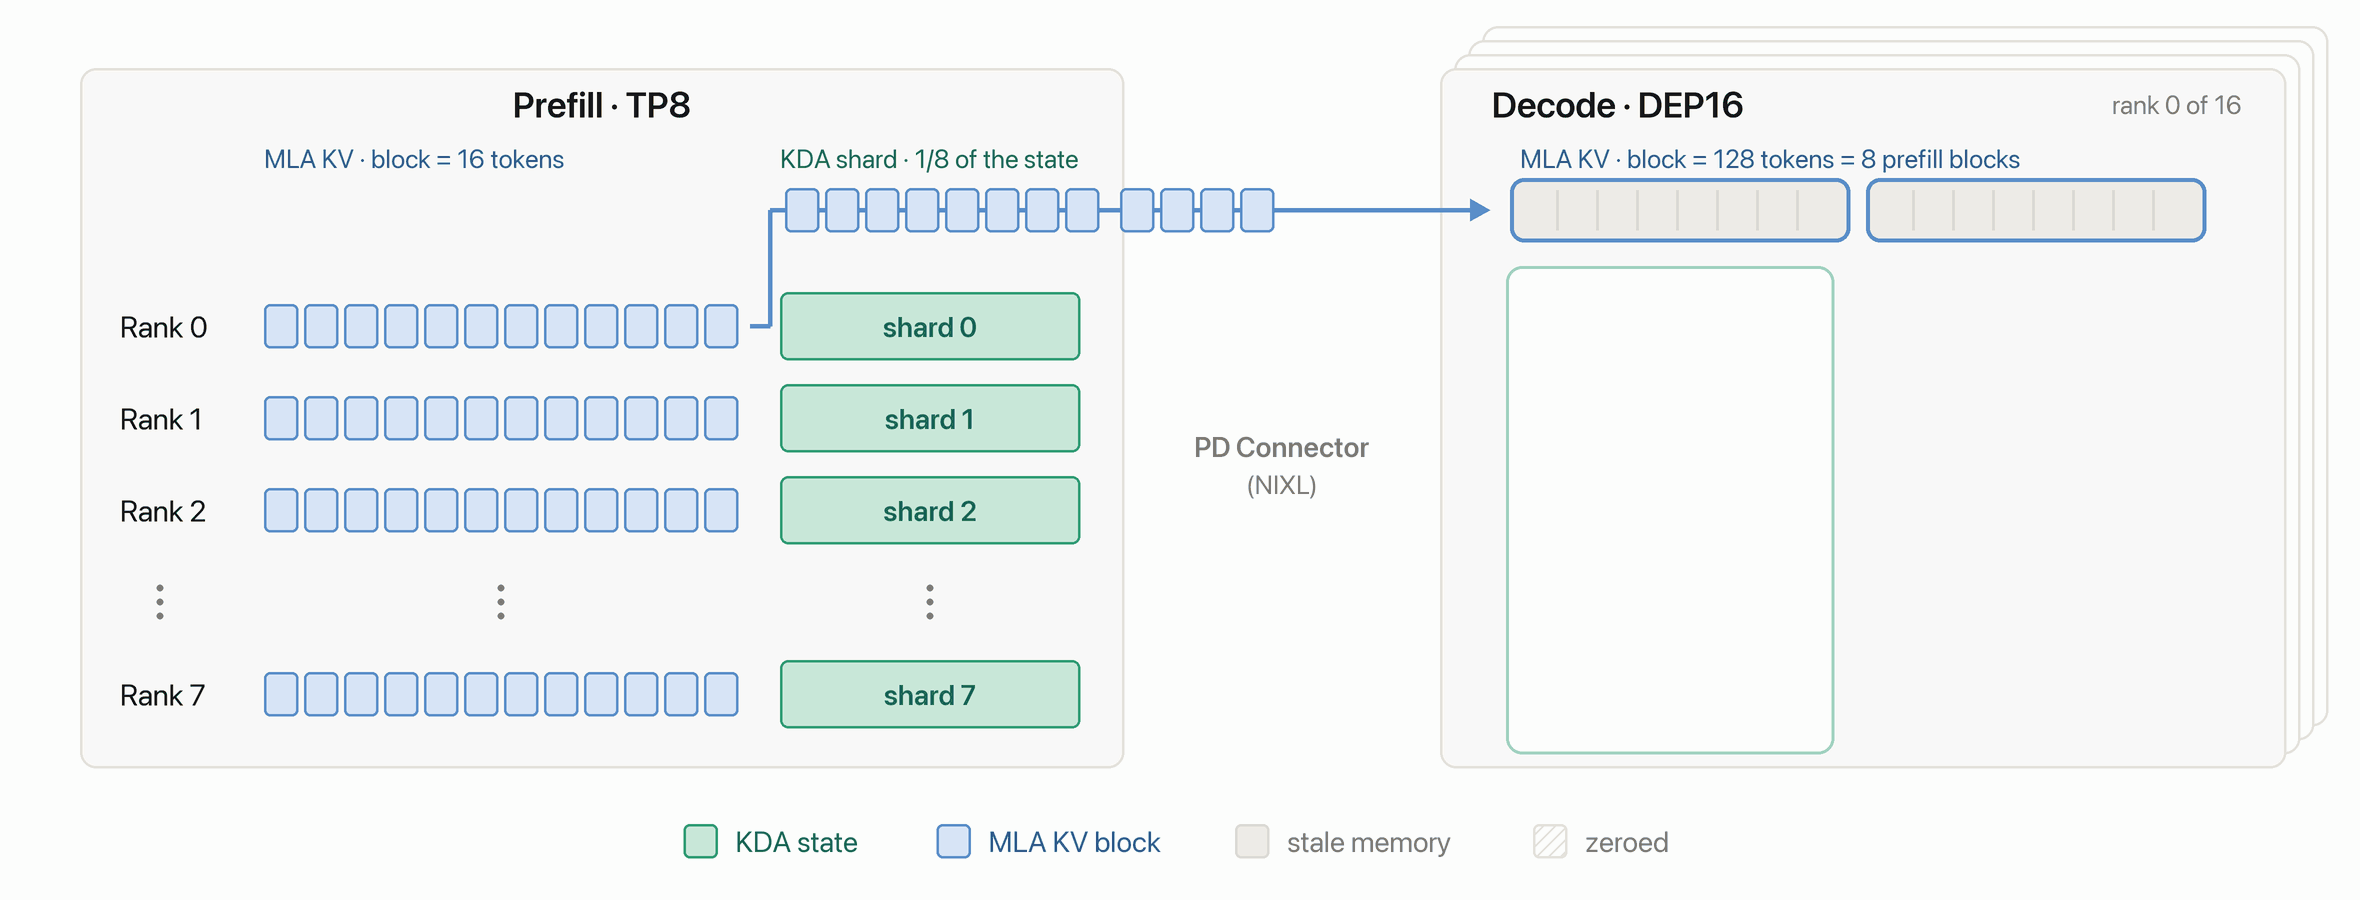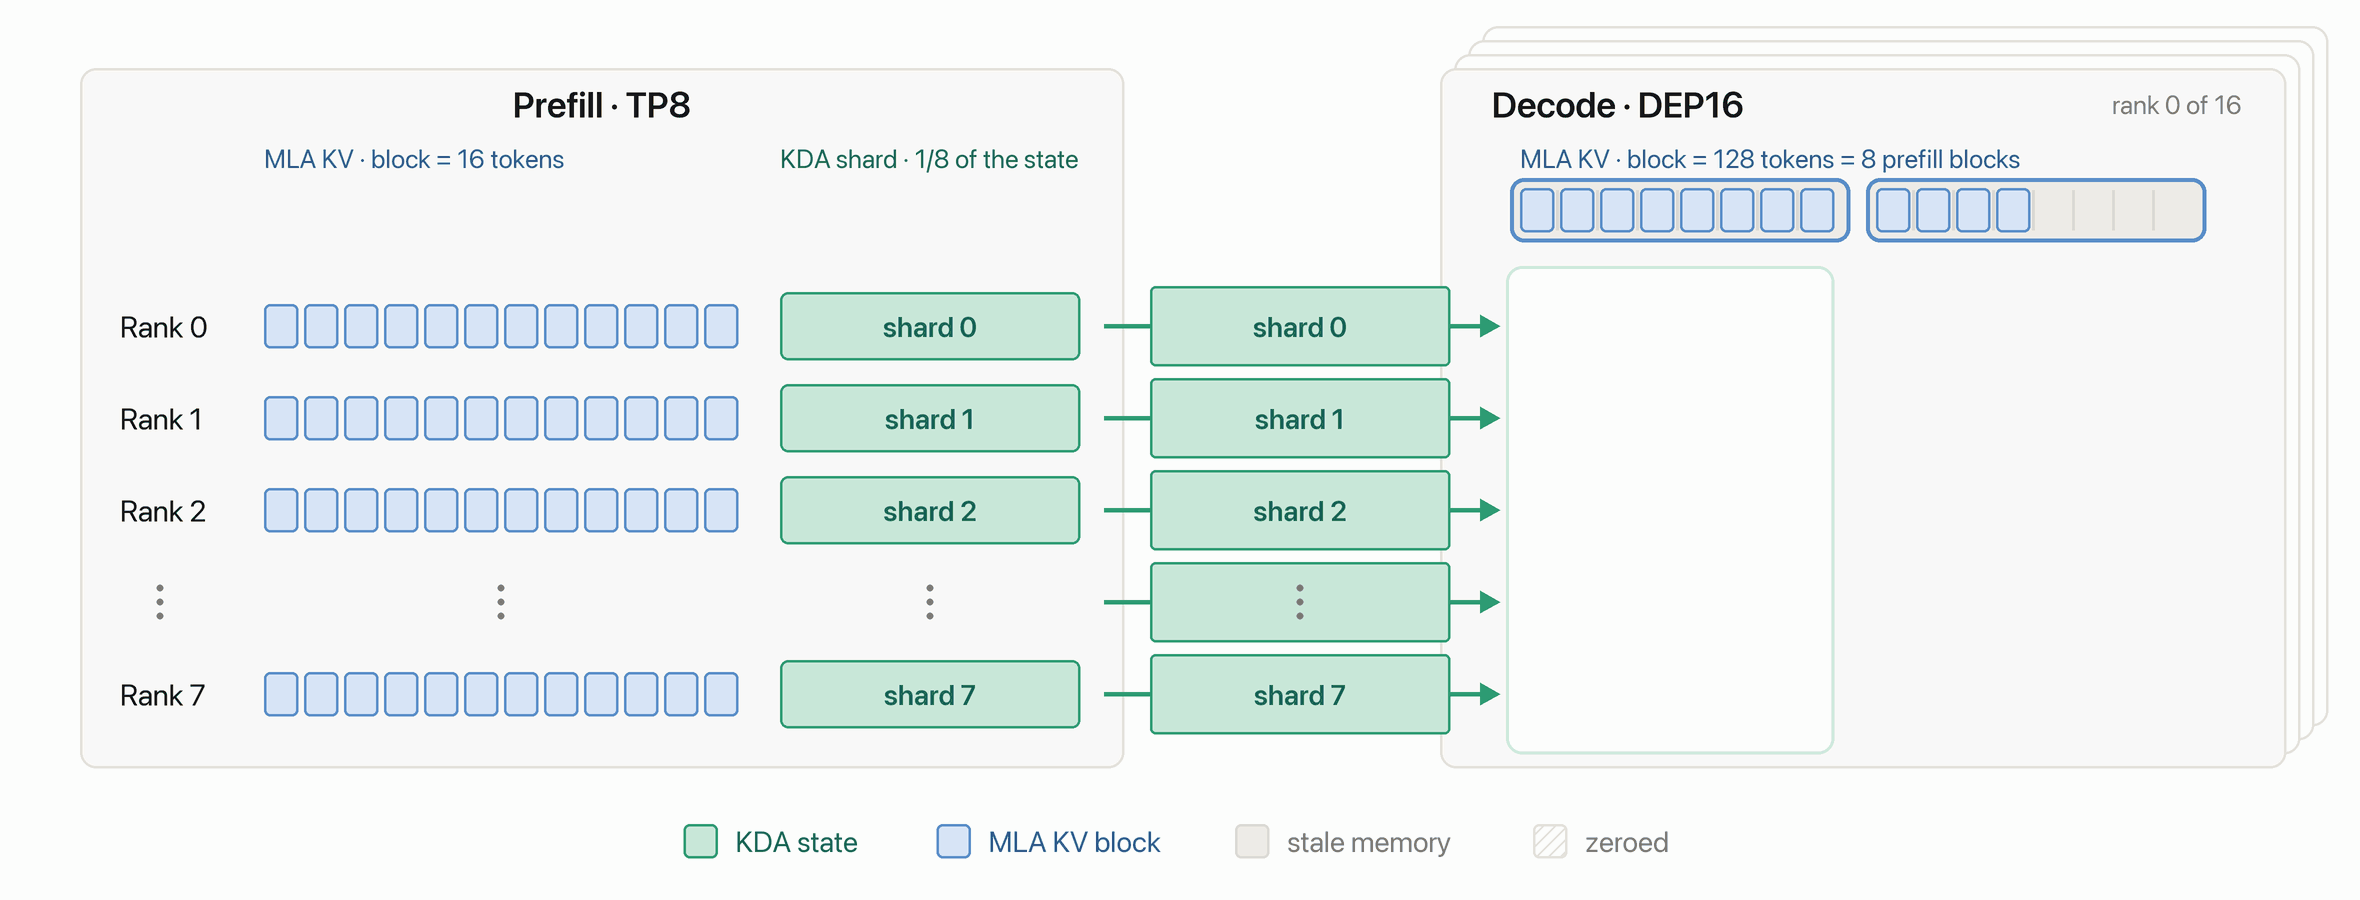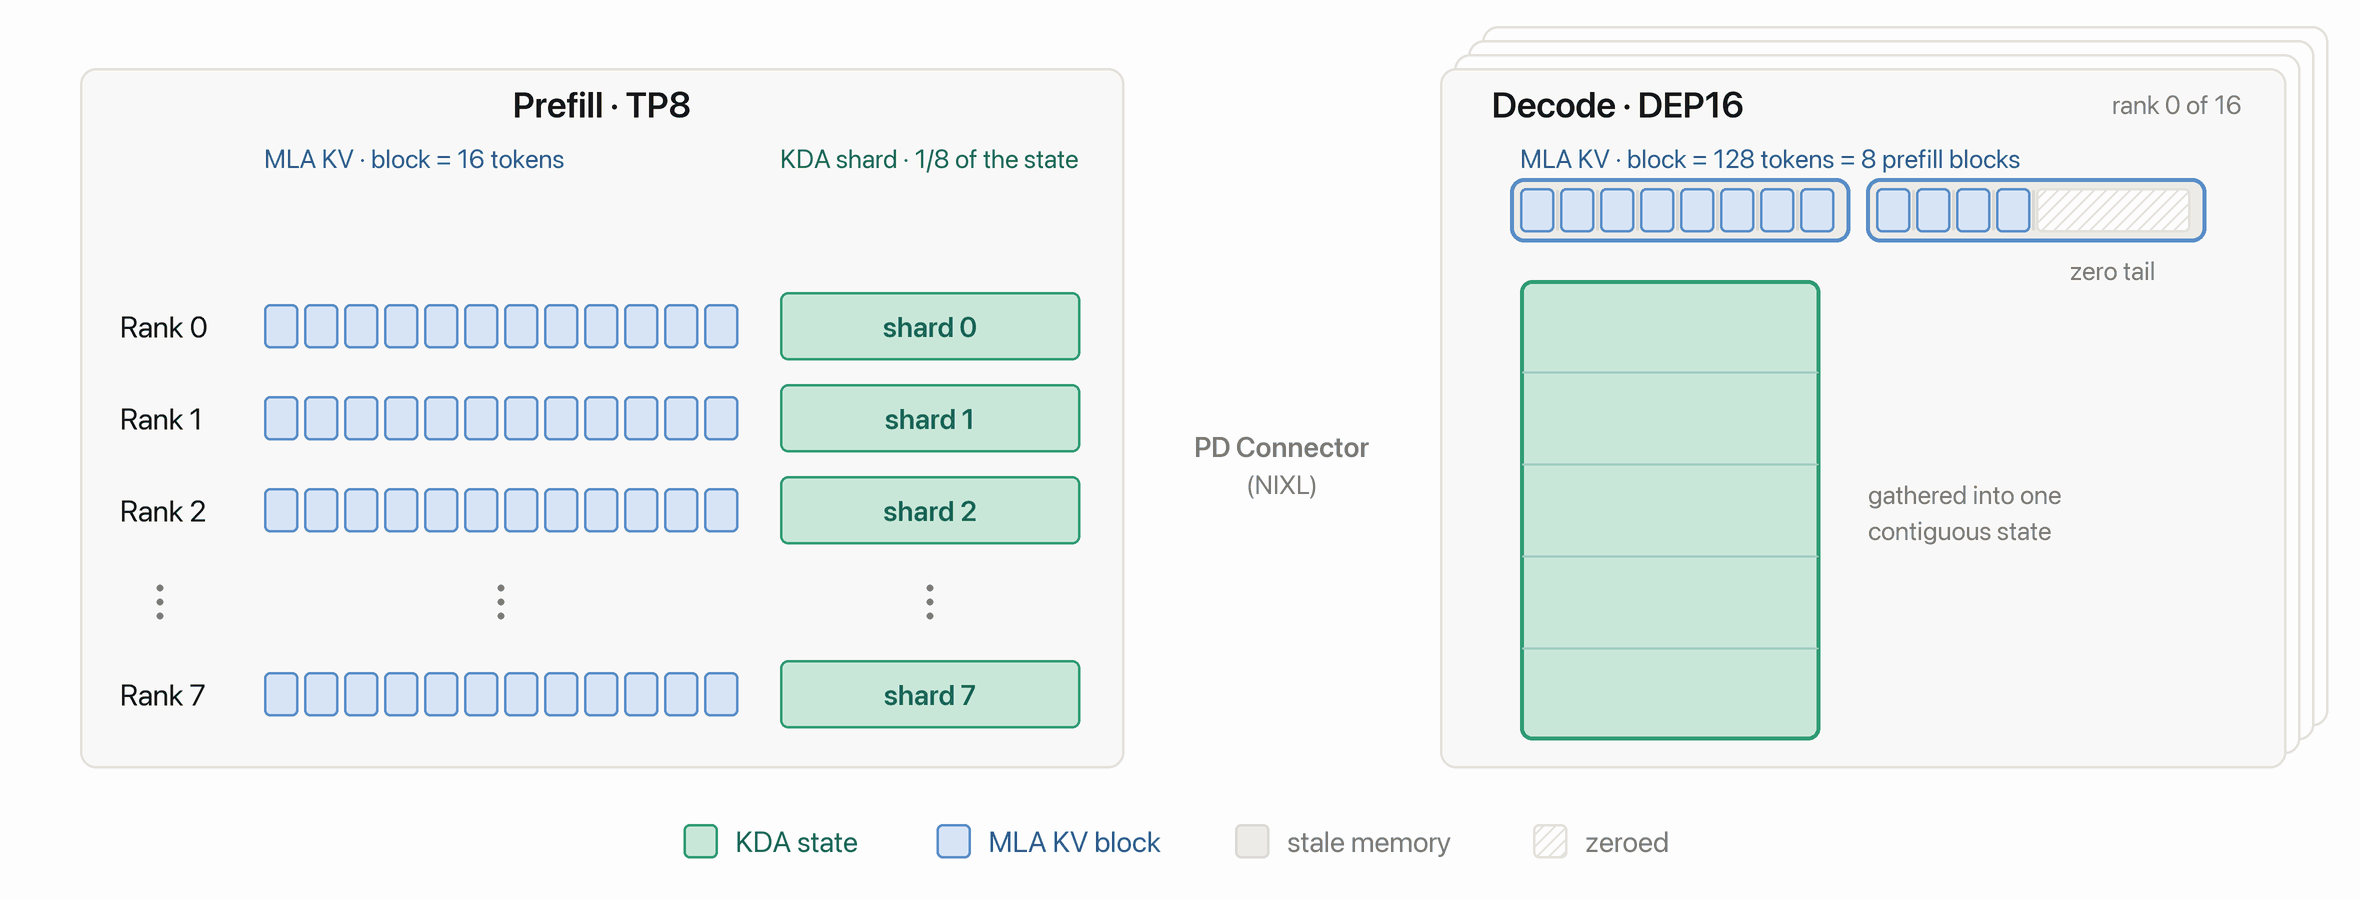
高吞吐场景下,vLLM 以专家与数据并行跨节点服务 Kimi K3,并启用 prefill/decode(PD)分离:prefill 密集与 decode 密集的工作分别运行在独立副本上,各自按瓶颈调优。一个已验证的拓扑是 TEP8 prefill 到 DEP16 decode,以 NIXL 作为 KV 传输引擎。
对混合模型而言,PD 分离不容出错:循环 KDA 状态、全注意力分页 KV 与块表都必须正确到达。NIXL 连接器把共享的 KV 缓存页视为两个逻辑视图:token 级 MLA 缓存与请求级 KDA 状态(含卷积与循环状态)。握手时交换 MLA/KDA 元数据,再为每次传输构建独立的传输描述符。在异构 TP 下,vLLM 的混合分配器为 prefill 与 decode 使用不同块大小,NIXL 连接器跟踪逻辑到物理的块映射,并清零未传输的尾部区域,防止先前请求的陈旧数据通过填充或布局空隙泄漏。
部分块缓存命中与 KV 缓存卸载的协调
vLLM 支持结束于物理缓存块内部的细粒度前缀命中,这给 KV 卸载带来微妙挑战:本地 GPU 可能先找到带部分尾部的命中,随后在外部存储(如 Mooncake)中发现更长前缀。整块命中时远程复用可干净地扩展到本地前缀之外,但部分尾部可能与远程结果重叠。
调度器因此会比较两个层级可复用的精确 token 长度并选择更长前缀;若远程命中胜出,则释放为较短本地尾部预留的块,并将所有缓存组协调到新的前缀长度。这套机制完全基于现有 KV Connector API 构建,使 MooncakeStoreConnector、SimpleCPUOffloadConnector 等连接器无需模型专属集成路径即可支持多层部分前缀复用。
智能体服务:更智能的缓存保留策略
Kimi K3 的线性注意力层只需恒定大小的 KDA 状态,长上下文下内存效率很高(单层 KDA 状态约相当于数千 token 的 MLA 缓存)。与常规 KV 缓存不同,该状态不随序列长度增长——这对横跨数十万到一百万 token 的智能体工作负载意义重大。
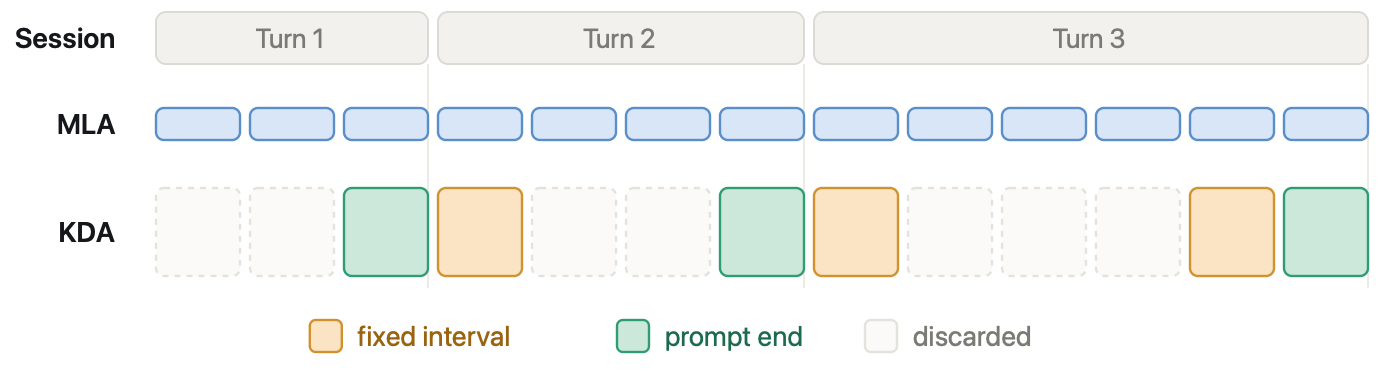
但同样的设计也使前缀缓存复杂化:KDA 状态在解码中原地更新,vLLM 必须在下一次前向覆盖前,在选定的前缀边界复制状态。在每个 token 位置缓存代价过高(每个 KDA 检查点远大于单 token 的 MLA 缓存)。为此 vLLM 支持两种互补的保留策略。
间隔式保留
把选定位置作为检查点(例如每 32K token 一个)来平衡缓存成本与重算成本。提示边界是更好的检查点:智能体工作负载的下一轮通常从重放上一轮提示开始,因此提示结尾的状态最可能被复用,vLLM 会自动检测并保留这些边界。
用户可通过 VLLM_PREFIX_CACHE_RETENTION_INTERVAL 控制周期性检查点:设为 0 时禁用周期性检查点、只保留提示结尾状态,适合多轮对话为主的工作负载;间隔越大,用更多重算换更低缓存占用。
Marconi 式选择性保留
系统提示、仓库快照或工具定义可能跨大量请求复用,却不与提示边界对齐。Marconi 式保留(MLSys ‘25)用一条简单规则处理:第二次命中才缓存。第一次观察证明前缀存在,第二次证明它确实被共享,此后 vLLM 才为它的 KDA 状态投入缓存容量。一次性前缀不会挤占缓存,热点前缀自动提升,无需用户预测工作负载的哪些部分会变热。
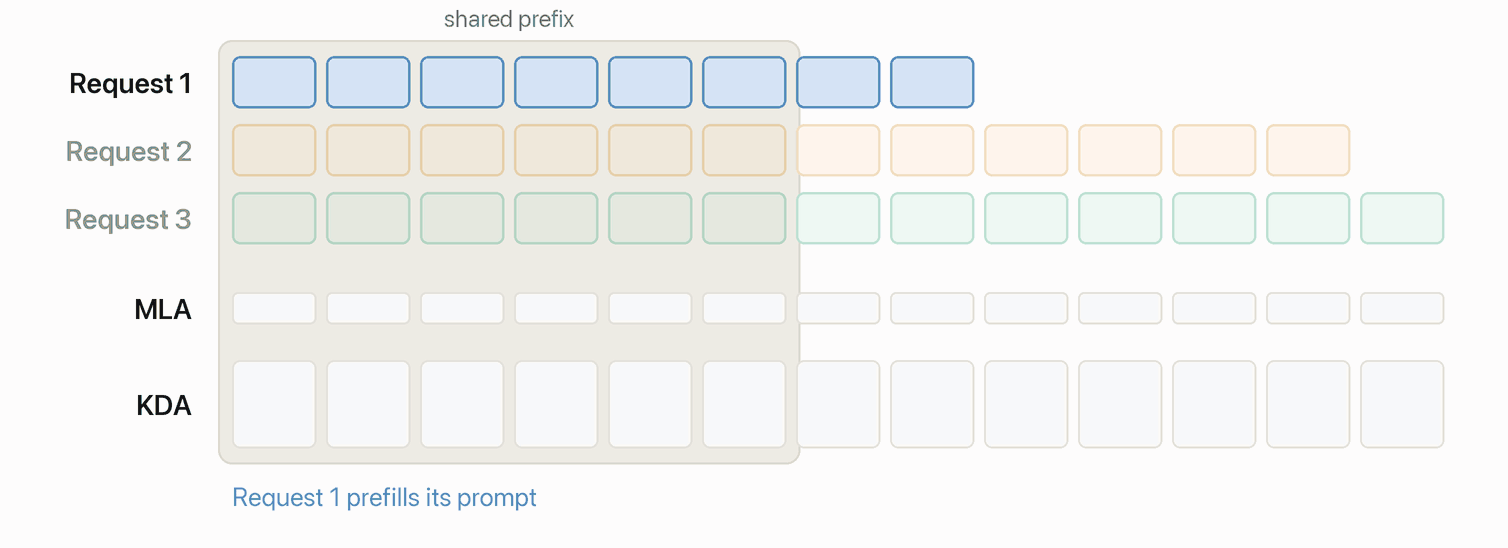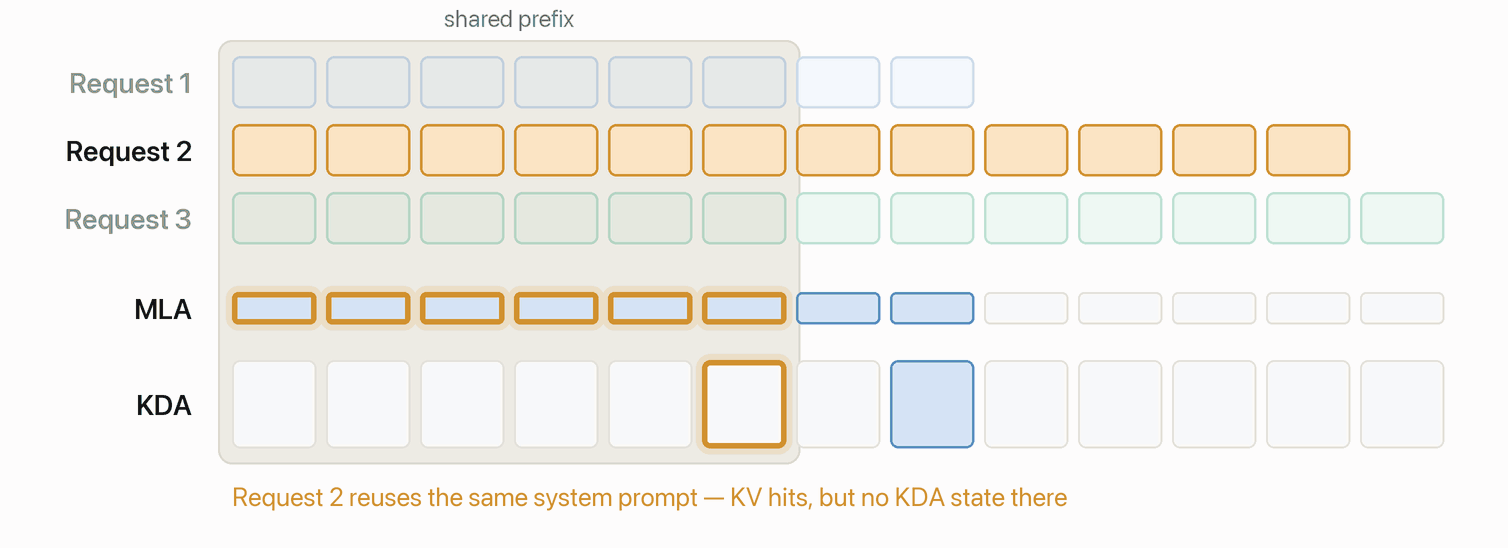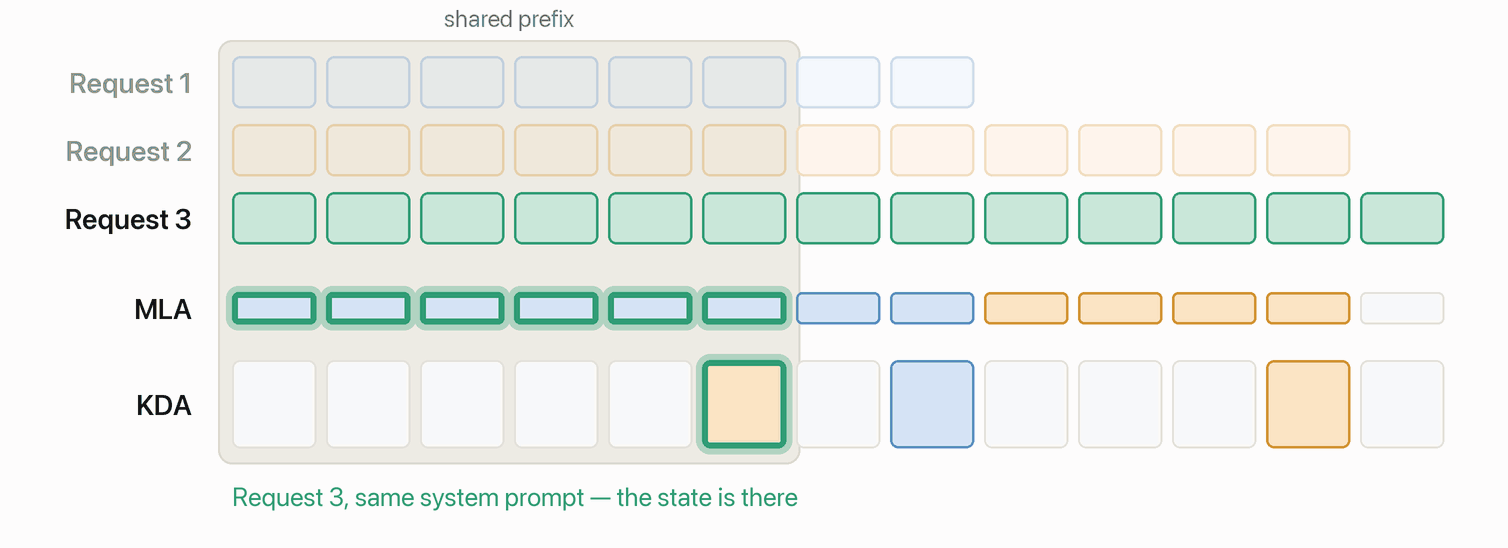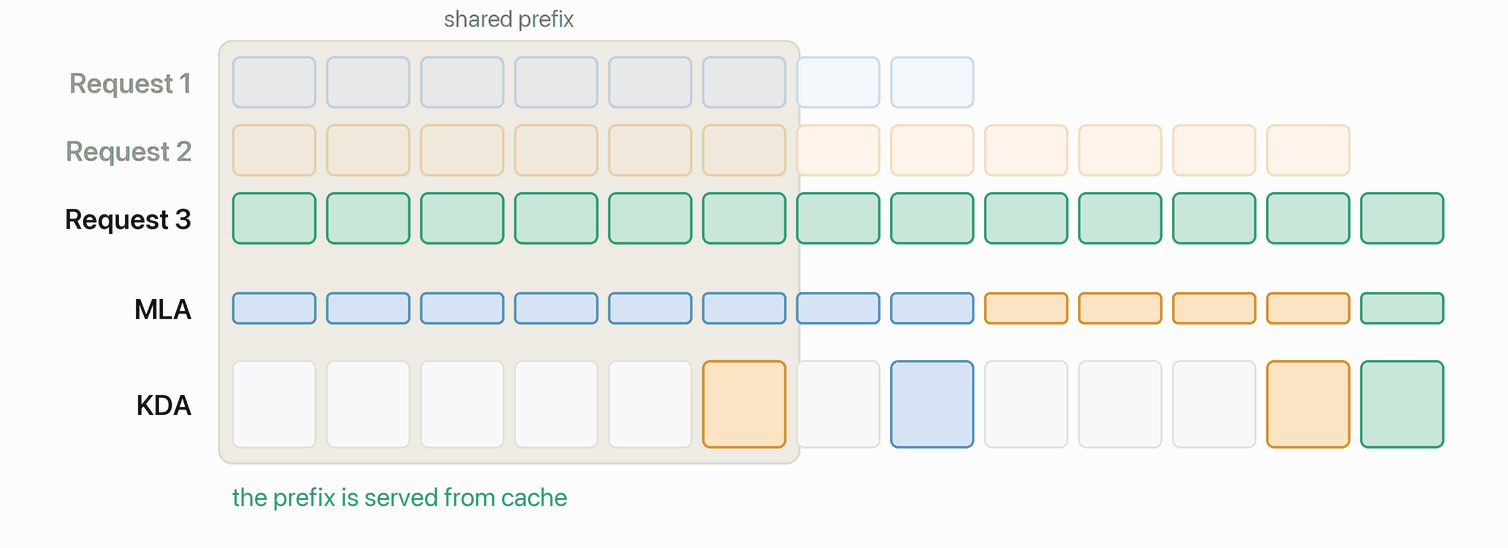
选择性缓存保留:请求 1 只在自身提示结尾保留 KDA 状态(位于共享前缀之后),因此请求 2 命中 KV 但 KDA 未命中;第二次出现证明该前缀确实被共享,于是前缀边界处缓存了状态,请求 3 即可直接复用。
两种策略互补:间隔保留为结构性重要边界做检查点,Marconi 式保留则学习哪些其他前缀值得保留。
性能优化
Kimi K3 的规模带来了独特挑战:整个模型勉强能放进单台 NVIDIA DGX B300,在该硬件世代上服务至少需要 16 块 B200/GB200 GPU。服务需要在交互性与系统总吞吐之间权衡:张量并行利于交互性,但有效 KV 缓存受限导致总吞吐低;大规模专家并行又可能因网络带宽瓶颈限制单用户输出速度。以下是 vLLM 为两种场景提升性能的关键优化。
Attention Residuals
Kimi K3 使用 Block AttnRes,最多对 8 个缓存块表示加上当前块内残差做注意力。vLLM 对每个 token 从 RMS 归一化来源计算 logits,在深度维候选上做 softmax 并聚合表示,类似 FlashAttention 的在线 softmax 策略但作用于模型深度而非序列位置,且最多 9 个来源。混合在单个融合内核中完成:输入处并入残差更新,输出处可选应用 RMSNorm。可移植的 Triton 实现覆盖通用路径,专用 CUDA 内核加速受支持的 Blackwell 配置。
KDA decode
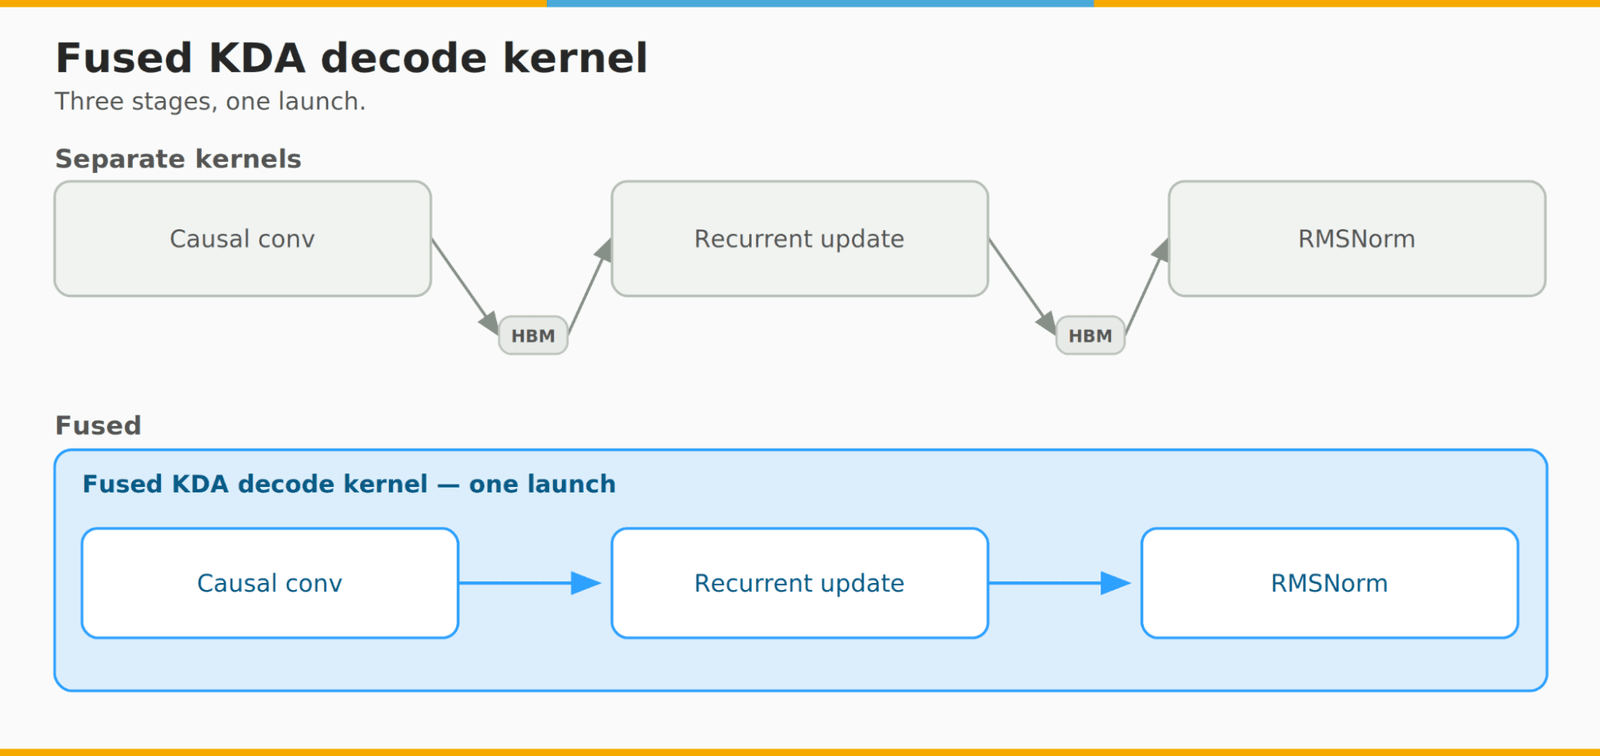
KDA 层包含大量操作:输入投影、因果一维卷积、QK 归一化、门控计算、KDA 循环更新与输出门控 RMSNorm。在受支持的配置上,vLLM 把投影后的 decode 路径(从因果卷积到门控 RMSNorm)融合为单个专用 CUDA 内核,原地更新卷积与循环状态并直接写出归一化输出,避免中间张量、重复状态流量与逐操作启动开销。不支持的配置回退到可移植的 Triton 路径。
KDA prefill
KDA prefill 成为开源协作的典型范例:月之暗面先开源了高性能 CUTLASS 实现 FlashKDA,vLLM 快速集成并解决 GPU 覆盖、元数据 dtype、张量布局与可靠 vendoring 等生产细节;随后独立贡献者 Shikhar Mishra 为 H100 优化内核并发布 Flash-Flash-KDA,在保持数值正确性的同时改善数据移动。vLLM 团队在一天内于 GB300 NVL72 上验证改进、完善循环流水线与同步并合入 FlashKDA 集成——不是单向交接,而是服务社区扩展内核、独立贡献者改进、快速进入生产的持续循环。
KDA 元数据构建器
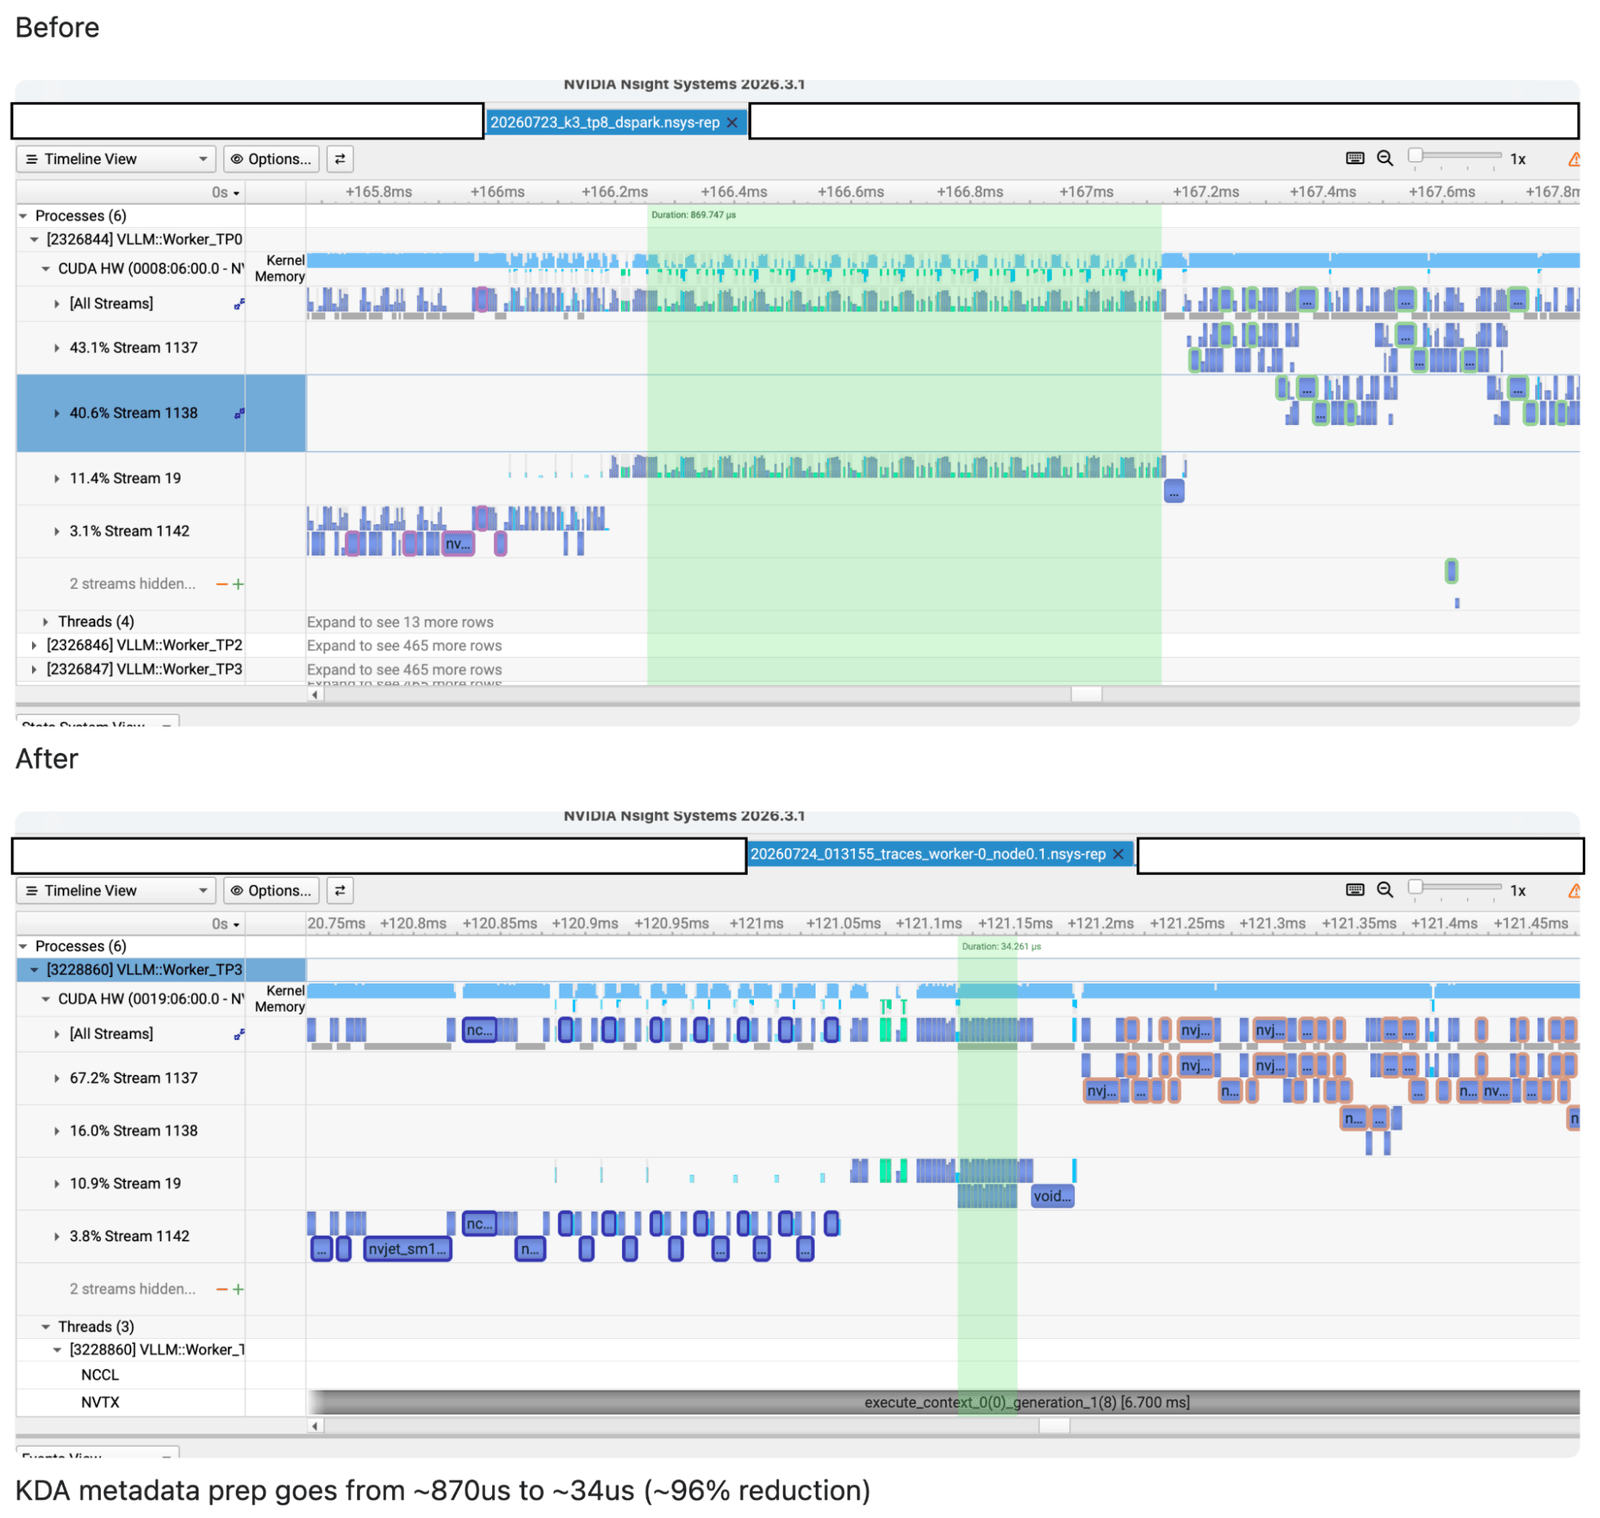
Kimi K3 DSpark 调优期间,KDA 元数据准备成为显著开销来源。vLLM 引入专用 KDA 元数据构建器,裁剪未使用路径,并用融合 Triton 内核替代零碎的小型 PyTorch 操作序列,把每个序列减为一次内核启动。batch size 为 1 时,元数据准备延迟降低 96%(从 870μs 降到 34μs),端到端 DSpark 延迟改善 6%。
低延迟 BF16 GEMM
低 batch、延迟敏感场景下,vLLM 用自研 skinnyGEMM 取代通用 BF16 GEMM(用于多个线性投影层)。通用 cuBLAS 内核为更一般的形状优化,此处并非最优。新内核绕过共享内存数据暂存,把激活与权重直接载入寄存器,用 CUDA Core FMA 指令完成计算,避开追求最大吞吐的 TMA 与 Tensor Core 初始化开销。微基准显示内核级加速 8%–100%,小 batch 场景端到端延迟降低约 10%。
低延迟 MoE 尾部融合
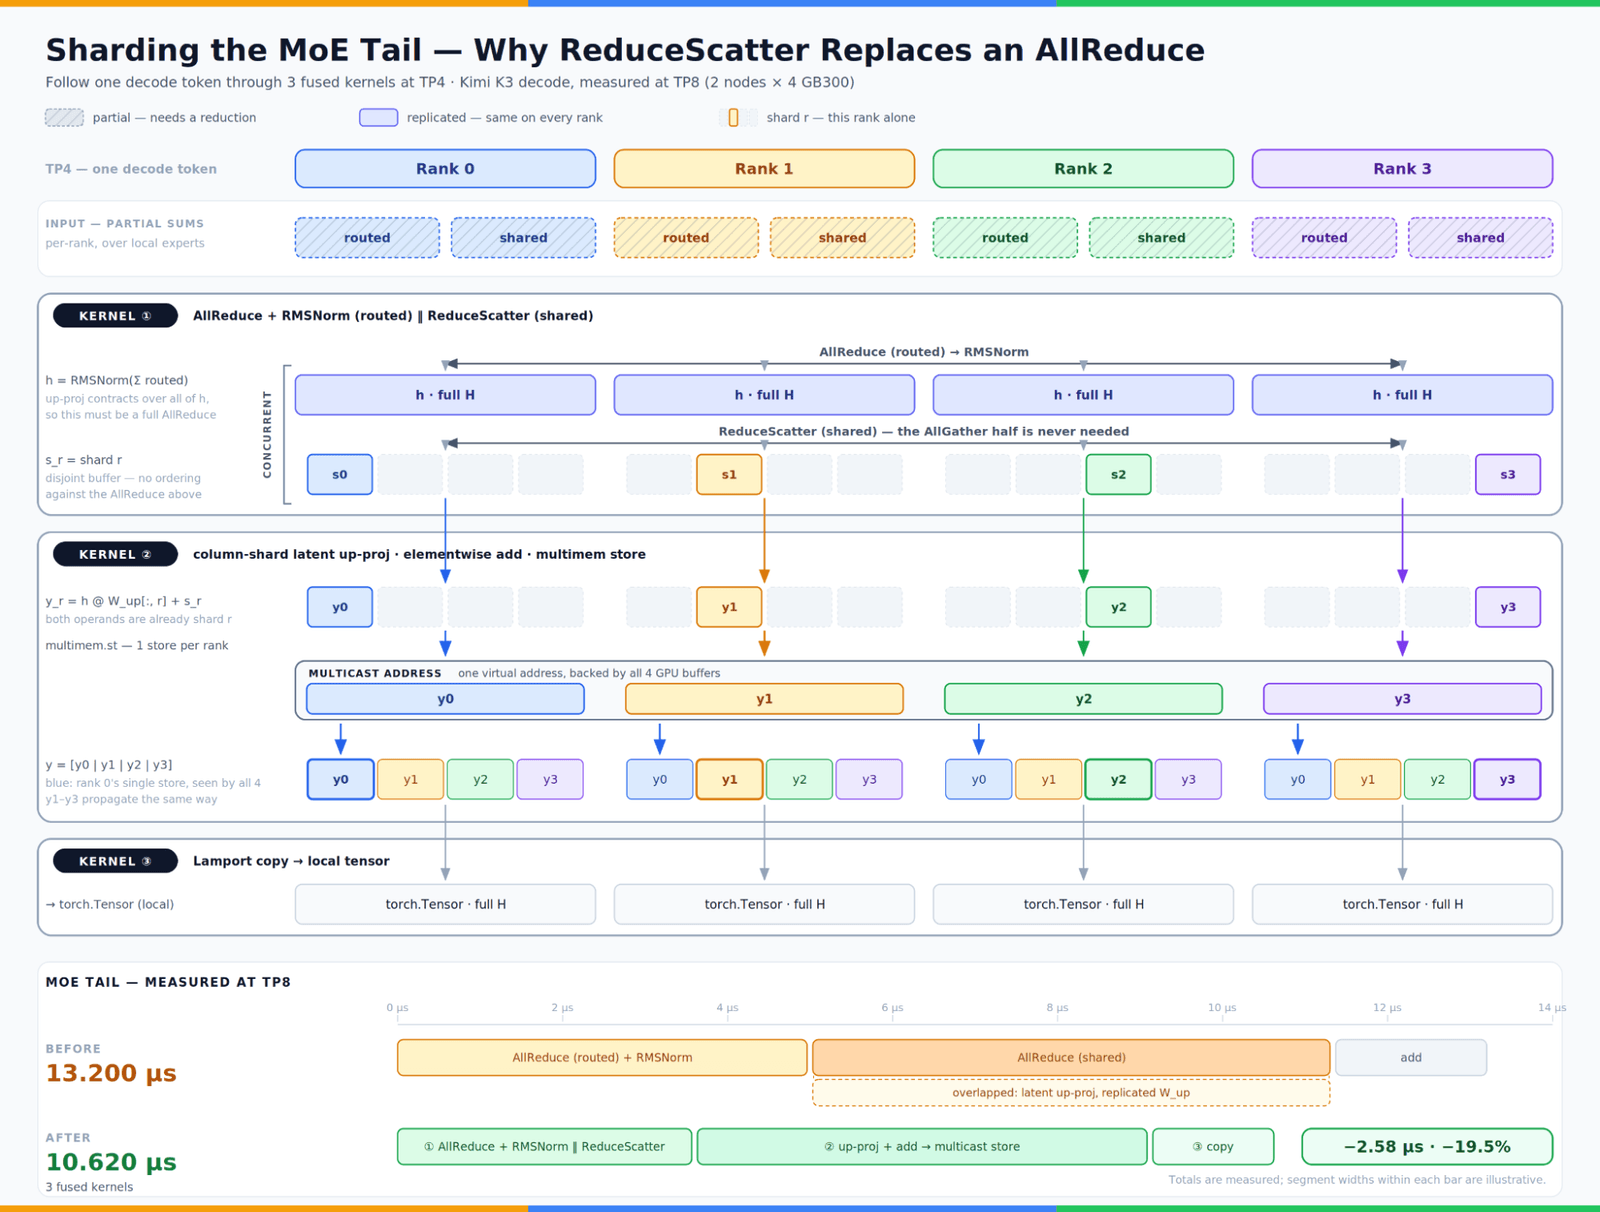
LatentMoE 尾部优化把两次 all-reduce、RMSNorm、潜空间升维投影与逐元素相加合并为三个内核,减少计算并更好地重叠通信与计算。常规 TP 下路由专家输出需 RMSNorm 与升维投影后再与共享专家输出相加,需要两次 all-reduce(或一次带拼接的 all-reduce)并复制升维投影。vLLM 改为对共享专家做 reduce-scatter、对路由专家保留 all-reduce(其激活需要归一化),复制后的路由专家激活与升维投影按列并行做矩阵乘,再与已分片的共享专家输出逐元素相加,最后用 broadcast 收集到各 rank。该步骤延迟降低约 20%,端到端提速 7%–8%。
质量与性能基准
准确率与正确性
vLLM 通过 OpenAI 兼容端点端到端验证 Kimi K3。在最高推理强度下,Kimi K3 on vLLM 的 GSM8K 得分 0.976、GPQA-Diamond 0.939、OCRBench 0.889、MMMU Pro Vision 0.818。需要注意:Kimi K3 回答前会大量思考,低分更多是回答被截断而非答错——先提高推理强度、设置充足的 max_tokens,并检查是否生成被截断,再排查其他问题。
服务性能
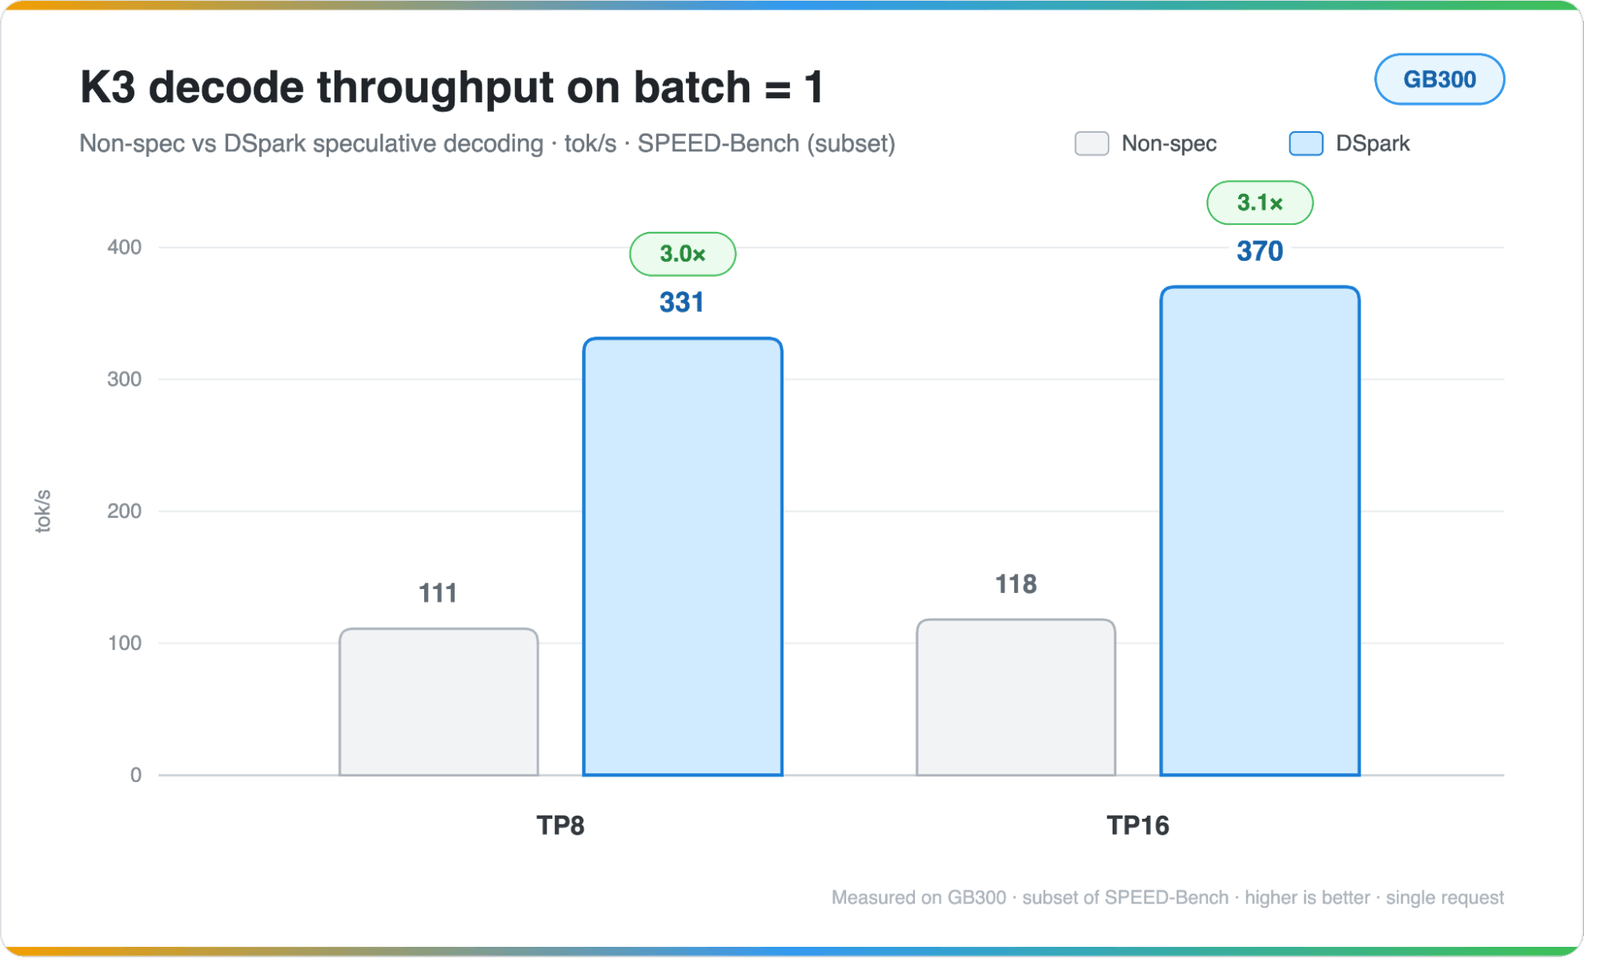
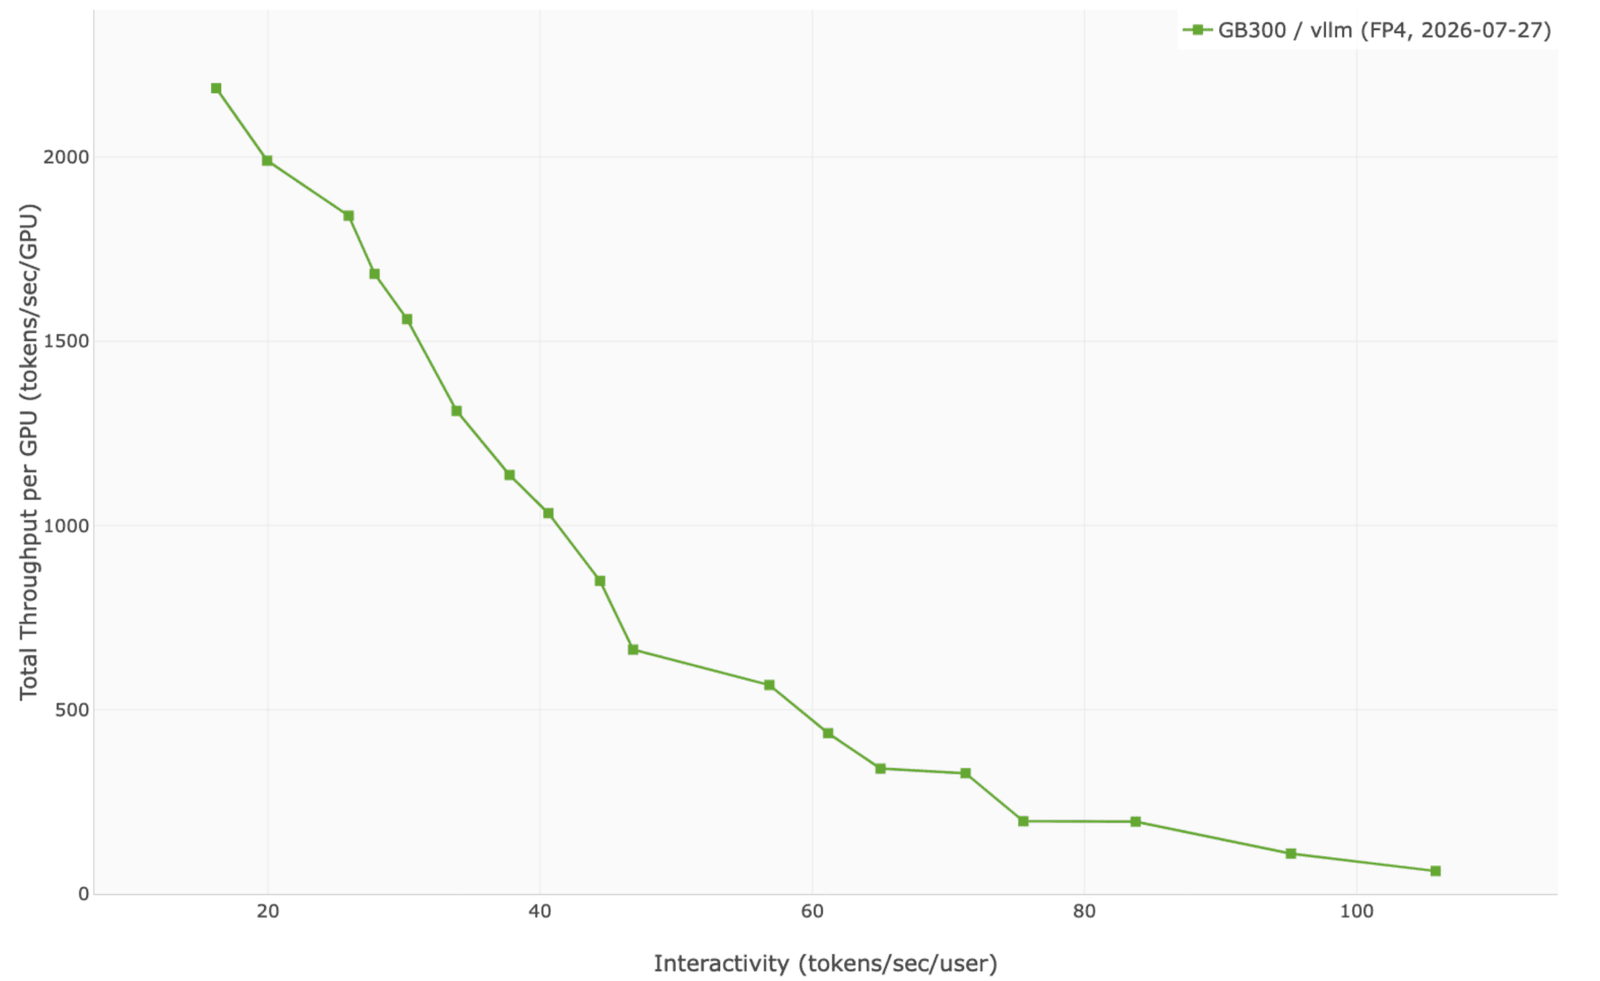
发布时,batch size 1 下 vLLM 在 TP8 上达到每用户 111 tok/s,TP16 上 118 tok/s;DSpark 投机解码将交互性能提升约 3 倍:TP8 331 tok/s、TP16 370 tok/s。vLLM 还发布了 GB300 NVL72 上从 2K+ TPGS 高吞吐到 100+ TPS/user 低延迟场景的初始 Pareto 前沿结果。
重要部署提示
- 前缀缓存:Kimi K3 的前缀缓存设计仍在演进,默认关闭,需显式传入
--enable-prefix-caching - 工具调用:上线前务必用自己的流量验证——K3 偶尔会输出其解析器不期望的工具调用格式,导致
tool_calls为空,而相同配置的干净探针完全正常。生产智能体应校验 schema、在空结果时重试或回退,并考虑严格/结构化工具调用 - All-to-all 后端:专家并行时用
--all2all-backend指定通信方式:NVLink 用flashinfer_nvlink_one_sided,RDMA 用deepep_v2 - MoE 后端:DEP 环境推荐
deep_gemm_mega_moe - Rust 前端:设置
VLLM_USE_RUST_FRONTEND=1启用完整支持 - ViT 并行:
--mm-encoder-tp-mode=data默认启用;K3 视觉编码器 head_size=12 无法在 TP=8 下均匀分片,且参数不足 1B,默认用 ViT DP 避免编码器 all-reduce 开销
FAQ 摘要
- 服务 Kimi K3 需要多少 GPU? 至少一个 8× B300(或 GB300 NVL72)节点,16× B200 也支持;多数生产部署通过 RDMA 或 NVLink 跨节点使用专家与数据并行
- 如何启用 DSpark? 加上文 speculative-config 参数即可,在推理与编码负载上单流 decode 约提速 3 倍
- 选哪个 MoE 与 all-to-all 后端? DEP 用
deep_gemm_mega_moe,TP > 1 用flashinfer_trtllm;all-to-all 按互联选:NVLink 用flashinfer_nvlink_one_sided,RDMA 用deepep_v2 - Kimi K3 支持前缀缓存吗?默认开启吗? 支持对全注意力 KV 与循环 KDA 状态的前缀缓存,但默认关闭,需传
--enable-prefix-caching - AMD GPU 支持吗? 支持,发布即提供 ROCm 支持,更广泛的调优在路线图上
路线图
- RL 支持:vLLM 已加入 rollout 支持,将与 RL 生态项目合作实现 Kimi K3 的端到端 RL 训练
- 持续性能优化:Day-0 之后继续提升性能
- Decode Context Parallelism(DCP):原型显示良好加速,即将合入上游;早期实验在部分负载下比 TP8 吞吐高 40%
- EPLB:继续改进专家并行负载均衡
- 置信度调度:用 DSpark 置信度头剪掉无需验证的草稿 token
- 更广泛的 AMD ROCm 调优
原文:Kimi K3 Is Here: Efficient Day-0 Support on vLLM(vLLM Team & Inferact,2026-07-27)


