大多数 AI 应用都围绕单个模型端点构建。但随着模型、设备与部署约束日益多样化,没有任何单一模型能适配每一个请求或环境。真正的问题是如何通过一个接口协调、评测并服务多个专用模型——vLLM Semantic Router 团队把这种系统化方法称为 Mixture-of-Models(MoM,模型混合)。
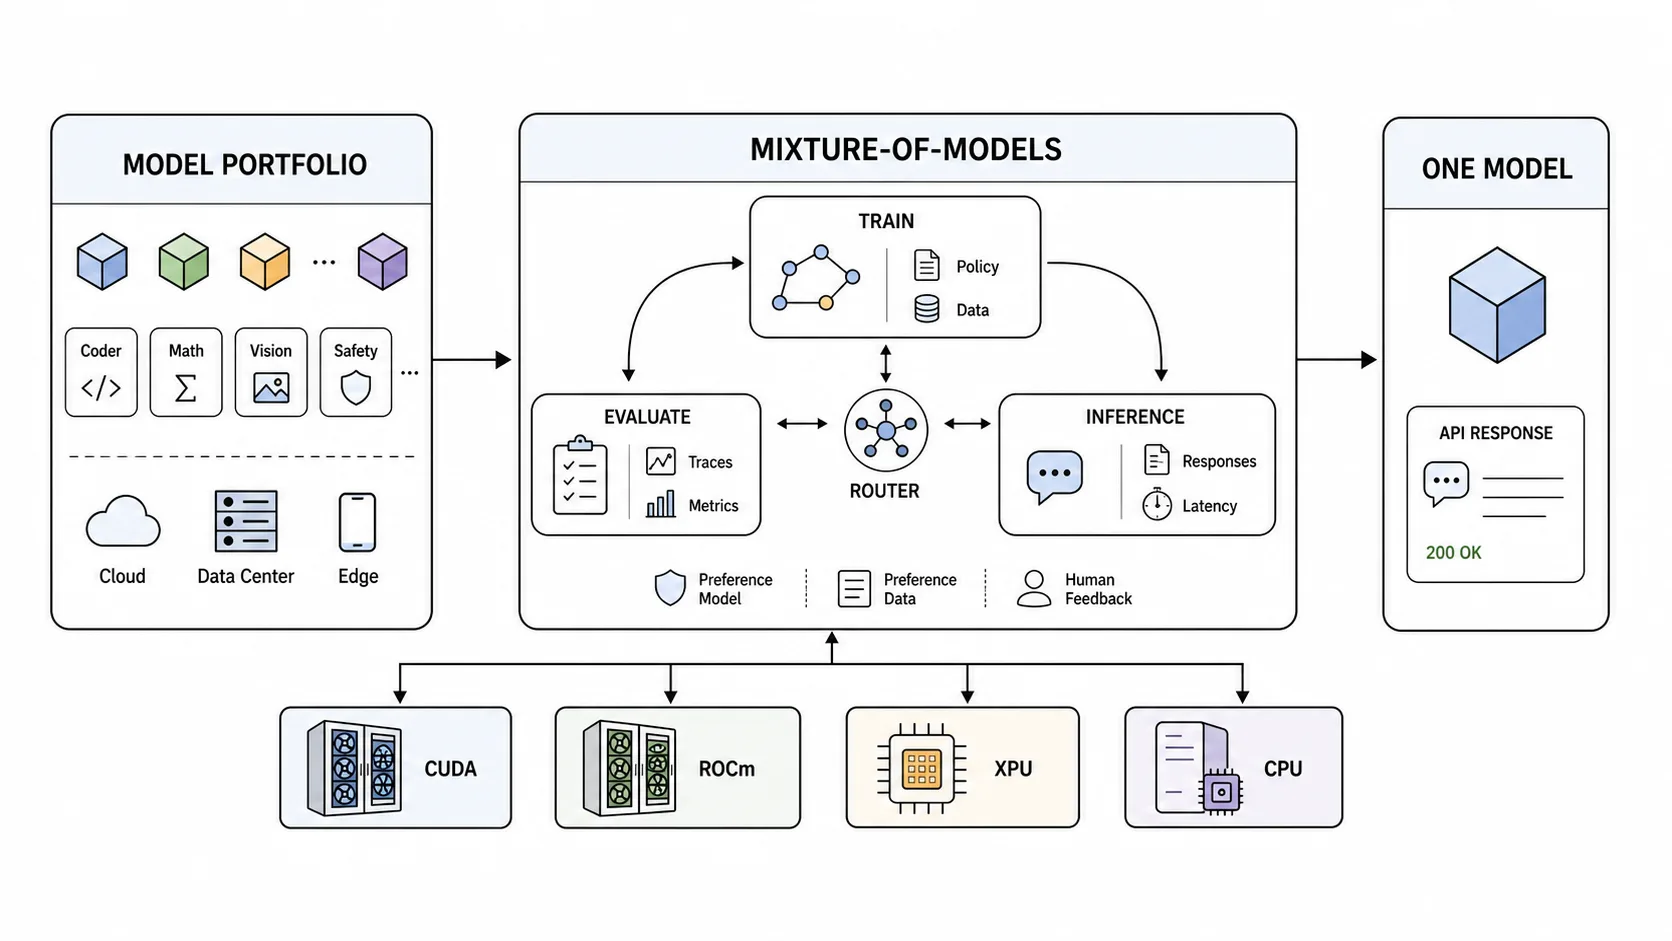
自公开上线以来不到一年,vLLM Semantic Router 已获得 5,000 颗星、150+ 贡献者,Hugging Face 模型家族累计下载超过 30 万次。经过 Iris、Athena、Themis 三个大版本,系统的控制边界从”选模型”逐步走向”治理多模型推理”,再到”跨会话保持状态与协调”——这些版本打下了 Day-0 就构想好的 MoM 架构基础。
这篇文章描述 vLLM Semantic Router 的下一步:从”在模型之间路由”转向”用它们构建可靠的模型系统”。在同一个版本化契约之下,独立的模型、策略、偏好与执行路径成为一个可以通过一个接口进行训练、评测、导出、导入、部署与调用的系统。目标是让 vLLM Semantic Router 成为 Mixture-of-Models 的训练、评测与推理引擎。
vLLM-SR 是如何走到今天的
第一篇 vLLM Semantic Router 文章提出了一个实际问题:为什么简单请求和困难请求要消耗相同的推理预算?一个轻量分类器用固定的领域标签在快速路径与推理路径之间选择,帮助 vLLM 更有选择性地使用推理算力。
生产流量很快暴露了这一设计的局限:仅凭领域无法表达隐私、安全、上下文、语言、模态、工具、偏好、延迟与授权;静态标签也无法处理”端点便宜但已过载、能力强大但距离远、或在一个智能体会话中途切换到它并不安全”等情况。
团队围绕模块化模型支持、共享 LoRA 计算、Rust/Candle 推理与 Go 集成重建了分类器层,并用 Signal–Decision(信号–决策)架构取代固定分类,把观测证据与策略、执行分离。这一架构成为其后三个版本的主干。
| 里程碑 | 时间 | 变化 |
|---|---|---|
| 孵化 | 2025 年 4 月 | 早期语义路由原型,MoM 从一开始就是长期系统目标 |
| 首次发布 | 2025 年 9 月 | 在快速路径与推理路径之间做意图感知选择 |
| v0.1 Iris | 2026 年 1 月 | 信号、决策与路由作用域插件取代固定分类 |
| v0.2 Athena | 2026 年 3 月 | 模型选择、记忆、RAG、长上下文与多模态,把路由扩展为推理控制系统 |
| v0.3 Themis | 2026 年 6 月 | 有状态路由、投影、重放、协议支持、会话连续性与统一生产配置契约 |
| Fusion 与 Micro-Agent | 2026 年 6 月 | 路由器开始选择协作模式,而不只是单个模型 |
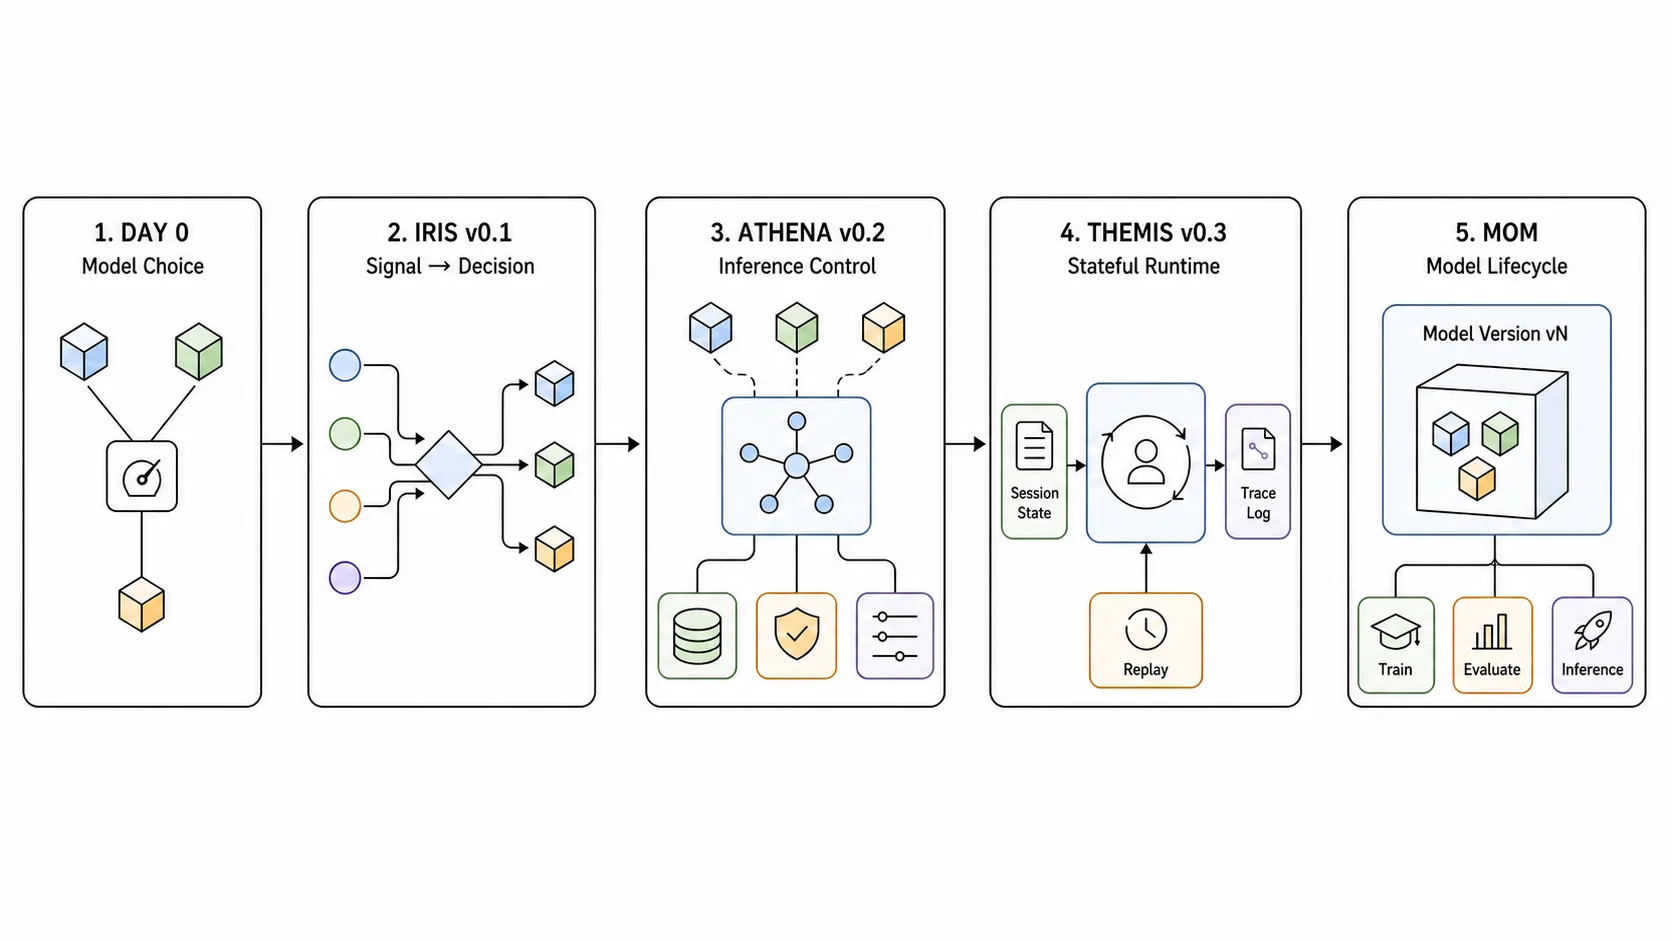
Iris 让路由变得可组合:领域、关键词、嵌入、事实性、反馈与偏好信号输入显式决策,而安全、PII 保护、缓存、幻觉检测与工具选择成为路由作用域内的行为。Iris 还推出了 MoM 模型家族,并把 vLLM-SR 定义为”面向 Mixture-of-Models 的系统级智能”。
Athena 加入了一等公民的模型选择、记忆与 RAG、多语言多模态模型栈、ROCm 加速与运维仪表盘——项目从 vLLM 前面的一个分类器,成长为多模型推理的”控制系统”。
Themis 把更大的系统变成可操作的契约:信号变成投影,投影喂给决策,决策选择算法,算法选择模型。它加入了会话感知的智能体路由、可重放追踪、更强的协议支持、运维控制台,以及 AMD ROCm、NVIDIA CUDA、Intel OpenVINO 与 CPU 环境的运行时路径,并让路由可解释:运维人员能看到每个决策背后的证据、策略、算法与物理模型。
从 Signal–Decision 到 Workload–Router–Pool
这些版本构建了运行时,两篇项目论文解释了背后的架构。
白皮书《Signal Driven Decision Routing for Mixture-of-Modality Models》形式化了神经证据与符号策略的分离:快速启发式与学习分类器把提示、上下文、身份、安全与模态转换为结构化信号向量;布尔引擎把这些信号组合成可审计的策略;类型化的神经符号 DSL 在编译为可部署配置前对策略进行解析与校验。论文发表时,系统已覆盖 13 种信号类型与 13 种模型选择算法,并为缓存、RAG、记忆、安全、供应商处理与响应校验提供逐决策插件。
愿景论文《The Workload–Router–Pool Architecture for LLM Inference Optimization》拓宽了视野,认为三个变量必须协同设计:
- 工作负载(Workload):对话还是智能体、单轮还是多轮、热启动还是冷启动、prefill 密集还是 decode 密集
- 路由器(Router):静态语义策略、在线反馈或 bandit 自适应、基于 RL 的选择、质量感知级联
- 模型池(Pool):同构或异构加速器、prefill/decode 拓扑、模型放置、KV 缓存管理
这些变量无法独立优化:工作负载形态决定哪种路由策略有效;路由策略改变所需的池规模与拓扑;池状态又决定哪条路由高效。安全与隐私贯穿三个维度,成本、质量、延迟与能耗构成优化前沿。论文把项目研究映射为 3×3 的 WRP 矩阵,并指出 21 个仍待解决的开放方向。
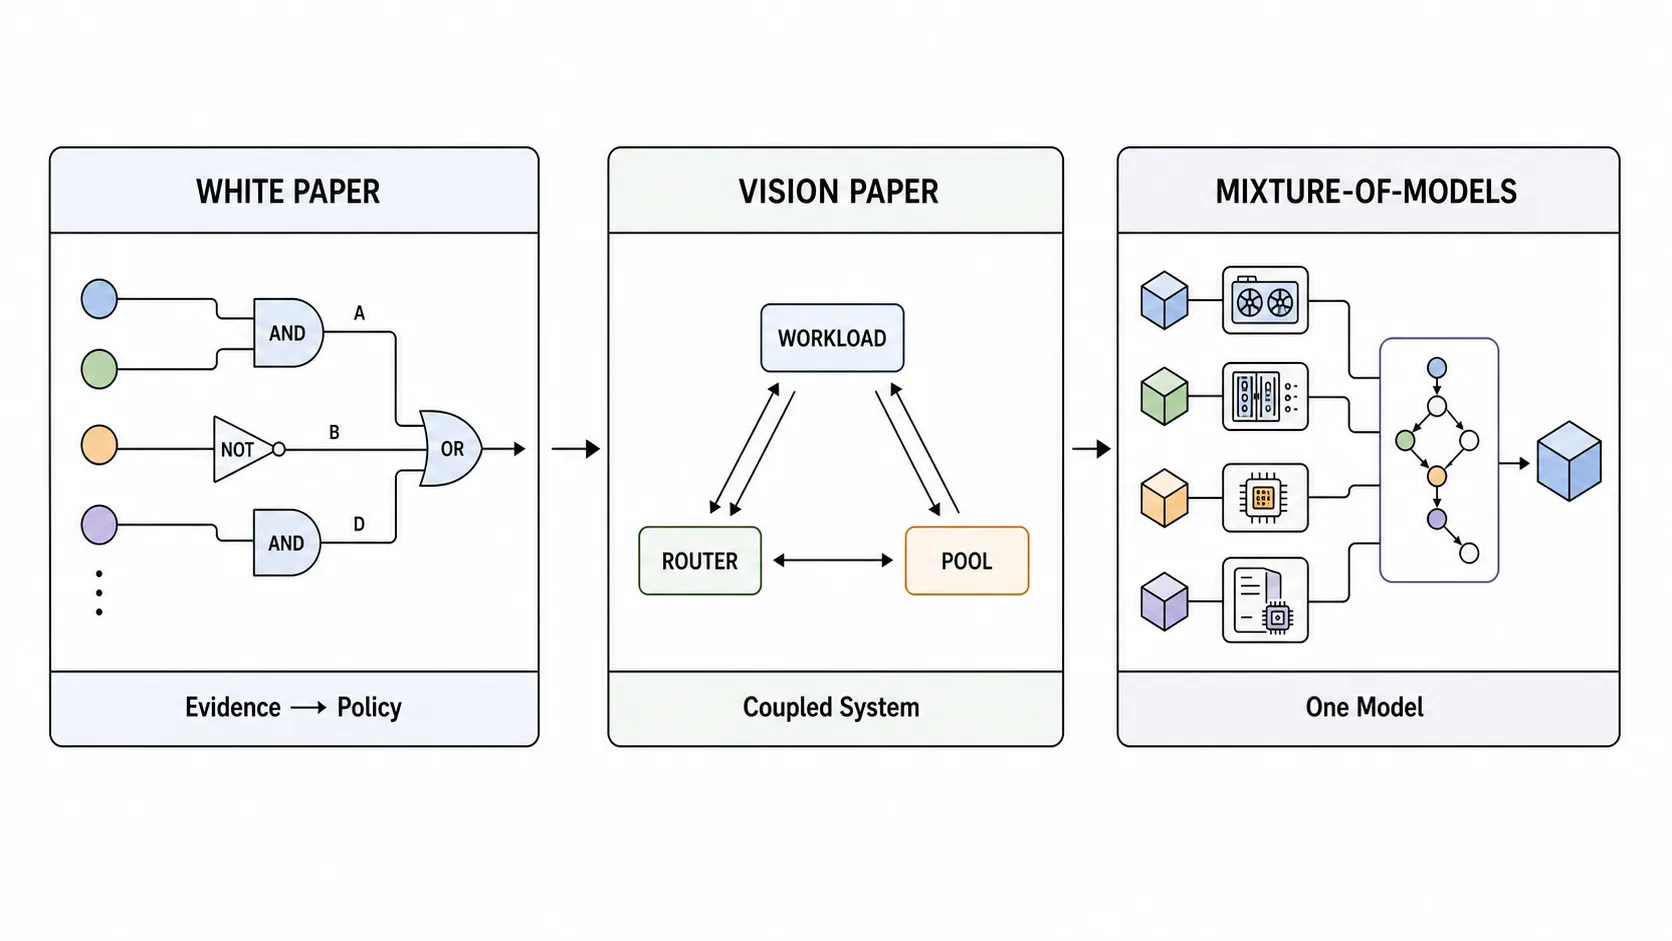
两篇论文让路由可编程,并将其与工作负载和硬件绑定——这正是 MoM 纳入同一个模型契约的两大基础。与此同时,运行时已经超越单模型选择:Fusion、ReMoM、Confidence、Ratings 与有界 Workflows 让一个请求可以调用模型间受控的协作。如 Micro-Agent 工作所示,客户端只需调用一个模型名,服务层就会选择配方、分发给工作节点、验证或综合结果,然后返回一个普通响应。
| 第一章 | 新章节 |
|---|---|
| 路由一个请求 | 构建一个模型系统 |
| 选择模型或能力路径 | 训练、评测并执行整个 MoM |
| 配置运行时策略 | 打包可移植、带版本的模型产物 |
| 优化一次路由决策 | 跨质量、成本、延迟、安全与能耗优化系统智能 |
| 用统一 API 隐藏后端选择 | 让整个多模型系统表现得像一个模型 |
路由仍然是基础——它是 MoM 分配工作、应用策略与协调各部分的方式。但路由只是机制,模型系统才是产品。
为什么模型边界必须移动
今天的 AI 技术栈沿四个轴碎片化:
- 模型碎片化:闭源前沿模型、开源通用模型、领域专家、紧凑本地模型、验证器与多模态模型将长期共存,没有谁能同时在质量、成本、延迟、信任、隐私与领域适配性上胜出
- 算力碎片化:GPU、CPU、专用加速器、边缘设备、云容量与私有集群在内核、内存、可用性、价格与能耗上各不相同,模型选择与放置正在变成同一个决策
- 位置碎片化:推理横跨云端、数据中心与边缘。隐私或数据驻留要求可能排除更强的远程模型,而本地负载可能仍需要按需的云专家
- 偏好碎片化:不存在普适的”最优”。产品与用户在准确率、延迟、价格、隐私、安全、风格与多模态之间做不同权衡,这些选择应当直接塑造执行
如今每个应用都要自行调和这些碎片。
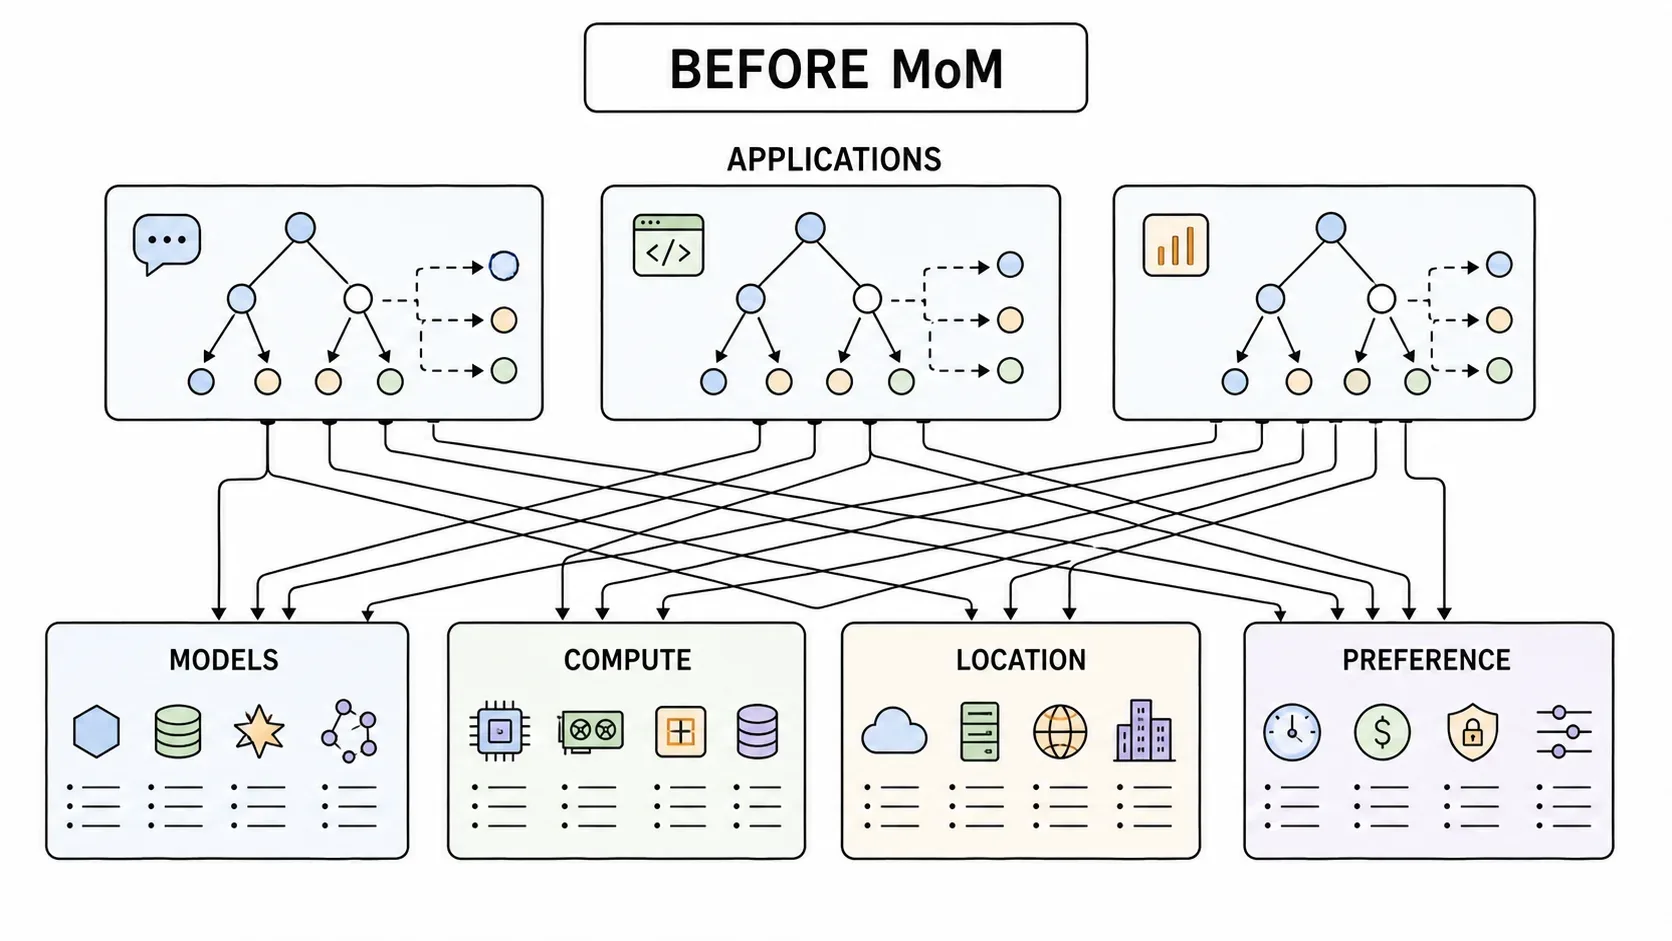
Mixture-of-Models 把这一责任移到一个模型边界之后。在这个边界上,智能分配成为模型的一部分:引擎决定哪些模型合格、执行可以运行在哪里、模型之间是否应该协作,以及如何满足硬约束。
能耗让分配与效率不可分离:硬件与推理引擎通过每瓦每美元产出更多 token 来改善供给侧;分配层则控制需求侧——哪些工作值得消耗这些 token,哪个模型或协作能在所需的质量、延迟与能耗预算内提供它们。
应用选择一个带版本的模型身份,收到一个可归属的响应。其物理实现仍可横跨开源与闭源模型、云与边缘、不同世代的加速器。碎片化依然存在,但它内化于模型系统之中,而不是泄漏到每个应用里。
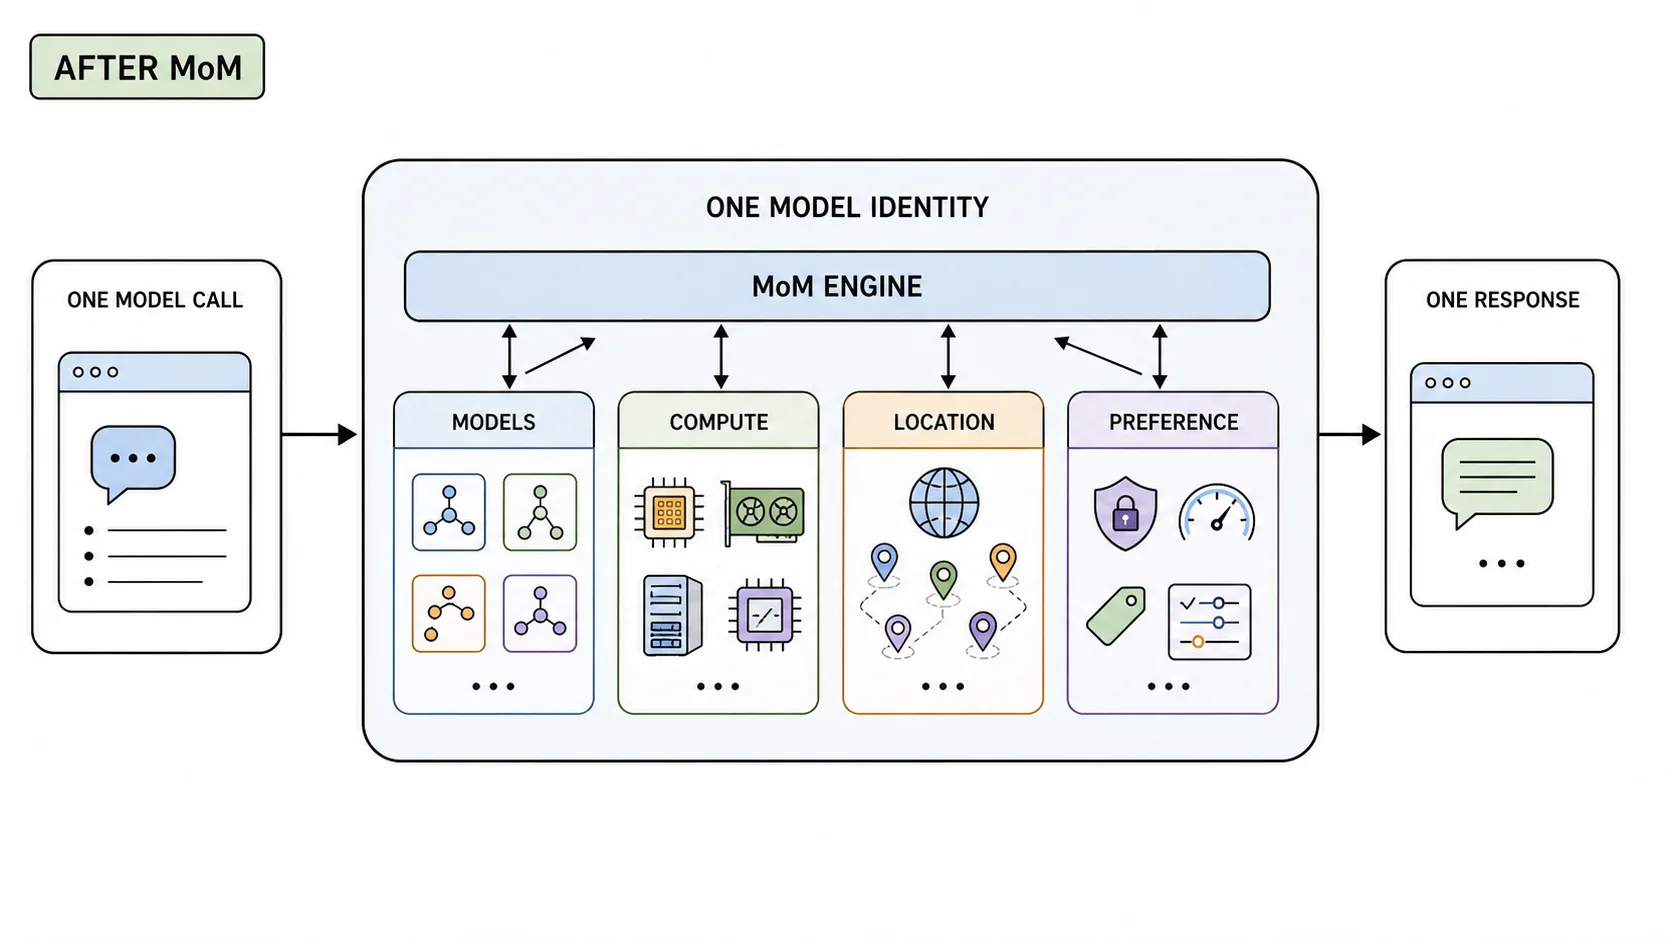
什么是 Mixture-of-Models
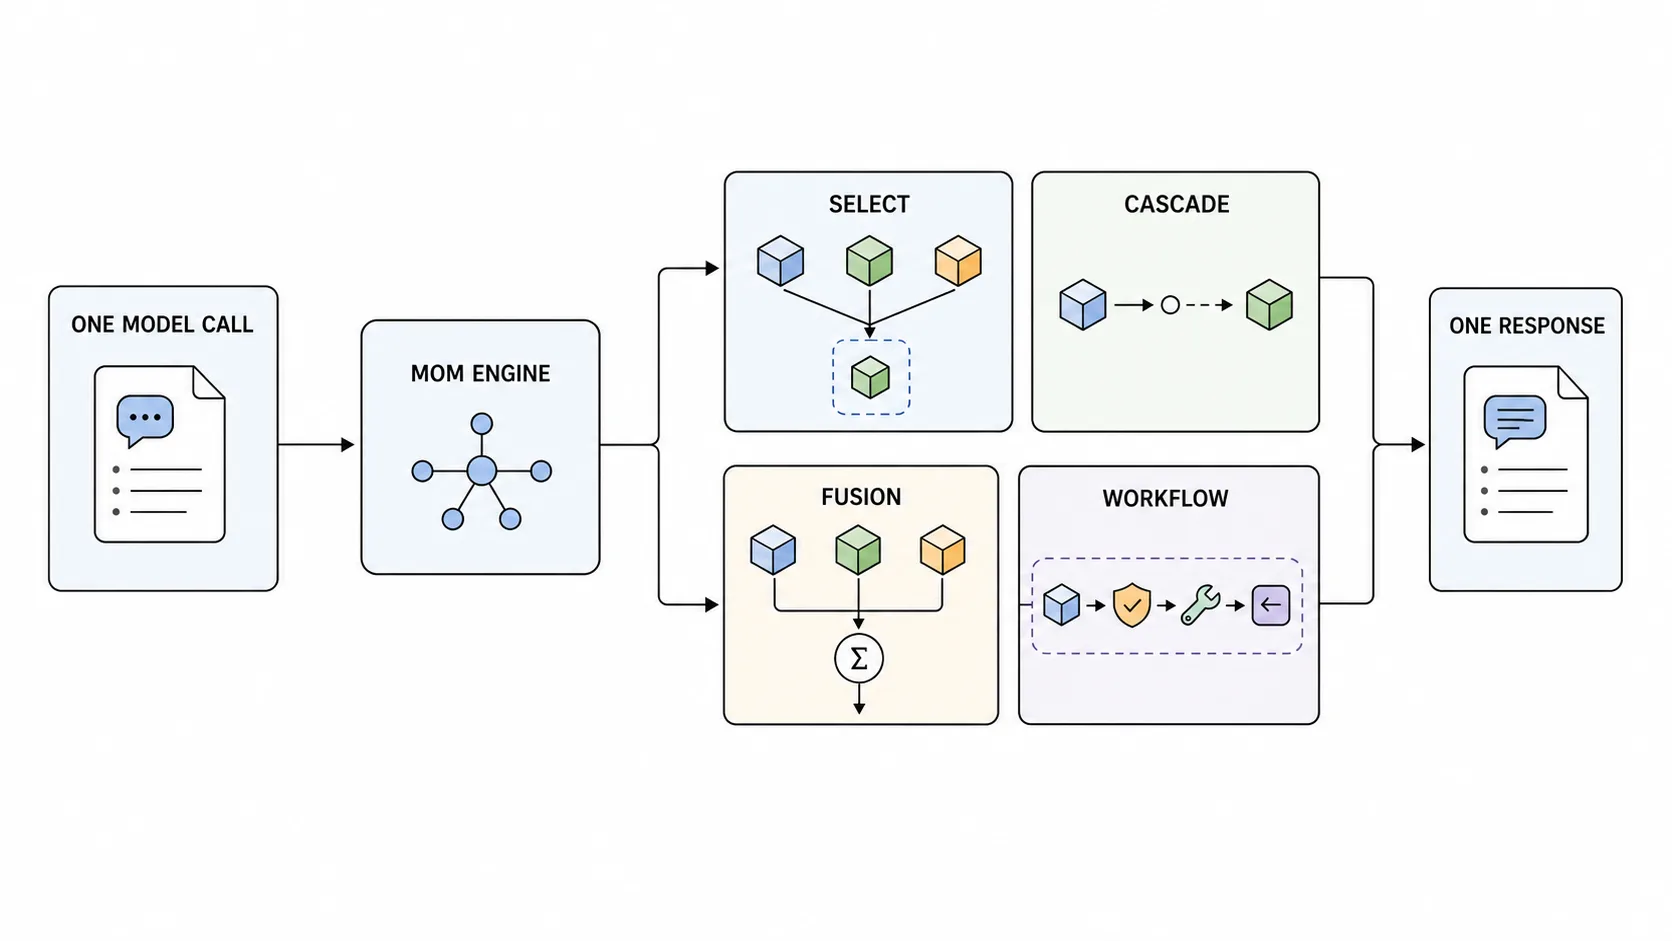
MoM 是一个带版本的组合模型:其引擎通过一条偏好条件化、资源受限的路径,跨越独立模型与算子实现每个请求。它通过一个模型接口呈现给用户,并返回一个可归属的结果。
多上游网关可以转发流量,但不拥有系统质量;MoM 拥有目标、评测契约、可复现的组合以及执行它的运行时。
MoM 也不同于 Mixture-of-Experts(MoE):MoE 在单次前向中把 token 路由到内部专家;MoM 协调的独立模型可能在架构、所有者、许可证、模态、协议、上下文窗口与硬件上各不相同。一个 MoE 检查点本身可以成为 MoM 的一个组件。
| 常规模型 | Mixture-of-Models | |
|---|---|---|
| 智能单元 | 单个检查点 | 受治理的模型系统 |
| 专长 | 主要编码在权重中 | 跨独立专家组合 |
| 执行 | 一条生成路径 | 选择、级联、验证、融合或工作流 |
| 优化目标 | 单个模型的质量与效率 | 跨质量、成本、延迟、安全、隐私与能耗的系统前沿 |
| 部署边界 | 单一运行时 | 云、数据中心与边缘 |
| 用户契约 | 一个模型身份 | 一个模型身份 |
因此,可移植的 MoM 需要的远不止权重与配置:还需要组件清单、能力元数据、路由与协作配方、策略、偏好、评测套件、运行时约束、来源与版本历史。开源检查点可以随产物一起携带;闭源模型则保持为经过认证的外部引用,带明确的能力与策略契约。导出 MoM 并不会让专有检查点变得可移植——它让模型系统变得可复现。
把偏好变成模型
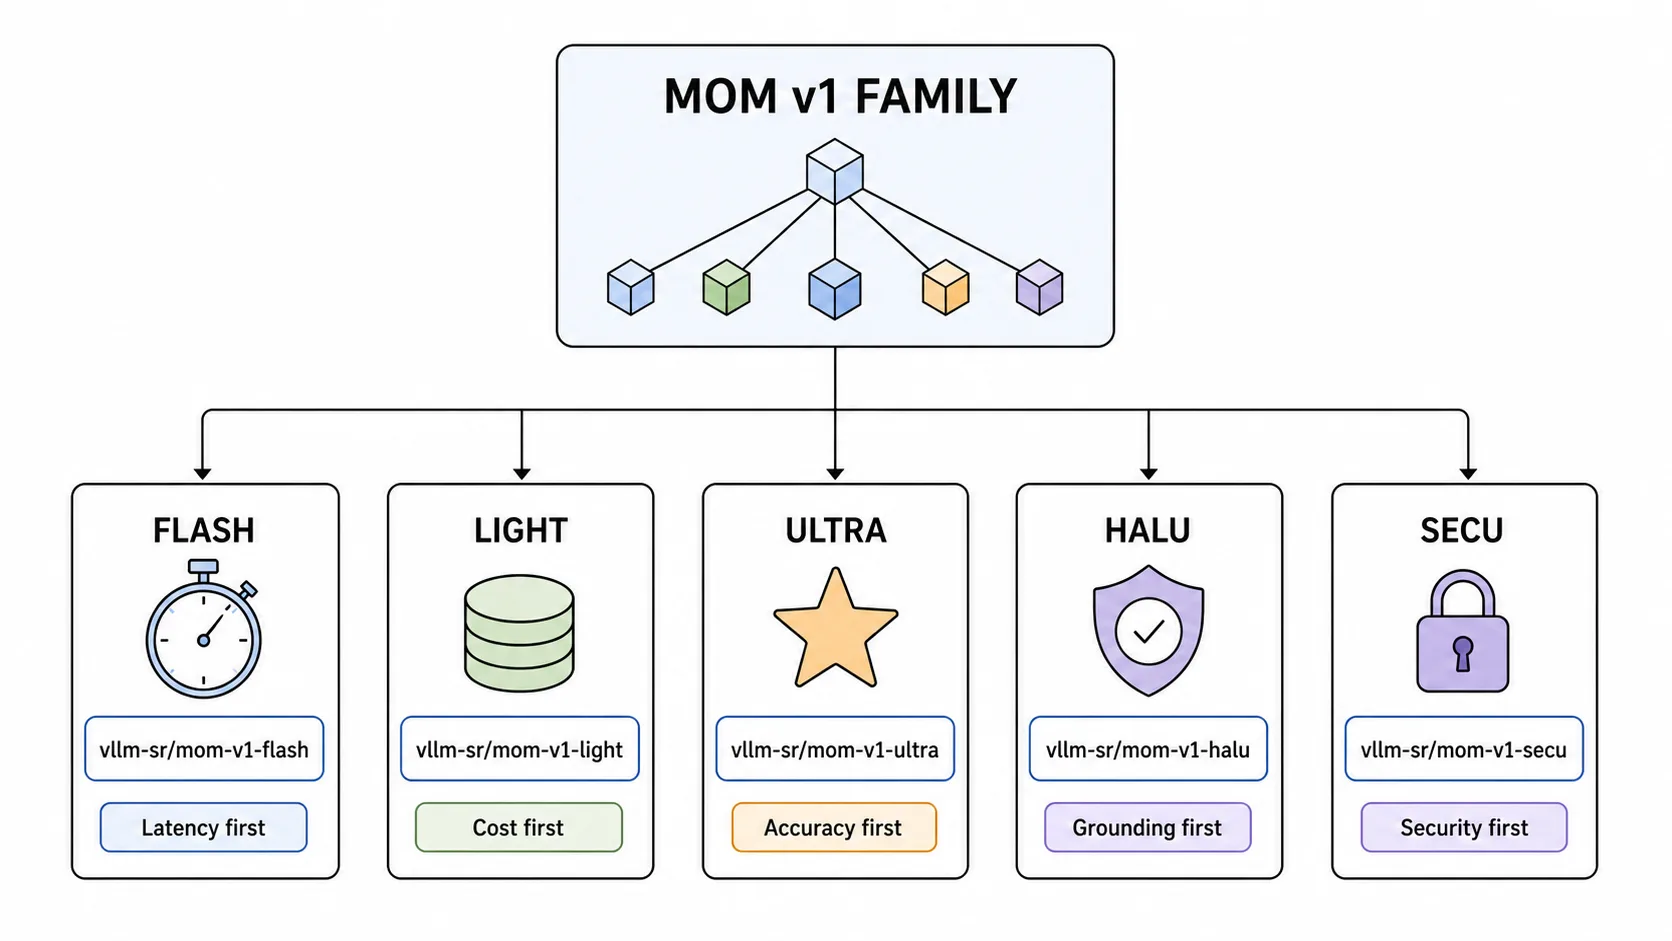
当偏好以模型身份发布时,它们就变得具体。同一个 MoM 家族可以提供多个运行点:
| 模型身份 | 契约 |
|---|---|
vllm-sr/mom-v1-flash | 最小化预期延迟 |
vllm-sr/mom-v1-light | 在质量下限之上最小化成本 |
vllm-sr/mom-v1-ultra | 在声明预算内最大化质量 |
vllm-sr/mom-v1-halu | 要求接地校验(grounding),失败即关闭 |
vllm-sr/mom-v1-secu | 执行前强制越狱与 PII 策略 |
每个名字都是一个带版本的模型契约,而不是路由器预设。应用选择自己需要的行为;vLLM-SR 在保持隐私、数据驻留、授权与安全硬约束的同时,选择并协调提供该行为的模型。
对应用而言,整个系统仍然是一次普通的模型调用:
{
  "model": "vllm-sr/mom-v1-ultra",
  "messages": [
    { "role": "user", "content": "Review this design and identify its weakest assumption." }
  ]
}
这个身份可能选择一个模型、沿级联升级、并行比较答案、要求接地校验,或运行一个有界工作流——外部接口、版本与响应契约均不改变。
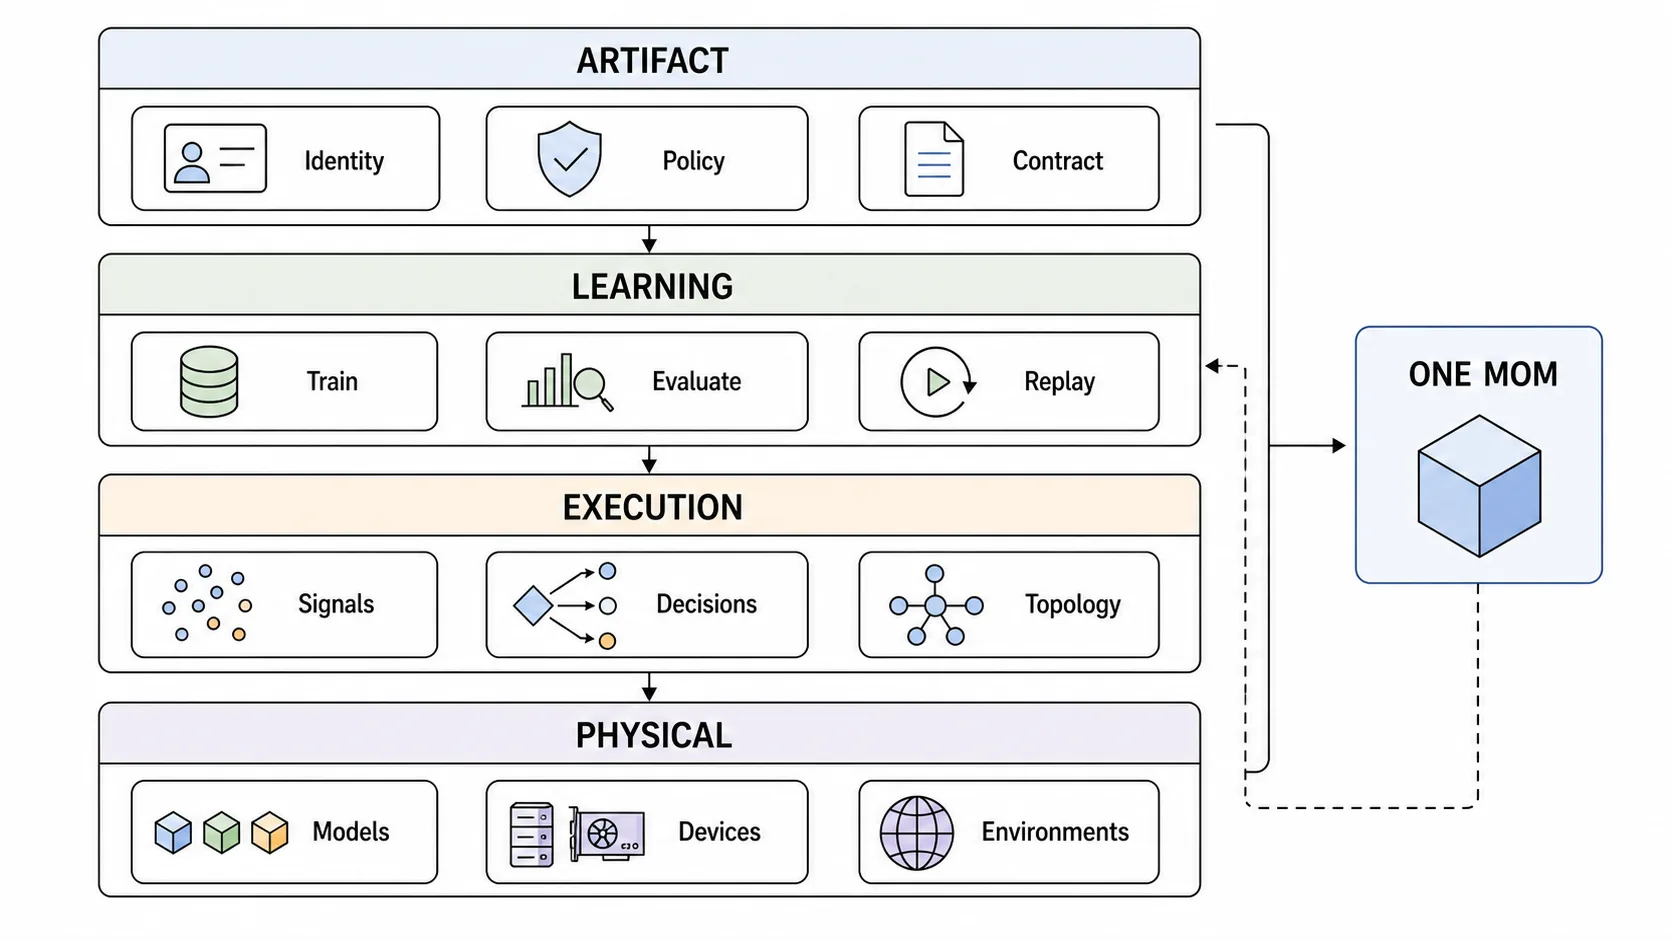
四个层面划分所有权:
| 层面 | 拥有的内容 | vLLM-SR 已有基础 | 下一步 |
|---|---|---|---|
| 产物 Artifact | 组件、能力、目标、策略、评测契约、来源 | 规范化配置、模型引用、DSL、带版本策略 | 可移植 MoM 导入/导出规范 |
| 学习 Learning | 路由器自有模型、偏好、结果、配方改进 | 训练栈、Router Learning、重放、结果 API | 联合训练与系统级发布门禁 |
| 执行 Execution | 信号、投影、决策、选择器、循环器、插件 | Signal–Decision 运行时、Fusion、ReMoM、Workflows、安全与记忆 | 一个生命周期感知的 MoM 引擎 |
| 物理 Physical | 供应商、模型池、加速器、位置、缓存与能耗状态 | vLLM 后端、云供应商、ROCm、CUDA、OpenVINO、CPU | 跨云、数据中心、边缘与本地设备的可移植放置 |
部署必须把逻辑需求映射到环境中可用的模型与机器上。该提案使用四个对象:
- Bundle(捆绑):固定接口、图、策略、行为变体、边界与不可变语义资产
- Binding(绑定):在不改变模型决策语义的前提下,把逻辑组件映射到合格部署
- Resolution lock(解析锁):冻结组成部件的修订、运行时、镜像、加速器与供应商观测
- Run record(运行记录):把每个决策、调用、约束检查、成本与结果归属到产生它的 bundle、binding 与 lock
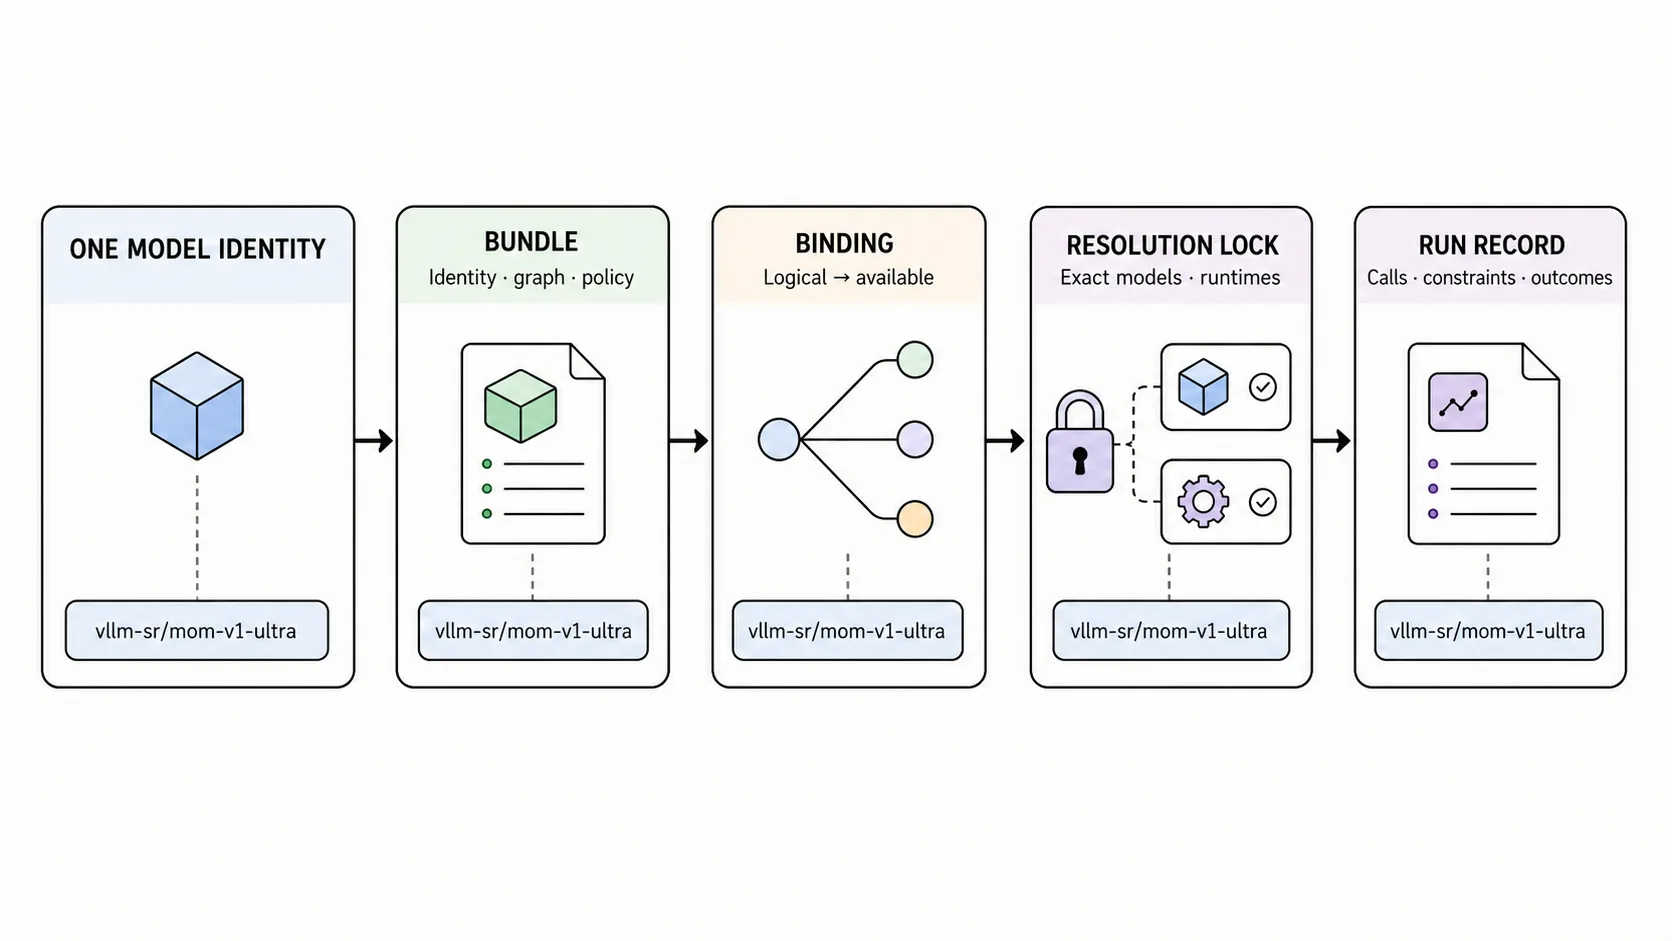
这种分离让可移植性名副其实:同一个 mom-v1-ultra 可以绑定到 ROCm、CUDA、私有 CPU/NPU 节点或混合部署,而不必承诺来自不透明供应商的完全相同输出。它保留控制语义、暴露替换,并让服务与评测使用同一个已解析的系统。
vLLM-SR 作为 MoM 引擎
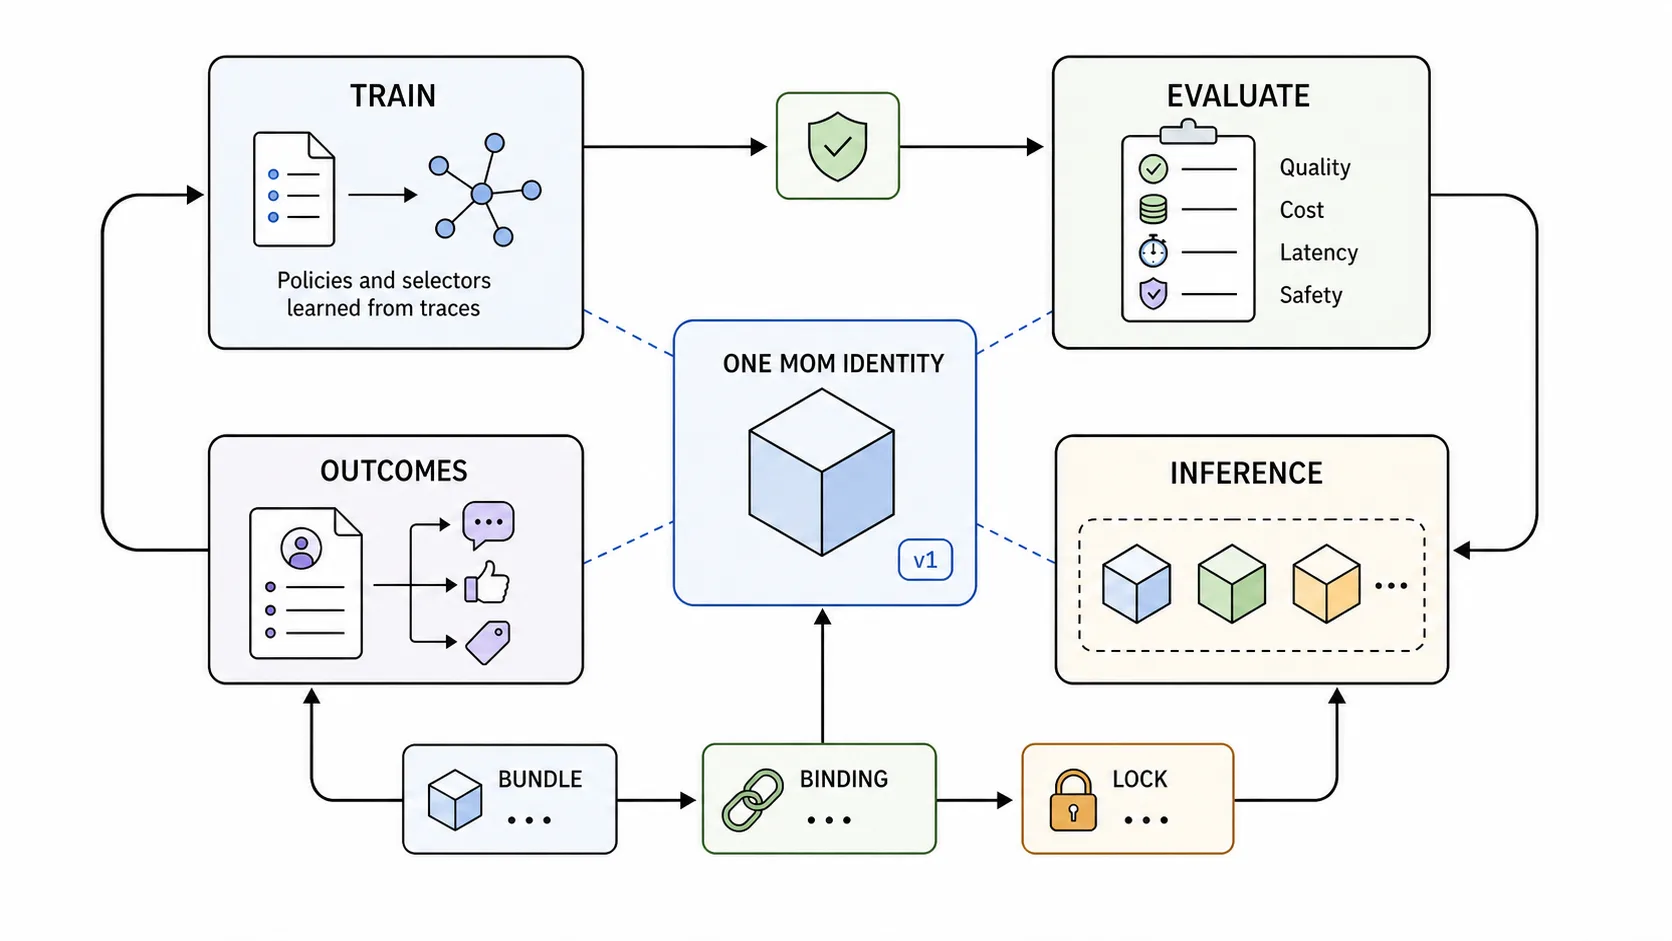
训练、评测与推理必须共享同一个契约,否则研究、基准与生产会漂移到不同的系统里。
训练分配,而不只是权重
MoM 训练覆盖路由器自有嵌入、信号编码器、偏好与安全模型及选择器,还学习分配与协作:哪条路径适配某类工作负载与预算、级联何时该停、评审组如何评判或综合、智能体会话何时该切换模型。由于组成部件可能是独立或闭源的,进展并不要求穿透所有部件做梯度;策略、阈值、池、提示、契约与拓扑都可以从追踪与结果中优化。
目标是跨越质量、延迟、成本、安全、隐私、可靠性、位置与能耗的前沿。重放与结果把生产经验反馈进离线训练,同时不让热路径悄悄改写策略。
把 MoM 当作一个模型来评测
评测必须端到端地给模型身份打分,后端基准只是输入而非结果。一份带版本的记分卡应衡量路由遗憾(routing regret)、协作增益、恢复能力、会话连续性、尾部延迟、成本、安全、隐私与能耗,并施压供应商故障、设备丢失、模型分歧、工作负载漂移与偏好变化。每个声明的运行点也需要自己的测试:flash 测其延迟–质量前沿,light 测其质量下限,ultra 测其预算内表现。
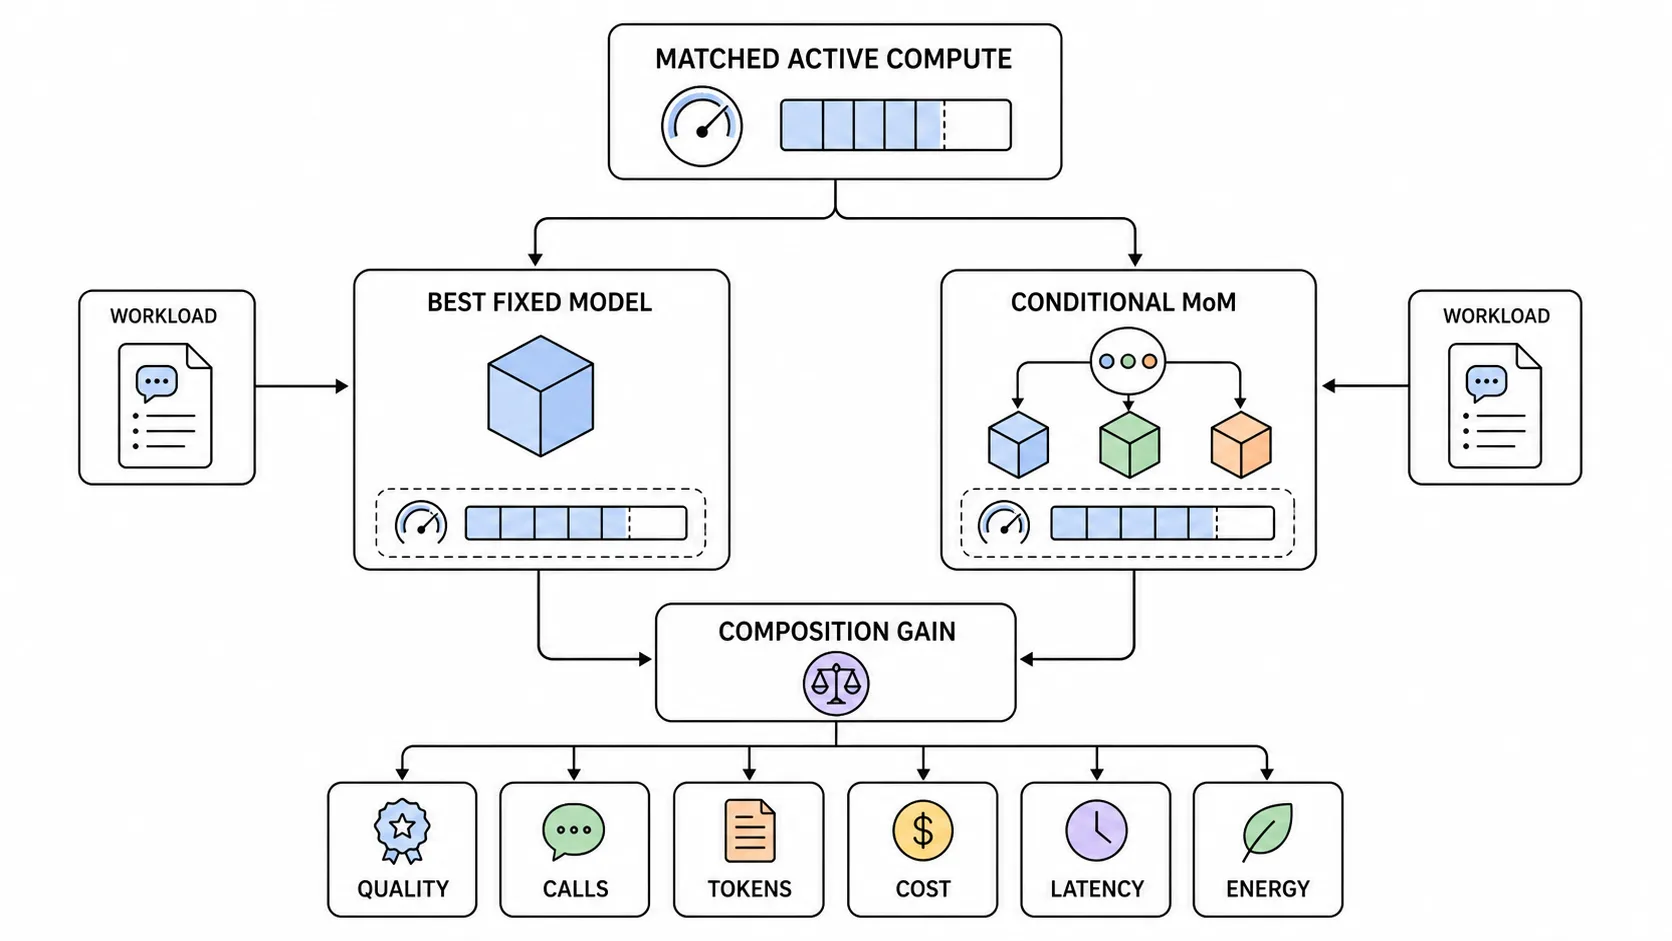
科学的检验比”更多调用是否提升基准”更严格:在匹配的活动算力下,条件系统能否比最好的固定模型更好地利用互补优势与失败模式?没有这个对照,MoM 可以把暴力缩放藏在巧妙的计算图后面。评测必须在质量之外同时报告调用次数、token、成本、延迟与能耗——并在组合无效时如实公布。
在推理时执行智能
推理时,引擎决定单个模型是否足够。它可能选择本地专家、保持热会话、沿置信度级联升级、要求检索或验证、运行 Fusion 评审组,或执行有界工作流。运行时拥有预算、拓扑、回退、追踪与响应契约;应用只做一次普通模型调用。
一个可以移动的模型
目标是构建一个完整的 MoM,可以像统一模型一样被构建、导出、导入、版本化、评测、部署与调用。逻辑规范编译为不可变 bundle,绑定到环境,解析出具体部署,并在服务与评测中保持同一身份。
产物应能在开发者机器、私有集群、云集群与边缘环境中运行,而物理实现在变化:专家可能解析为可接受的本地检查点或托管端点,加速器运行时可能被替换。若隐私使远程专家不可用,引擎走声明的回退或弃权路径。Binding 不能悄悄改写图、放松护栏或把评审组变成级联——这些变更需要新的模型版本。
“在任何硬件上运行”是一个架构需求,而不是声称今天每个组件都可移植。项目已支持 ROCm、CUDA、OpenVINO 与 CPU 路径;下一步是把硬件能力与放置纳入 MoM 契约,让引擎把模型系统映射到可用资源上。
用户体验标准很简单:一个模型身份,多个模型,任意硬件。
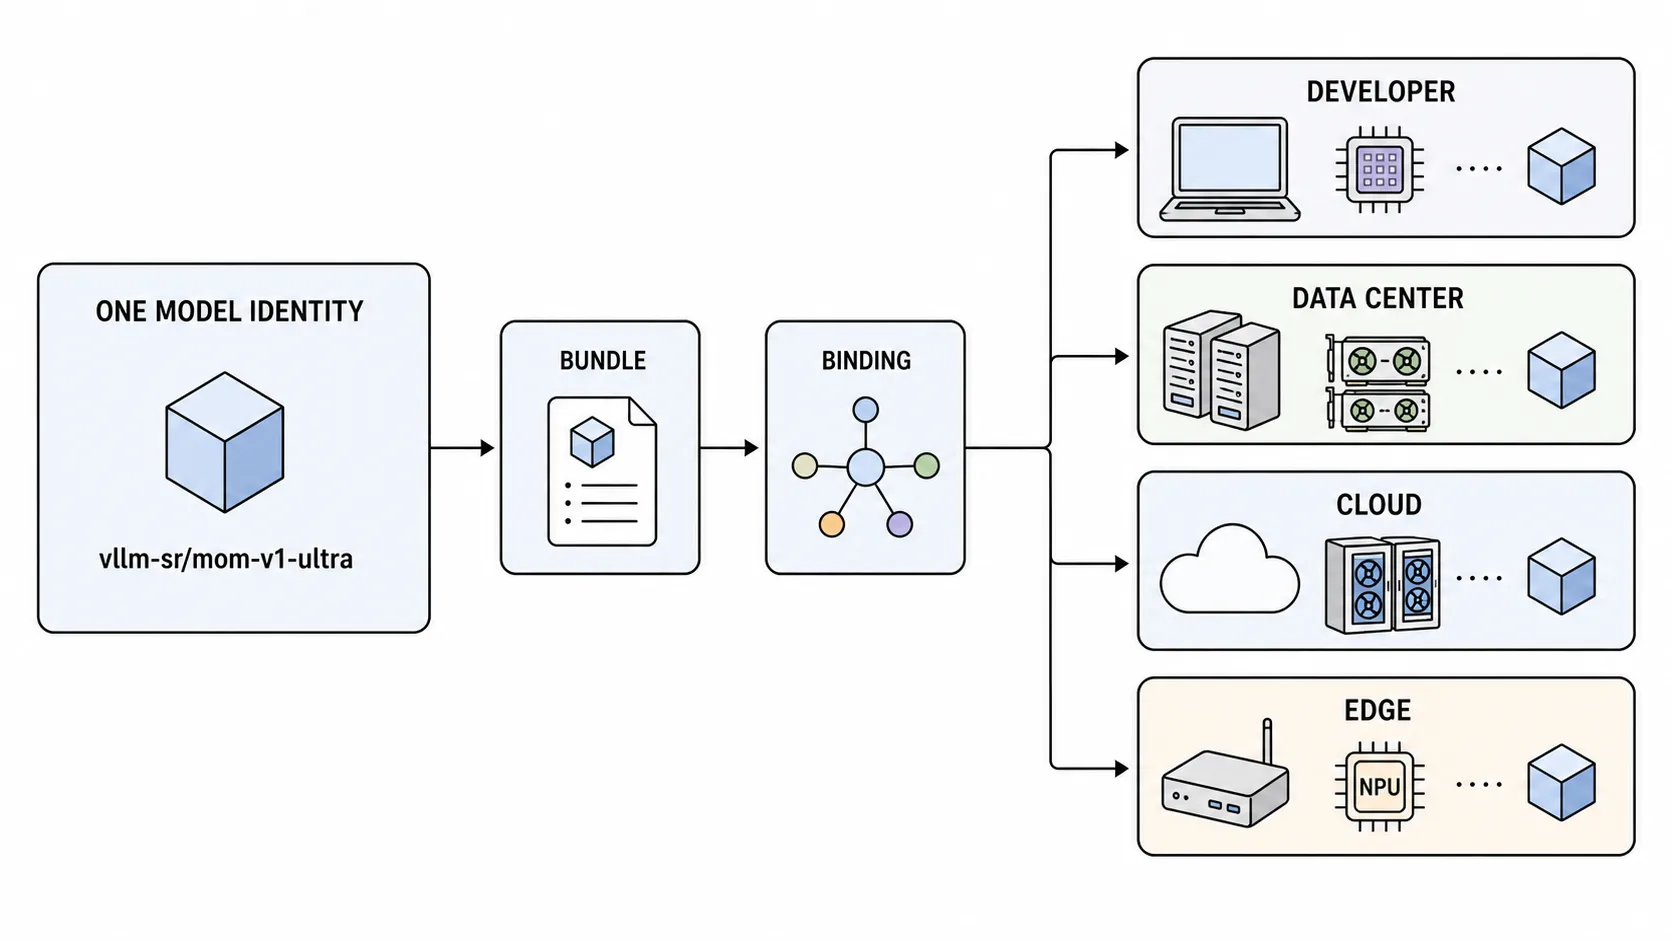
如果应用需要知道每个子模型属于哪个供应商、运行在哪个设备上、或者该执行哪条回退图,那么抽象就泄漏了。
现在会发生什么
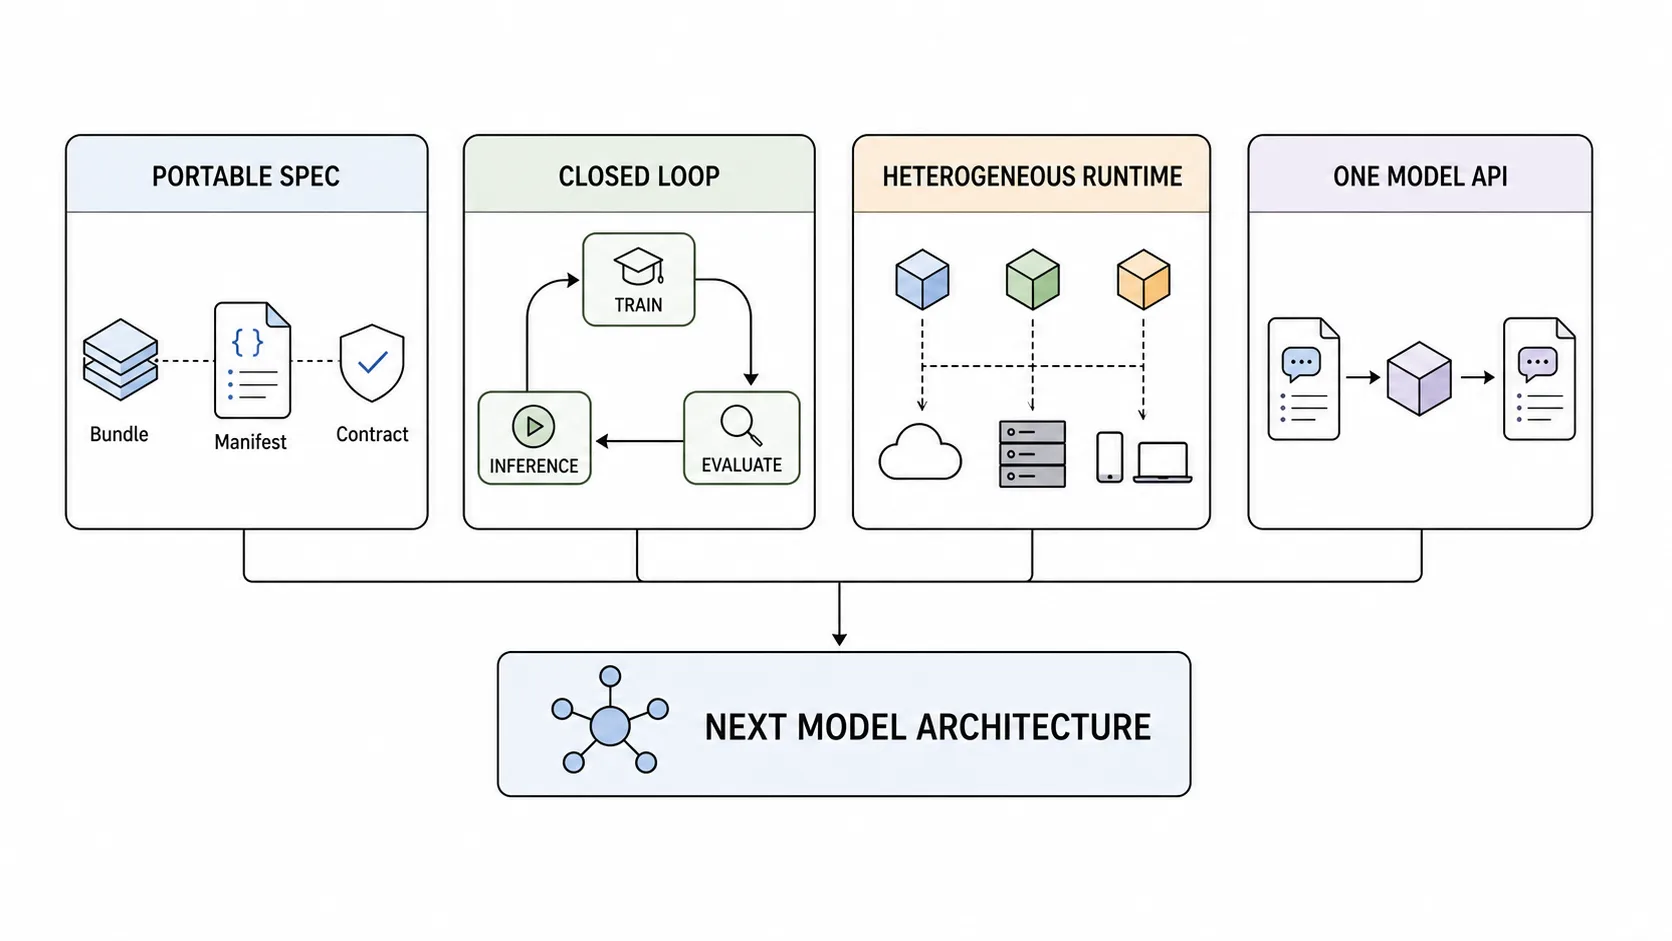
下一阶段聚焦四个相互关联的方向:
- 定义可移植的 MoM 规范:把组件、目标、策略、偏好、评测、约束与执行语义打包为一份带版本产物
- 闭合训练–评测–推理回路:从评测与重放改进模型与配方,再通过可审查、可回滚的发布交付
- 构建异构运行时:以硬件、位置、能耗与数据边界为输入,把一个 MoM 映射到云、数据中心与边缘
- 保持模型接口简单:让 MoM 像单个模型一样易于导入、部署与调用
这是一个研究项目:独立模型应如何专长化、竞争、验证与协作;如何度量由此产生的系统;以及一个模型契约如何跨设备与环境存续。使命是:推进跨模型、设备与环境的智能科学——研究组合何时能产生超越单个检查点的能力,把放置与能耗视为智能的一部分,让同一个模型契约从边缘走到云端、从研究走到生产。
与我们共建
构建 Mixture-of-Models 需要的远不止路由,工作横跨模型训练、评测、服务系统、硬件与生产运维。Iris、Athena 与 Themis 之所以进步,是因为贡献者带来了真实工作负载、添加了后端、训练了模型、发布了基准、发现了失败案例并推动了更好的接口。MoM 需要同样广泛的工作:学习式分配、偏好优化、模型协作、能耗感知推理、可移植产物、开放评测与异构运行时。
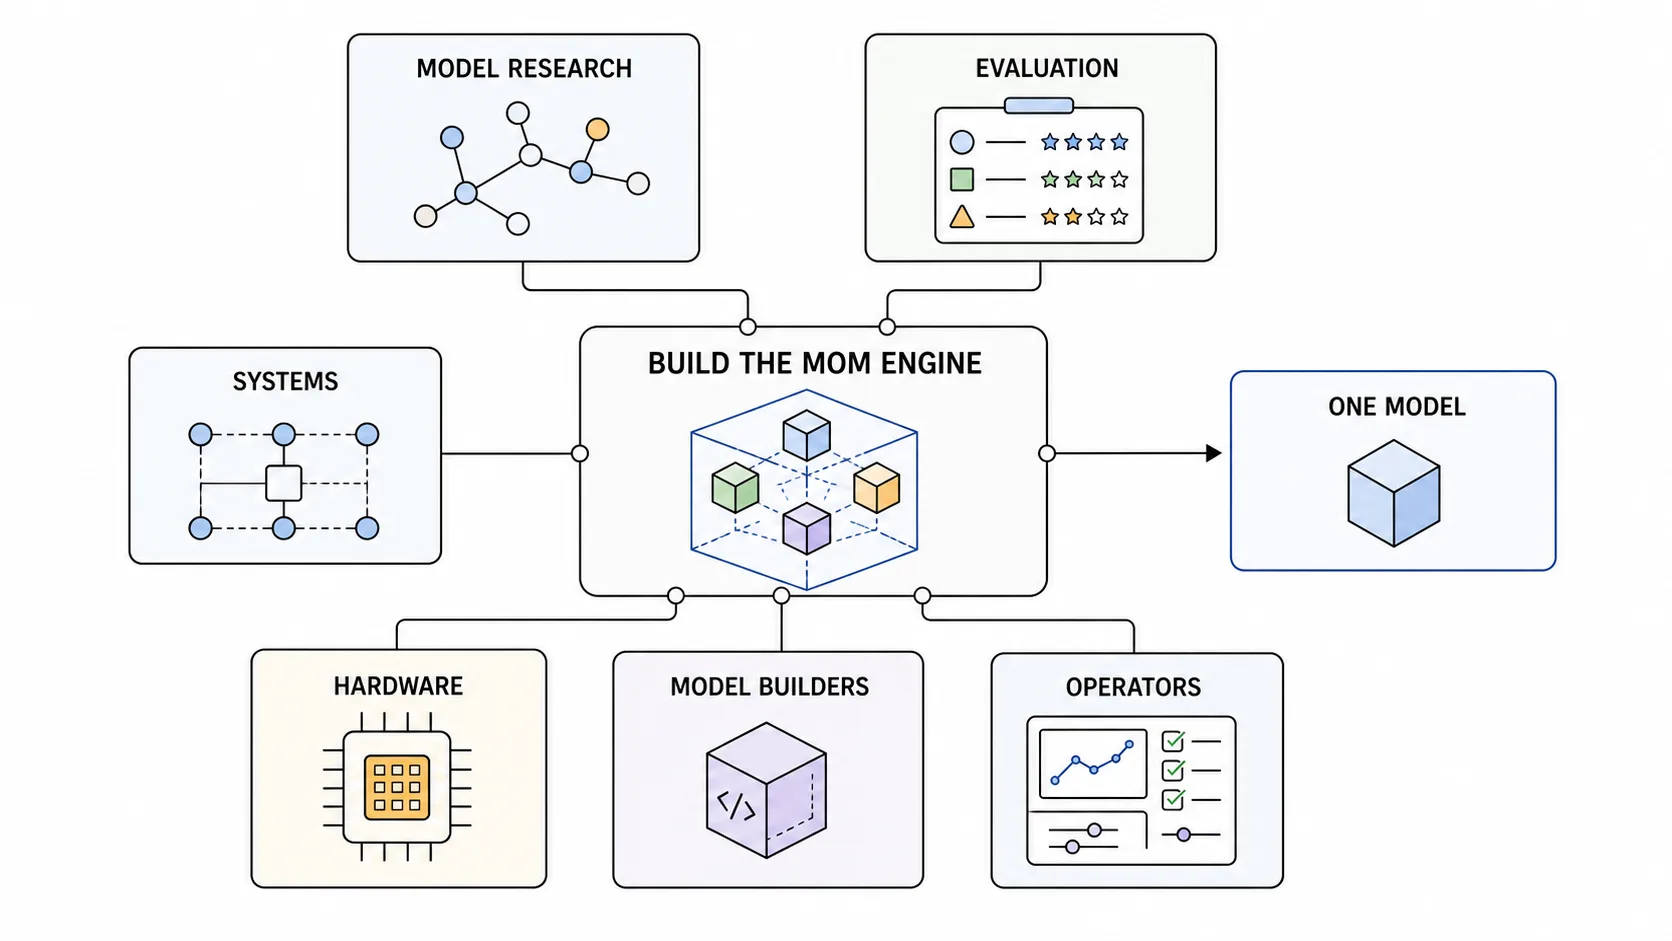
在致谢中,团队提到项目已达 1,734 次提交与 150+ 贡献者,并感谢 MBZUAI、麦吉尔大学、Mila、莱斯大学等学术伙伴,以及 vLLM、AMD、Intel、Meta、Red Hat、Microsoft、Google、IBM、NVIDIA、Hugging Face、NASA、Nutanix、DaoCloud 等社区协作。这一里程碑属于每一个帮助把早期路由器变成真正系统的人。
原文:Beyond a Single Model: Building Mixture-of-Models Systems with vLLM Semantic Router(vLLM Semantic Router Team,2026-07-21)


