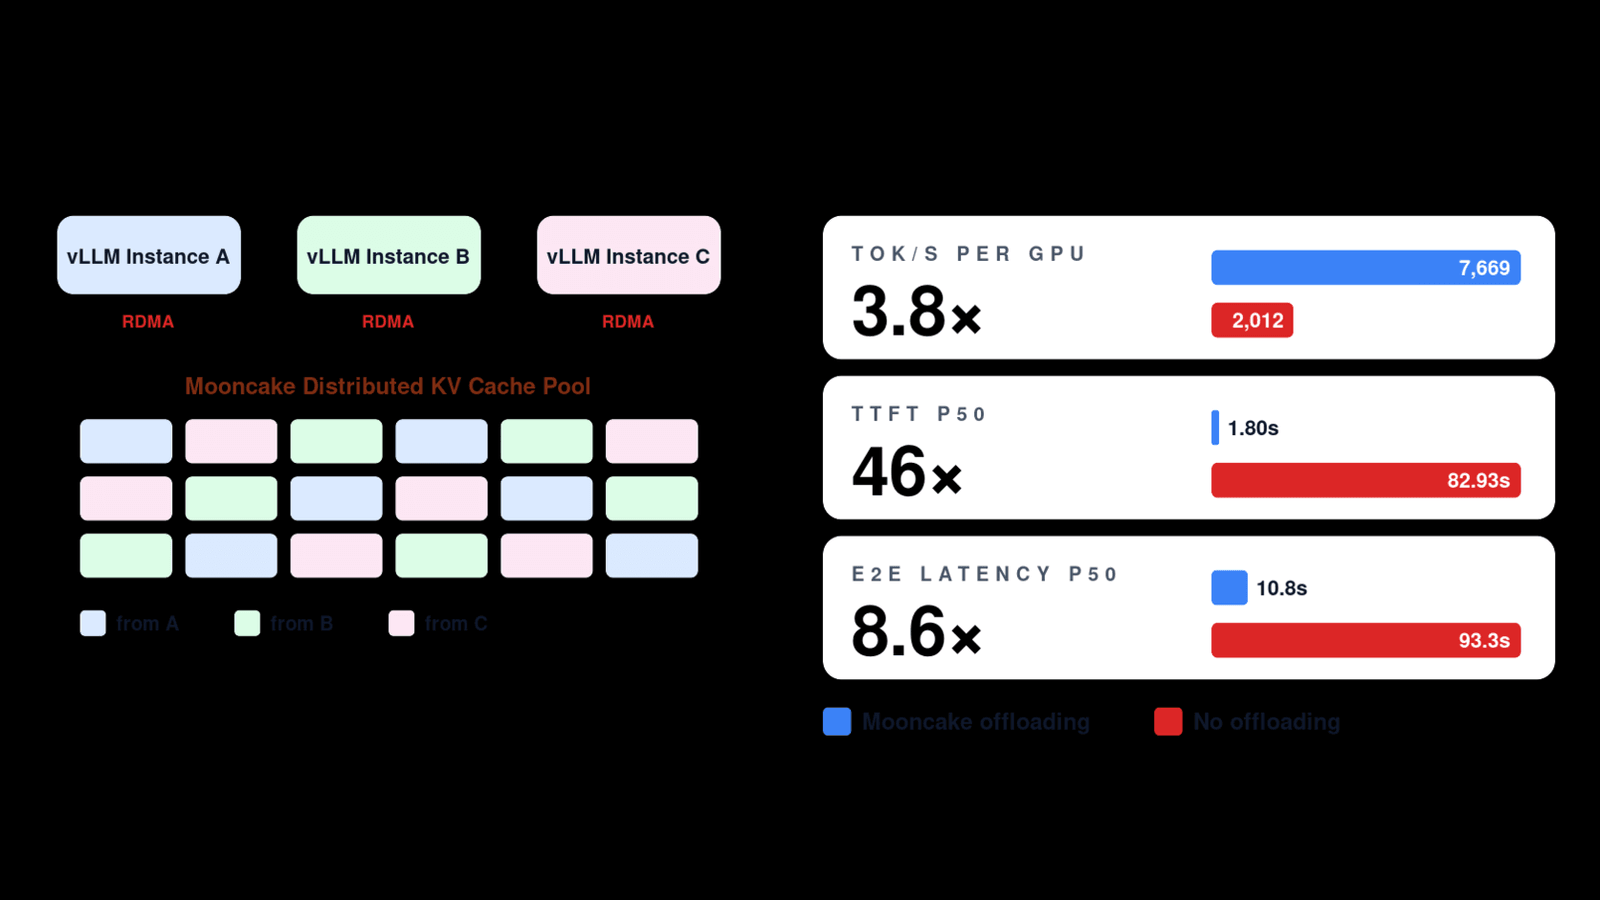
智能体负载正在改变 LLM 推理服务的形态:Claude Code、OpenClaw 这类长期运行的自主系统,每一轮都要在”推理”与”行动”之间循环,上下文不断累积,却只有少量新 token。如果每个实例各自为战,这些被反复读取的前缀只能一遍遍重算。vLLM 团队给出的答案是把 KV 缓存从单机搬到集群——通过 Mooncake Store 构建分布式 KV 缓存池。
核心结论:在真实的 Codex/SWE-bench Pro 智能体轨迹上,分布式 KV 缓存池把 vLLM 吞吐提升 3.8 倍,P50 TTFT 与端到端延迟分别降低 46 倍与 8.6 倍;在轮询(round-robin)路由的跨节点压力测试下,缓存命中率稳定在 95% 以上,系统近乎线性扩展到 60 块 GB200 GPU。
智能体负载正在重塑 LLM 服务
正如 Jensen 在 GTC 2026 主题演讲中所说,LLM 正从简单聊天机器人走向能规划、推理并朝复杂目标行动的自主长程系统。这类工作负载的结构高度独特:由长时间跨度、多轮循环组成,在推理步骤(模型处理上下文并产生中间思考)与行动步骤(模型发起工具调用并接收外部结果)之间交替。
为了量化这一行为,vLLM 团队收集并分析了 Codex 与 GPT-5.4 在 SWE-bench Pro 数据集上的轨迹,并开源了该数据集,供社区研究智能体服务负载。
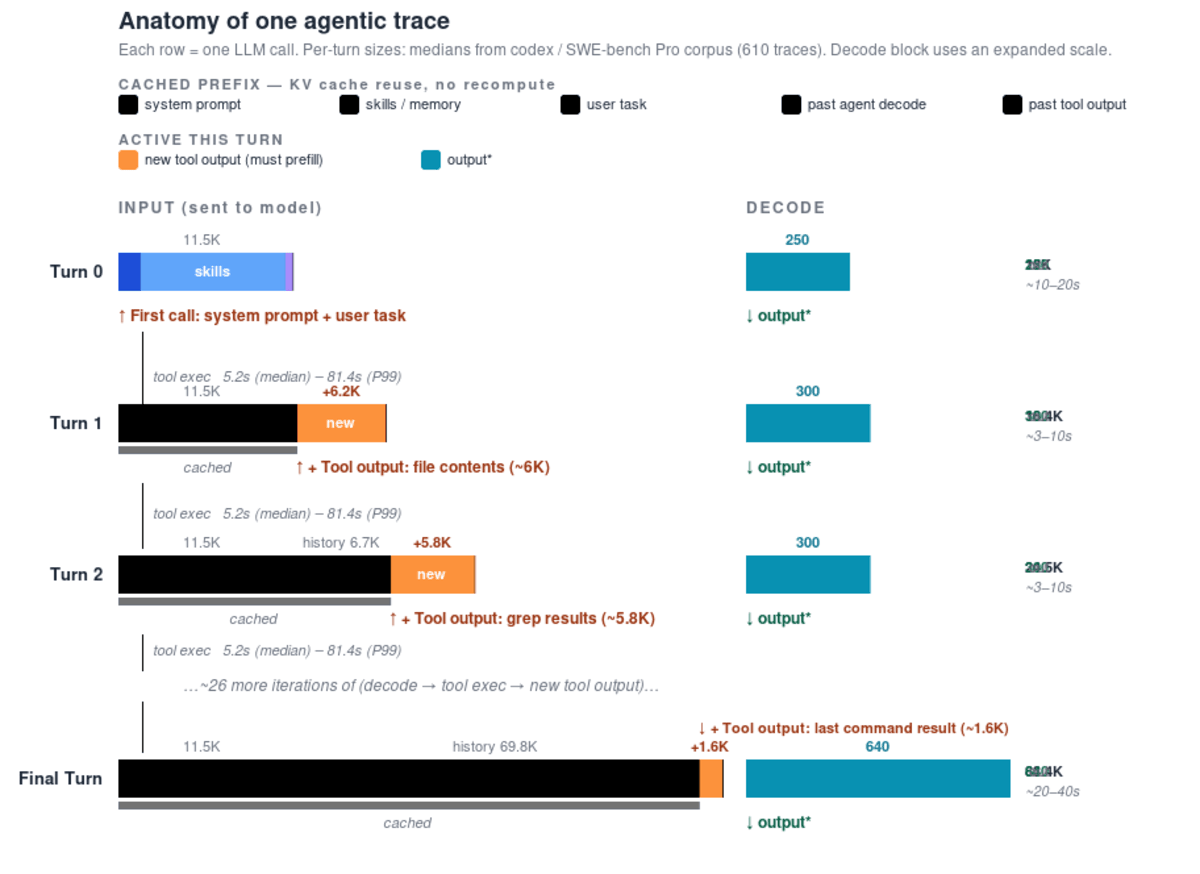
图 1:来自 Codex/SWE-bench Pro 语料的一条智能体轨迹。每一行是一次 LLM 调用;每轮大小取 610 条轨迹的中位数。缓存前缀(系统提示、技能/记忆、历史轮次)逐轮复用,每轮真正活跃的只有新增的工具输出与模型的 decode。
规律非常醒目:到第 30 轮,上下文已增长到约 8 万 token,最长的上下文可超过 18 万 token;而每一轮通常只引入几百到几千个新 token,其余都是模型已经见过的前缀。整个数据集平均输入/输出 token 比约为 131:1。
如果这些前缀能被缓存,缓存部分的 prefill 就几乎免费,每轮的真实成本只剩新增的增量。Codex/SWE-bench Pro 数据集包含 610 条轨迹、每条约 33 轮,关键统计如下:
| 指标 | 数值 |
|---|---|
| 缓存命中率 | 94.2% |
| 输入/输出 token 比 | 131:1 |
| 每轮平均上下文增长 | 约 2,242 token |
| 单条轨迹上下文增长中位数 | 从 12K 到 80K token |
| 轮间间隔 | 中位数 5.2 秒,P99 81.4 秒 |
然而,把 KV 缓存卸载到本地 CPU DRAM 或磁盘,对智能体负载有两个重大限制:
- 容量与驱逐:10 万 token 的上下文可能占用数 GB 存储(例如 Kimi-2.5 FP8 KV 缓存约 3.8 GB)。一个同时服务大量长会话的繁忙实例,很快会被大块前缀缓存占满并触发驱逐。
- 跨实例未命中:为了负载均衡,路由器未必把会话的下一轮调度到同一个 vLLM 实例。会话一旦迁移到新实例,该实例从未见过此前缀,只能从头重算。
结论:推理服务不能再被当作一组相互隔离的 vLLM 副本。对智能体负载而言,实例之间需要共享一个分布式 KV 缓存池——既提供更大的聚合容量,也带来跨实例的缓存命中。
用 Mooncake Store 构建分布式 KV 缓存池
Mooncake 是开源的 KV 缓存传输与分布式存储高性能库。vLLM 此前已通过 MooncakeConnector 把 Mooncake 用于 prefill/decode(PD)分离,用其传输引擎在 GPU 之间搬运 KV 缓存。这次,vLLM 在此基础上更进一步,用 Mooncake Store 构建分布式 KV 缓存池。
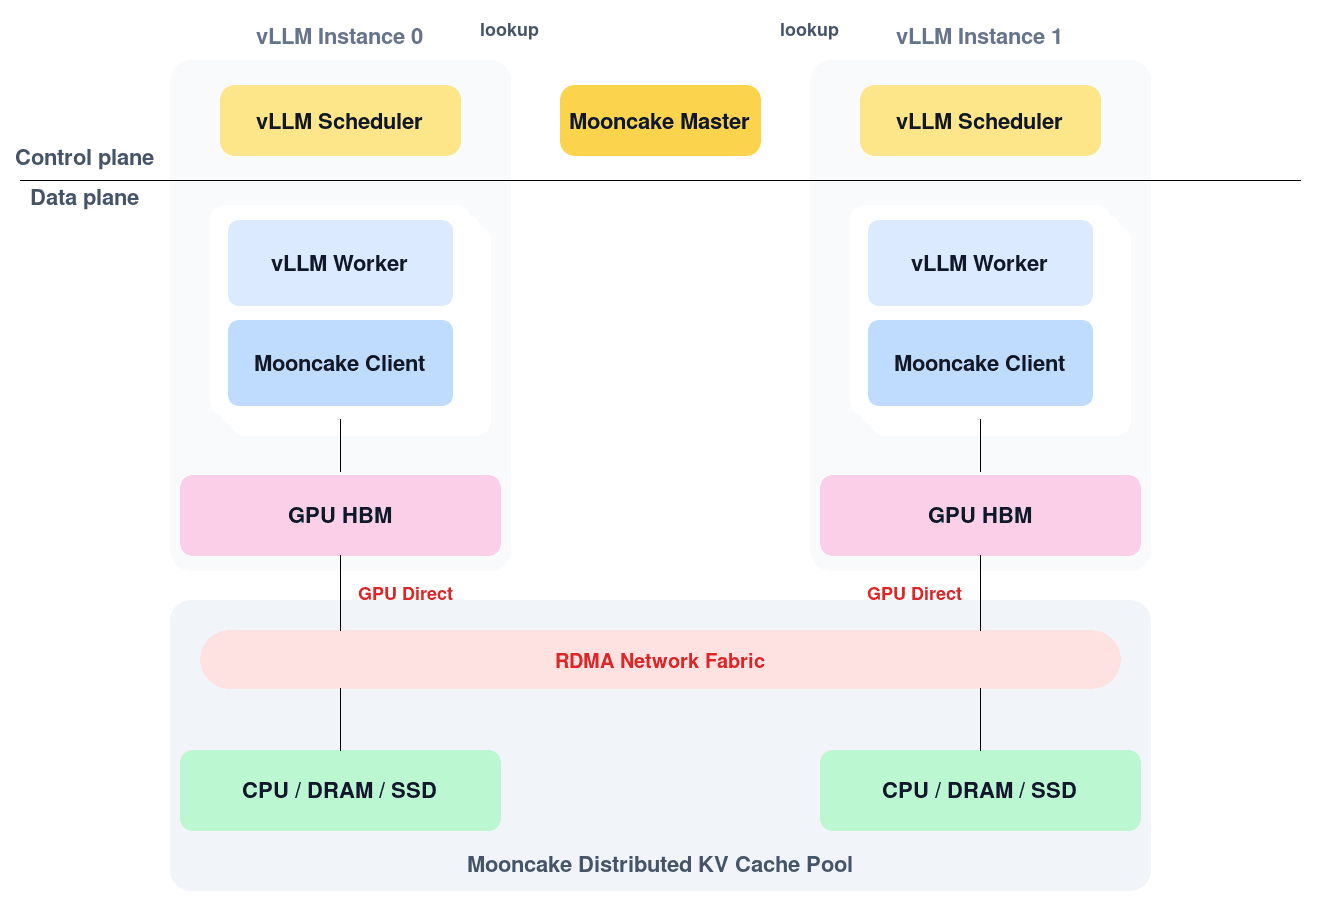
图 2:vLLM 分布式 KV 缓存池总体设计。多个 vLLM 实例内嵌 Mooncake 客户端,共享一个集群级 Mooncake Store:master 管理 KV 块元数据、服务发现与客户端健康,worker 通过 RDMA 在 GPU HBM 与分布式 DRAM/SSD 池之间传输 KV 块。
高层架构上,Mooncake Store 由一台 master 服务器与一组客户端组成:
- master 服务器运行在集群范围,管理 KV 块哈希、大小等元数据,监控客户端健康与可用性,提供服务发现与失效节点清理
- Mooncake 客户端运行在 GPU 节点上,管理本地 CPU/DRAM/SSD 资源;客户端之间通过 RDMA 连接传输 KV 缓存,共同构成分布式 KV 缓存池
vLLM 的集成复用现有 KVConnector 接口——与 PD 分离所用的是同一抽象,承担两个角色:
- 调度器侧:新请求到达时,vLLM 对提示的 token 块做哈希,向 Mooncake master 查询匹配的 KV 缓存块,并用结果指导调度决策
- worker 侧:vLLM 在每个 GPU worker 内嵌一个 Mooncake 客户端,并启动后台线程负责数据搬运。GPU KV 缓存内存注册为 RDMA 缓冲区,从而可以通过 Mooncake 客户端执行 GPUDirect RDMA 读写,不占用 SM,也不经过 CPU 内存中转
设计亮点
SM-free 与零拷贝的 GPUDirect RDMA 传输
传统的 GPU 到 CPU 数据传输要么用 cudaMemcpyAsync(走 GPU 拷贝引擎,对大量小传输吞吐不佳),要么启动专用 GPU 内核用 SM 拷贝(适合大量小传输,但会与 GPU 上其他内核互相干扰)。vLLM 采用第三条路径:用 RDMA 网卡与 GPUDirect RDMA 直接在 GPU HBM 与 CPU 内存之间搬运 KV 块——无需暂存缓冲区、不消耗 SM,且在大量小 KV 块传输场景下表现良好。
借助 Mooncake Transfer Engine,传输路径还能通过多网卡池化(multi-NIC pooling)与拓扑感知路径选择,同时利用节点上的多块 RNIC,让 KV 传输聚合起来、更好地利用可用网络带宽。
完全异步的传输
虽然 RDMA 操作本身是异步的,但准备描述符、发起 RDMA 读写仍需可观的 CPU 工作,且开销随序列长度增长——序列越长,KV 块越多。为避免阻塞主 CPU 路径(进而延迟 GPU 内核启动),所有 RDMA 操作都运行在专用的后台 I/O 线程上。从 vLLM 的视角看,传输路径完全异步。
用 MultiConnector 打通 PD 分离与分布式缓存池
这套集成天然延伸到 PD 分离场景,靠的是 MultiConnector 接口:一个把多个子连接器串联起来的包装器,各连接器独立工作、互不依赖。
- prefill:prefill 实例为 PD 连接器准备 KV 块,同时通过 store 连接器把 KV 块存入分布式缓存池。命中时 vLLM 会查询所有连接器,可以从 Mooncake Store 连接器恢复匹配的前缀
- decode:decode 实例把 KV 块写入分布式池后,prefill 实例立即可见。decode 目前不从池中读取:因为 vLLM 会把每个请求同时调度到 prefill 与 decode 实例,由 prefill 实例从池中加载前缀 KV 块,再经 PD 连接器转交给 decode
团队正在推进从 prefill 实例与分布式池同时加载 KV 的多路径方案,以最大化可用网络带宽。
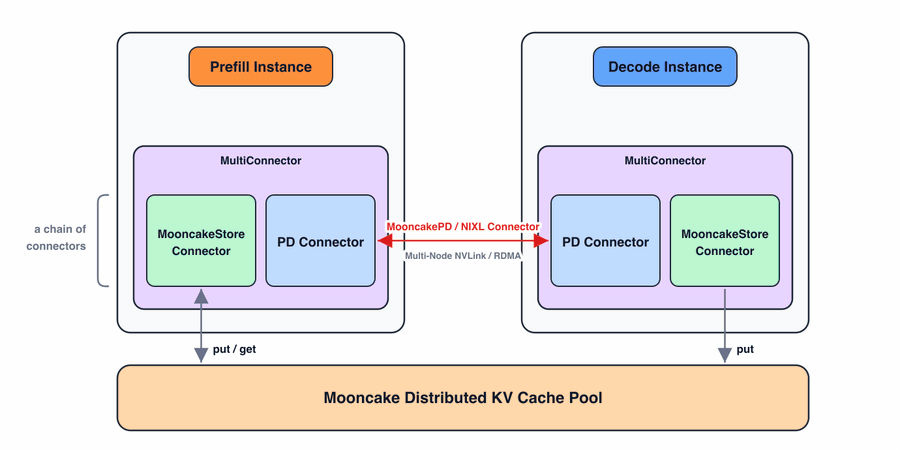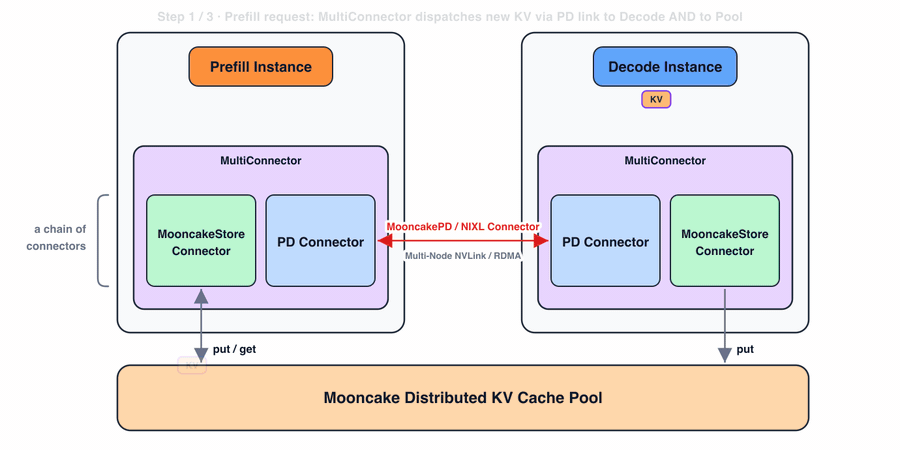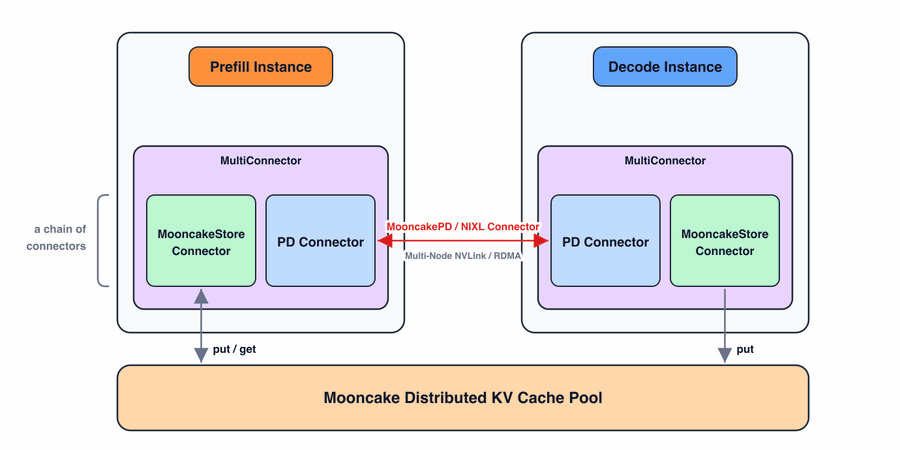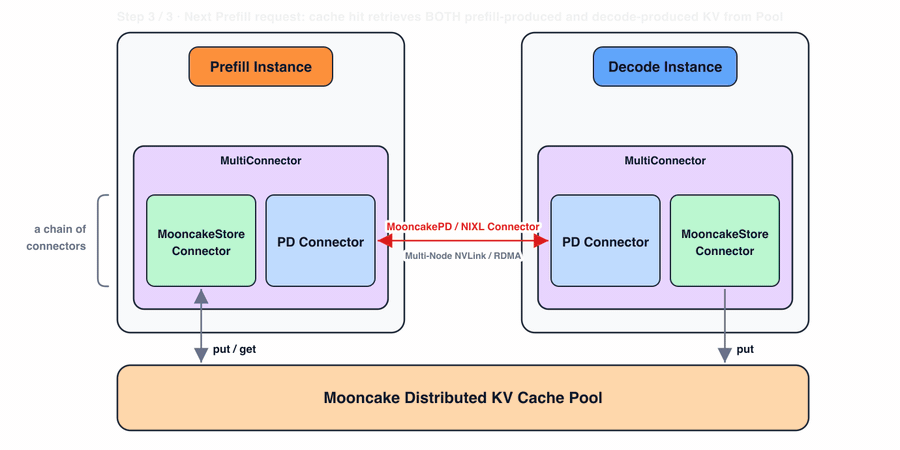
图 3:通过 MultiConnector 把 PD 分离与分布式 KV 缓存池结合。
性能
当前实现与基准脚本均已开源。评测使用 Kimi-2.5 NVFP4 模型跑在 GB200 节点上,启用 PD 分离:prefill 实例 TP4,decode 实例 DP8 + EP,该配置在延迟与吞吐之间取得了最佳权衡。
加速真实智能体轨迹
首先用前述 Codex 智能体轨迹做贴近实际的评测:1P1D 拓扑,共 12 块 GPU。
分布式 KV 缓存池把 vLLM 吞吐提升 3.8 倍,P50 TTFT 与端到端延迟分别降低 46 倍与 8.6 倍。收益来自缓存命中率的巨大提升:从只有系统提示被缓存的 1.7%,提高到几乎整个前缀都被缓存的 92.2%。
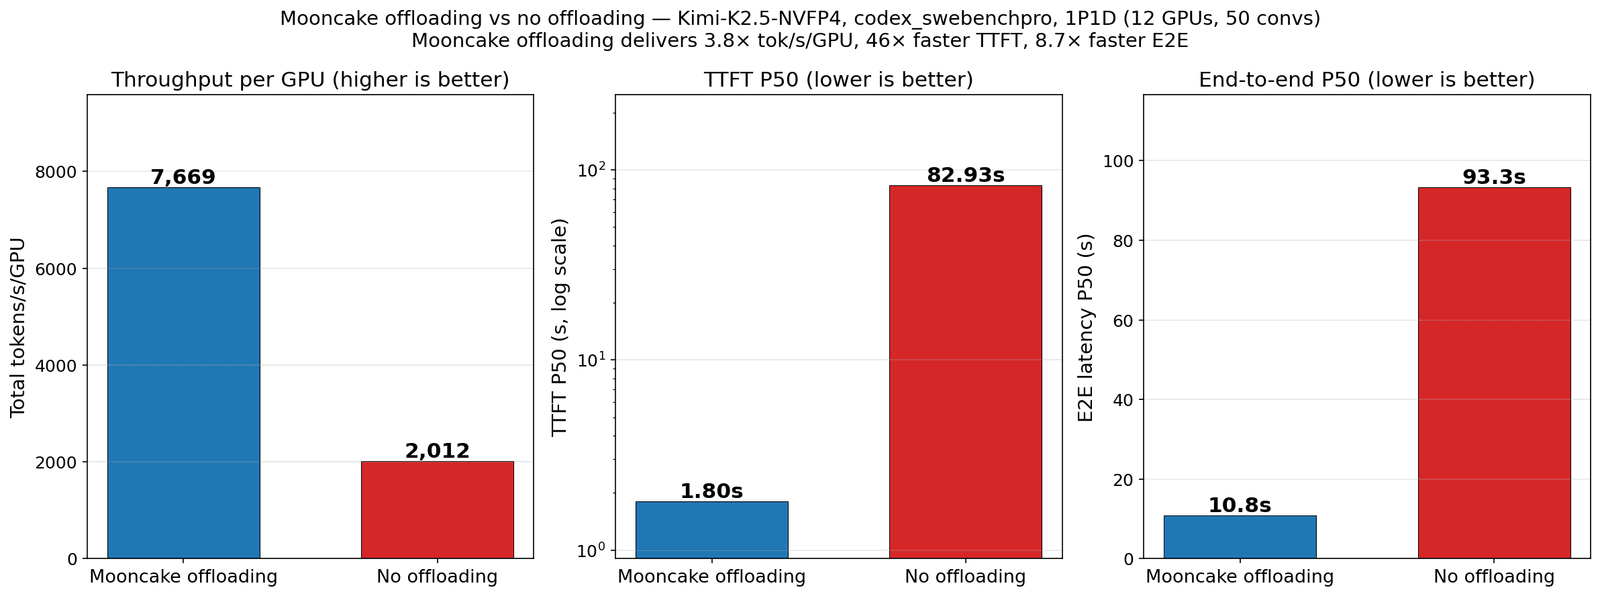
图 4:真实 Codex 智能体轨迹上 vLLM + Mooncake Store 与基线的对比(1P1D,12 块 GB200 GPU):吞吐提升 3.8 倍,P50 TTFT 降低 46 倍,端到端延迟降低 8.6 倍,缓存命中率从 1.7% 升至 92.2%。
多节点扩展
扩展测试进一步增加节点数,并使用由 Codex 负载派生的合成数据集做受控实验:
| 参数 | 设定 |
|---|---|
| 公共 token(系统指令) | 20K |
| 首轮输入 | 10K token |
| 每轮输入 | 2,048 token |
| 输出 | 900 token |
| 总轮数 | 30 |
| 会话数(随 GPU 数缩放) | 75 → 150 → 225 → 300 → 375 |
| 总输出/输入比 | 约 1.3% |
参数设定大致对齐原始 Codex 负载。为了压测跨节点数据路径,实验使用轮询路由:请求可能在轮次之间被调度到不同节点,经常需要从上一节点拉取 KV 缓存。
没有分布式 KV 缓存池时,这种路由模式会造成大规模缓存未命中与严重的吞吐退化;启用 Mooncake Store 后,vLLM 在各规模下缓存命中率始终高于 95%,系统近乎线性扩展到 60 块 GPU。这表明分布式 KV 缓存池在集群扩大的同时显著提升命中率,并维持高效的数据路径。
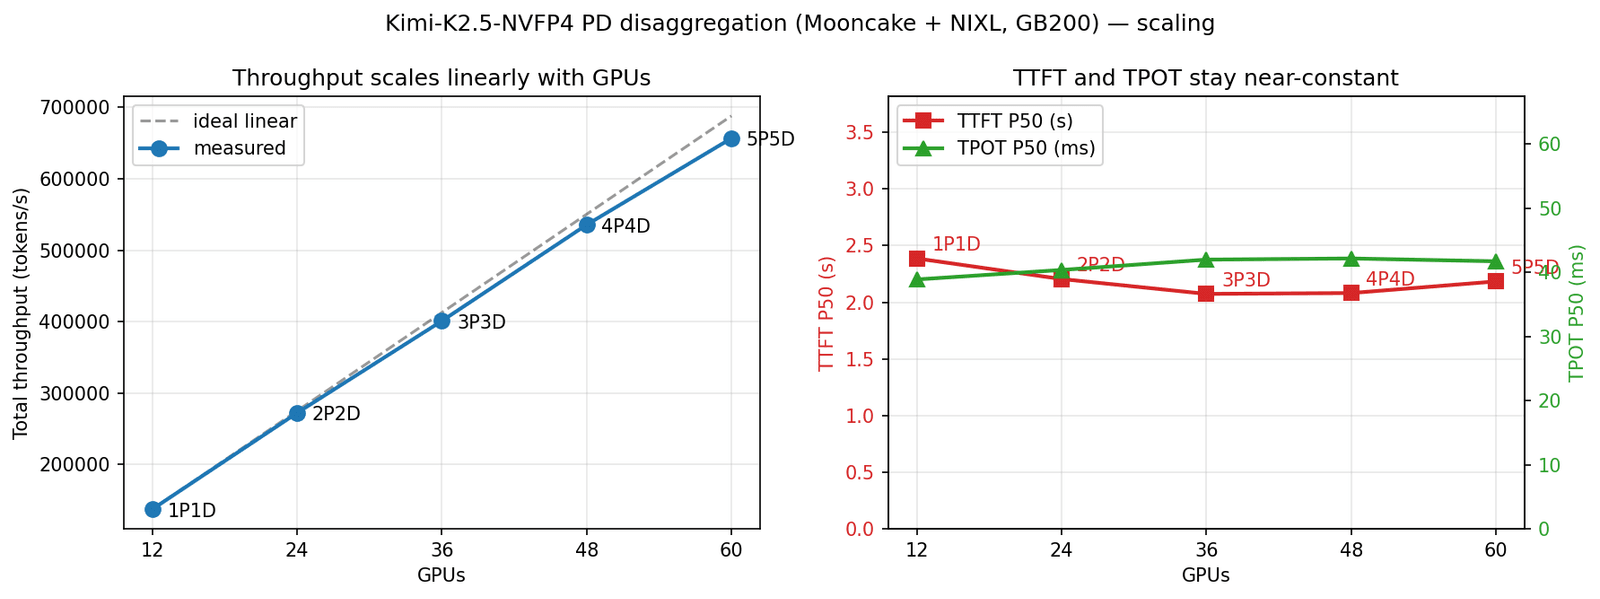
图 5:轮询路由下,Mooncake Store 使吞吐从 12 块扩展到 60 块 GB200 GPU:各规模命中率均 >95%,扩展接近线性。
下一步
团队正在推进以下特性与优化:
- 分布式磁盘卸载:把存储层级从 CPU DRAM 扩展到 NVMe SSD 与分布式文件系统,提供更大的缓存容量
- 混合模型的 KV 缓存卸载:支持注意力机制混合的新兴模型架构,其不同层可能需要不同的缓存策略
- 缓存感知路由:把请求路由器与 KV 缓存池协同设计,让轮次优先被调度到已持有相关前缀的实例,在回退到分布式池之前最大化本地命中
- 数据路径进一步优化:在 RDMA 之外利用 NVIDIA 多节点 NVLink,实现更快的多路径 KV 传输;同时探索类似 DualPath 的、从 prefill 与 decode 实例同时加载 KV 的方案,最大化聚合带宽
结语
智能体工作负载把前缀复用变成服务系统设计的首要问题。Mooncake Store 集成表明,KV 缓存可以像模型权重一样成为集群级资源:master 管理元数据、客户端通过 RDMA 共享 GPU 显存,vLLM 用同一套 KVConnector 抽象把它们接进调度与执行路径。3.8 倍吞吐、46 倍 TTFT 与近乎线性的 60 GPU 扩展,都来自缓存命中率从 1.7% 到 92.2% 的跃迁——对智能体应用而言,命中率就是一切。
该集成的思路很大程度受到 vLLM-Ascend 前期工作的启发,蚂蚁集团(Ant Group)的 Chao Lei 完成了最初实现,Inferact 的 Zijing Liu 提供了智能体轨迹与分析。作者感谢 Approaching.AI、华为、阿里云、蚂蚁集团与 9#AISoft 等团队的技术反馈,以及整个 vLLM 与 Mooncake 社区的支持。
原文:Serving Agentic Workloads at Scale with vLLM x Mooncake(vLLM Team,2026-05-06)


