OpenAnt 深度调研:Knostic 如何用”受限人设”的 LLM 找到真实可利用的漏洞
本文基于 Knostic 公开发布的仓库 knostic/OpenAnt(含 README、
ARCHITECTURE.md、威胁模型模板、CHANGELOG)与官方博客 Open OpenAnt 调研整理。文末附完整参考来源。
一、是什么:一个”谁活下来谁才是真漏洞”的开源扫描器
OpenAnt 是安全公司 Knostic 开放源代码的基于 LLM 的漏洞发现产品(LLM-based vulnerability discovery product),目标是帮助防御者主动、先于攻击者发现”已被确认”的安全缺陷,同时把误报(false positives)和漏报(false negatives)都压到最低(README)。
它的核心方法论按照官方”一句话”概括是:
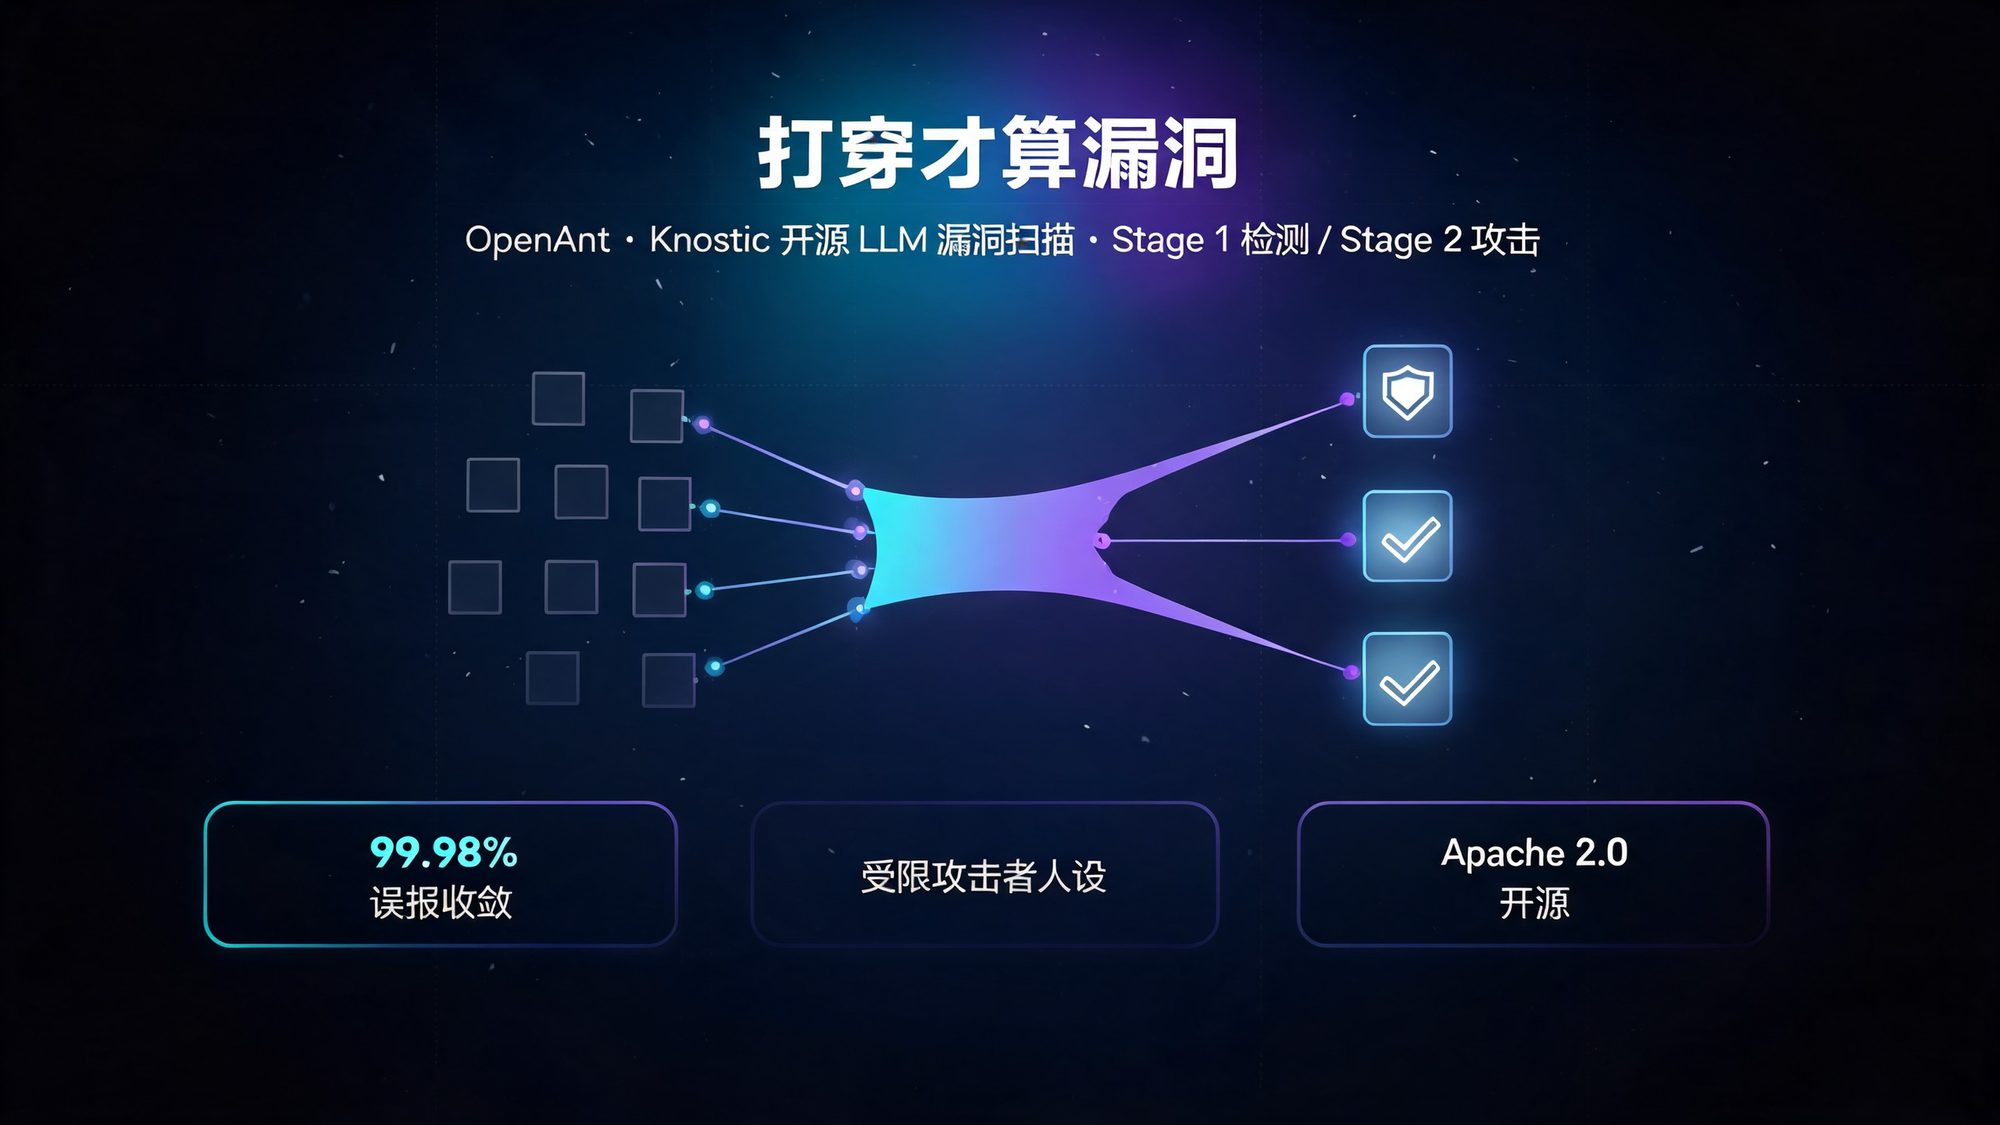
Stage 1 检测(detects),Stage 2 攻击(attacks)。能活到最后的就是真的(What survives is real)。
这句话值得拆开理解。绝大多数 AI 漏洞扫描工具止步于”检测”——也就是第一遍让模型说出”这里有潜在问题”。而 OpenAnt 的第二阶段是要让模型真的扮演攻击者去打一遍,只有通过了攻击验证的发现才会被当作”已确认可利用(exploitable)“的漏洞输出。它不再给你一份装满”疑似问题”的清单,而是给你一份经得起攻击推演的结论。
技术上,OpenAnt 是一个 Go CLI 包裹的 Python 引擎:Go 侧负责用户工作区、项目/配置/检查点、进程生命周期等”运维”事务,Python 侧(libs/openant-core)负责所有与代码分析相关的逻辑,两者通过一个刻意保持非常窄的 JSON 信封契约通信(ARCHITECTURE.md)。
项目在 2026 年 3 月由 Knostic 负责人 Gadi Evron 在官方博客正式宣布开源,采用 Apache 2.0 许可证(博客)。仓库本身定位仍是”研究项目”,部分功能处于 beta 阶段,官方会对扫描发现的漏洞走协调披露(coordinated vulnerability disclosure)流程,也欢迎社区贡献。
二、为什么开源:给维护者一双”跑在攻击者前面”的眼睛
Knostic 开源的动机在 README 里写得很直白,可以概括为三点:
第一,给开源维护者一个”先手”工具。 官方判断,AI 发现的漏洞数量即将”爆炸式增长”,他们希望 OpenAnt 能成为帮助开源维护者跑在攻击者前面的工具——维护者既可以自己扫描仓库,也可以把仓库提交给 Knostic 免费扫描。
第二,这不是 Knostic 的主业。 Knostic 自己聚焦于保护 AI 代理与编码助手(防止它们删掉你的硬盘、泄露代码,并管控 MCP 服务器、扩展、技能等供应链风险),漏洞研究/应用安全并不是它的核心业务,加上公司本身喜欢开源,于是决定以 Apache 2 协议把 OpenAnt 放出来。
第三,明确”不竞争”的定位。 README 特意点名:你可能听说过 OpenAI 的 Aardvark(现已更名 Codex Security)和 Anthropic 的 Claude Code Security,Knostic 对这些”零竞争意图”(zero intention of competing with them)。
这是一次很有意思的行业定位:当 OpenAI、Anthropic 这些巨头把”AI 漏洞扫描”做成自家的商业安全产品时,Knostic 选择把同类能力开源出来、交给开源生态自用。也正因为不靠它盈利,“免费扫描开源仓库”的服务才说得通。
三、最大的技术亮点:对抗性反思(Adversarial Reflexion)
如果说 OpenAnt 有什么值得单独拎出来讲的技术思想,那一定是它的对抗性反思(Adversarial Reflexion)——也就是第二阶段的攻击验证。官方博客用了相当篇幅解释”为什么不能简单地问模型能不能利用”。
为什么”让你当攻击者试试”不够
最直觉的验证方式是提示模型:“你是攻击者,这段代码你能利用吗?“很多工具就是这么干的。OpenAnt 认为这远远不够,原因有二:
- LLM 天生”好好先生”(agreeable by default)。你问”这段代码有漏洞吗”,它会想方设法说”有”;你问”你能利用吗”,它会给你编一个听起来很可信、其实站不住脚的攻击场景。
- 模型会”作弊式”地假设攻击者能力。它会默认攻击者拥有服务器访问权、数据库凭据、能读本地文件、甚至能在目标机上开一个本地 shell——而这些假设往往根本不成立。
结果就是:对着安全代码,模型也能构造出一个看似合理的攻击链,制造大量误报。
受限人设(constrained persona)+ 逐步追溯 + 结构化攻击路径
OpenAnt 的解法是给模型套上一个极其受约束的攻击者人设:
- 模型不能假设自己有服务器访问权、不能假设自己有数据库凭据、不能假设自己能读本地文件。
- 每一步利用都必须在这个约束内成立,并且逐步显式追溯——必须给出具体的输入、具体的端点、具体的数据流,一步步走通,不能跳过关键步骤、不能”手一挥”带过难的部分。
- 对 CLI 工具和库,约束更严:模型被明确告知它没有任何运行 CLI 命令的能力,必须找到一种远程触发漏洞的方式。
这一条尤其能消灭一整类误报:如果唯一的攻击路径需要本地运行命令行、需要服务器 shell 访问、或者需要”应用的用户本人”才能触发,那么该漏洞会被判为不可利用(NOT EXPLOITABLE)——因为本地用户本来就能在自己的机器上做任何事,这不构成安全边界被突破。
再配合工具访问(模型能实际去读代码、查调用关系、验证它的每一步声称),OpenAnt 把第二阶段的验证变成一场真实的对抗测试:模型不是在”确认”一个发现,而是在受限条件下尝试打穿代码,并且必须展示它的工作过程。
这是 OpenAnt 与传统 LLM 扫描工具最本质的分野:它不是让模型复述漏洞,而是逼着模型在一个贴近现实的攻击者能力边界内、可验证地把漏洞一步步攻下来。
四、架构:Go CLI 包着 Python 引擎,Key-Value 式窄契约
在动手之前先理解它的架构,能帮你更快地上手。OpenAnt 是一个”双运行时”项目:
| 层 | 语言 | 职责 |
|---|---|---|
| Go CLI(apps/openant-cli) | Go 1.25+ | 项目/配置/检查点管理、进程生命周期、扫描调度、结果渲染 |
| Python 引擎(libs/openant-core) | Python 3.11+ | 解析、增强、分析、验证、报告等全部分析逻辑 |
两边的契约刻意做得很窄(ARCHITECTURE.md):
- stdout 只输出一个 JSON 信封({status, data, errors}),供 Go 侧程序化读取;
- stderr 输出人类可读的过程信息,流式透传、不做解析;
- 退出码约定:0 干净、1 发现漏洞、2 出错;
- 只有
ANTHROPIC_API_KEY以环境变量形式跨运行时传递,配置不传递——Go 与 Python 各自独立读取~/.config/openant/config.json(这一点也是官方在架构文档里点名的”已知漂移向量”,后面会讲)。
多语言处理采用”扇出再合并”策略:解析阶段按语言扇出到各自目录(避免 7 个同名文件互相覆盖),随后把多语言数据集合并成一份 dataset.json,昂贵的 LLM 阶段只跑一次。这样一份扫描只有一份预算、一套去重、一份报告,代价是 LLM 阶段看到的是混合语言的语料(ARCHITECTURE.md)。
目前支持的语言:Go、Python(成熟),以及 JavaScript/TypeScript、C/C++、PHP、Ruby、Zig、Swift(beta)。Rust、Java、C# 等出现在路线图上。
五、流水线:从 15,232 个单元一路漏斗到 3 个漏洞
官方博客给出了非常具体的端到端漏斗数据——以 OpenSSL 为例,能让你直观感受这套”先广撒网、再逐层收敛、最后攻击确认”的设计意图(博客,成本为 2026 年 2 月观测值)。
OpenAnt 把代码切成单元(unit):一个代码块(函数、模块等)+ 附加元数据(谁调用它、它调用谁、其它有用信息)。单元加调用图,就给 LLM 提供了验证”某处漏洞是否真正可利用”所需的上下文。
| 阶段 | 说明 | LLM 成本 | OpenSSL 结果 |
|---|---|---|---|
| 1. 代码解析 | 提取每个函数、建调用图,构成”单元”;纯静态分析,无 LLM 成本 | 0 | 15,232 个单元 / 1,769 个文件 |
| 2. 可达性分析 | 定位入口点,沿调用图前向追踪到”能从外部输入到达”的函数;纯图遍历 | 0 | 掉到 390 个(-97%) |
| 3. 代理式暴露分类 | Sonnet 代理对每个可达单元迭代探查代码库,按暴露度分类 | 每个迭代约 0.13 美元 | 掉到 49 个外部暴露单元(再 -87%) |
| 4. 漏洞发现 | Claude Opus 分析每个外部暴露单元找漏洞 | — | 49 个中 28 个被标记为潜在漏洞 |
| 5. 可利用性验证 | Claude Opus + 工具用,扮演攻击者逐步攻击,最贵的一步 | 每个单元 0.14–10.54 美元 | 28 个中 3 个被确认为可利用(再 -89%) |
| 6. 动态验证 | 在 docker 隔离沙箱里动态跑(可复现)验证 | 约 0.90 美元/次 | 3 个发现进入动态验证 |
从 15,232 → 390 → 49 → 28 → 3,整体收敛了 99.98%,最终只剩 3 个”被确认可利用且动态验证过”的漏洞。这正是 OpenAnt 想传达的:输出不是”可能有问题”,而是”打穿了”。
成本真相:“免费”的只是软件,token 要自掏腰包
官方博客一句俏皮话很到位:“OpenAnt 免费,就像小狗免费一样(free, as in puppy)——它需要照顾和喂养,尤其是 token 成本。“用 OpenSSL 跑一轮完整扫描约 442.65 美元(含增强 393.41 + 发现 7.69 + 验证 38.86 + 动态 2.70)。
其他项目的实测成本:
| 项目 | 语言 | 单元数 | 可达性过滤后 | 发现到验证 | 总成本 |
|---|---|---|---|---|---|
| OpenSSL | C | 15,232 | 390 | 49 → 28 → 3 | 442.65 美元 |
| WordPress | PHP | 12,177 | 393 | 93 → 67 → 20 | 239.45 美元 |
| LangChain | Python | 6,701 | 143 | 37 → 1 → 1 | 51.48 美元 |
| Rails | Ruby | 89 | 89 | 19 → 2 → 2 | 25.18 美元 |
| Grafana | TS & Go | 18,500 | 2,379 | 223 → 143 → 86 | 1,080.86 美元 |
成本大头在于代理式暴露分类 + 漏洞发现/验证这几步的 agentic 迭代(每个迭代都会把此前对话追加进上下文,token 随轮数增长)。官方还提醒:单元数与代码量并不直接相关,大项目单位元可能更少,建议在让 OpenAnt 处理前先自己估算单元数。
六、威胁模型:用 OPENANT.THREATMODEL.md 告诉扫描器”攻击者到底是谁”
这是 OpenAnt 一个非常有意思的设计,值得单独讲。早期设计把仓库归为四类之一(web_app / cli_tool / library / agent_framework),每类对应一套硬编码攻击模型,并把”攻击者是谁”压成一个布尔值。架构文档直白地批评这种设计:“把整个对手模型压进一个枚举加一个布尔值,喂给两个硬编码人设——‘一个只有浏览器的互联网攻击者’和’一个有 shell 的本地用户’——如果你真实的对手两者都不属于,那么每个判定都会继承这个错误。”
因此 OpenAnt 支持在你的仓库根目录放一个 OPENANT.THREATMODEL.md,用自由文本 + 机器可读 JSON 描述:
- 自由格式分类(不再限于枚举),以及组件(自由格式类型 + 暴露等级 remote/local/internal);
- 具名攻击者画像,带显式的 CAN / CANNOT 能力清单(“不能做什么”恰恰是杀死误报的关键);
- 输入源(trusted / semi_trusted / untrusted)及由哪些组件处理;
- 什么算漏洞、什么不算,以及被攻破后的具体影响。
机器实际读取的是文件中标注 "schema": "openant-threat-model"(version 1)的 JSON 代码块。三个设计细节很能体现工程严谨度:
- 缺省回退,畸形则中止。 缺失该文件是一个”选择”(回退到内置四类分类器);但文件存在却解析/校验失败则是硬错误、直接中止扫描——因为一个静默回退到 web_app 的扫描,看起来”成功”了,实际上却是在错误的安全模型下分析。
- 该文件本身是”攻击者可控制的”。 它来自被扫描仓库,其文本不设提示注入防护——官方在架构文档里明确这是”已记录、已接受的缺口”。
- 宽容威胁模型会有告警。 因为一个 schema 合法但过于宽松的威胁模型会被用来”合理化地”抑制发现,所以对”全信任/无远程攻击者”这类模型,扫描会给出显式警告,让这种抑制变得可见。
七、动手用:本地安装与一次扫描
OpenAnt 不需要”上传代码到云端”,而是本地命令行工具。上手路径(README):
# 1. 构建 CLI(需 Go 1.25+)
cd apps/openant-cli && make build
# 输出到 apps/openant-cli/bin/openant,可软链到 PATH

# 2. 配置 LLM(交互式向导,按管道阶段选 provider/model)
openant setup llm

# 3. 初始化仓库并扫描(-l 指定语言,必填)
openant init <repo-url> -l go
openant scan --verify
scan --verify 会一次跑完整个流水线(parse → enhance → analyze → verify → build-output → report)。没有 Anthropic 之外偏好的话,跳过向导、直接 openant set-api-key sk-ant-... 也能用内置的 openant-default 配置跑起来。
关于 LLM 配置有几个值得注意的点:
- 每个管道阶段可以配不同的 (provider, model),配置示例展示了”强推理模型负责检测/验证/可达性审查,轻量模型负责上下文/报告/测试生成”的分工思路;内置默认用 Claude Opus 4.6 做检测、Sonnet 4 做其余。
- 支持自定义接入:provider 可配
base_url走 OpenRouter、vLLM、Bedrock 等 OpenAI/Anthropic 兼容代理;想加新 provider 的话,官方给出了一套”一个 Python 文件实现 LLMAdapter Protocol + 一个契约测试工厂 + 注册项”的小配方,再补几个 Go 触点即可接入向导。 - 官方也提醒三个内置 adapter 的 API key 都不包含在各自消费订阅里:Anthropic 的 key 不算在 Claude Pro/Max、OpenAI 的不算在 ChatGPT/Codex、Google 的不算在 Gemini Advanced 里,需要单独在 API 控制台开通。
八、工程现实:一份诚实的”已知隐患”清单
OpenAnt 是研究项目,官方在架构文档里主动列出了大量”已知但尚未修复”的结构性问题,这种坦诚在开源安全工具里相当少见,也值得读者(尤其是想部署到生产的人)了解:
来自官方博客的已知问题(Known Issues)
- 动态测试设计质量不稳定。动态测试由”预算内最强 LLM”(目前 Opus 4.6)现场生成,但测试设计未必足够严谨——有时能技术上确认漏洞、方法学上却有争议,在 C 代码库里尤甚(底层内存管理、指针运算、复杂控制流让动态验证困难)。官方曾考虑”生成多个备选测试设计再择优”,但因架构与编排复杂度而放弃。
- 上下文窗口约束。单个逻辑单元可能超出 LLM 上下文窗口,C 项目尤其容易(密集依赖 + 大量头文件包含链)。路由到更大上下文模型能缓解但不根治,缩单元又冒”漏掉执行路径/隐含假设”的风险。
- 成本估算波动。实际开销可能接近预估的两倍——比如某步产出非法 JSON 会触发自动修正循环,产生额外提示与 token 消耗,这类级联效应难以提前建模。
来自架构文档的已知结构隐患(Known Structural Hazards)
架构文档(ARCHITECTURE.md)甚至列出了”每个都至少踩过一次坑”的清单,其中几条相当尖锐,例如:
- Go/Python 契约靠约定而非 schema:core/schemas.py 与 internal/types/results.go 之间没有机械约束,历史上 formatter.go 读 data[“reports”]、而 Python 产出的是 step_reports,导致 CLI 的 Reports 区块从未渲染过;types.ReportData 结构体零引用——表面是类型安全,实际生产在读无类型 map。
- 配置路径两侧各自解析:Windows 上 Go 写 %APPDATA%、Python 读 ~/.config,引擎可能永远看不到向导写的配置。
- 模型默认值重复:Go 向导预填的模型 ID 与 Python 内置可能漂移,新用户的配置每个阶段都可能 404。
- scan_repository 是 841 行 / 26 参数的巨型函数:一切流水线改动的高发区。
- 限流器仅进程内生效:多并发扫描之间不协调退避。
- 全仓库没有设 temperature:同一 commit 扫两遍结果可能不一致,发现不可运行复现对比;—limit 限制的是单元数而非金额,没有花费上限。
这些大多属于”脚手架”层面、不影响工具的正确性判断,但如果你想在产品里长期依赖它,值得把这些列进评估清单。
九、路线图与定位小结
OpenAnt 的路线图(README)大致包括:更多 provider adapter(Ollama、vLLM、Cohere、Mistral、Groq、Bedrock、Azure,每个都是小 Python 配方);基于订阅的认证(ChatGPT/Codex、Claude Pro/Max、Gemini Advanced 目前都不提供 API 额度,靠 OAuth 适配器接消费订阅可补上这个缺口);跨 provider 工具调用的长尾差异;更多语言与托管扫描服务。
横向看,它的价值主张与 Codex Security / Claude Code Security 形成鲜明的”互补而非竞争”格局:
- Codex Security 走”威胁模型 + 自动验证 + 可审查补丁 + 人在环路”,重点在发现并推进到修复,规模化数据惊人(3000 万+ 提交、7 万+ 修复);
- OpenAnt 则把重心放在**“确认可利用”这个中间态上**——用受限攻击者人设替你把”疑似”收敛成”打穿了”,开源、本地可跑、免费扫 OSS。
对开源维护者来说,OpenAnt 的价值在于:它不逼你把代码交给私有云,可以本地/自托管跑,且输出的每一条结论都经过了攻击验证的”拷问”。结合官方的 OSS 免费扫描 offer,它确实是给”想跑在攻击者前面”的维护者多了一个实在选项。
一句话总结:OpenAnt 用”Stage 1 检测、Stage 2 攻击”的两阶段框架,加上刻意收紧的攻击者人设(不能有 shell、不能读本地文件、必须远程、必须逐步可追溯),把 LLM 扫描从”给你一堆疑似告警”推进到”给你几条打穿了的结论”——而这一切以一个 Apache 2 的开源工具形式交给社区。
参考来源
官方仓库与文档
- GitHub:knostic/OpenAnt(README)
- OpenAnt 架构文档(ARCHITECTURE.md)
- 威胁模型模板(OPENANT_THREATMODEL_TEMPLATE.md)
- 两阶段分析设计与落地(OPENANT_TWO_STAGE_PLANNING.md)
- OpenAnt CHANGELOG
官方博客与站点
- OpenAnt: Open Sourcing Knostic’s LLM-based Vulnerability Discovery Product(knostic.ai/blog/openant)
- OSS 免费扫描提交入口(knostic.ai/blog/oss-scan)
- Knostic 官网
相关背景


