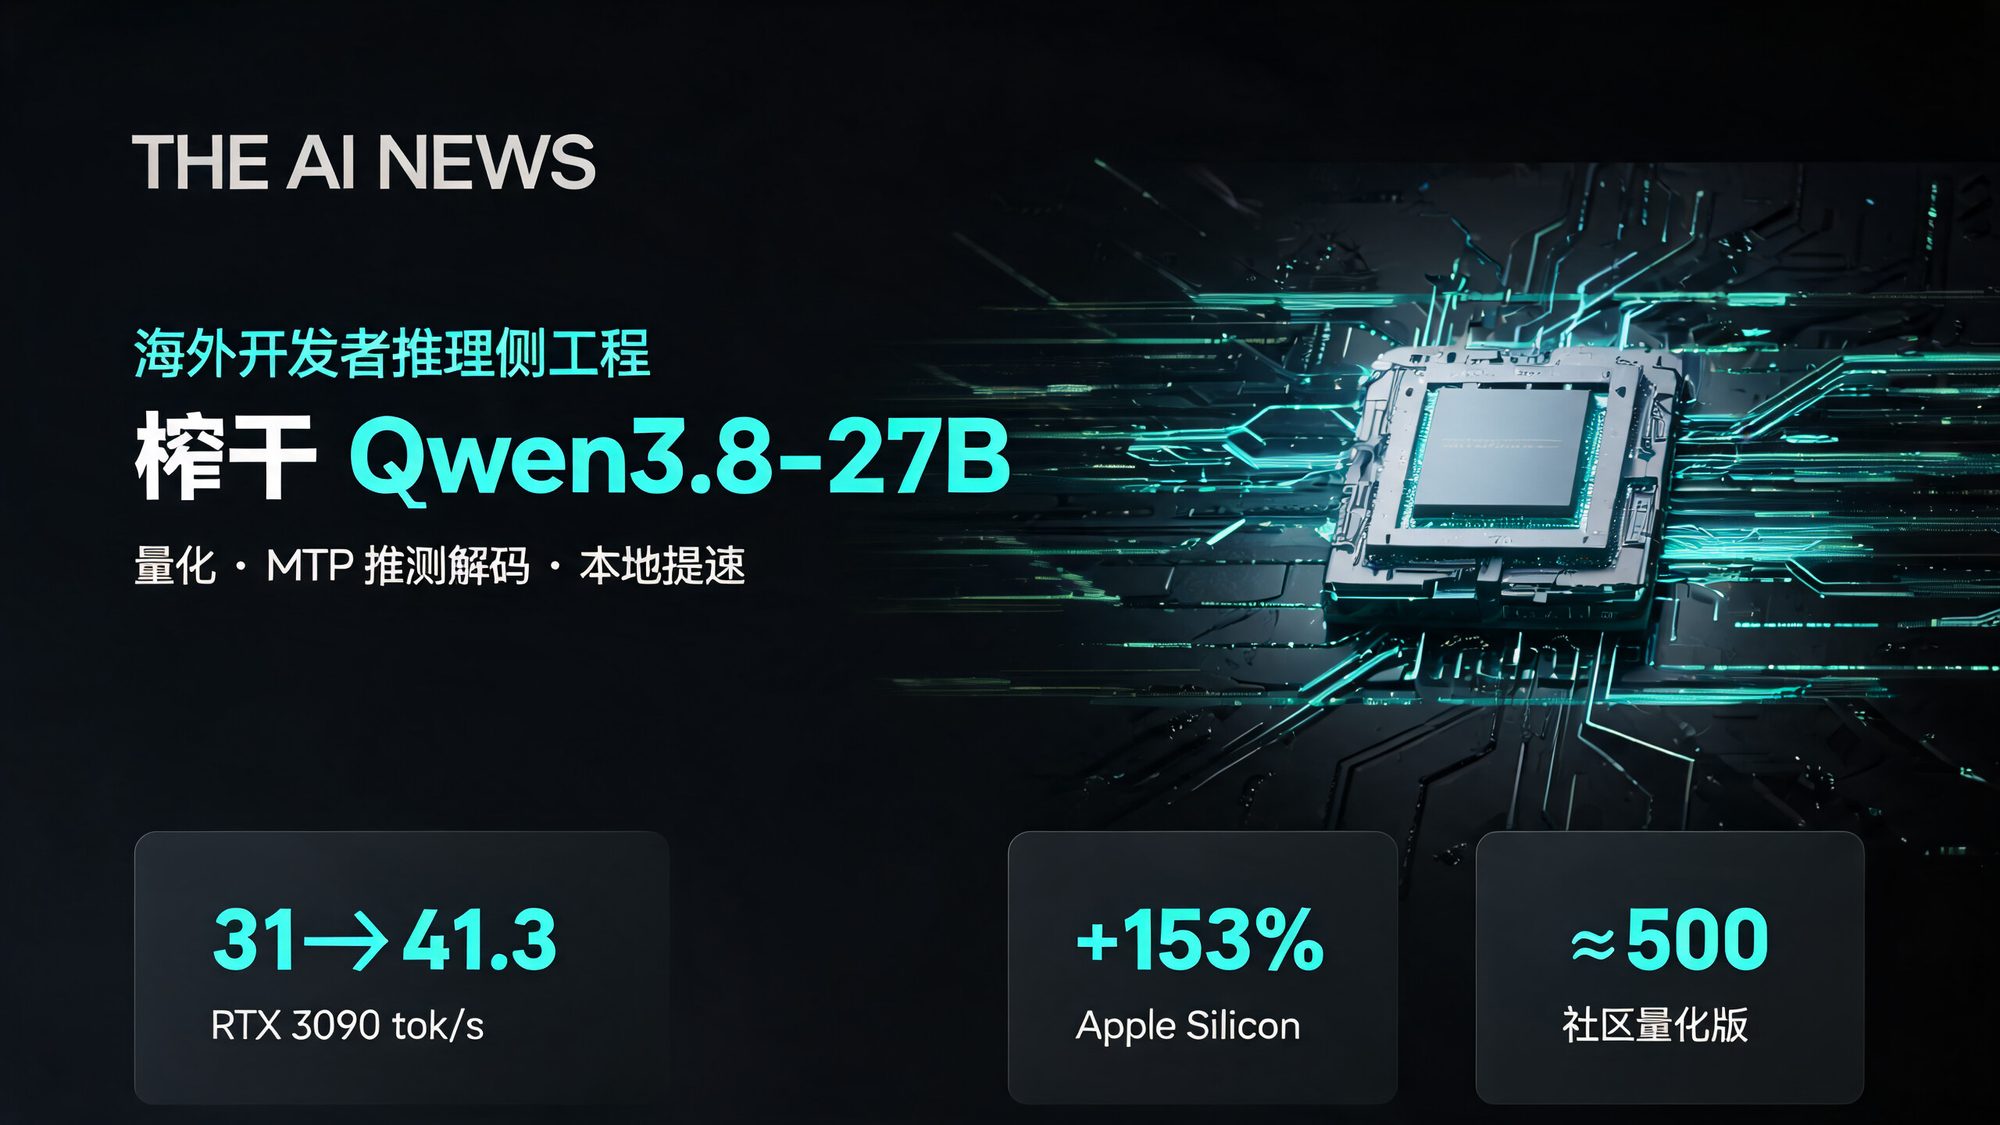
阿里开源的 Qwen3.8-27B 一发布便引发海外开发者社区的狂热。X 上一个关于 Anthropic 的玩笑被当成新闻转发:「Dario Amodei 得知一个 27B 模型在 LiveCodeBench 上超过 Opus 4.6 Max、还能在 900 美元的二手显卡上离线运行后,紧急要求与立法者开会」——发布者随后澄清,除了「紧急开会」,细节都是真的。开源不到 12 小时它就登上 Hugging Face 历史最受欢迎 TOP4 与 Trending 榜首,两天下载破 100 万次、社区自发贡献约 500 个量化版本。而真正体现热度的,是围绕模型的工程生态:NVIDIA、AMD、联发科、摩尔线程等芯片厂商快速适配;SGLang 开发者发布当天就开始提速,单张 RTX 5090 的 decode 速度经 NVFP4 等优化已可超过 200 tokens/s。
稠密模型的工程现实
Qwen3.8-27B 是 27B 参数的原生多模态稠密模型(Apache 2.0),一方面延续 Qwen3.5 的 Gated DeltaNet + Gated Attention 混合架构,原生支持 262K 上下文、可用 YaRN 扩展到 100 万 token;另一方面,稠密模型每个 token 都需完整模型参与计算——对比 30B-A3B 的 MoE 每个 token 只激活约 3B 参数,27B 稠密模型每次生成都跑满全部参数,解码头因此成为本地部署最现实的问题。
这也让讨论迅速从「能力怎么样」转向「怎样把它跑得更好」:开发者开始围绕量化精度、推理配置展开测试,并用多 Token 预测(MTP)做推测解码来提速。
社区提速战报
- MTP 推测解码:发布数小时后,Sudo Su 便建立
qwen38-mtp项目。A/B 测试中 RTX 3090 从 31.0 提到 41.3 tokens/s,RTX 5090 Mobile 从 36.7 提到 50.9;RTX 4090 从 47.7 提升至 76.3,RTX A6000 从 26.7 提升至 52.5。启动两天即积累 21 名贡献者、27 组配置。 - Apple Silicon 挑战:开发者 Kydo 发起性能优化挑战,不到 16 小时即把运行性能相对基线提升 153%,达到默认 MTP 解码的约 2.5 倍,下一步计划扩展到 CUDA 平台。
- 推理强度调优:
reasoning_effort(low/medium/xhigh)与enable_thinking、preserve_thinking可控制思考深度。但测评者 Bijan Bowen 用 xhigh 时,生成一个 C++ 滑板游戏竟循环思考 5–10 次、耗时一个多小时仍卡在 bug 上;社区因此开始按任务难度分配推理预算,并修订 Qwen3.5/3.6/3.8 的 Jinja template 与 sampler 配置。
核心总结
- 热度:12 小时进 HF 历史最受欢迎 TOP4,两天下载破百万,约 500 个社区量化版本
- 能力:编程、Agentic(SWE-bench Pro、CoWorkBench、LiveCodeBench v6)、多模态(OSWorld-Verified、SWE-MM)等得分高于 Claude Opus 4.6 Max;适合前端开发、GUI Agent 等需要视觉 + 代码 + 环境交互的场景
- 工程关键:稠密模型每个 token 跑满全部参数,MTP 推测解码、NVFP4 量化是主要提速方向(RTX 3090 +33%,RTX 4090 +60%)
- 生态:「权重不等于最终体验」——同一份权重经不同 chat template、sampler、backend 会产生不同表现,开源社区正在补上这轮「推理侧工程」
原文:从模型能力到工程优化,海外开发者正在「榨干」 Qwen3.8-27B(机器之心,姚戈,2026-08-17)


