8 月 19 日,LMSYS(Large Model Systems Organization)发布博客,详解其团队如何在 NVIDIA H20 上为万亿参数的 Mixture-of-Experts(MoE,混合专家)模型 DeepSeek-V4-Pro 搭建场景化推理服务栈。V4-Pro 是 1.6 万亿参数的 MoE 模型,官方同时提供 FP8 与 FP4 权重;这类规模的模型天然受益于 Blackwell 级加速器(更高 HBM、更强算力、原生 FP4 Tensor Core),但 H20 虽仍被广泛部署却不具备这些优势。LMSYS 的核心结论是:没有一套通用配置能同时满足所有负载,必须按场景拆分服务画像。在 batch size 为 1 时,单节点 H20-141GB 参考配置达到 271 tokens/s,对比 B300 的 383.7 tokens/s,尽管峰值算力比高达 45.6×,实测解码性能差被压缩到仅 1.42×。
从硬件约束到服务画像
硬件约束与服务角色
Blackwell 提供原始性能,H20 提供可部署规模。B300 具备原生 FP4 Tensor Core、高得多的 FP8 吞吐和显著更大的 HBM;H20 无法匹敌其算力,但保有高内存带宽和 900 GB/s 的 NVLink,且能规模化供应。本研究中每个节点含 8 张 GPU,由 NVLink 互联。Prefill(预填充)不保留跨请求的长期状态,其硬件选择主要由 TTFT、算力与通信效率决定;Decode(解码)则要在整个生成期内保留每个活跃请求的 KV Cache,HBM 容量直接限制上下文长度与并发度。因此该部署用 H20-141GB 做解码、H20-96GB 做 prefill。
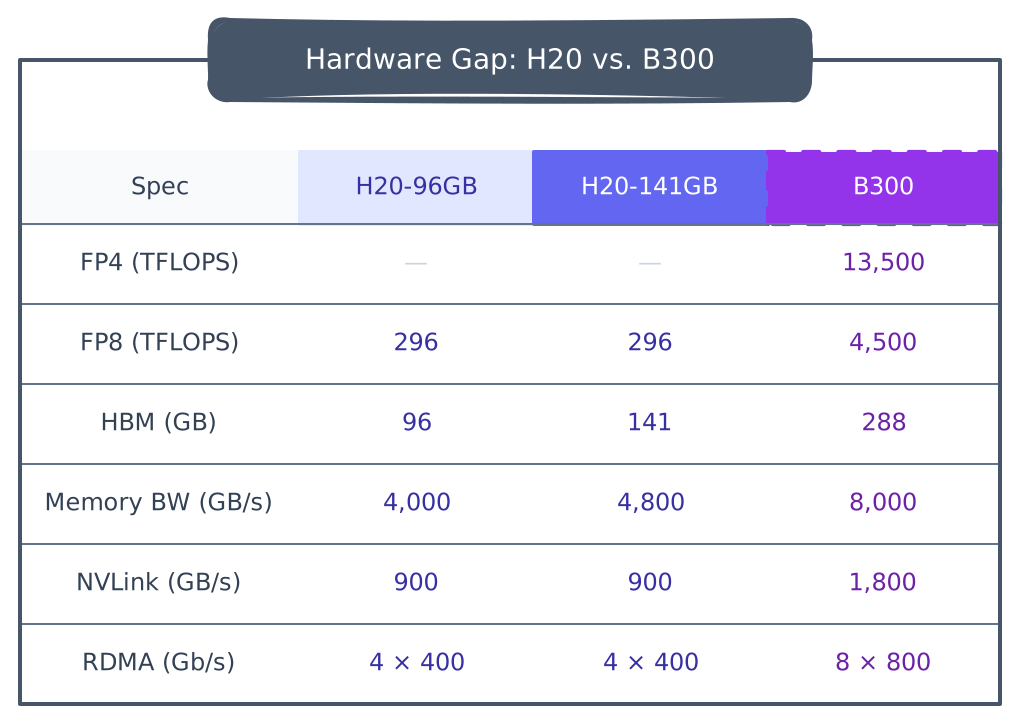
图 1:硬件差距——H20 对比 B300
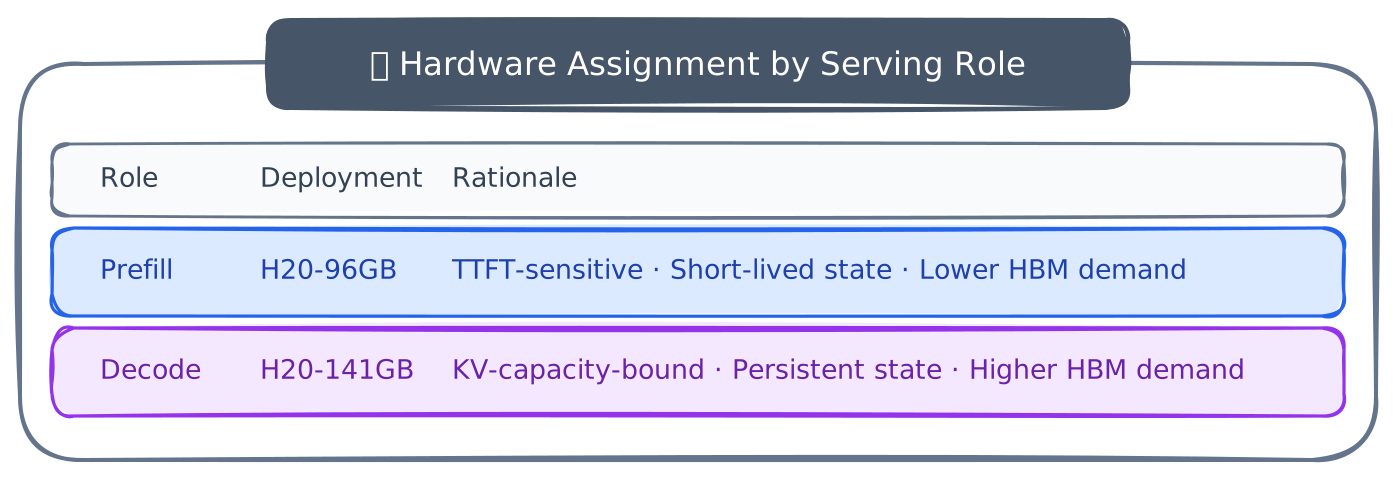
图 2:按服务角色分配硬件
容量选择
服务容量归根结底来自共享的 HBM 预算:模型权重与每请求的 KV 状态竞争同一块内存。LMSYS 定义了全 token 容量(full-token capacity)——即分配完权重与运行时缓冲区后,每个 rank 最多能容纳的全注意力 KV token 数,它是一个内存上限,而非可接受 batch size 的直接保证。
先用 Humming MXFP4AFP8 缩减权重占用。 Humming MXFP4AFP8 使用 MXFP4 专家权重 + 在线 FP8 激活,在缺乏原生 FP4 Tensor Core 的 H20 上降低权重占用与内存流量(对应 SGLang 集成见 sglang#23754,作者将在后续专门文章详细介绍)。
再用 Online C128 扩容 KV 缓存。 Offline C128 基线为每个压缩页保留逐索引状态;Online C128 改为维护紧凑的聚合状态,把更多 HBM 释放给 KV 缓存池。它引入了额外的状态维护与投机校验开销,但作者在测试中未观察到 TPOT 回退。
容量增益可叠加。 通过缩小权重占用,Humming MXFP4AFP8 把 DP32-EP32 的全 token 容量提升到「Baseline FP8 + Offline C128」的 1.71×、PP2-TP8 的 4.47×;Online C128 在此基础上再减少 C128 辅助状态占用,额外带来 2.268×。两者叠加后,容量分别提升到基线的 3.88×(DP32-EP32) 与 10.14×(PP2-TP8)。
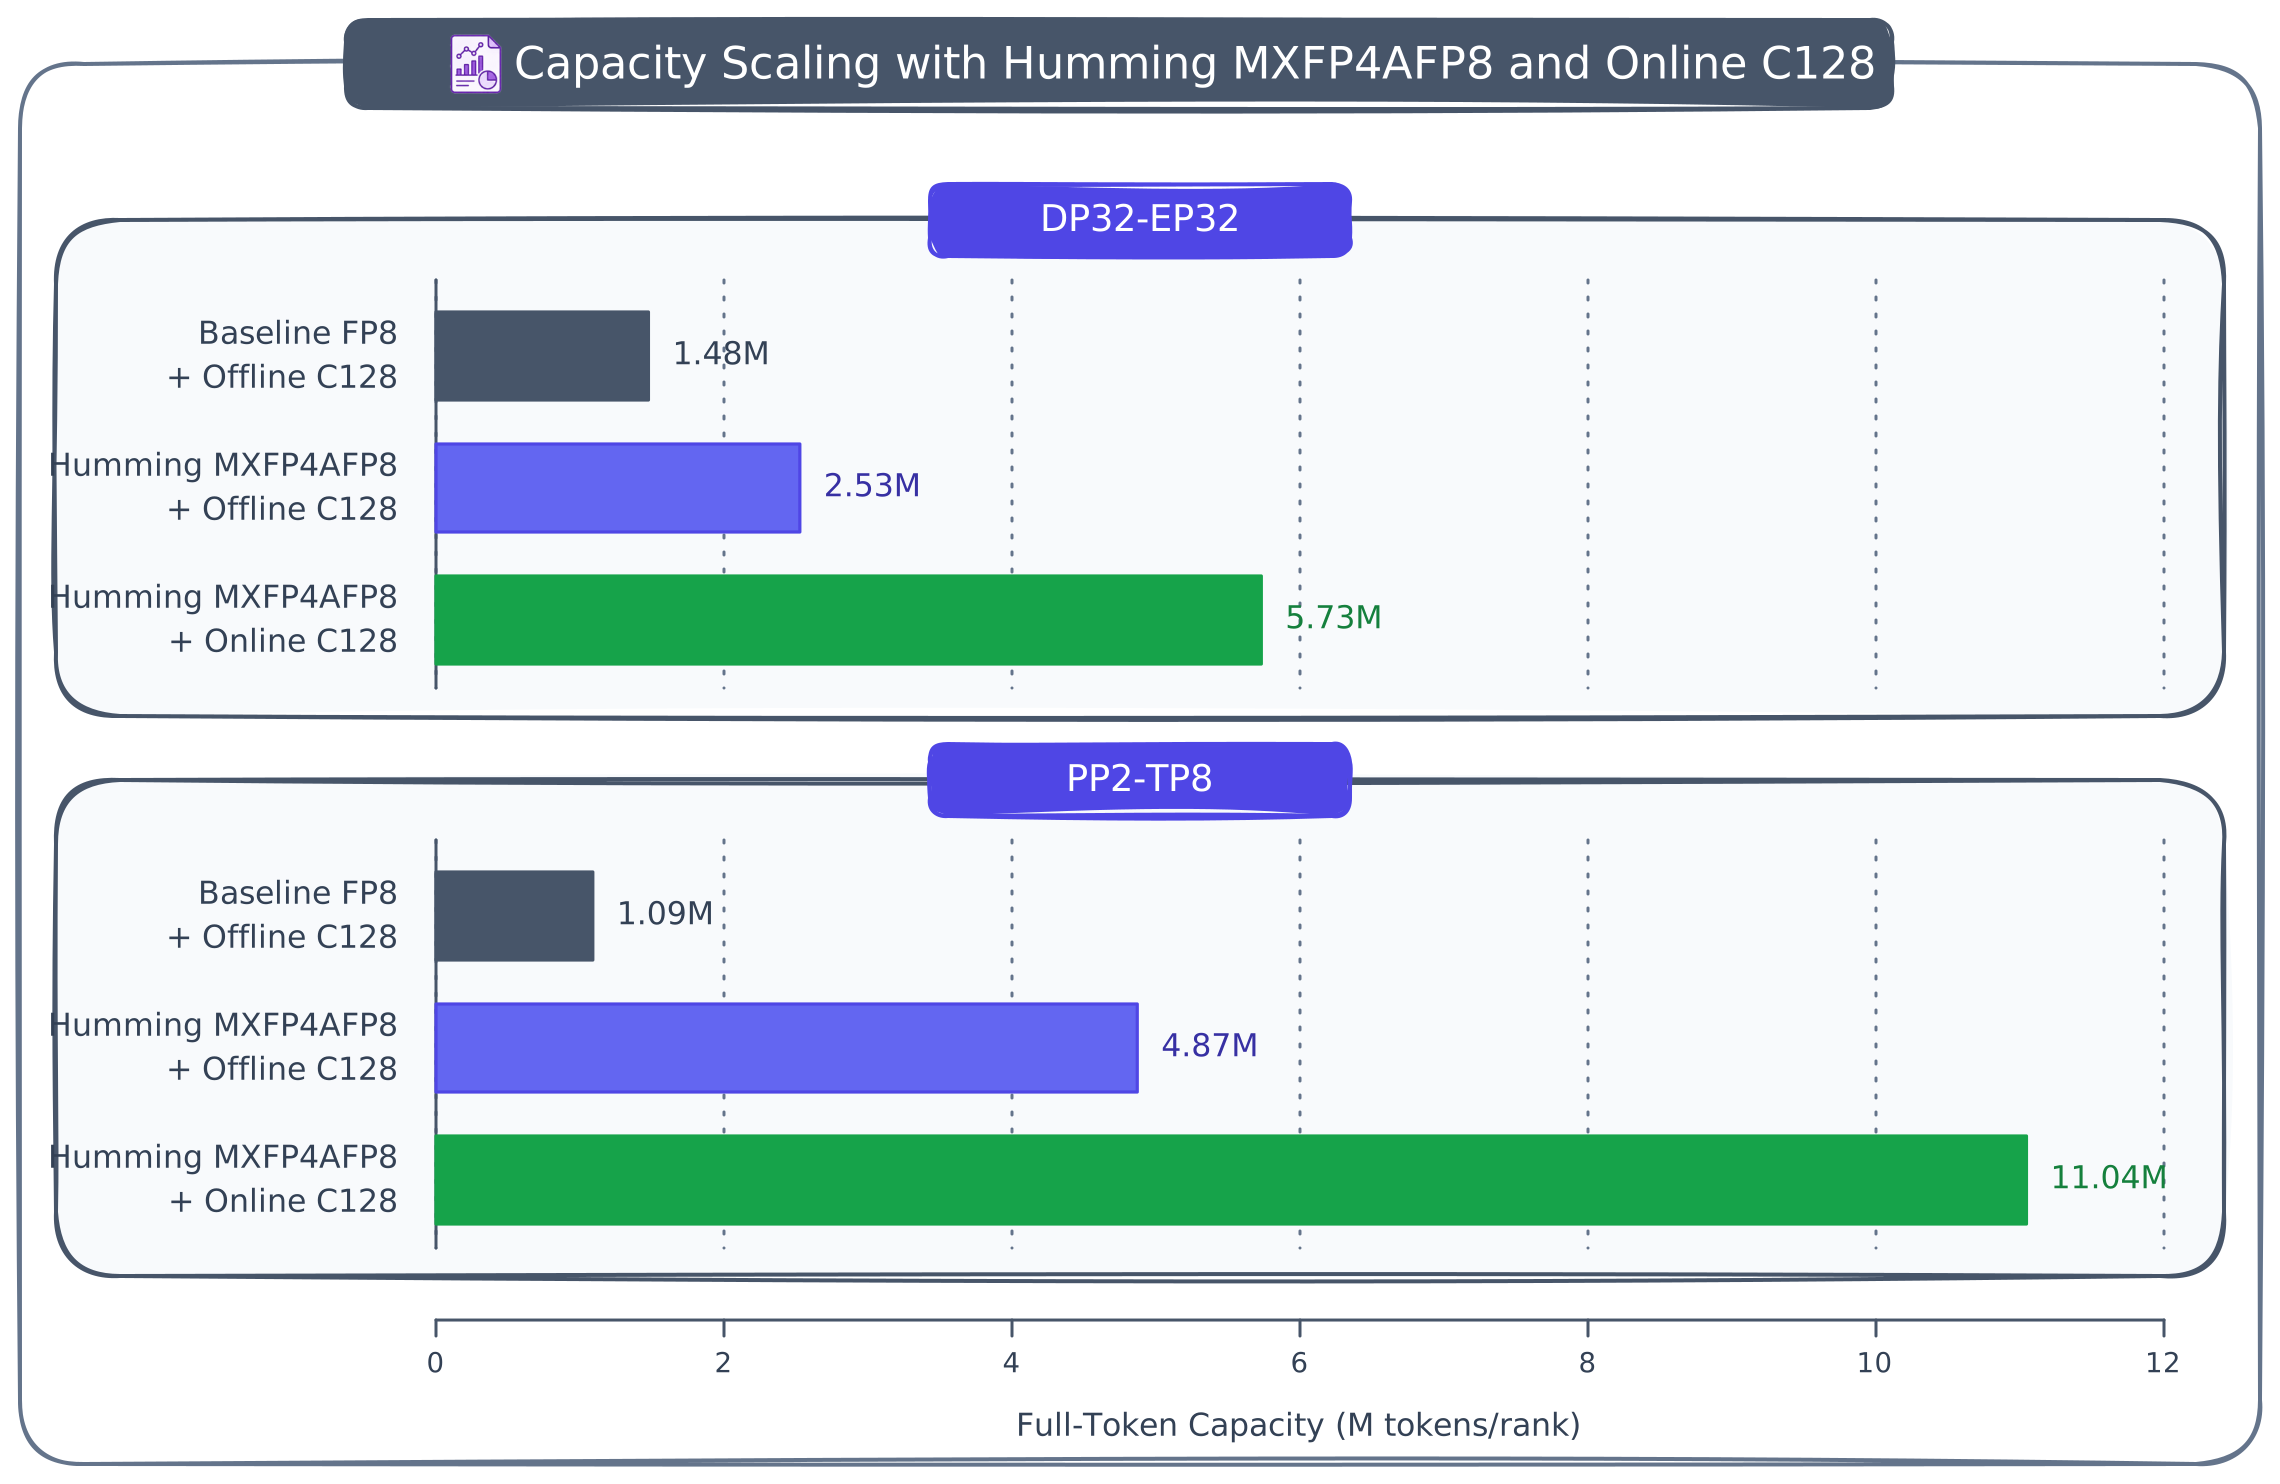
图 3:Humming MXFP4AFP8 与 Online C128 的容量扩展
场景化服务画像(Serving Profiles)
- Prefill 画像:PP2-CP8-TP8 与 PP4-CP8-TP8 共用同一套 Attention-CP8 → MoE-TP8 执行路径,区别只在流水线深度(PP2 分为两阶段、PP4 分为四阶段)。短输入更适合浅流水线(fill/drain 与跨阶段传输开销更突出);长上下文有足够 chunks 让四阶段保持忙碌,更多节点带来更多 prefill 并行度。因此部署中用 PP2-CP8-TP8 服务短上下文、PP4-CP8-TP8 服务长上下文。
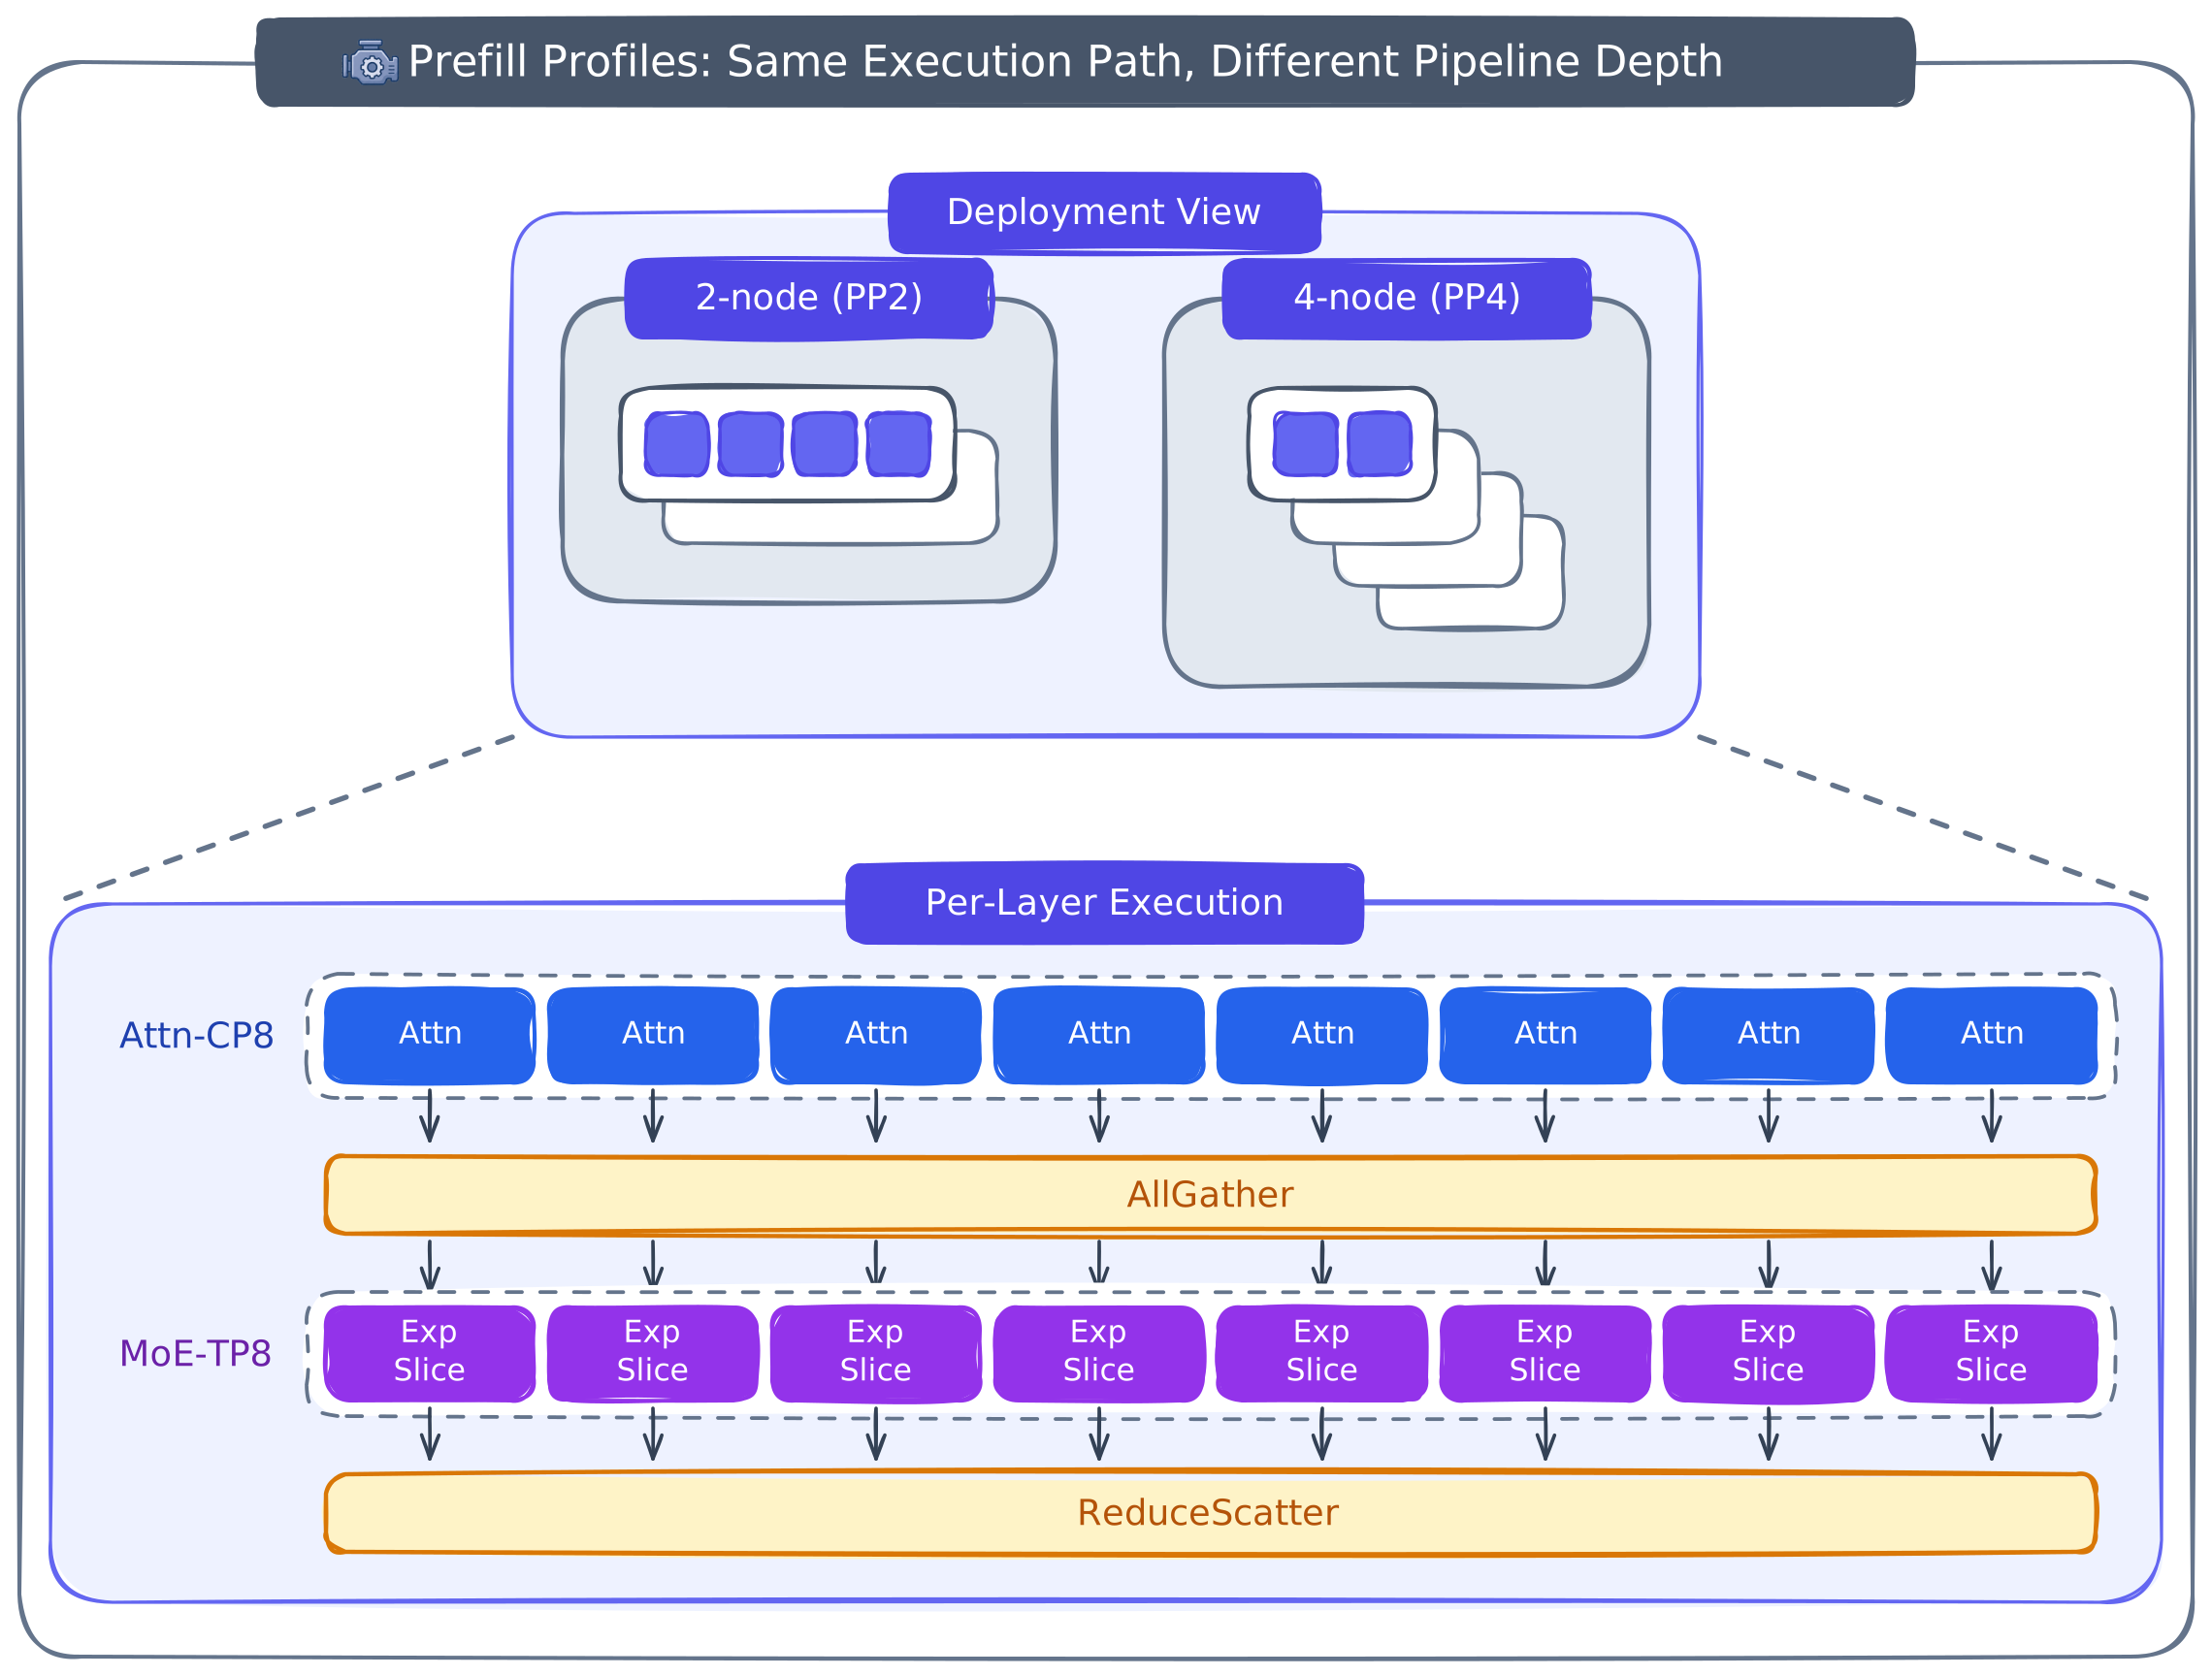
图 4:Prefill 画像——执行路径相同、流水线深度不同
- 低延迟 Decode 画像:单节点 TP8 与 PP2-TP8 共享 Attention-TP8 → MoE-TP8 路径,区别在于模型是否跨节点划分。单节点 TP8 执行路径最短、无跨阶段通信与同步,但权重与服务状态同占一个节点的 HBM,留给 KV 缓存的空间有限,无法同时支撑长上下文与较大 batch。PP2-TP8 付出额外流水线开销,却把权重分布到两个节点,释放更多 HBM 给 KV 状态。作者以 TP8 做 batch-1 延迟参考、PP2-TP8 做低延迟服务画像。
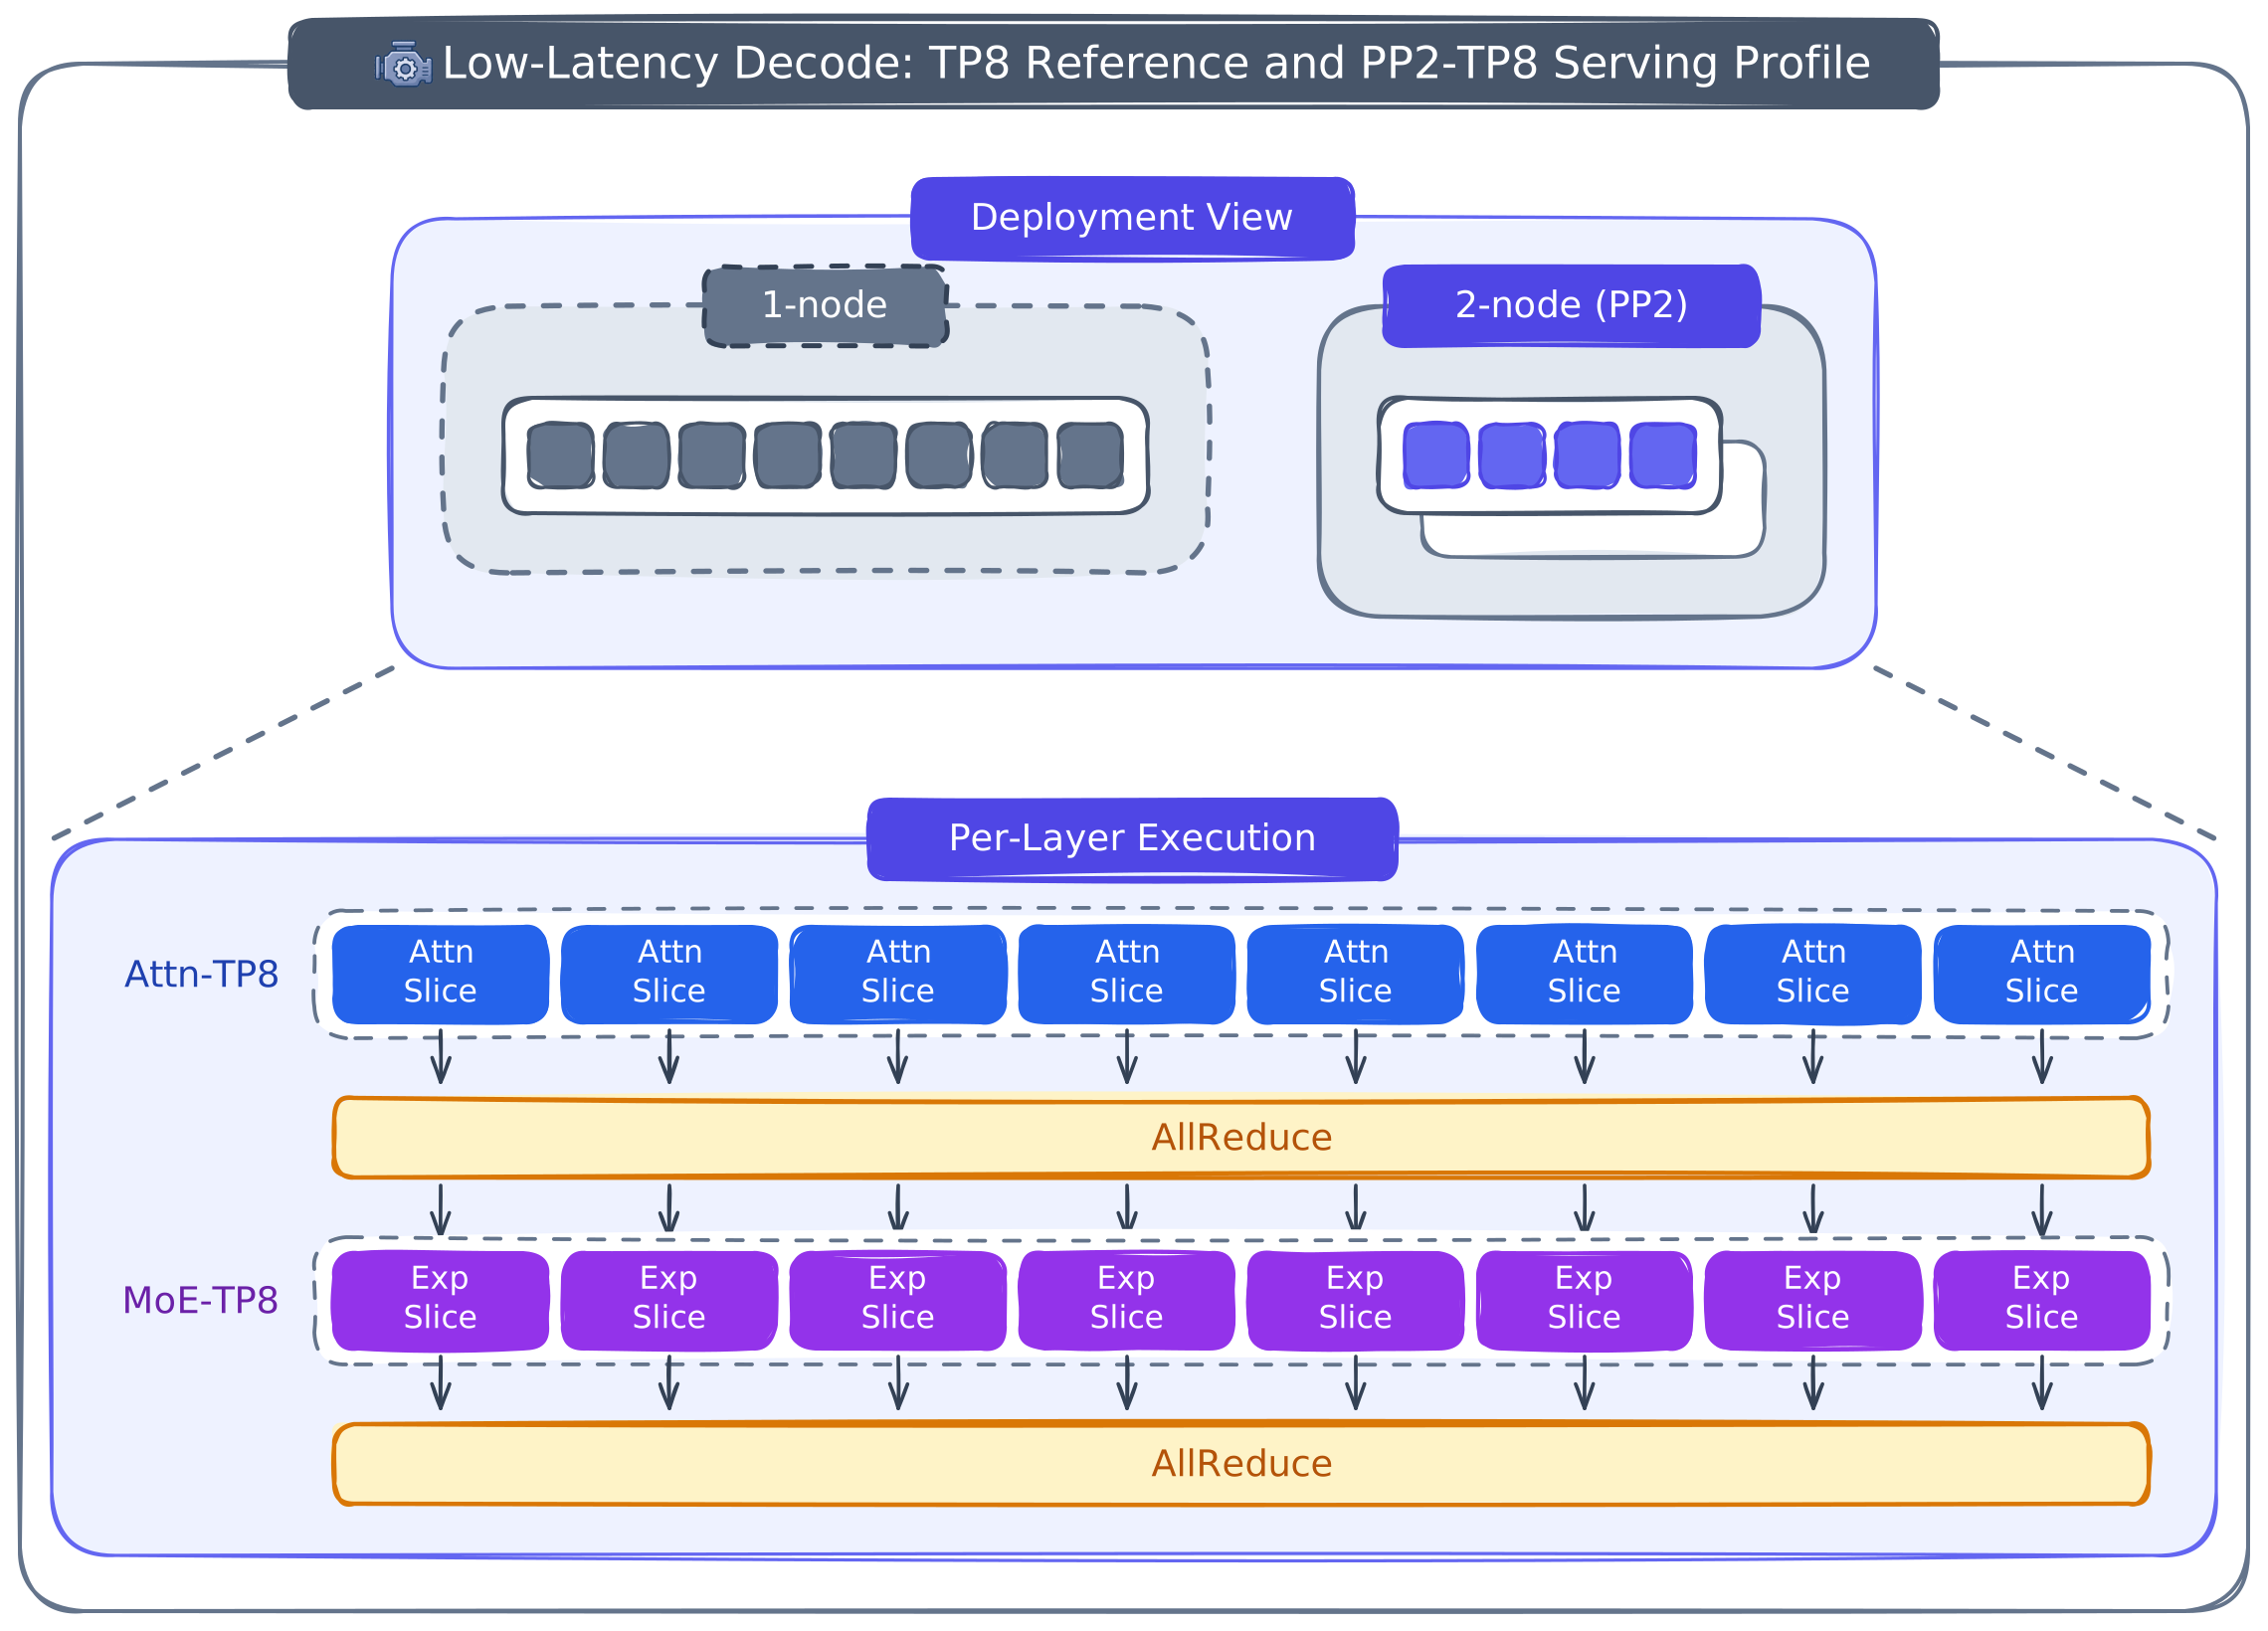
图 5:低延迟解码——TP8 参考与 PP2-TP8 服务画像
- 高吞吐 Decode 画像:DP16-EP16 是最小部署单元,DP32-EP32 在同一拓扑内同时扩展 DP 与 EP。更大的 EP 组把专家权重分散到更多 GPU,释放 HBM 给 KV 缓存并容纳更多并发请求;代价是留在单个节点内的 MoE 流量比例下降、跨节点流量上升,可能降低单 GPU 效率。作者用 DP16-EP16 做最小单元与效率参考、DP32-EP32 扩展请求容量。
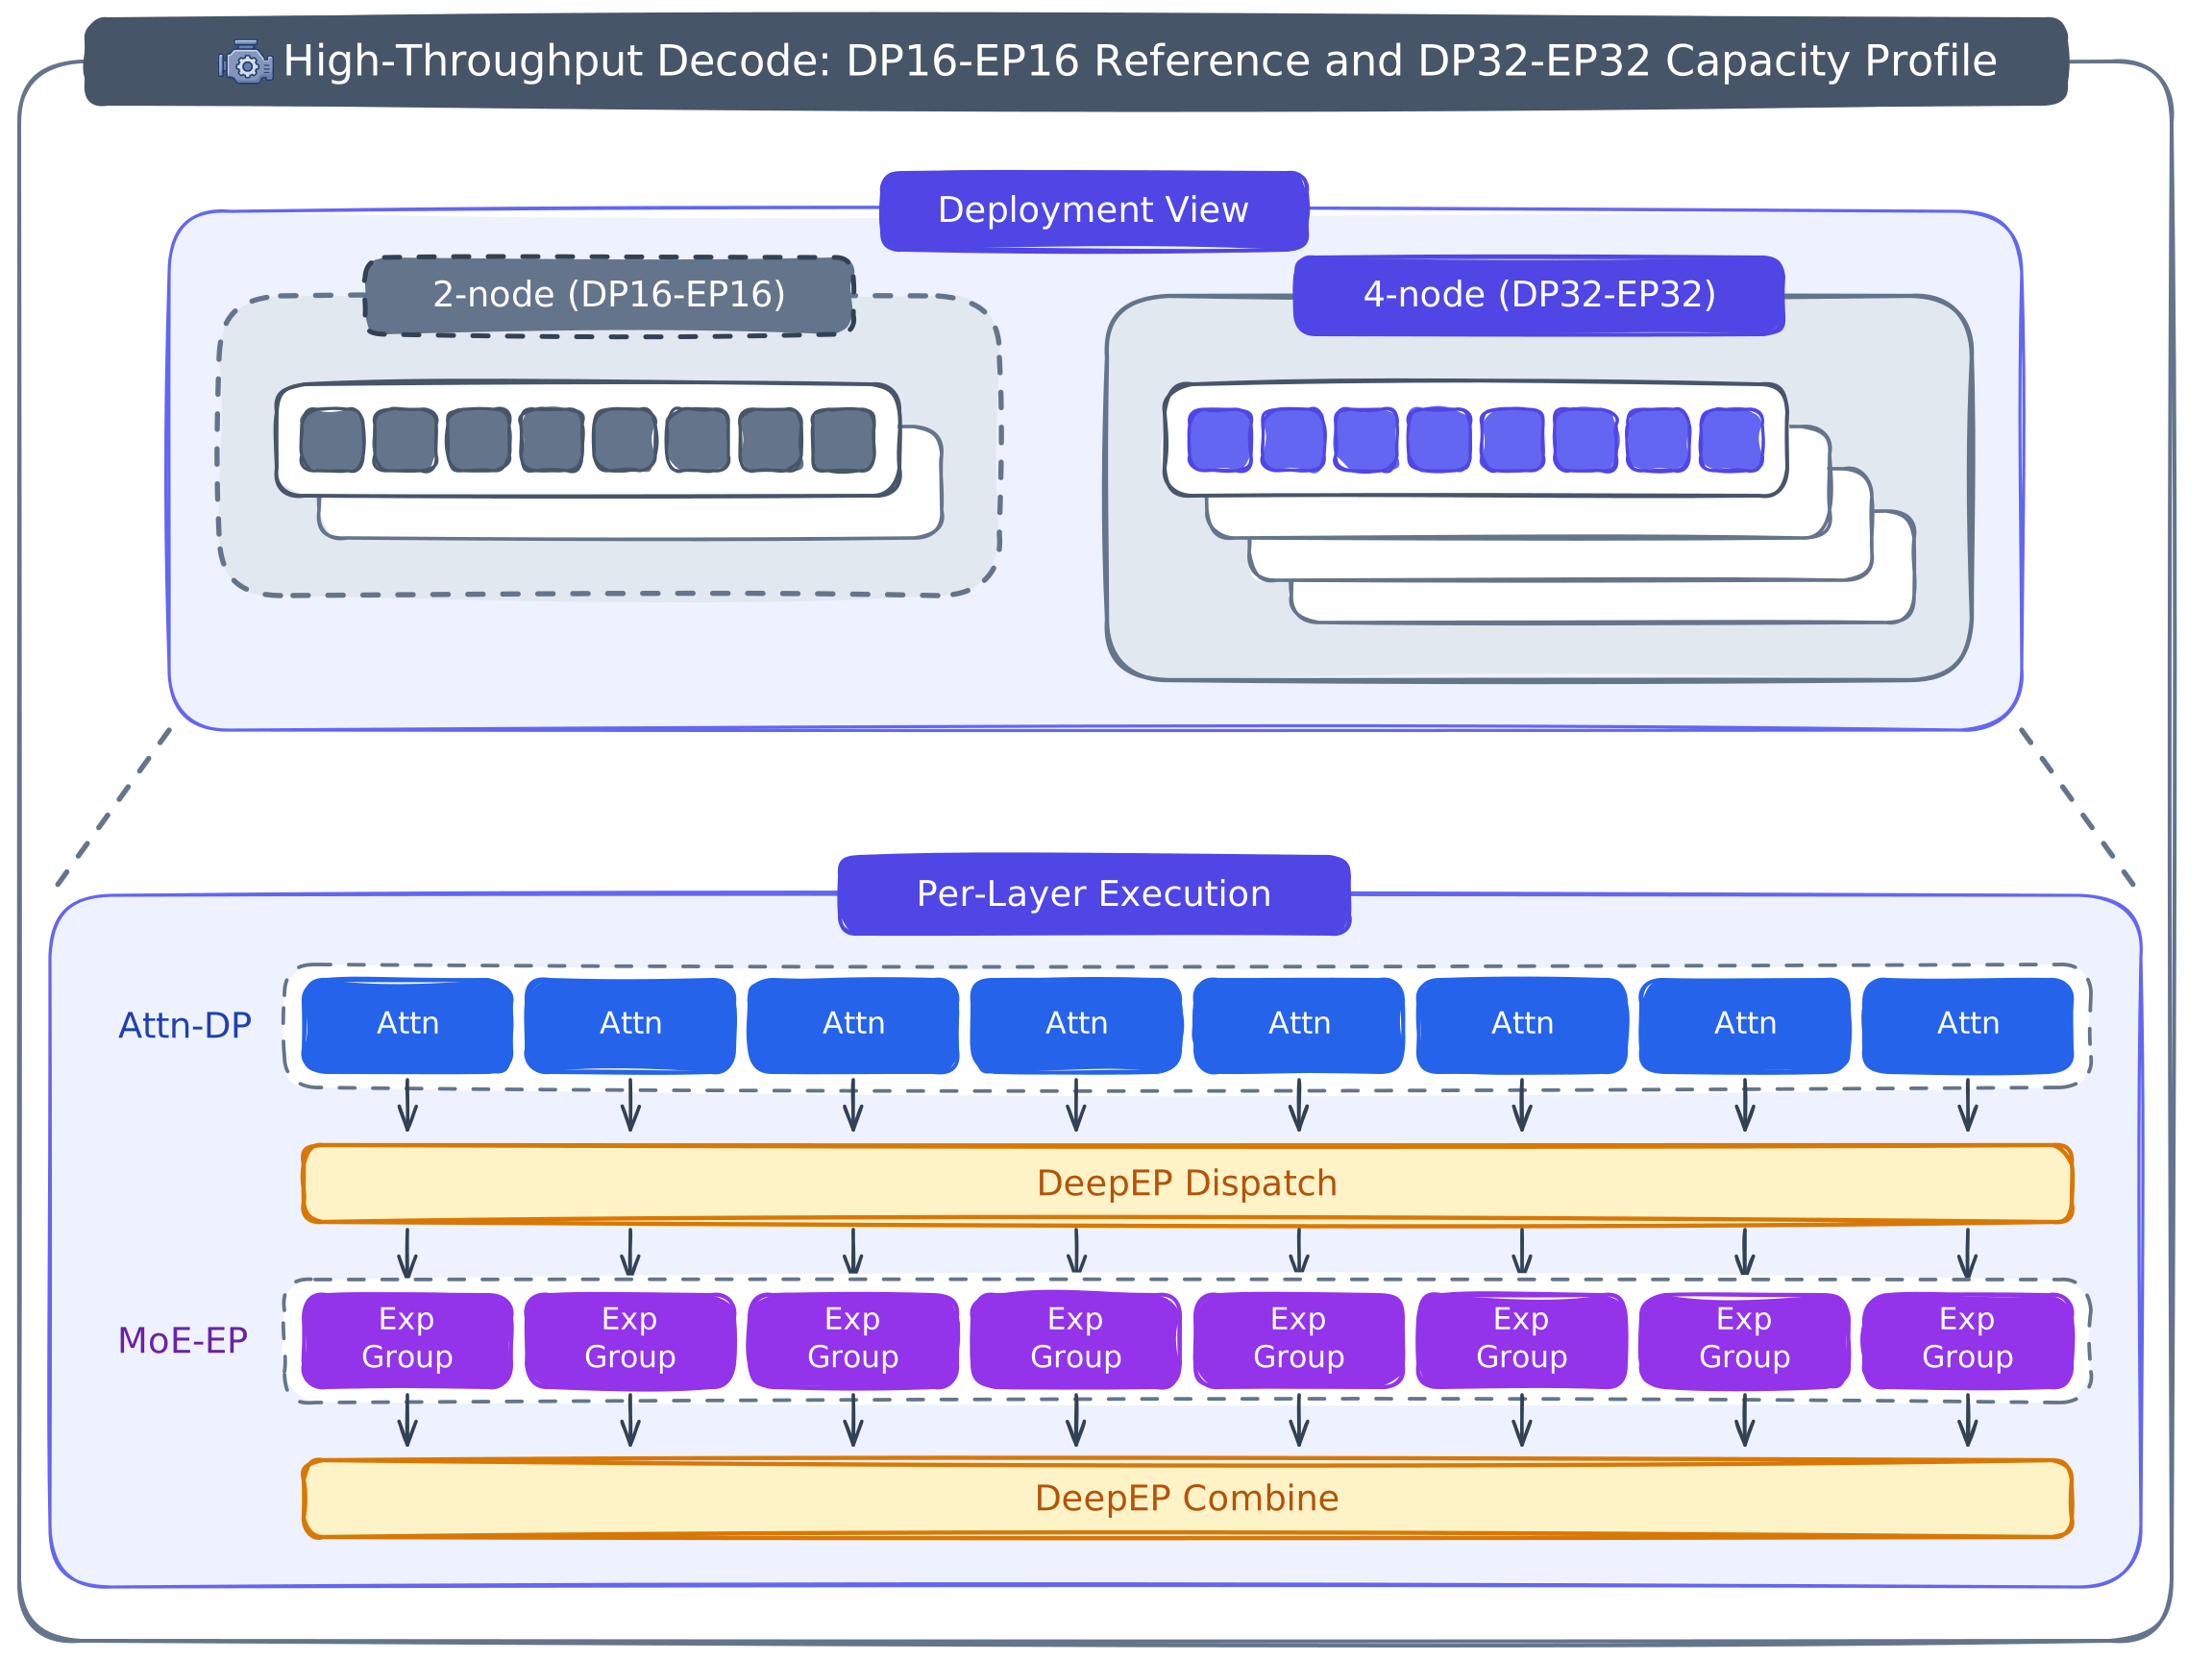
图 6:高吞吐解码——DP16-EP16 参考与 DP32-EP32 容量画像
Prefill:平衡算力与通信
Prefill 是一个系统问题:专家失衡(expert skew)、上下文并行通信与真实路由形状共同决定 TTFT,单点优化内核并不够。
为何用 MoE-TP 而非 MoE-EP
MoE-EP 只交换被路由的 token,但真实 prefill 流量存在显著的专家倾斜:拥有热门专家的 rank 计算更重而成为落后者(straggler),其余 rank 在 combine 步等待最慢路径。更低的通信量并不等于更低的 TTFT。先平衡算力,再最小化流量。 本研究中 PP2 与 PP4 均使用 MoE-TP:全序列 all-gather 与 reduce-scatter 通信量更大,但流量始终留在高带宽 NVLink 上、成本稳定可预测;所有 TP rank 对相同的路由 token 做张量并行计算,杜绝专家倾斜形成 rank 级长尾。实现见 sglang#24947。
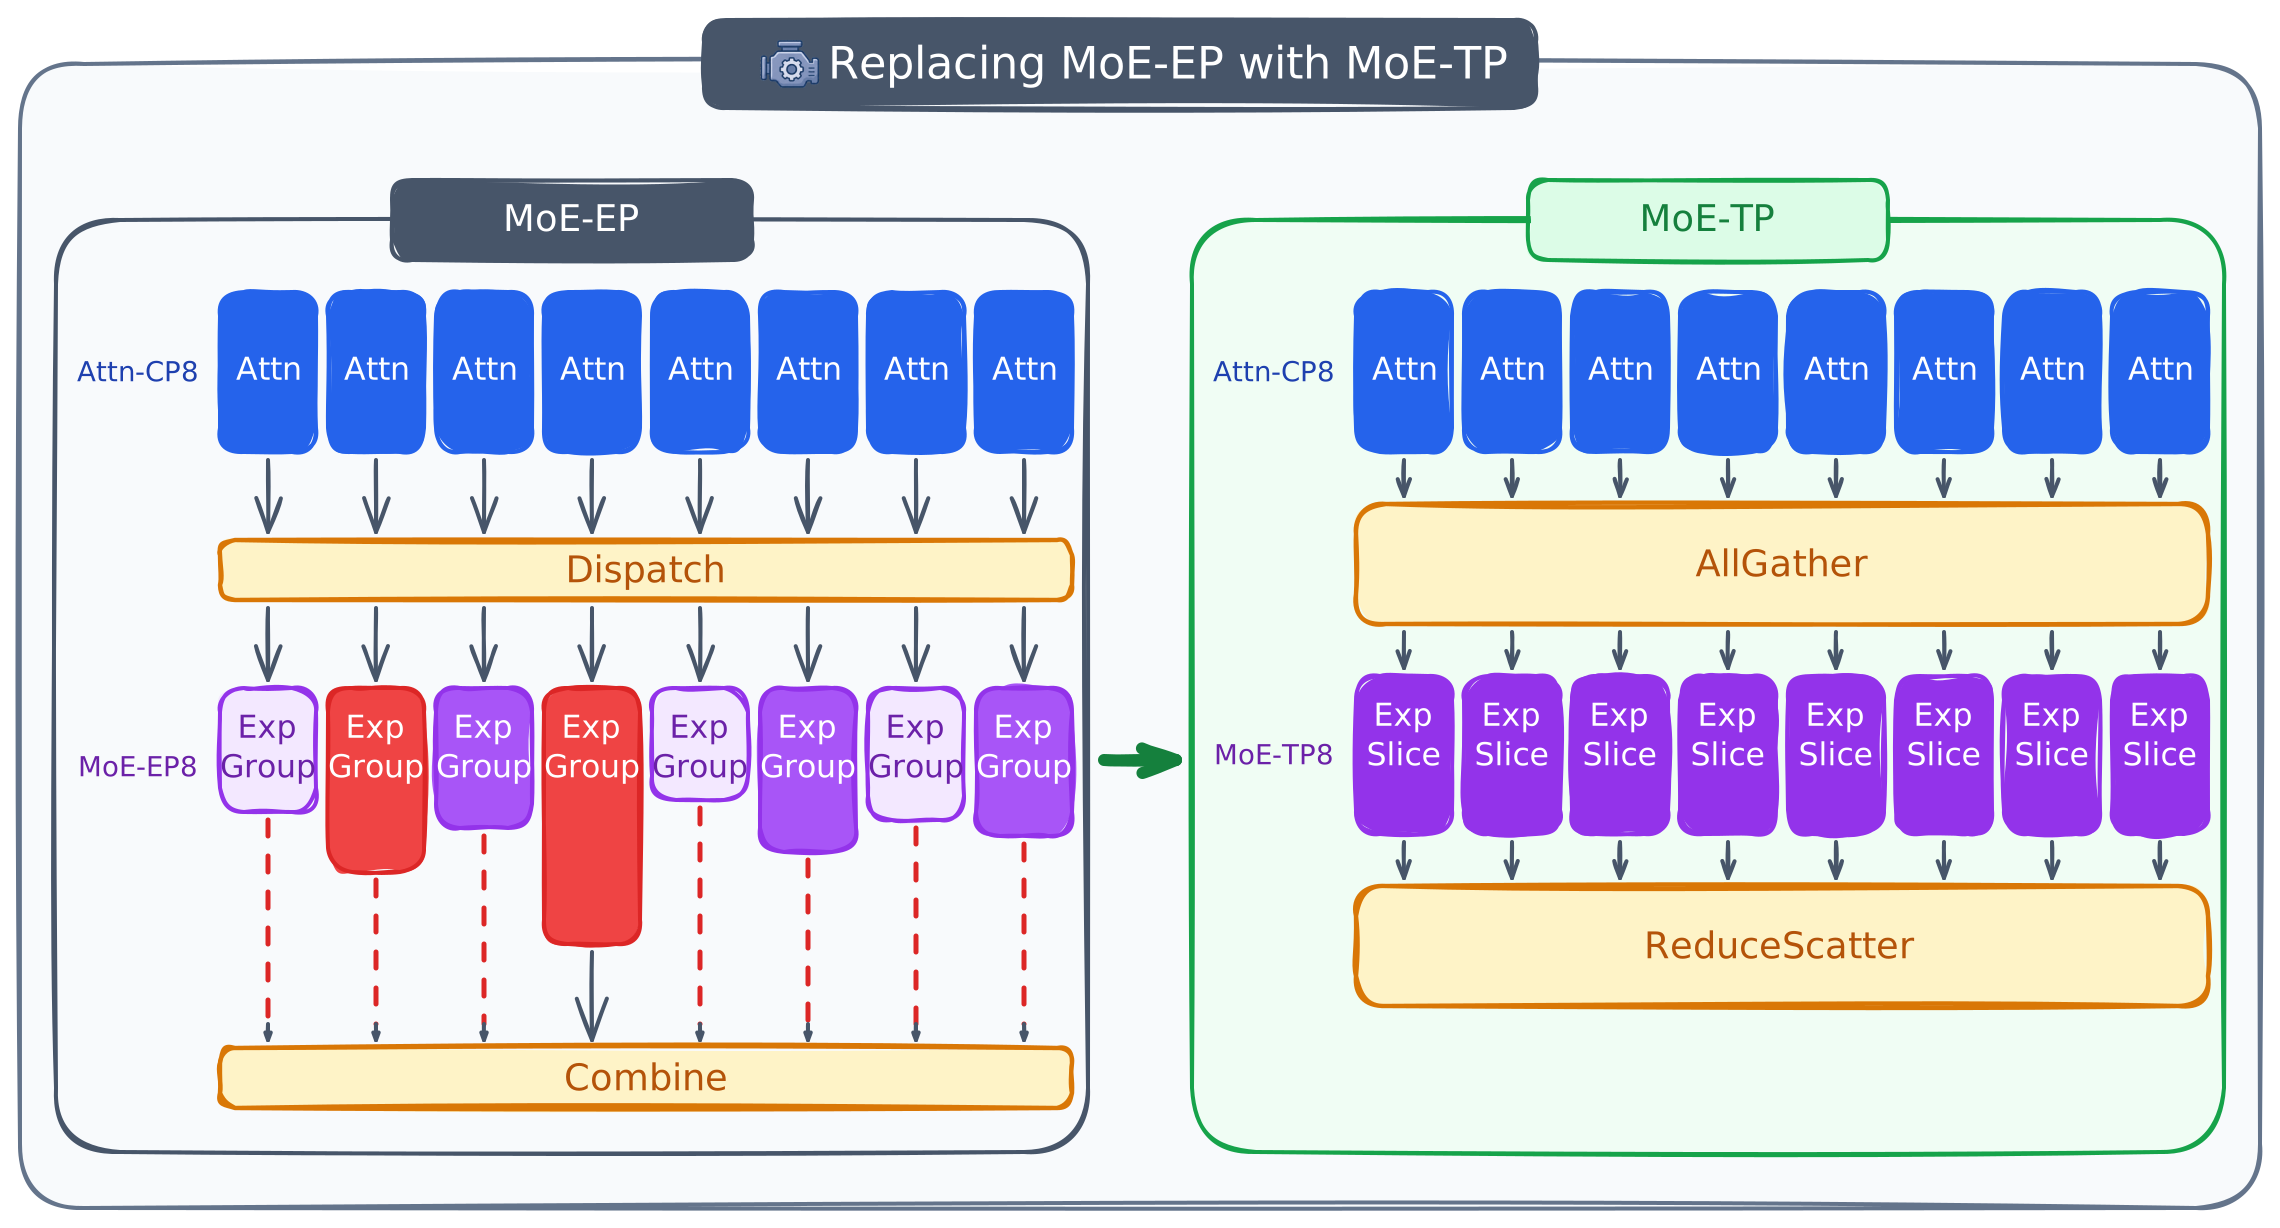
图 7:用 MoE-TP 替换 MoE-EP
加速并融合 Prefill 集体通信
MoE-TP 把不可预测的专家倾斜替换为可预测的集体通信,通信效率随之成为下一个瓶颈。先构建可复用的集体通信快速路径:让对称内存在 TP 与 CP 之间复用,使 AllReduce、AllGather、ReduceScatter 共享注册缓冲快速路径及适用的 Hopper 加速。上游工作涵盖内存池所有权、通信器注册、MoE-TP 集体缓冲,以及 CP Attention 与 KV 缓存缓冲路径。再缩短 Prefill 关键路径:针对 32K 单 chunk 场景,构建融合路径——用 copy-engine 驱动的 AllGather 与融合 FP8 量化及共享专家 GEMM 重叠,再在第二个 Triton kernel 中合并 TopK reduction、共享专家加法与 ReduceScatter。该方案把七个算子重组成三个执行组,在匹配的 PP4 A/B 中令 TTFT 下降约 3.5%。
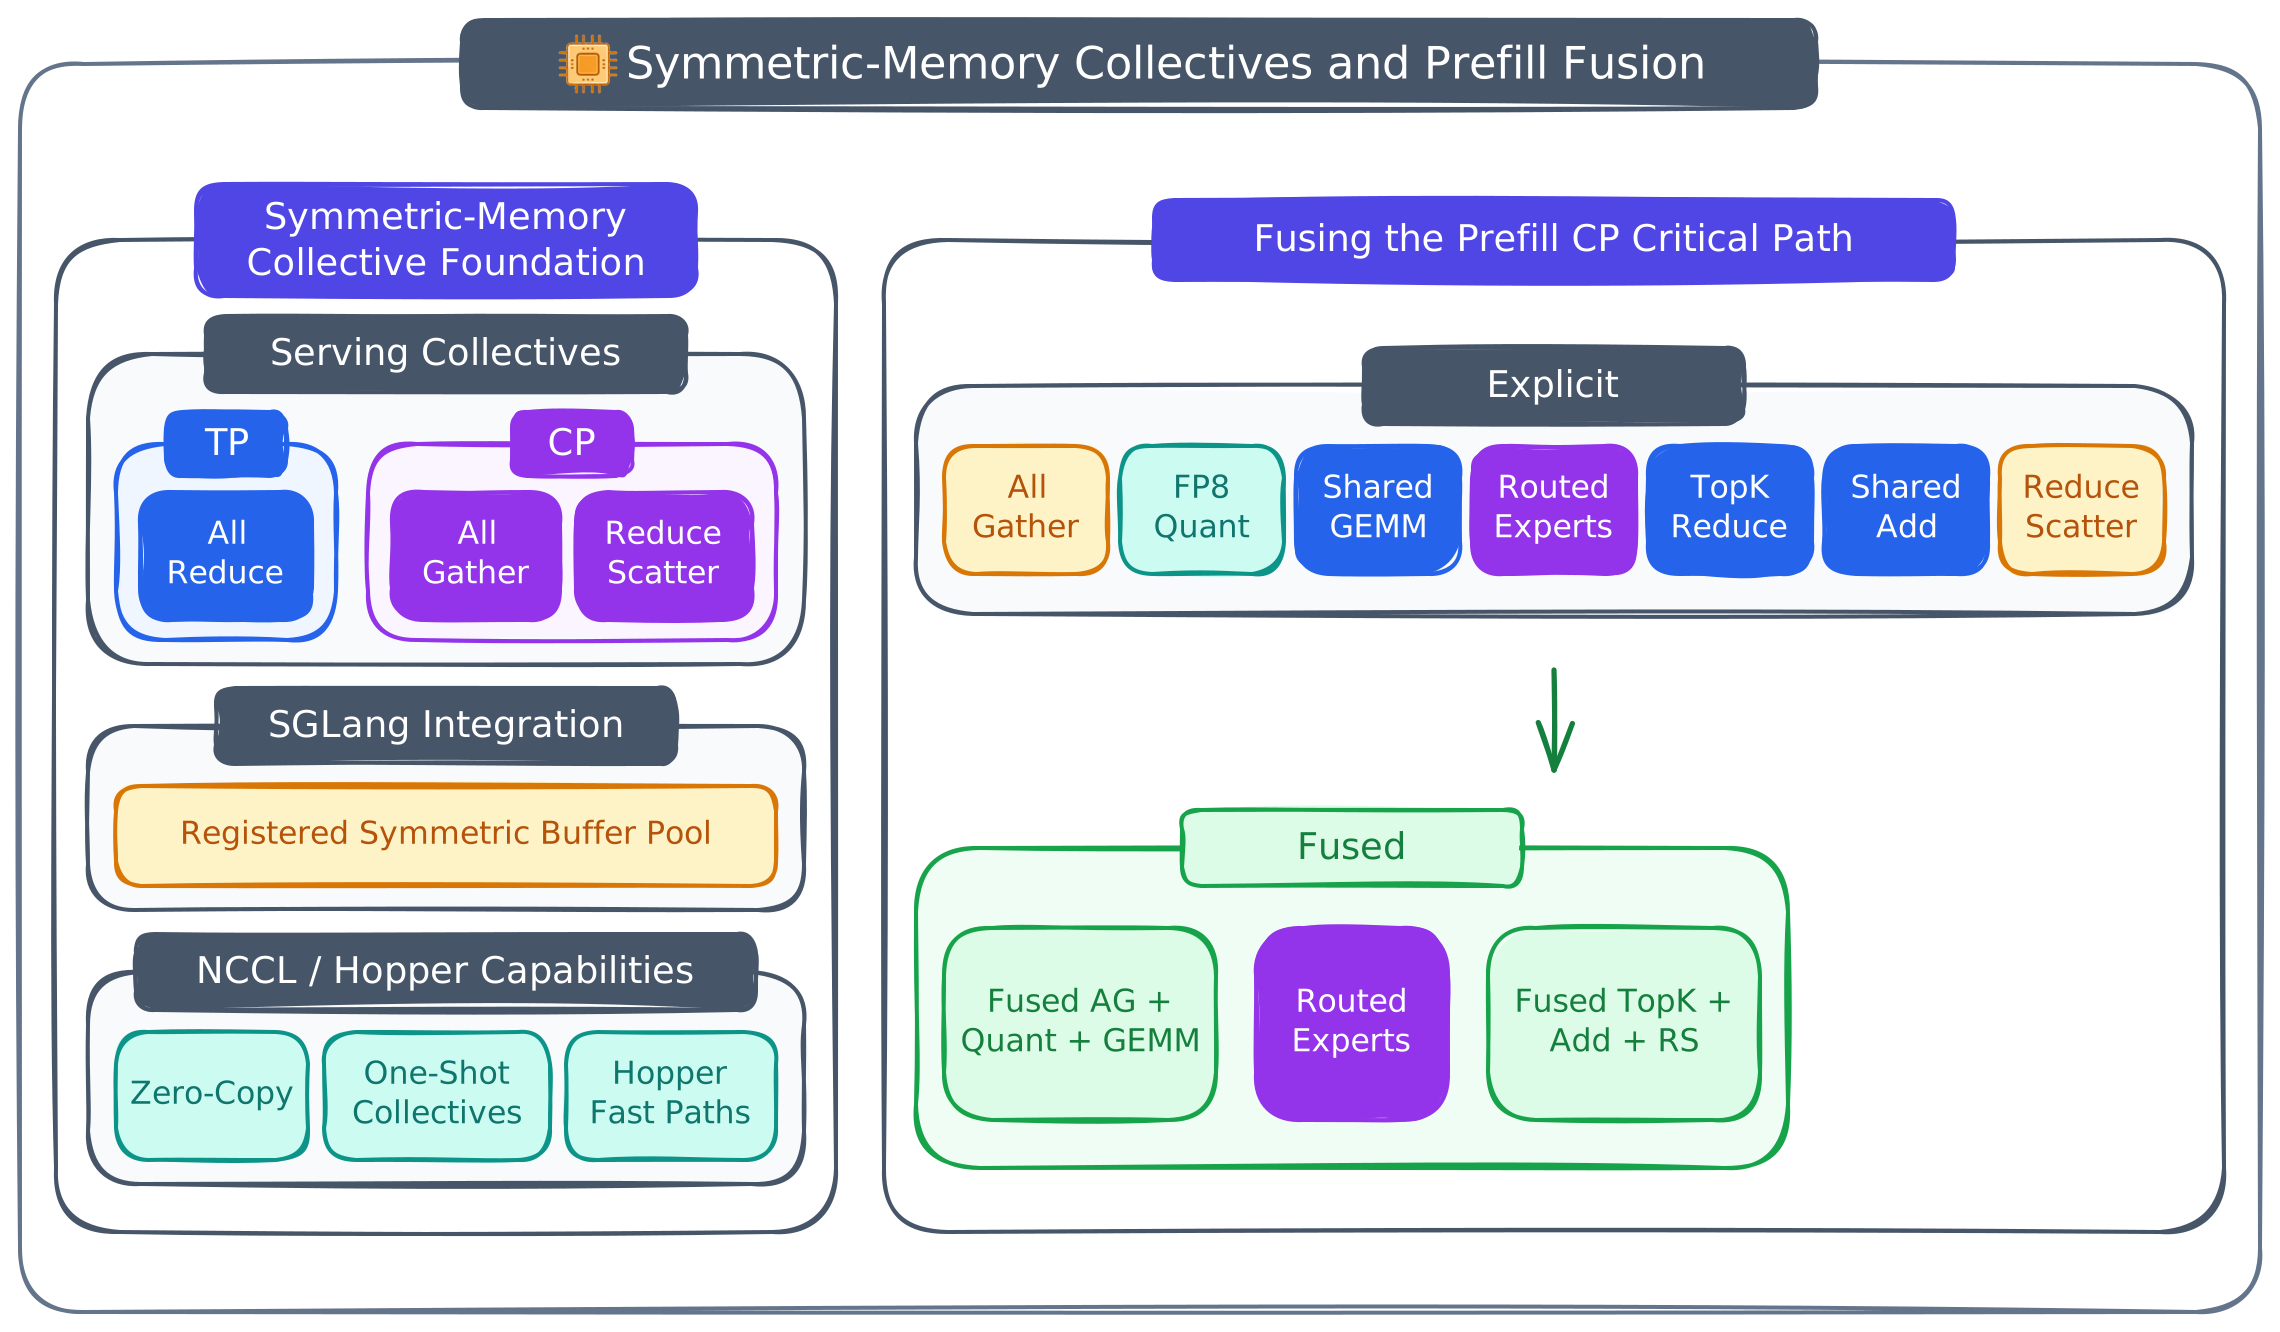
图 8:对称内存集体通信与 Prefill 融合
为真实路由形状调优 Humming
通用调优无法命中真正重要的形状。Prefill 路由把 token 不均匀地分布到 384 个专家,有效 M 维聚集到一小组离散值;W13 与 W2 又作用于不同形状,单一的通用启发式无法同时优化两条路径。作者从真实路由直方图中提取高频形状,为 W13 与 W2 分别构建精确形状(exact-shape)配置,并在 kernel、流水线阶段与匹配 A/B 三个层面验证。目标不是合成的 M 区间,而是实际服务的路由分布。在 32K 的匹配 PP4 A/B 中,所选 MoE kernel 延迟下降约 21%,换算为端到端 TTFT 降低 11.35%。
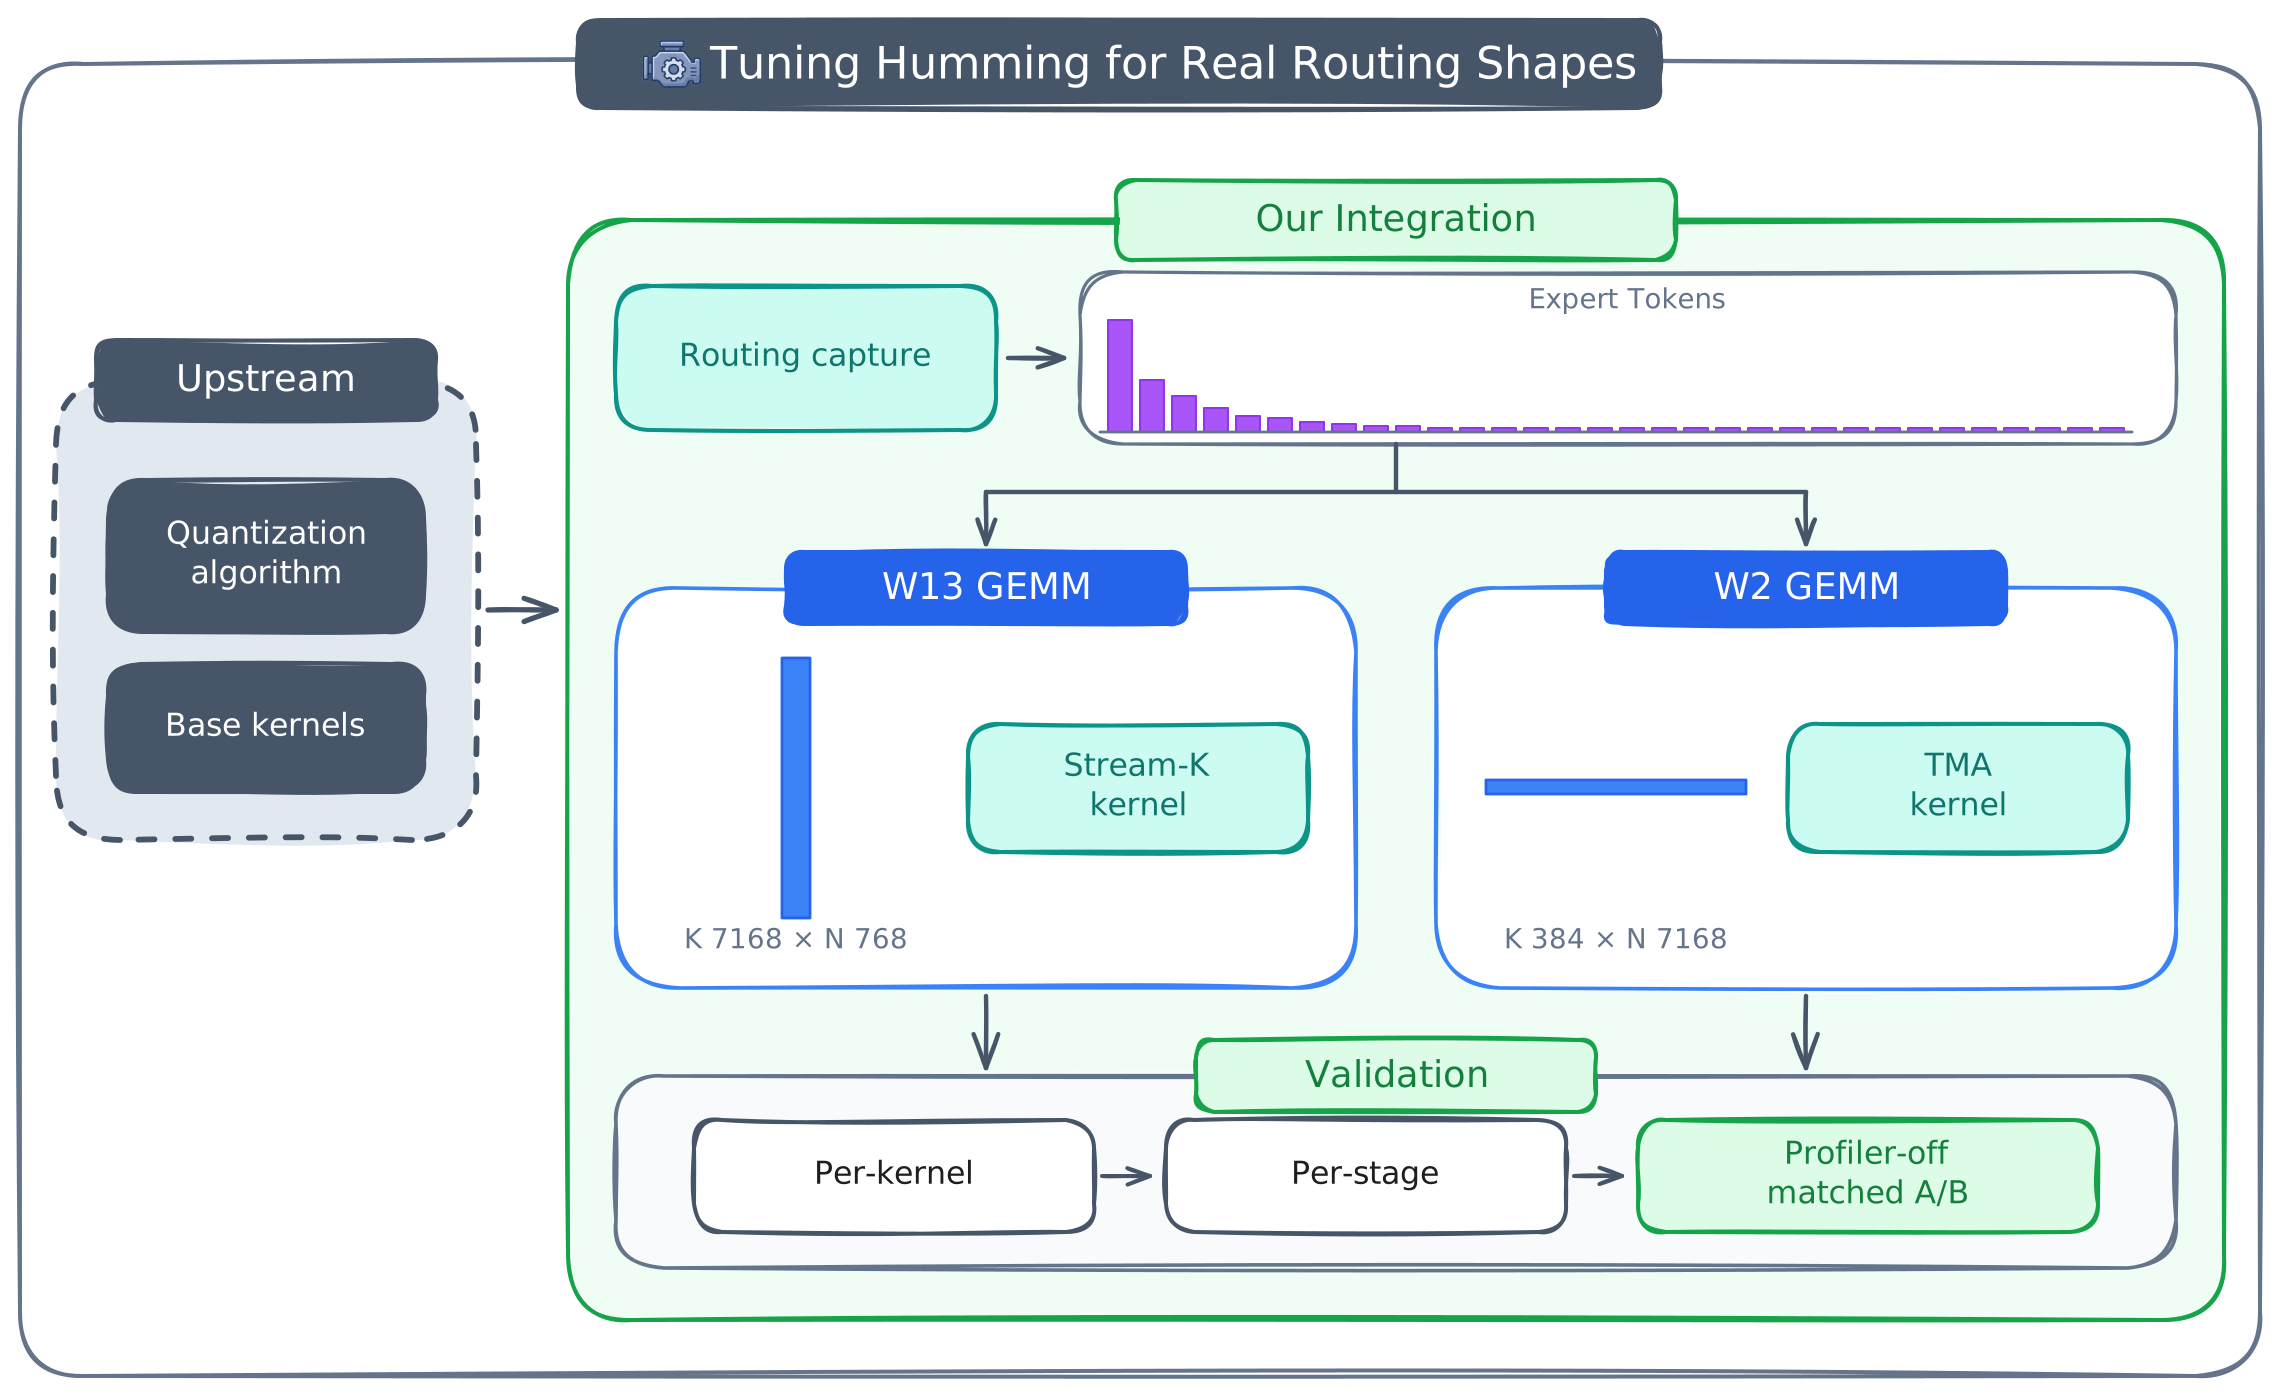
图 9:为真实路由形状调优 Humming
Decode:优化投机采样与 MoE 执行
在作者的实现中,Decode 优化是按画像量身定制的:PP2-TP8 需要跨投机流水线阶段协调,DP32-EP32 则聚焦高并发下的精炼(refinement)步骤与专家路由优化;Humming 的融合与重叠则优化这些拓扑底层的共享 MoE 热点路径。
低延迟 PP2-TP8:把 DSpark 扩展到流水线阶段
流水线并行拆散了投机循环。在 PP2-TP8 中,目标模型执行跨两个流水线阶段,而 DSpark drafter 只驻留在最后阶段:Stage 0 把目标隐藏状态发给 Stage 1,由 Stage 1 完成验证、接受 token 并为下一轮生成候选。每一轮投机都跨越流水线边界。作者用单一执行协议协调两个阶段及所需的中间传输,既防止阶段进入不同轮次,又避免冗余同步。PP 专属的 DSpark 集成正在向上游提交(sglang#32281)。
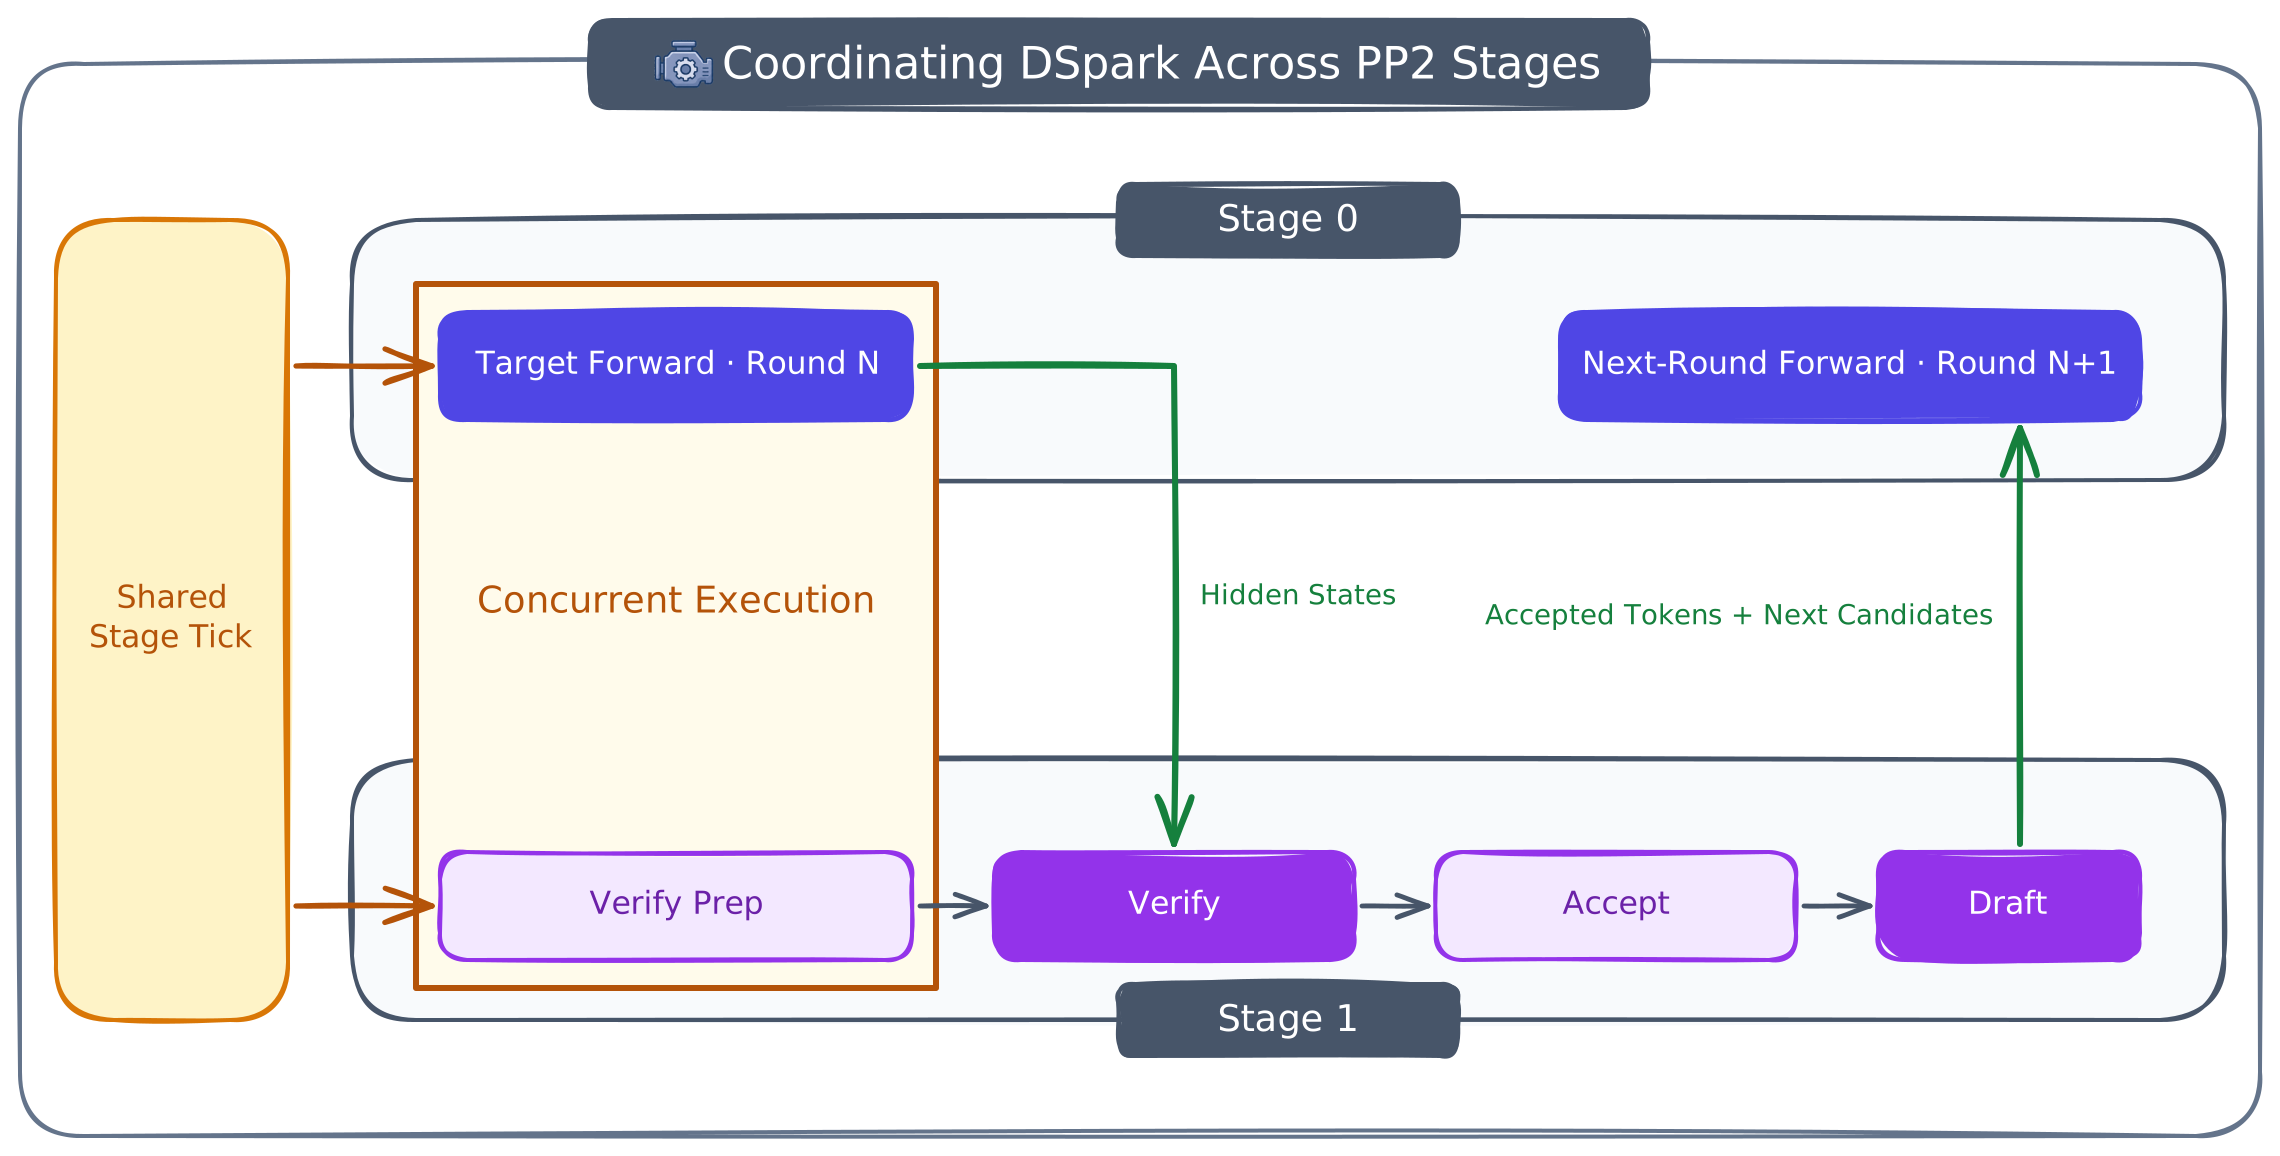
图 10:跨 PP2 阶段协调 DSpark
高吞吐 DP32-EP32:移除高并发瓶颈
本节匹配 A/B 结果使用 4K 长度、每个 DP rank 32 个并发请求。为精炼步骤选择正确的执行形状:refinement 用全词表投影对 DSpark 候选集合重新打分。高并发下,逐行 dot-reduce 为每个活跃行反复读取词表权重,在每个解码步制造持续尾延迟。作者把活跃行合并成一次转置 GEMM,减少冗余内存流量、缩短精炼路径,单 GPU 吞吐提升 22.8%。基于实测路由放置专家:DSpark 流量同样存在显著专家倾斜,作者记录代表性请求的路由亲和性,用于配置专家并行负载均衡(EPLB)与冗余专家,防止少数热门专家反复拉长关键路径,单 GPU 吞吐再提升 13.5%。
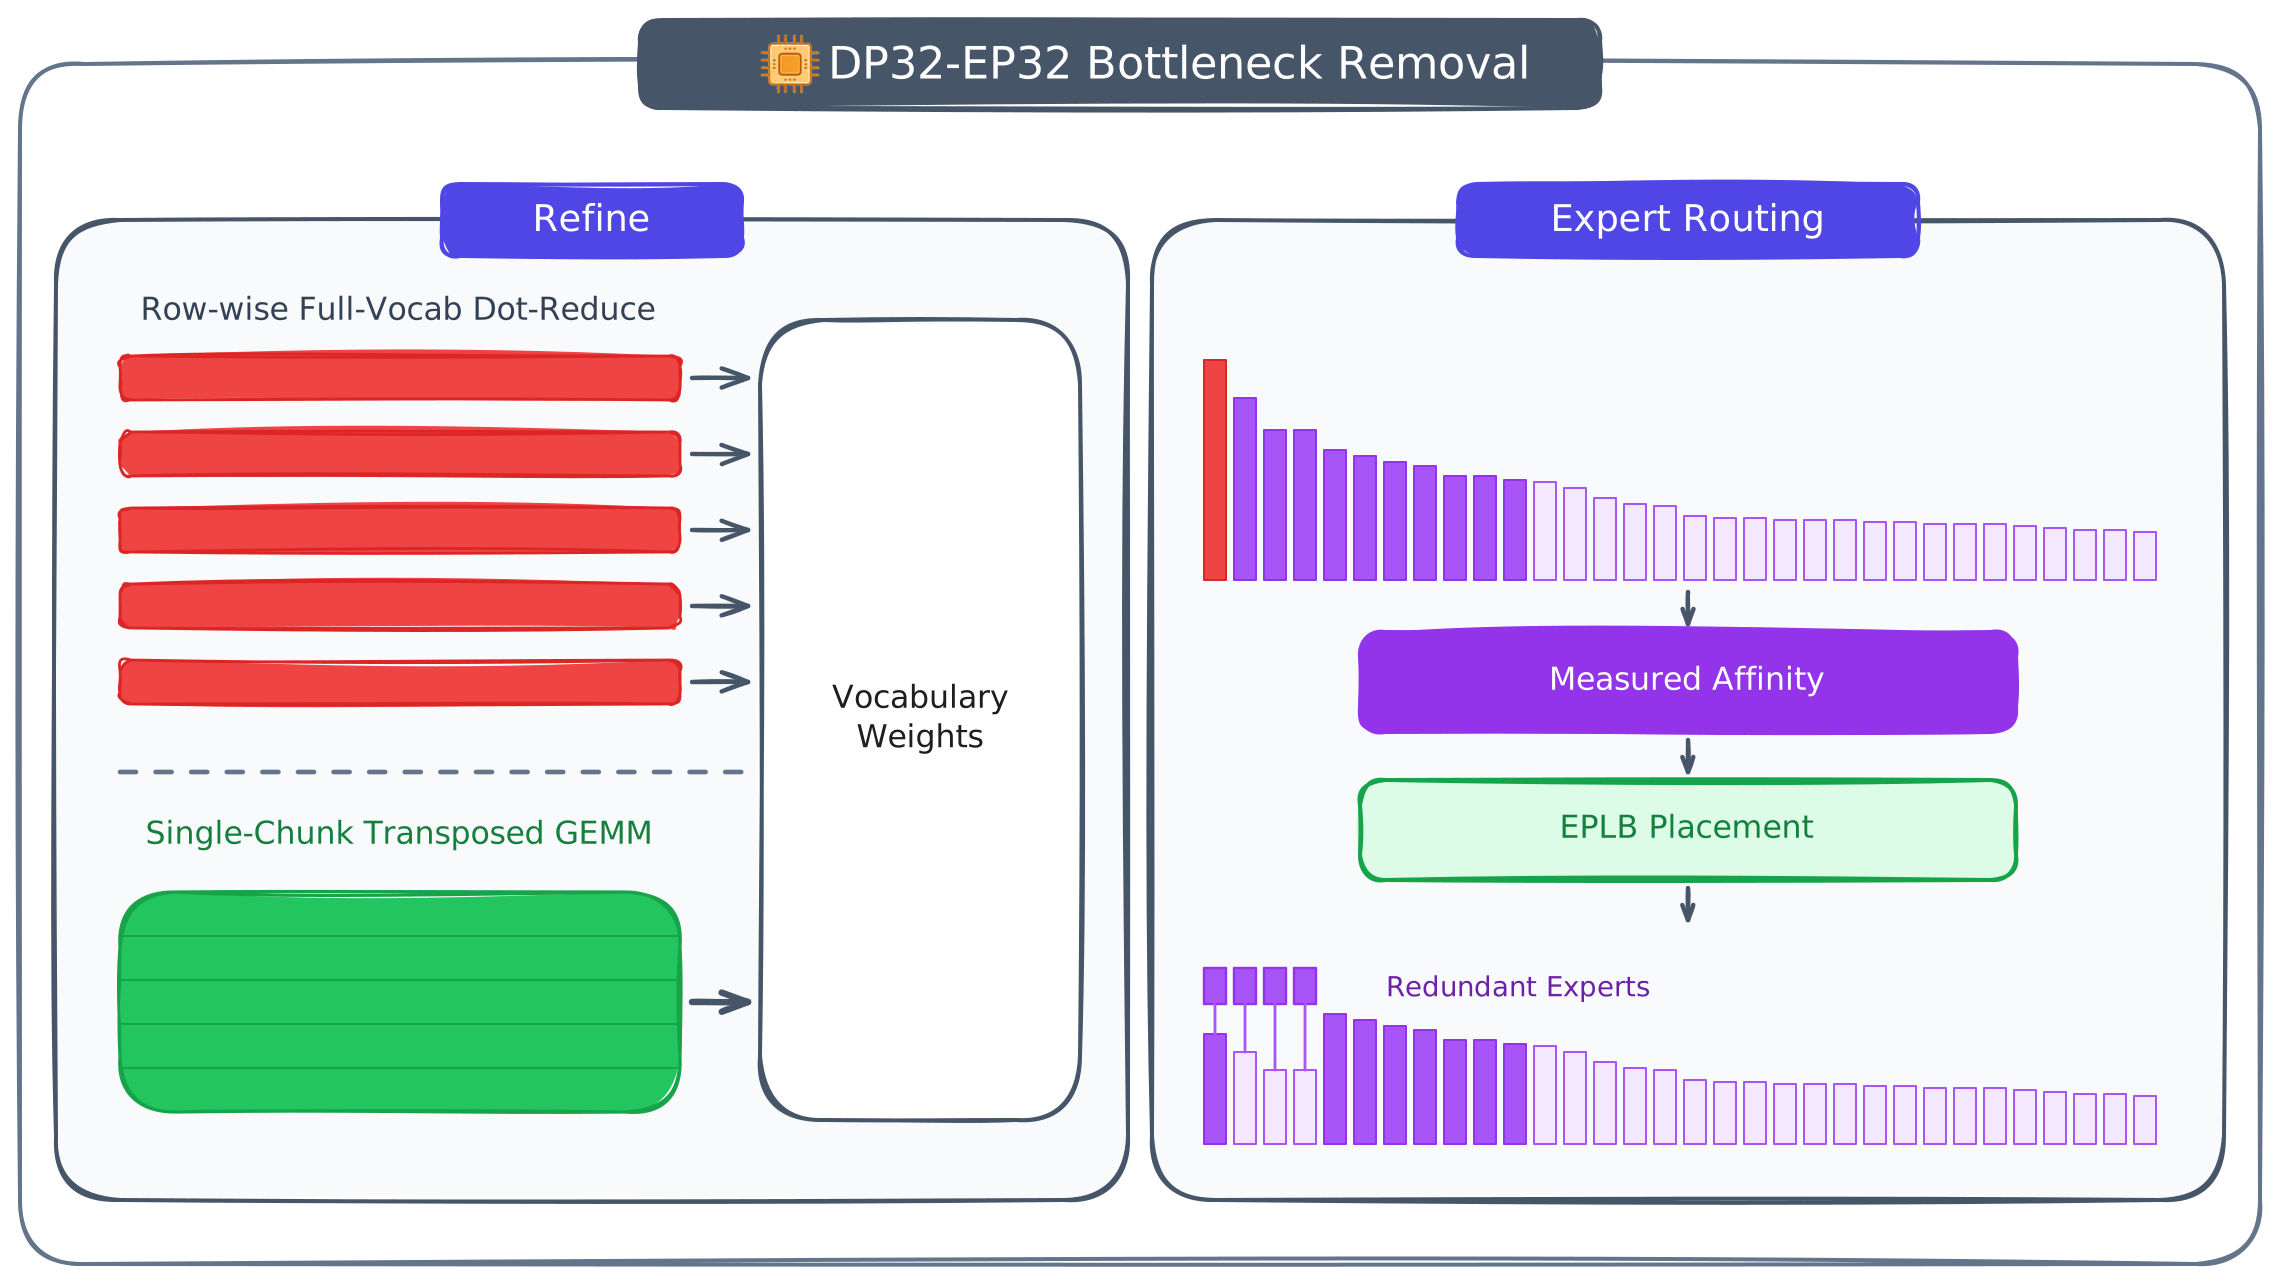
图 11:DP32-EP32 瓶颈移除
Humming 解码热点路径:融合与重叠
这些优化位于服务拓扑之下,可被基于 Humming 的解码画像复用(匹配结果同样用 4K/32 并发)。移除多余量化通道:把 SwiGLU 激活与量化融合,让融合 kernel 直接产出 W2 所需的数据与 scale,消除对中间缓冲的重复访问、省掉独立量化过程,使 W2 更早开始,在匹配 DSpark A/B 中单 GPU 吞吐提升 44.0%。让通信与 W2 重叠:作者把此前工作(sglang#9660)中的 Single-Batch Overlap(SBO)机制改造成 Humming-Aware SBO,按 tile 信号让 DeepEP 在某个 W2 输出 tile 完成后立即开始对应 combine 发送,无需等待整个 GEMM 结束;在相同工作点的早期匹配非投机 A/B 中,SBO 相对 FP8 传输层恢复 4.12% 吞吐。
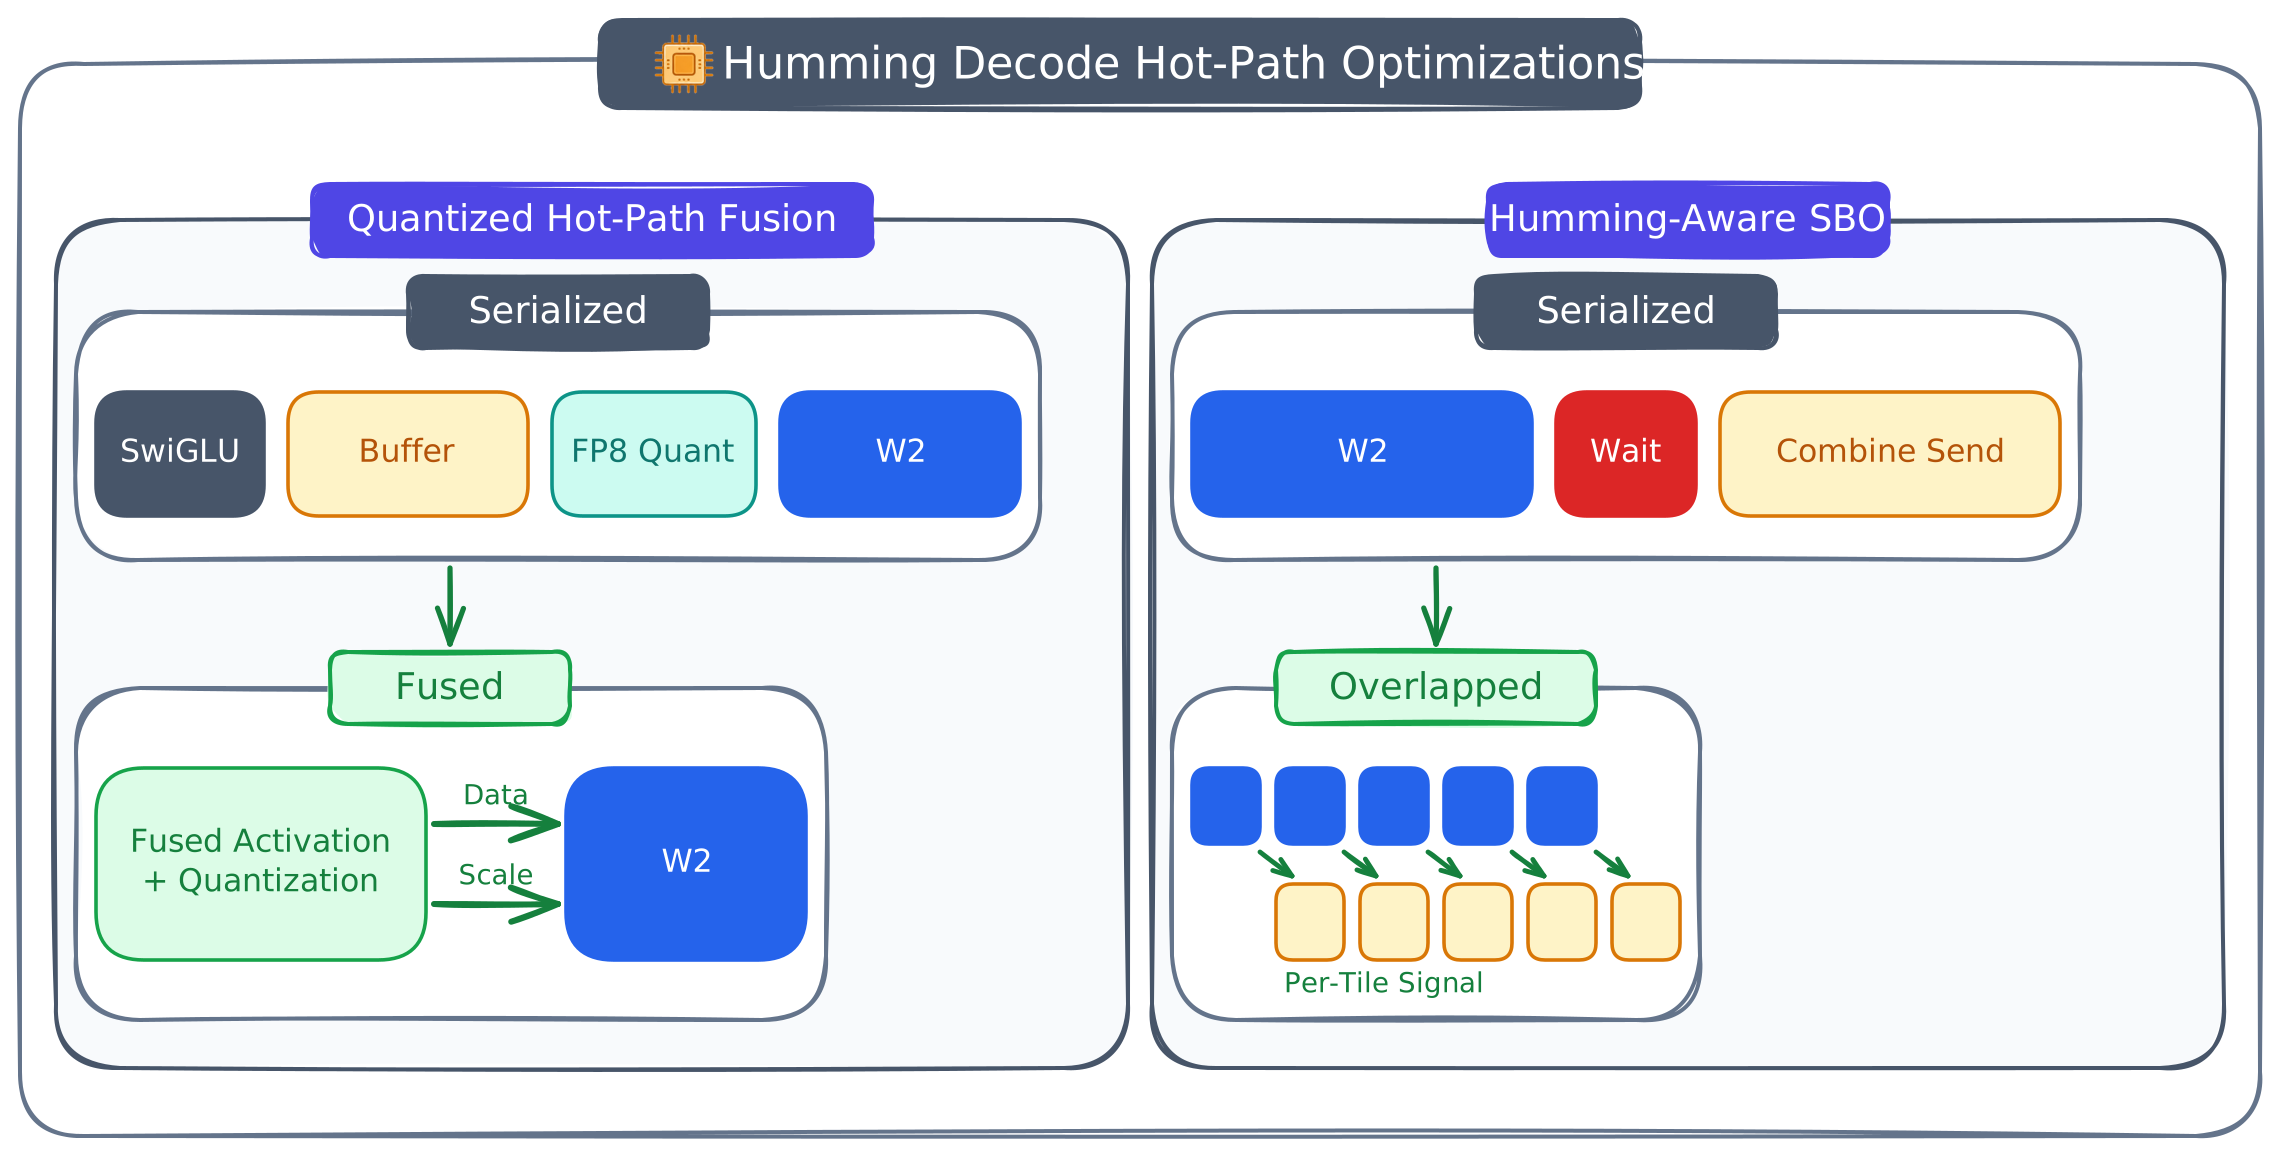
图 12:Humming 解码热点路径优化
评测:系统增益与画像权衡
Prefill:累进增益与上下文长度权衡
PP2 强化短上下文画像。 PP2 在全部九个输入长度上都有提升,几何平均吞吐增益 36.5%、峰值总输入吞吐 16,900 tokens/s。更浅的流水线降低短请求的 fill-and-drain 开销,让 PP2 用更少资源维持更低 TTFT。PP4 把增益带入长上下文。 相同九个点上 PP4 几何平均增益 31.8%;随上下文增长,更深流水线有足够工作摊薄固定成本:总输入吞吐在 512K 达 25,860 tokens/s、1M 仍保持 23,970 tokens/s。
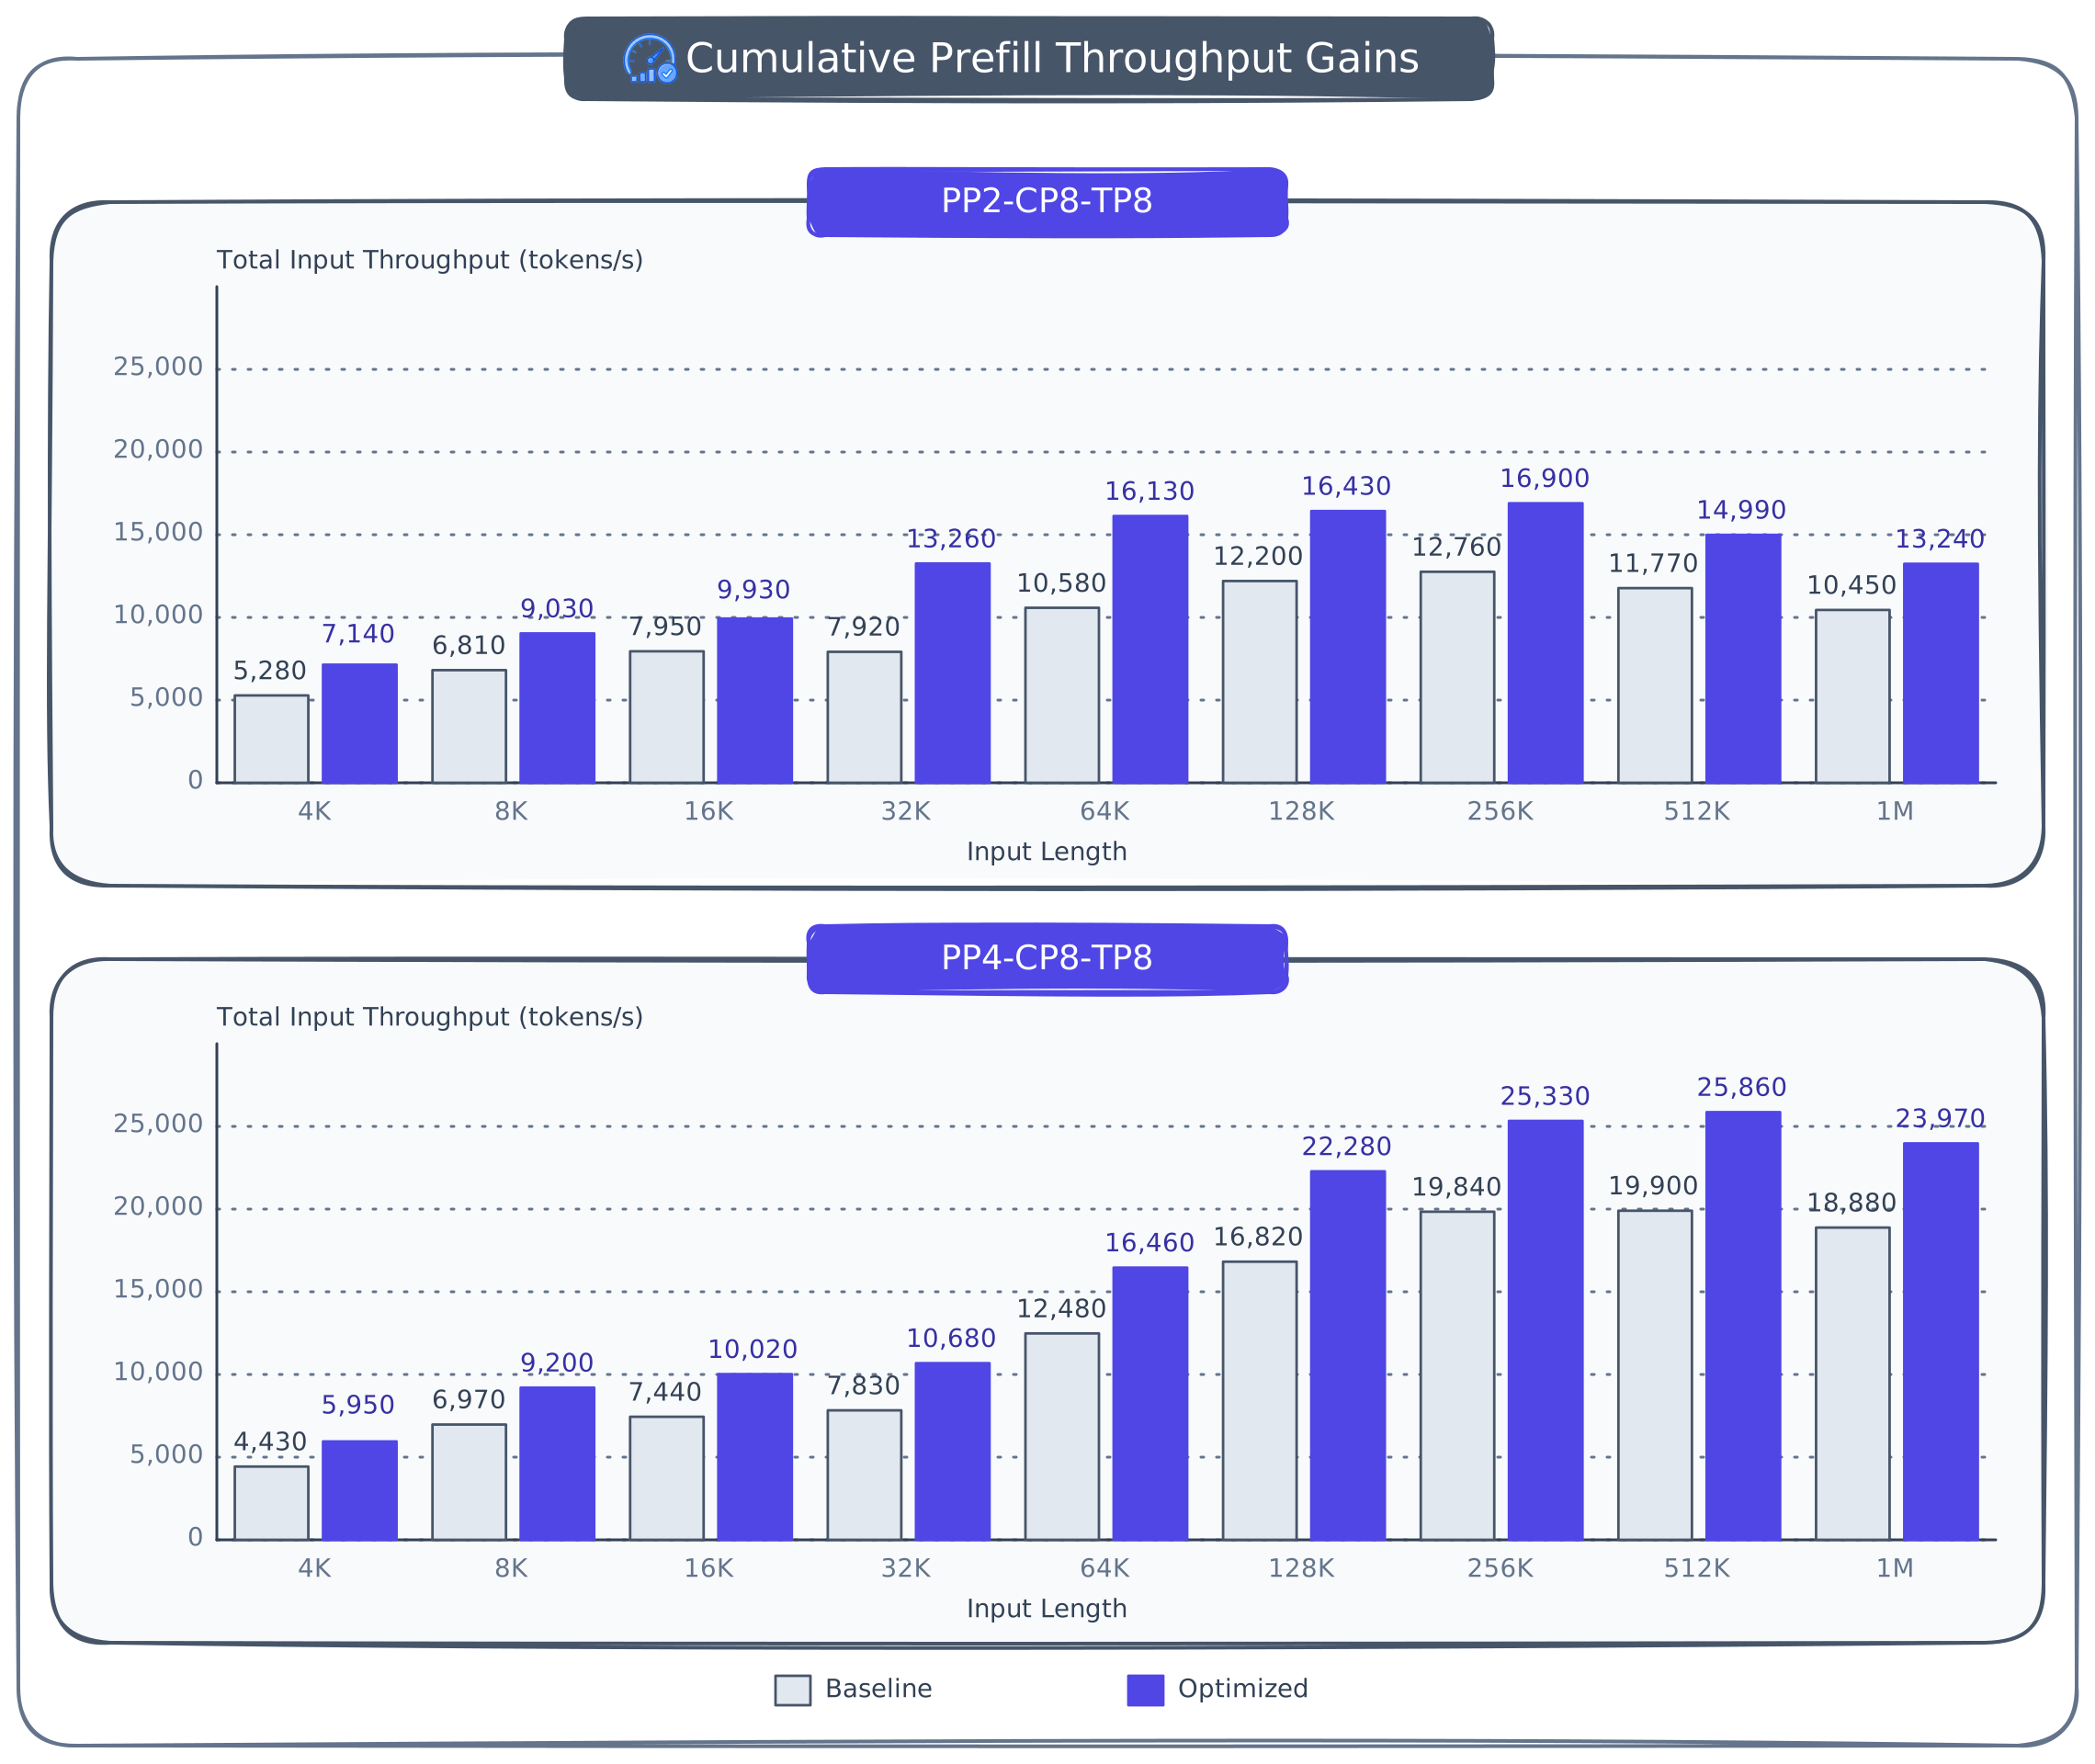
图 13:Prefill 累计吞吐增益
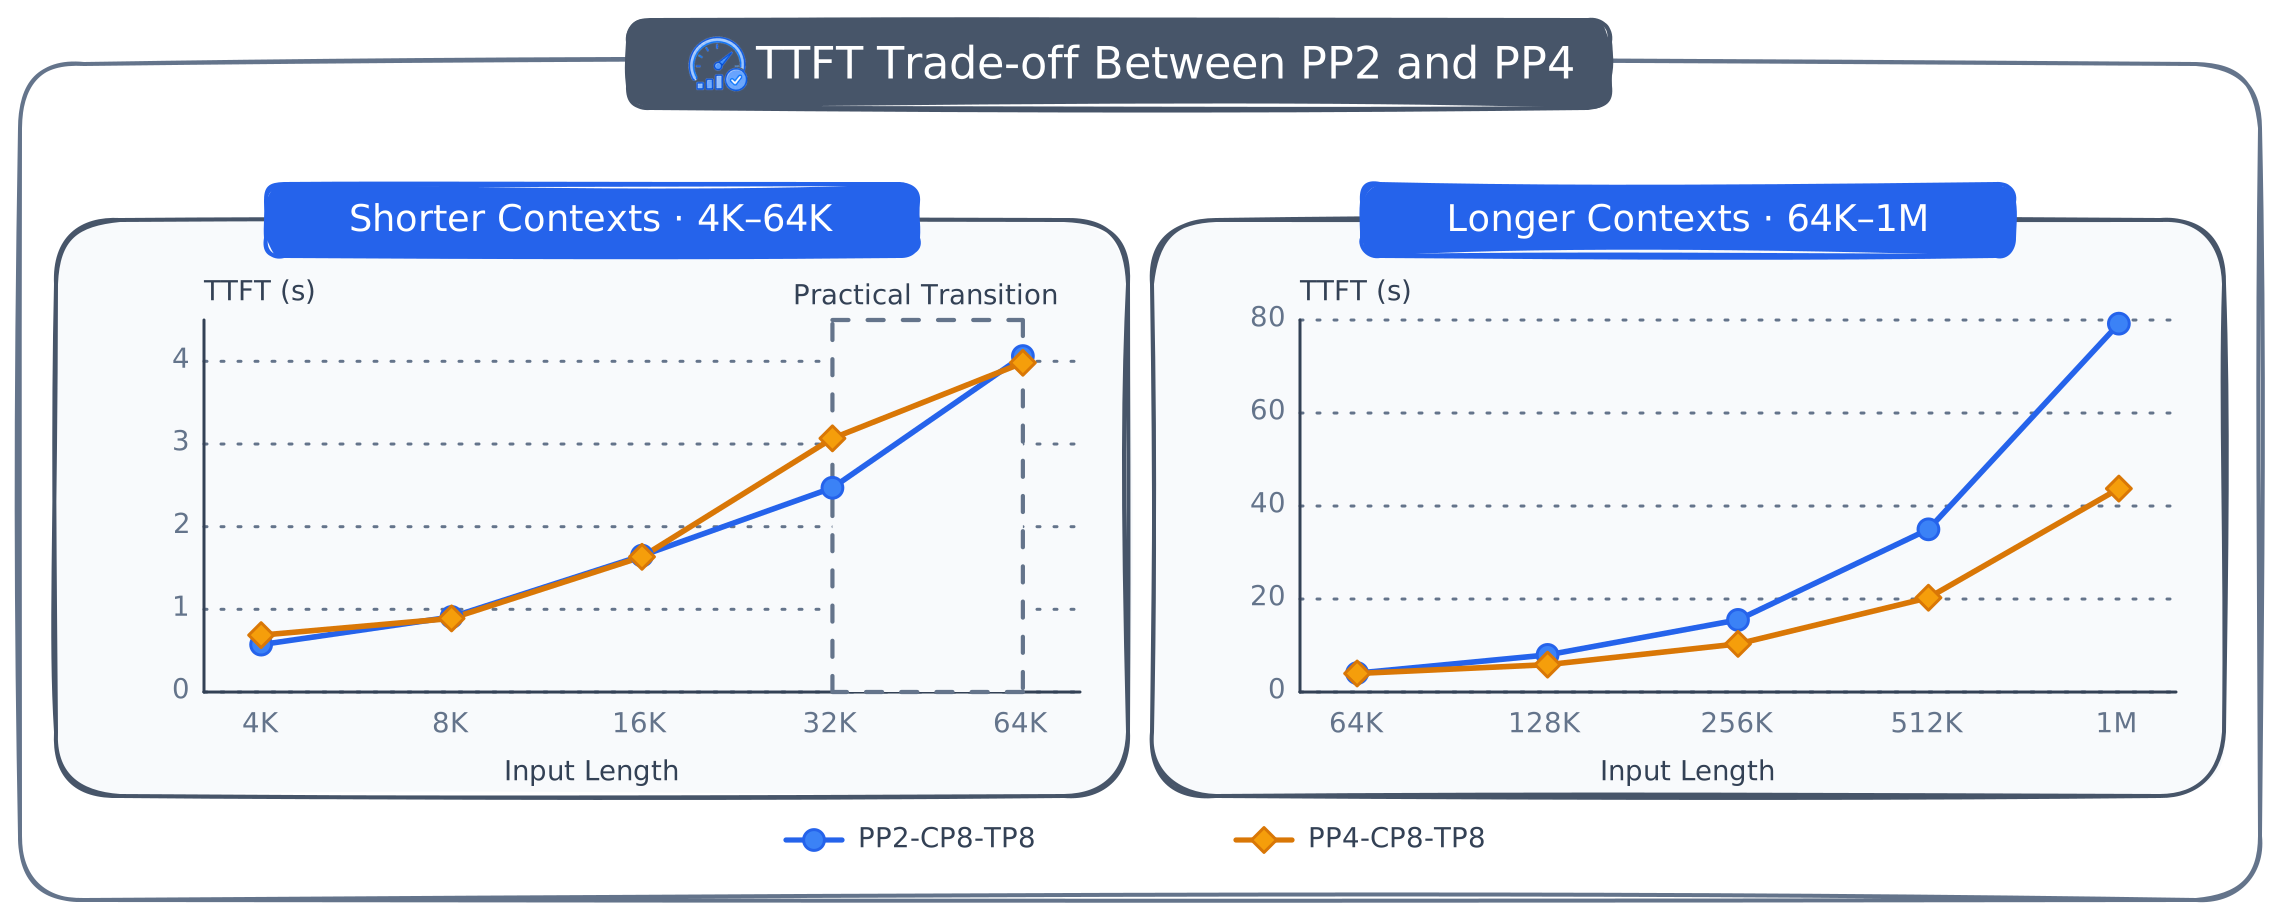
图 14:PP2 与 PP4 的 TTFT 权衡
上下文长度会改变 PP2/PP4 的权衡。相对 PP4,PP2 在 4K 与 32K 分别降低 16.7%、19.5% 的 TTFT;两者在 8K、16K、64K 差距在 2% 以内;从 128K 起 PP4 建立决定性优势,相较 PP2 在 128K/256K/512K/1M 依次降低 26.2% / 33.3% / 42.1% / 44.8%。因此作者把路由边界视作由实测上下文长度区间导出的运行策略,而非普适的交叉点。
低延迟解码:性能与容量权衡
优化后的 DSpark 重置了延迟基线。在图 15 所示的四个输入长度下,batch size 为 1 时优化 DSpark 把峰值 TPOT 降低 74.8%–78.0%;在每组测量共享的最大 batch 处,降幅仍有 52.2%–60.0%。增益从 8K 贯穿到 1M,而非只局限在短上下文或单请求执行。
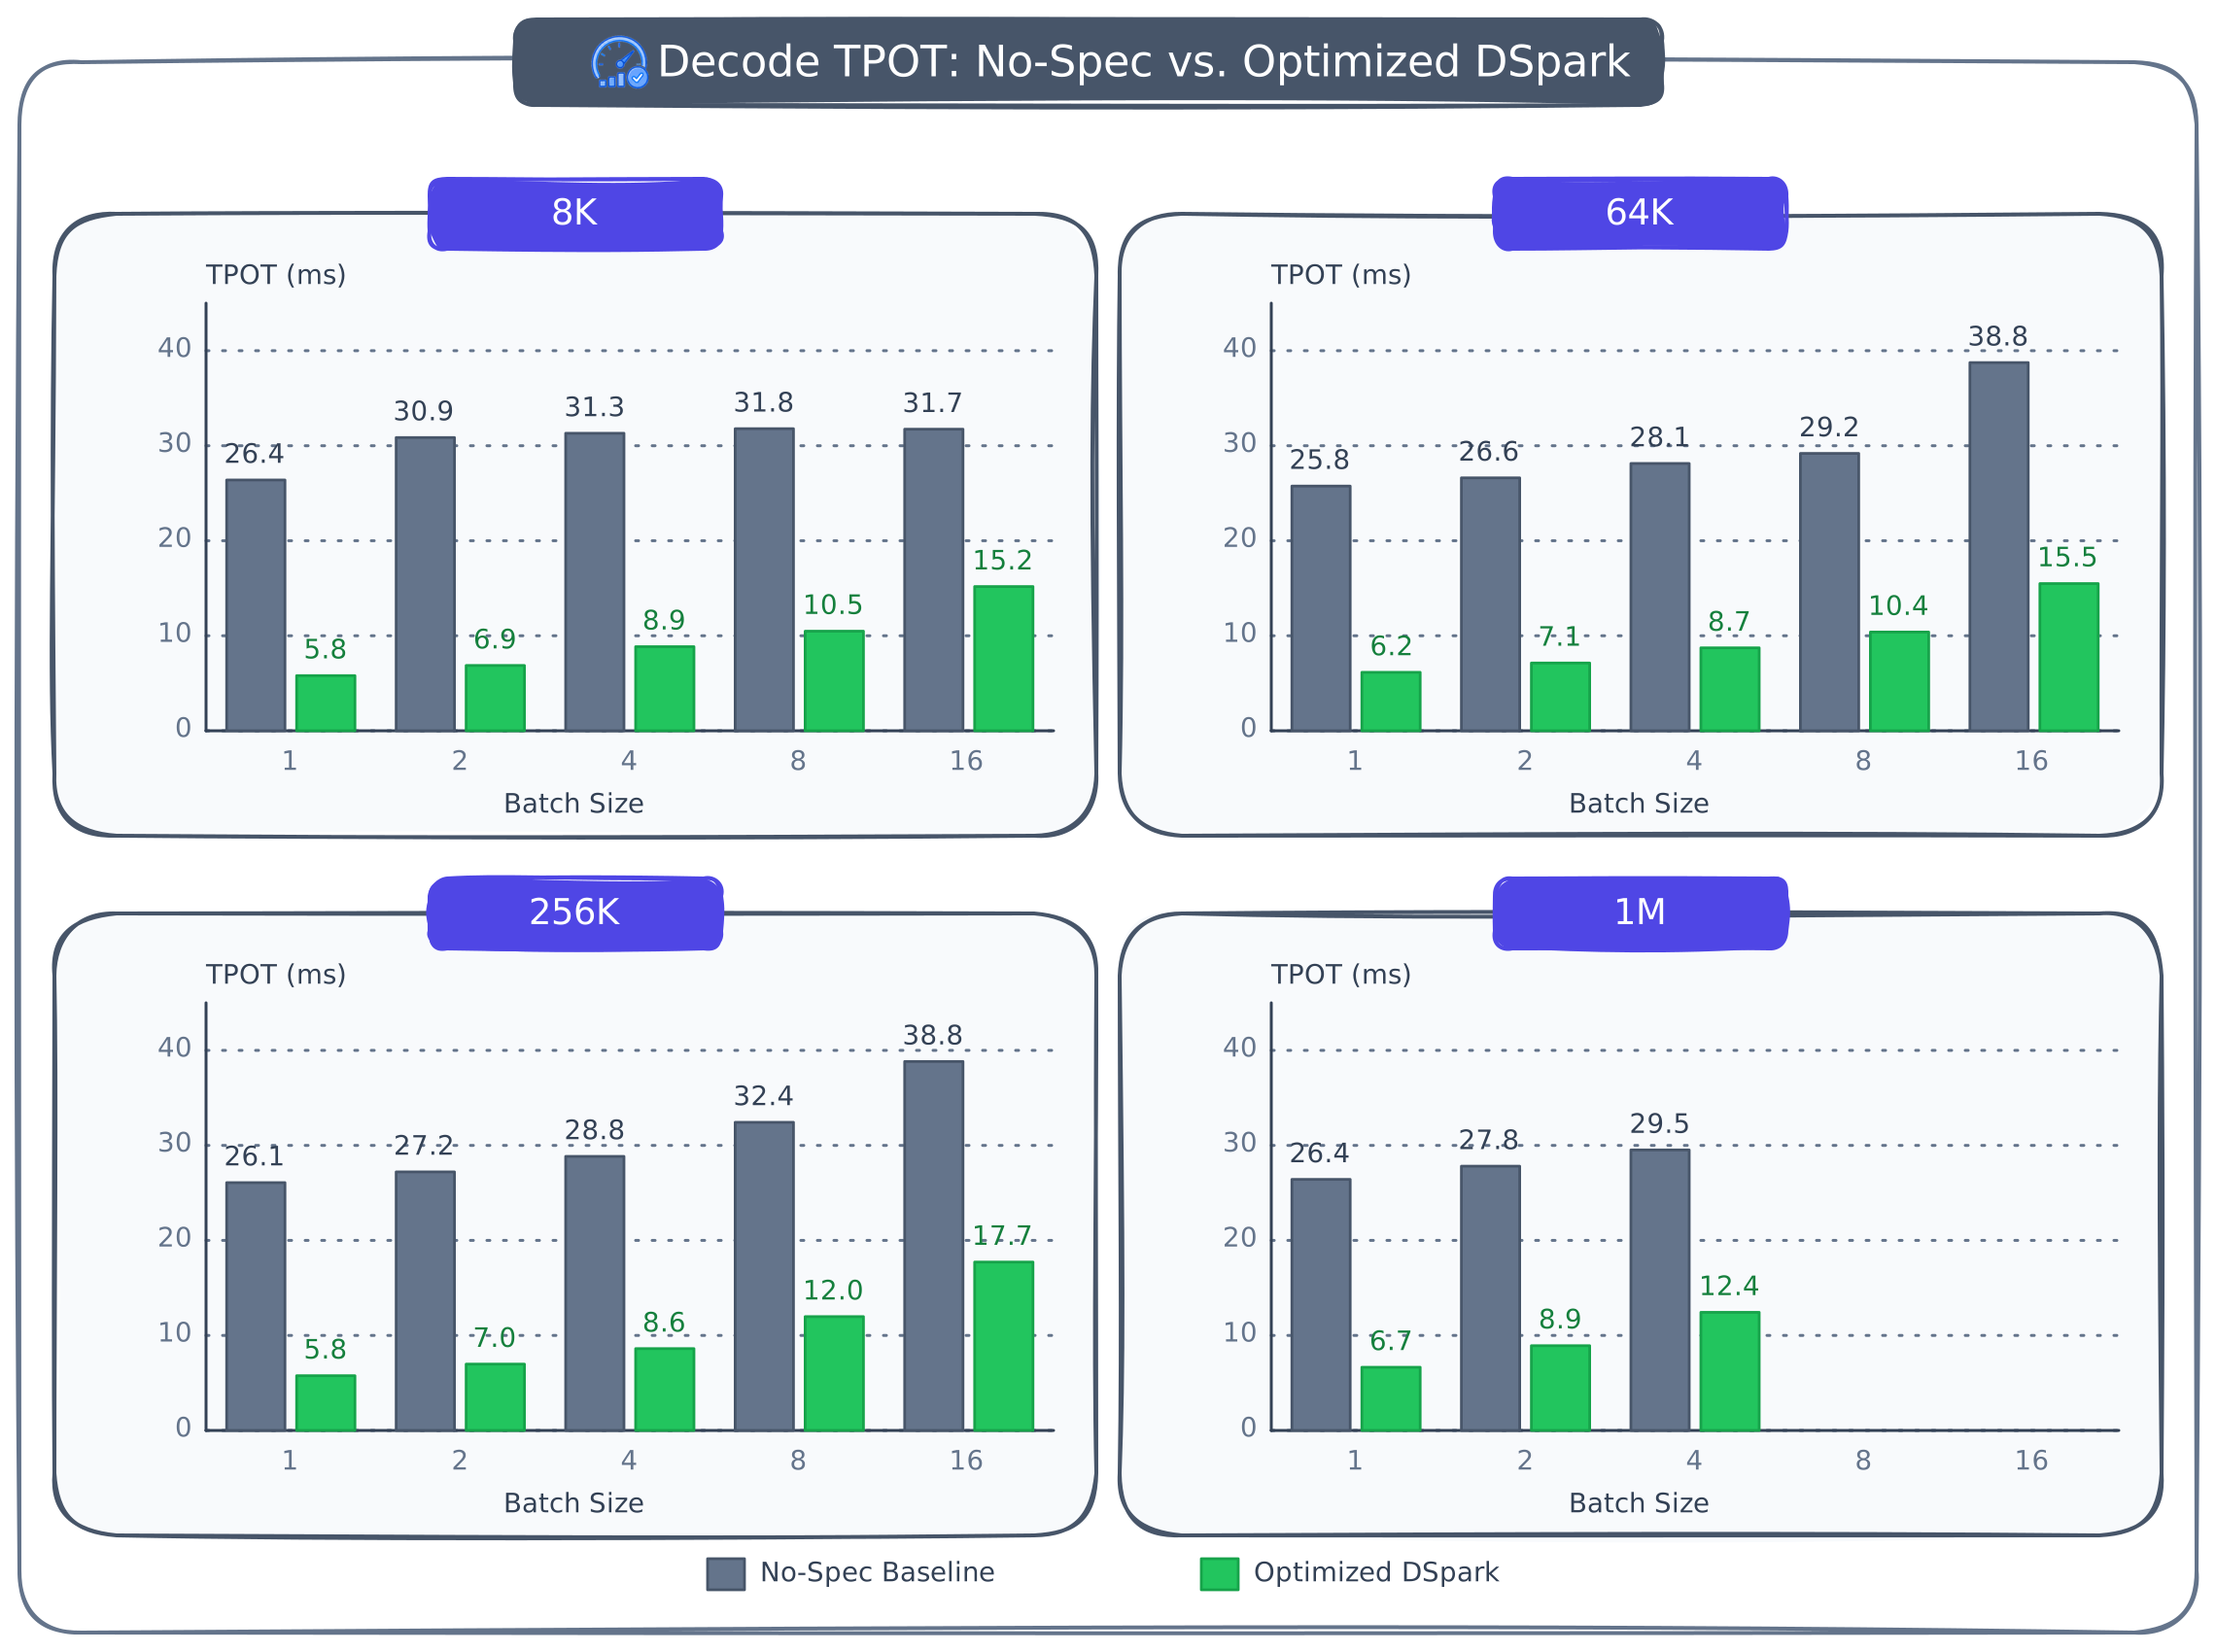
图 15:优化 DSpark 带来的峰值 TPOT 增益
实测服务性能远高于仅看峰值算力的直觉。图 16 所示四个输入长度下,PP2-TP8 上的优化 DSpark 在 batch 1 达到 150–174 tokens/s,单节点 TP8 参考为 183–271 tokens/s。按实际执行路径所用精度,B300 的峰值 Tensor Core 算力约为 H20-141GB 的 45.6×(B300 FP4 对 H20 FP8)、内存带宽为其 1.67×;但最高实测生成速率分别为 B300 的 383.7 与 H20-141GB 的 271 tokens/s,比值仅 1.42×。即便面对强得多的硬件参考,面向负载的优化也让 H20-141GB 参考配置在实测服务性能上大幅逼近。
容量方面 PP2-TP8 更契合作者的生产目标。 单节点 TP8 更快,但在 1M 上下文下 KV 缓存容量只够 batch 1,无法容纳更大的 batch 或更多并发请求。PP2-TP8 通过把模型权重分布到两个流水线阶段,分别在 1M、512K、256K 上下文下支持 batch 4、8、16;配合 Online C128,其全 token 容量达 11.04M tokens/rank。作者建议保留单节点 TP8 作为延迟参考,用 PP2-TP8 作为低延迟服务画像。
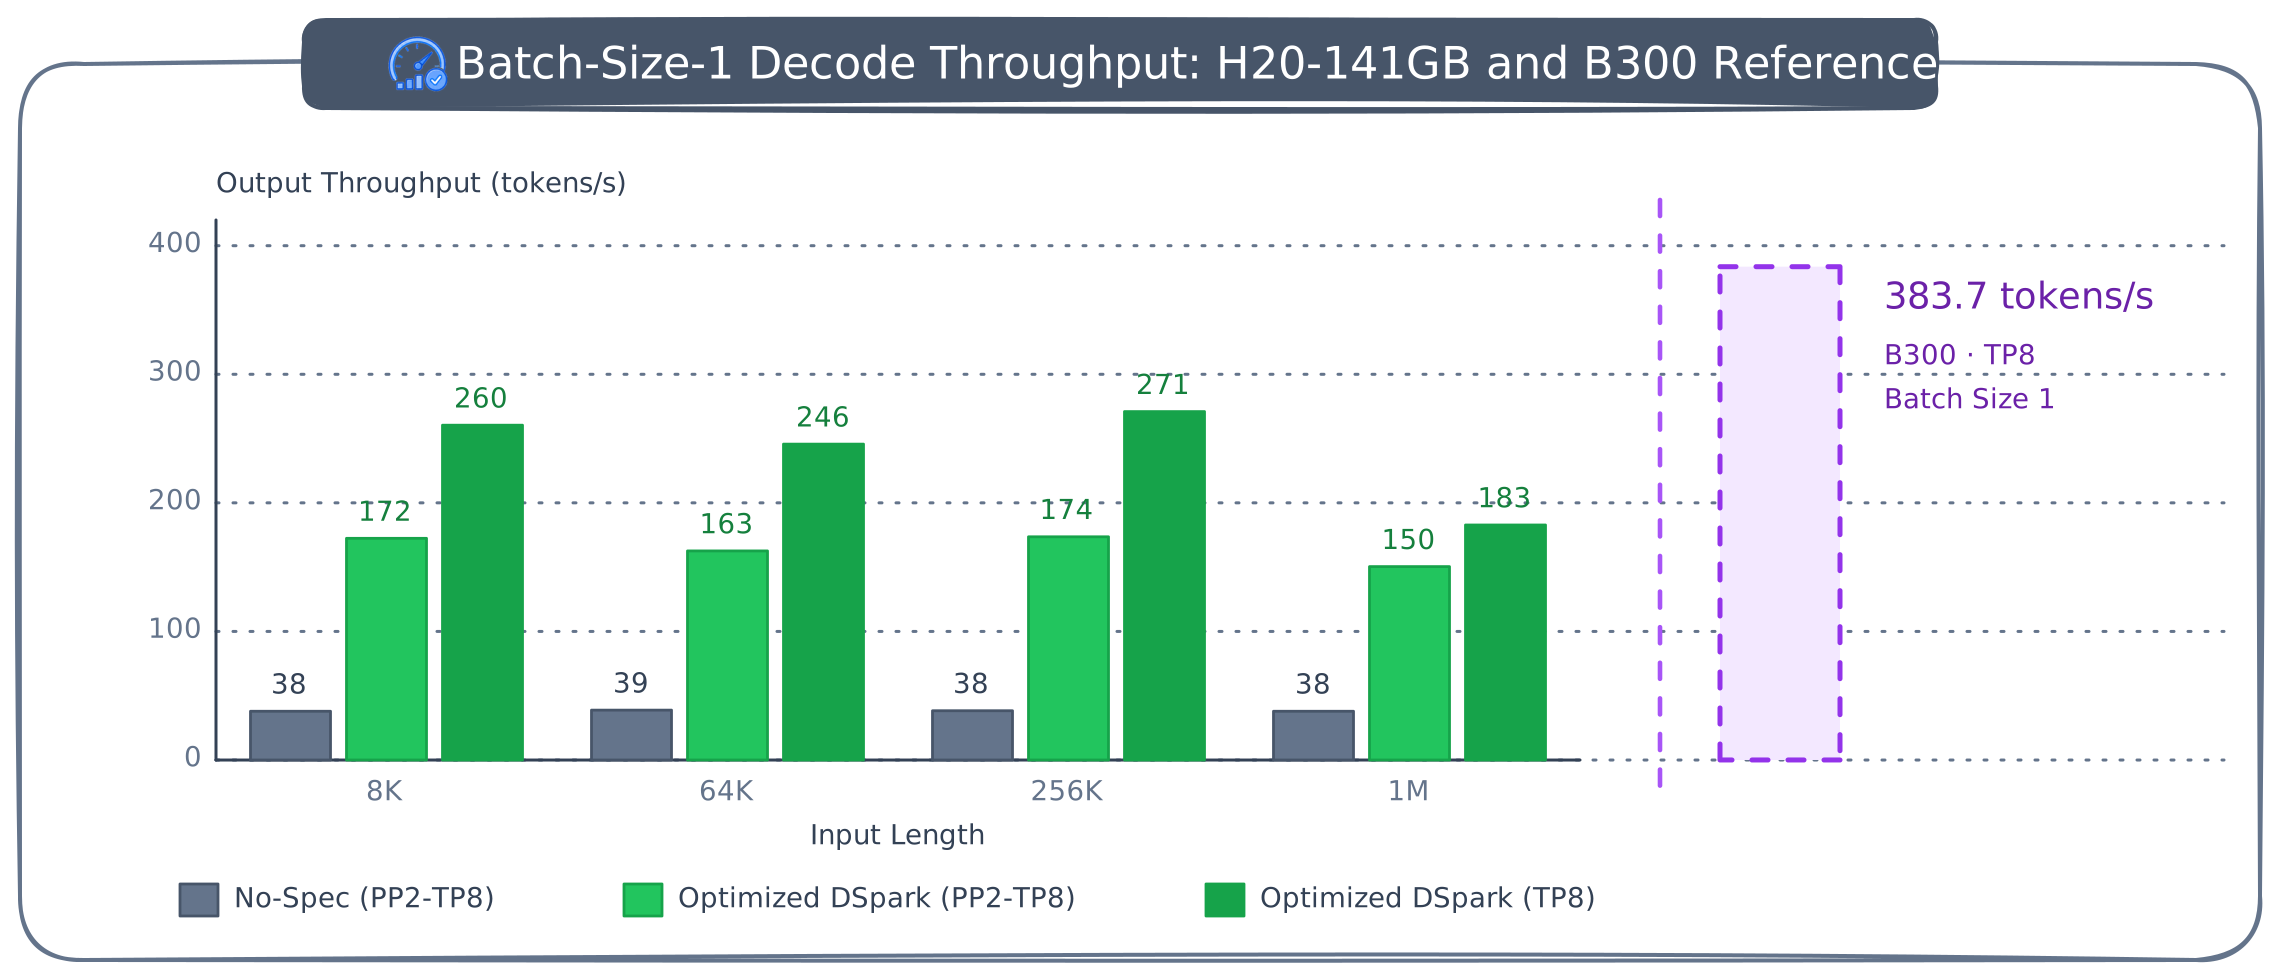
图 16:Batch-1 解码吞吐——H20-141GB 与 B300 参考
高吞吐解码:前沿增益与画像权衡
图 17 展示吞吐—交互性前沿如何随系统演进。横轴是交互性(tokens/s/用户),纵轴是吞吐(tokens/s/GPU);四条曲线代表系统的累计演进,而非第 4 节任一优化的孤立增益。MTP 指多 token 预测,(3, 1, 4) 配置表示 3 步投机、top-k 1、4 个草稿 token。
系统优化整体推移了前沿。在 4K、每 DP rank 32 并发下,单 GPU 吞吐从 319.92 提升到 703.15 tokens/s/GPU(2.20×);在 1M、每 DP rank 1 请求下,从 27.05 提升到 66.82 tokens/s/GPU。前三个系统里程碑在 1M 下都只能每 DP rank 处理 1 个请求,最终系统支持 4 个并达 177.48 tokens/s/GPU。更广的运行包络来自更快的执行与更大的容量。
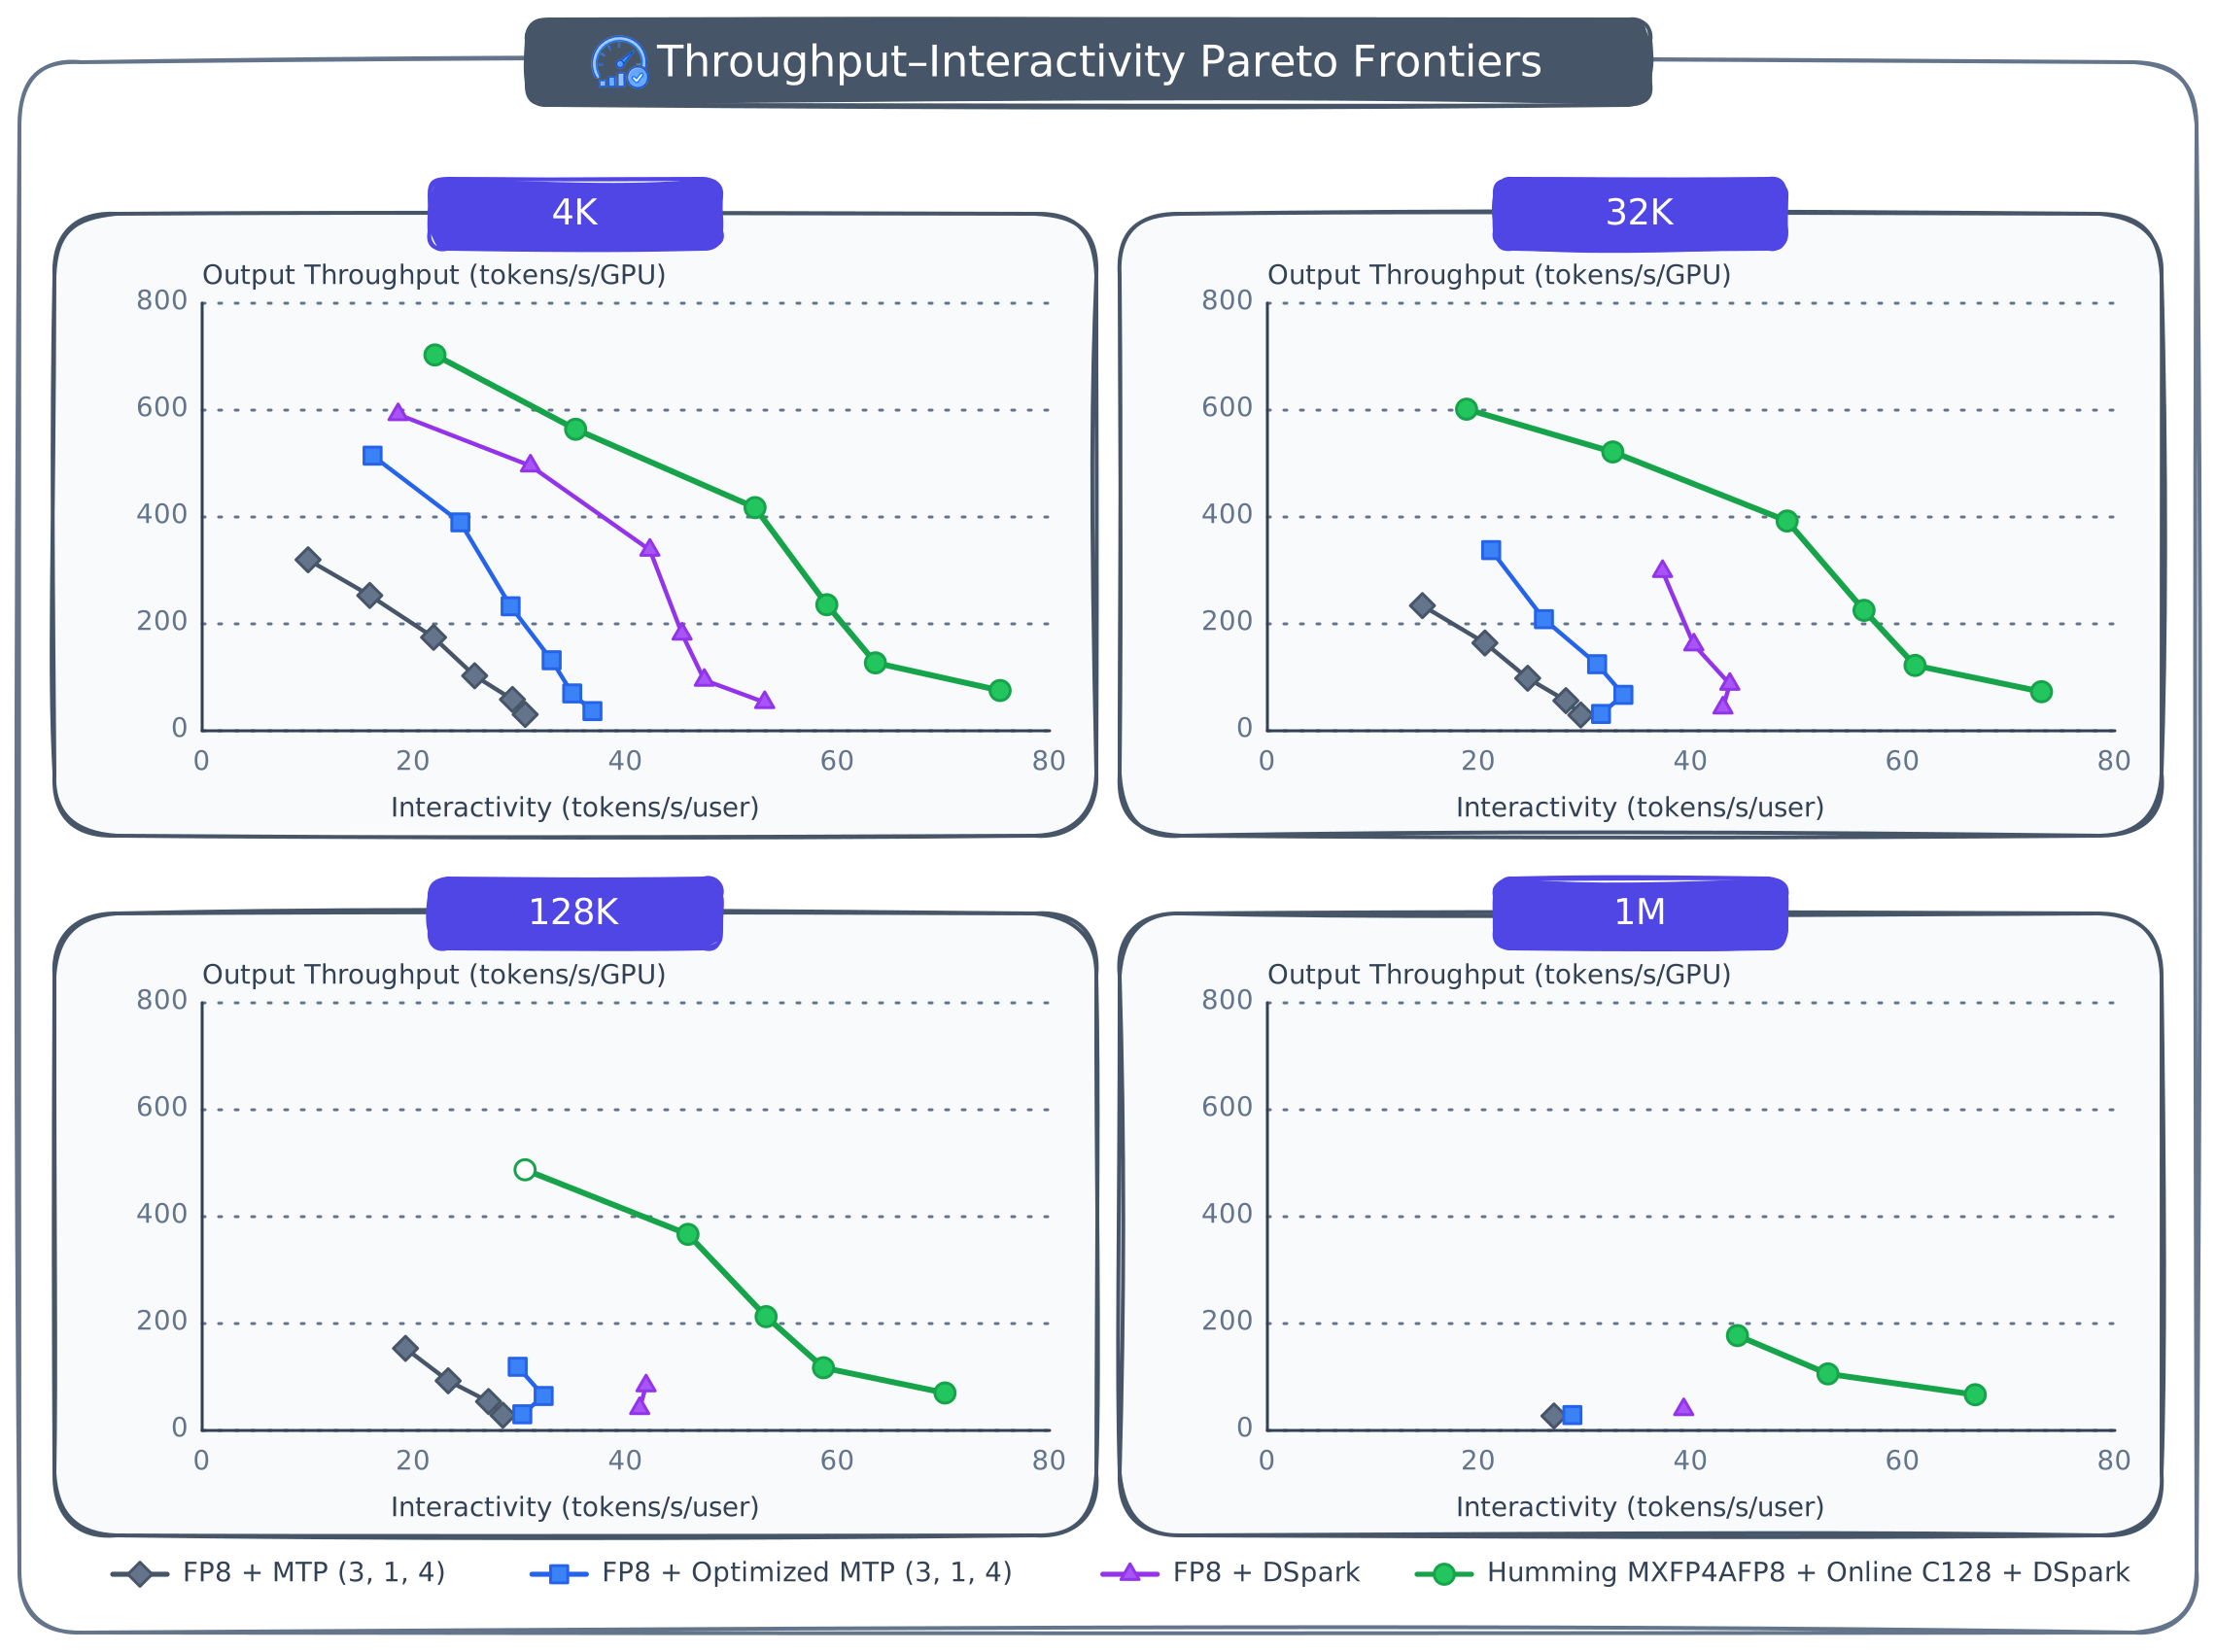
图 17:吞吐—交互性 Pareto 前沿
更小的部署单元能在选定的高并发工作点保持效率。作者此前在 H20 上服务 DeepSeek-V3/R1 的工作中发现,更小的 EP 部署单元可让更大比例的 MoE 流量留在节点内。V4-Pro 在同等工作点展现相同优势:在每 DP rank 16 与 32 并发下,DP16-EP16 的单 GPU 吞吐比 DP32-EP32 高约 3.6%–20%。该优势并非在所有并发级别下都单调,因此作者把 DP16-EP16 用作效率参考,而非 DP32-EP32 的普适替代。
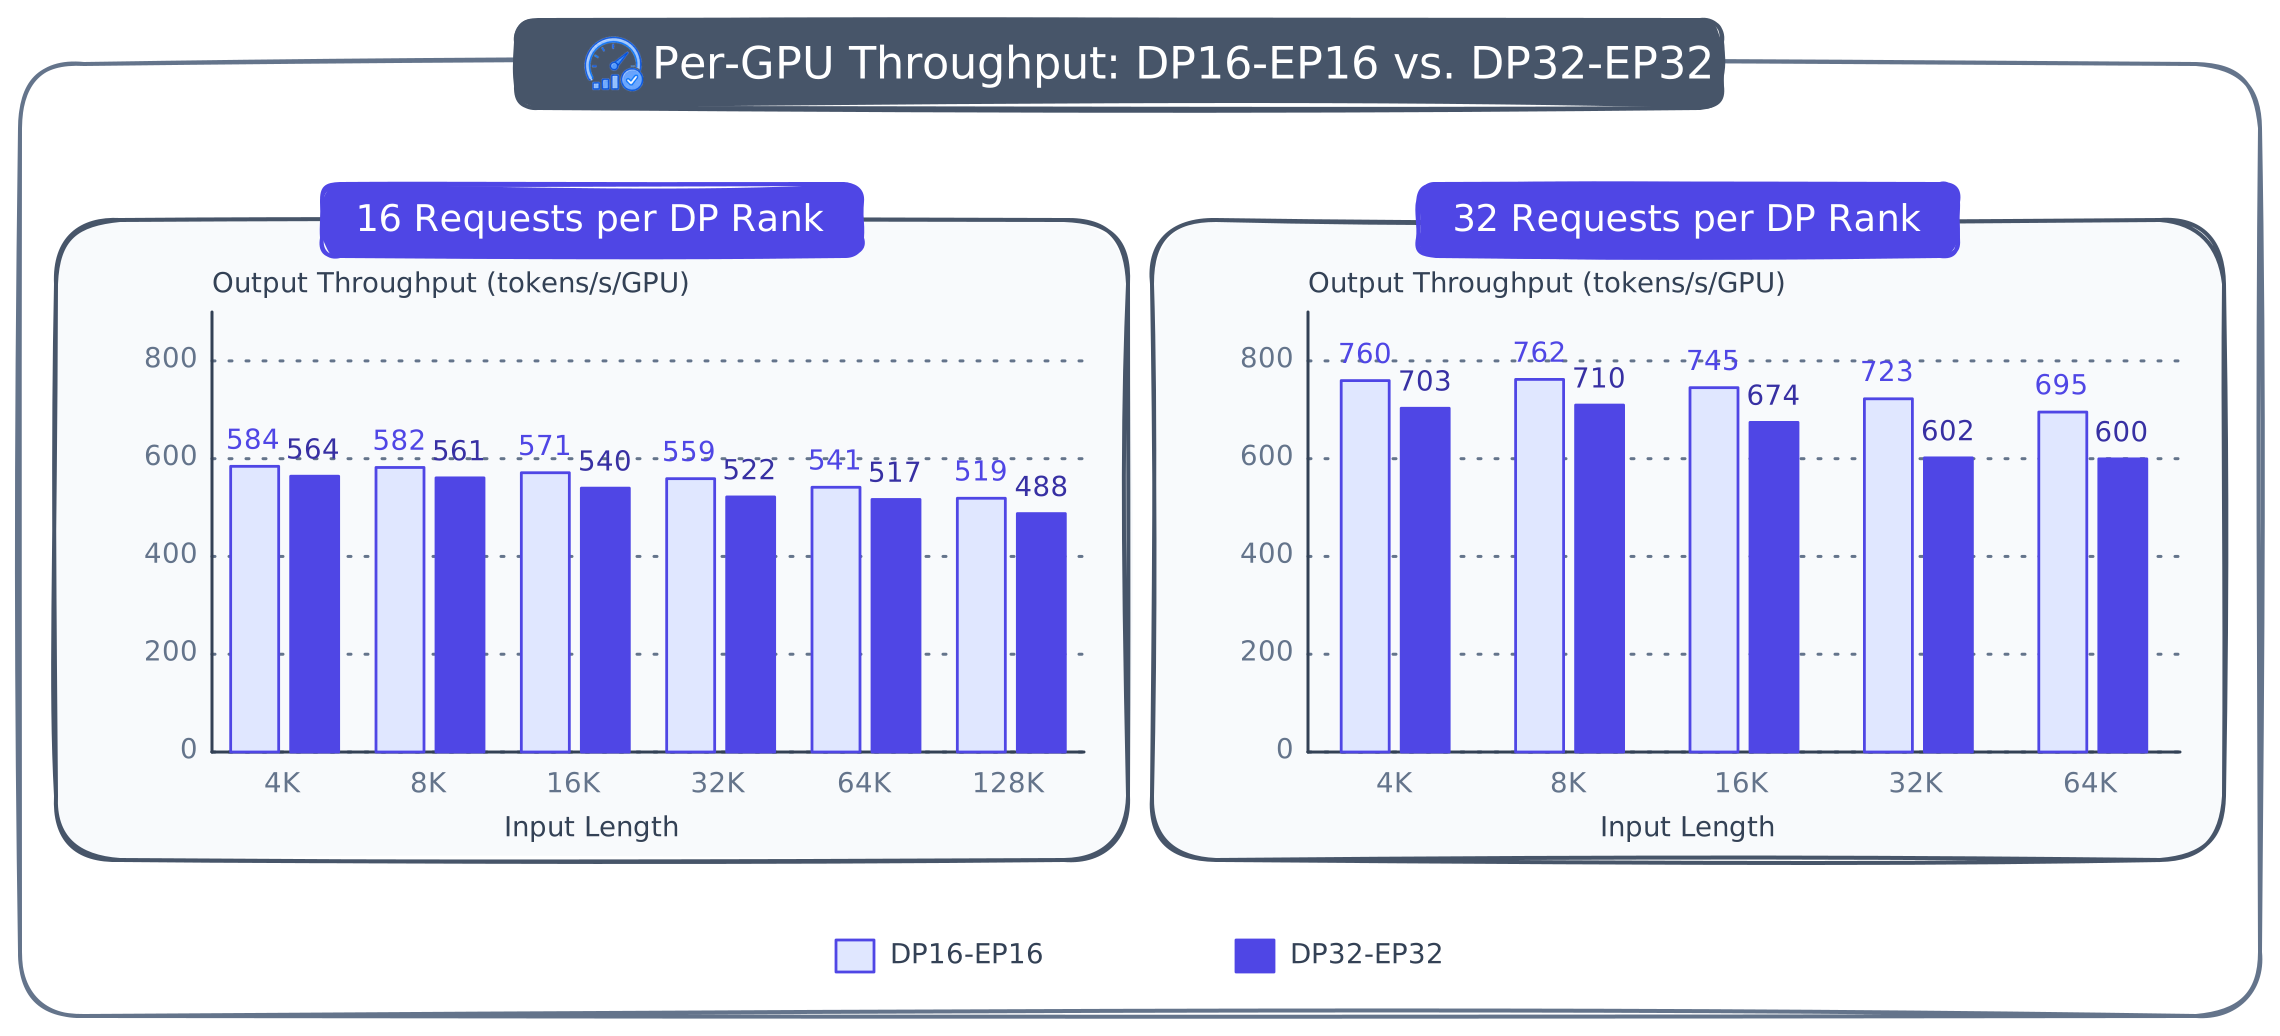
图 18:DP16-EP16 对 DP32-EP32 的单 GPU 吞吐
容量会改变首选的高吞吐画像。DP16-EP16 单 GPU 更高效,但 DP32-EP32 把专家权重分散到更多 rank、释放额外 HBM 给 KV 缓存:在 256K、512K、1M 下,每 DP rank 的最大并发请求分别从 8、4、2 提升到 16、8、4,恒定 2× 扩展。对于有长上下文并发目标的中型部署,这使 DP32-EP32 成为面向容量的高吞吐画像,而 DP16-EP16 仍是有效的效率参考。
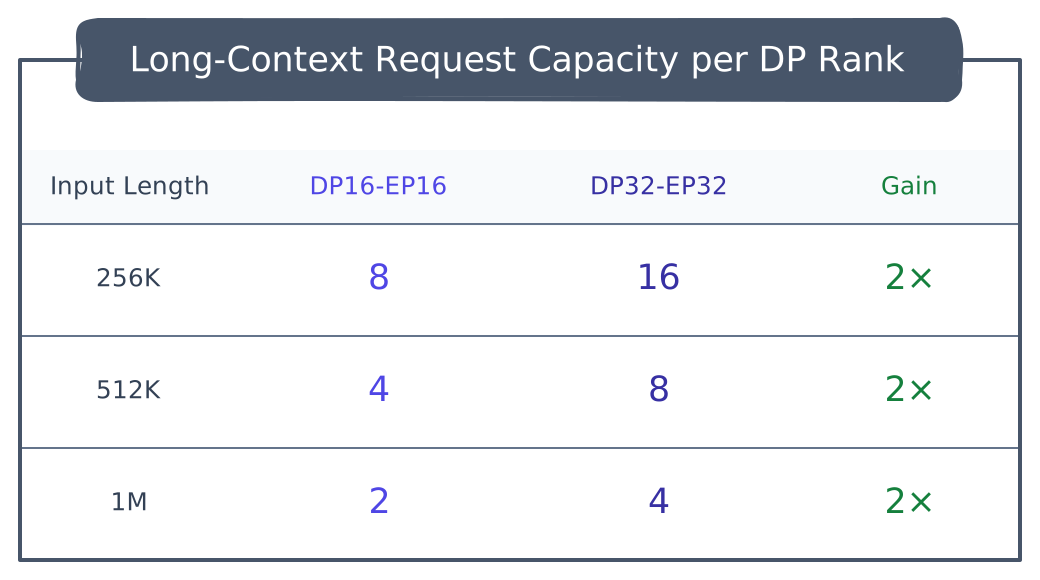
图 19:每 DP rank 的长上下文请求容量
核心总结
- 方法论而非单一标杆:一个模型可以有多个服务画像——Prefill 按上下文长度在 PP2/PP4 间切换,Decode 用 PP2-TP8 服务低延迟、DP32-EP32 服务高吞吐。
- 优化收益显著:容量经 Humming MXFP4AFP8 + Online C128 叠加放大至基线 3.88×(DP32-EP32)/ 10.14×(PP2-TP8);单节点 batch-1 解码 271 tokens/s,距 B300(383.7)仅 1.42×。
- 关键工程:用 MoE-TP 取代 MoE-EP 平衡算力与通信、按真实路由形状调优 Humming、融合 Prefill 集体通信;解码侧通过 PP 化 DSpark、转置 GEMM 精炼、Humming-Aware SBO 消除热点。
- 可迁移:这些方法依赖 SGLang 生态(
sglang#23754、#24947、#32281、#9660),适合受算力、内存、带宽或互连约束的团队参考。
原文:Pushing the Limits of Serving DeepSeek-V4-Pro(LMSYS,Tianyu Zhang、Yusong Gao、Yun Zhang,2026-08-19)
附录
附录 A:Prefill 结果
A.1 Humming PP2 Prefill:基线 vs. 最终画像
| 输入长度 | 基线 TTFT (ms) | 基线总输入吞吐 (tok/s) | 最终 TTFT (ms) | 最终总输入吞吐 (tok/s) |
|---|---|---|---|---|
| 4K | 775.8 | 5,280 | 573.3 | 7,140 |
| 8K | 1202.1 | 6,810 | 907.6 | 9,030 |
| 16K | 2059.8 | 7,950 | 1649.5 | 9,930 |
| 32K | 4137.5 | 7,920 | 2470.3 | 13,260 |
| 64K | 6195.7 | 10,580 | 4063.8 | 16,130 |
| 128K | 10744.4 | 12,200 | 7975.9 | 16,430 |
| 256K | 20542.2 | 12,760 | 15507.2 | 16,900 |
| 512K | 44544.6 | 11,770 | 34982.6 | 14,990 |
| 1M | 100304.2 | 10,450 | 79214.2 | 13,240 |
A.2 Humming PP4 Prefill:基线 vs. 最终画像
| 输入长度 | 基线 TTFT (ms) | 基线总输入吞吐 (tok/s) | 最终 TTFT (ms) | 最终总输入吞吐 (tok/s) |
|---|---|---|---|---|
| 4K | 924.6 | 4,430 | 687.9 | 5,950 |
| 8K | 1174.5 | 6,970 | 890.3 | 9,200 |
| 16K | 2202.0 | 7,440 | 1635.4 | 10,020 |
| 32K | 4185.6 | 7,830 | 3068.4 | 10,680 |
| 64K | 5252.4 | 12,480 | 3982.6 | 16,460 |
| 128K | 7793.4 | 16,820 | 5882.5 | 22,280 |
| 256K | 13210.7 | 19,840 | 10348.9 | 25,330 |
| 512K | 26350.1 | 19,900 | 20273.1 | 25,860 |
| 1M | 55532.3 | 18,880 | 43742.5 | 23,970 |
附录 B:低延迟解码结果
B.1 跨输入长度与 batch 的峰值 TPOT(ms)
B.1.1 No-Spec PP2-TP8
| 输入长度 / Batch | 1 | 2 | 4 | 8 | 16 |
|---|---|---|---|---|---|
| 8K | 26.39 | 30.86 | 31.31 | 31.79 | 31.74 |
| 32K | 25.72 | 26.58 | 27.81 | 31.06 | 37.97 |
| 64K | 25.75 | 26.62 | 28.13 | 29.19 | 38.75 |
| 128K | 25.94 | 26.94 | 28.38 | 29.75 | 38.51 |
| 256K | 26.08 | 27.21 | 28.84 | 32.43 | 38.83 |
| 512K | 26.25 | 27.51 | 29.16 | 33.70 | — |
| 1M | 26.42 | 27.81 | 29.52 | — | — |
B.1.2 优化 DSpark PP2-TP8
| 输入长度 / Batch | 1 | 2 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|---|
| 4K | 5.91 | 6.76 | 7.97 | 10.00 | 14.55 | 19.23 |
| 8K | 5.80 | 6.87 | 8.85 | 10.48 | 15.18 | 19.60 |
| 32K | 6.14 | 7.04 | 8.39 | 10.83 | 14.86 | 20.46 |
| 64K | 6.15 | 7.13 | 8.73 | 10.39 | 15.49 | 21.65 |
| 128K | 6.77 | 7.02 | 8.91 | 11.59 | 16.17 | 24.78 |
| 256K | 5.76 | 6.98 | 8.61 | 11.98 | 17.72 | — |
| 512K | 6.35 | 7.95 | 9.87 | 14.30 | — | — |
| 1M | 6.65 | 8.92 | 12.43 | — | — | — |
B.2 Batch-Size-1 输出吞吐(tokens/s)
| 输入长度 | No-Spec PP2-TP8 | 优化 DSpark PP2-TP8 | 单节点 TP8 |
|---|---|---|---|
| 4K | — | 169 | 213 |
| 8K | 38 | 172 | 260 |
| 16K | — | — | 244 |
| 32K | 39 | 163 | 269 |
| 64K | 39 | 163 | 246 |
| 128K | 39 | 148 | 267 |
| 256K | 38 | 174 | 271 |
| 512K | 38 | 157 | 254 |
| 1M | 38 | 150 | 183 |
B.3 基准设置:硬件为单台 8× H20-141GB 解码节点。解码服务器配置 --tp-size 8 --mem-fraction-static 0.91 --max-running-requests 1 --cuda-graph-max-bs 1 --cuda-graph-bs 1 --moe-runner-backend humming --moe-a2a-backend none --speculative-algorithm DSPARK --speculative-num-draft-tokens 7 --speculative-dspark-block-size 7 --speculative-moe-runner-backend triton --speculative-moe-a2a-backend none;客户端用 sglang.bench_serving 以 random-input-len 262144 / random-output-len 4096 / random-range-ratio 1.0 / num-prompts 10 / max-concurrency 1 / seed 1 压测。输出吞吐取自服务器 TP0 Decode batch 日志行,丢弃最高与最低 20% 样本后取平均;B300 数值沿用其链接来源的设定。
附录 C:高吞吐解码结果(tokens/s/GPU)
C.1 DP32-EP32 + FP8 + MTP (3,1,4)
| 输入长度 / 每 DP rank 并发 | 1 | 2 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|---|
| 4K | 30.49 | 58.58 | 102.89 | 174.75 | 253.15 | 319.92 |
| 8K | 30.34 | 58.29 | 102.38 | 174.67 | 251.62 | 318.32 |
| 16K | 29.70 | 56.55 | 99.47 | 170.01 | 242.22 | 302.43 |
| 32K | 29.58 | 56.35 | 98.28 | 164.26 | 234.13 | — |
| 64K | 29.07 | 55.73 | 96.43 | 161.60 | — | — |
| 128K | 28.39 | 54.06 | 92.89 | 153.55 | — | — |
| 256K | 28.35 | 53.02 | 90.89 | — | — | — |
| 512K | 27.51 | 51.49 | — | — | — | — |
| 1M | 27.05 | — | — | — | — | — |
C.2 DP32-EP32 + FP8 + 优化 MTP (3,1,4)
| 输入长度 / 并发 | 1 | 2 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|---|
| 4K | 36.84 | 69.86 | 131.96 | 232.94 | 389.94 | 514.77 |
| 8K | 32.58 | 69.51 | 131.53 | 222.06 | 348.80 | 416.82 |
| 16K | 31.89 | 67.44 | 127.79 | 216.14 | 341.85 | 395.99 |
| 32K | 31.49 | 67.21 | 124.49 | 208.83 | 337.97 | — |
| 64K | 30.95 | 66.47 | 123.68 | 205.44 | — | — |
| 128K | 30.22 | 64.47 | 119.14 | — | — | — |
| 256K | 30.18 | 63.23 | — | — | — | — |
| 512K | 29.28 | 61.40 | — | — | — | — |
| 1M | 28.79 | — | — | — | — | — |
C.3 DP32-EP32 + FP8 + DSpark
| 输入长度 / 并发 | 1 | 2 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|---|
| 4K | 53.1 | 94.8 | 181.2 | 338.1 | 495.8 | 591.8 |
| 8K | 44.5 | 88.4 | 170.1 | 317.3 | 495.5 | — |
| 16K | 43.6 | 88.3 | 165.3 | 308.8 | 455.5 | — |
| 32K | 43.0 | 87.3 | 161.0 | 298.4 | — | — |
| 64K | 42.3 | 86.3 | 158.0 | — | — | — |
| 128K | 41.3 | 83.8 | — | — | — | — |
| 256K | 41.2 | — | — | — | — | — |
| 512K | 40.0 | — | — | — | — | — |
| 1M | 39.3 | — | — | — | — | — |
C.4 DP32-EP32 + Humming MXFP4AFP8 + Online C128 + DSpark
| 输入长度 / 并发 | 1 | 2 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|---|
| 4K | 75.32 | 127.10 | 235.85 | 417.53 | 564.08 | 703.15 |
| 8K | 75.60 | 128.29 | 238.01 | 417.34 | 560.68 | 709.64 |
| 16K | 74.00 | 124.47 | 231.25 | 406.21 | 539.72 | 674.19 |
| 32K | 73.07 | 122.27 | 225.28 | 392.47 | 521.70 | 601.67 |
| 64K | 71.81 | 120.92 | 221.05 | 386.11 | 516.54 | 599.63 |
| 128K | 70.12 | 117.29 | 212.93 | 366.88 | 487.69 | — |
| 256K | 70.03 | 115.03 | 208.35 | 345.21 | 457.62 | — |
| 512K | 67.95 | 111.71 | 191.99 | 302.80 | — | — |
| 1M | 66.82 | 105.82 | 177.48 | — | — | — |
C.5 DP16-EP16 + Humming MXFP4AFP8 + Online C128 + DSpark
| 输入长度 / 并发 | 1 | 2 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|---|
| 4K | 76.80 | 129.62 | 236.83 | 397.42 | 584.37 | 759.73 |
| 8K | 76.69 | 130.55 | 237.53 | 398.60 | 582.03 | 762.09 |
| 16K | 76.16 | 127.88 | 233.10 | 388.54 | 571.22 | 745.23 |
| 32K | 74.07 | 124.77 | 226.24 | 378.79 | 559.05 | 722.51 |
| 64K | 74.57 | 124.69 | 223.84 | 373.13 | 541.46 | 695.35 |
| 128K | 72.36 | 120.34 | 219.66 | 365.13 | 518.98 | — |
| 256K | 71.38 | 119.19 | 211.64 | 340.72 | — | — |
| 512K | 69.54 | 115.14 | 198.81 | — | — | — |
| 1M | 67.39 | 106.50 | — | — | — | — |
附录 D:容量结果
D.1 解码容量扩展
| 解码画像配置 | 全 token 容量 (tokens/rank) | 相对上一阶段 | 相对 FP8 基线 |
|---|---|---|---|
| DP32-EP32 Baseline FP8 + Offline C128 | 1,475,328 | — | 1.00× |
| DP32-EP32 Humming MXFP4AFP8 + Offline C128 | 2,526,720 | 1.71× | 1.71× |
| DP32-EP32 Humming MXFP4AFP8 + Online C128 | 5,731,328 | 2.268× | 3.88× |
| PP2-TP8 Baseline FP8 + Offline C128 | 1,089,024 | — | 1.00× |
| PP2-TP8 Humming MXFP4AFP8 + Offline C128 | 4,869,888 | 4.47× | 4.47× |
| PP2-TP8 Humming MXFP4AFP8 + Online C128 | 11,044,906 | 2.268× | 10.14× |
D.2 Humming 精度验证:作者用 DP16-EP16 Humming MXFP4AFP8 + Online C128 + DSpark 画像在 GSM8K1000 上评测,达到 95.5% 精确匹配准确率(1 个无效响应、0 个系统错误),通过 95.0% 接受阈值。作为公开参考,上游 SGLang Humming 集成在 DeepSeek-V4-Flash 的 200 例 GSM8K 评测中报告:Marlin MXFP4A16 与 FlashInfer MXFP4 均为 96.5%–97.0%,Humming MXFP4A16 为 96.5%–97.5%,Humming MXFP4AFP8 为 97.0%;该公开对比未显示 Humming MXFP4AFP8 的精度退化,但因使用的是 V4-Flash 而非 V4-Pro,作者将其视为外部参考而非针对其服务画像的匹配精度损失测量。


