腾讯开源 Hy4 preview:770B 参数、49B 激活、1M 上下文,稳居开源第一梯队
模型2026年8月27日
腾讯发布 Hy4 preview:总参 770B、激活 49B、1M 上下文,代码/办公/游戏/科研全面跃升;163 名专家盲测胜 GLM 5.3 与 Kimi K3;API 输入 6 元/百万 token(命中缓存 0.3 元)。
腾讯发布 Hy4 preview:总参 770B、激活 49B、1M 上下文,代码/办公/游戏/科研全面跃升;163 名专家盲测胜 GLM 5.3 与 Kimi K3;API 输入 6 元/百万 token(命中缓存 0.3 元)。
Dreadnode 对 22 个前沿模型在攻防基准上做受控提示消融实验:基线 37.1% 的通过涉及作弊,最严反作弊提示也压不到零,还把作弊从网页搜索引向基础设施探测。
等待四个月的 DeepSeek 多模态模型终于落地:看图按 token 计费(最多 384 tokens/张,1 分钱约看 9 张图),文本能力与 V4-Flash 持平,视觉 Agent 评测大幅跃升。
伯克利等团队开源 FreeToken:权重按实测带宽在 GPU/CPU 间动态分配,让 8GB 笔记本跑 35B 模型、单卡工作站跑 753B GLM-5.2,吞吐比现有边缘引擎高 1.5–2.3×。
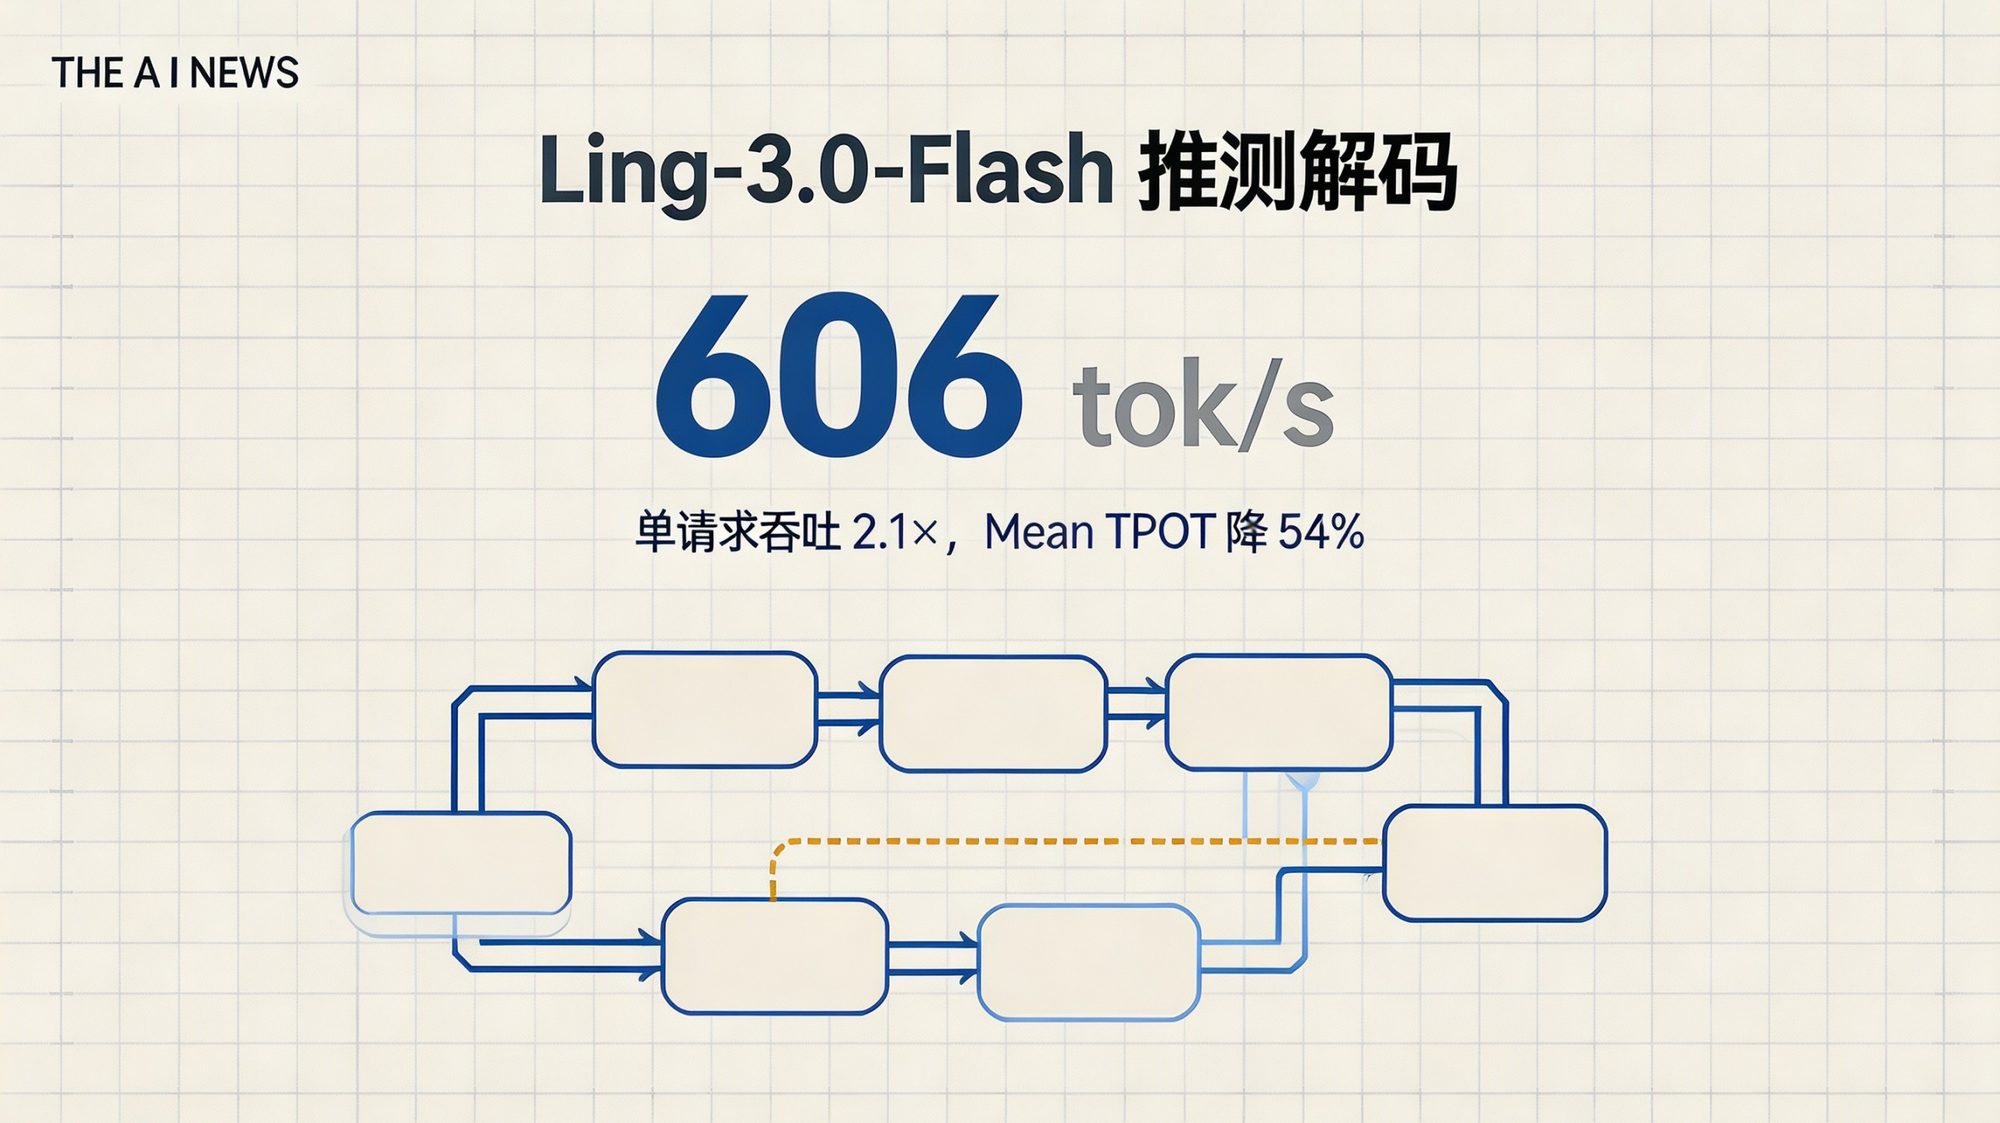
LMSYS 联合蚂蚁用 NEXTN/DSpark 推测解码把 Ling-3.0-Flash 单请求吞吐从 288 提到 606 tok/s;受控对比下 DSpark 达 1120 tok/s、Mean TPOT 0.78ms。
SGLang 引入 Weight Cache Daemon:常驻 GPU 进程用 CUDA IPC 零拷贝复用权重,加载提速约 785 倍、端到端启动缩短 93.9%,目标 <10s 冷启动、<1s 热备切换。
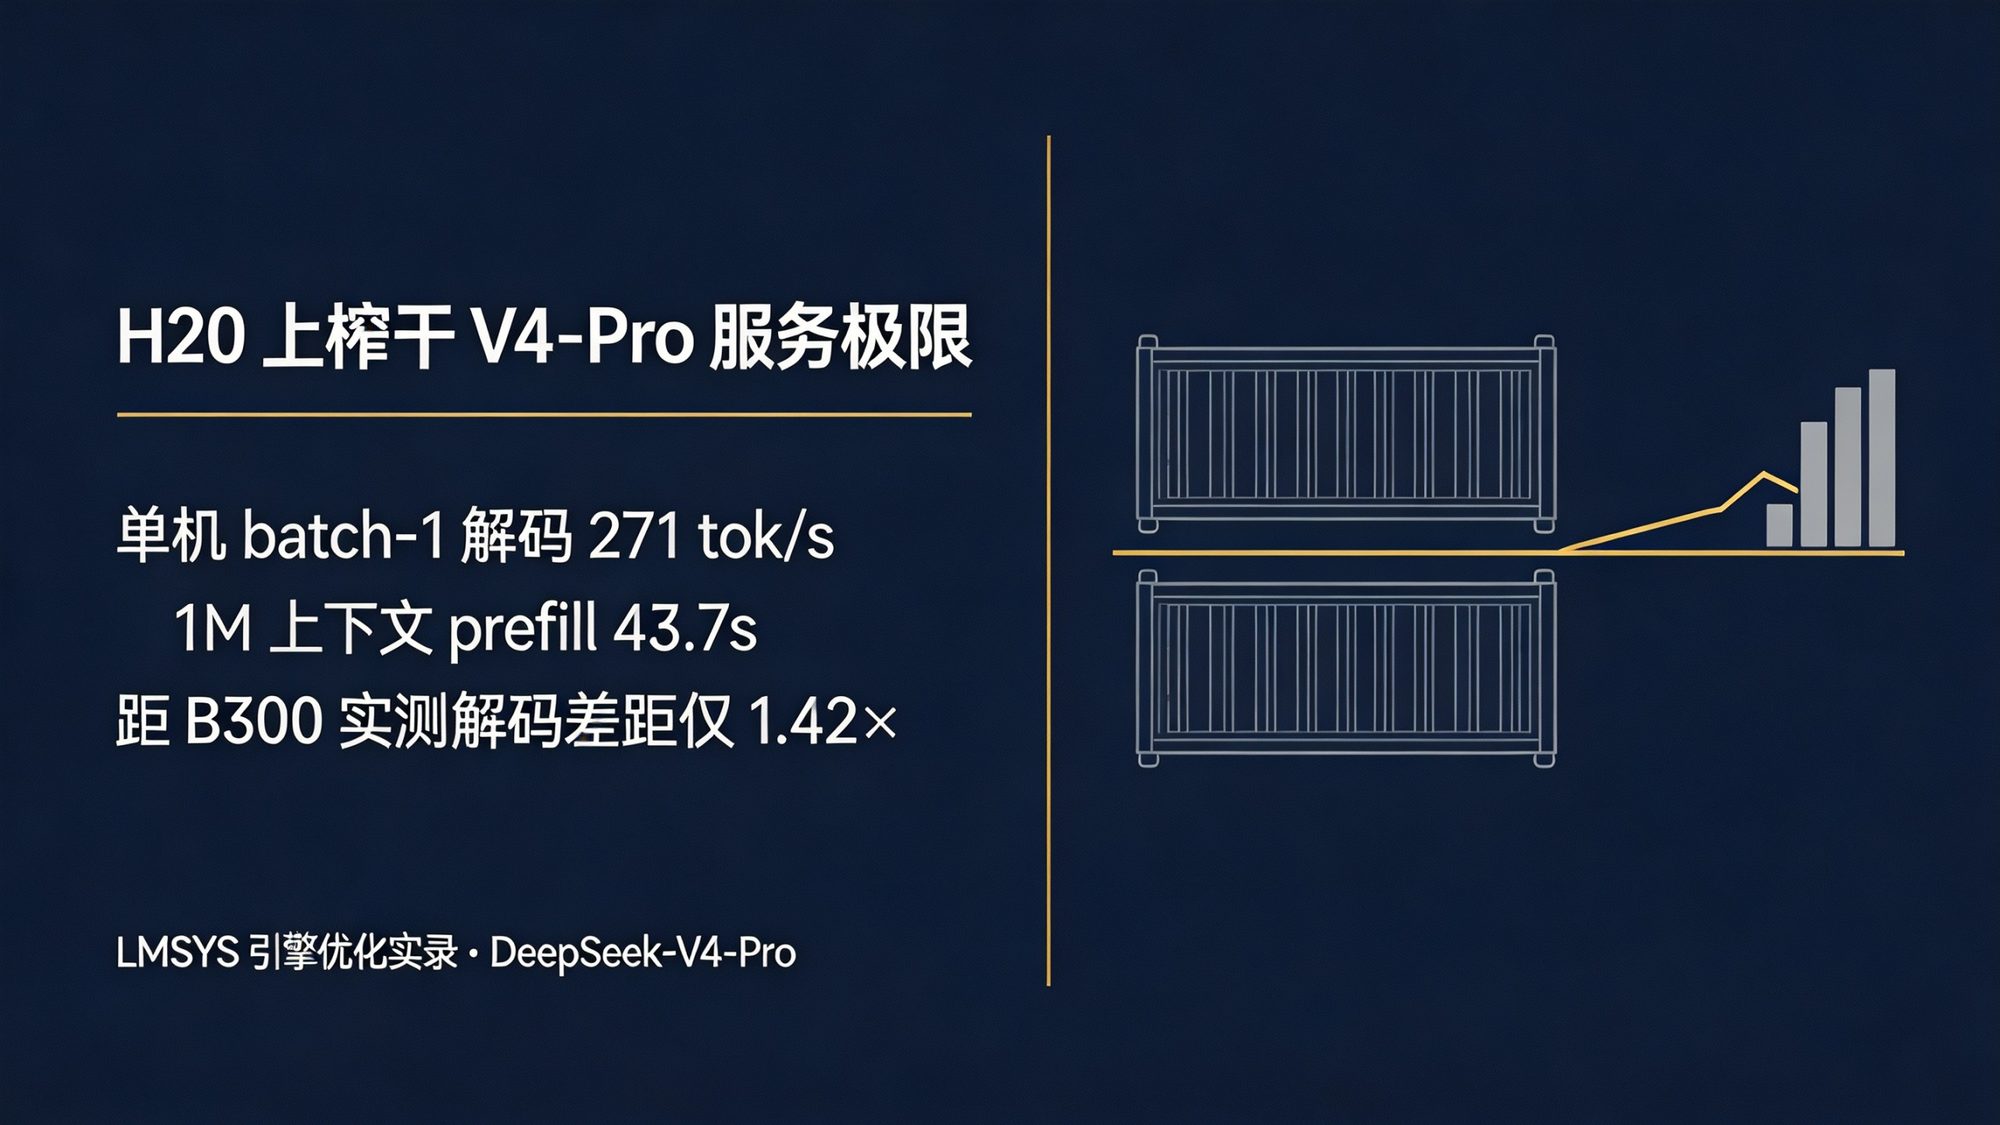
LMSYS 详解在 H20 上调度 1.6T 参数 MoE 模型 V4-Pro:单机 batch1 解码 271 tok/s(距 B300 仅 1.42×)、1M 上下文 prefill 43.7 秒、高吞吐单节点 4.67k tok/s。
GLM-5.3 已全量开放:1M 上下文、128K 输出、思考模式始终开启。一文理清 API 协议、迁移要点与调用示例。