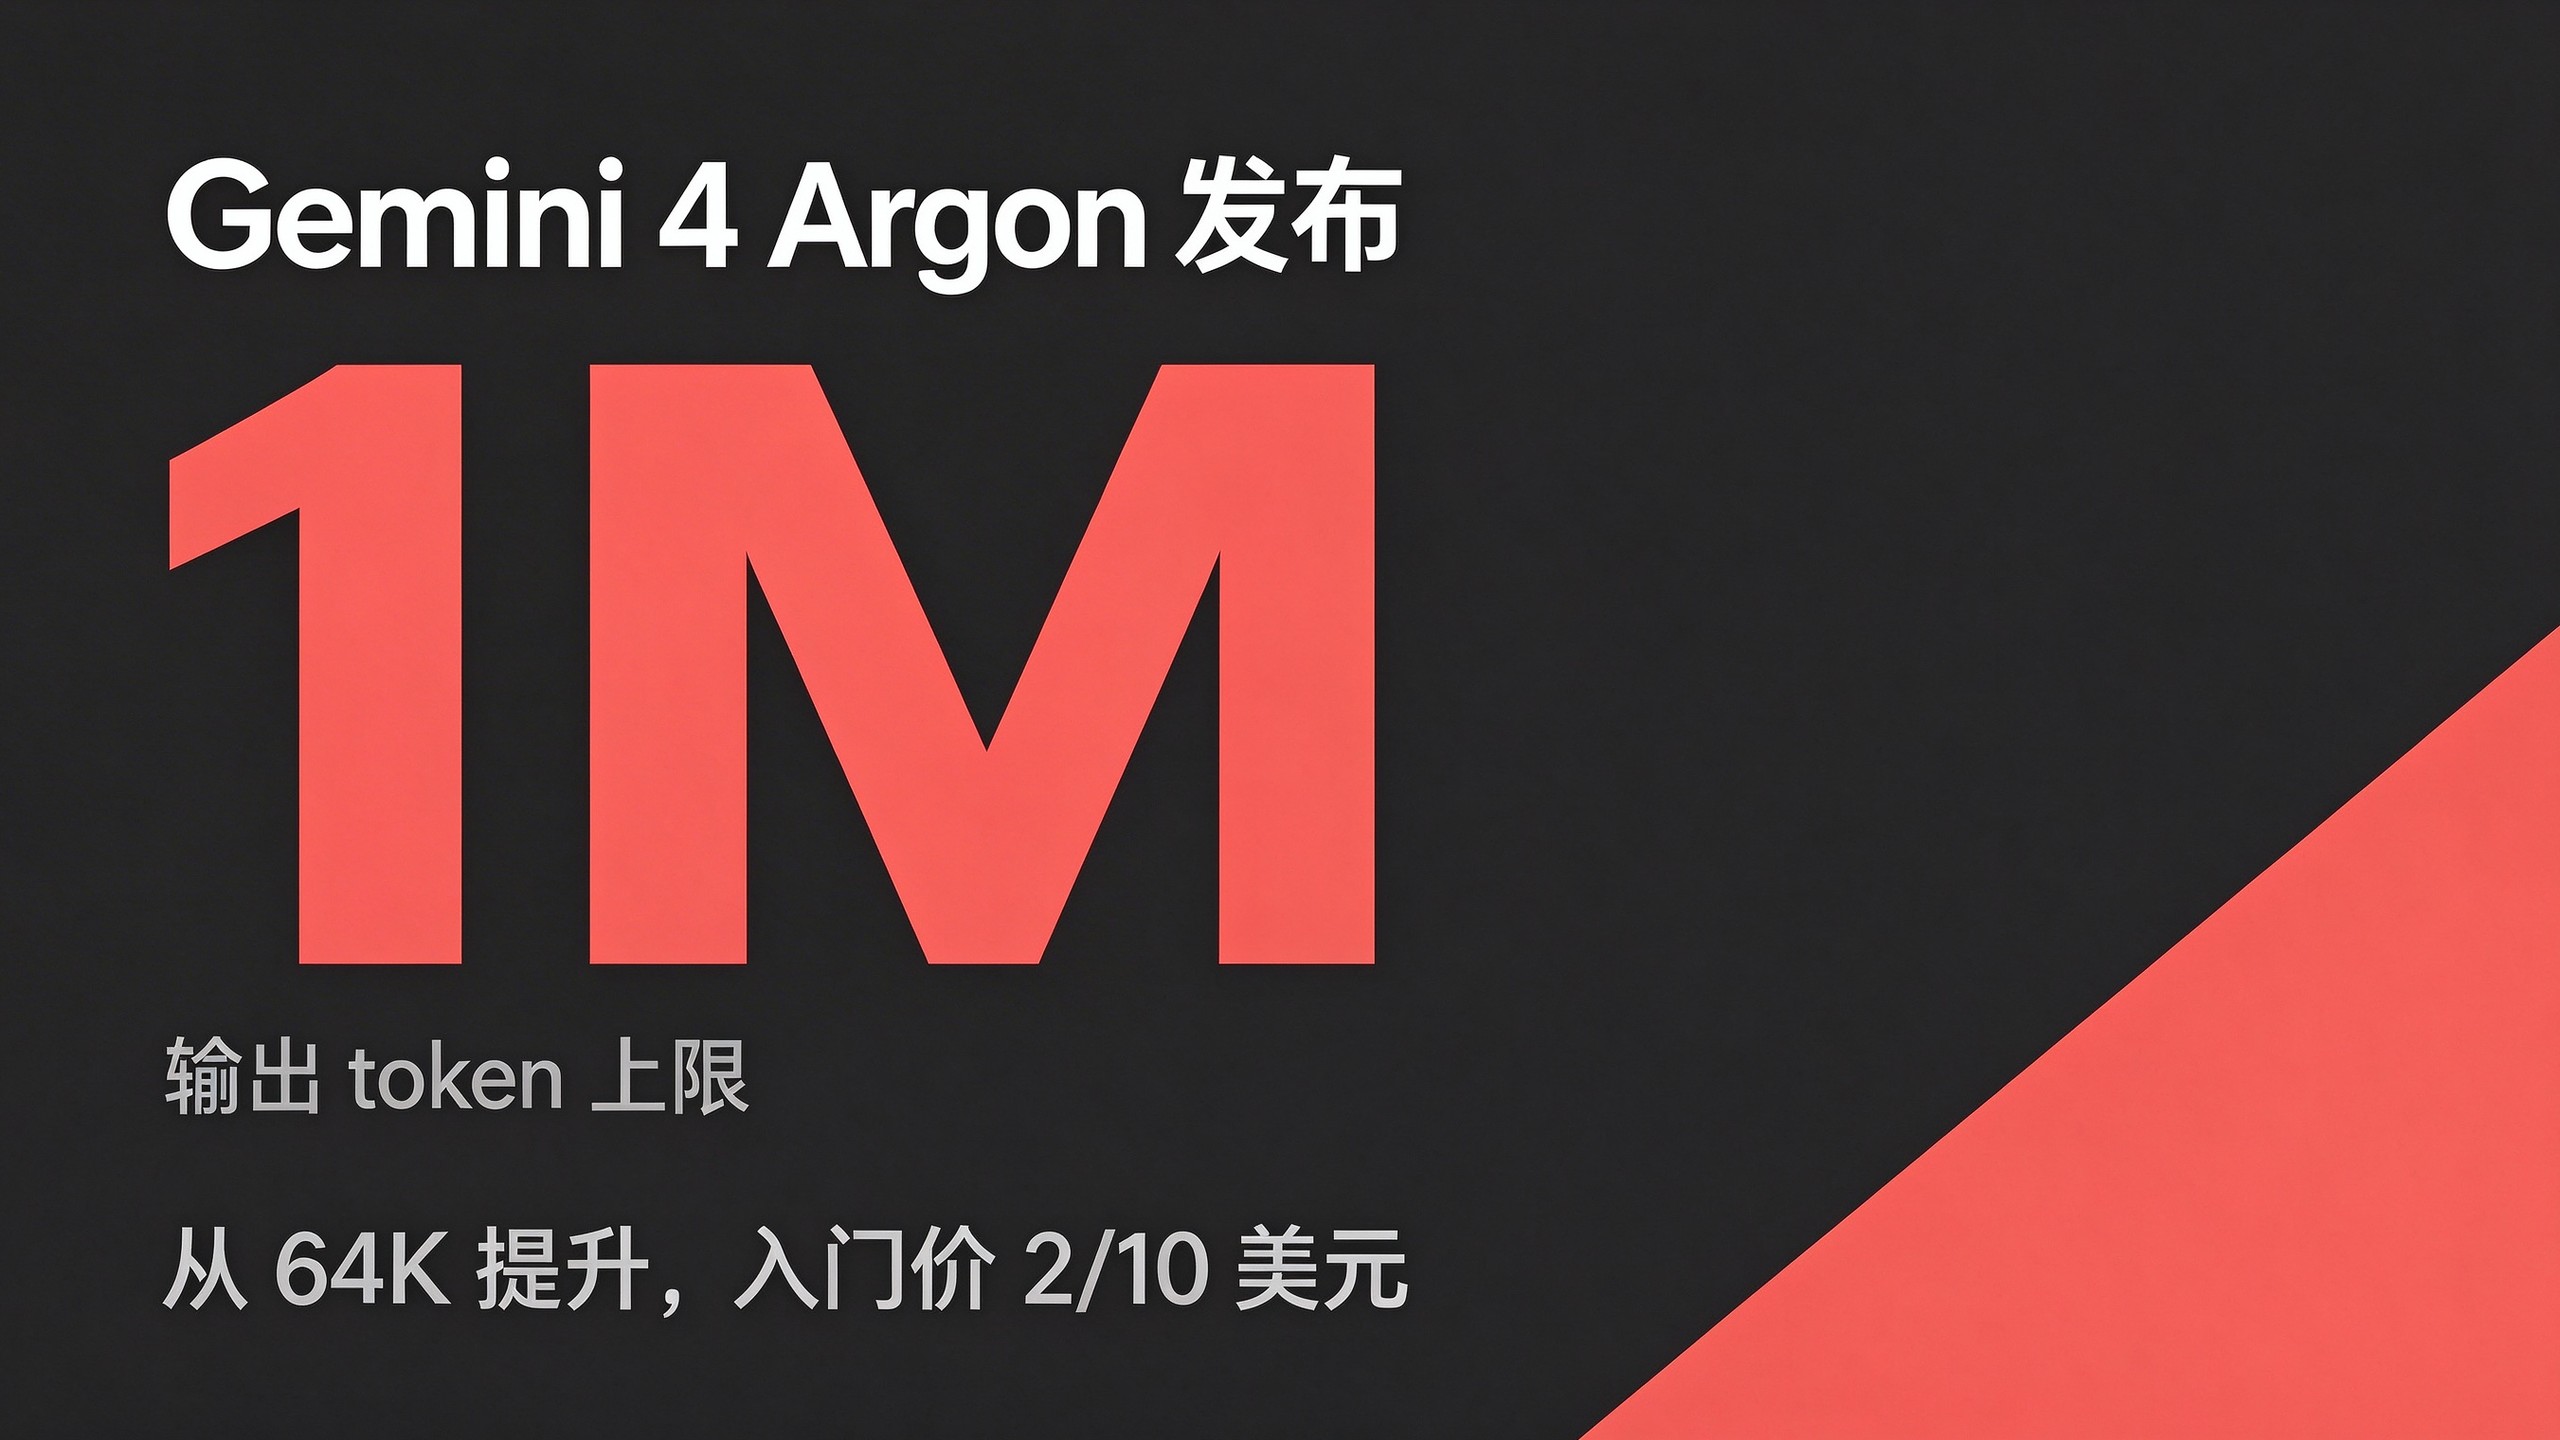
9 月 30 日,Google DeepMind 发布新前沿模型 Gemini 4 Argon。它面向复杂、长程工作流的深度推理设计,官方称在真实软件工程、法律与金融等企业知识工作、以及网络安全防御三类场景上达到前沿水平。与以往不同的是首发方式:Argon 先通过 Fairwind Program 定向提供给一批可信网络防御者,Google 同时正参与美国政府关于「发布前模型访问」的自愿流程,之后才会面向开发者、企业与消费者开放。
Google 给出的入门价为每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入按输入价的 5% 计费(优惠 95%)。
关键规格:输出上限从 64K 拉到 1M
支撑长程任务的核心变化是输出上限:Argon 的输出 token 上限从此前的 64K 提升到 100 万(1M),达到官方所称的「行业领先」。Google 的说法是,当模型有足够空间在单条轨迹里持续思考、生成数十万 token 时,难题可以一次做完,推理深度也随之上一个台阶。
基准:知识工作与多数评测领先,工程类有失分
按 Google 官方博客附图整理的对比(列为同场对比模型):
| 基准 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench Score | 51.3% | 41.4% | 31.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| Harvey’s Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| GraphWalks(256k–1M,BFS F1) | 84.2% | 71.8% | 65.0% | 66.8% |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
要点:
- DeepSWE v1.1 拿到 77.9%,官方称为新 SOTA,该基准衡量真实世界长程软件工程任务。
- Vals Index(按各行业对美国 GDP 贡献加权,衡量金融、编码、法律、税务的经济影响)以 68.9% 居首,Zapier 的 AutomationBench 以 51.3% 排名第一,长视频理解 LVBench 达到 91.7%。
- 失分同样明显:FrontierSWE v2(55.0%)落后 GPT-6 Astra 的 65.5%,Terminal-bench 4.0 也由 Claude Opus 5.5 领跑。
- 网络安全 CWE-bench v1 上 Argon 以 68% 并列第一,延续上一代 3.8 Flash Cyber 在 CWE-bench v0 的前沿表现。
Google 内部已经在用
Argon 已接入 Google 内部流程,数千名员工用它做专业编码、深度研究与写作,几个公开案例:
- 量子算法优化:帮助量子计算研究者优化那些拖累关键应用的子程序的时空资源(量子比特 × 门数),其中一个例子在几分钟内把已发表基线改进 40%。
- 内存优化:一组 Argon 智能体分析 fleet 级性能剖析遥测,自主识别并落地数据中心的内存优化,全部上线后可释放 300 TiB 以上内存,官方估算总节省在 500 TiB 到 1 PiB 之间。
- C/C++ 迁移到 Rust:从 re2、libgav1 等核心库的数万行,扩展到 Fuchsia Zircon 内核的 80 万行以上;由于这些系统关键,大规模重写要经过严格的自动与人工审计、仿真测试与评审才会进入生产。
- libgav1 实测:Argon 智能体在已有 Rust 移植版基础上替换了 3.2 万行 SIMD 代码,做法是跑多轮性能剖析实验、研究编译器输出、写出能让编译器自动向量化的安全 Rust,最终得到视频输出完全一致、比 Rust 移植版快 2.7 倍的内存安全解码器,进一步逼近优化过的 C++ 版本。
网络安全:面向防御者发布,且不带「网络护栏」
Argon 被训练为可自主发现、验证并修补关键软件漏洞。对受信任的防御者与 Google 自家内部团队,Google 将以不带网络护栏(cyber guardrails)的形态释放 Argon,让他们用上完整的前沿级防御能力。
Wiz 已通过其 Scan for Good 计划(免费为关键公共基础设施排查高风险暴露)使用 Argon。早期演示中,模型发现了全球医院所用医疗软件里暴露敏感个人信息的关键漏洞——官方称这一严重风险被此前的前沿模型漏掉。在衡量漏洞修复能力的 CWE-bench v1 上,Argon 以 68% 并列第一;在覆盖 20 种编程语言的 Google 内部漏洞基准上,它暴露了复杂代码库中的多类问题;在 Wiz 的黑盒渗透测试基准(无源码、分析线上 Web 系统)上,它在攻击面发现、漏洞识别与验证性 PoC 产出三项上都超过 3.8 Flash Cyber。
广泛开放前,先补四类前沿安全
- 防滥用:按 Frontier Safety Framework 拒绝网络与 CBRN(化学、生物、辐射、核)相关恶意请求,同时保留正当的两用科研;本次发布会加强对模型内部激活的监测以发现滥用,保障措施经内外部红队以手工加自动化方式做过稳健性测试。
- 防提示注入:通过自动化红队与对抗训练,Argon 是目前抗间接提示注入最强的模型,在 Gray Swan 的 IPI 基准上领先。
- 失准(misalignment)监控:对 Argon 的思维链与动作进行监控,必要时中止执行;训练期间也用类似系统告警给专门的事件响应团队,且刻意不把发现回灌进训练,以免塑造出「绕开监控」的推理方式。DeepMind 同时公开呼吁行业在能力跃升的关键期保留推理透明度。
- 系统加固:按智能体控制路线图,在高风险训练或评测开始前把沙箱环境隔离并「密封」,并计划与伙伴分享智能体安全最佳实践。
何时可用
Argon 的能力覆盖编码、知识工作、网络安全防御与创意写作。首发范围是 Fairwind Program 的网络防御者与可信测试者;在护栏根据反馈迭代后,将先向付费 API 客户与 Google AI Ultra 订阅者开放,再逐步推向开发者、企业与消费者。
核心总结
- 规格:输出上限从 64K 提升到 100 万 token,为长程单轨迹推理留出空间
- 价格:入门价每百万输入 2 美元、输出 10 美元,缓存输入再降 95%
- 成绩:DeepSWE v1.1 77.9%(官方称 SOTA)、Vals Index 68.9%、AutomationBench 51.3%、LVBench 91.7%、CWE-bench v1 68% 并列第一;FrontierSWE v2、Terminal-bench 4.0 落后对手
- 落地:Google 内部用于量子算法优化、数据中心内存优化(300 TiB+)、re2/libgav1/Zircon 的 Rust 迁移
- 发布方式:先经 Fairwind 交给可信防御者,且对防御者不带网络护栏;再开放给付费 API 客户与 AI Ultra 订阅者
- 安全:防滥用、抗提示注入、思维链与动作监控、沙箱加固四条线并行,训练期发现不回灌
原文:Gemini 4 Argon: our next era of frontier intelligence(Google DeepMind,2026-09-30)


