10 月 29 日,Mistral 与 vLLM 团队联合发布博客,宣布 Mistral Large 4(ML4)在 vLLM 上获得 Day-0 支持,并把这项工作形容为「不止一个模型文件」:模型只在 vLLM 的 model runner V2(MRV2)上运行,配合可断点的 CUDA Graph,最终同时产出了 decode 上下文并行(DCP)、prefill 上下文并行(PCP)、DSpark 推测解码、基于 NIXL 的 P/D 分离与 HiSparse 主机内存 KV 卸载等通用能力。
按博客给出的数:TP8 上 DCP 把 KV 容量从 360 万 token 扩到 2876 万(NVFP4),可同时容纳 27 条 100 万 token 的请求;内置 DSpark 草稿器每步接受 约 2.9 个 token,TP8 的 c1 TPOT 从 8.84 ms 降到 3.50 ms,输出吞吐约 2 倍。同一天,AMD Instinct MI350 与 TPU v7x 的支持、以及 SkyRL 上的 Day-0 强化学习也一并就位。
先看模型:72 层、1T/49B、MLA + DSA
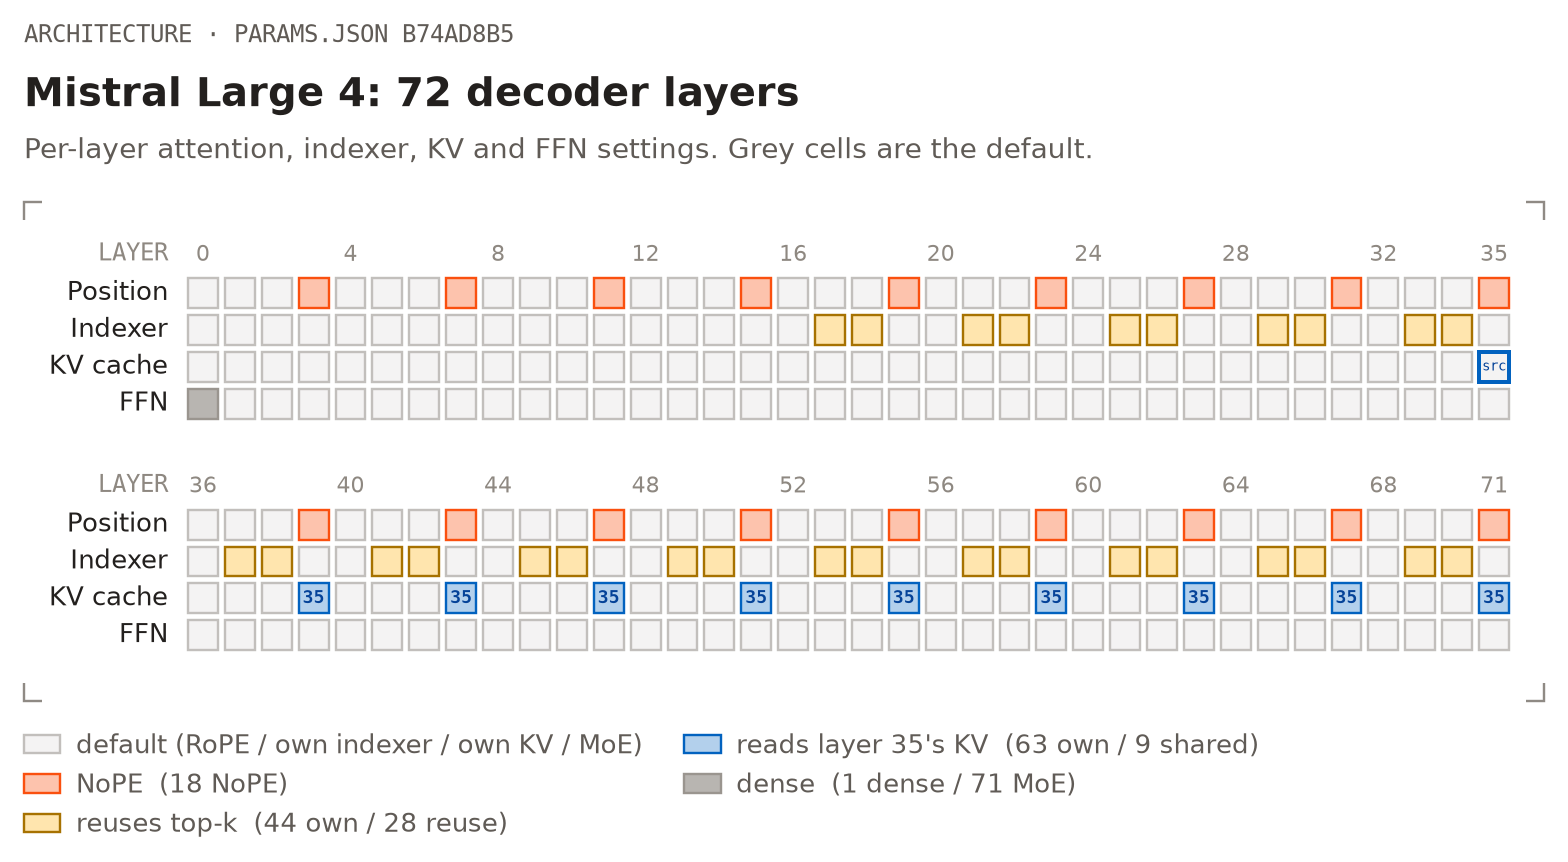
ML4 是 Mistral 首个万亿参数级前沿 MoE,原生多模态。它的注意力部分是「DeepSeek 味」的稀疏栈:MLA 加 DSA top-k 索引器,每 token 存 47,136 字节 KV——41,328 字节给 MLA latent,5,808 字节给索引器。在这之上叠了四个新特性:跨层 KV 共享、NoPE 层、SSMax 与 LeRoPE。
| 组件 | Mistral Large 4 |
|---|---|
| 层数 / 隐藏维度 / 头数 | 72 / 6144 / 64 |
| 注意力 | MLA,无 query LoRA,KV LoRA rank 512,RoPE 维 64 |
| 稀疏注意力 | DSA 索引器,top-k 2048,32 个 index head |
| indexer 分布 | 44 层自持,28 层复用最近前序 indexer 层的 top-k |
| 位置编码 | YaRN + LeRoPE;每第 4 层为 NoPE |
| KV 共享 | 第 39、43…71 共 9 层读第 35 层的 latent 缓存 |
| MoE | 第 0 层 dense;1–71 层 128 专家、top-4、1 个共享专家 |
| 视觉 | Pixtral 编码器(30 层、隐藏 2048、patch 14) |
这几个数字直接决定了实现方式:72 层里只有 63 层真正持有 KV 缓存,其余 9 层只读不写;同时只有 44 层需要跑索引器。博客把这套逐层差异做成 params.json 驱动的 layer spec,而不是在共享代码里堆模型专属分支——这也是新增 vllm/models/mistral/ 组件包、把 ML4 实体放在 vllm/models/mistral_large4/nvidia/model.py 的原因。
权重提供两个版本:FP8(block-scaled 权重)与 NVFP4(专家 NVFP4、注意力与共享专家 FP8),默认都使用 fp8_ds_mla 的 FP8 latent KV 缓存。博客专门论证了 NVFP4 不掉点:在多模态、长上下文、智能体编码、业务自动化与网络安全评测上,每项任务与 FP8 的差距都在 2.1 分以内,平均差 −0.3 分,平均输出 token 数相差约 4%;而在 TP8 上,NVFP4 单 token decode 比 FP8 快 1.08–1.19 倍(开 DSpark 后 1.18–1.22 倍),KV 缓存多出约 1.5 倍。
不用 torch.compile:可断点 CUDA Graph 加手写融合
ML4 不走 torch.compile,而是用可断点 CUDA Graph(模型位于多模态封装内时也会自动启用),博客称相对 eager 模式约有 6 倍加速。编译器原本要做的事,换成手写融合补上:
- 第一轮融合 SSMax、MLA RoPE + SSMax、索引器 Q 路径与 K 路径,decode TPOT 降 8%–10%。
- decode 轮把 FP32 router GEMM、索引器 query 的单次 Triton LayerNorm、all-reduce + residual + RMSNorm 合成一个 FlashInfer 内核,索引器 K 直接写入 FP8 缓存;TP8 FP8 下 c1 TPOT 从 10.22 ms 降到 9.00 ms(−12%),c8 从 16.01 ms 降到 15.08 ms。
长上下文:DCP 换容量,PCP 换首 token
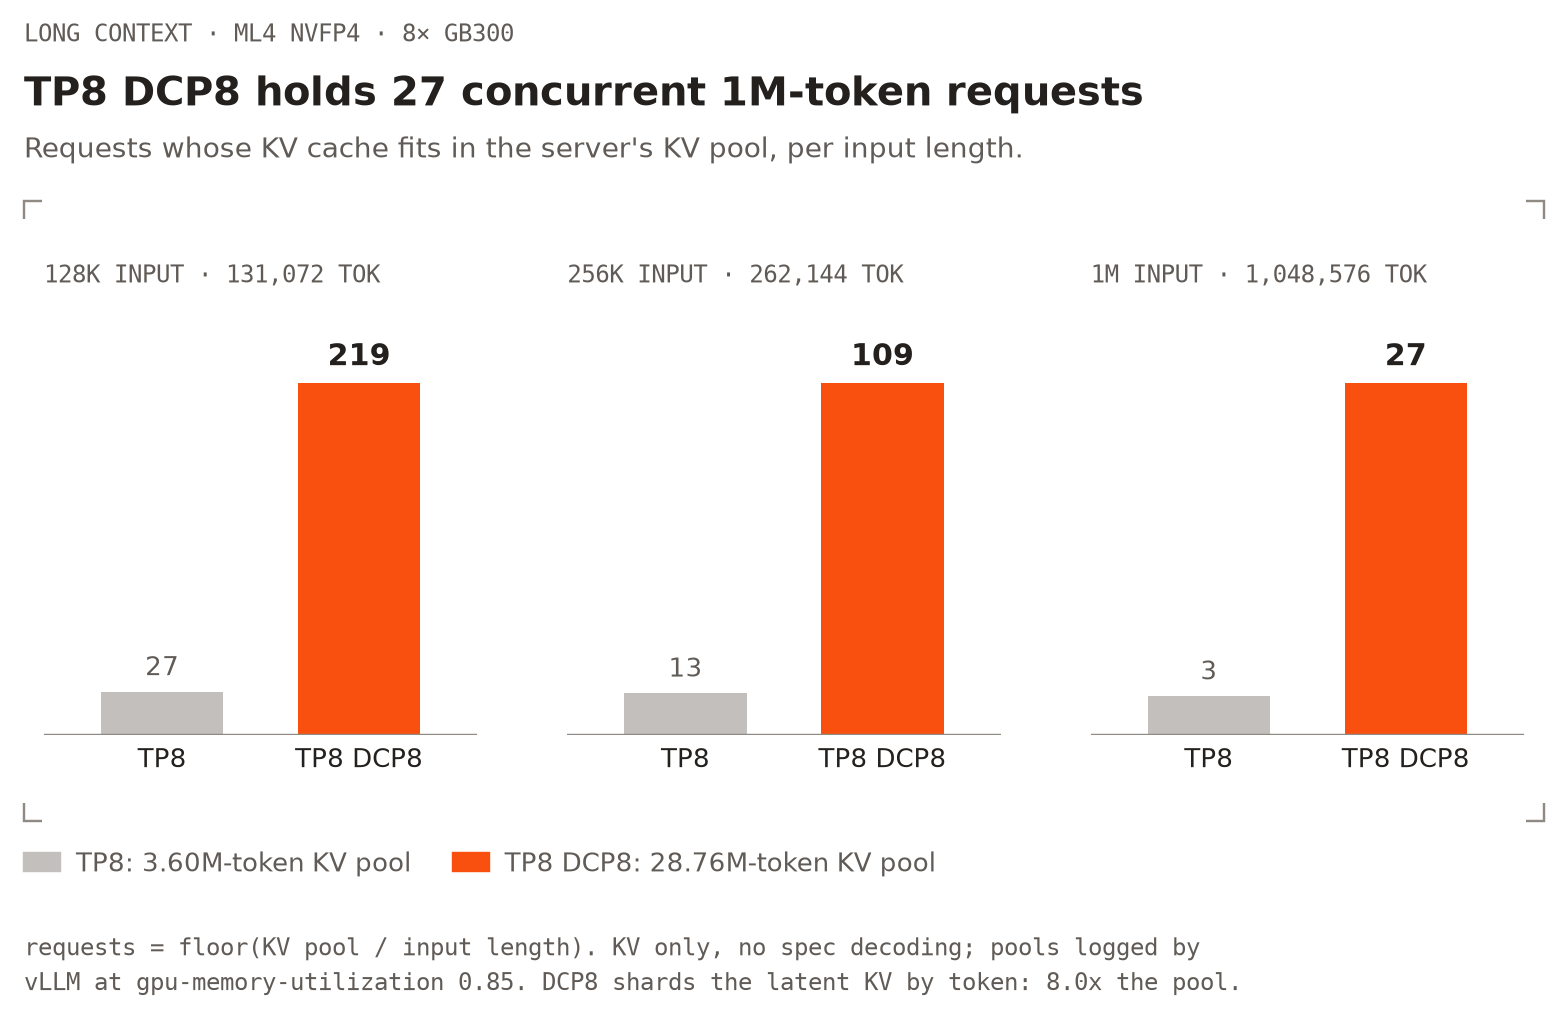
MLA 只保留一个 latent KV 头,所以张量并行(TP)下缓存会在每个 rank 上复制一份。DCP 改为按 token 切分:TP8 上 DCP8 把 KV 池从 238 万提到 1888 万 token(FP8),从 360 万提到 2876 万 token(NVFP4),正好 8 倍——DCP8 分片后,8 块 GB300 能同时装下 27 条 100 万 token 请求,而纯 TP8 只有 3 条。
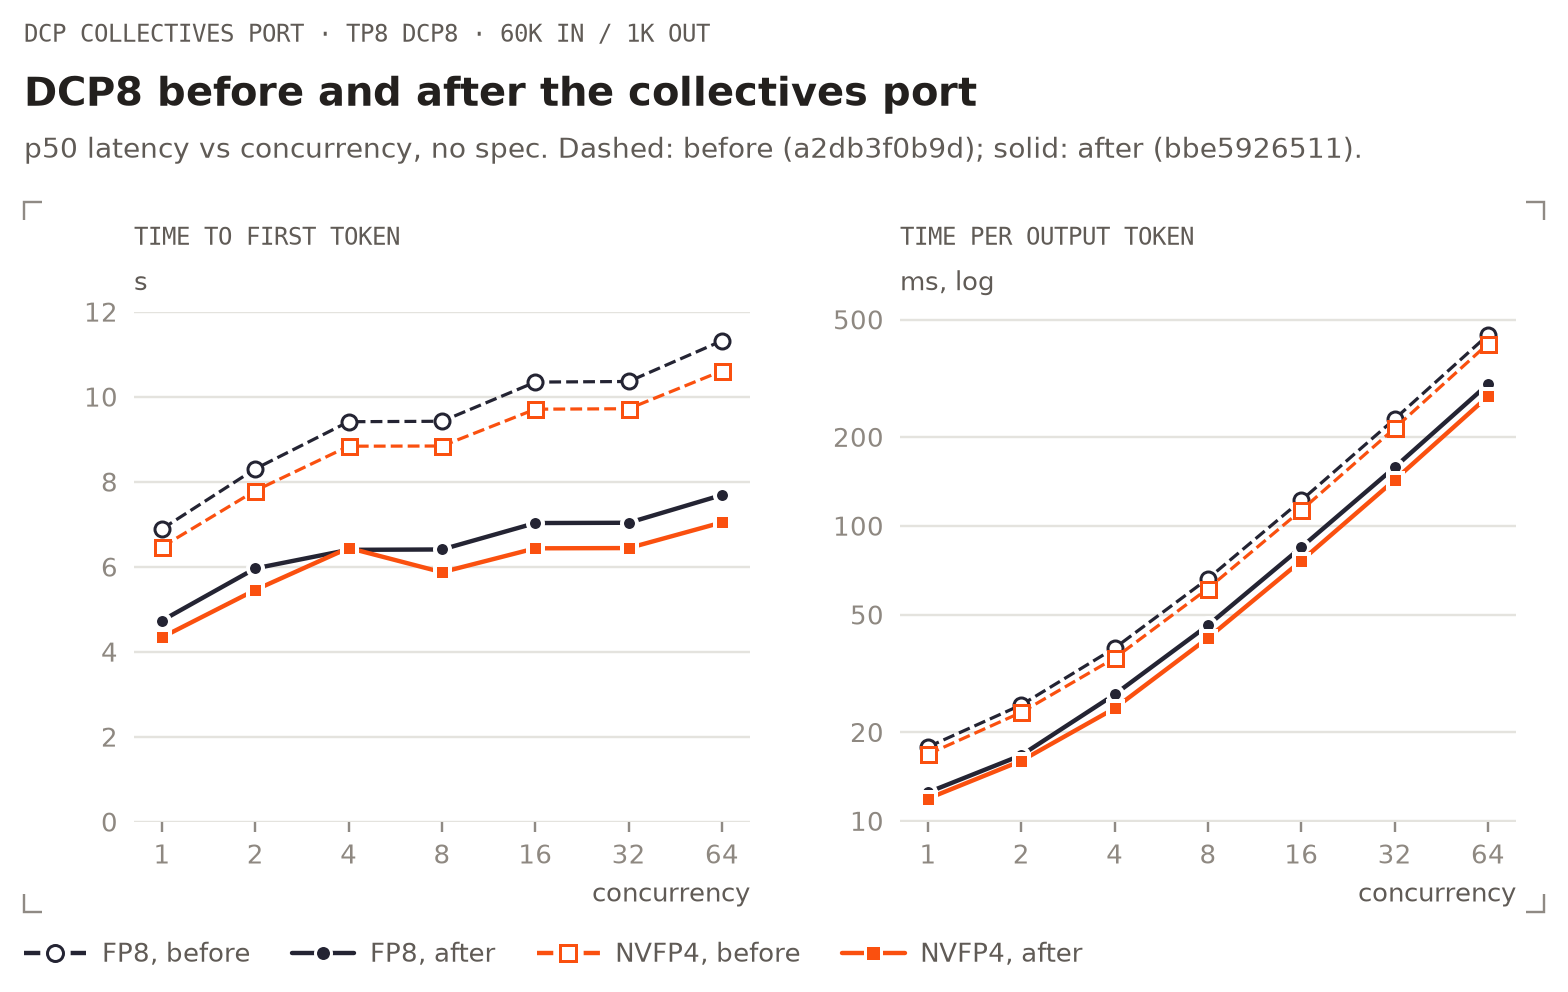
代价是每步的固定开销。稀疏 MLA 下,60k 上下文的 profile 显示每步约有 7 ms 纯 DCP 工作:LSE 与索引器 top-k 候选的 NCCL all-gather(44 个 indexer 层)、reduce-scatter、稳定 top-k 归并、query gather、小 mask 内核与启动间隙。四项改造把它压到 3.2 ms:
- a2a combine:用对称内存 all-to-all 合并 LSE,替代 all-gather + reduce-scatter,已合入 vllm#61285,ML4 默认启用。
- 直接交换 top-k:每个 rank 把打包好的(分数、id)候选推进对端对称内存收件箱,选择器原地读取,省掉一次 NCCL all-gather 和每层 6 趟 radix select。
- top-k 压缩:batch ≥32 token 时只扫有效槽位,用
topk_length约束内核,不再扫满 2048 个填-1的槽;5k token prefill 的注意力从 165 ms 降到 38 ms。 - 一个融合内核处理空行(某 rank 不持有该 query 的任何 top-k 槽)。
叠加 decode 融合后,TP8 DCP8 FP8(60k 输入 / 1k 输出)的结果是:c1 TTFT p50 从 6.89 s 降到 4.73 s,c1 TPOT 从 17.82 ms 降到 12.50 ms,c64 输出吞吐从 139.1 升到 204.0 tokens/s(+47%)。
博客也明确写了 DCP 何时不该用:它用单步延迟换 KV 容量。同样的 8× GB300 NVFP4 部署上,DCP8 每 token decode 比 TP8 慢 16%–28%(c1 TPOT 8k 输入 11.1 对 8.7 ms,60k 输入 11.4 对 9.1 ms);128 条以内 8k–60k 的请求根本用不到 360 万 token 的池子,此时 TP8 吞吐更高。只有当 KV 成为瓶颈时才划算——在约 10 万 token 的智能体会话里,TP4 DCP4 的 decode 节点在 32 会话时 TTFT 仍保持 0.7 s,而普通 TP4 节点 KV 耗尽后一路涨到 15 s。
prefill 一侧,PCP 把单条 prompt 的 token 切到多个 rank,PCP+DCP 现在能在 ML4 上配 CUDA Graph 工作(含 DCP > PCP 与 DSpark)。两个修复点很具体:PCP 下 MLA 写缓存前要 all-gather 输入,而这次 gather 依赖 batch 的 prefill/decode 切分,被分段图捕获后就被冻结——现在只让 gather 以 eager break 跑进固定大小缓冲,写缓存本身留在图里;另一个是把 DCP 组的 rank 顺序对齐到 collectives 返回数据的顺序。修完后 TP1×PCP4×DCP4 开图,GSM8K-200 从 0.315 跳到 0.975,加 DSpark 为 0.980。
DSpark:并行的草稿器,一块块地猜
ML4 的 checkpoint 里直接带了 DSpark 草稿器(mtp_dspark.* 张量,params.json 里有 mtp 块)。DSpark 是并行草稿:小型非因果 transformer 一次前向提出整块草稿位置,条件取自目标模型第 1、18、36、54、71 层的隐状态。ML4 的版本加了三样东西:一个 rank 512 的门控循环状态(RNN Markov head),让每个草稿位置的 logits 依赖此前已草拟的 token;每个草稿槽独立的可学习 mask 输入嵌入;以及 3 层带 2048 token 滑窗、BF16 KV 缓存的 MLA 草稿层(自成一组 KV cache,Triton MLA 后端为此新增滑窗 decode)。
TP8、200 条真实 prompt、贪心解码、最多 512 输出 token 的实测:
| 并发 | FP8 基线 TPOT | FP8 + DSpark TPOT(接受长度) | NVFP4 基线 TPOT | NVFP4 + DSpark TPOT(接受长度) |
|---|---|---|---|---|
| c1 | 8.84 ms | 3.50 ms(2.90) | 8.21 ms | 2.95 ms(2.93) |
| c8 | 15.28 ms | 7.08 ms(2.85) | 12.85 ms | 5.80 ms(2.86) |
| c32 | 29.92 ms | 11.57 ms(2.85) | 25.38 ms | 9.80 ms(2.86) |
同等并发下,DSpark 把输出吞吐提高 1.9–2.1 倍(FP8)与 1.9–2.2 倍(NVFP4),且不改变模型输出:每个草稿 token 都经目标模型验证,标准拒绝采样保证无损。GSM8K(1,319 题)上 FP8 由 0.909 变为 0.918。采样时接受长度略降(T=1.0、top-p 0.95 下 c8 约 2.8),博客建议高温场景设 "draft_sample_method": "probabilistic":T=1.5 时接受长度从 2.04 提到 2.36–2.53,吞吐高 12%–22%。
DSpark 与 DCP 的组合此前不支持滑窗 MLA 草稿。做法是把草稿的小窗口缓存(3 层 × 约 2k token,每请求约 7 MB)在每个 DCP rank 上复制,目标缓存仍按 DCP 分片。TP8 DCP8、60k 上下文下 c1 TPOT 从 11.82 ms 降到 5.22 ms(2.26 倍),GSM8K-200 保持 0.965。代价是容量:DCP8 下每个 64 token 草稿块持有一个块 ID,其目标页覆盖 512 token,64k 上下文时容量降为纯 DCP8 的约 0.69 倍;在 max_num_seqs 128、平均上下文不到约 99k 时不会触顶。
P/D 分离:PCP4×DCP4 拿首 token,DP4/EP 拿吞吐
NIXL 的 1P1D 测试跑在 4+4 块 GB300 上:NVFP4 加两侧 DSpark、全开 CUDA Graph、关前缀缓存,8k / 32k / 60k 三档定长 prompt,每请求 1,024 输出 token,扫并发与固定 QPS 两条曲线。所有配置经代理跑 GSM8K-200 都在 0.965–0.980,NIXL 传输与请求零失败。
| prefill → decode | 8k,≥40 tok/s/用户 | 8k,≥100 | 32k,≥40 | 32k,≥100 | 60k,≥40 | c1 TTFT(8k/32k/60k) |
|---|---|---|---|---|---|---|
| DP4/EP → DP4/EP | 718.2 | 176.7 | 202.6 | 139.2 | 108.8 | 0.49 / 1.90 / 3.65 s |
| DP4/EP → TP4 | 459.2 | 194.2 | 205.2 | 150.0 | 107.2 | 0.46 / 1.88 / 3.66 s |
| PCP4×DCP4 → TP4 | 350.6 | 192.6 | 91.5 | 91.5 | 49.8 | 0.35 / 1.37 / 2.57 s |
| TP4 → TP4 | 259.2 | 185.3 | 62.8 | 62.8 | 32.3 | 0.52 / 2.07 / 4.02 s |
读法很清楚:要吞吐选 DP/EP,要首 token 选 PCP4×DCP4,而 60k 长输入下纯 TP4 的 prefill 已经明显吃力(32.3 对 108.8)。
AMD 与 TPU:MXFP4 专家与 16 芯片 TPU
AMD Instinct MI350 从第一天就能跑,包括 DSpark、图像输入与 MXFP4 专家并行。稀疏 MLA 走 AITER 的 MLA decode 内核,DSA 索引器走 gfx950 版本。拿到 MXFP4 专家有两条路:
- AMD Quark checkpoint(
amd/Mistral-Large-4-1T-A52B-Quark-MXFP4):只重量化路由专家,注意力、共享专家、dense FFN、router、输出头、视觉编码器与 DSpark 草稿器保持原精度,权重从约 1,061 GB 缩到 578 GB,因此能在 4 块 288 GB 的 MI350 上服务。 - 加载时重量化:
VLLM_FP8_MOE_REQUANT=mxfp4逐层把 FP8 专家转成 MXFP4,峰值内存只多一层 FP8 专家,TP4 也能装下;TP8 下每卡专家权重从约 125 GiB 降到 69 GiB,1–64 并发下输出吞吐比直接用 FP8 专家高 22%–71%。
在 MI350X、TP4、FP8 KV 缓存下,检查点自带的 DSpark 每步接受 3.1 个 token,单请求 per-token 延迟降 2.7 倍,8 并发降 1.9 倍、32 并发降 1.8 倍。ROCm 上 latent KV 默认是 FP8(E4M3),容量是 bf16 的 1.86 倍(每 token 42,096 字节对 78,384 字节)。此外还有一条低延迟专用路径:decode_backend: latency_specialized 把 1、2、4 请求的纯 decode 步按层做成单次常驻 FlyDSL 内核(256 个 CTA、两次张量并行 all-reduce 都在内核内完成),MI350X TP4 下单请求延迟降 1.5 倍,配 DSpark 后比「标准 decode 且不开推测」低 2.9 倍。这条路径是默认拒绝的:任何内核不支持的配置都会在启动时列出全部原因并失败,内核内的等待 10 秒超时,超时后置粘性故障字并终止引擎,避免跨卡挂死。
TPU 侧,ML4 在 TPU v7x 上 Day-0 可用,验证配置是机内 TP8 × 4 路数据并行、跨 16 芯片开专家并行,MLA latent KV 存 FP8、路由专家做 W4A16。
HiSparse:把 KV 挪到主机内存
稀疏注意力每 query 只读 2048 个 key,所以长请求的大部分 KV 并不需要待在显存里。HiSparse 把完整 latent KV 放在锁页主机内存,显存只留常驻工作集加每请求热缓冲,未命中时拷回选中的行,通过 HiSparseConnector 开启(示例配 440 GiB 主机池)。
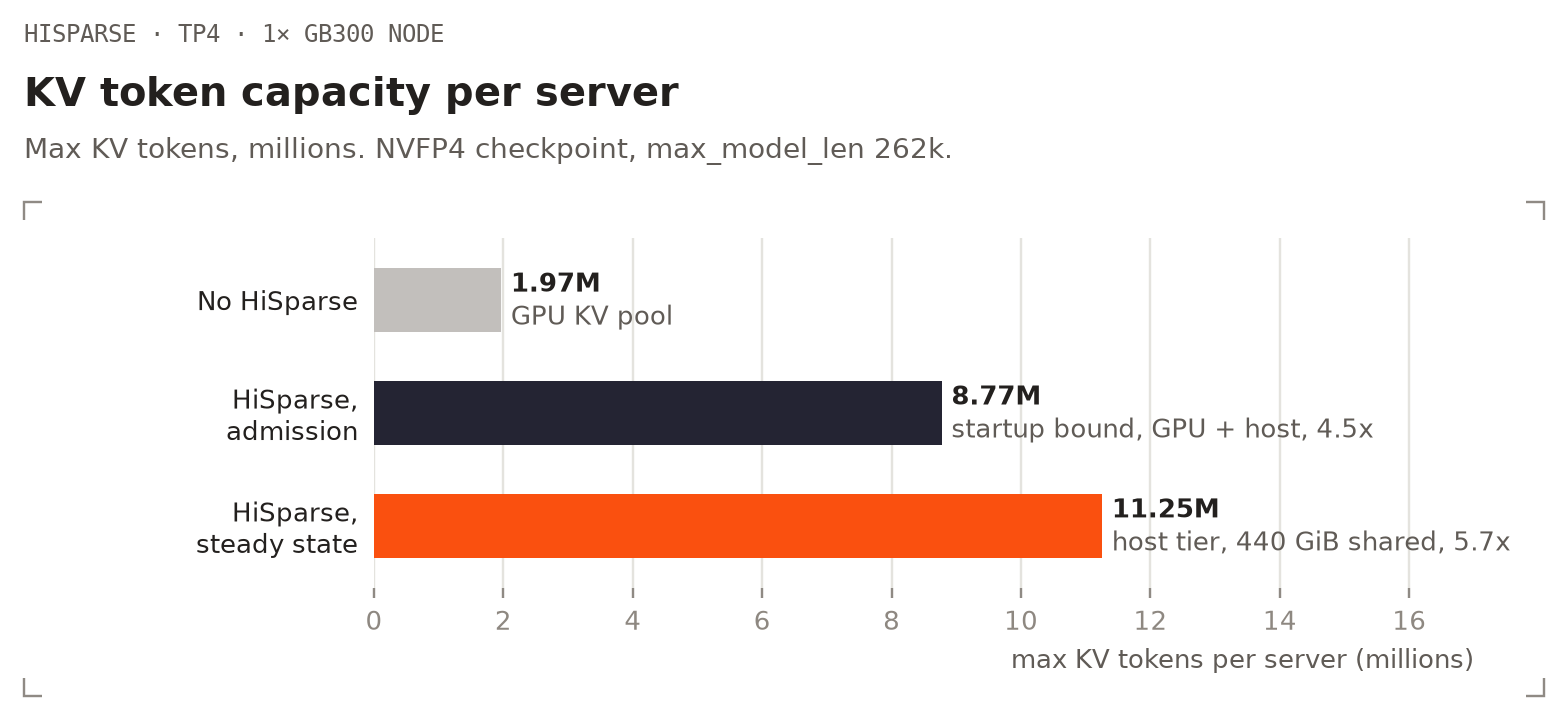
ML4 的改动是让 HiSparse 支持跨层 KV 共享:9 个消费层绑定到第 35 层的常驻视图与主机副本,各自只保留热缓冲与 LRU(各层有自己的索引器),不复制数据也不需要环境变量。相比把共享层实体化,同样的主机池能多放 14.3% 的 token。容量上,单台 GB300 节点(TP4、NVFP4、max_model_len 262k)4 个 TP rank 共享 440 GiB 去重主机池,启动时接纳 877 万 token、稳态可达 1125 万,而纯显存只有 197 万(4.5–5.7 倍);GSM8K-200 不变(两边均 0.975),大海捞针在约 98k(10/10)与约 248k(5/5)都通过。博客还挂了一个已知问题:单机 TP 组需设 VLLM_FLASHINFER_ALLREDUCE_BACKEND=trtllm,否则 HiSparse 把 KV 溢出到主机后,默认的 MNNVL all-reduce 可能让引擎崩溃(vllm#64327,修复在 flashinfer#7782)。
Day-0 强化学习:SkyRL 上的 AIME 曲线
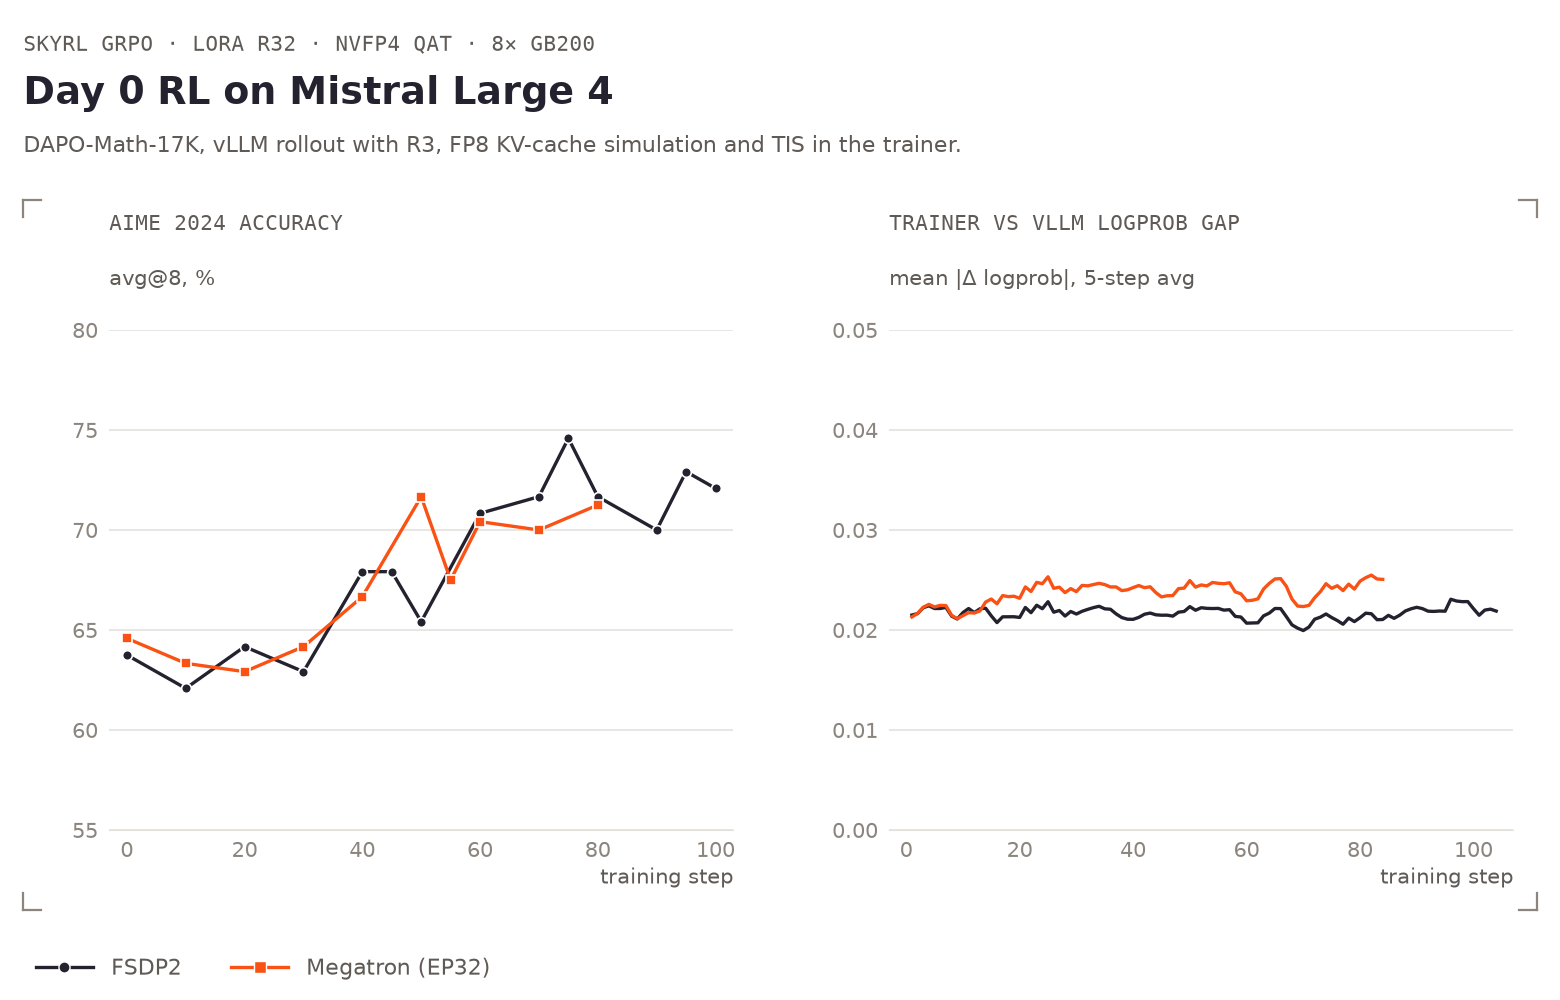
同一个模型也能立刻用来做 RL:SkyRL 在 8 台 GB200 节点上支持 ML4,rollout 用 vLLM,训练侧可选 FSDP2 或 Megatron。trainer 在 NVFP4 checkpoint 上跑 LoRA(rank 32)并做 NVFP4 量化感知训练,模拟 vLLM 实际服务的 FP8 latent KV 缓存,再用 Rollout Routing Replay(R3)与 token 级截断重要性采样对齐训练与推理。DAPO 配方下,AIME 2024 的 avg@8 在 75 步内从约 64% 升到约 75%,trainer 与 vLLM 的平均绝对 log-prob 差全程保持在 0.02–0.026;Megatron 后端(EP32、与 4 个 TP8 vLLM 引擎同置)精度曲线一致,单步快约 30%。
核心总结
- 模型:72 层 MoE、128 路由专家 top-4 加 1 共享专家、隐藏 6144,总计 1 万亿参数、每 token 激活 490 亿(含嵌入与输出层 520 亿);MLA(KV LoRA rank 512、RoPE 64)+ DSA 索引器 top-2048,44 层自持索引、28 层复用,9 层跨层共享第 35 层 KV,每第 4 层为 NoPE
- 精度:FP8 与 NVFP4 两个 checkpoint,均默认
fp8_ds_mlaKV;NVFP4 每项评测与 FP8 差距 ≤2.1 分、平均 −0.3 分,token 消耗差约 4%,TP8 上快 1.08–1.19 倍、KV 多 1.5 倍 - 运行时:只跑 MRV2 + 可断点 CUDA Graph(不用 torch.compile,约 6 倍于 eager),手写融合把 c1 TPOT 从 10.22 ms 降到 9.00 ms
- 长上下文:DCP8 在 TP8 上把 KV 池扩到 1888 万(FP8)/2876 万(NVFP4)token;DCP 每步开销 7 ms → 3.2 ms,c64 吞吐 +47%;代价是每 token 慢 16%–28%,KV 不紧张时应用 TP8
- 推测解码:DSpark 每步接受约 2.9 token,c1 TPOT 8.84 → 3.50 ms,吞吐 1.9–2.2 倍且无损;与 DCP 组合在 60k 上下文下再降 2.26 倍,容量代价约 0.69 倍
- P/D 分离:1P1D(4+4 GB300)上 DP4/EP→DP4/EP 在 60k、≥40 tok/s/用户时达 108.8 tok/s/GPU;PCP4×DCP4 prefill 节点把 c1 TTFT 压到 0.35/1.37/2.57 s
- 多硬件:AMD MI350(AITER + MXFP4 专家,单节点两块 TP4 副本)与 TPU v7x(TP8×DP4、16 芯片 EP)同日可用;HiSparse 配 440 GiB 主机池把单机 KV 容量提到 4.5–5.7 倍;SkyRL 上 75 步把 AIME 2024 从约 64% 提到约 75%
- 下一步:跨层 KV 共享、DSpark 滑窗草稿与 DCP 下 DSpark、HiSparse KV 共享陆续上游(vllm#64095、#63795、#63796),并计划做带 DSpark 的 DCP decode 节点、独立草稿块池与多节点共享主机池
原文:Day 0 support for Mistral Large 4 on vLLM(vLLM Blog,2026-10-29)
参考:


