10 月 27 日,Google DeepMind 发布世界模型 Genie 4。与上一代 Genie 3(2025 年 8 月,720p、24 fps,能在实时交互中维持数分钟一致性的世界模型)相比,这一代的跨越不只在画面清晰度:它首次让实时世界模型原生生成音频——环境声、氛围音乐感的声音,乃至能与你实时对话的人物,都与世界画面一同生成。
目前 Genie 4 只以研究预览形式开放给可信测试者,之后才会进入 Google AI Ultra 订阅者的 Project Genie,以及 Gemini API 与 Google AI Studio 的早期访问伙伴,官方已开放等待名单。
四个关键能力
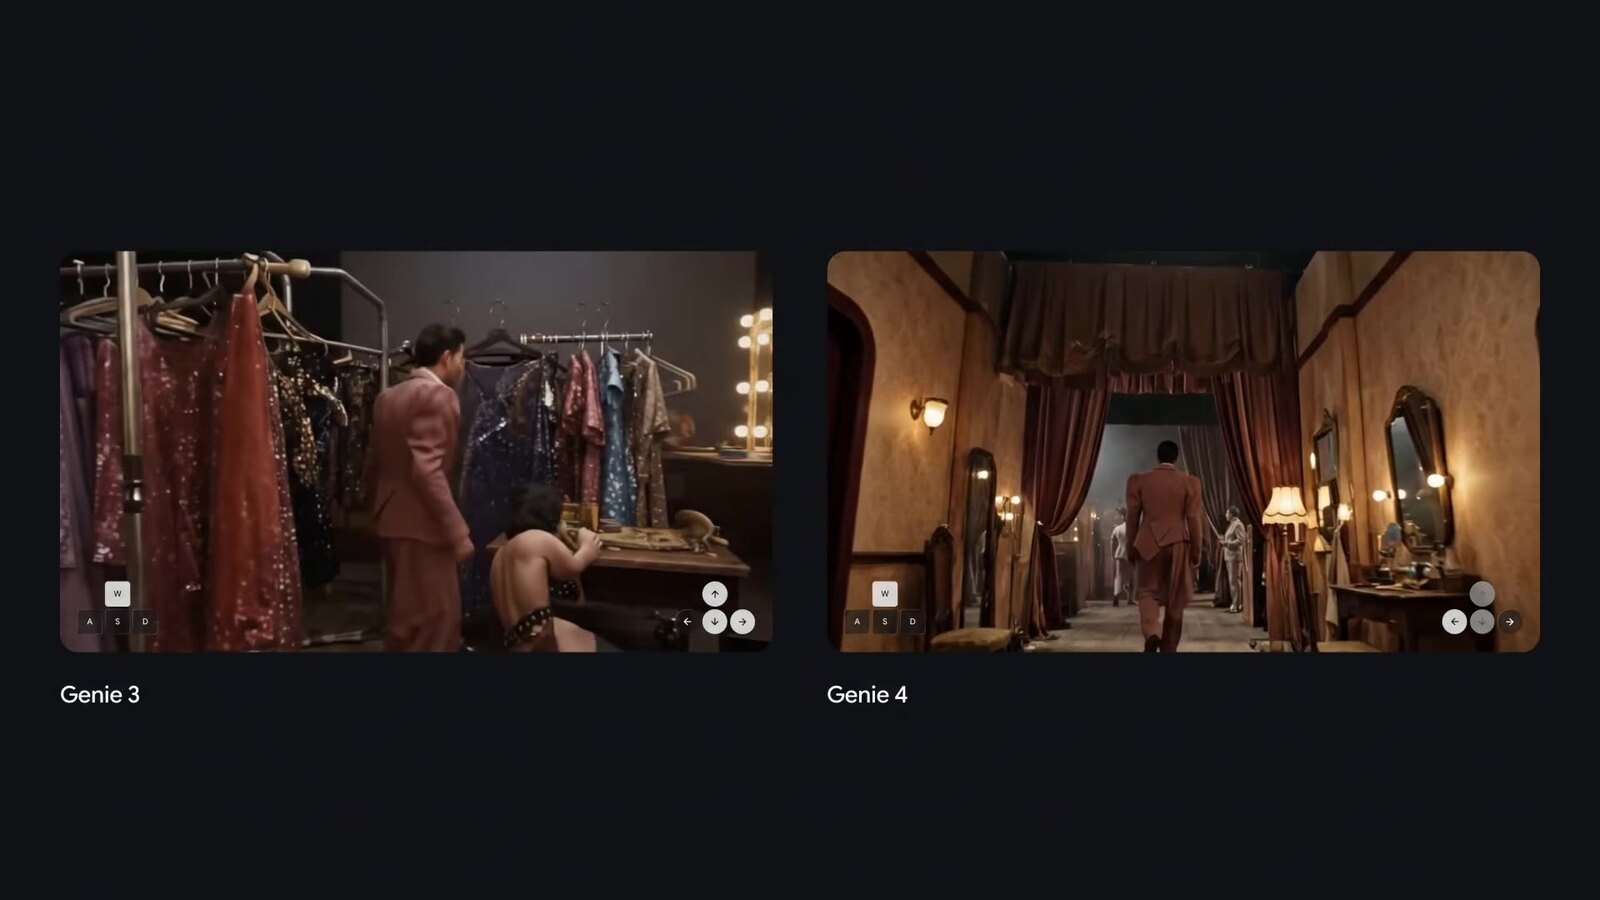
实时塑造世界:用户可以用自然语言随时修改模拟——换天气、移机位、加入一个新的人或物。Gemini 会把你的提示词结合周边场景做改写;而在两次输入之间,Gemini 也会持续观察并引导场景,让世界连贯地推进下去。
物理与人物的真实感:Genie 4 建立在对世界的物理理解之上,能模拟空气动力学、碰撞等真实场景。官方称最大的跃升在于「人」——角色移动自然、对环境作出有机响应,并且可以被实时操控。
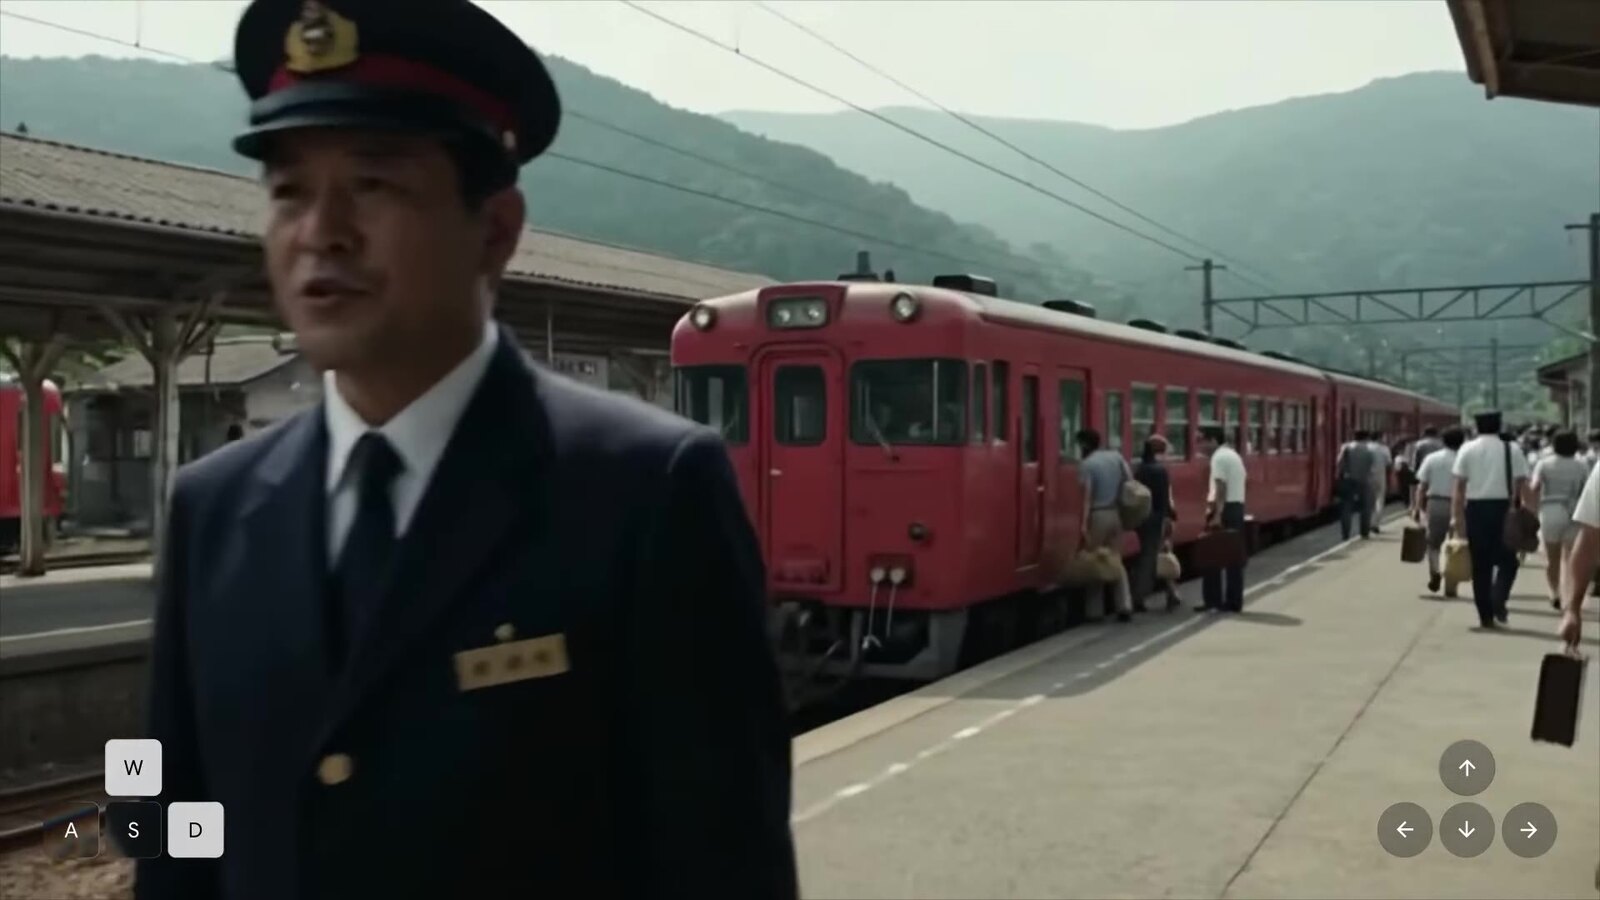
原生音频:每个世界自带属于它的环境声,从林间风声到拍岸海浪。DeepMind 把真正的难点放在人类语音上:Genie 4 的交互式对话能在运行中即时适配,角色会回应你的输入,也会对世界里发生的事件作出反应。
由 Gemini 规划的多步事件:这可能是最具工程意味的一点。Gemini 3.8 Flash 在回路中担任引导智能体——一边观察 Genie 实时生成的世界,一边把目标拆成步骤序列,再回看每一帧来跟踪进度、确认上一步是否成功;当世界发生变化或用户介入时,计划随即调整。DeepMind 称这让模拟具备了可靠的因果性、程序化行为与多步推理。
世界模型与 Gemini 的分工
Genie 4 并非孤立模型,而嵌在 Gemini 家族里:Gemini Omni 负责把模拟锚定在真实世界的外观与行为上,其他 Gemini 模型提供维持连贯与持续所需的推理能力。官方演示中,Gemini 的规划过程以「REASONING STEPS」面板直接叠在画面上,例如:「用户输入『wind blows on silk』,触发了已建立的世界规则——风速上升会让粉色缎带扬得更高、波动更快。」
DeepMind 把这称作通向混合世界模型(hybrid world models)的早期一步:语言与代码模型在幕后负责结构、拆解与叙事时间线,Genie 负责逐像素渲染即时的物理现实。两者互补,可能得到比任何单一路线都更连贯、更可控、也更接地气的世界模型。
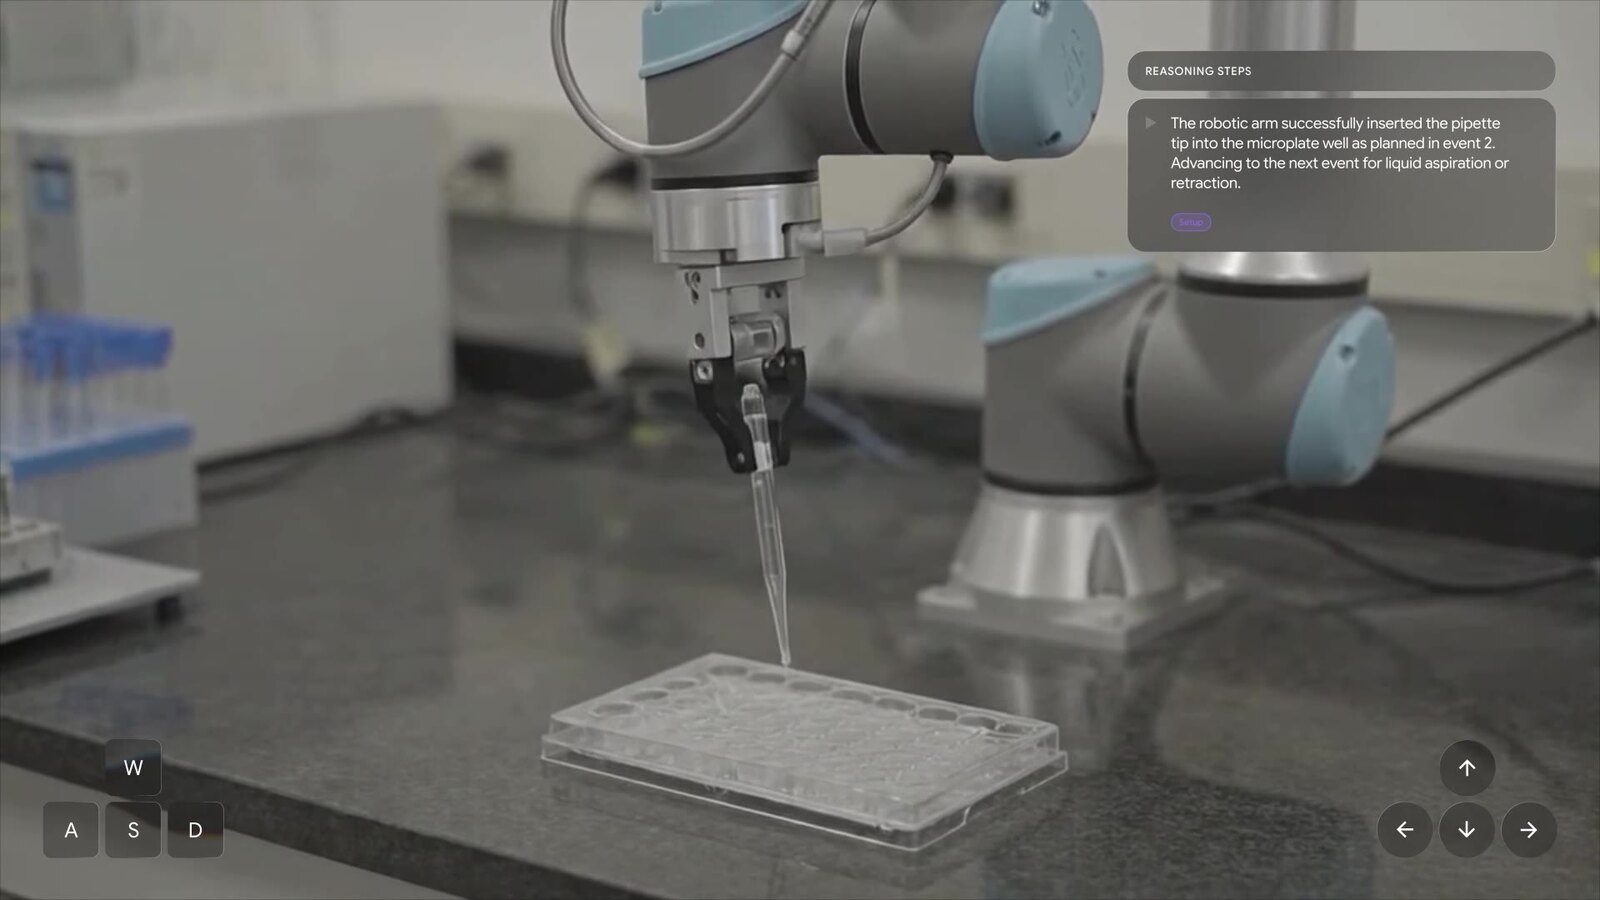
这条路线同样延伸到机器人。DeepMind 用 Gemini 4 Argon 与 Genie 4 做了联合实验:Argon 把用户指令拆成步骤,作为文字提示穿插进正在渲染的 Genie 4,于是模拟可以在推进过程中被逐步调整,直到任务完成。演示之一是 Apptronik 的 Apollo 人形机器人下跳棋,另一个是 Universal Robots 的 UR5 机械臂用移液器向微孔板加液。
测试者的四类用法
DeepMind 与创意、新闻、教育、游戏与工程领域的可信测试者合作,总结了四种用法:
- 创意预演:导演可以直接「走进」一场戏的实时模拟,连续跑多个 take,随时调整机位、灯光、台词与动作;
- 历史场景与沉浸照片:摄影记者正在试验把一张二维档案照片在数秒内变成可进入的环境模拟,用来体验历史空间,或预览山洪、山火这类短期环境事件如何展开;
- 交互体验概念设计:游戏开发者从一句自然语言到可探索的原型只要几秒,在写第一行引擎代码之前就能试视觉风格、材质观感与交互机制;
- 仿真:除机器人研究外,企业伙伴正把 Genie 4 当作「从零到一」的场景生成工具,同时指出它距真实仿真需求还有哪些缺口。
边界:仍然是一个早期模型
DeepMind 对局限写得相当直接:Genie 4 能在短时会话中维持连贯环境,但视觉细节与物体恒存性(object permanence)仍会漂移——模拟跑得越久、经过多次复杂提示编辑、或在场景中反复穿行之后,偏移越明显。复杂物理交互、实时音频的准确性、可读文字的渲染、空间精度与长期一致性,都仍是活跃的研究方向。
值得注意的是,官方这一篇里没有公布分辨率、帧率与可维持时长这三个 Genie 3 时代最常被追问的指标。演示页面给出的提示词本身也很能说明当前的使用门槛:动辄数百词,逐条约束胶片质感、镜头运动、剔除 HDR、指定声音构成——效果仍高度依赖提示词工程。
安全方面,Genie 4 沿用 Google 各模型的安全策略与内部评测,并选择先小范围发布;所有生成的视频与音频都嵌入 SynthID 不可见水印,便于在视觉与音频两种模态上识别 AI 生成内容。
核心总结
- Genie 4 是 Google DeepMind 的新一代实时世界模型,10 月 27 日以研究预览形式向可信测试者开放;
- 四项能力:自然语言实时改造场景、更真实的物理与人物动作、原生生成的音频与交互对话、由 Gemini 3.8 Flash 在回路中规划的多步事件;
- 技术路线指向混合世界模型:语言模型管结构与叙事,Genie 管逐像素的物理现实;
- 与 Gemini 4 Argon、Gemini Robotics 的联合实验,已经能把任务拆解并逐步渲染成可交互的模拟;
- 仍是早期模型:细节漂移、音频准确性、文字渲染与长时一致性尚未解决,分辨率与时长等指标也未公布。
原文:Genie 4: A new generation of world simulation(Google DeepMind,2026 年 10 月 27 日)


