智谱(Z.ai)在 10 月 12 日发布面向法律工作的专用模型 GLM-Legal,并同步开放 Beta 申请。官方给出的定位很直接:用一条弱于旗舰的基座,去冲击由闭源前沿模型把持的法律任务榜单——GLM-Legal 建立在轻量级 GLM-5.3-Flash 之上,参数规模远小于同级对手,却在 Harvey LAB、LegalBench、PLawBench 三项基准上取得与前沿闭源模型相当的成绩。
三个基准,三条不同的证据链
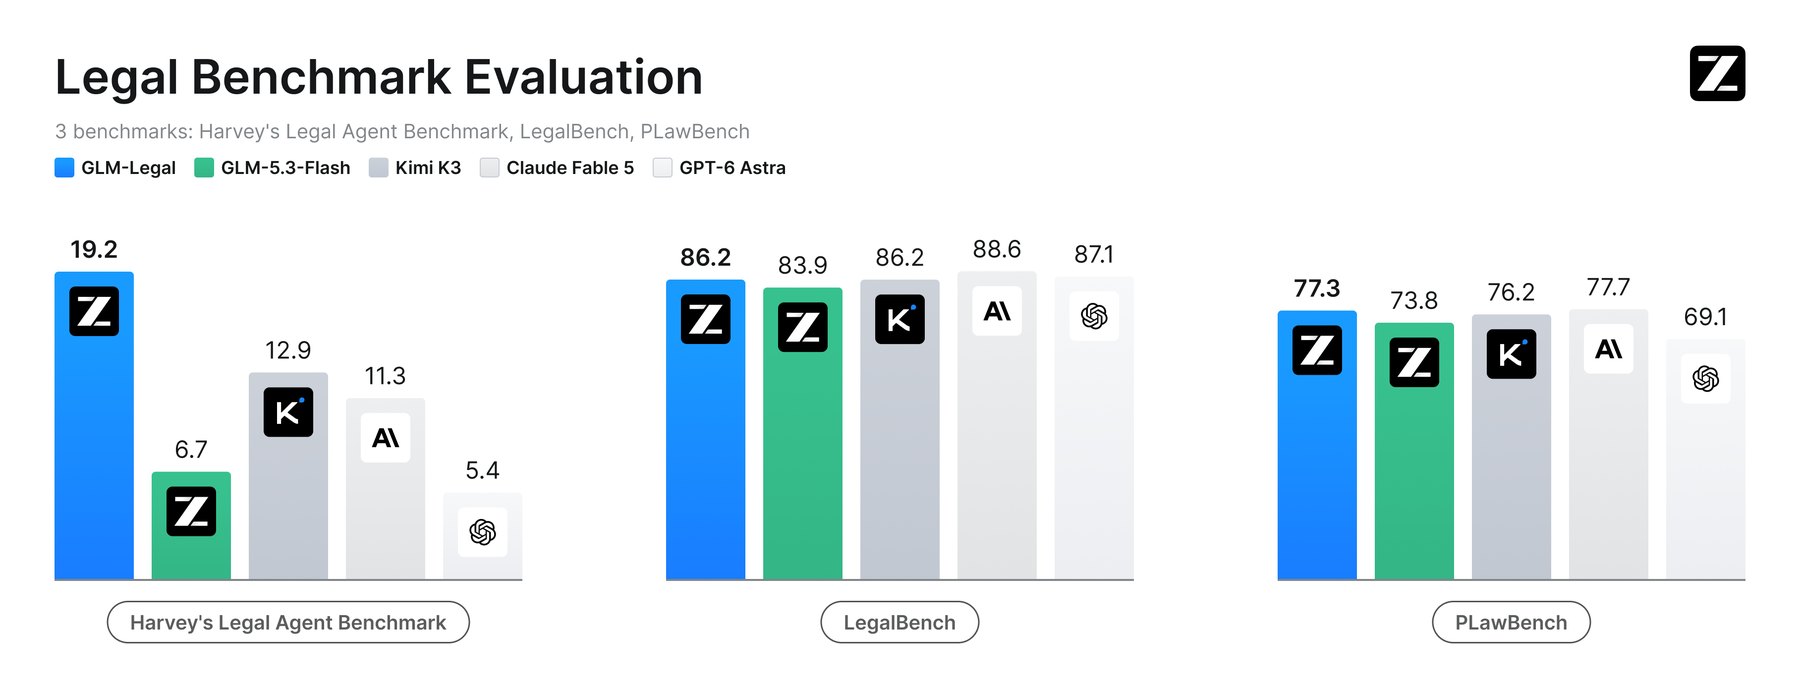
官方把评估拆成三个方向:复杂任务执行、专业法律推理、真实法律工作流。三张成绩单里,最值得看的是第一项。
| 基准 | GLM-Legal | GLM-5.3-Flash | Kimi K3 | Claude Fable 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| Harvey’s Legal Agent Benchmark | 19.2 | 6.7 | 12.9 | 11.3 | 5.4 |
| LegalBench | 86.2 | 83.9 | 86.2 | 88.6 | 87.1 |
| PLawBench | 77.3 | 73.8 | 76.2 | 77.7 | 69.1 |
- Harvey LAB(19.2% 全通过率):Harvey 的法律智能体基准覆盖 24 个执业领域、全部按真实律所工作流构造。19.2% 这一数字单看不高,但它的评分是「全通过」制——一个任务从事实抽取、法条适用到成品交付,任一环节掉链子就整题不得分,因此分数天然被压低。相比同门基座 GLM-5.3-Flash 的 6.7%,GLM-Legal 提升了 12.5 个百分点,接近三倍。
- LegalBench(86.2%):考察合同、并购申报文件、司法意见的专业解析能力,GLM-Legal 与 Kimi K3 同分,落后 Claude Fable 5 与 GPT-6 Astra 约 1–2 个百分点。官方强调这是在远小的参数预算下取得的。
- PLawBench(77.3%):中文法律咨询、案件分析与文书起草,按细粒度评分标准评测,GLM-Legal 在本组模型中排名第一。
独立评测:从「打平」到「性价比」
原文称 Harvey LAB 与 LegalBench 两项由 Vals 独立评测,Vals 的模型页给出了更细的横向位置:
- Harvey LAB 19.17%,在 79 个受测模型中排第 7;单题成本约 0.15 美元,是前 10 名里最便宜的。
- LegalBench 86.23%,150 个模型中排第 14,Vals 注明这是 GLM 系列在该基准上的最好成绩。
- Legal Research Bench 41.83%(第 24 / 78),综合准确率 49.08%。
- 定价:每百万输入 token 0.075 美元、输出 0.25 美元。
这组数字补上了官方图表没说的部分:GLM-Legal 在绝对分数上确实不是最强,但它进入的是同一梯队,而成本低了一个量级——对需要反复跑长链条任务的智能体场景,这个差别会被放大。
训练:中训打地基,后训练与 Harness 互相牵制
官方把训练方法总结为三段,核心是把训练效率放在第一位。
中训(mid-training)扩大高质量法律语料规模,让模型密集地接触法律概念、成文规则与解释框架,强化「事实—规则—结论」之间的演绎链条,为下游执行提供知识底座。
后训练则是在数万个真实法律环境中做强化学习。这里有个不同于常规的做法:官方没有把模型和运行框架分开优化,而是让 Harness 与模型训练同步迭代。Harness 负责管理任务上下文、连接工具集、回传执行反馈;训练中暴露的边界案例会反过来指出 Harness 的架构瓶颈,Harness 的改进又把更真实的执行约束喂给模型。官方称之为「双向学习」,目标是让模型从接收指令到最终签署交付的整条链路上都保持水准。
生产反馈闭环是第三段。法律从业者对产出提出的是可以判定的问题:关键争点与边界情形是否都覆盖了、论据是否有据可依、引用是否站得住、成品是否符合案件简报的要求、下游团队能否不再返工直接使用。官方把这些要求转成工程上的损失信号,出现漏事实、分析浅、格式跑偏时回溯整条执行链路,分清问题出在模型本身、上下文编排还是工作流逻辑,再把结论写回任务环境、评分标准与 Harness 设计。这种「把主观质量变成可优化目标」的做法,也是法律这类高风险领域能不能真正上生产的关键。
三个真实任务,看它比基座强在哪
官方在 AutoClaw(智谱的桌面原生智能体平台)上演示了三类常见法律工作,并给出 GLM-5.3-Flash 与 GLM-Legal 的产出对照。
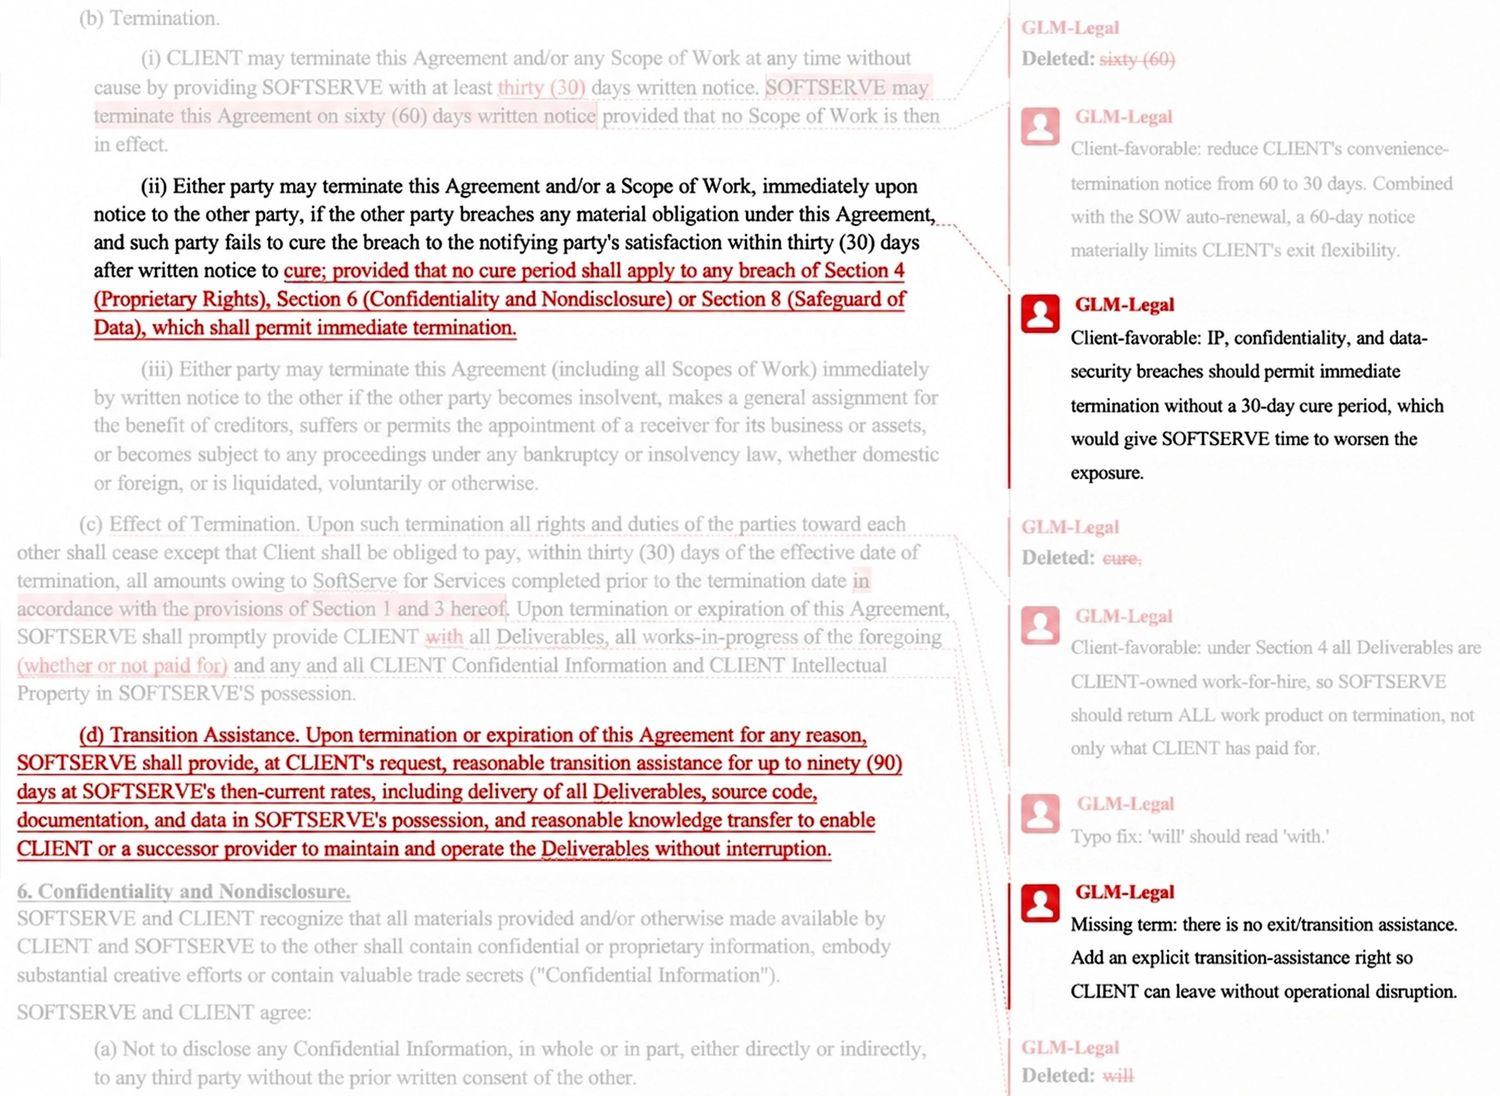
合同审查:任务是审查一份客户更换供应商时的软件服务合同,聚焦终止与交接条款。基座模型的回答停留在「建议缩短通知期、增加过渡支持」这类方向性提示;GLM-Legal 则落到具体条款——把 60 天便利解约通知期压到 30 天、删掉知识产权与数据安全违约的 30 天补救期以实现即时终止、指出第 4 条已把工作成果归客户所有因而应当要求返还未付款的在途交付物、并加入最长 90 天的过渡协助(含源码、文档、数据与知识转移)。AutoClaw 会把这些改动以修订与批注的形式直接写进 Word 文档。
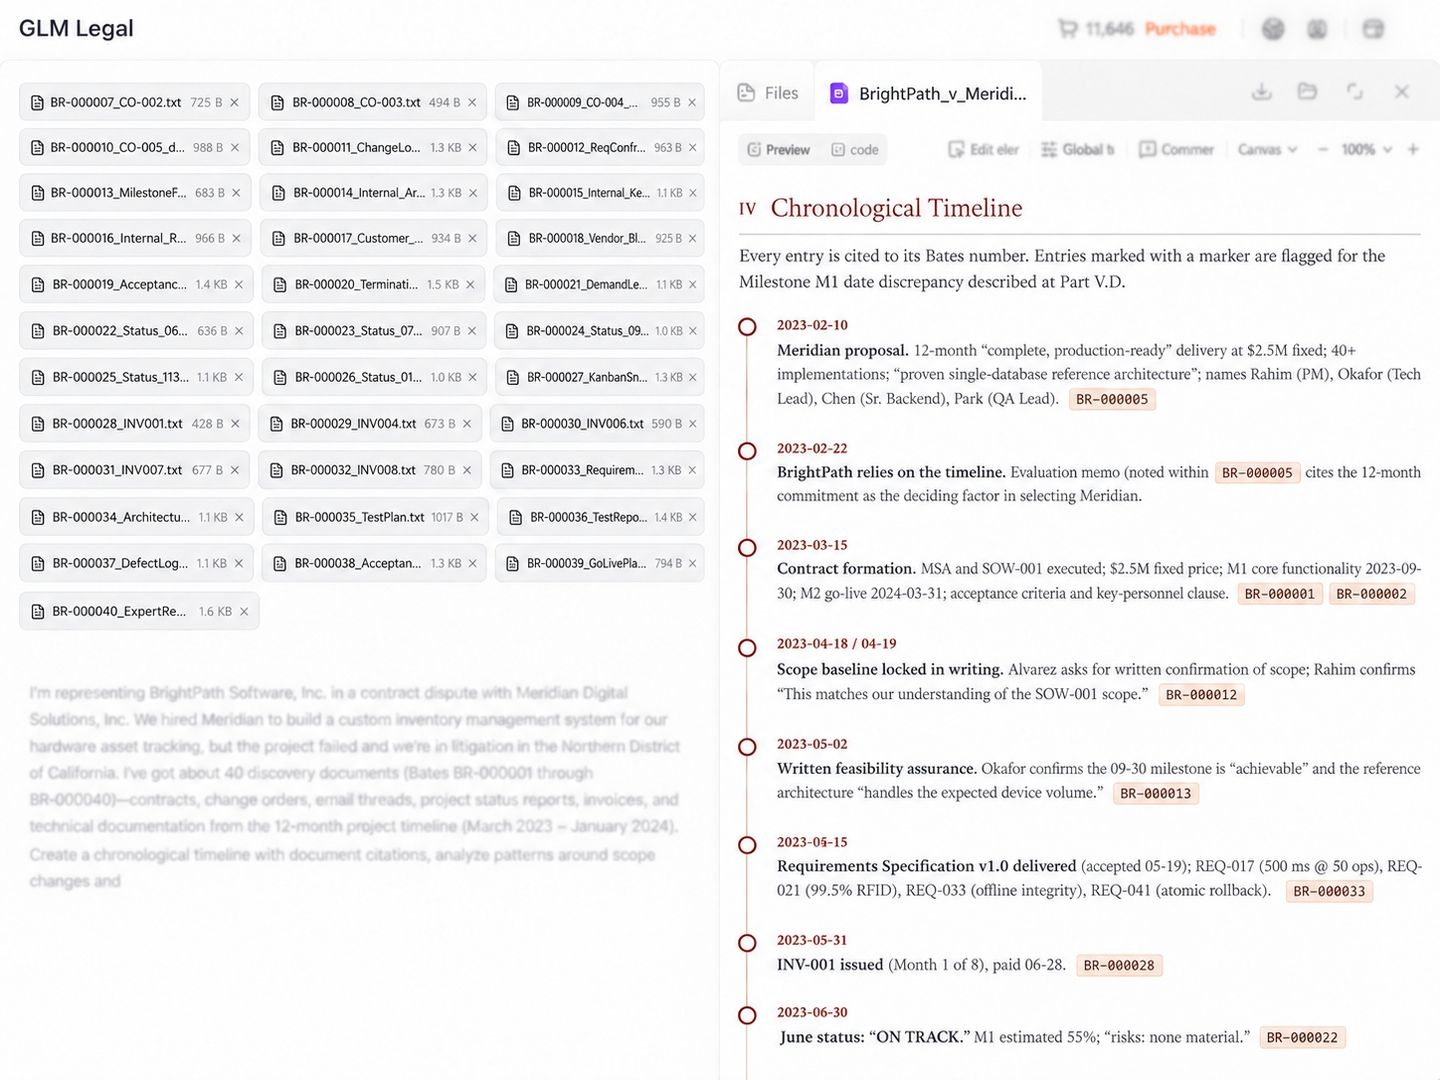
证据分析:任务是从 40 份软件项目纠纷文档中找出供应商进度报告中的矛盾。GLM-Legal 把 9 月 30 日对外宣称「ON TRACK – 60% COMPLETE」的报告与 9 月 8 日内部「该里程碑无法诚实达成」的预警、以及约 41% 的内部进度快照(含 Bates 编号)关联起来,再指出 CEO 要求压下风险并继续开票的指示把内部认知与披露决策连成一线,同时援引 MSA 第 2、5 条说明「持续付款不构成权利放弃、担保在付款后依然存续」,最后给出这是否支持隐匿主张、还需核实哪些要件。基座模型只指出了数据不一致,没有把事实与推断分开,也没有落到法条。
合规调研:任务是为一个在新加坡、马来西亚、印尼上线的网站规划隐私合规,涉及埋点、邮件营销与海外云存储。GLM-Legal 给出分级清单——P0 项包括发布英文与印尼语隐私声明、对非必要分析与广告采用主动勾选、把营销同意与注册分离、让退订请求进入抑制名单、梳理云/支付/邮件/分析/CDN 各供应商的数据流向,并逐条挂上依据(新加坡 PDPA s26、马来西亚 PDPA s129、印尼 PDP Law Arts 55–56)。基座模型只给出「应当发布隐私声明、检查是否需要同意」这类通用建议,未落到具体法条。
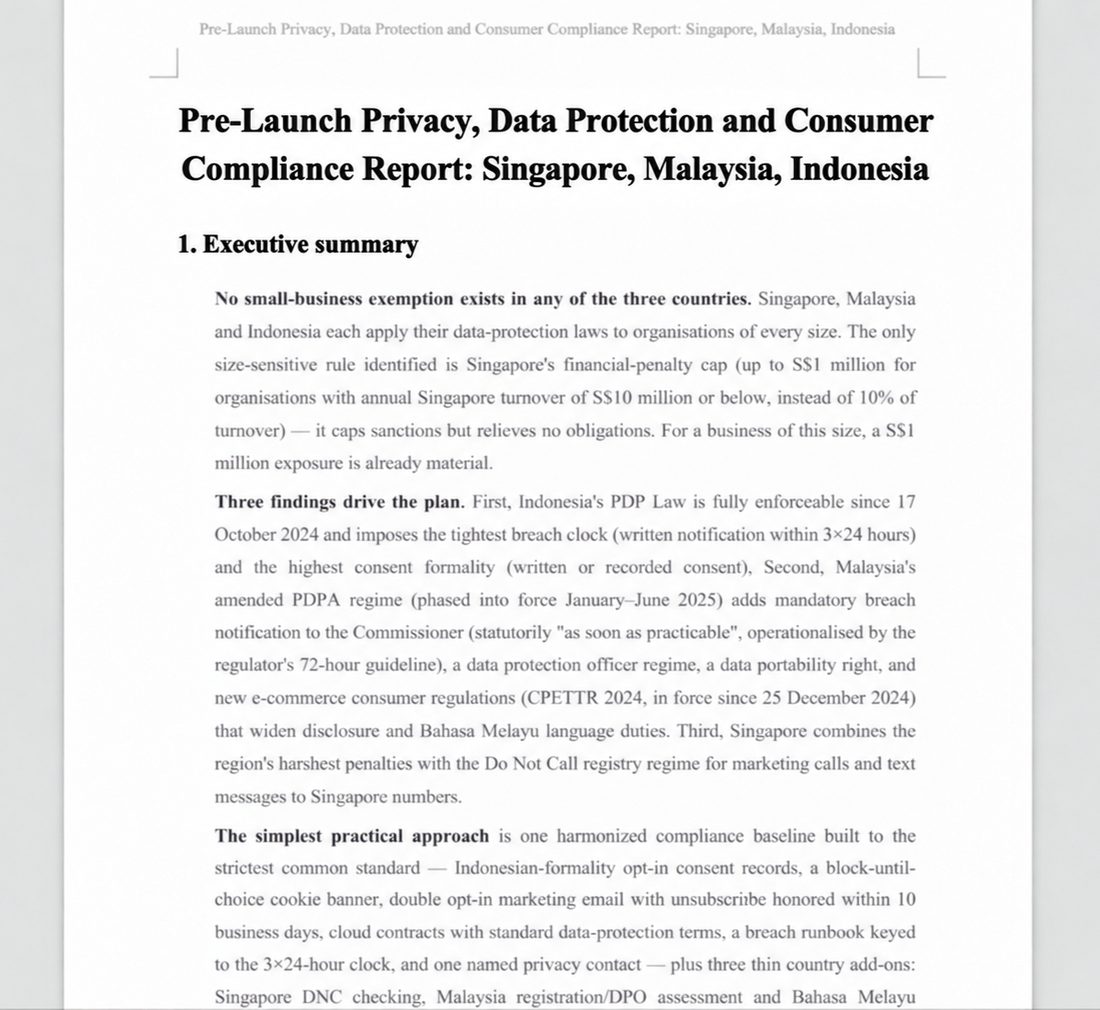
三组对照的差别不在文风,而在是否给出可直接执行、且可溯源的东西:具名条款、Bates 编号、法条条目、可谈判的具体数字。这也正是官方所说的「专业协作(Professional Cowork)」——从单轮代码生成转向高风险专业领域的全流程承接。
可用性与申请方式
GLM-Legal 目前处于 Beta,面向律所、法律科技公司、企业法务团队与独立执业者开放。申请 API 访问的入口是 z.ai/consultation/legal,演示所用的 AutoClaw 桌面端在 autoclaw.z.ai。官方未给出通用 API 的模型名与正式上线时间。
核心总结
- 是什么:智谱发布的法律领域专用模型 GLM-Legal,建立在轻量级基座 GLM-5.3-Flash 之上,主打用更小的参数规模承接高风险专业工作流
- 成绩:Harvey LAB 全通过率 19.2%(较基座 +12.5 个百分点)、LegalBench 86.2%、PLawBench 77.3%(本组第一)
- 独立验证:Harvey LAB 与 LegalBench 由 Vals 独立评测;Vals 页显示 Harvey LAB 19.17% 位列 79 个模型第 7,单题约 0.15 美元,为前十中最便宜
- 定价:每百万 token 输入 0.075 美元、输出 0.25 美元
- 方法:高质量法律语料中训打底,数万个真实法律环境做强化学习,并在训练中让模型与 Agent Harness 双向迭代;生产反馈被转成具体损失信号回灌到任务环境与评分标准
- 能力差异:相比基座,产出从方向性建议变为具名条款、Bates 引用、法条条目与分级执行清单
- 现状:Beta 阶段,通过 z.ai/consultation/legal 申请 API 访问,可在 AutoClaw 桌面端使用
原文:GLM-Legal: Advancing Agentic Legal Intelligence(Z.ai,2026-10-12)
参考:
- Vals:GLM Legal 评测页(Vals,2026-10-12)


