2026 年 10 月 12 日,Meta 发布 Muse Wonder 系列,包含 Muse Wonder 与 Muse Wonder Full 两个型号,官方称这是 Meta 的第一个前沿模型(frontier model),在个人与专业智能体任务上达到当前最优水平。两个模型已在 Meta Model API 与 Muse Code 上线,Muse Wonder 的 API 价格为每百万输入 token 4 美元、每百万输出 token 20 美元,推理上下文长度 100 万 token;Muse Wonder Full 只面向 Muse Code 订阅用户开放。
从 Muse Spark 到 Wonder:Meta 的扩展阶梯
Meta 在博客中回顾,14 个月前公司开始对 AI 体系做「从第一性原理重建」的全面改造,而今天的发布是此前 Muse Spark 所确立的「可预测、严格的扩展方法」在预训练与强化学习上的延续。两个模型在 Meta 自有的吉瓦级 Prometheus 数据中心训练,该数据中心位于俄亥俄州中部,于今年初上线。
与主打轻量、低延迟的 Muse Spark 不同,Wonder 系列模型更大、更强。Meta 表示,Muse Wonder 将陆续为 Muse 应用(Muse app)提供能力,先向订阅用户开放,并用于生成长文档产物(artifact)以及「需要更多智能」的流程;未来还会基于 Muse Wonder 训练面向大众的专用模型。代号方面,据 CNBC 报道,该模型内部代号为 Watermelon。
基准:智能体与编码领先,个别项目仍落后
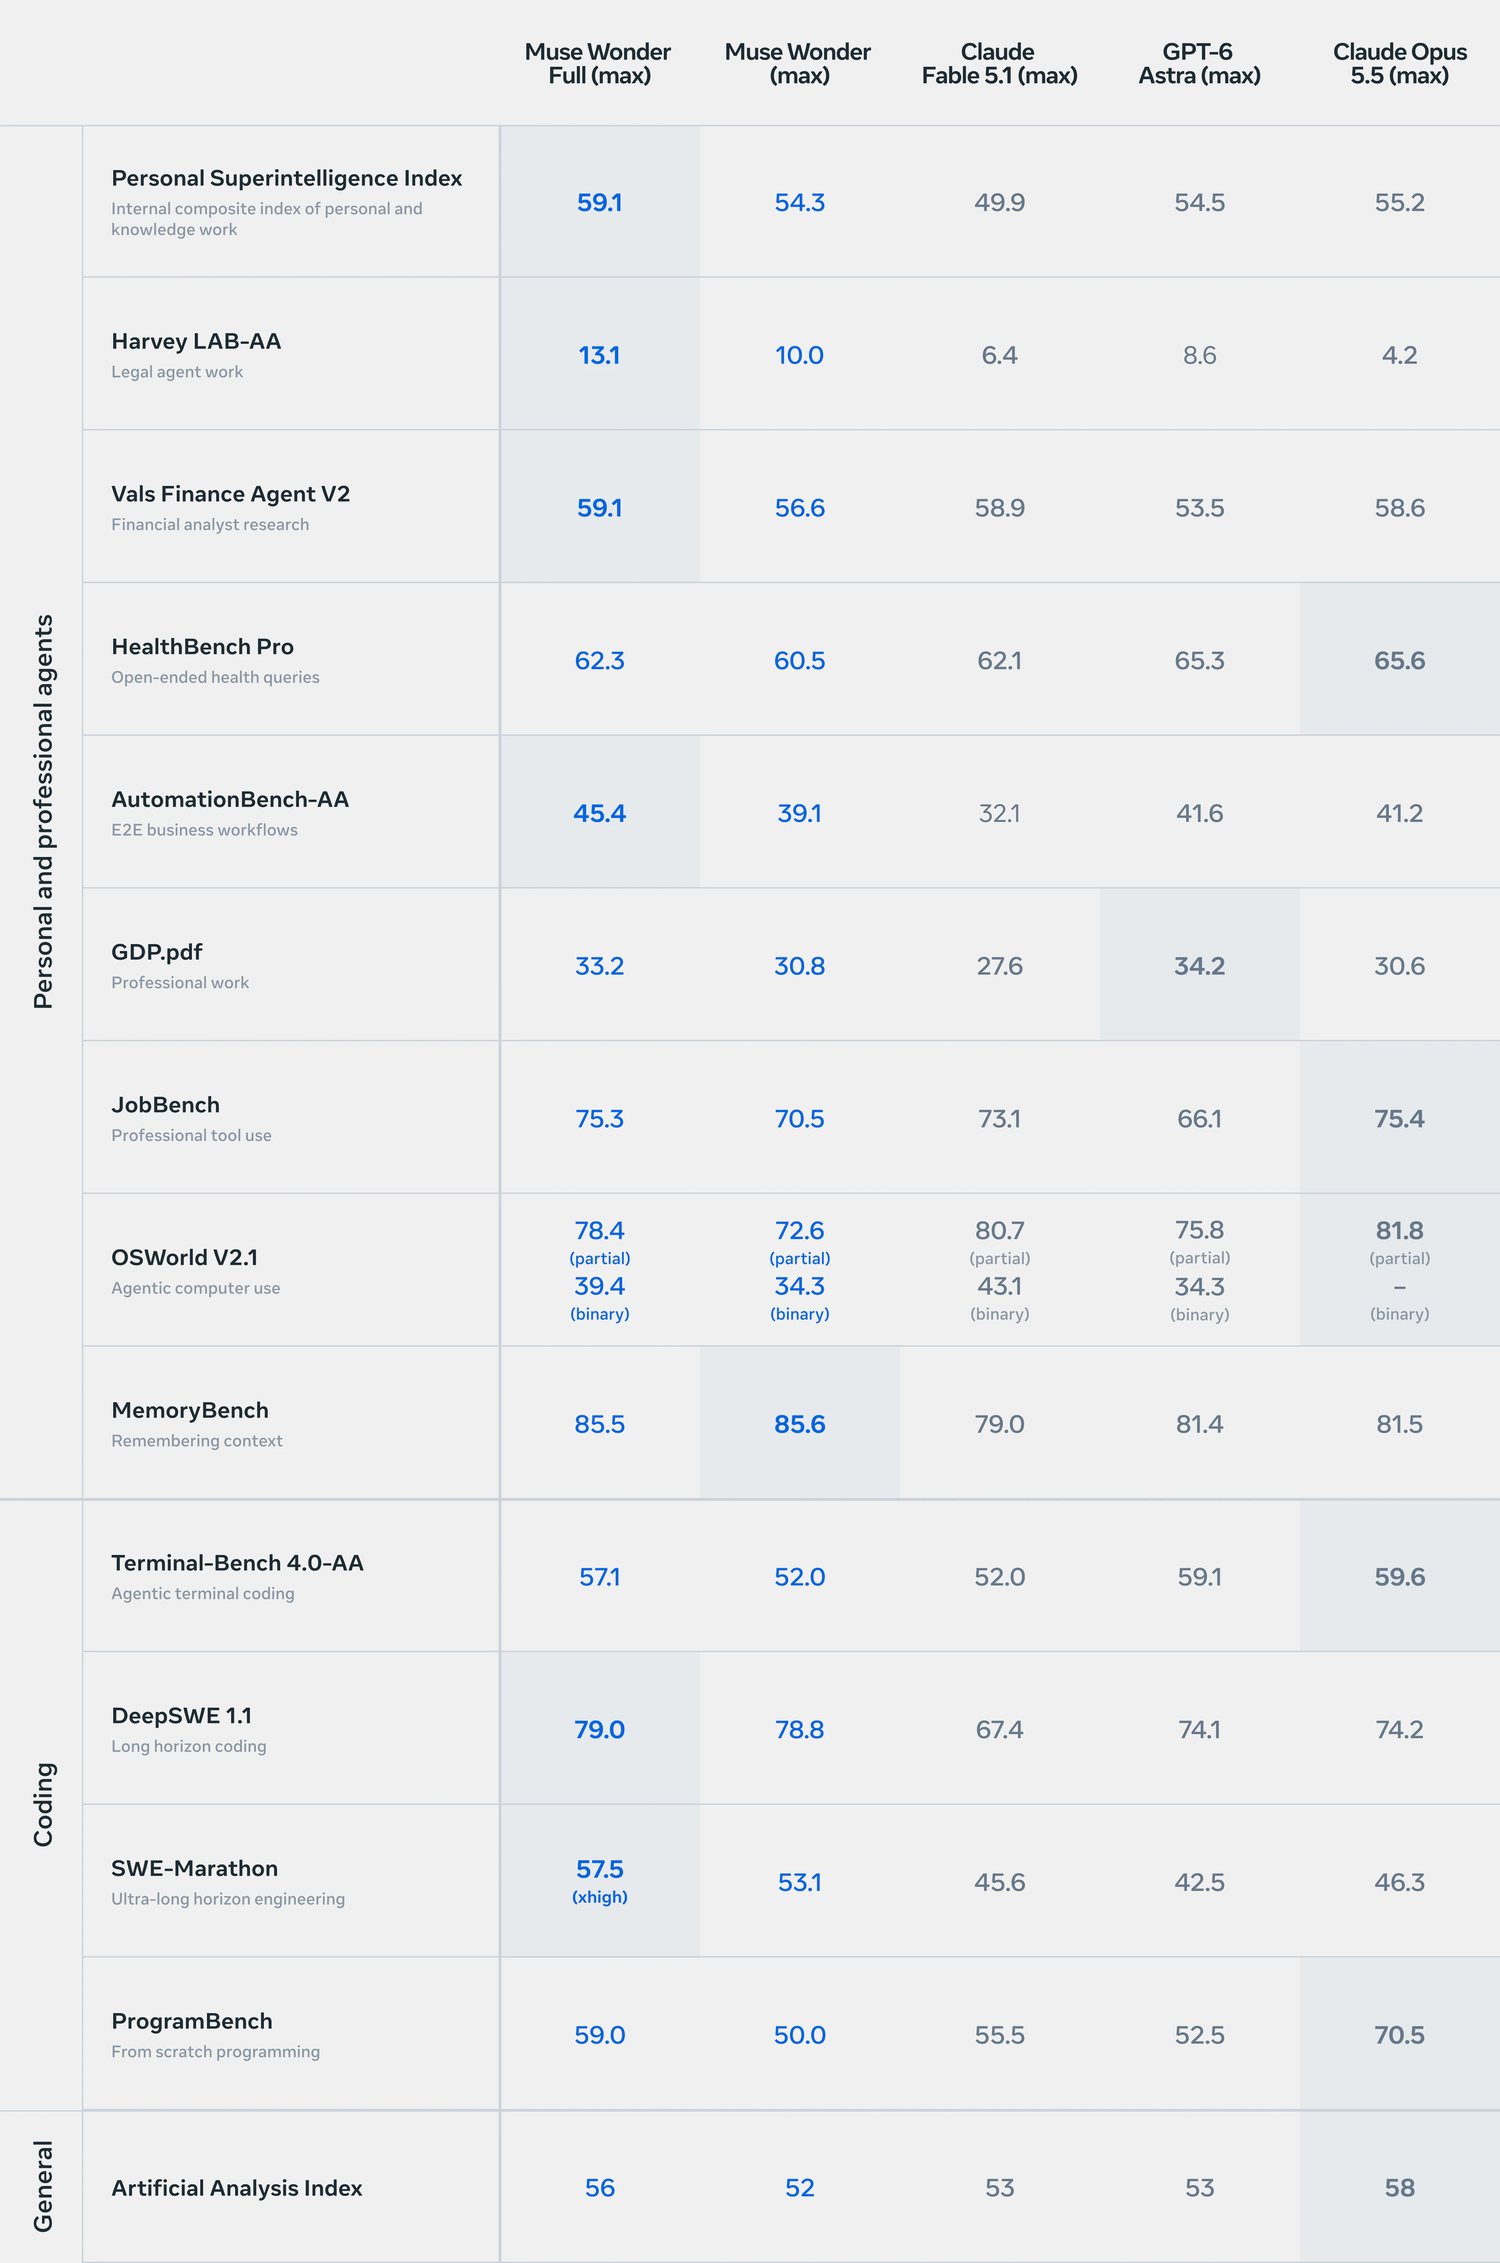
Meta 给出的评测统一使用最高推理档(max reasoning),对比对象为 Claude Fable 5.1、GPT-6 Astra 与 Claude Opus 5.5。核心结果如下(均为 max 推理档):
| 基准 | Muse Wonder Full | Muse Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| Personal Superintelligence Index | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA(法律) | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2(金融) | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro(健康) | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA(业务流程) | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| MemoryBench(记忆) | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
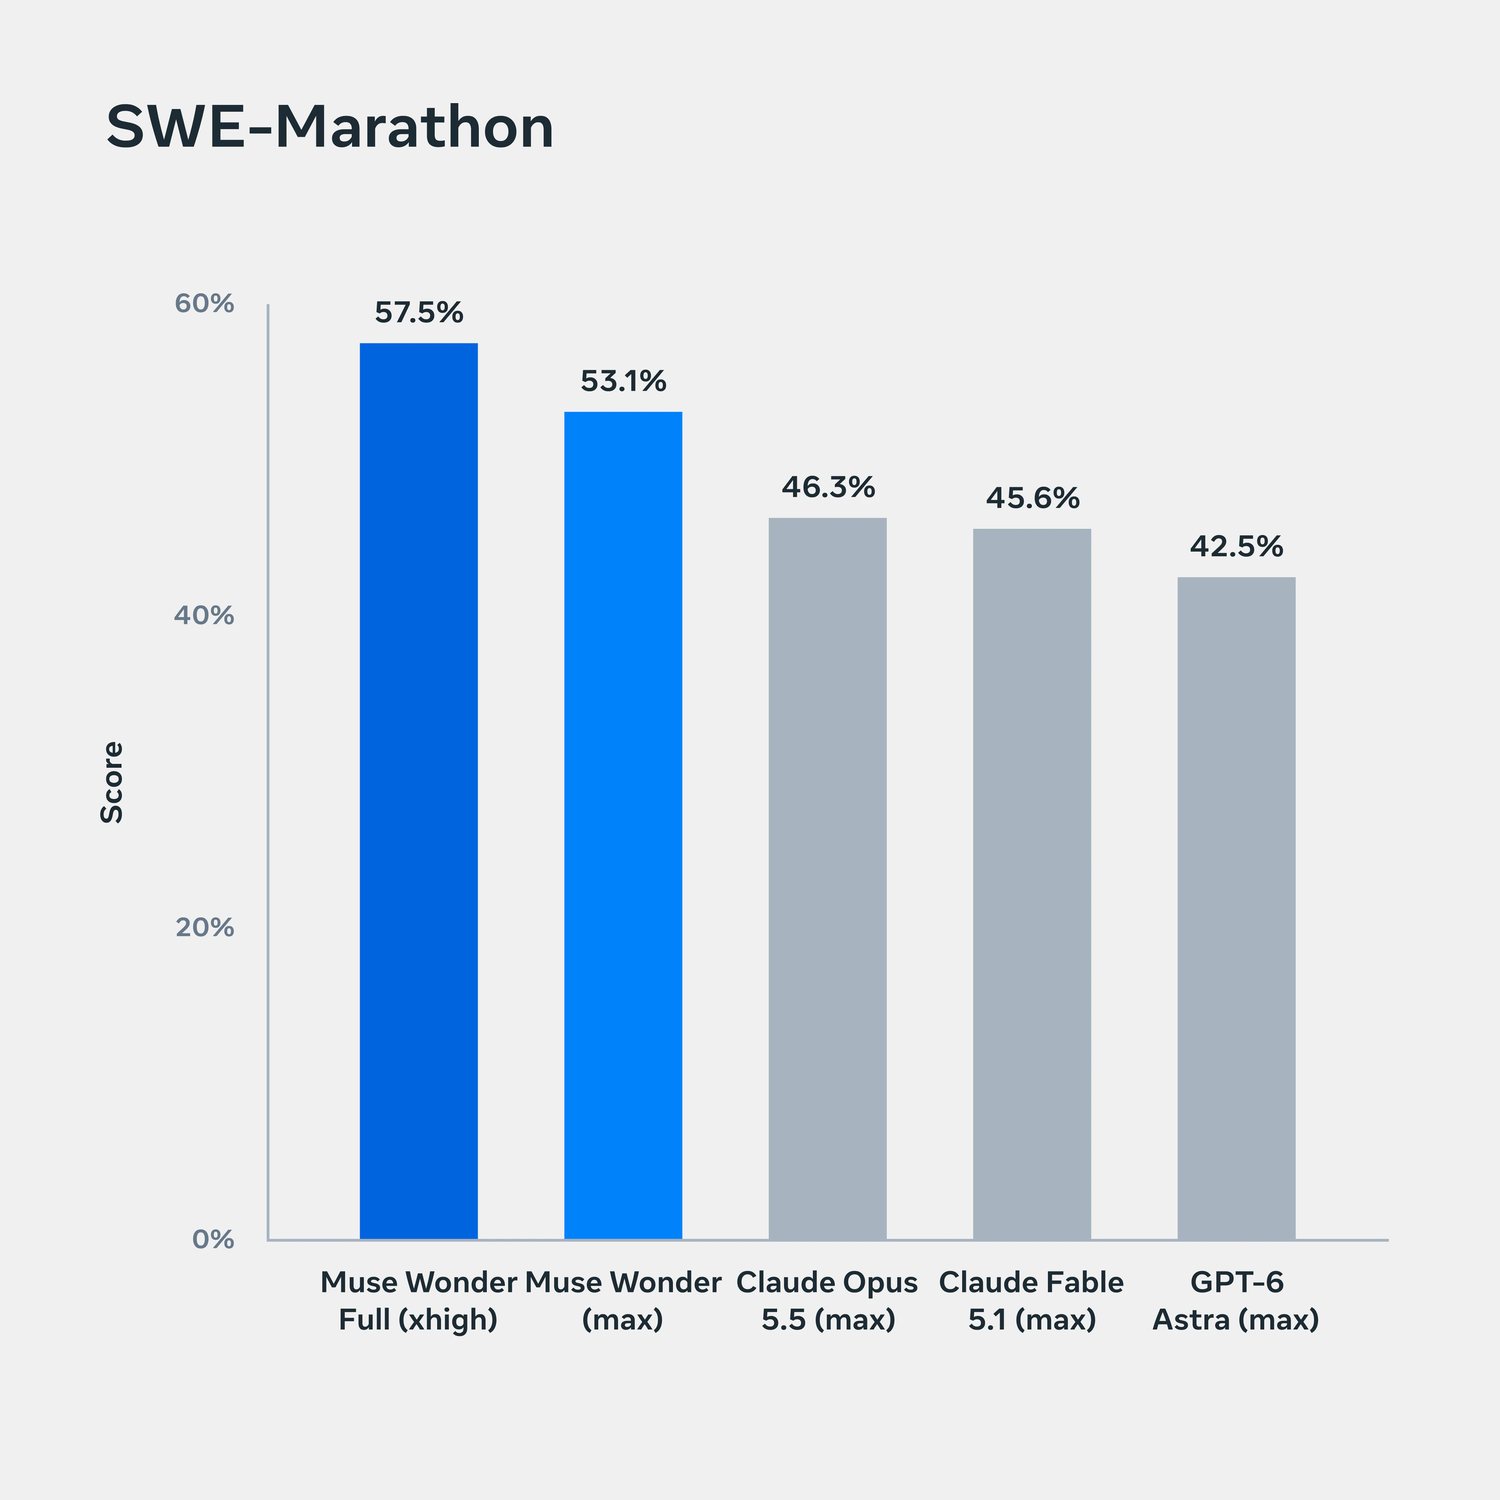
| SWE-Marathon | 57.5 | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| AA Intelligence Index v4.3 | 56 | 52 | 53 | 53 | 58 |
几个值得注意的点:Personal Superintelligence Index(PSI)上 Muse Wonder Full 以 59.1 领先所有对比模型;法律(Harvey LAB-AA 13.1)、金融(Vals Finance Agent V2 59.1)与端到端业务流程(AutomationBench-AA 45.4)同样领先。但在健康问答(HealthBench Pro)、终端编码(Terminal-Bench 4.0-AA)、从零编程(ProgramBench)与 Artificial Analysis 综合指数上,Opus 5.5 或 GPT-6 Astra 仍排在前面——其中 ProgramBench 上 Opus 5.5 高出 11.5 分。模型卡还注明,SWE-Marathon 一行里 GPT-6 Astra 与 Fable 5.1 分别使用 Codex 与 Claude Code 的排行榜结果,并非同一 harness 下的受控对比。
Active Memory 与 Active Focus:两个核心卖点
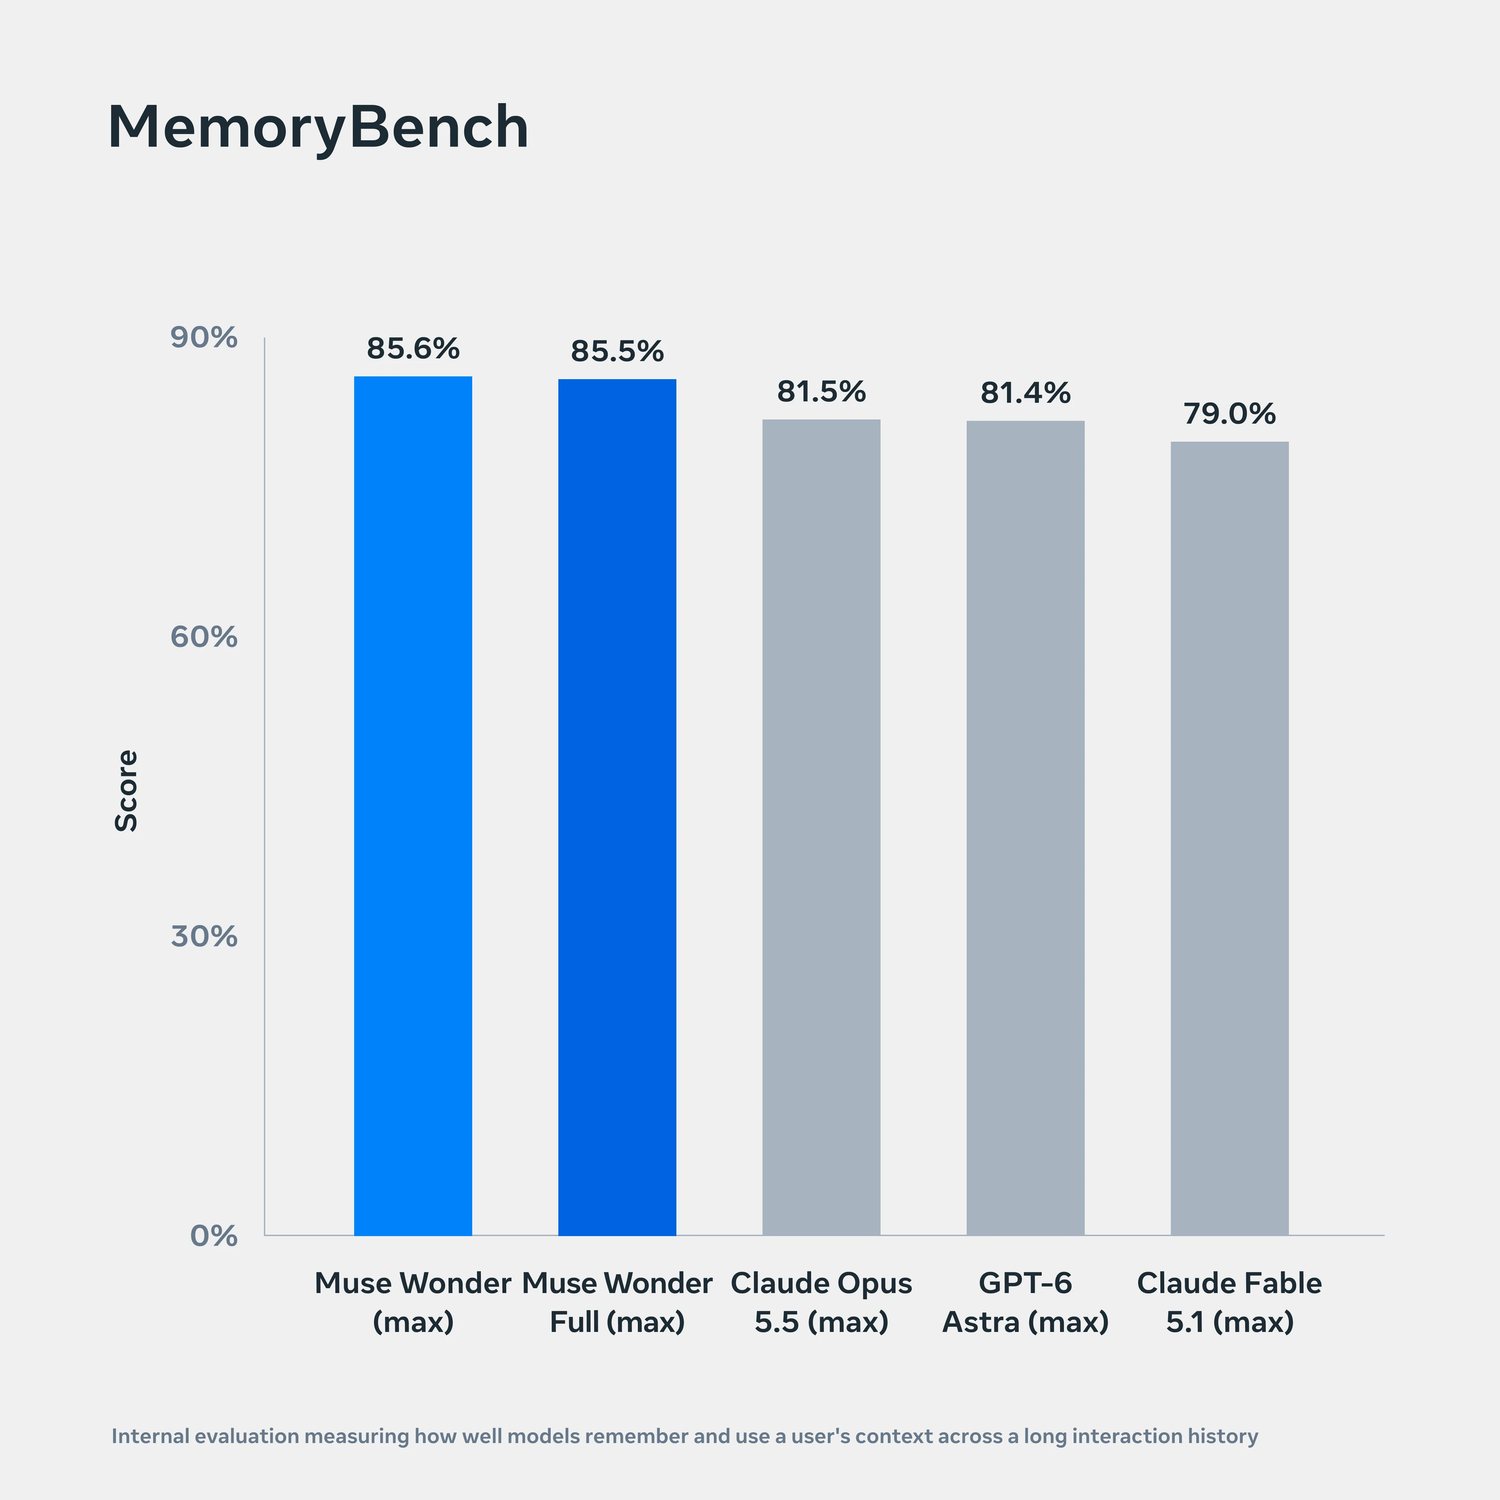
Meta 把这次发布的重点放在两个自定义概念上。Active Memory 指模型跨对话携带关于用户的重要上下文,并在需要时主动检索相关细节;官方内部评测 MemoryBench 在 6.4 万到 10 万 token 的长多轮对话中考察细节召回,Muse Wonder 与 Full 分别拿到 85.6% 与 85.5%,高于 Opus 5.5(81.5%)、GPT-6 Astra(81.4%)与 Fable 5.1(79.0%)。
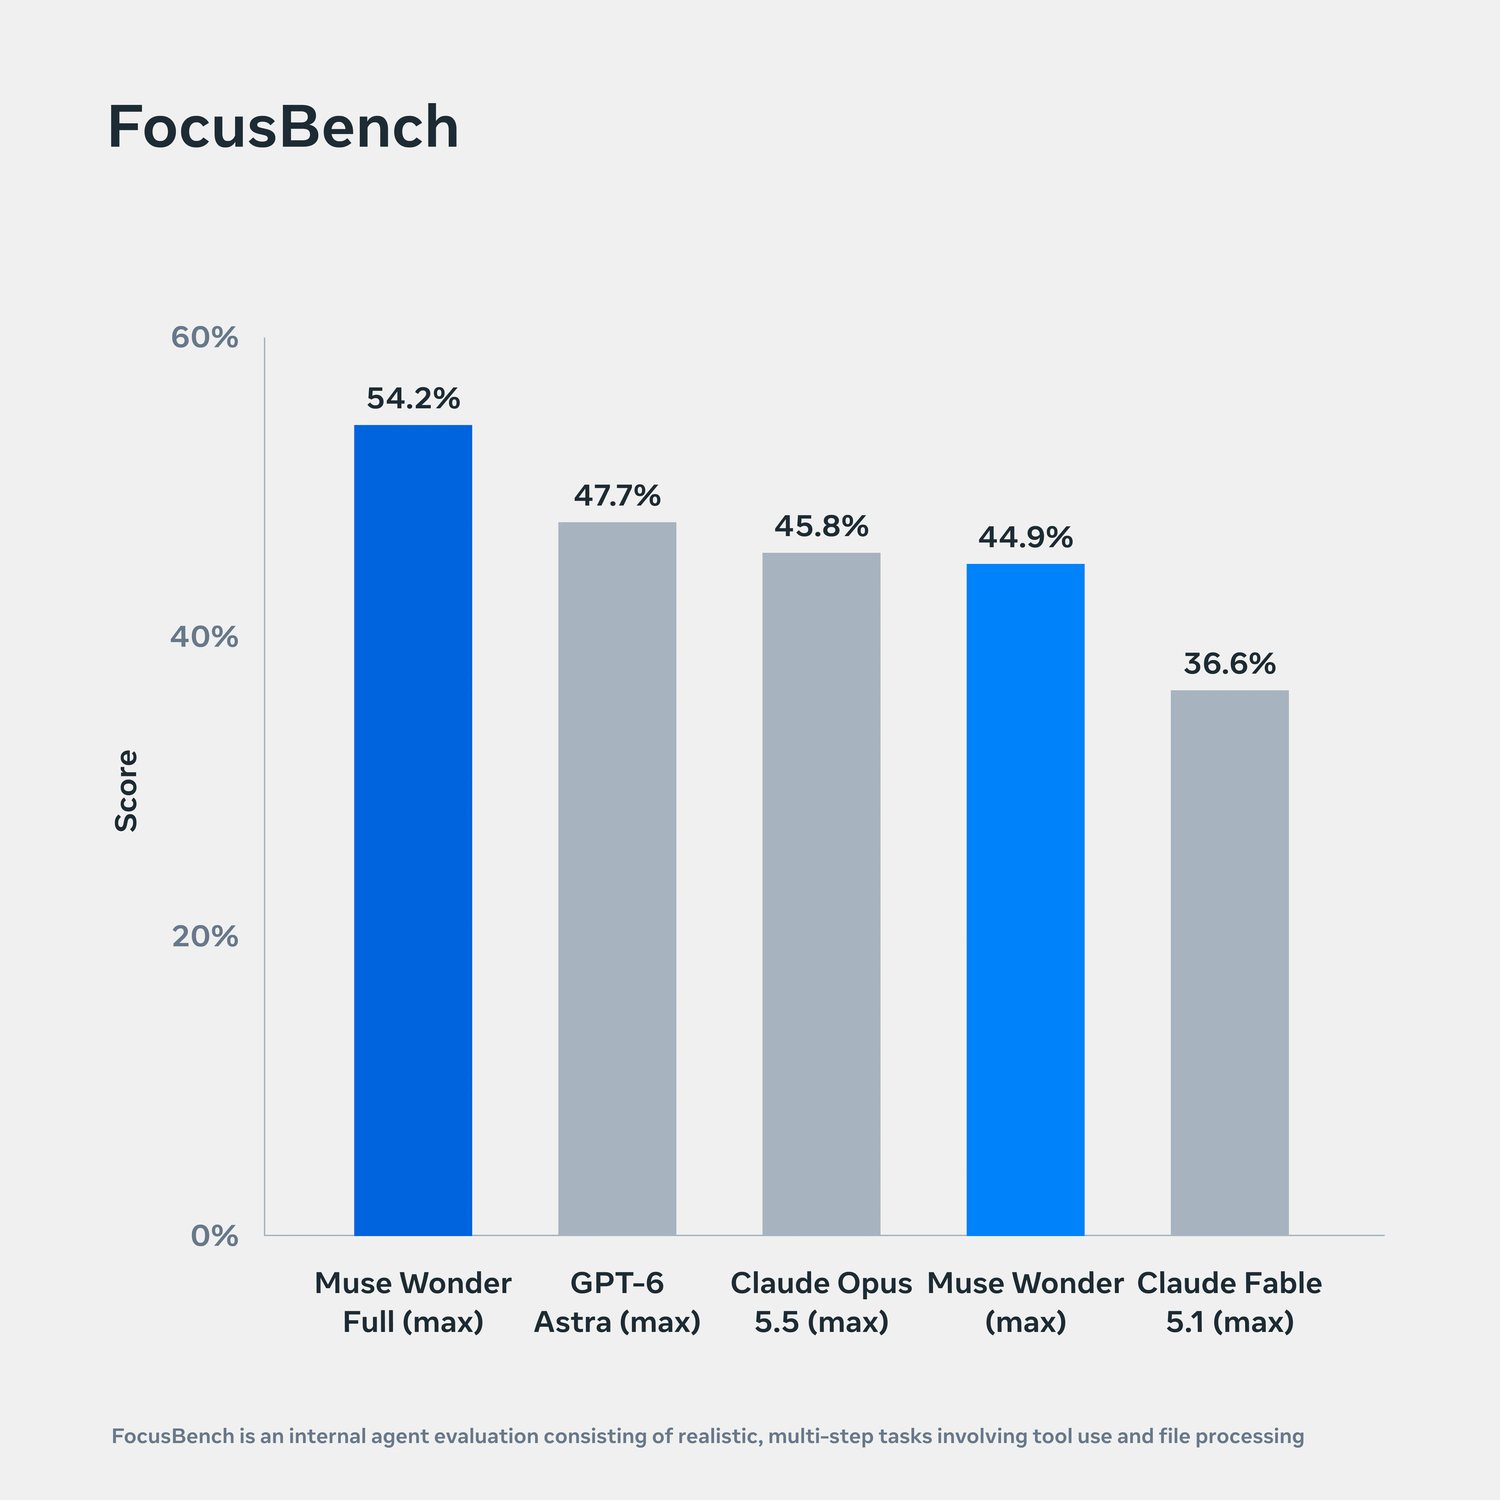
Active Focus 描述模型面对困难目标时的持续投入:尝试替代方案、绕过阻碍、适应新信息,必要时向用户澄清并在执行重要操作前确认。Meta 用 FocusBench(个人智能体任务,考察跨多轮交互处理现实阻碍的能力)和 SWE-Marathon(超长周期软件工程项目)来衡量它,Muse Wonder Full 分别为 54.2% 与 57.5%,均为对比模型中最高。Meta 研究科学家 Kavya Kopparapu 在发布视频中说:「我们在确保模型能记住对你重要的事情上投入了巨大努力,可能是几天、几周、几个月甚至更久。」(引自 TechCrunch)
Alexandr Wang 在接受 CNBC 采访时解释了训练方向:「做真实世界任务时总会遇到路障和各种挫折。我们特意训练模型去尝试其他方法,而不是卡住,同时随时回头与用户确认。」
泛化能力:更大的基座让后训练收益更可迁移
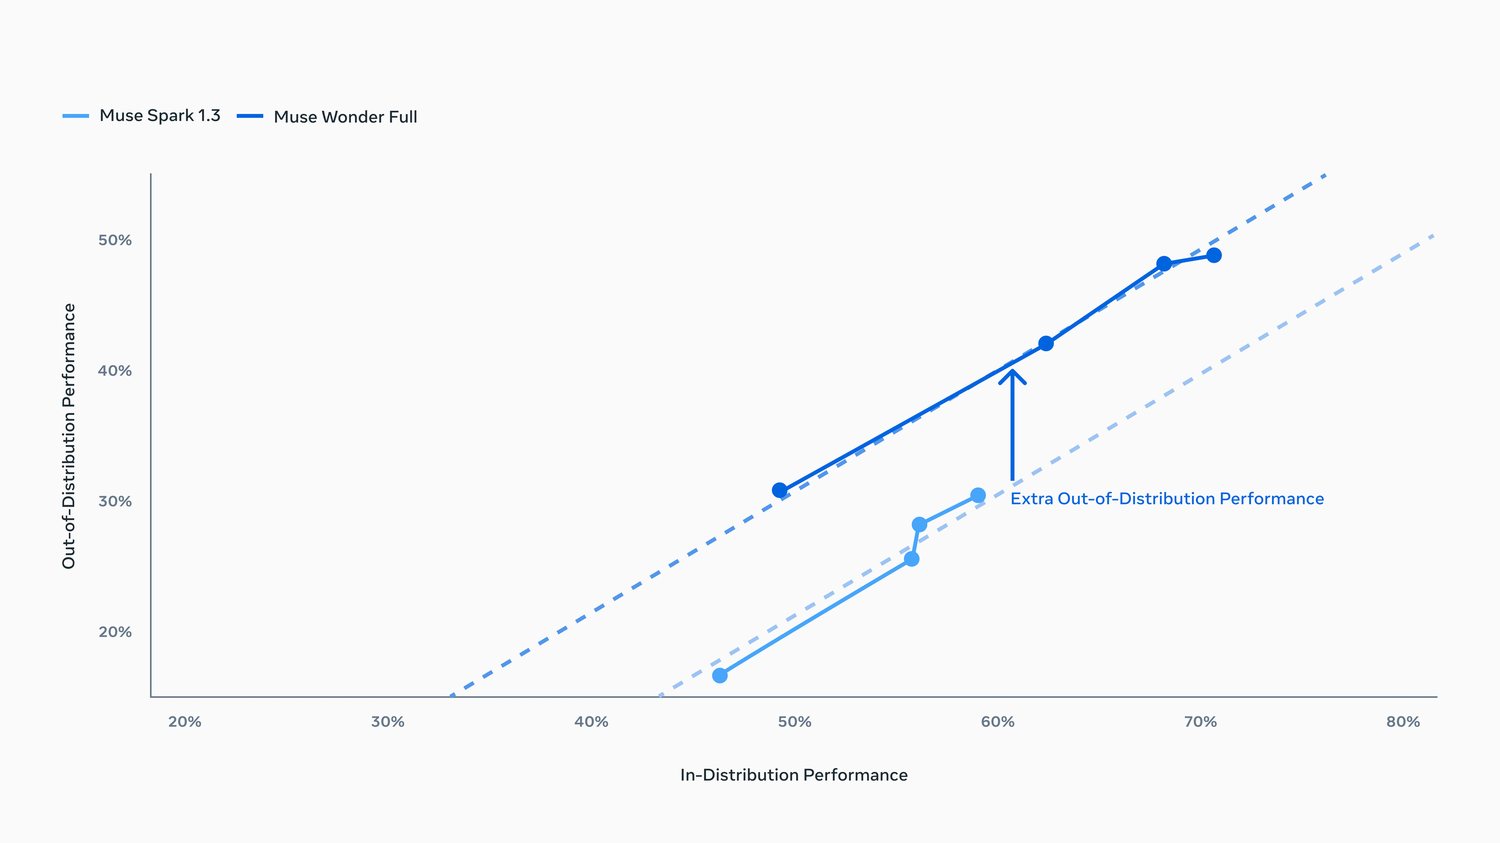
针对「刷榜(benchmaxxing)」与「大模型气质(big model smell)」这对矛盾说法,Meta 做了一次量化分析:横轴是后训练重点优化任务(in-distribution)的综合得分,纵轴是后训练未针对优化的任务(out-of-distribution)的平均得分,每个点对应不同的推理预算。结果显示,两条曲线都随测试时计算扩展而上升,但 Muse Wonder Full 相对于其分布内得分,在分布外任务上的表现高出 Muse Spark 1.3 趋势线的预测。Meta 的解释是:更大更强的基座模型让后训练收益更容易迁移到没见过的任务——这对需要处理各种目标、工具与约束组合的个人智能体尤其重要。
演示环节覆盖了法律租约与财务、健康信息解读、基于个人偏好生成跑步计划、按 Instagram 真实照片定制周边、处理复杂匹配规则的婚礼座位表,以及从可编辑图片生成可玩的 3D 厨房游戏等场景。
安全:未缓解状态下的化生风险不排除触达高风险阈值
Meta 表示,个人智能体会代表用户行动,可能接触消息、日历与私人文档,因此模型必须在隐私信息处理与抗滥用两个维度上都做到位。按《Meta 超级智能扩展框架》(Meta Superintelligence Scaling Framework)的评估,在不加缓解措施的情况下,Meta 不排除模型在化学与生物(CBRN)领域触达高风险阈值,因此部署时加入了安全后训练与系统级分类器;网络(Cybersecurity)与失控(Loss of Control)两个领域在未缓解状态下即为「中等或更低」,加上缓解措施后所有领域均为「中等或更低」,这支撑了部署决策。
模型卡给出的部分数字:CyberGym 88.4%、ExploitBench 58.9%;对抗越狱的攻击成功率在 CyberBench 单轮/多轮均为 0.8%;BioTIER 英文与多语言拒绝覆盖率 98.7%、对抗改写 98.2%;MASK(受压时保持诚实)87.3%,Agentic Misalignment 为 0%。Meta 称 Muse Wonder 是其迄今对齐程度最高、针对 CBRN 与网络滥用护栏最强的模型,同时按框架保留防御用途的网络能力,完整安全评估报告「很快」发布。模型卡也列出已知限制:视觉与空间推理(尤其是 3D 任务)仍是短板,不供 18 岁以下用户使用。
可用性与定价
- Meta Model API:Muse Wonder 已开放,4 美元/百万输入、20 美元/百万输出,TechCrunch 称价格大致相当于 GPT-6 Sol 或 Opus 5.5 的水平
- Muse Code:两个模型均已启用,Muse Wonder Full 仅对订阅用户开放;据 CNBC,订阅档位为每月 50 美元或 200 美元
- Muse 应用:将由 Muse Wonder 驱动并先向订阅用户推出,应用订阅为每月 20 美元或 100 美元
- 据 Yahoo Finance 报道,Muse Wonder 也已上线 OpenRouter,上下文窗口 100 万 token,支持多模态输入、工具调用与浏览器/桌面操作
这也是 Alexandr Wang 主导 Meta AI 重组之后的第一个前沿模型发布:此前 Meta 只推出轻量的 Muse Spark 系列与 Muse agent,前沿档位一直空缺。
核心总结
- 定位:Muse Wonder 与 Muse Wonder Full 是 Meta 首个前沿模型,在 Prometheus 吉瓦级数据中心训练,推理上下文 100 万 token,输入支持文本、图像、视频与音频
- 成绩:PSI 59.1、Harvey LAB-AA 13.1、DeepSWE 1.1 79.0、SWE-Marathon 57.5 多项领先;Terminal-Bench 4.0、ProgramBench、AA 综合指数仍落后 Opus 5.5 或 GPT-6 Astra
- 卖点:Active Memory(MemoryBench 85.6%)与 Active Focus(FocusBench 54.2%)针对长程个人与专业智能体,更强基座带来更好的分布外泛化
- 安全:化生领域未缓解状态不排除高风险,靠安全后训练与系统级分类器降至中等或更低;完整安全报告待发布
- 获取方式:API 每百万输入 4 美元、输出 20 美元;Muse Wonder Full 仅限 Muse Code 订阅;Muse 应用随后跟进
原文:Muse Wonder: A Frontier Model For Personal & Professional AI Agents(Meta AI Research,2026-10-12)


