Claude 自己写了 Claude Code 大约 90% 的代码。那么,代码还读得过来吗?如果出了问题,谁来发现?
10 月 15 日,Anthropic 的 Addy Osmani、Morgan Westlee Lunt 与 Qing Wang 在 claude.dev 发文,复盘 Claude Code 团队的代码评审流程。给出的结果数字是:6 月到 9 月,合并进 Claude Code 代码库的 PR 数量翻了一倍以上,而需要回滚的比例下降了超过 40%。作为参照,Anthropic 单体仓库每天落地的变更数从今年 5 月的约 2,500 次涨到 9 月的 30,000 次以上。
他们没有取消评审,而是把大部分「阅读」交给了机器,把人类时间集中在只有人能解决的问题上,并在「让错误容易撤销」上做了大量投入。
重新理解评审到底在做什么
文章把代码评审拆成两项工作:一是在上线前发现问题并修复;二是在团队内建立共享上下文与代码理解。前者是本文主线,后者在结尾回到。
作者认为,「有没有人类读过这段代码」是「这次变更可能出什么问题、该由哪道检查(自动还是人工)来兜住」的一个不精确替代指标。换了这个问题,评审的发生时机也变了:过去评审是位于终点的关卡——写完代码、开 PR、等同事;现在评审是持续运行的,更像写作时的拼写检查。多数变更在被要求人类查看之前,已经被 Claude 至少评审并修过一轮。
稀缺资源是人的时间和注意力
人的时间有两笔成本:花在评审上的,以及花在修复烂代码造成的问题上的。只削减前者并不划算——如果省下的时间又跑到后者去,等于没省。
因此团队的目标写得很明确:Claude Code 各个仓库(CLI、桌面端与 Web 应用、移动端)的绝大多数 PR,在至多一名人类在环(这个人可以是作者本人)的情况下合并,且不带来回滚率或事故率的上升。
度量方式也相应确定:跟踪每个 PR 的人类批准数(中位数与 95 分位)、人类评论数,以及 PR 等待人的时长。而回滚率与事故率是护栏指标——这两项一旦上升,说明人类时间没有被节省,只是被挪了个地方。
一次变更的完整旅程
图 1:路径上的大部分环节是自动的,人的注意力只投向风险所在。
从作者的笔记本(或 Slack 里的一个 Claude 会话)出发,一次典型变更要穿过六层检查,失败时还有第七层兜底。
图 2:每一层都会挡住一部分问题、漏掉另一部分;能穿过全部六层的问题极少,剩下的交给回滚。
第一层:在别人看之前,先自己验证
如今大部分评审发生在 PR 存在之前。做法是给 Claude 一件可以运行的东西——测试、构建,或一张用来对照设计稿的截图——并要求它展示输出,而不是声称做完了。随后由一个新的 subagent 带着干净上下文再评审一遍 diff。这两个习惯都来自他们的最佳实践指南。
开 PR 之前,许多人还会跑几个内部 skill:一个找 bug,一个简化 diff,一个做端到端行为检查;涉及 UI 的变更还要对照设计规范。
创建 Claude Code 的 Boris Cherny 称,给 Claude 一个验证自己工作的方式「大概是最重要的一件事」,他估计这能让最终结果好上 2 到 3 倍,并强调验证在每个领域的样子都不同——可能只是一条 bash 命令、一个测试套件,或在浏览器、手机模拟器里试一遍。
当自动评审反复指出同一件事时,就去源头修掉它:改 skill、加 lint 规则,或更新说明文件:
CLAUDE.md:告诉 Claude 这个项目是什么——技术栈、约定、目标与非目标。每次评审都会加载它,所以在大仓库里要写短,再从里面指向其他文档。评审器也会标出违反其中约定的代码,以及让某一行过时的改动。REVIEW.md:由代码所有者撰写,告诉评审器在这块代码里什么才算重要。团队会单独检查评审器是否真的照做。好的REVIEW.md都很短:说清这个仓库里「失败」长什么样(文档是「它在撒谎」,配置是「它路由错了」),限定 nit 的数量,列出该跳过的路径,并要求给出文件与行号作为证据,而不是靠名字猜。它还要求摘要以数量开头,并在没什么可修时直说。
第二层:每个 PR 都跑 AI 评审
每个人工查看之前,PR 都会先过一遍 Claude 评审:它对照整个仓库和 PR 声明的意图读 diff,问三个问题——变更是否解决了它要解决的问题、是否契合系统、是否破坏了别的东西?若是修 bug,它会去找根因。
公开版本 Code Review for Claude Code 已在 Team 与 Enterprise 计划上正式可用,/code-review 则可以在本地跑一个更轻量的版本。研究预览发布时,内部 PR 中获得实质性评审意见的比例从 16% 升到 54%:超过 1,000 行的大 PR 大多会有发现,小 PR 大多干净通过。管理员可按仓库设置 Quick、Standard、Deep 三档,其中 Deep 适合那种「漏一个 bug 的代价高于多花评审时间」的仓库。
发现要先由其他 agent 验证,才轮到人看。多个 agent 同时找 bug,然后另一组 agent 对每条发现投票,只有足够多的票认为它是真的,才会被发布出去。仅涉及风格、诊断信息或清理的建议会被丢弃——这些过滤器是先在自家 PR 上做 A/B 测试才留下的。保留下来的以内联评论呈现,按严重程度排序,并分别标记为 Important、Nit 或 Pre-existing,这样不是这个 PR 引入的老 bug 就不会看起来像是作者的锅。
每条发现都必须被回应:要么修,要么在讨论串里给出理由后关闭。常常是 agent 在夜里就把修复接手做了,作者第二天回来时,PR 已经又过了一轮。
第三层:能拦住合并的安全评审
安全有独立的自动评审。只要 bug 评审或安全评审还有任何一条未闭合的发现,PR 就不能合并——你要么修,要么写一句简短理由关闭讨论串,这也是清除误报的方式。如果后续提交修掉了问题,发现会自动清除。同样的能力可以用开源的 security review GitHub Action 或 /security-review 命令配置。
第四层:能拦住合并的自动检查
常规项目:lint、类型检查、各平台测试和构建。典型的 CLI PR 在有人看之前会跑上几十项检查。PR 模板会问这个变更怎么测过、怎么撤销——Claude 可以代填,但最终要由提出变更的人签字确认。
第五层:按风险分级的人工审批
改一段文档和改自动更新器,风险不同,评审强度也就不同。
| 风险 | 示例 | 需要的人工批准 |
|---|---|---|
| 低 | 文档、文案、仅内部使用的功能、开关后面的增量变更 | 自动评审与安全检查全绿后,无需人工批准 |
| 中 | 常规产品变更,以及缓存、自动更新器、系统提示词等敏感区域 | 一人 |
| 高 | 风险最高的代码,以及一小批始终需要两人确认的路径 | 两人 |
这里有几条值得记住的规则:
- 决定等级的是变更本身,不是作者。一个分类器读变更内容并定级;第二个分类器则追问:即便这个等级不需要人,这次变更是否仍然需要一个人?某些路径永远需要人,包括所有者标记为敏感的路径和任何 CI 工作流文件。
- 只有受信任的作者才走轻量路径。只有仓库信任列表上的作者(主要是拥有该仓库的团队)可以走轻量路径,其他人都需要第二个人批准。agent 的批准永远不能顶替人的批准:自动评审可以让一个低风险变更过关,但它不能填补一个需要人类的席位。
- 谁促成的变更,谁就要负责。对于 agent 写的 PR,指挥 agent 的那个人计入必需评审人之一,和他自己敲了代码一样。
- 一次批准只对应一个具体提交。如果之后落入了系统无法背书的提交——比如 agent 的推送,或某人手工解决的合并——批准必须重新给一次。
第六层:合并队列、开关与灰度发布
合并队列会把变更叠加到 main 上重跑全部检查,避免两个分别通过的 PR 合成一个坏掉的 main。新行为通常先放在开关后面只对 Anthropic 员工开放,内部的高强度使用往往先于用户暴露回归。公开发布先走 latest 通道,stable 通道在其后跟进。
第七层:快速发现,快速回滚
总会有错误漏过去,所以最后一层要做的是尽快抓住它们:开关不用部署就能关闭;Claude Code 有每周轮换的 on-call;事故复盘会追问哪一层本该抓住这个问题。
作者也承认不足:发现坏合并仍然依赖作者与 on-call,以及回滚与事故看板;目前还没有那种「指标一动就收紧审批」的断路器,工程师希望在更多代码转向零人工合并之前先有这个。一位同事的说法是:慢下来确实会降低错误率,但那主要是因为什么都做得更少了——他们宁愿让自己更快地发现和修复问题。
让评审器本身变得更好
每一次事故都变成一条 eval。团队收集了历史上引发事故的 PR(连同它们的 forward fix 与回滚),请熟悉那部分代码的工程师逐条确认 bug 及其位置,评审器每天在这个集合上跑一遍。改评审器的提示词、工具或模型时,都要用全部用例重新打分。
噪声靠观察人的行为来度量。想多抓 bug,只要不在乎误报就行,所以必须有反向约束。团队按 PR 作者的反应给评审留下的每条评论分类:改了、说它是错的、说这是有意行为、觉得无所谓。他们还会在已知干净的 PR 上跑评审器,统计它多久会报出一次「照着改反而有害」的建议。写下来的优先级是:抓真 bug 第一,减少评审轮次第二。
作者特别指出,当作者是 agent 时,噪声的代价更高:人可以几秒钟挥掉一个 nit,而 agent 会去修它——那意味着又一次提交、又一轮评审。
评审必须收敛。agent 作者加 agent 评审器可以无限互相消耗:有一个 CLI PR 在一夜之间经历了 50 多轮评审与修复,最后被作者叫停。他们对评审器反复标记的代码跑 git blame,发现约 59% 是评审器第一遍就已有的代码——它不是每轮在找新 bug,而是每轮多找几个老 bug。团队自己也把这个习惯养坏了:因为每一遍总能抓到点东西,就默认多跑几轮,这在有风险的变更上值得,但不该用在每个 PR 上。
于是他们同时跟踪通过所需的轮次与召回率,并改掉了复审方式:
- 轮次上限:三轮之后,评审器会请作者停下来重新考虑方案。
- 只审增量:头几遍之后只复审新增的 diff。
- 按类报错:让作者把同类问题一次改完,而不是只改一行。
- 不重复:已经发过的发现不再重发。
此外,评审 agent 每晚还会在已有代码上跑一遍,去发现那些「还没在别处暴露出来」的老 bug。收敛改造的效果是:一轮评审加修复即通过的 PR 从 65% 升到 78%,需要五轮以上的从 8.9% 降到 1.5%,平均通过所需评审次数从 2.08 降到 1.32。
人在环路里的位置
把一位资深工程师从深度工作中拽出来,只为拦住一个常规错误,代价远高于一次自动评审。在 Anthropic,工程师的工作已经从「读每一份 diff」转向机器不擅长的判断:
- 这东西到底该不该做?方向、品味与范围。有一个宣称已经解决评审瓶颈的团队,仍然保留了对外部人员提交的变更的人工评审,就是为了让有人问一句「这事我们真的要做吗」。
- 高风险代码:计费、自动更新器、CI 工作流。
- 会成为他人范式的架构。
- 读证据:测试输出、跑过的命令及其返回、截图、评审器的发现。如果你说不出这些检查会漏掉什么,就该要求一次真正的评审,而不是快速点个批准。
- 对结果负责:每一个上线的变更都由某个人负责,不管代码是谁敲的。
「你让它落地,你就负责」
如果一个小或中等规模的变更落地后出了问题,团队惯例是由你本人来修。支撑这个惯例的是几件事:变更都小,所以好评审、好调试、好回滚;一切都可逆,开关、回滚与分阶段发布能在几分钟内撤销绝大多数错误;爆炸半径决定门槛,昂贵的代码配更多人和更多检查;回归会很快浮出水面,靠遥测与内部使用;这不是追责——负责修复意味着你拥有最多的上下文,事故复盘看的是系统。
所有权也是共享的。团队很多工作在公开频道里进行,任何人都能看到别人在做什么、接过一个话题,或让 Claude 去补一个缺口,反馈也来自并不拥有那块代码的人。这种开放性正是「不必守好每一行」还能保持质量的重要原因。
至于方向变更:agent 让启动一件事变得便宜,因此总有一些工作不该落地。通常频道里有人问为什么、指出早先的决定、或建议一条更简单的路,作者就把 PR 关掉或改写。因为代码写得快,关闭 PR 不让人觉得是损失——诀窍是在讨论串里尽早提出不同方向,而不是在完成的 PR 上留一条阻断性评论。
如何在你的团队里落地
文章最后给了一份可操作的清单:
提交 PR 之前
- 给 agent 能运行的检查,写进简短的
CLAUDE.md,再用 hook 跑格式化与 lint。 - 本地跑
/code-review与/security-review,或用干净上下文的 subagent 做一次评审。 - 加一份
REVIEW.md,把反复出现的评审意见搬进去。
每个 PR 上
- 强制 CI,并在 PR 模板里加入「测试方式」「风险」「如何撤销」。
- 先在一个仓库接入 AI 评审器(Code Review for Claude Code 或 Claude Code GitHub Action),用几周时间调
REVIEW.md,再扩大范围。 - 加上自动安全评审,并要求合并前所有评审讨论串已解决。
- 评审强度匹配风险:常规变更快速过一遍,漏 bug 代价高的地方深挖(Quick / Standard / Deep)。
- 限制评审轮次,头几遍之后只复审新增的 diff。
审批环节
- 把风险分级写下来,由变更而非作者决定;先严后松,松开要有证据。
- 轻量审批路径只留给受信任的作者。
- 用 CODEOWNERS 与分支保护,让认证、计费、CI 与发布工作流、安装器始终需要人。
- 绝不让机器人的批准替代必需的人类批准;有新提交时作废旧批准。
合并与之后
- 使用合并队列、功能开关、先内部使用、分阶段发布,以及一步回滚。
- 把事故与回滚变成 eval 集合,评审器的提示词、工具或模型一变就重新打分。
- 度量人类时间,用回滚率与事故率当护栏。
理解代码这件事怎么办
评审的第二项工作——在团队内传播代码理解——文中并没有正式流程。团队里没有人、也不需要有人把 Claude Code 完整装进脑子。当有人想弄懂某块代码时,就让 Claude 为那一小片写一份讲解:几分钟就好,而且反映的是代码当下的样子。
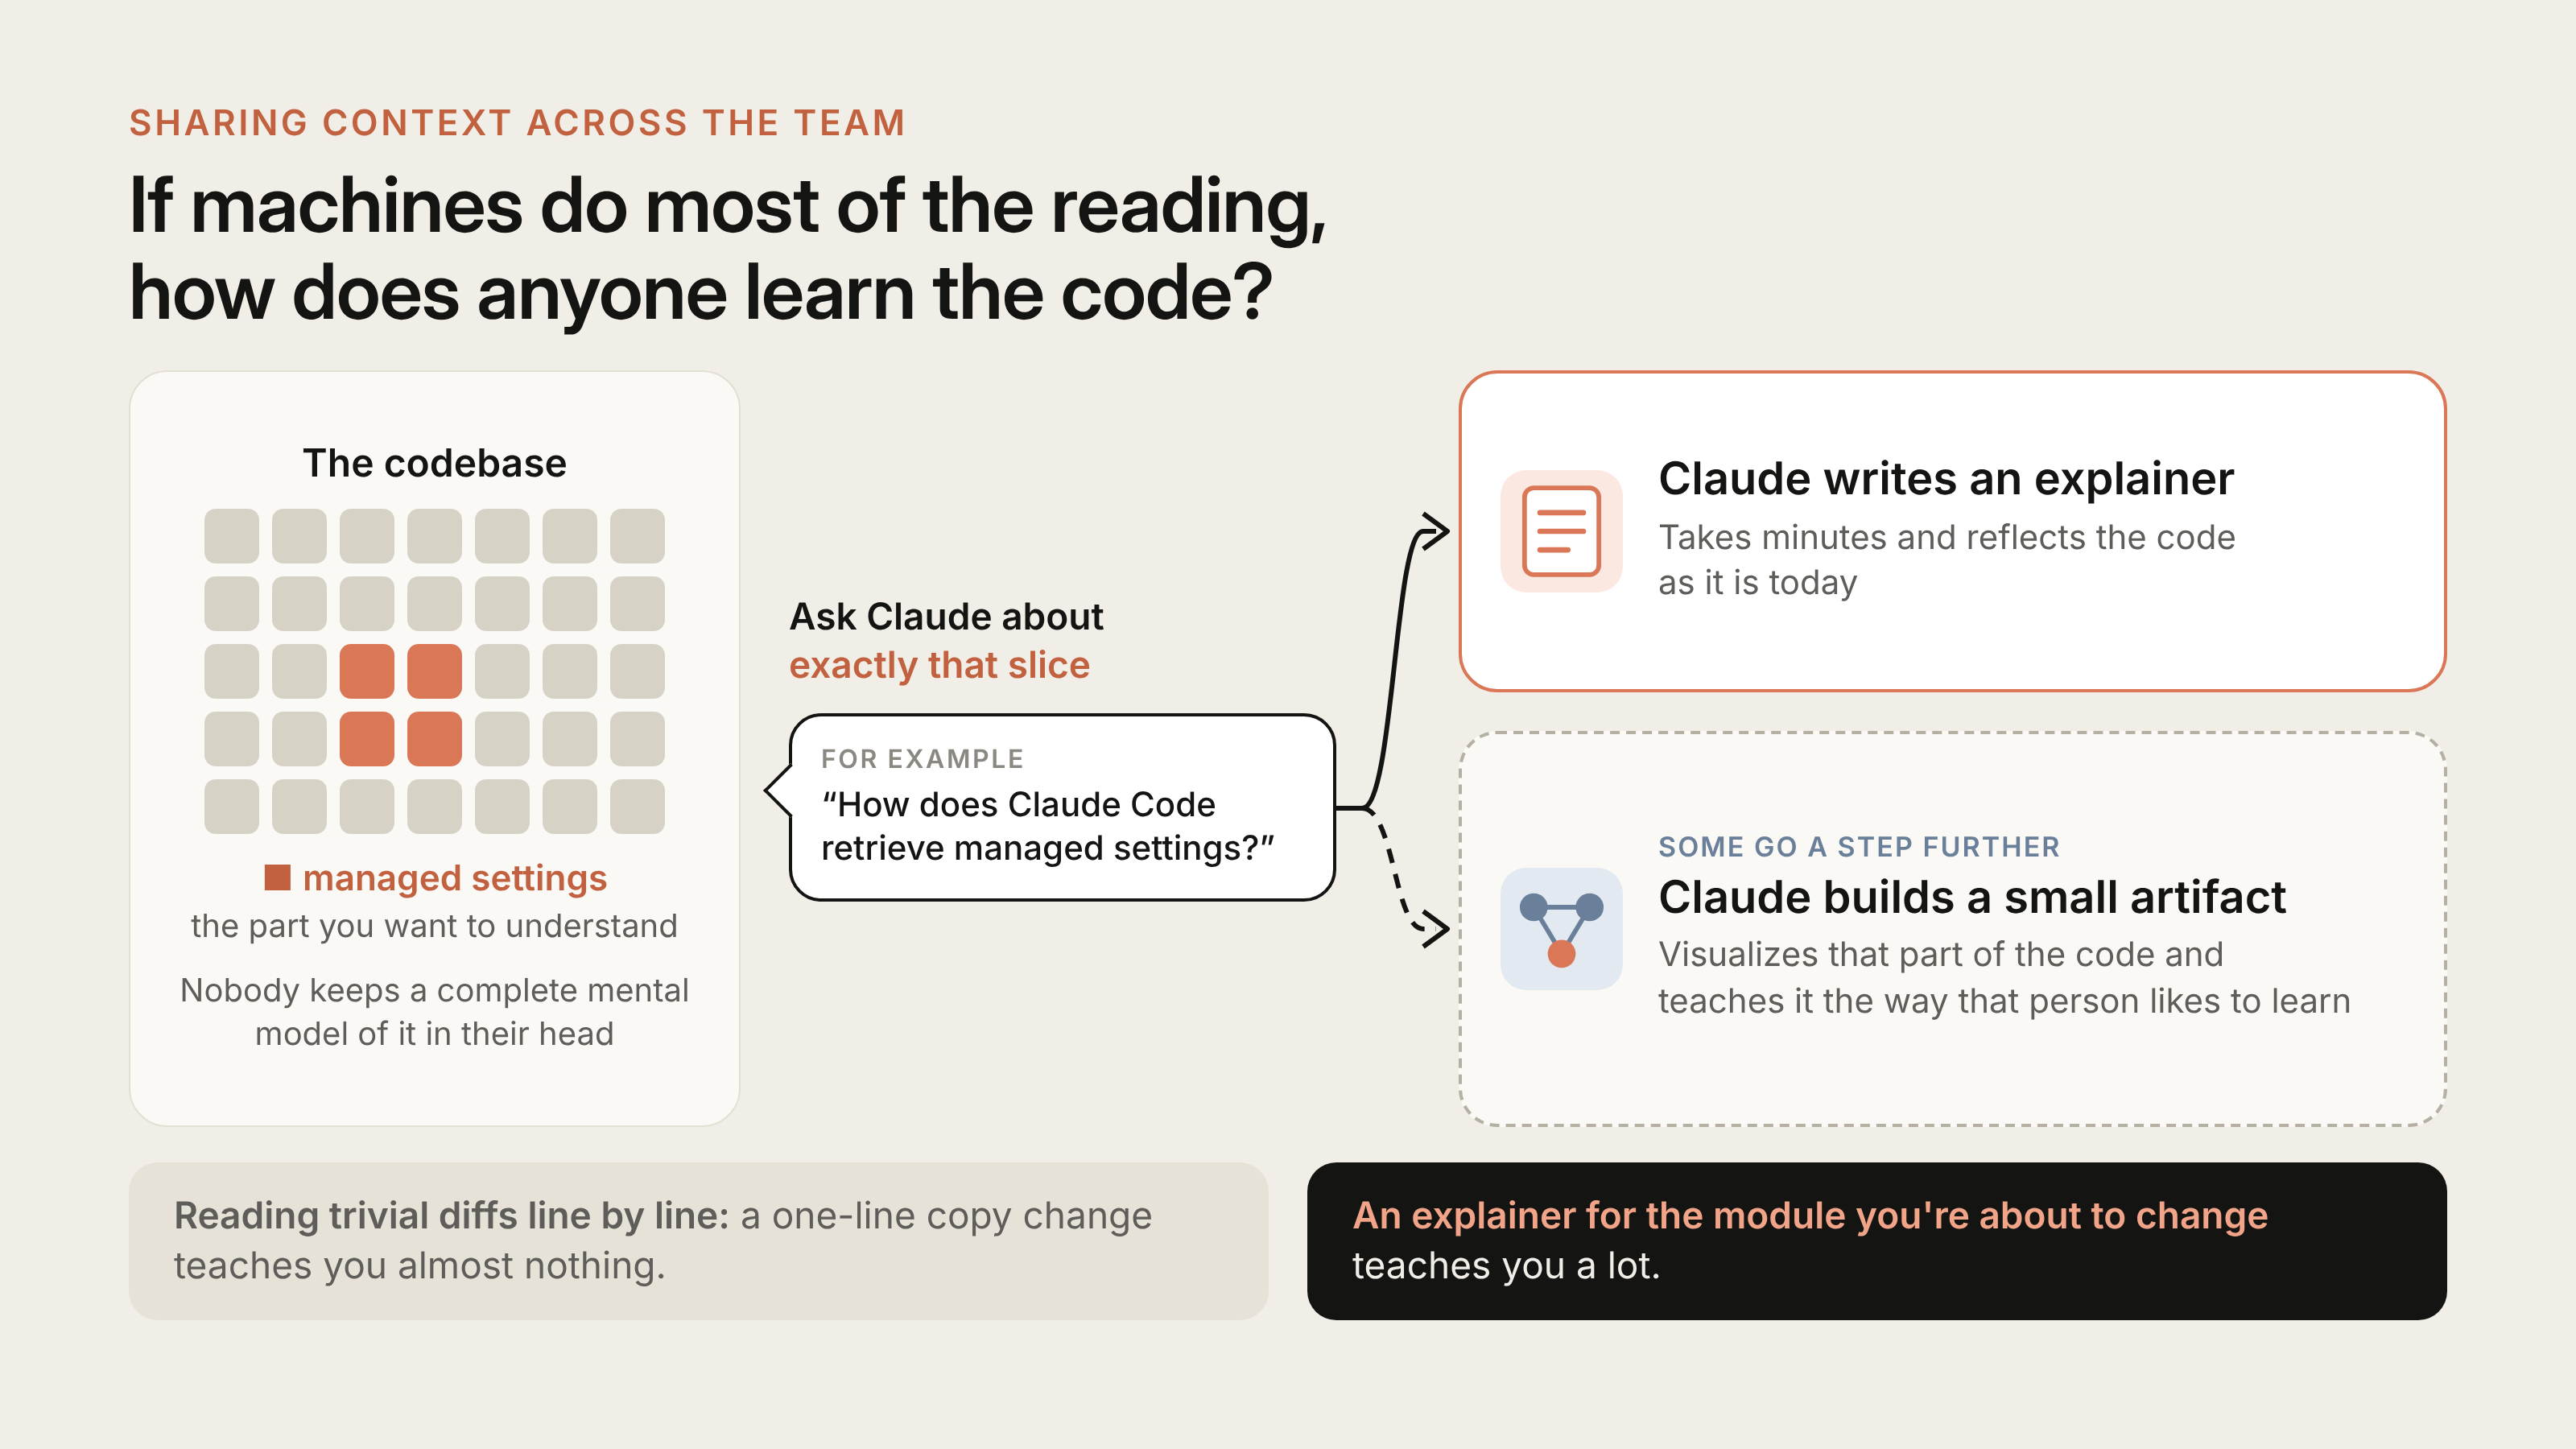
图 3:一行的文案改动几乎学不到什么,而针对你即将修改的模块的讲解能学到很多。
有些人更进一步,让 Claude 造一个小小的可视化制品,按那个人偏好的方式去讲那块代码。文章认为,如果目标是让人的注意力花得值,这种做法胜过逐行读琐碎的 diff:一行的文案改动教不会你什么,而你即将修改的那个模块的讲解能教会你很多。
核心总结
- 结果:6 月到 9 月合并 PR 翻倍以上,回滚比例下降超 40%;Anthropic 单仓日落地变更从 5 月的约 2,500 次增至 9 月的 30,000 次以上
- 目标:绝大多数 PR 在至多一名人类在环(可为作者本人)的情况下合并,且回滚率与事故率不升;用人工批准数、人工评论数与等待人的时长度量人类时间,用回滚率与事故率当护栏
- 六层检查:PR 前的自我验证、AI 评审、可阻断的安全评审、可阻断的自动检查、按风险分级的人工审批、合并队列与开关灰度,最后一层是快速检测与回滚
- AI 评审效果:研究预览上线后,内部 PR 获得实质性评审意见的比例从 16% 升到 54%;发现先由多个 agent 投票验证,再按 Important / Nit / Pre-existing 标记,且每条都必须被回应
- 分级的审批:低风险在自动检查全绿后无需人工,中风险一人、高风险两人;等级由变更决定而非作者;agent 的批准永远不等于人的批准;一次批准只覆盖一个提交
- 让评审器收敛:git blame 显示反复被标记的代码约 59% 是首轮就已存在的旧代码;加轮次上限、只审增量、按类报错、不重复之后,一轮通过率 65%→78%,五轮以上 8.9%→1.5%,平均评审次数 2.08→1.32
- 人留在环路里的五件事:该不该做、高风险代码、会成范式的架构、读证据、对结果负责
- 落地清单:
CLAUDE.md+REVIEW.md+ hook、强制 CI 与安全评审、风险分级写在纸上、合并队列与开关灰度、把事故变成 eval、用回滚率当护栏
这篇文章最值得借鉴的不是某个工具,而是它把问题重新定义的方式:不问「有没有人读过代码」,而问「这次变更可能出什么错、该由哪道检查来兜住」。它也诚实地标出了边界——噪声在高频 agent 作者面前代价更高、评审器需要轮次上限才能收敛、事故处置仍依赖人和看板,而且他们自己还没有实现在指标异动时自动收紧审批的断路器。对正在让 agent 开 PR 的团队来说,这份清单里几乎每一项都能今天就开始做。
原文:How the Claude Code team does code review(claude.dev Blog,2026-10-15)
参考:


