2026 年 10 月 5 日,硬件深度分析媒体 Chips and Cheese 发布了对 NVIDIA Vera 平台 CPU 核心 Olympus 的详测,作者是 Chester Lam。传统上服务器核心的单线程性能总比同期桌面核心弱,但这一差距在收窄:AMD 近两代服务器核心把频率越推越高,而 NVIDIA Olympus 选择了另一条路——不追频率,靠每时钟周期的性能(IPC)把服务器单线程性能顶到接近桌面的水平。本文结合 Chips and Cheese 的独立实测与 NVIDIA 官方技术博客,把 Olympus 核心与它所处的 Vera CPU 平台放在一起介绍。
先看平台:Vera CPU 为智能体 AI 定制
要理解 Olympus 为什么长成这样,得先看它所在的平台。NVIDIA 在同期发布的技术博客中把 Vera CPU 的定位讲得很直白:智能体 AI 正在把关键执行路径推回 CPU。智能体在沙箱里执行代码、调用工具、检索上下文、访问数据库、分析结果,然后再把信息交回模型;当成千上万个这样的循环在 AI 工厂里并发运行时,CPU 性能直接决定单个智能体的响应速度和整体吞吐。
这类负载的需求与传统云 CPU 不同,NVIDIA 归纳为四点:插槽满载时仍要有强劲的单线程性能、每核心要有足够的内存带宽来供给大量活跃执行上下文、并发下的延迟要可预测、要能高效处理不规则控制流与长依赖链(大量指针追逐)。而传统云 CPU 的设计思路是堆核心密度、服务更均匀的负载。也因此,Vera 把 Olympus 的核心目标定为「最大化 IPC」而不是频率。
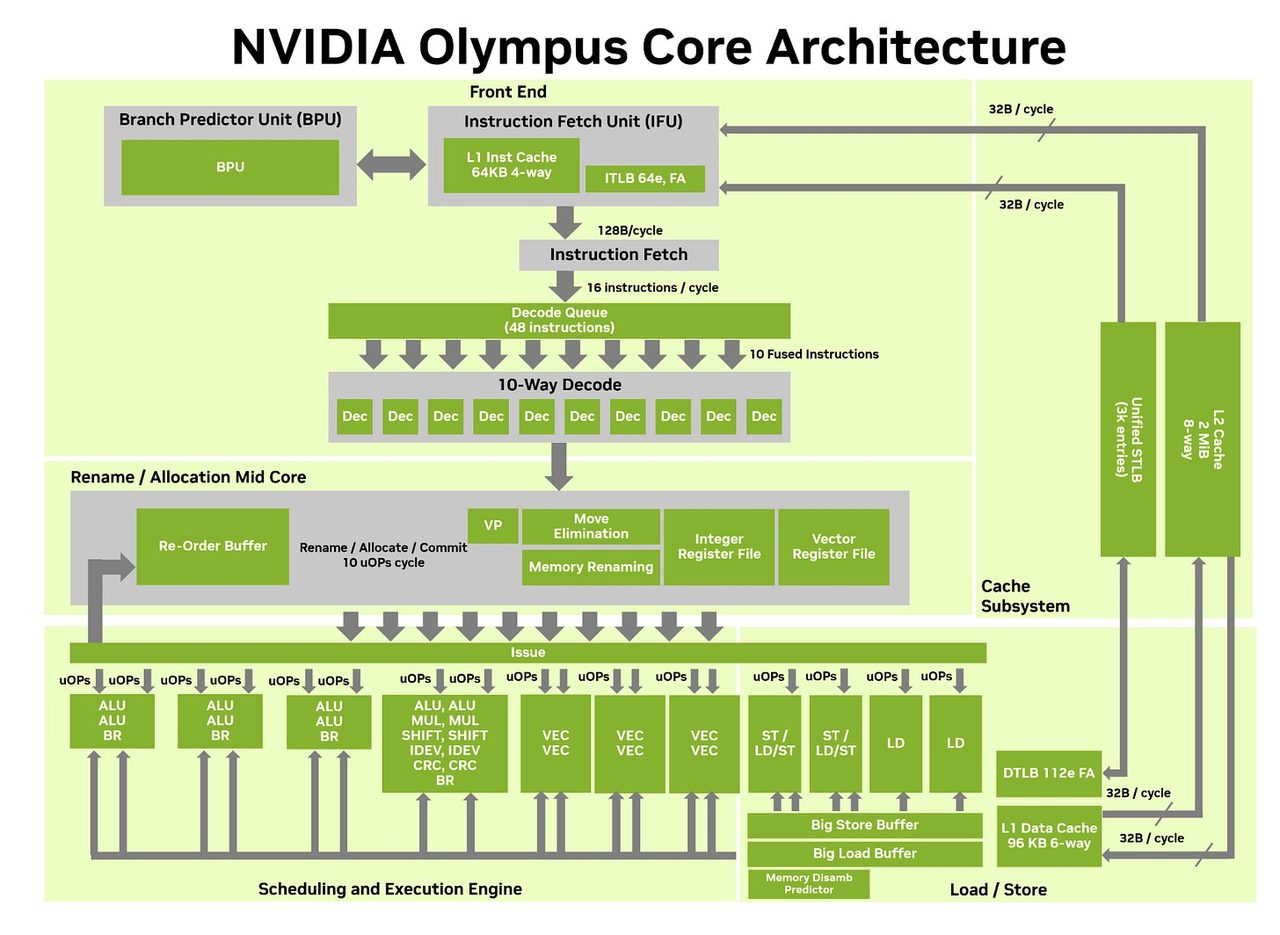
NVIDIA 把 Olympus 分成四个部分:前端(强分支预测 + 高带宽取指 + 10 宽解码)、中间核心(重命名/分配、大重排序缓冲与物理寄存器,并用内存重命名、值预测、关键路径加速来打破依赖)、执行引擎(整数/分支/向量/浮点/加密/访存资源均衡调度)、缓存子系统(深层缓存层次 + 内存消歧 + 多个硬件预取引擎)。其中最值得注意的是一个专门为图分析设计的「图预取器(graph prefetcher)」——因为智能体常处理运行时对象、检索索引、工具状态、图结构与稀疏数据,这类访问每个地址都依赖上一次查找的结果,传统预取器几乎无能为力。
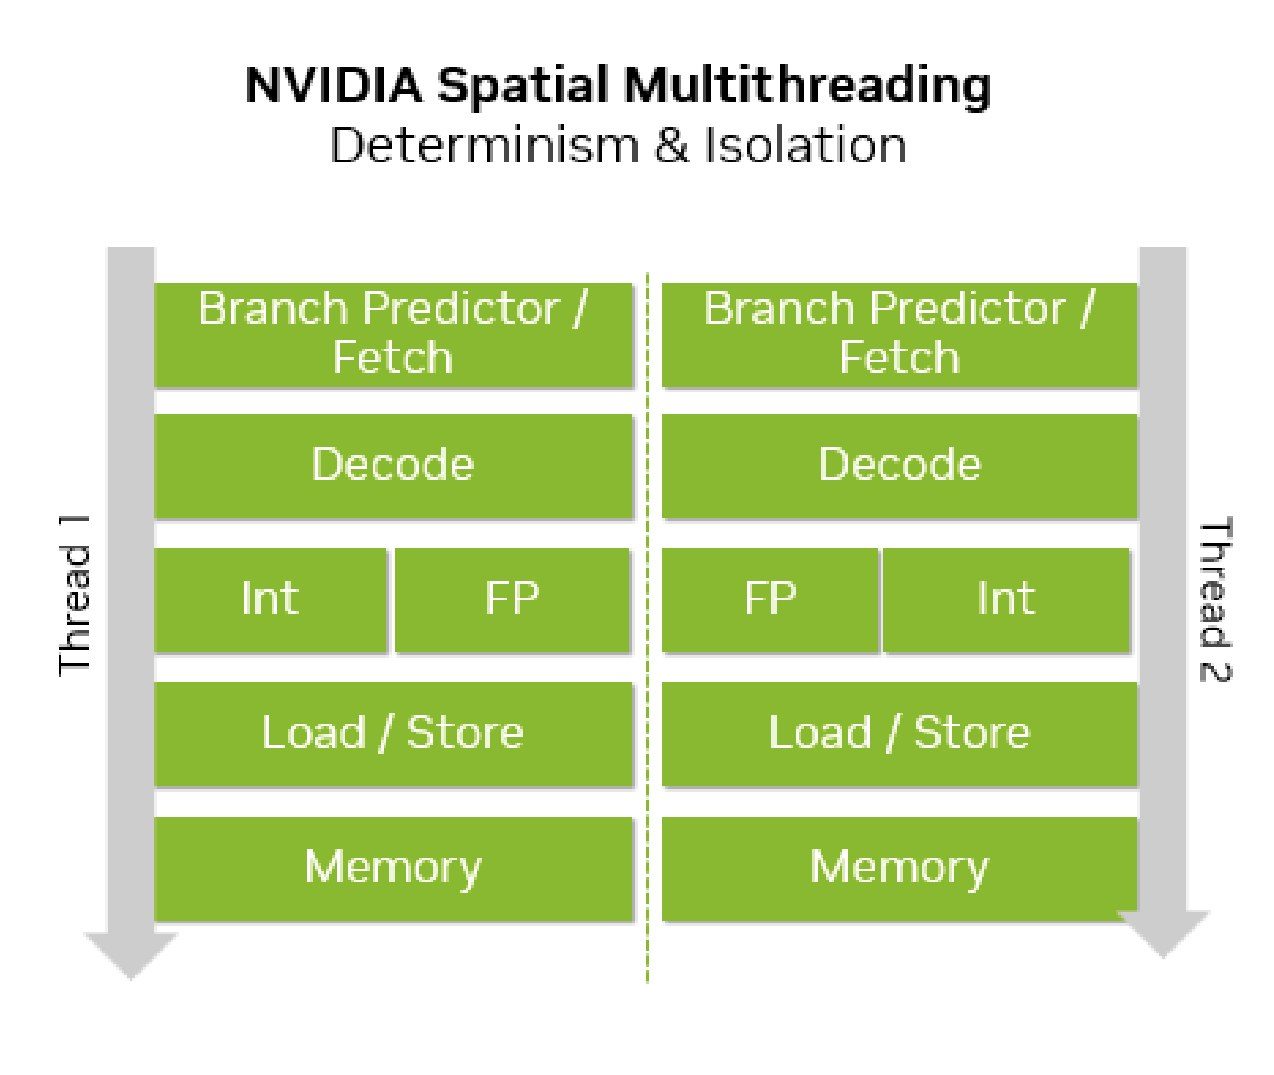
Olympus 还带来一个此前从未在 NVIDIA CPU 上出现的特性:Spatial Multithreading(空间多线程)。Vera CPU 共 88 个 Olympus 核心、176 个 SMT 线程,NVIDIA 的说法是:既可以让它作为高吞吐单线程核心运行(兄弟线程只处理管理类活动),也可以当作两个更隔离的执行上下文来提高线程密度,从而减少线程间干扰、给出更一致的延迟——这正是 Chips and Cheese 在实测中确认的「静态切分」策略,好处与代价都来自这一点。
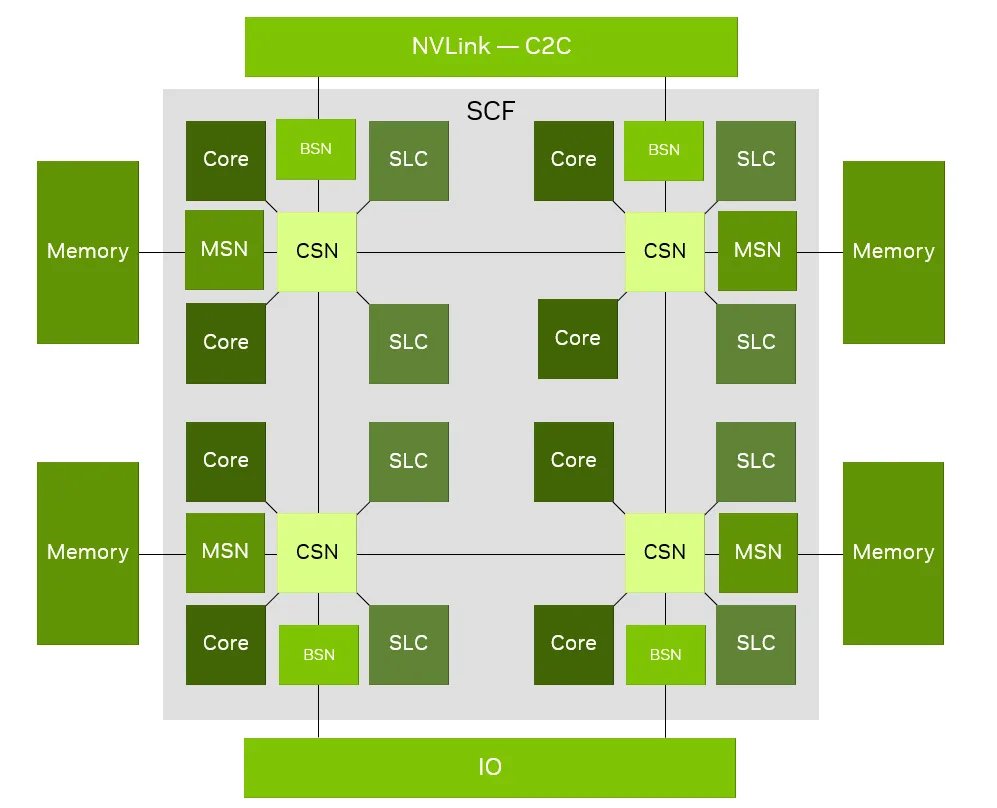
平台层面,Vera CPU 用 NVIDIA Scalable Coherency Fabric(SCF)把核心、共享缓存、内存控制器、I/O 与 NVLink-C2C 接口连成一张相干高带宽片上网络,双向对分带宽最高 3.4 TB/s,并集成 164 MB 统一 L3 缓存;缓存与互连都在同一颗单体计算 die 上,避免了 chiplet 拆分常见的跨 die 跳转延迟与波动。内存则改用 SOCAMM2 形态的 LPDDR5X:聚合带宽最高 1.2 TB/s,折合每核心最高 14 GB/s,相比 DDR5、MRDIMM 服务器方案在同样带宽下内存功耗明显更低;而且它是模块化、可现场更换的,不再是焊死的 LPDDR,兼顾了数据中心的可维护性(RAS)。
低频宽核:学 Cortex X925,再放大一圈
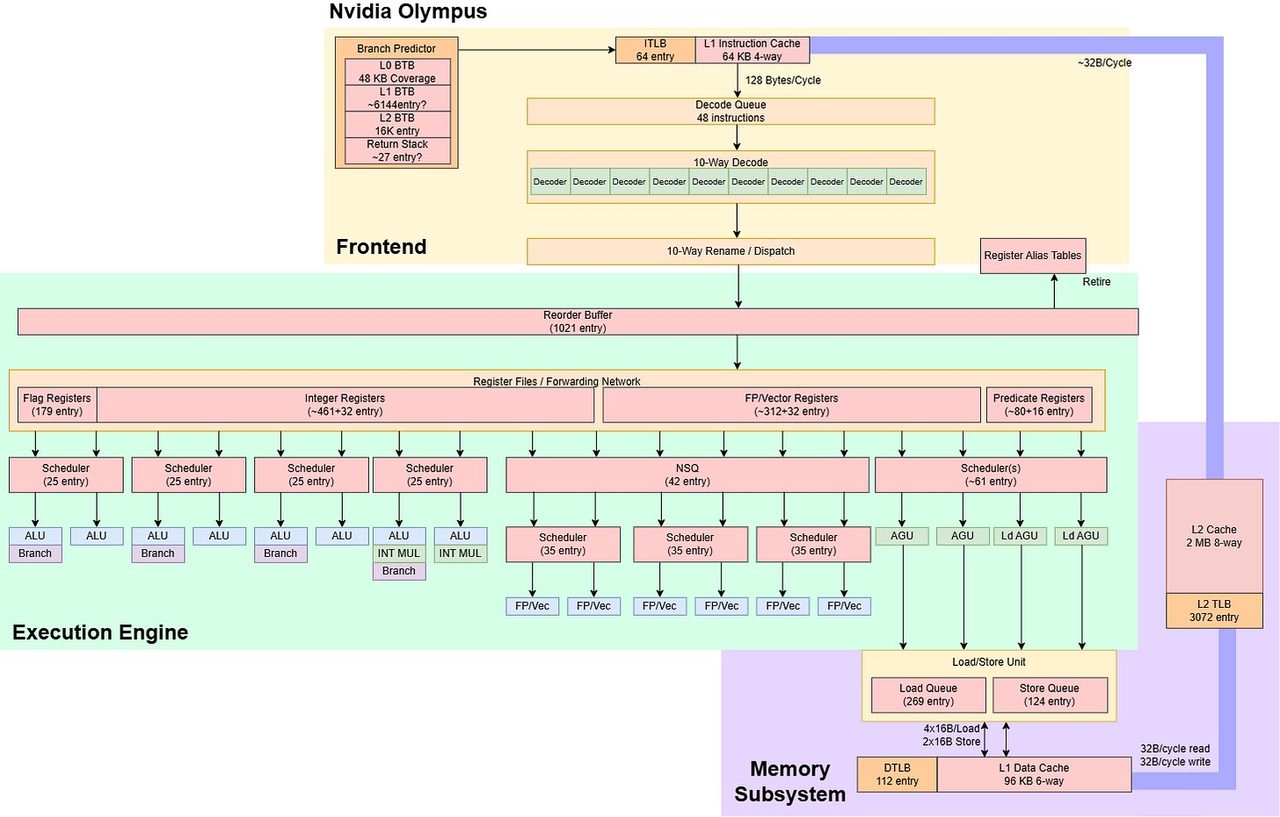
Olympus 是一枚 10 宽乱序核心,乱序结构大得「有点滑稽」,而频率只有 3.3 GHz——在今天的服务器里也不算高。这意味着它必须靠极强的单周期性能来达标。
它的总体布局与 Arm 的 Cortex X925 有很多相似之处:都用半分布式调度器、执行单元排布也接近,目标都是在不追高频率的前提下拿到高性能;区别在于 Olympus 把乱序结构做得比 X925 更大,并加上了 X925 没有的同步多线程(SMT)。此外 NVIDIA 在浮点调度器前放了一个不参与调度的队列(non-scheduling queue),这也是与 Arm 不同的设计。
分支预测:方向预测略逊 X925,吞吐更激进
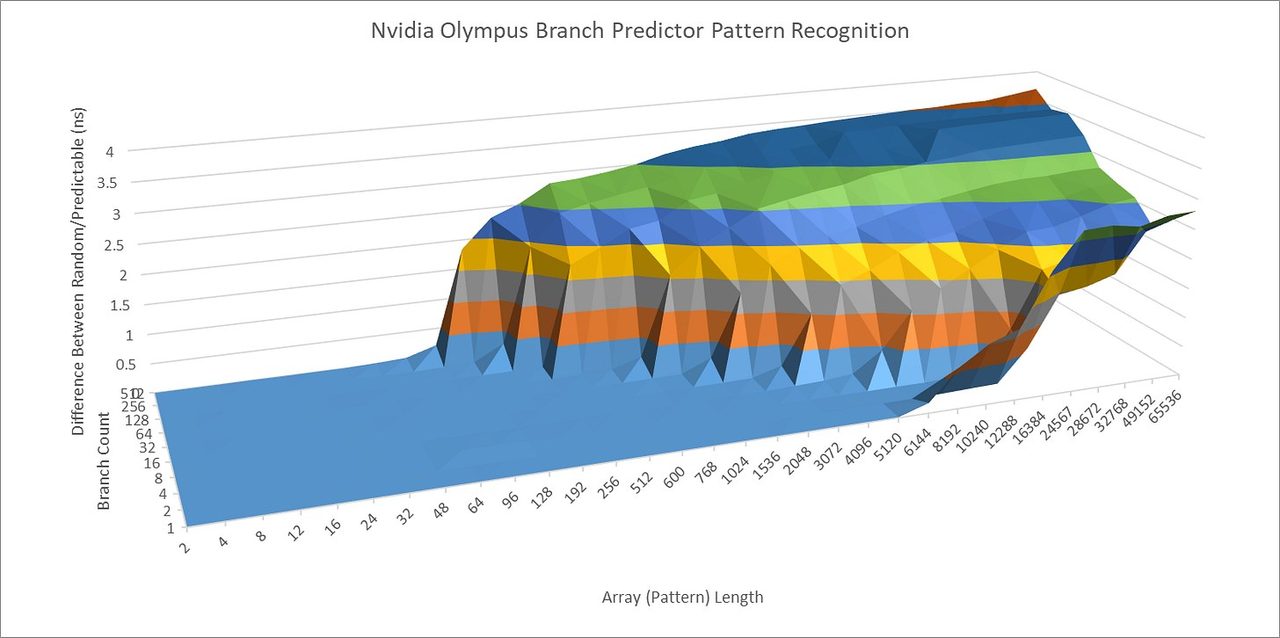
宽核加深重排序窗口,一旦分支预测错误代价很大,因此 Olympus 需要很强的预测器。在「不同模式长度的 taken/not-taken 分支」测试中,它略逊于 X925:X925 的方向预测器在少量分支下能跟踪约 1.6 万–2.4 万个全局历史模式,512 条分支时可超过 6.4 万;Olympus 对应约为 5000–6000 和 4.8 万。
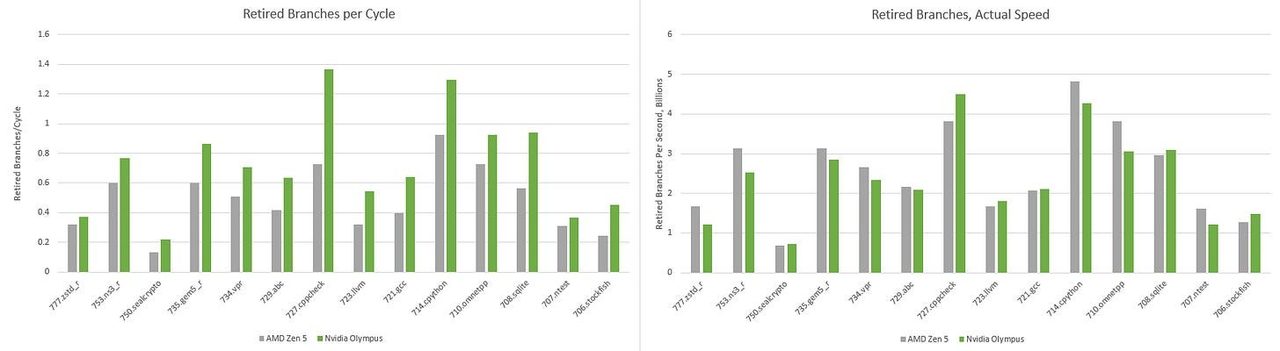
到 SPEC CPU2026 上,其预测准确率与 Intel、AMD 最好的核心相当:略低于 AMD Zen 5,略高于 Intel Lion Cove。各负载互有胜负,说明想用一个预测器覆盖各种程序行为有多难。浮点套件对分支预测更友好,Olympus 凭借 731.astcenc 的大幅领先整体反超 Intel 与 AMD。
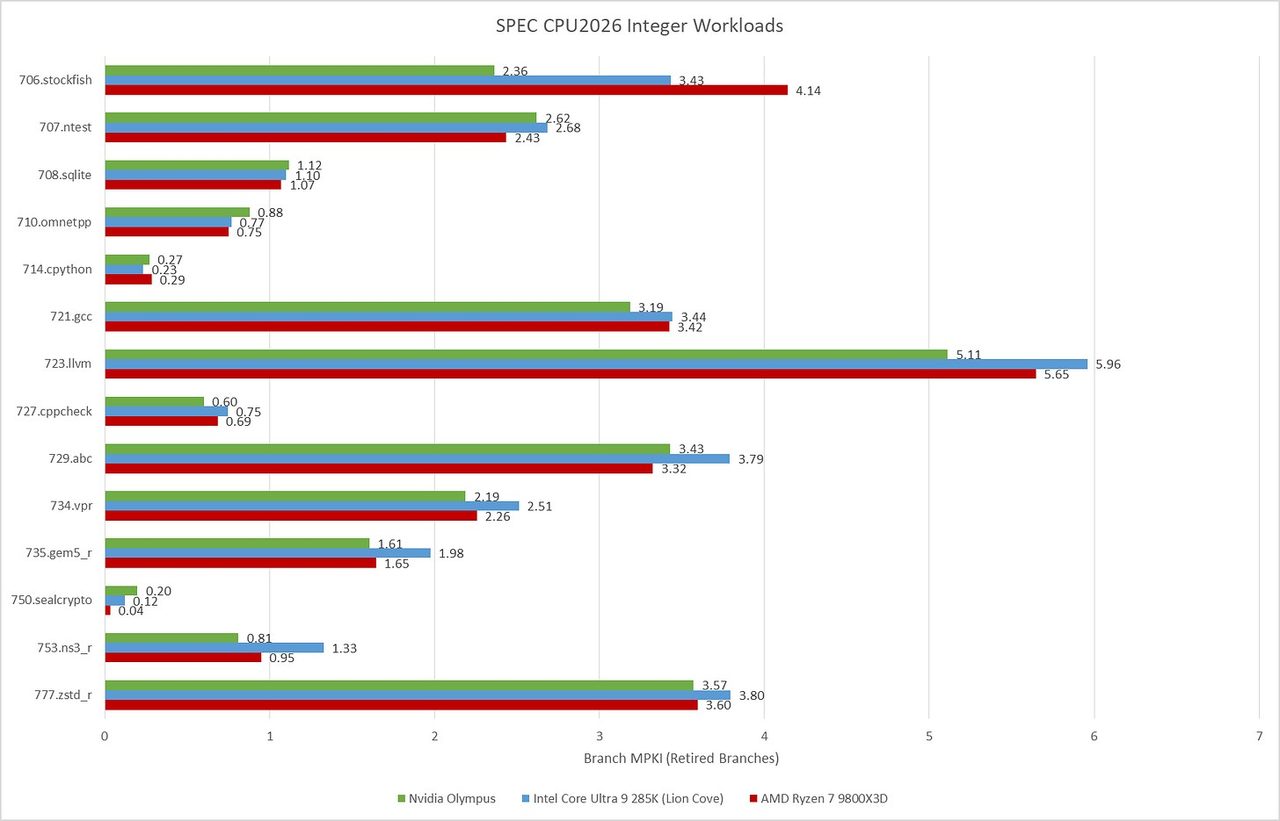
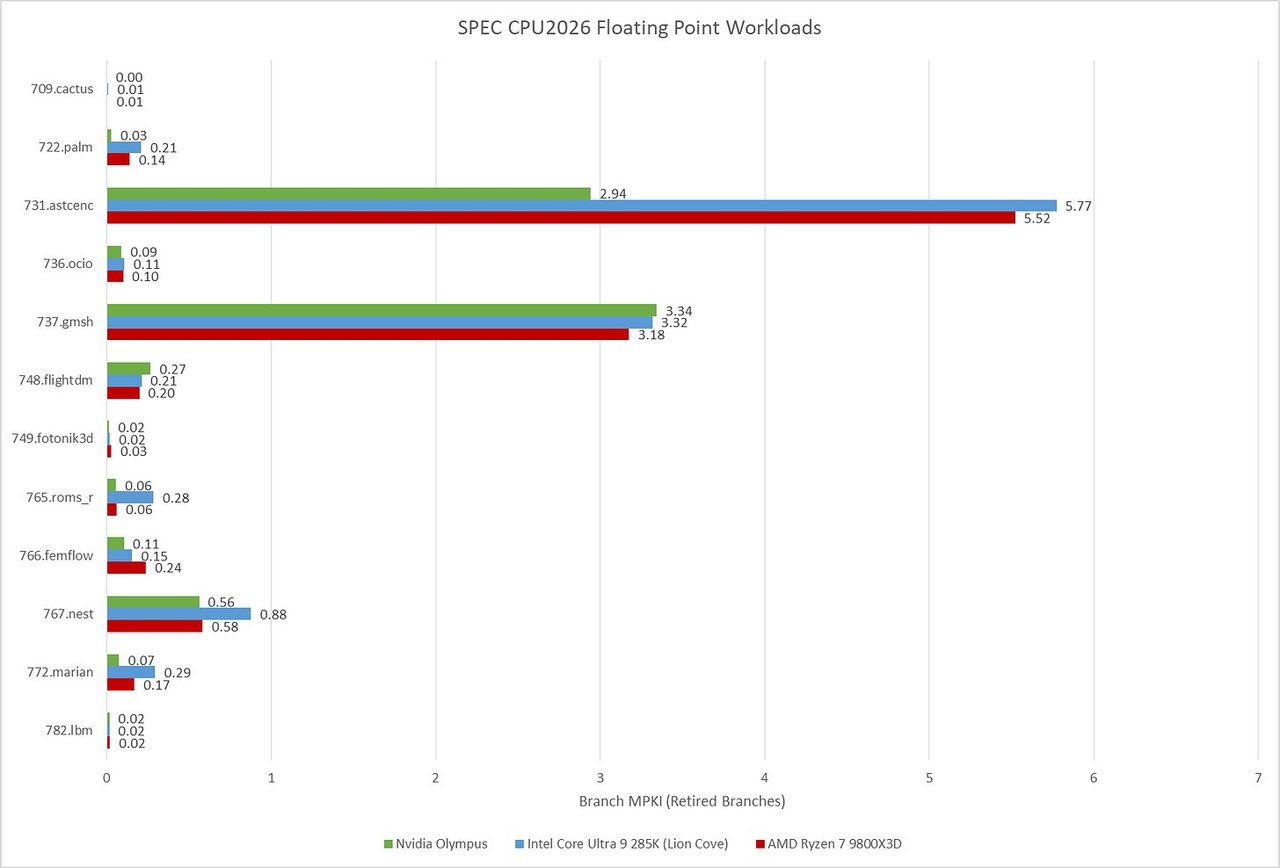
预测速度同样关键,因为代码里 taken 分支很常见。与 Zen 5 一样,Olympus 每个周期能处理两条 taken 分支;但不同于 Zen 5 和 X925,它的这一能力绑定的是指令足迹而非分支数量——指令足迹超过 48 KB(大致对应指令缓存容量)后,每周期两条 taken 分支的能力就会失效,此时改用 16K 条目、4 周期延迟的 BTB。
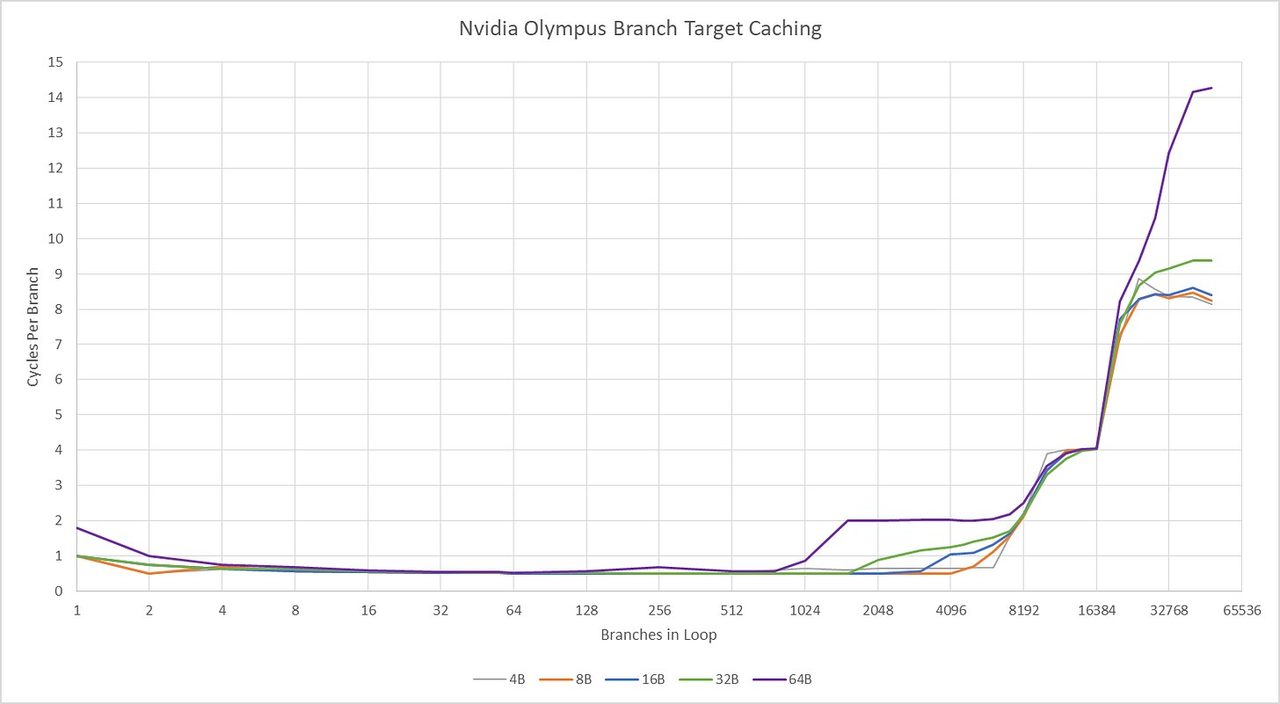
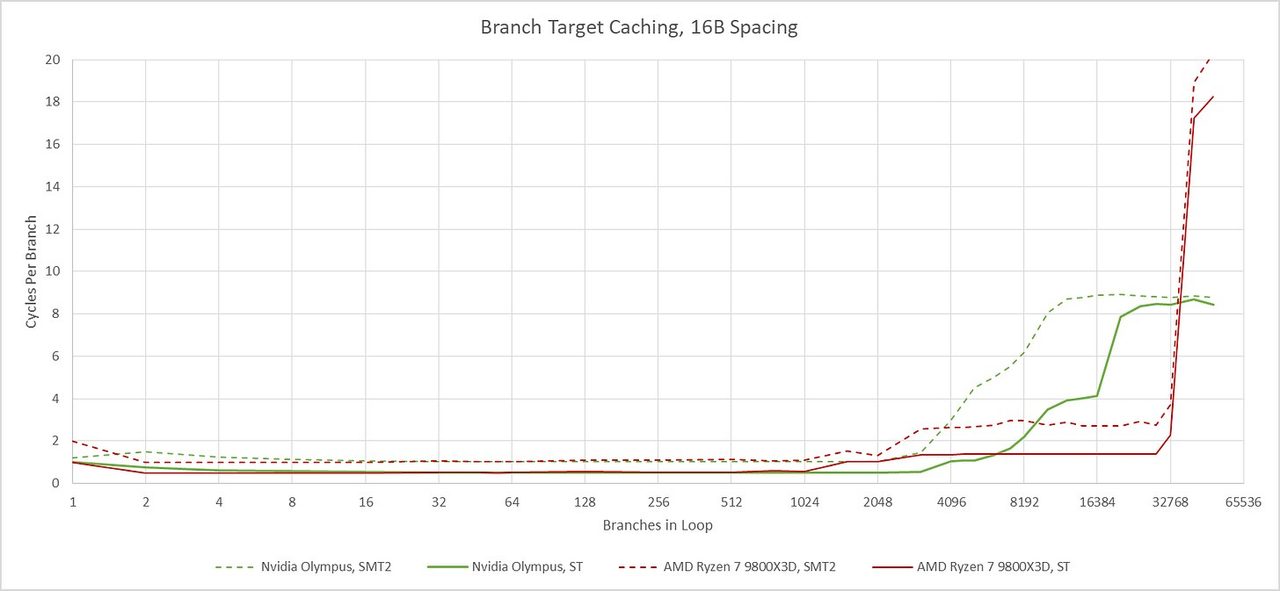
双线程时,NVIDIA 把分支目标缓存结构一刀切分,每个线程各得约一半容量,即使两个线程属于同一进程、共享地址空间也不能共享条目;从每个线程看,16K 条目的二级 BTB 每 5 个周期才给出一个目标,从核心整体看约每 2–3 个周期一个。
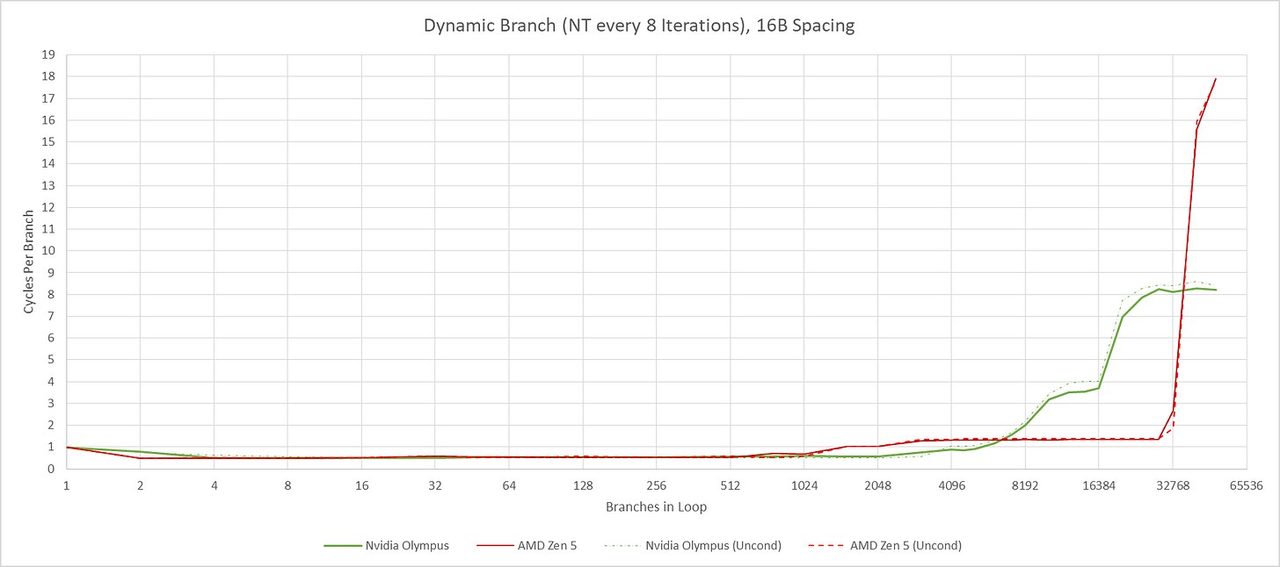
NVIDIA 与 AMD 都使用「提前索引」(ahead indexing),一次查表为接下来两条分支给出预测。NVIDIA 声称 Olympus 凭借更完善的流水机制,每周期预测数可达竞品的 2.3 倍。
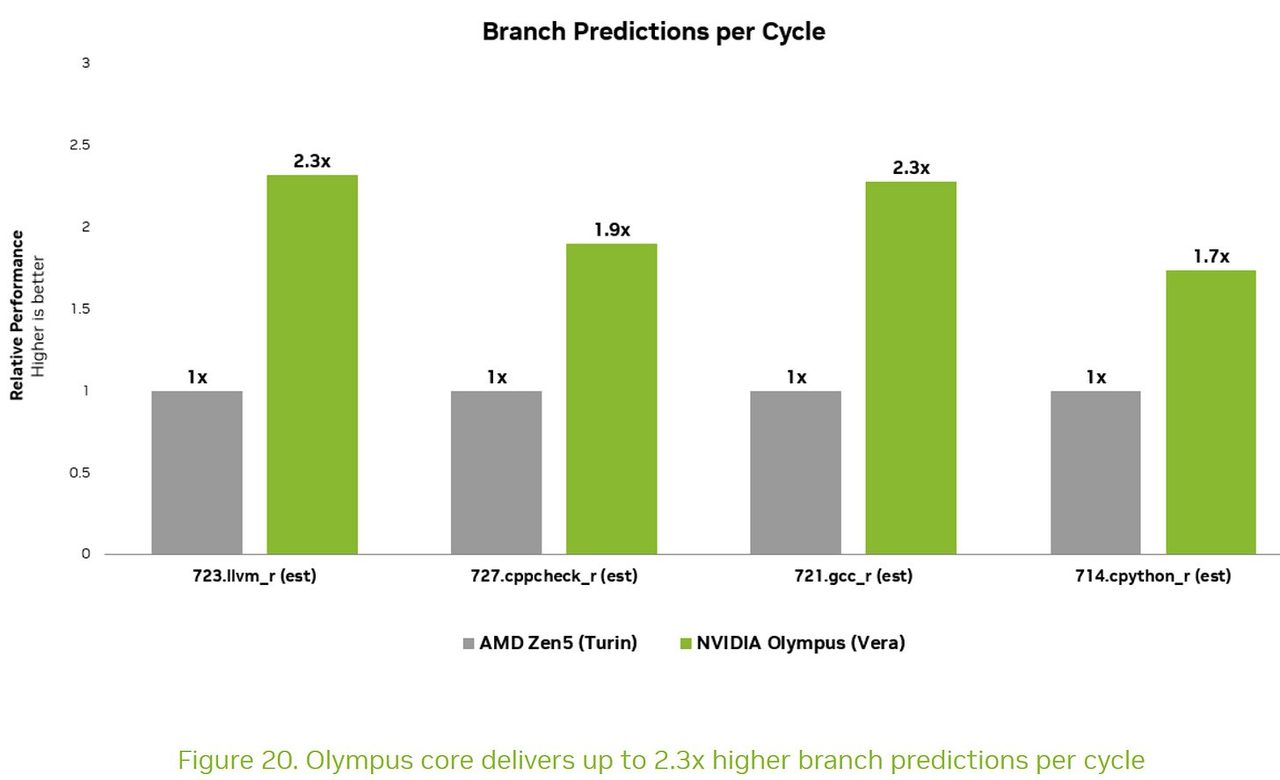
作者对此持保留态度:两家的架构都不提供统计预测次数的硬件计数器,无法验证;而且「每周期预测数」本身未必是有意义的指标——预测错误之后的预测毫无价值,前端喂得动时多预测也不提升性能。另一种解释是:Olympus 本就设计成每周期推进更多指令流,所以预测数自然更多;Zen 5 则是为高频率设计。把频率算进去后,两者完成分支的速率其实相差不远。
取指与重命名:128 B/周期,但双线程被腰斩
取指地址先经 64 条目全相联指令 TLB 翻译,再从 64 KB 四路组相联指令缓存取指,每周期可向 48 条指令的解码队列送入 128 字节;128 字节最多含 32 条指令,远超解码吞吐,其用意大概是在长延迟分支或预测错误后让前端快速追上。
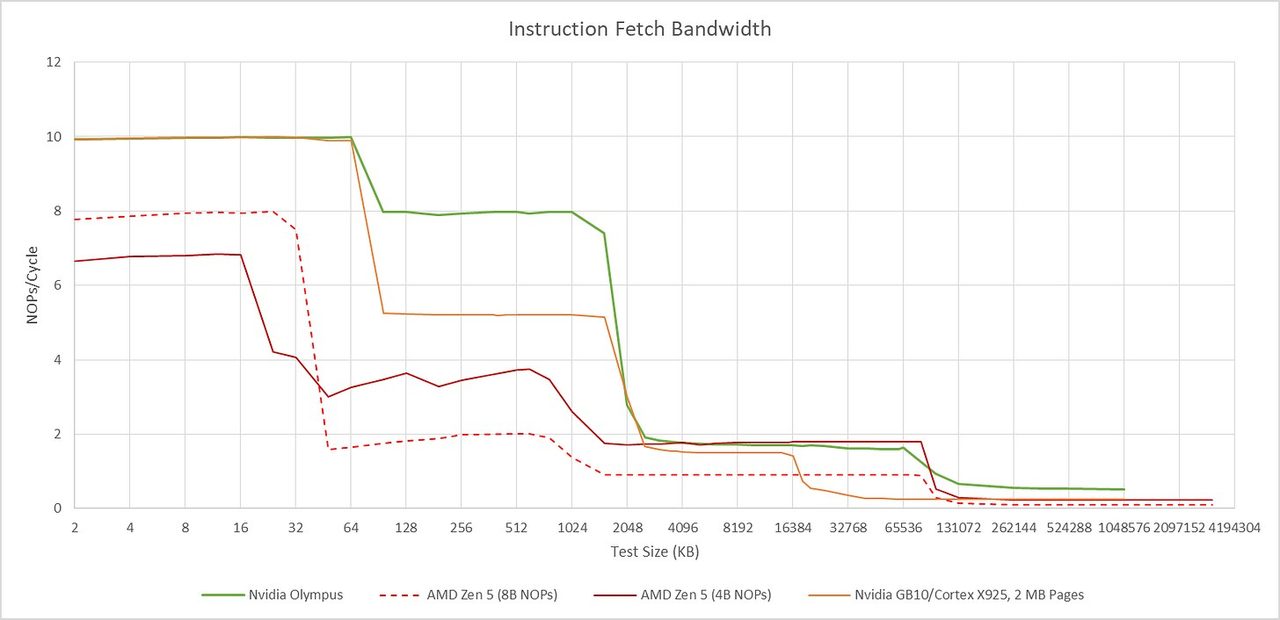
大指令足迹表现不错,能从 L2 以 32 B/周期取指,单线程的 L2 代码吞吐明显高于 Zen 5 与 X925;一旦指令溢出到 L3,吞吐同样骤降。但核心跑两个线程时,不到 1 MB 就出现取指带宽的断崖式下跌,说明 Olympus 对 L2 做了静态切分——哪怕兄弟线程只是跑个几指令的小循环、完全不访存也一样;一个高 IPC 线程(纯 NOP)的吞吐会直接减半,即使另一个线程正卡在低 IPC 的长延迟上。
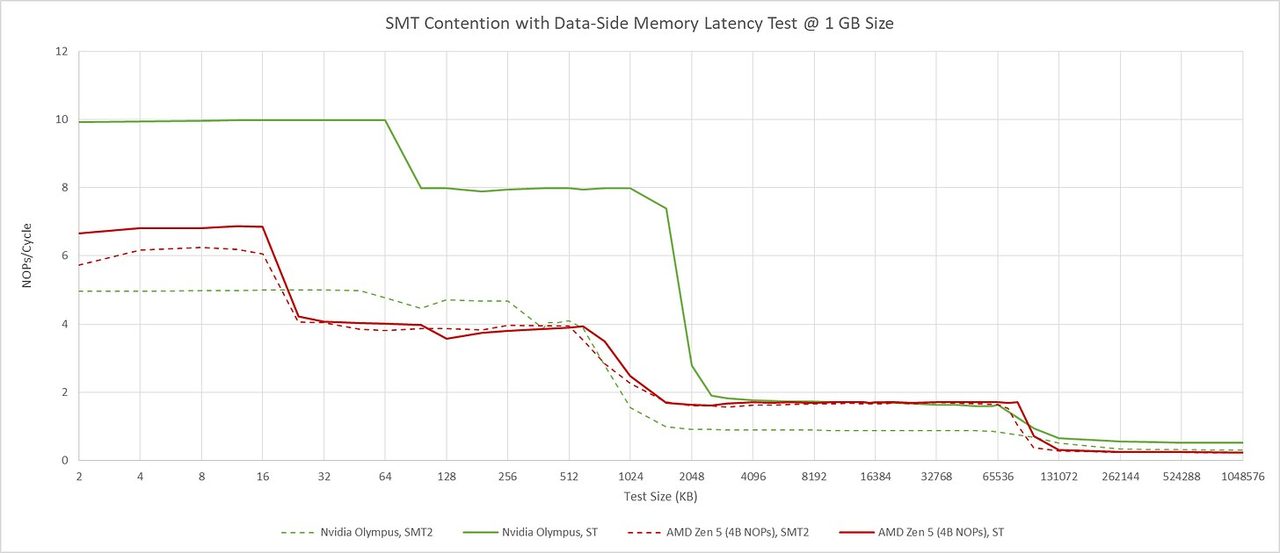
重命名与派发环节可以顺带做一些优化,比如 move 消除。Olympus 的 move 消除能力有限:依赖 MOV 链的吞吐约为每周期 1 条略多,说明只有部分 MOV 以零延迟执行;相比之下 Zen 5 每周期能跨 5 条 MOV。有趣的是,开两个线程后 Olympus 的每线程 move 消除反而变好,达到每线程 1.7 条/周期(合计 3.5 条);Zen 5 总量升到 7 条/周期,但每个线程从 5 条降到 3.5 条。
后端:寄存器堆和队列大到夸张
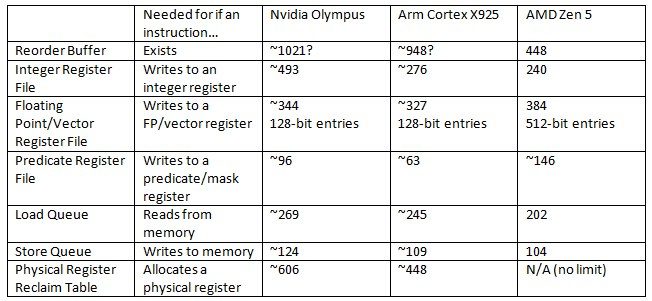
Olympus 的后端到处是巨大的寄存器堆和队列,整体像 X925 的加强版。唯一条目数偏少的是浮点/向量寄存器堆(比 Zen 5 少),但它常用一个 128 位向量寄存器同时容纳两条独立指令写入的标量浮点值——考虑到大量代码无法向量化,这个优化很实用。
用 NOP 测试可以测出在飞指令数量的上限:核心能在两个长延迟加载之间塞进 1000 条以上 NOP,但实际在飞指令数受限于约 606 个已分配架构寄存器,会明显低于这个数字。
调度器布局同样借鉴 X925:8 个整数 ALU 两两成对,每对由一个约 25 条目的调度队列供给,其中一对 ALU 专门处理不常见的运算;浮点侧为六管 FPU,也是每对管线配一个队列。区别在于 NVIDIA 用「不参与调度的队列 + 较小的调度队列」的组合,Arm 则用三个很大的调度队列。
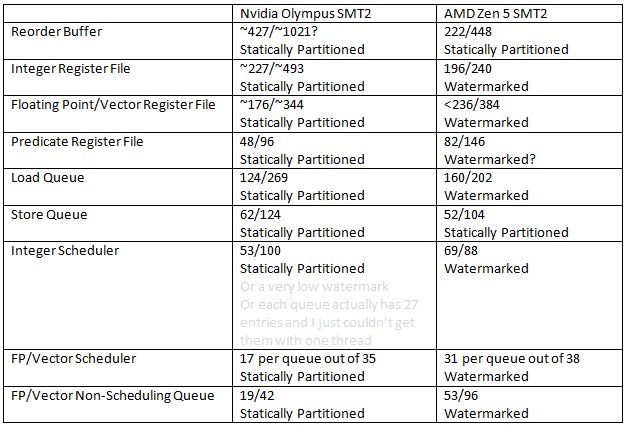
作者检查的所有后端结构都是静态切分的:只要兄弟线程不空闲,每个线程就只能拿到一半(或更少)容量——连通常采用水位线或竞争共享的调度队列也不例外,执行单元同样如此,吞吐直接减半,不管兄弟线程是否争用同一端口。作为对比,AMD 的 SMT 大部分结构是灵活共享的,只用水位线防止一个线程独占资源。
载入/存储:四条流水线,和 32 B 边界的怪停顿
访存走四条流水线,全部支持载入,其中两条支持存储。L1 数据缓存标称延迟 4 周期,但简单的内存延迟测试能测到 2–3 周期,作者推测可能来自值预测(value prediction)。
内存消歧(memory disambiguation)行为更像 Arm 的旧核心或 Intel Atom:64 位存储转发给依赖的 32 位载入时,只要载入对齐到存储的任一半即可快速转发——地址完全匹配时延迟 3–4 周期,转发上半部 5–6 周期;其余重叠情形会吃到 12–13 周期的惩罚,很可能是核心挡住了载入、等存储提交。
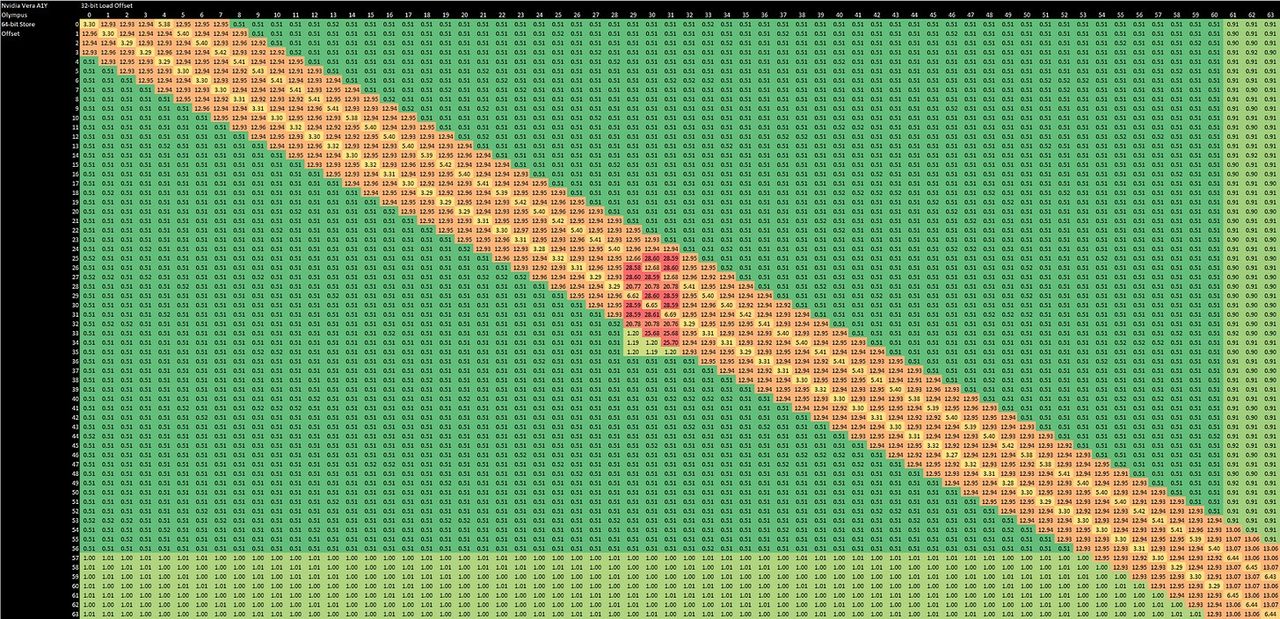
更奇怪的是,Olympus 在跨越 64 B 缓存行正中间那条 32 B 边界时会「卡一下」,而跨越整条 64 B 缓存行边界时反而不卡——尽管每条 64 B 对齐边界自然也 32 B 对齐。此外,同一条缓存行前半 32 B 末尾那个 32 位块上的独立载入与存储,有时不能并行推进。
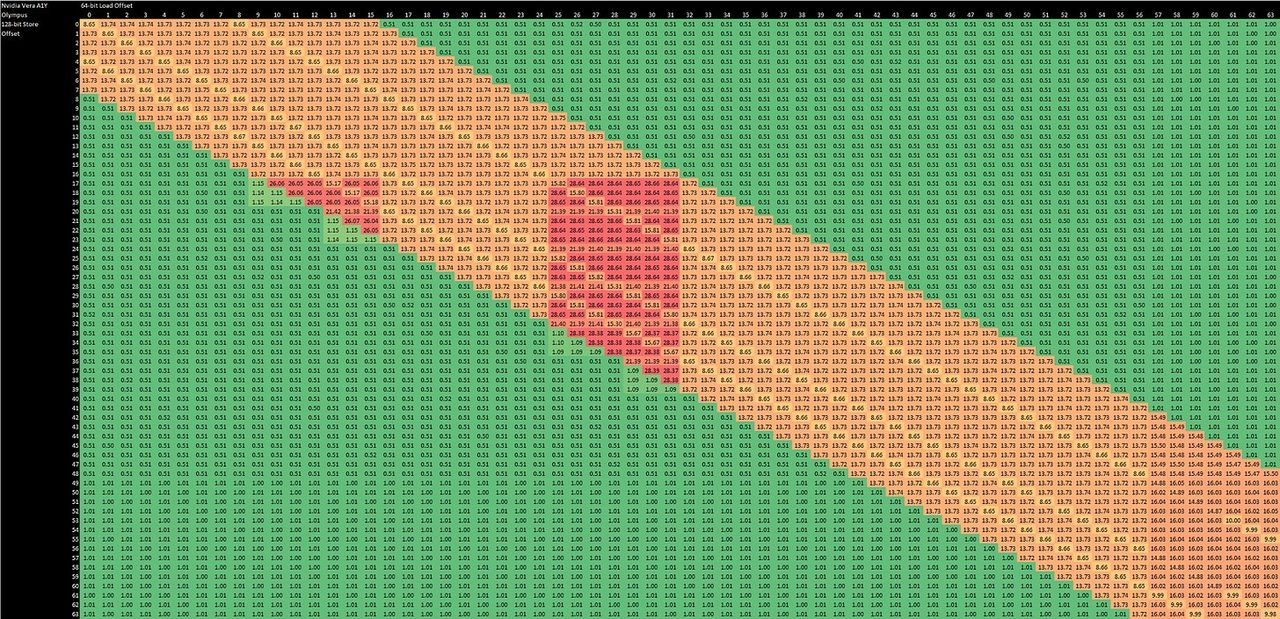
更宽的向量访问在中间 32 B 边界有同样表现,还会在缓存行内第一条 16 B 对齐边界上再额外卡一下;向量存储转发的延迟更高,这在很多核心上属于常态。
地址翻译方面,Olympus 有 112 条目全相联数据 TLB,背后是统一的三千条目 L2 TLB。Zen 5 则是 96 条目全相联数据 TLB 加 4000 条目的 L2 数据 TLB,且 AMD 不用统一 L2 TLB,指令侧另有 2048 条目的 L2 指令 TLB。测试机器使用 64 KB 页,让地址翻译在很多测试里几乎不构成延迟因素,也让直接对比更困难。
缓存与内存:96 KB L1D、2 MB L2、164 MB L3
大乱序结构、预取器、分支预测和值预测帮核心「忍受」内存延迟,缓存则从另一边降低延迟。Vera 的缓存策略相比此前的 Grace CPU 有大幅改进:Olympus 的 L1 数据缓存达到 96 KB、六路组相联,容量超过 AMD、Arm、Intel 服务器核心常见的 32/48/64 KB。
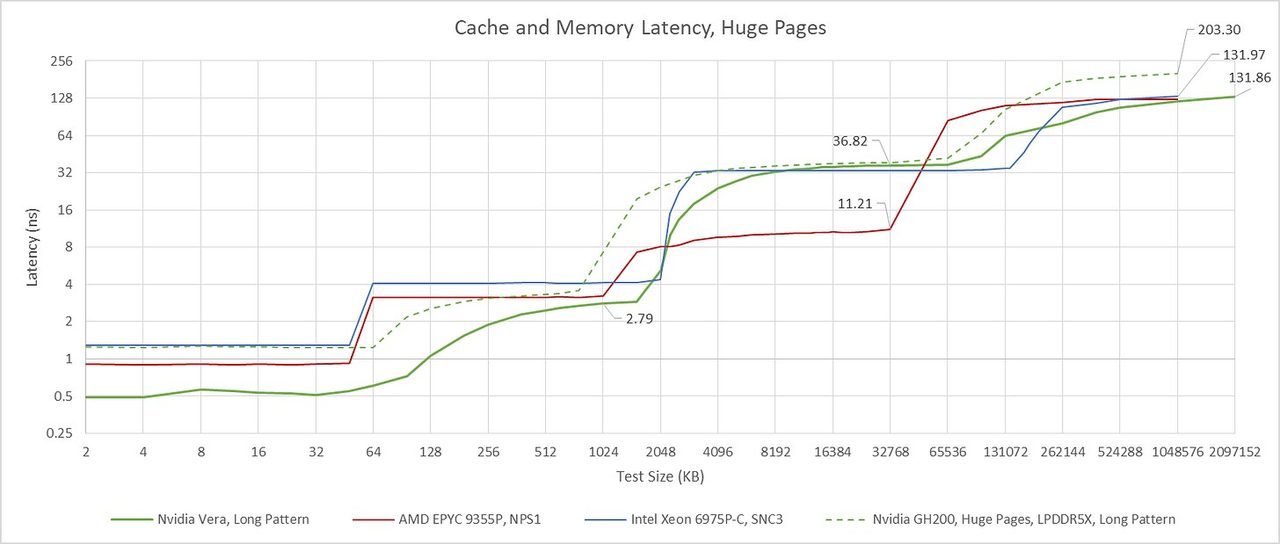
L1 未命中由 2 MB 八路组相联的 L2 接住,载入到使用 10 周期。周期数低意味着尽管 X925 频率高达 4 GHz、L2 延迟 12 周期,Olympus 的 L2 交付速度仍几乎相当。2 MB 的 L2 容量也是相对 Grace(Neoverse V2,只有 1 MB L2)的显著升级。Vera 的 L3 延迟与 Grace 相当,绝对值不佳(超过 120 周期),但这在以巨型单体互连实现 L3 的设计中很常见;好在容量从 114 MB 提升到 164 MB。
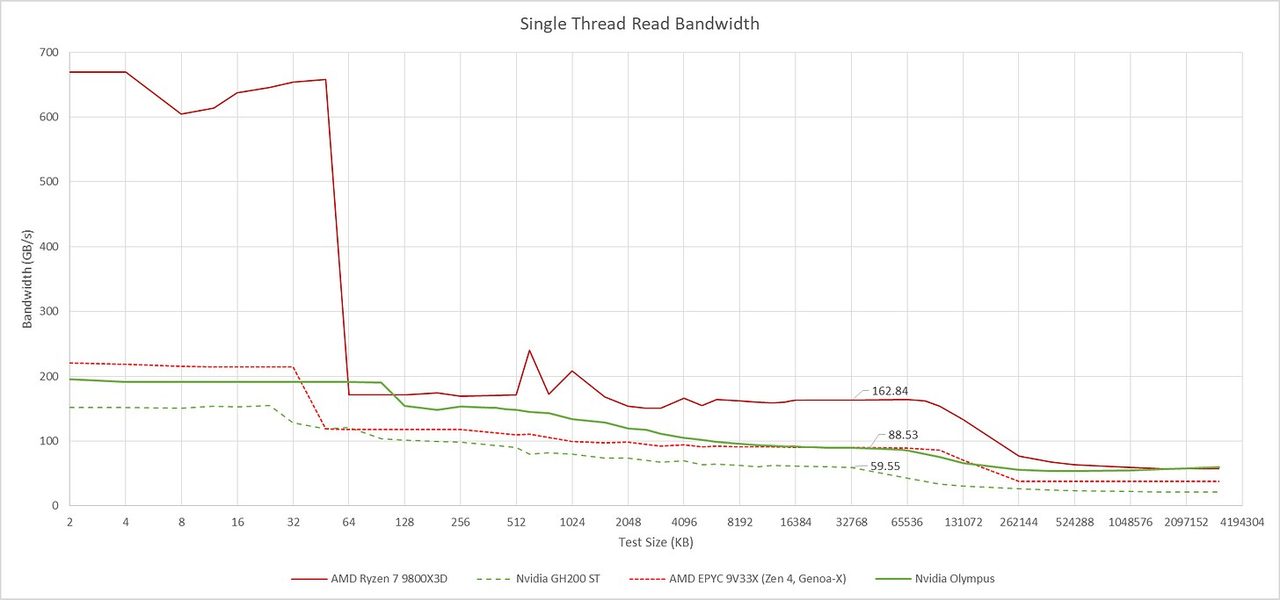
NVIDIA 用激进的预取来弥补 L3 高延迟:单线程线性读可从 L3 跑到 88.53 GB/s,按 Little 定律推算,Olympus 能维持约 50–51 个在飞请求(88.53 GB/s ÷(64 B × 3.3 GHz)≈ 0.42 条缓存行/周期,乘以 121.5 周期延迟 ≈ 50.9),而 Grace/GH200 只有 35–36 个。用 Lemire 的内存级并行微基准测试,Olympus 可同时有 18–19 个需求型 L1D 未命中在飞;该测试用随机指针追逐,无法借助 L2 预取器,所以也吃不到更大 L2 未命中队列的好处。
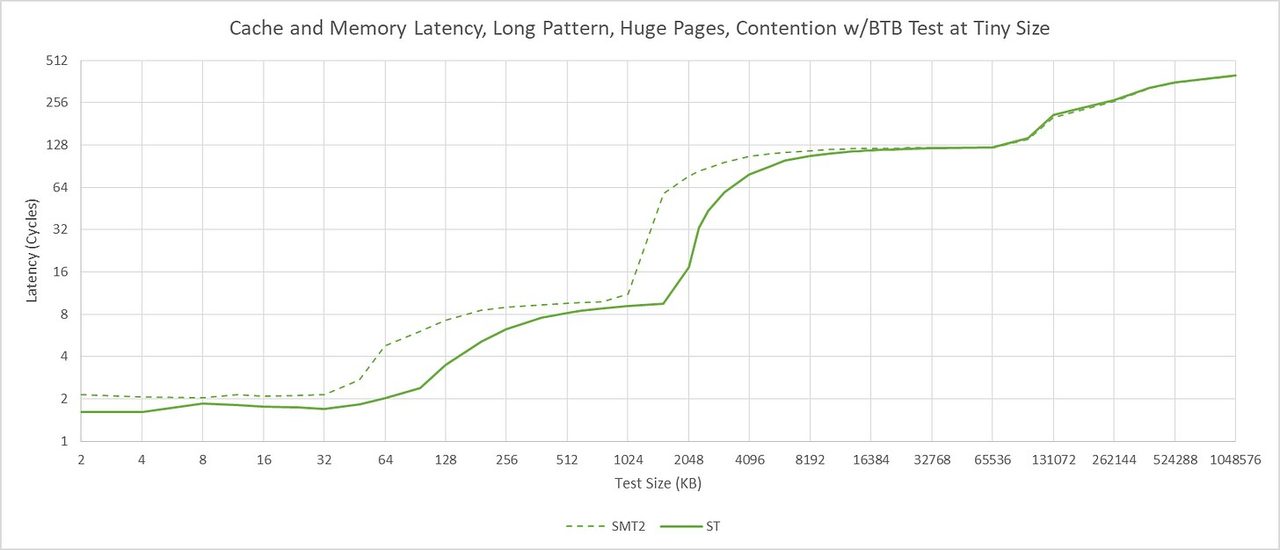
SMT 同样切分 L1D 与 L2 的数据容量:兄弟线程活跃时,每个线程只能用到核心私有缓存的一半,即便兄弟线程完全不访问数据也一样。
SPEC CPU2026:服务器核心逼近桌面旗舰
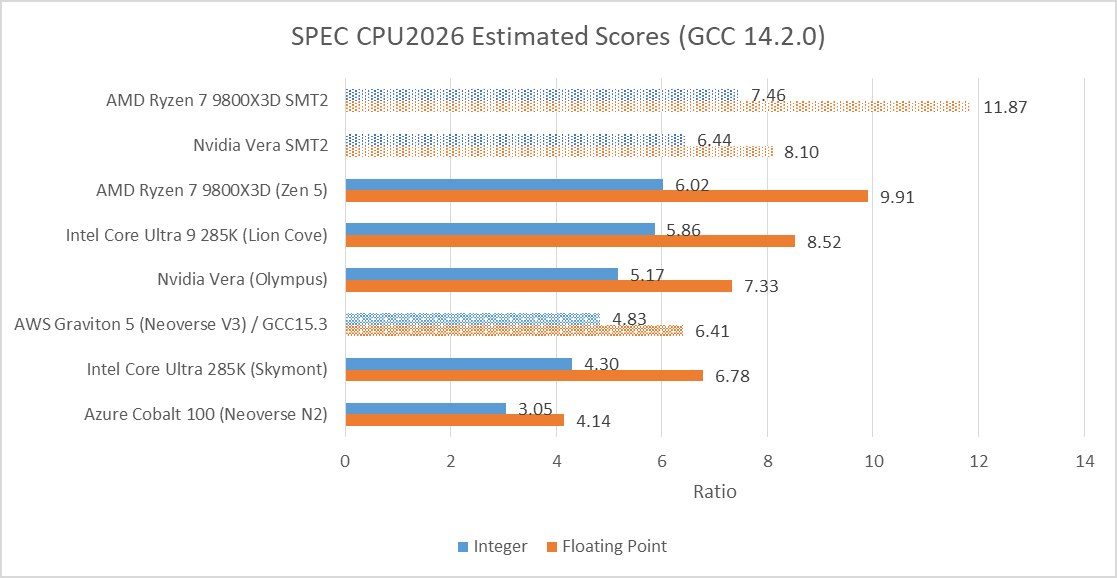
SPEC CPU2026 的成绩显示,Olympus 为服务器核心提供了非常强的单线程性能,与桌面环境的 Intel Core Ultra 9 285K、AMD Ryzen 7 9800X3D 相差不远;对上 Neoverse V2、Neoverse N2 等 Arm 服务器核心则有明显领先。需要注意的是测试机使用 64 KB 页,而其他成绩都在 4 KB 页下取得;作者预计即使换成更小页,Olympus 在 Neoverse 面前依然占优。
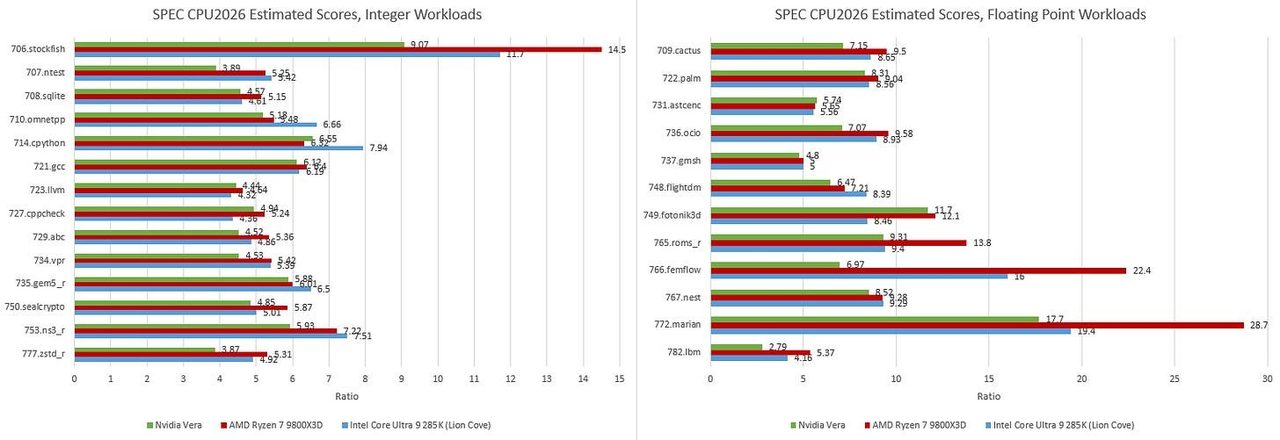
细化到单项,NVIDIA 在大量整数负载上表现良好,包括其白皮书点名的 723.llvm_r、727.cppcheck_r、721.gcc_r、714.cpython_r。它在 706.stockfish_r 上大幅落后 Zen 5,主要原因是指令集差异——该负载下 Olympus 执行的指令数约为 Zen 5 的两倍;浮点侧 772.marian_r 同样受 ISA 影响。指令数也可能反过来,例如 aarch64 在 750.sealcrypto_r 上需要更少指令,但 Zen 5 靠整体吞吐优势仍保住成绩。
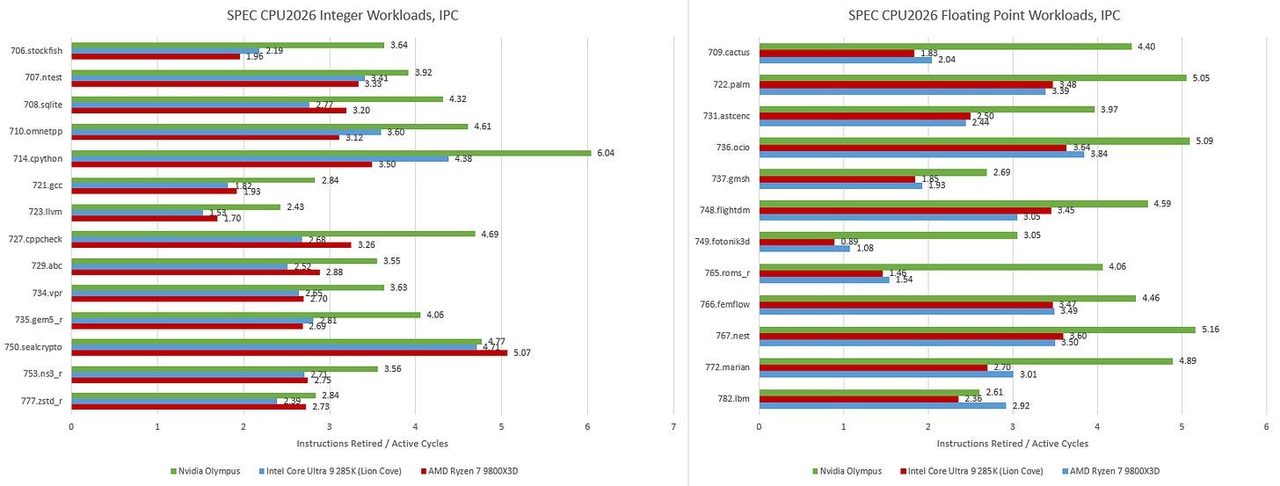
既然目标是靠每周期性能取胜,硬件计数器显示 IPC 很高也就不奇怪:即使在做 Zen 5 性能更高的负载里,Olympus 的 IPC 往往也更高。
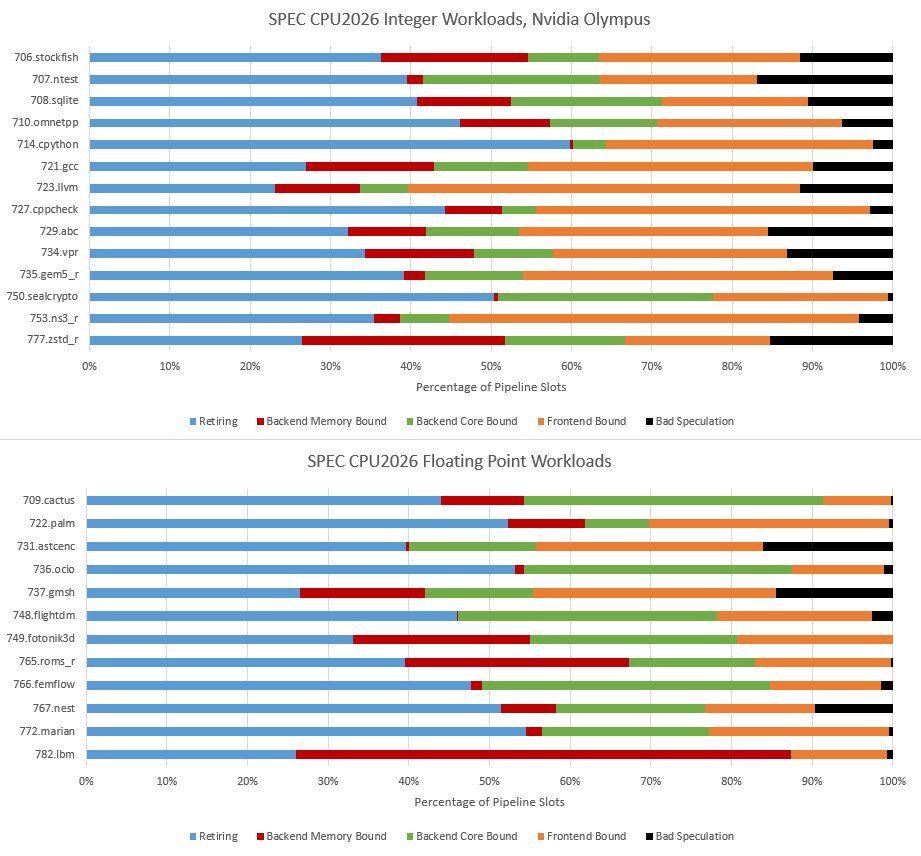
宽流水线很难喂饱。自上而下(top-down)分析显示,几乎所有负载平均都有超过 50% 的派发槽位闲置;SPEC 整数负载大量损失在「前端供给不足」上——即便有提前两条的快速分支预测器和大指令缓存,也未必跟得上,Zen 5 同样如此。浮点负载更偏「后端受限」,即微操作因后端资源占满而无法派发,也就是核心已经到了在飞指令数的上限。
「空间多线程」:把一颗核心一分为二
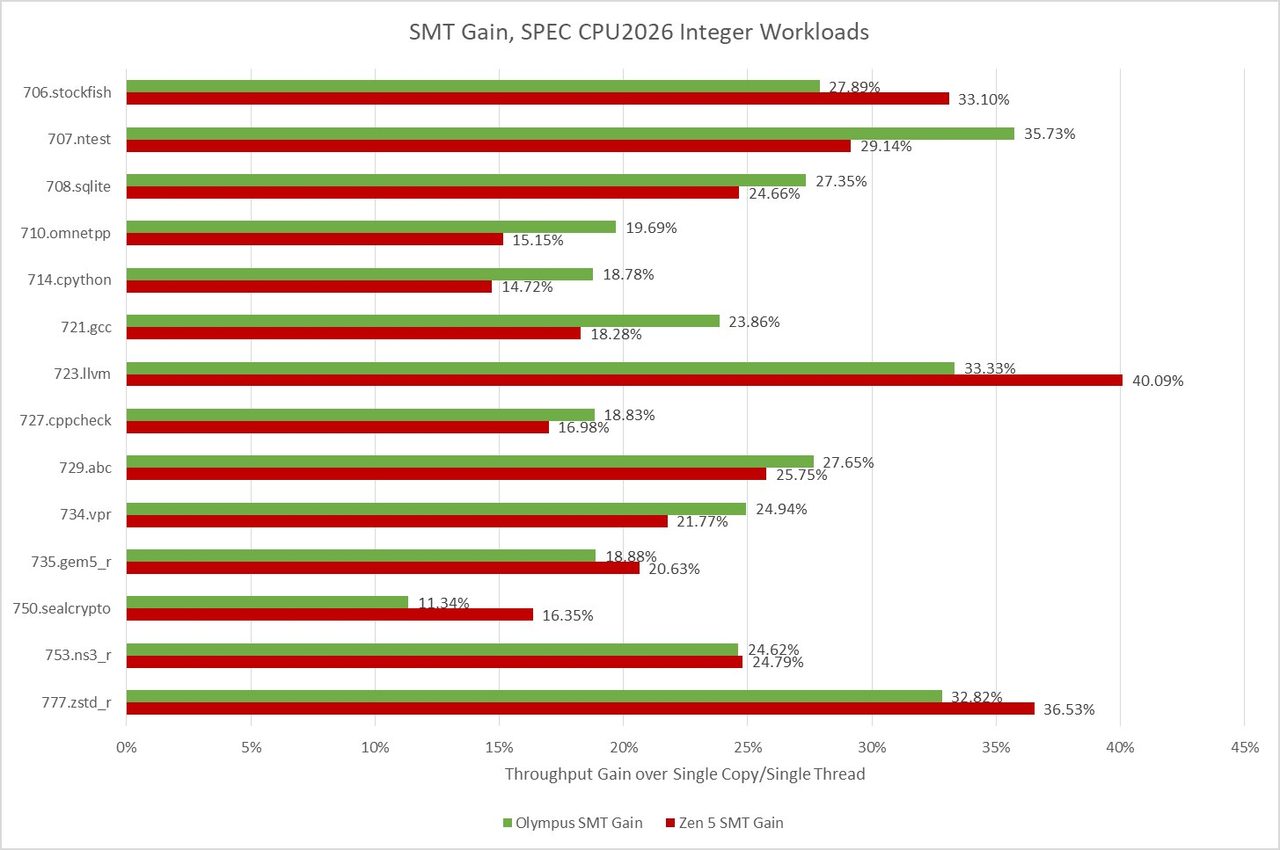
SMT 的初衷是在有第二个线程时回收闲置的核心宽度、更充分利用后端资源。NVIDIA 的「空间多线程(spatial multithreading)」很不常规:在 SPEC CPU2026 整数负载上,它的 SMT 增益与 Zen 5 相当(这里看的是增益;绝对性能上 Zen 5 更高,但两者定位不同——桌面 CPU 本就以单核性能为目标)。
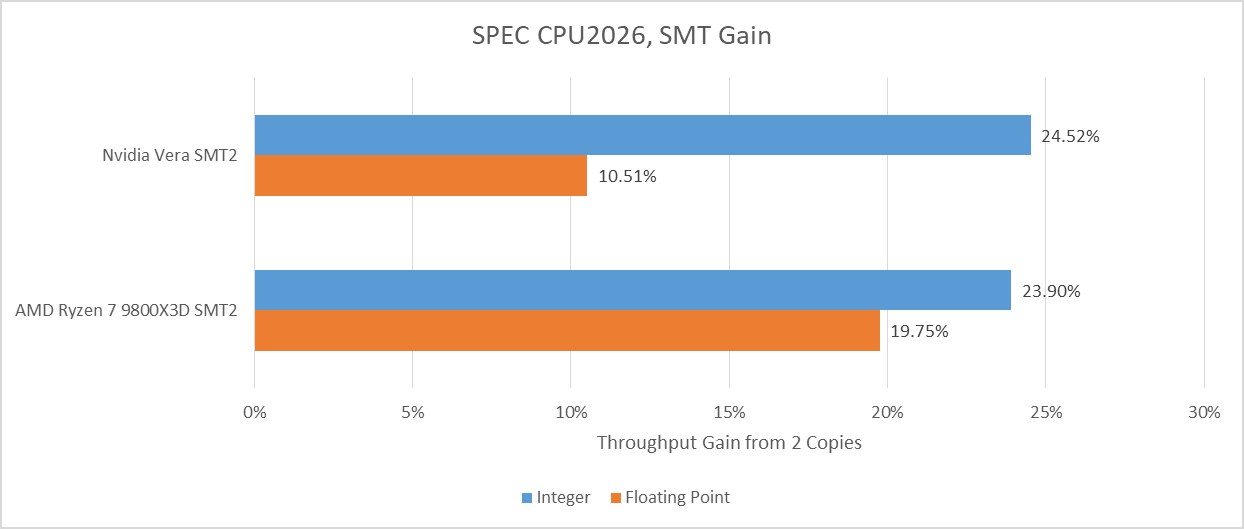
浮点侧的说服力就弱一些,尽管整体仍有可观提升。单项差异很大:低 IPC、前端受限的负载(如 723.llvm)从 SMT 中获益巨大,而高 IPC、吞吐受限的负载(如 750.sealcrypto、714.cpython)收益有限——两家核心的总体规律一致。
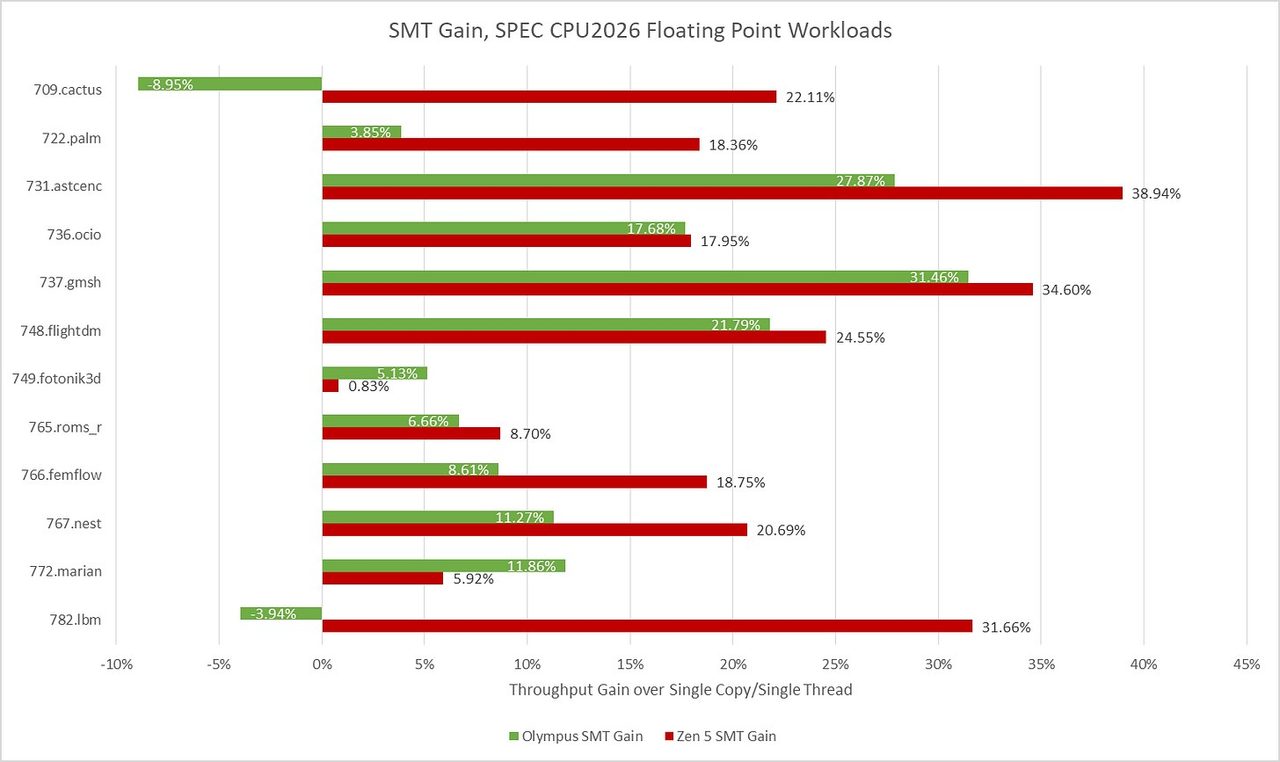
问题出在浮点:Olympus 在 709.cactus 和 782.lbm 上出现了吞吐倒退。理想的 SMT 实现不应在双线程时损失总吞吐,因此这两处显得不理想;Zen 5 在 SPEC 浮点上的 SMT 收益也不高,但至少没有出现「双线程比串行跑两个任务更差」的情况。
SPEC CPU2017:与 Zen 4 桌面旗舰打平
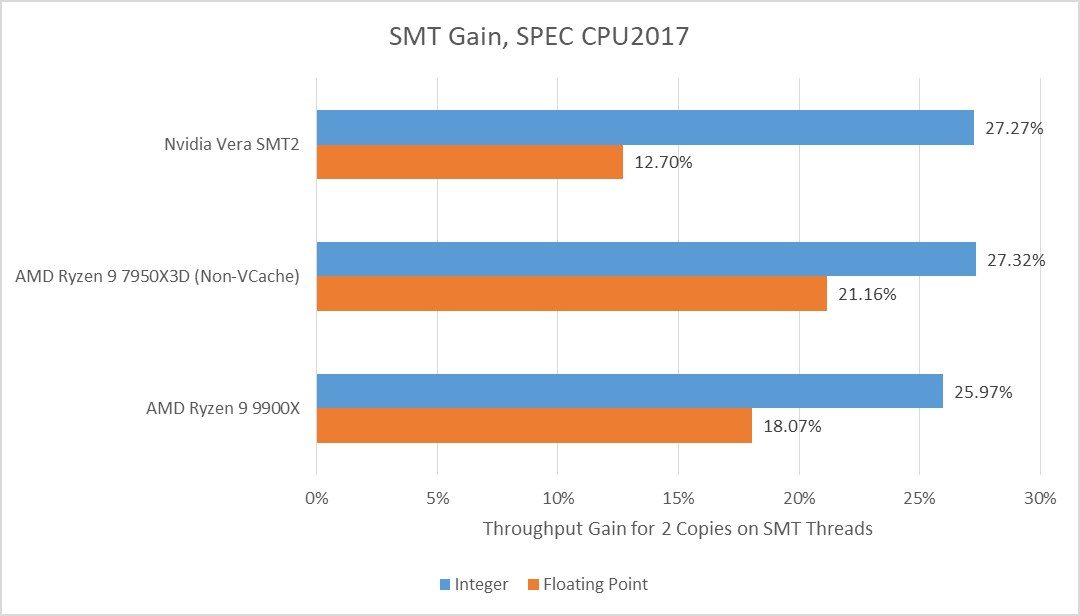
SPEC CPU2017 仍具价值,因为它包含 SPEC CPU2026 中没有对应物的困难负载,作者手上的历史数据也更多。数据显示 Olympus 击败了多个服务器核心,包括一个 Zen 5 服务器实现,并与 AMD 顶级 Zen 4 桌面芯片打平——对服务器核心来说相当了不起。
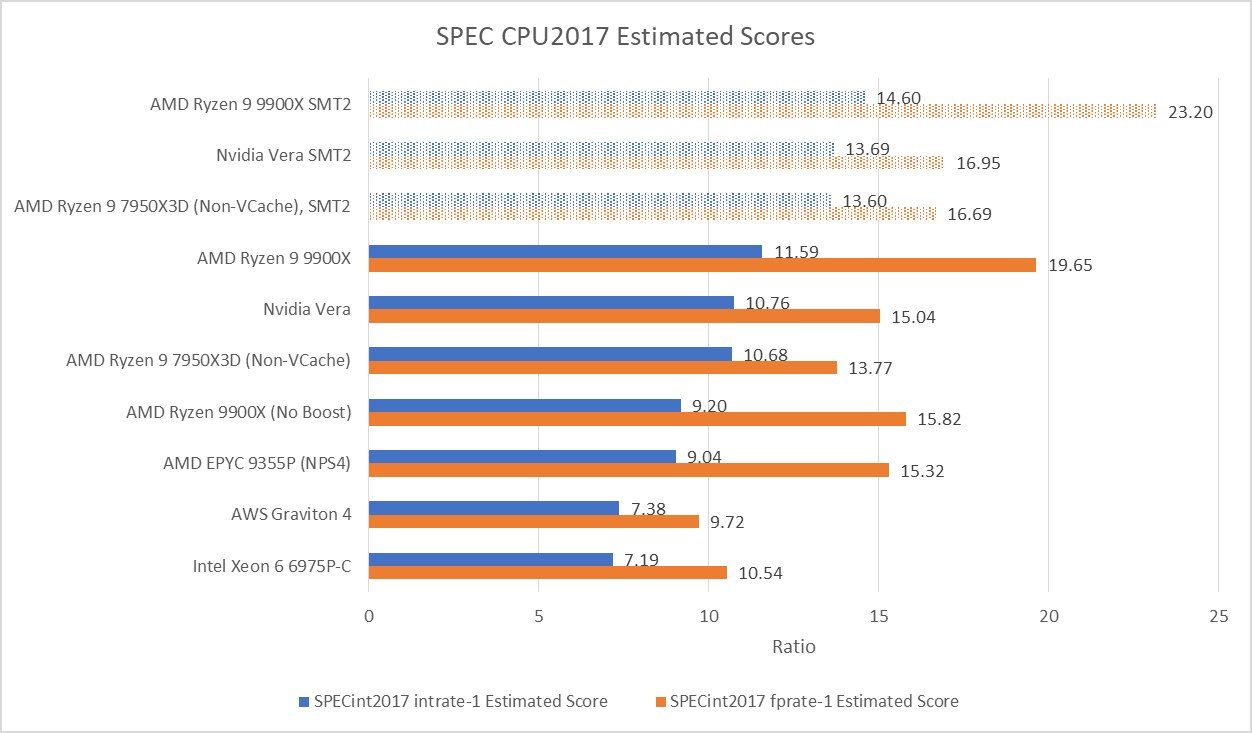
SPEC CPU2017 的 SMT 增益比 CPU2026 更高,这得益于那些让分支预测器「崩溃」、又受后端内存延迟拖累的负载,比如 505.mcf。Olympus 在浮点侧再次出现令人担心的 SMT 倒退;AMD Zen 4 也未能幸免,但幅度轻得多——3% 或 1% 的下降远谈不上理想,却大概比 11.98% 或 9.78% 的损失更不易察觉。
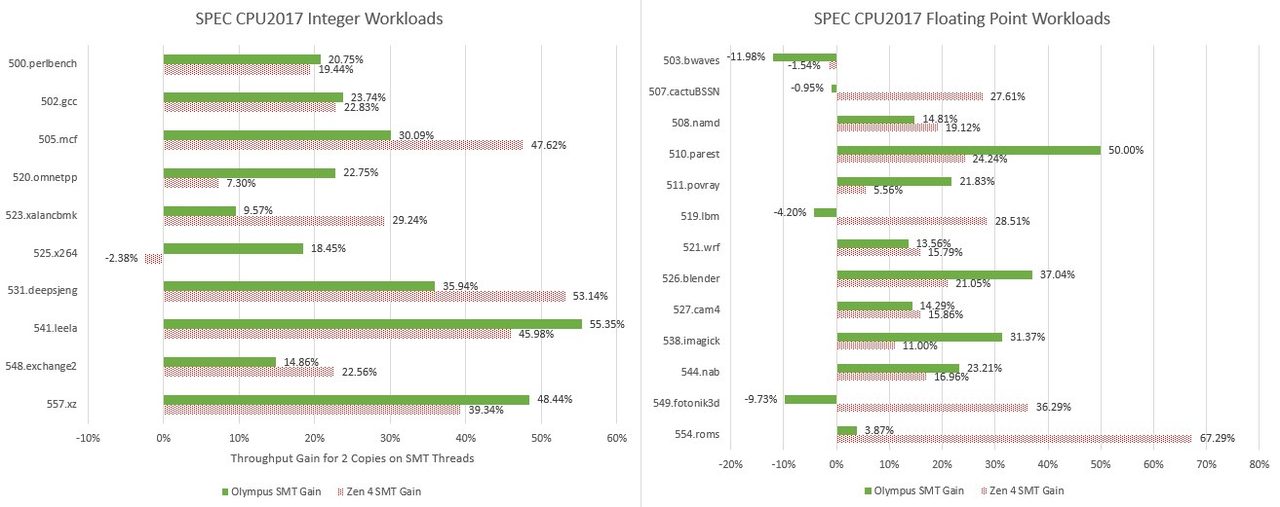
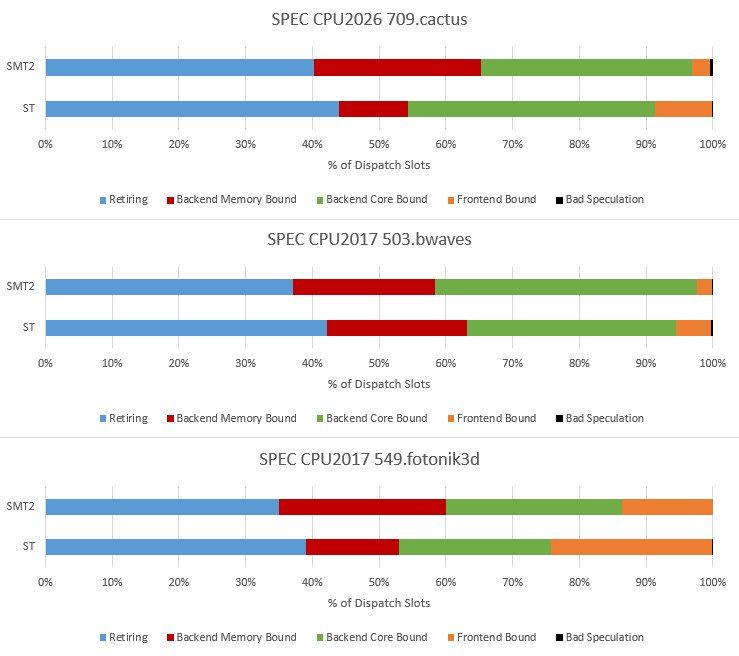
要解释 Olympus 的 SMT 行为并不容易,因为分析 SMT 用例本就比单线程难。709.cactus 可以用「跑两份负载时 L2 数据 MPKI 从 3.58 升到 6.52,加上后端资源被切分后难以承受高 L3 延迟」来解释;但 SPEC CPU2017 的 503.bwaves 和 549.fotonik3d 套不上同一套逻辑:503.bwaves 在单线程和双线程下都在冲刷 L2(MPKI 32.12 对 33.03),而自上而下事件显示性能损失并非内存受限所致;549.fotonik3d 的 L2 未命中率也很高(单线程 52.45,双线程 57.13),但相对差距同样不大。总体看,空间多线程在前端受限负载上能给出与常规 SMT 相当的可观增益,但对后端受限负载处理得不够好。
作者对「空间多线程」的判断是:它与其说是常规 SMT,不如说是双线程时把 Olympus 动态拆成两颗更小的核心。几乎所有能想到的资源、直到 L2 缓存都是静态切分的,每个线程只能拿到一半。这样做的好处很实在——把两个 SMT 线程当成两颗 5 宽核心来看,性能分析比分析 Zen 5 里两个线程如何动态争用资源简单得多;对核心设计来说也更省事,NVIDIA 不必去调那些复杂机制来保证公平,因为「一切减半」本身就是公平保证。
但这是好主意,还是为了简化第一代 SMT 实现而做的妥协,作者认为尚无定论。空间多线程在 SPEC 整数负载上展现了希望;在最理想的情况下,Olympus 说明只要核心资源足够巨大,两个线程如何共享资源可能并不那么重要。然而收益并不稳定,在 SPEC 浮点的后端受限场景里甚至为负。这些波折究竟来自第一代 SMT 的磨合问题,还是来自「把每个线程锁死在半颗核心」带来的根本性低效,目前很难判断——毕竟常规 SMT 的一部分收益,正来自让线程动态取用兄弟线程闲置的资源。作者的建议是继续观察 NVIDIA 是否会在后续世代沿用这一策略:成功的架构技术通常会被延续并被业界采纳,而空间多线程会不会如此,谁也说不准。
结语
Arm 早期的服务器芯片重核数而轻单核性能,随着新核心不断上探性能目标,Arm 服务器阵营已经多元化;如今 NVIDIA 的 Vera 反过来成了单线程性能顶尖、核数相对较少的那一方(不过 88 核在绝对数量上依然很多),而 AMD 的服务器芯片核更多、单线程性能更低。不同页大小给 SPEC 结果留了一些模糊空间,但作者认为这只会缩小 Olympus 与最快 AMD 服务器核心的差距,不会改变相对排名。
对上 Arm Neoverse 阵营,Olympus 在每核心吞吐上占尽优势:既因为单线程性能高,也因为第二个线程能进一步拉高吞吐——当 Arm 核心根本无法同时跑第二个线程时,讨论常规 SMT 与空间多线程孰优孰劣已无意义。相比上一代 Grace(无论是更快的核心还是更多的核心),Vera 是一次巨大跃升。
平台层面:双路单 NUMA、I/O 与机密计算
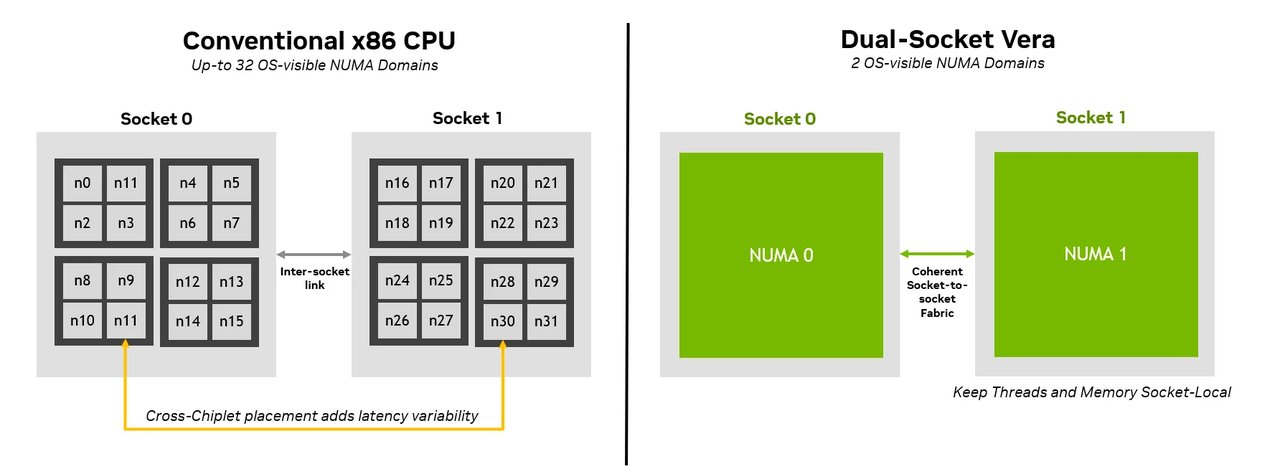
Vera CPU 支持双路扩展,用第二代 NVLink-C2C 做插槽间相干互连。这里 NVIDIA 特意强调了一个「软件优先」的设计:每颗插槽对外呈现为一个 NUMA 域,双路系统就是干净的 2 NUMA 节点拓扑;而传统 x86 的 chiplet 设计可能在一个插槽内就暴露多个 NUMA 域,大规模双路系统里能堆到几十个 NUMA 域,需要软件小心翼翼地把线程、内存和 I/O 摆到正确位置,否则就要吃远程访问和额外 die 跳转带来的延迟抖动。
I/O 方面提供 PCIe 6.4,双路配置共 176 条 PCIe 通道,并支持 CXL 3.1(相干内存扩展、内存池化与可组合基础设施)。机密计算方面,Vera Rubin NVL72 把机密计算从单机扩展到整个 scale-up 域,基于 Arm CCA/RME 与每虚拟机独立密钥做机密虚拟机隔离,支持安全分配具备 TDISP 能力的相干设备,并对相干链路使用经过认证的 C2C 加密——目标是在不额外拷贝数据的前提下保护「使用中」的数据。
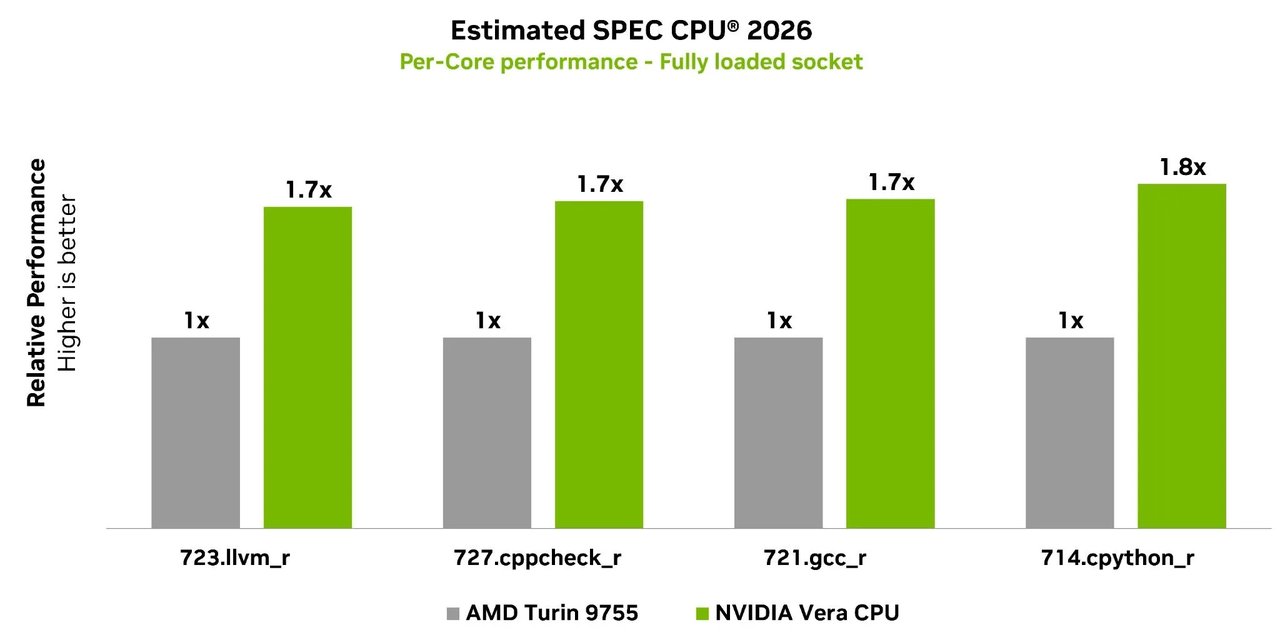
NVIDIA 自己给出的性能口径是:在插槽满载(fully loaded socket)条件下的每核心性能,Vera CPU 在 SPEC CPU2026 的 723.llvm_r、727.cppcheck_r、721.gcc_r 上达到 AMD EPYC 9755(Turin)的 1.7 倍,714.cpython_r 上达到 1.8 倍。它强调这个指标比空载单线程成绩更有代表性,因为智能体场景下大量沙箱、工具与环境并发运行,单线程的进展必须在整颗 CPU 共享功率、缓存、内存带宽与互连资源时依然成立。
厂商口径与第三方实测的差异
把 NVIDIA 的博客和 Chips and Cheese 的实测放在一起读会更有意思,两者并不矛盾,但侧重不同:
- 分支预测:NVIDIA 强调 Olympus 使用「神经分支预测器」,在统计上有偏向的困难分支模式上更准;C&C 的实测则显示,其方向预测能力其实略逊于 Arm Cortex X925,SPEC CPU2026 准确率也略低于 Zen 5——宣传口径描述的是设计意图,实测给出的是横向排位。
- 空间多线程:NVIDIA 的卖点是减少「吵闹邻居」干扰、让延迟更可预测;C&C 则指出这来自「几乎所有资源静态减半」的实现方式,在 SPEC 整数上收益与 Zen 5 相当,但在后端受限的浮点负载上出现了吞吐倒退。换句话说,可预测性是用资源利用率换来的。
- 性能对比对象:NVIDIA 的白皮书与博客选用 SPEC CPU2026 与 AMD Turin 对比满负载每核心性能;C&C 则拿它与 Intel、AMD 的桌面旗舰以及 Arm Neoverse 对比单线程绝对值,并提醒测试机使用 64 KB 页会影响可比性。
核心总结
- 总体设计:10 宽乱序、3.3 GHz 的低频宽核,靠 IPC 而非频率取胜;布局借鉴 Arm Cortex X925 并进一步放大乱序结构,另加 SMT
- 前端:分支方向预测略逊 X925,SPEC CPU2026 准确率略低于 Zen 5、略高于 Lion Cove;每周期两条 taken 分支,但超过 48 KB 指令足迹即失效;64 KB 指令缓存、128 B/周期取指
- 后端:寄存器堆与队列规模巨大,实际在飞指令受约 606 个寄存器限制;几乎所有资源(含 L1D/L2 缓存与执行单元)在双线程时静态减半,与 Zen 5 的灵活共享形成对比
- 访存:96 KB L1D、10 周期 2 MB L2、164 MB L3;L3 延迟超 120 周期但靠激进预取维持约 50–51 个在飞请求;存储转发在缓存行中间 32 B 边界有异常停顿
- 性能:SPEC CPU2026 单线程接近桌面旗舰,SPEC CPU2017 与 Zen 4 桌面打平;整数负载常受前端限制,浮点负载多受后端限制,IPC 普遍高于 Zen 5
- 空间多线程:整数负载增益与 Zen 5 相当,浮点后端受限负载出现负增益(709.cactus、782.lbm),本质是双线程时把核心拆成两颗 5 宽核心;是否长期沿用尚待观察
- 平台定位:Vera CPU 为智能体 AI 设计,共 88 个 Olympus 核心 / 176 线程;主打 IPC 而非频率,并针对指针追逐、图结构等不规则访存加入图预取器
- 片内与内存:SCF 相干网络提供最高 3.4 TB/s 对分带宽与 164 MB 统一 L3,位于单体计算 die;SOCAMM2 LPDDR5X 提供最高 1.2 TB/s 聚合带宽(每核心最多 14 GB/s),模块可现场更换
- 平台扩展:第二代 NVLink-C2C 双路,每插槽一个 NUMA 域(双路共 2 个);PCIe 6.4 双路 176 通道、CXL 3.1、基于 Arm CCA/RME 的机密计算;NVIDIA 称满负载每核心性能为 AMD Turin 9755 的 1.7–1.8 倍(SPEC CPU2026)
原文:NVIDIA’s Olympus Core: Pushing Server Single Threaded Performance Boundaries(Chips and Cheese,2026-10-05)
补充:Inside NVIDIA Vera CPU: Olympus Cores Built for Maximum Single-Thread Performance in Agentic AI(NVIDIA Developer Blog,2026)


