编码智能体写前端代码时有个稳定的坏习惯:用一堆 JavaScript 去实现浏览器早已原生支持的功能。Google Chrome 的 Modern Web Guidance 项目正是针对这一点:把现代 Web 平台特性整理成结构化指南,通过 Agent Skill 和 CLI 注入智能体的上下文。项目由 Chrome、Microsoft Edge、Mozilla Firefox 与 MDN 团队共同治理,源仓库 GoogleChrome/modern-web-guidance-src 创建于 2026 年 1 月,截至 11 月 11 日约有 1,450 个 star、129 个 fork,仍在每日更新。
问题:训练数据里堆满了旧代码
官方给出的解释很直接:LLM 的训练语料里包含大量遗留代码,智能体因此默认沿用旧写法;即使模型知道某个 API 存在,也缺少足够的真实实现模式来产出可用于生产的代码。结果是本可由浏览器优化的原生能力,被替换成臃肿的脚本、重型 polyfill 或过时的第三方库。
项目的目标有三个:让模型正确组织那些「知道但用不对」的现代浏览器 API;优先使用平台层能力,以拿到浏览器优化与内置无障碍支持;在必须兼容旧浏览器时,给出轻量、负责任的回退,而不是直接塞一个完整 polyfill。
用法:两行命令,检索完全离线
npx modern-web-guidance@latest install
npx modern-web-guidance@latest search "animate a dialog modal backdrop"
npx modern-web-guidance@latest retrieve "animate-to-from-top-layer"
运行时的流程是:编码智能体遇到相关任务后激活 modern-web-guidance 技能,调用 modern-web-guidance search 做本地语义检索,再用 retrieve <guide-id> 把对应的代码模式、坑位与回退方案取回上下文。检索用的是离线嵌入模型加 BM25,不联网、不需要 API key;npm 包自包含且不带额外依赖,官方称这样既降低延迟,也减少供应链风险。另有 legacy-scan . 可以扫描代码库里的遗留写法。
安装方式覆盖了主流智能体:除 npx 安装器外,还提供 Vercel Skills CLI、GitHub CLI、Google Antigravity、GitHub Copilot CLI、Claude Code 插件市场、Grok Build、Kimi Code 与 OpenAI Codex 的插件命令。技能包可以按需勾选,目前有 modern-web-guidance(约 205 token)与 chrome-extensions(约 175 token)两个。
指南写了什么:252 篇,250 个特性
指南按主题分目录,每篇是一个独立目录,包含 guide.md(给智能体读的规范)、demo.html(金标准实现)与 expectations.md(可观察的断言清单)。内容覆盖 250 个 Web 特性:CSS 与布局 140 个、HTML 与 DOM 36 个、JavaScript 与 API 74 个。
以官方的 navigation-drawer 指南为例,它没有用 JavaScript 的 transform 动画去实现侧滑抽屉,而是把抽屉做成顶层元素(<dialog> 或 popover="manual"),再用 CSS 滚动吸附提供开、关两个停靠点,让浏览器原生处理滑动手势的动量与打断;背景遮罩的透明度由滚动驱动的动画绑定滚动位置,并用 IntersectionObserver 判断抽屉是否完全进出视口。指南还区分了「只做抽屉」与「宽屏时变侧栏」两种场景,并逐一给出 aria-controls、aria-expanded、autofocus 等无障碍细节。
指南刻意做得省 token:官方会通过评测剪掉模型已经掌握的内容,只保留真正能改变输出的部分。
评测:金标准必须 100% 通过,原版必须 0%
光有内容不够,这个项目花了不少工程在「证明有效」上。评测流程是一个闭环:专家先写指南与演示页,再生成面向真实应用(daily-grind、devtools-times)的开发任务与 Playwright 评分器;评分器先在多模型的金标准补丁上校准到全部通过,再在未修改的原始应用上校准到全部失败;最后让智能体分别在「有指南」和「无指南」两种模式下跑同一批任务。
任务提示刻意不点名 API,例如「让我的图片加载更快」,用来测试智能体能否自己找到正确的指南。评分器检查的不只是源码模式,还包括计算样式、运行时 DOM 行为与无障碍状态。官方用「机会」(100% 减去无指南通过率)与「提升」(有指南减去无指南)两个指标决定取舍:模型本来就能做对的,指南会被剪掉。
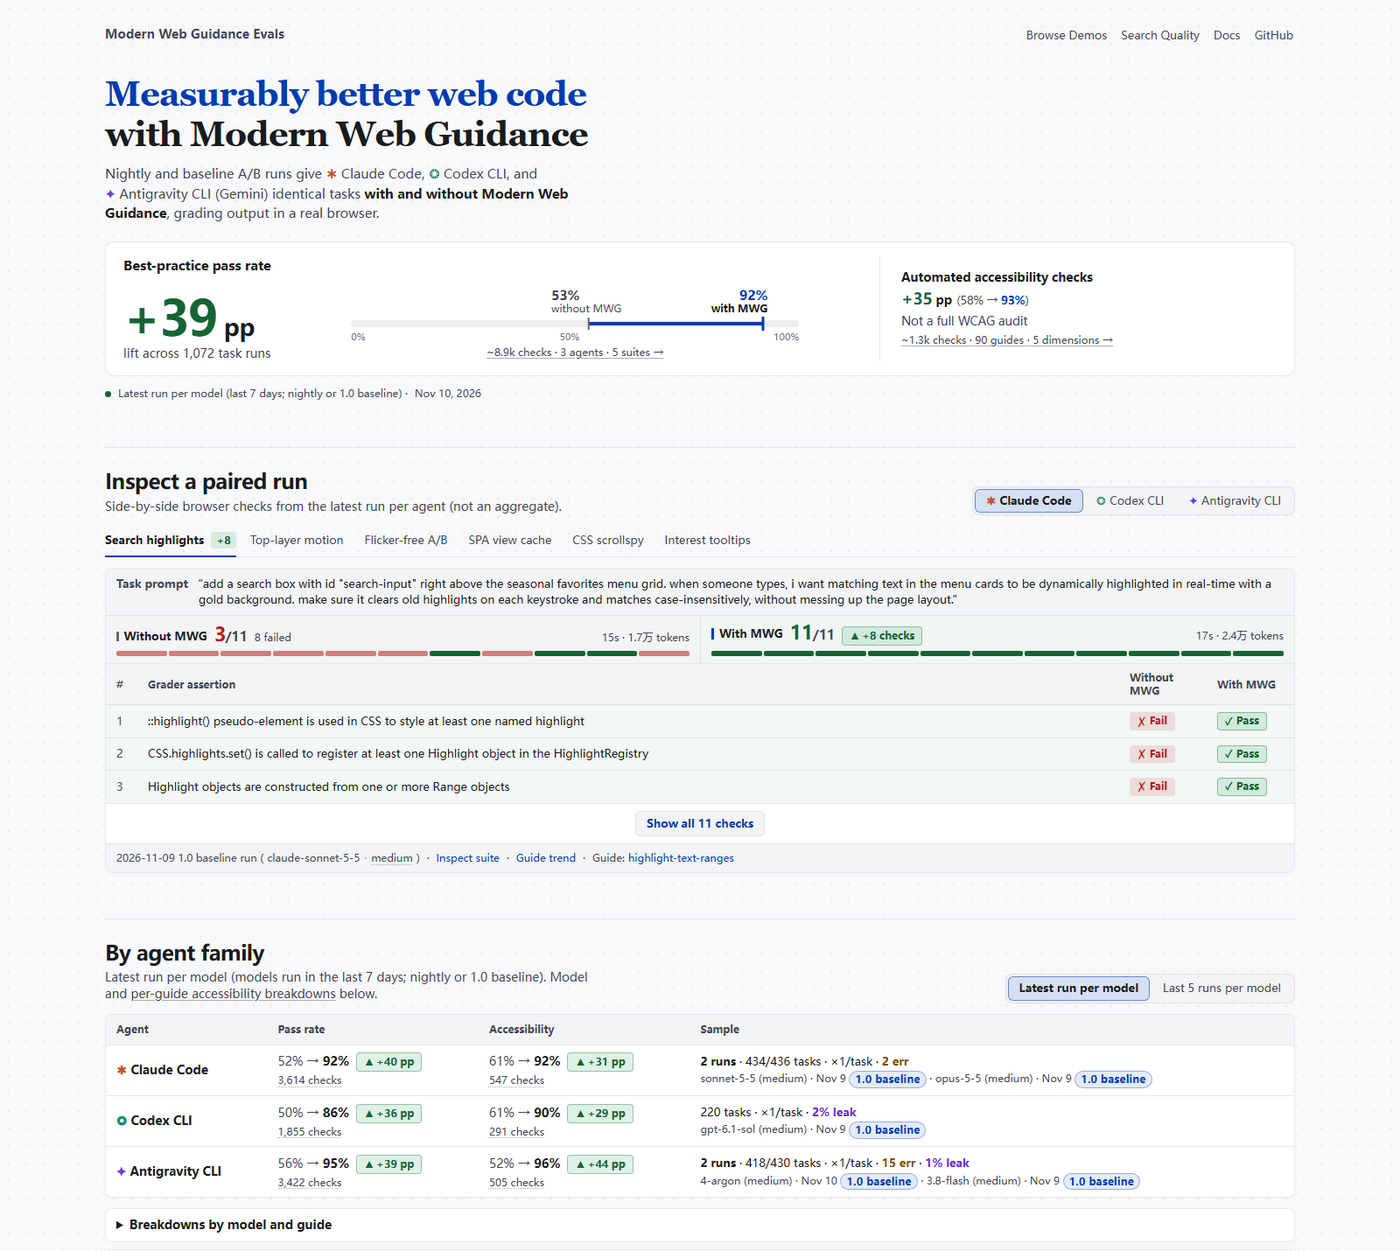
面板上 11 月 10 日的最新快照显示,跨 1,072 次任务运行,最佳实践通过率平均从 53% 提升到 92%,即 +39 个百分点;自动无障碍检查从 58% 提升到 93%。分智能体看:Claude Code 从 52% 到 92%(+40)、Codex CLI 从 50% 到 86%(+36)、Antigravity CLI(Gemini 4 Argon)从 56% 到 95%(+39)。
代价并不为零。面板里的单例对比中,Claude Code 完成「给搜索框加实时高亮」任务时,无指南版本通过 3/11 项检查、消耗约 1.7 万 token,有指南版本通过 11/11 项、消耗约 2.4 万 token。换来的代码更符合平台惯例,但上下文成本会上升。
谨慎采用:Baseline、Origin Trial 与 .mwgrc
指南接入了 Baseline 项目的实时兼容数据,让智能体能按当前浏览器支持情况调整写法。官方把特性分成两类对待:纯增量能力(如预加载)可以让旧浏览器直接忽略;关键行为(如对话框控件、网络信标)则要写轻量的定制回退,代码量控制在 50 行以内,或按条件加载 polyfill。
对实验性 API 另有一道闸门:Origin Trial 中的特性,以及近三个月才落地、仍在稳定的「单引擎特性」,在 search 里可见,但 retrieve 默认会被拦截,除非项目根目录的 .mwgrc 显式打开 allowOriginTrials 或 allowVolatileFeatures。指南还会记录容易被忽略的平台限制,比如 fetchLater() 的 64KB 载荷配额、macOS 上滚动条的特殊行为。
多浏览器共治与双仓库发布
治理结构上,Owners 共六席:Chrome 两席(Kadir Topal、Rick Viscomi)、Edge 一席(Patrick Brosset)、Firefox/MDN 一席(Jake Archibald)、独立 Web 平台专家两席(Lea Verou 与一名待定代表)。贡献者分为 Contributors、Peers、Content ATLs 与 Owners 四级;因为指南会直接进入模型上下文,从零撰写新指南的权限保留给经过审核的 Peers,其他人可以提议题或改进现有指南。
仓库采用双仓结构:源仓库承载指南、评测与 CLI,所有 issue 与 PR 都在这里;编译产物发布到只读的分发仓库与 npm 包,按周发布。代码用 Apache-2.0,guides/ 下的文档用 CC-BY-4.0。有意思的是,这个仓库自己也大量使用智能体协作,AGENTS.md 要求机器人在 PR 评论前加标记,区分「自主完成」「人类提示」「人机共同设计」三种情况。
隐私方面,官方会采集安装次数、调用方智能体名称、取回的指南 ID 与检索词,但明确不采集用户的原始提示词;设置 DISABLE_TELEMETRY=1 可关闭。
核心总结
- Modern Web Guidance 把 252 篇现代 Web 指南做成 Agent Skill + 本地 CLI,让编码智能体在任务中按需检索
- 检索完全离线(嵌入模型 + BM25),npm 包零额外依赖,避免联网与供应链开销
- 官方评测显示平均通过率提升 39 个百分点、无障碍检查提升 35 个百分点,但引导后的任务会多消耗 token
- 通过 Baseline 数据、50 行以内的轻量回退、Origin Trial 与易变特性的
retrieve闸门来控制采用风险 - 项目由 Chrome、Edge、Firefox/MDN 与独立专家共治,新指南仅限审核过的 Peers 撰写,按周从源仓库发布到分发仓库与 npm
原文:GoogleChrome/modern-web-guidance-src(GitHub,2026 年 11 月 11 日访问)


