编码智能体已经能跨整个仓库改代码,但它们通常以一句「所有测试通过」收尾。这句话的分量有限:测试只覆盖有人想到要写下来的用例。形式化验证提供更强的保证——用机器检查的证明,说明实现在规格覆盖的每一个输入上都满足规格。Berkeley RDI 联合芝加哥大学、加州理工、斯坦福、Apodex 与 AWS 的研究者(Zhe Ye、Hantao Lou、Yuechun Sun 为共同一作)在 2026 年 9 月发布基准 Vero,专门测一件事:智能体能否在真实代码库里做到这个标准。
Vero 的答案是「部分能做到」。最强配置在 43 个多模块 Lean 4 实例中全解 27 个,单条规格通过率达到 87.3%;但没有任何配置能在两种模式下解决全部实例,剩余 10 个实例对所有组合都无解。作者的核心判断是:单独证明一条规格已不再是难点,难的是把整个证明仓库组织起来,让它始终能构建、每条义务都能闭合。
基准:43 个仓库、743 个 API、2,705 条规格
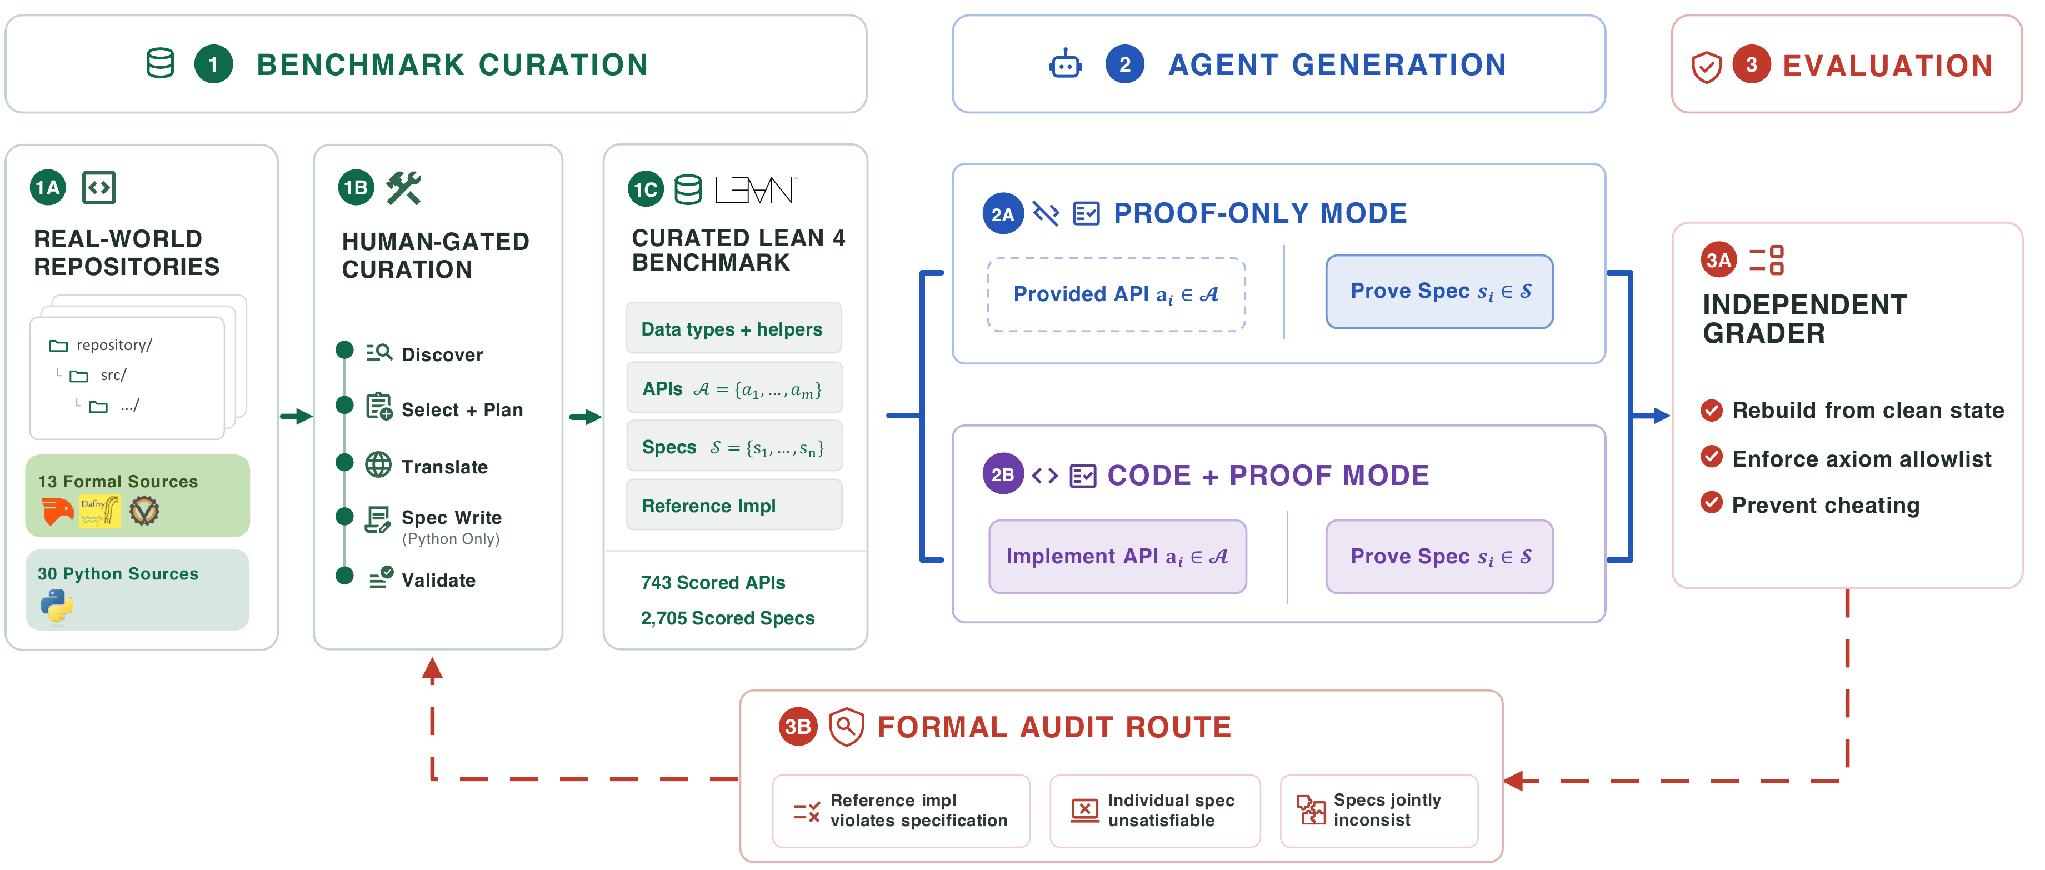
Vero 包含 43 个自包含的 Lean 4 项目:13 个译自 Dafny、Verus、Coq 这类本身带验证的项目,30 个译自 Python 项目、并由标注者为它们补写形式化规格。覆盖智能合约与区块链协议、分布式系统与共识、安全关键基础设施、形式数学、数据结构、算法与数值工具。全部 743 个计分 API 对应 2,705 条形式化规格。
每个实例由标注者提供三层冻结内容:共享数据类型与辅助定义、定义必须实现哪些接口的 API 签名、以及写成谓词的形式化规格。智能体负责填写实现体与证明义务。只有所有规格都被证明、仓库能从干净的基准源重新构建、且不依赖白名单之外的公理,才算一次全解。
评测有两种模式:
- 仅证明(proof-only):给出参考实现,智能体只需针对它证明所有规格,保留了仓库级的依赖关系
- 写实现并证明(code-and-proof):不提供参考实现体,智能体要自己写每个 API 体,再针对自己的实现证明规格;这是 Vero 的主模式
第二种模式不只是把任务叠起来。一个「好证明」的算法可能比忠实但难证的参考算法容易验证得多,而糟糕的实现选择会制造新的证明义务甚至弄坏构建。
判分与防作弊
判分器只从允许智能体编辑的区域提取内容,插入由基准源重新渲染的干净项目,再重建整个项目;它检查证明依赖是否落在公理白名单内,并用规则与 LLM 裁判筛查那些会让义务变得平凡的声明或类型类实例。这些措施针对的是「改冻结内容」或「引入不允许的公理」这类取巧。
主结果:27/43,单规格 87.3%
四种前沿配置在两种模式下运行,每次运行都有完整的文件系统、构建与 Lean 工具链权限,墙钟预算 90 分钟:
| 配置 | 写实现并证明(全解) | 仅证明(全解) |
|---|---|---|
| GPT-5.5(xhigh)+ Codex | 27/43 | 25/43 |
| Claude Opus 4.8 + Claude Code | 8/43 | 10/43 |
| GPT-5.5(medium)+ Codex | 2/43 | 6/43 |
| Claude Sonnet 5 + Claude Code | 2/43 | 2/43 |
GPT-5.5(xhigh)在 45 分钟内就分别完成 25 个与 23 个全解。从单条规格看,它在两种模式下的通过率为 87.3% 与 85.8%,与全解率的落差正是文章的主结论:大部分规格能证,但把整个仓库收尾要难得多。此外,多数被解出的实例只有一个配置能完成,另有 10 个实例在全部 8 种「配置 × 模式」组合下都无解。
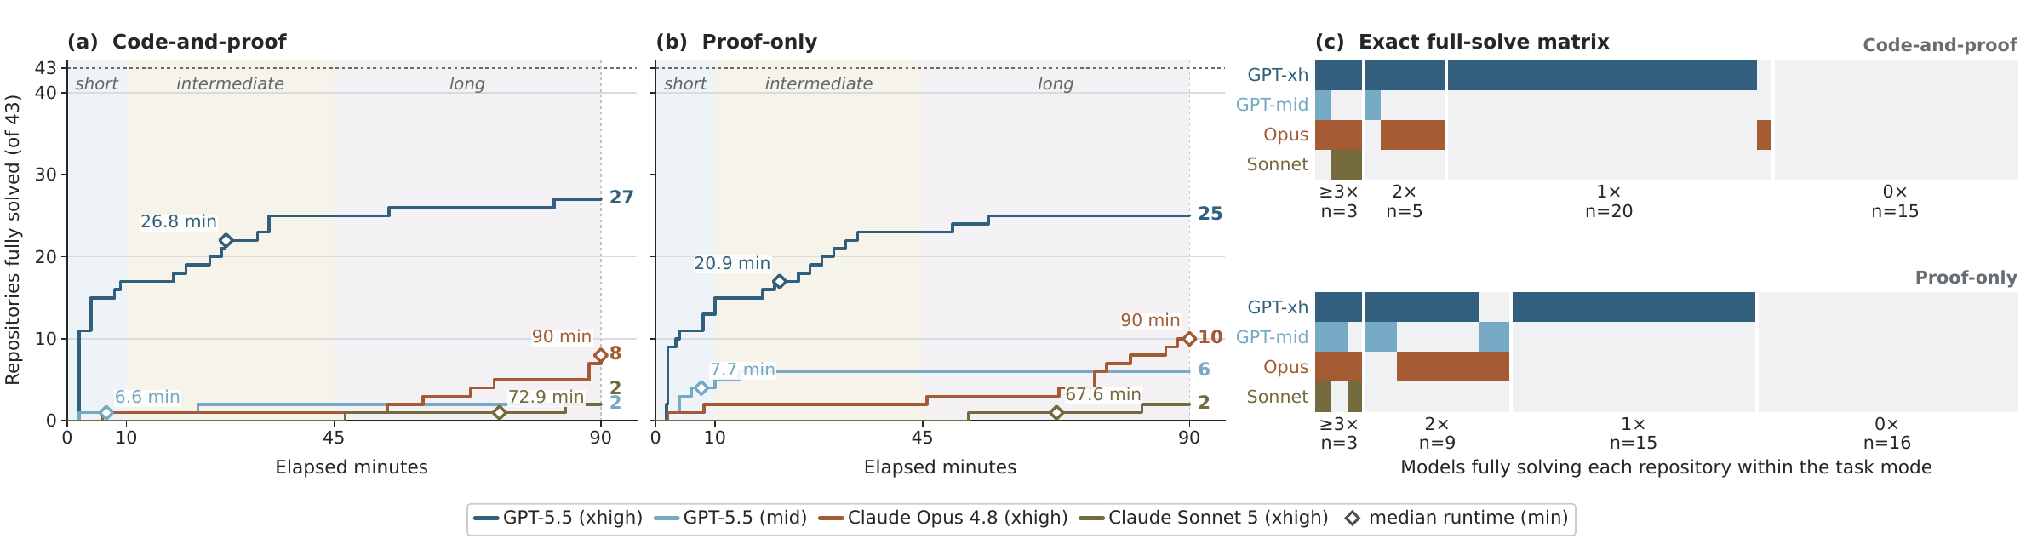
作者强调以「全解」为主要指标,因为部分规格覆盖会被简单义务抬高。在写实现并证明模式下,一条未证明的规格可能意味着缺证明,也可能意味着实现不满足规格;单规格覆盖率适合做诊断,但只有全部覆盖才能认证这份实现。
全解靠可复用引理库
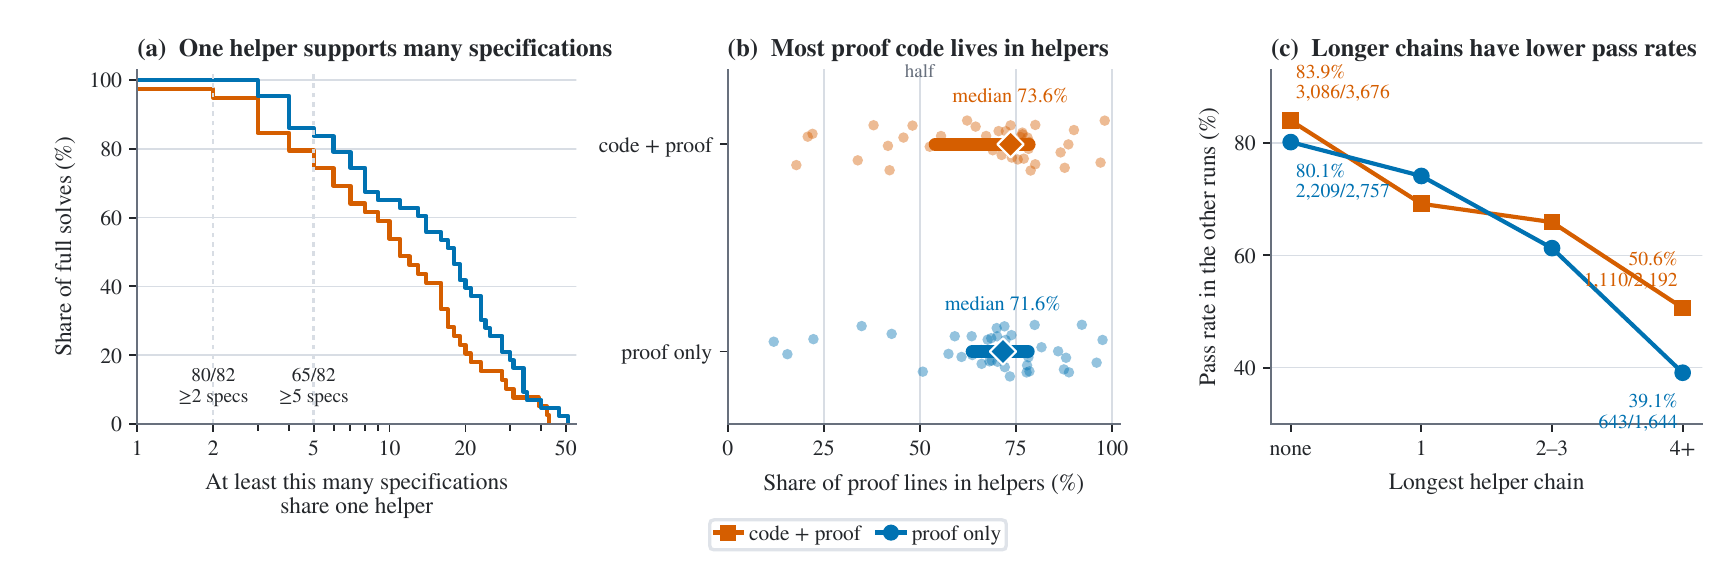
在 82 次全解运行中,智能体自己写的辅助定理占证明行数的中位数分别为 73.6%(写实现并证明)与 71.6%(仅证明)。82 次全解里有 80 次至少有一个辅助引理支撑两条以上规格,65 次至少支撑五条。
反过来说,引理链越深,通过率越低:没有任何辅助引理时,两种模式的规格通过率是 83.9% 与 80.1%;当最长辅助链达到 4 层以上,分别跌到 50.6% 与 39.1%。作者据此指出,需要更好的不变量发现、证明依赖规划与可复用的局部引理库。
实现自由度既帮忙也添乱
论文找到 5 组「实例—智能体」配对:智能体把一个难证的参考算法替换成满足同样规格的简单实现。把这 5 组改掉后,写实现并证明模式闭合了全部 250 条规格,而针对固定参考实现的仅证明运行只闭合 201 条。也就是说,实现自由带来的主要是可证明性,不一定是生产质量——有些替换牺牲了渐进复杂度。
自由也会增加难度:17 组匹配的「实例—智能体」配对在仅证明模式下能全解,在写实现并证明模式下不能。轨迹分析显示,智能体倾向于早早选定实现,然后一直堆证明到截止时间,而不是在证明反复卡住时回头修改定义。
基准自身也会出错
形式化验证基准也可能藏着错误,它们能通过类型检查、构建成功、甚至躲过标注者审阅。Vero 把这类问题变成持续改进的机制:当某个证明义务看似不可能完成时,审计机制接受三种机器检查的「否定证据」——参考实现违反规格;不存在任何实现能满足该规格;一组规格虽然各自可满足、合在一起却互相矛盾。每份形式化证据都会把对应实例送回标注复核,所有被确认的缺陷都在本文报告的成绩之前修好。
核心总结
- Vero 是仓库级的「写实现 + 写证明」基准:43 个 Lean 4 多模块项目、743 个 API、2,705 条规格,来自真实 Python、Dafny、Verus、Coq 代码
- 最强配置 GPT-5.5(xhigh)+ Codex 全解 27/43,单规格通过率 87.3%;Claude Opus 4.8 为 8/43;10 个实例对所有配置都无解
- 差距不在单条证明,而在仓库级组织:共享不变量、代码与证明的协同、保持构建可复现
- 全解普遍依赖可复用引理(中位占证明行数七成以上),但引理链一深,违约率明显上升
- 实现自由能让难证算法变简单、闭合更多规格,但也会让智能体过早锁定实现;这是作者眼中下一阶段要解决的方向
原文:Vero: Can AI Agents Build Formally Verified Software Repositories?(Berkeley RDI,2026 年 9 月)|论文:arXiv:2608.13522


