2026 年 10 月 6 日,Mistral 发布 Mistral Large 4(内部简称 ML4,昵称「le Chonk」)的公开预览,可通过 Mistral Studio 的预览 API 调用,权重将在本月底开放。这是一款 1 万亿参数、490 亿激活参数的原生多模态混合专家(MoE)模型,也是 Mistral 迄今最大、最强的模型;公司称它在网络安全、金融、法律等关键企业负载上达到开源模型中的最优水平,在视觉定位等方向甚至超过前沿闭源模型。
规格与定位:万亿参数、490 亿激活、原生多模态
ML4 是「指令 + 推理」一体的混合 MoE,支持多模态输入,把指令跟随、推理与智能体能力统一在同一个模型里。官方给出的 API 定价为每百万输入 token 1.36 美元、每百万输出 token 4.18 美元。模型卡里还有一句值得注意的描述:原生流利支持 160 种以上语言,其中包含欧盟全部官方语言。
Mistral 强调了两件事。第一,ML4 的性能已能与全球最强开源模型竞争,并且显著超过任何在美国或欧洲开发的开源权重模型。第二,在正式开源权重之前,他们会与网络安全负责人、经过审核的合作伙伴以及国家机构一起,在真实环境中对模型做红队测试——这些参与者拿到的是同一个模型,但拥有更宽松的审核设置和更强的网络能力。
编码与智能体:进入第一梯队
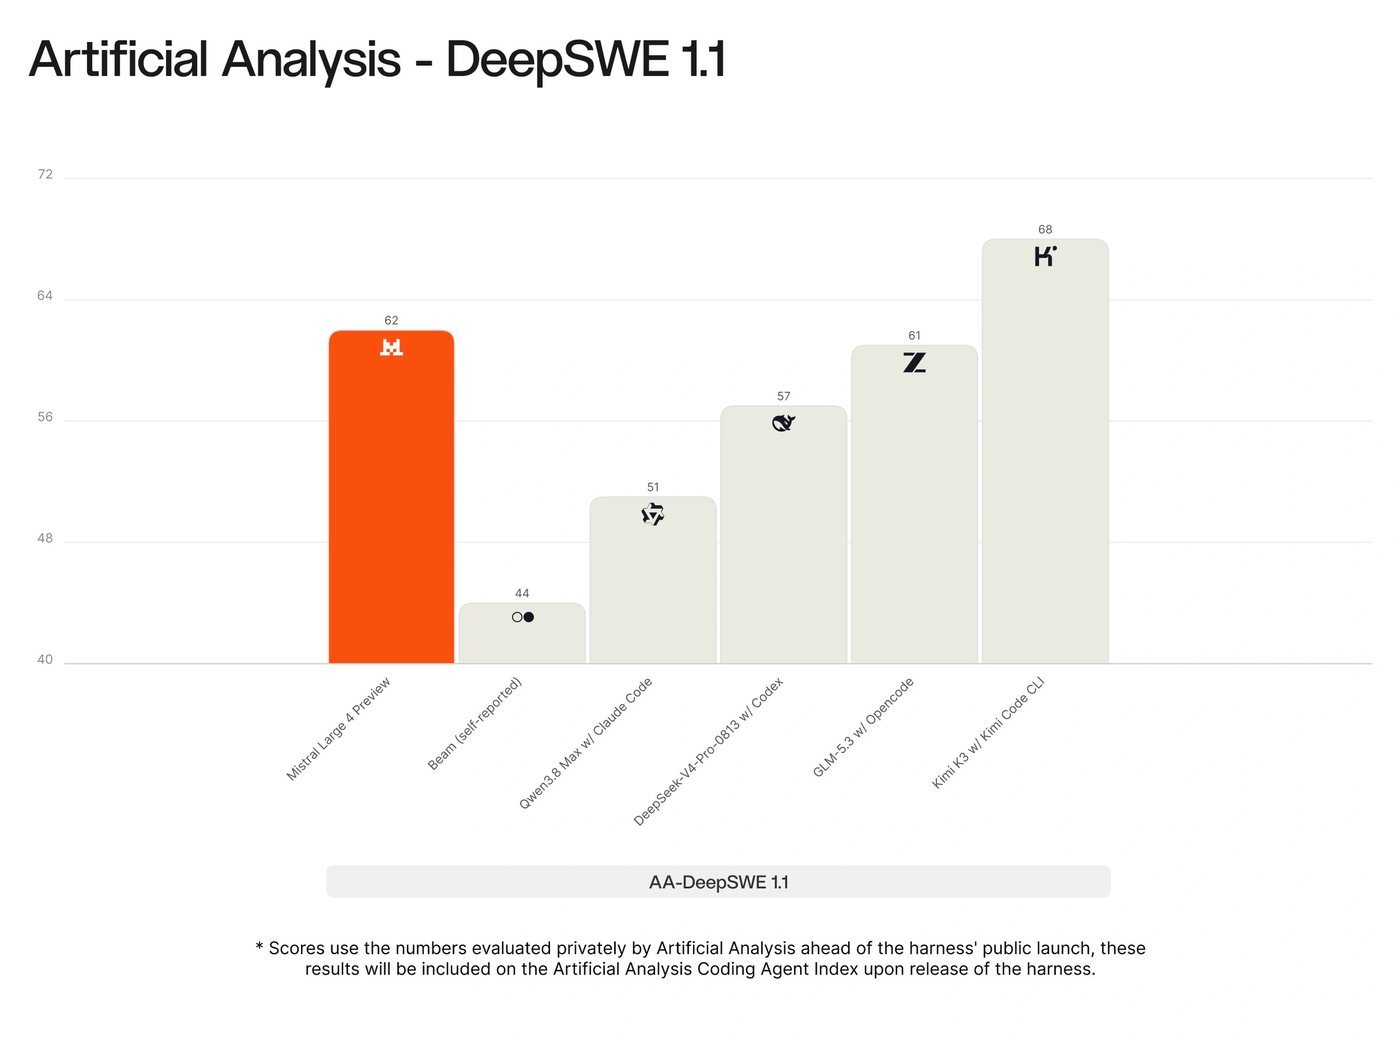
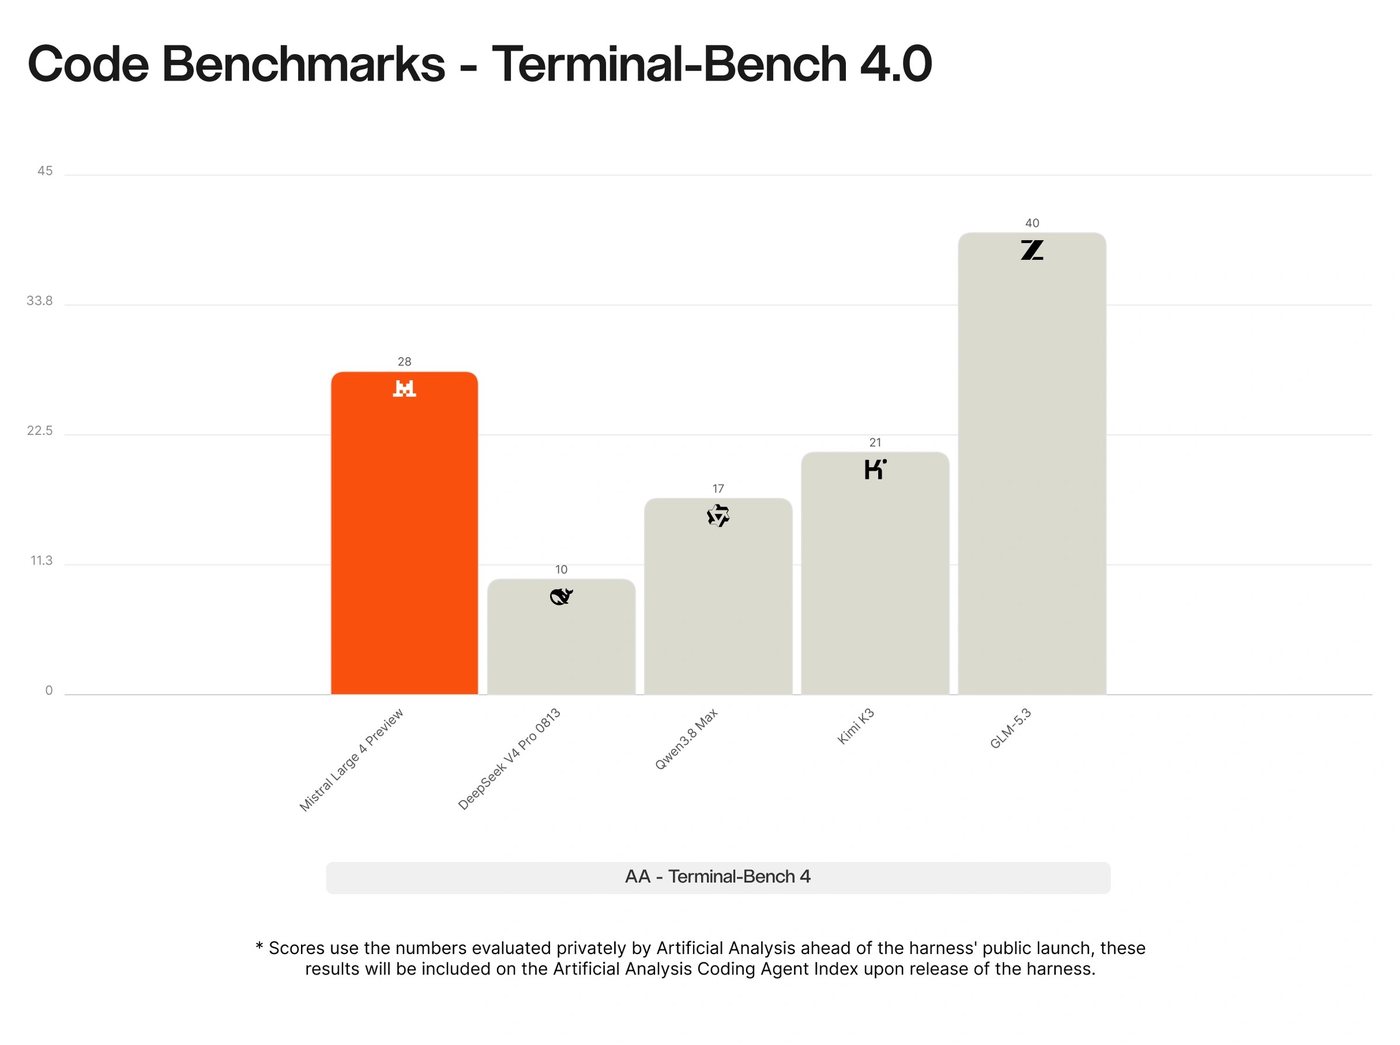
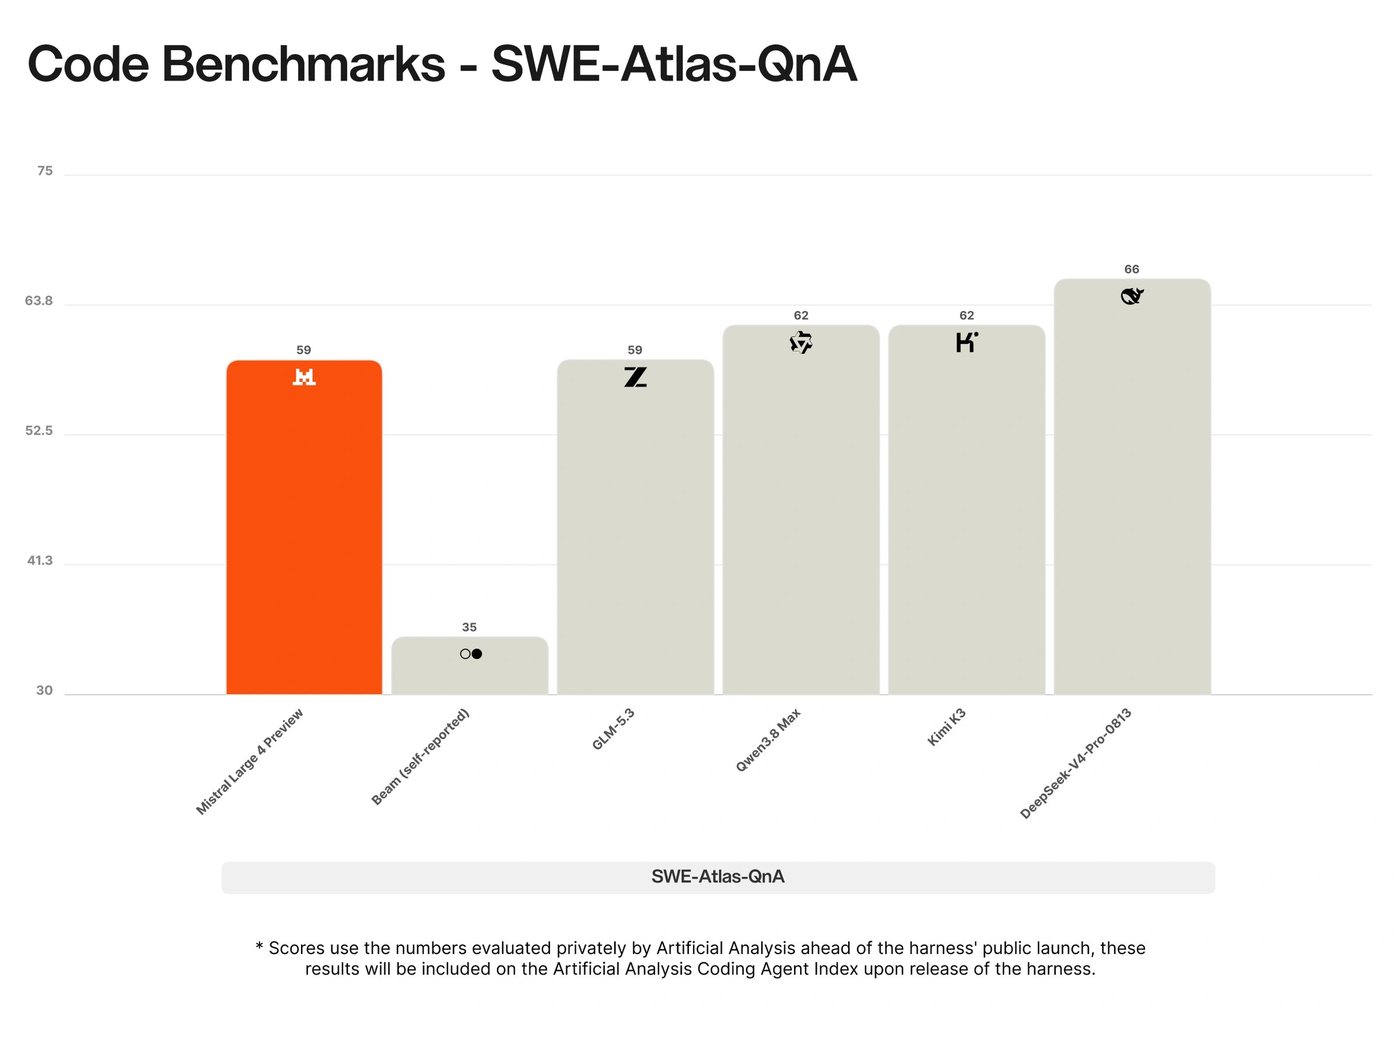
在编码方向,Mistral 给出三个数字:DeepSWE v1.1 上 61.7%、SWE-Atlas-QnA 上 59.4%、Terminal-Bench 4 上 28.3%,综合 Coding Agent Index 得分 49.8%,领先 DeepSeek V4 Pro 0813 与 Qwen3.8 Max。
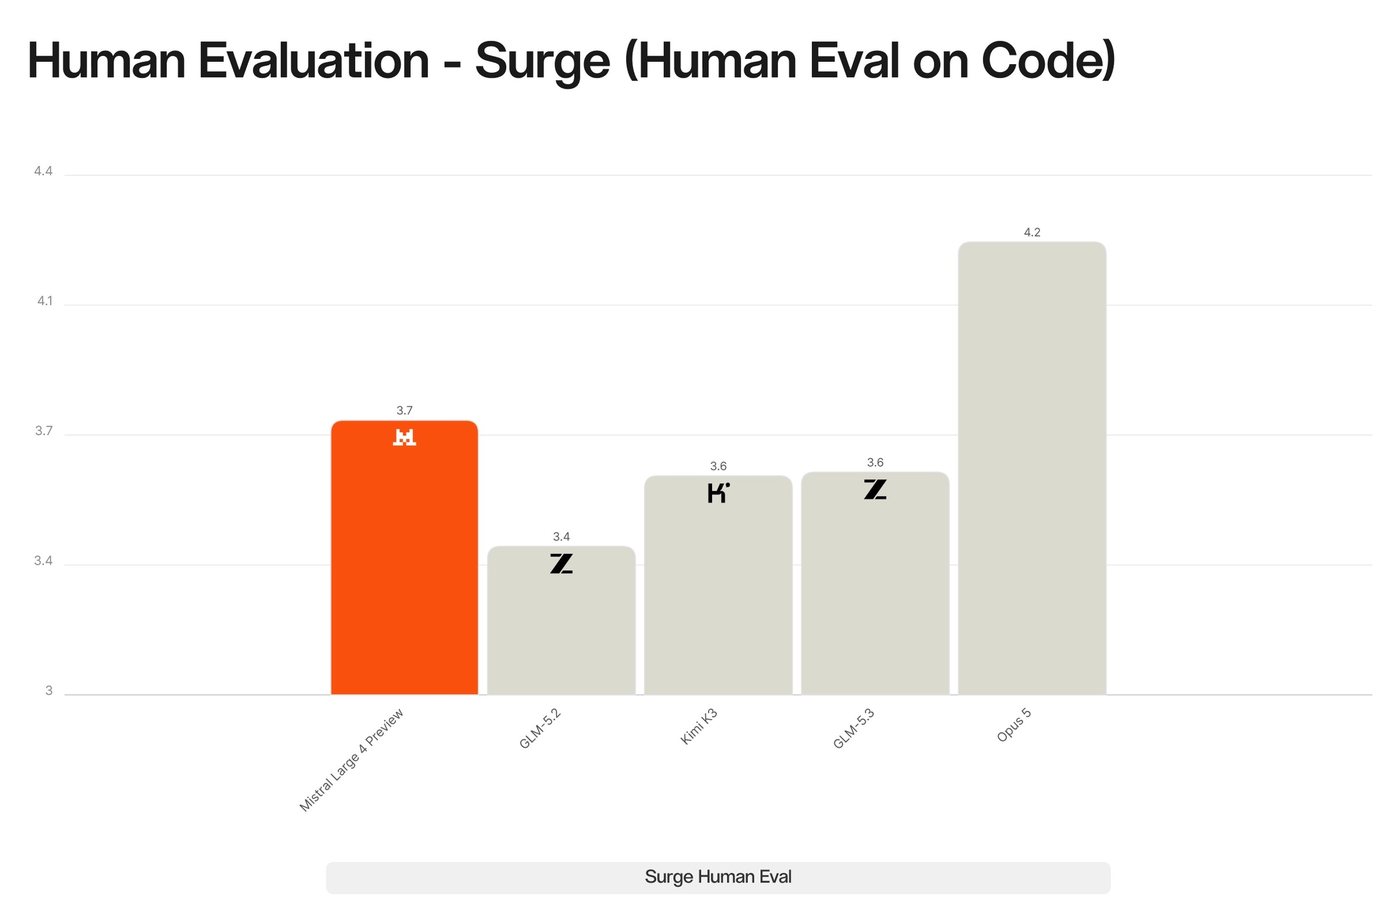
在编码质量上,Mistral 与 Surge AI 做了一次盲测人工评估:专业标注员在不知道模型身份的情况下按 1–5 分打分。ML4 预览版以 3.74 分在五个模型中排第二,超过 Kimi K3(3.59)、GLM-5.3(3.60)和 GLM-5.2(3.40),仅次于 Claude Opus 5(4.22)。
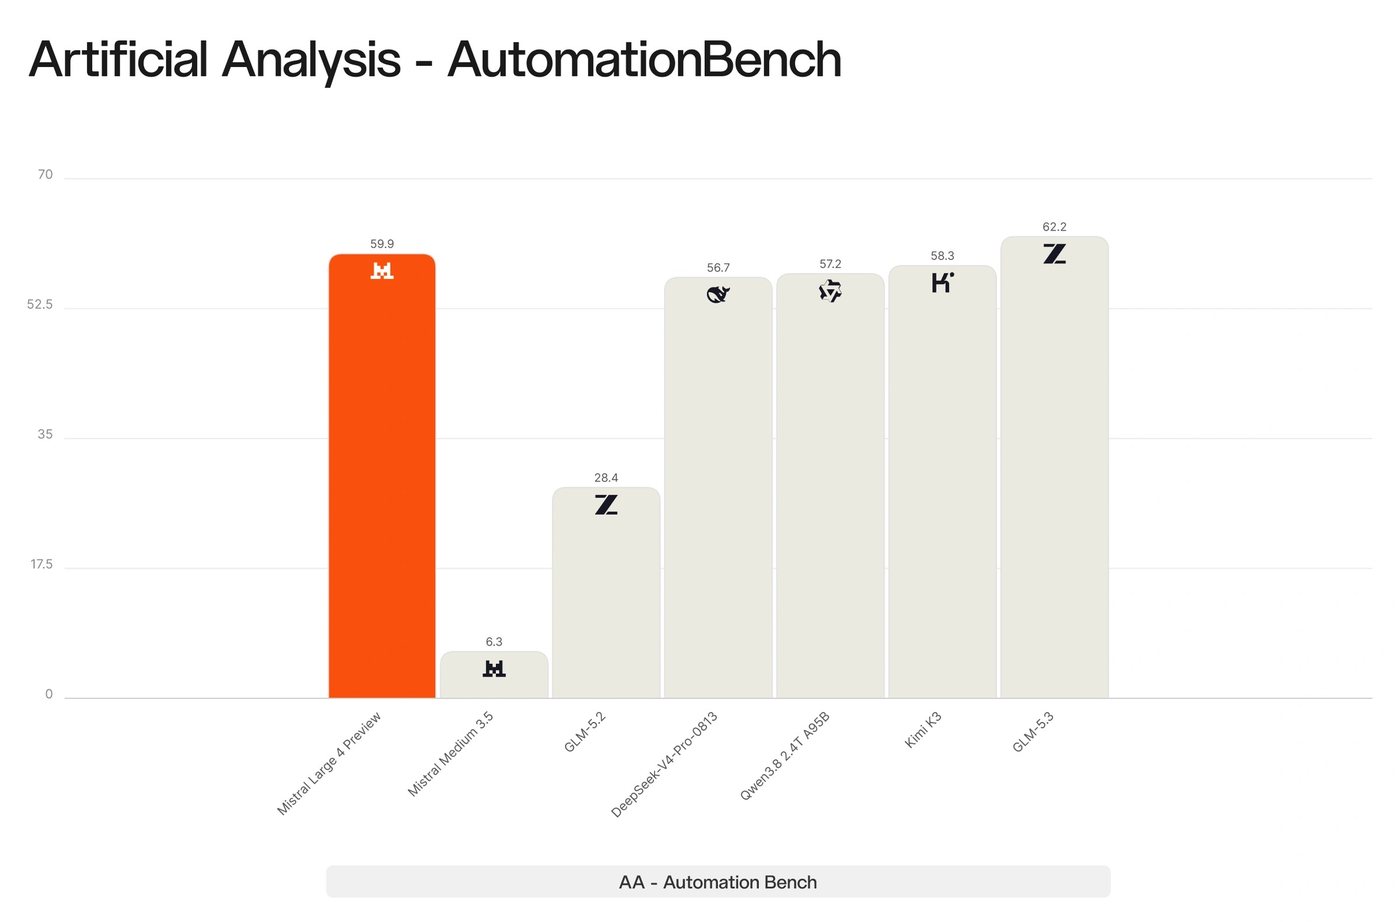
智能体方向上,ML4 定位是「能搜集信息、调用工具并交付成品」的通用智能体。在覆盖 Gmail、Google Sheets、Slack、Salesforce 等应用、共 657 条业务流程的 AutomationBench 上,它拿到 59.9%,领先 Kimi K3、MiMo-V2.6-Pro 与 DeepSeek V4 Pro;在评价长周期知识工作的 AA-Briefcase 上达到 1393 Elo。
网络安全:把「拒绝率」也当成竞争力
网络安全是 Mistral 重点着墨的方向,理由也很直白:在安全领域,服务商层面的拒绝会挡住合法的漏洞研究与应急响应,而在事件处理中途失去能力本身就是一种安全风险。
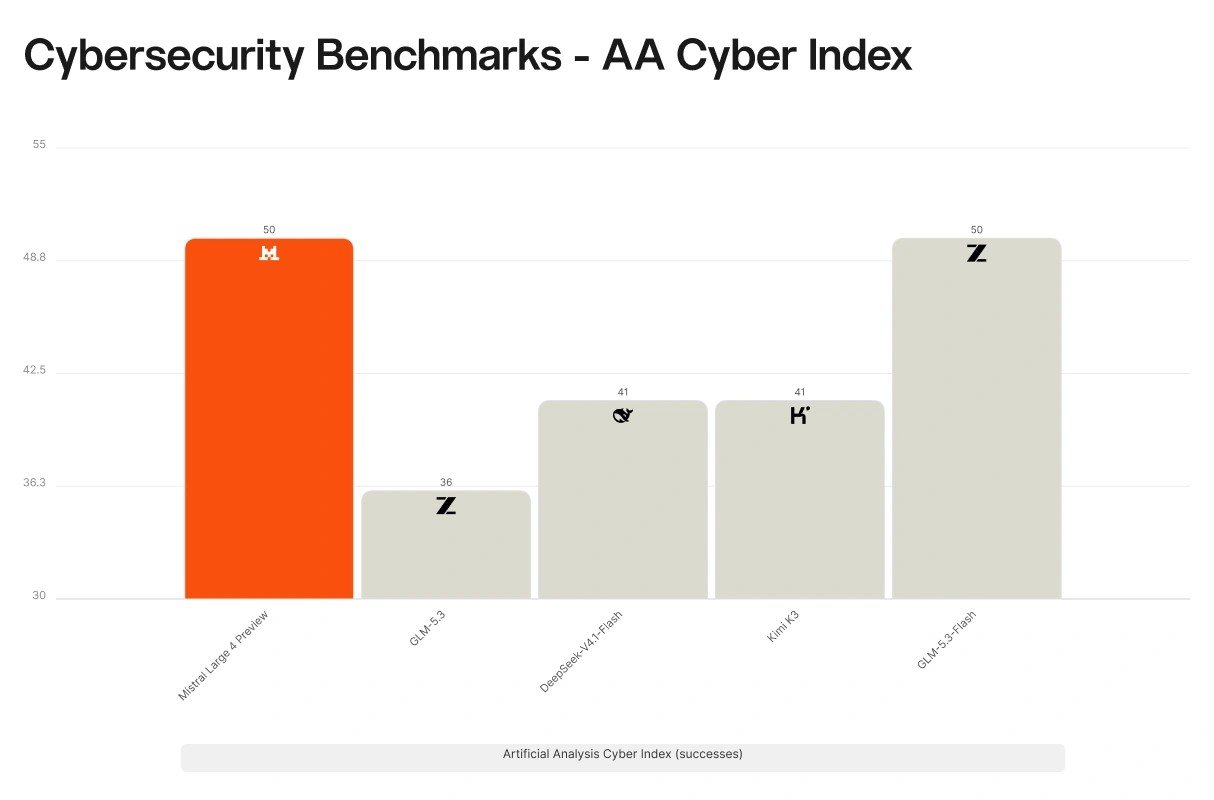
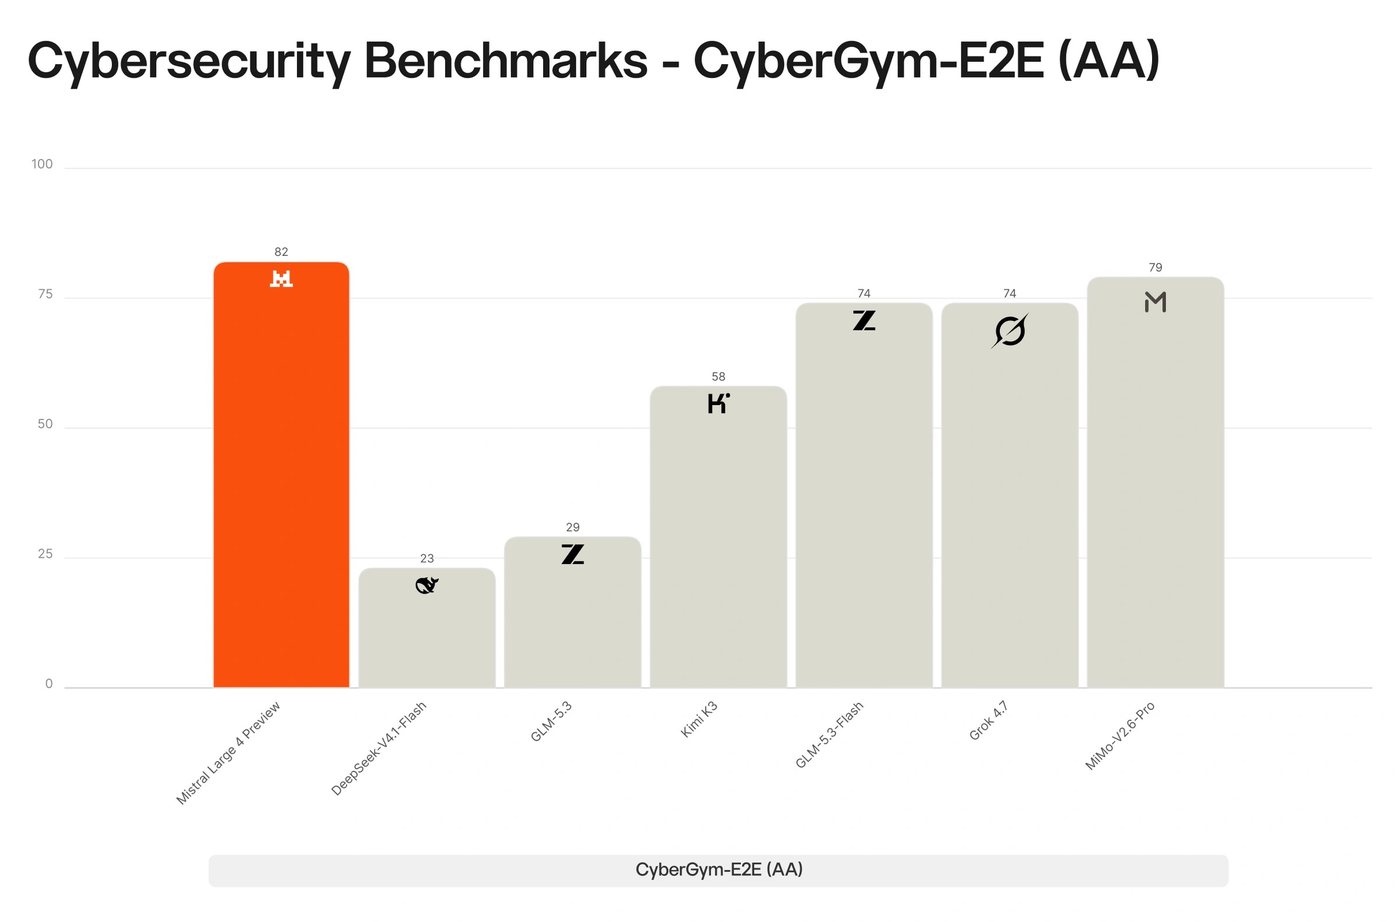
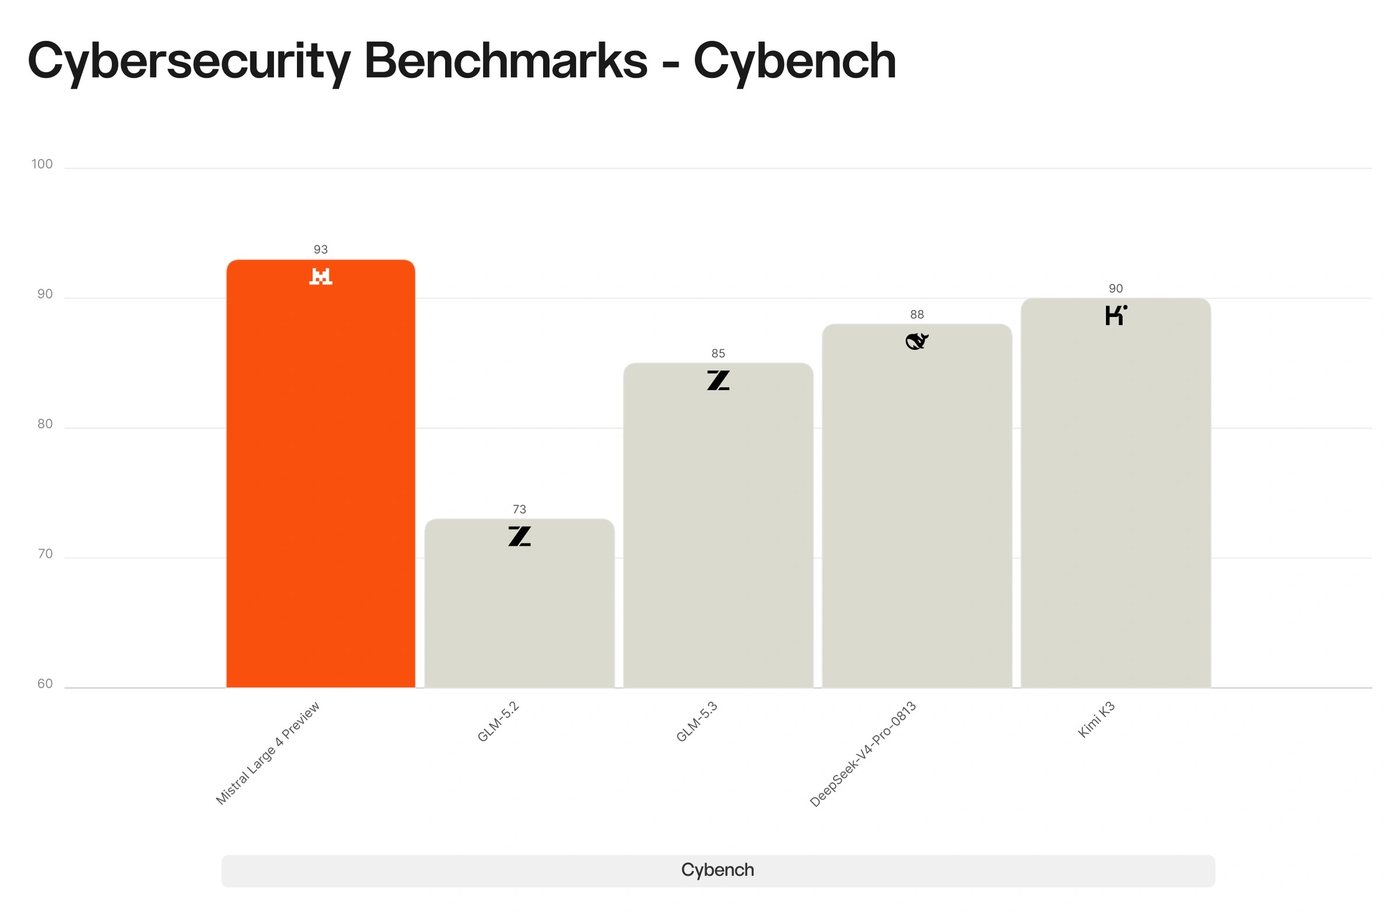
在 Artificial Analysis Cyber Index(独立评测模型在真实软件中发现并修复安全缺陷的能力)上,ML4 进入全球前五,并大幅领先在中国以外开发的开源权重模型;在其中一项「复现开源软件真实漏洞再打补丁」的测试里,ML4 拿到 82%,是所有模型中最高;在取自安全竞赛的 40 道题(Cybench)中解出 93%,是开源权重模型里有报告的最高分之一。
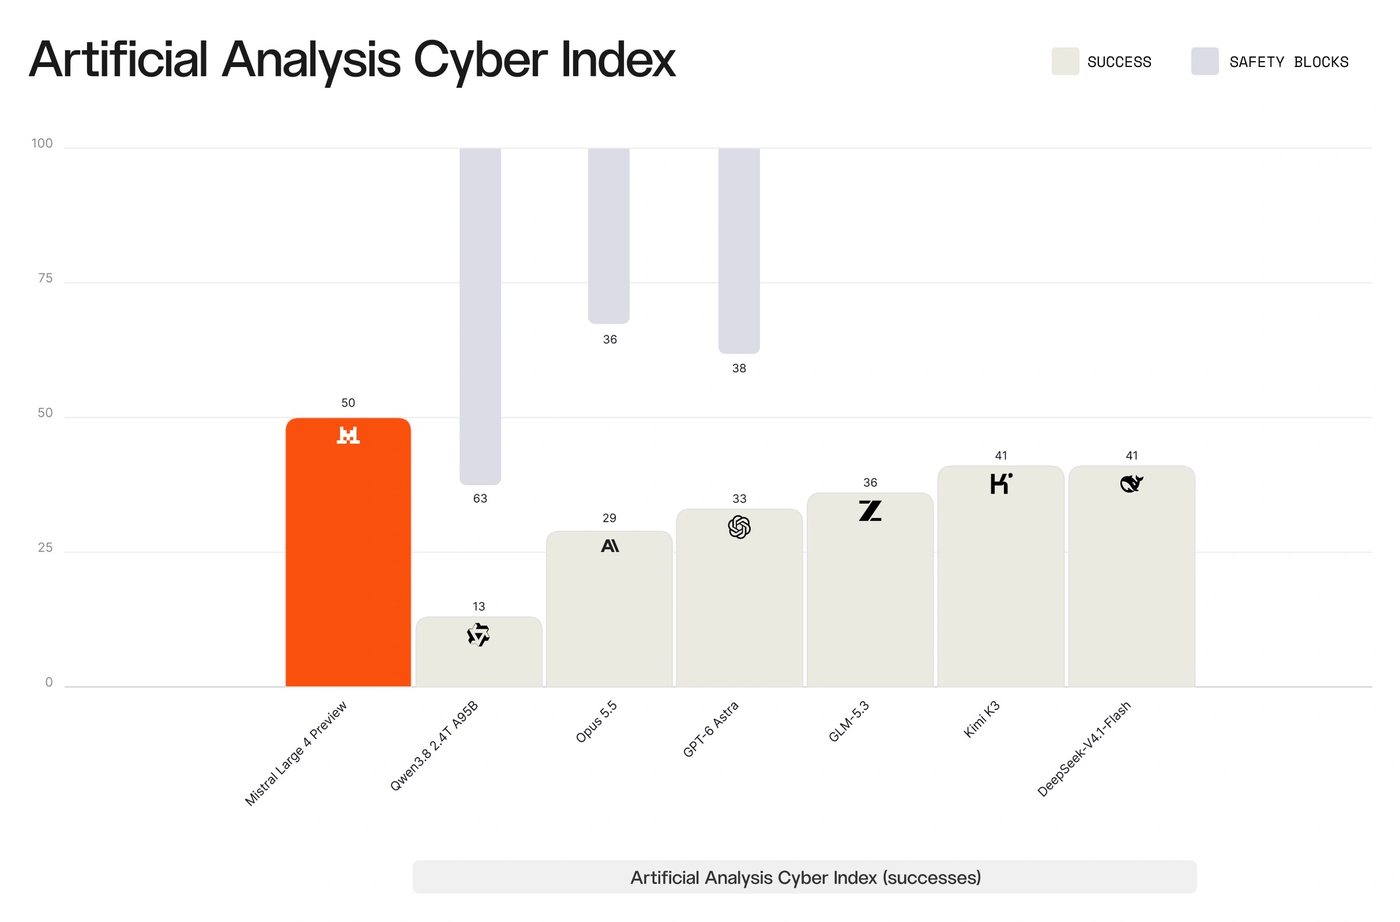
Mistral 特别点出了对比中的关键:包括 Claude Opus 5.5 与 GPT-6 Astra 在内的若干领先闭源模型在同一测试上接近零分,原因是它们拒绝执行该任务。下图把「成功率」和「安全拦截(safety blocks)」并列展示,可以清楚看到这一差异。
Mistral 还提到,ML4 的能力超出显式训练范围:内部测试中它可用于分析恶意软件、为漏洞排优先级、编写检测规则。对于需要主权、可审计安全 AI 的机构,模型可运行在私有云或本地环境。
多模态、科学与知识工作
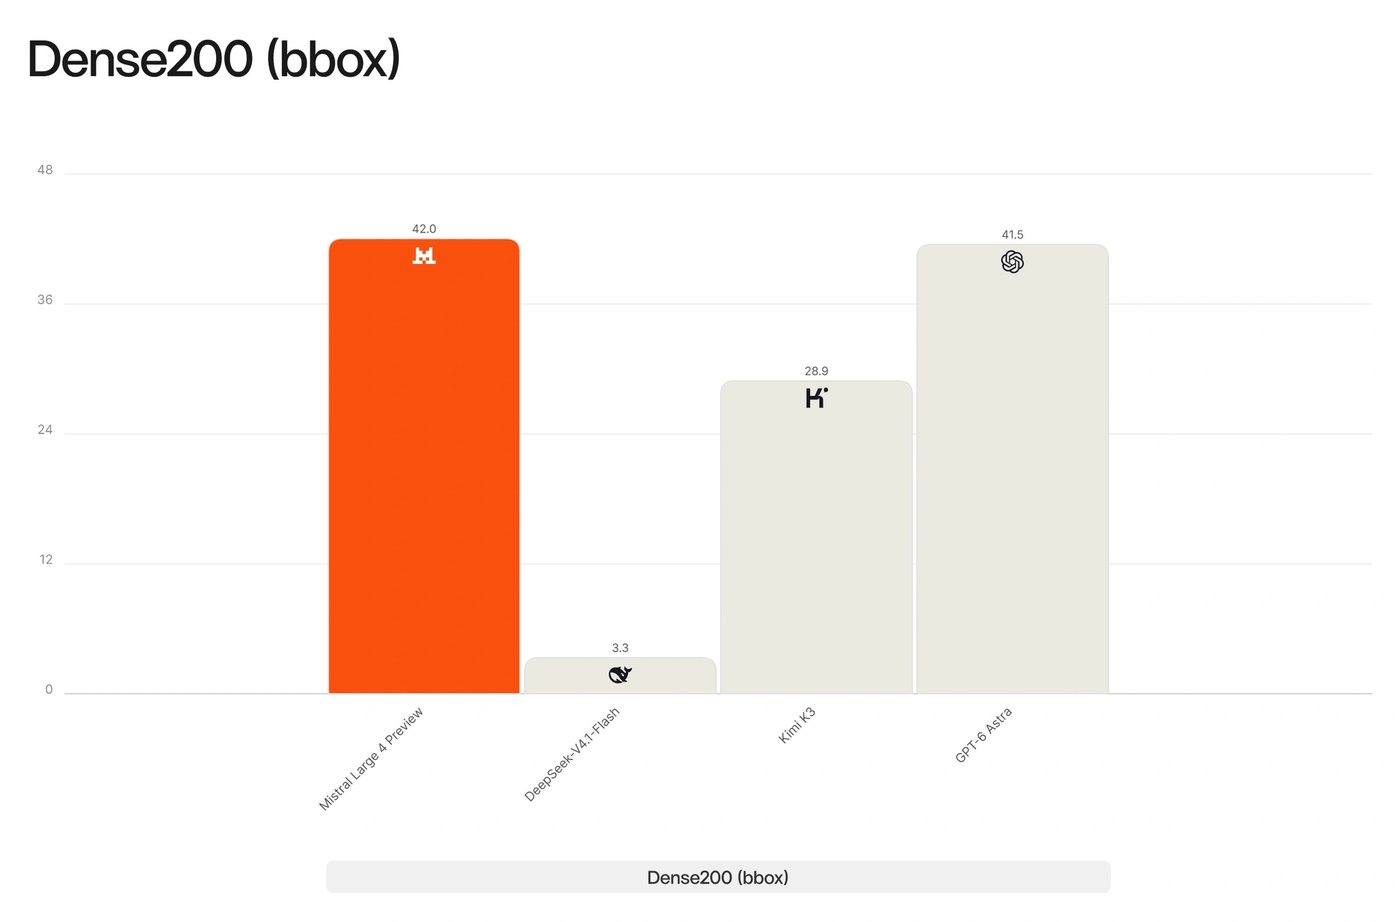
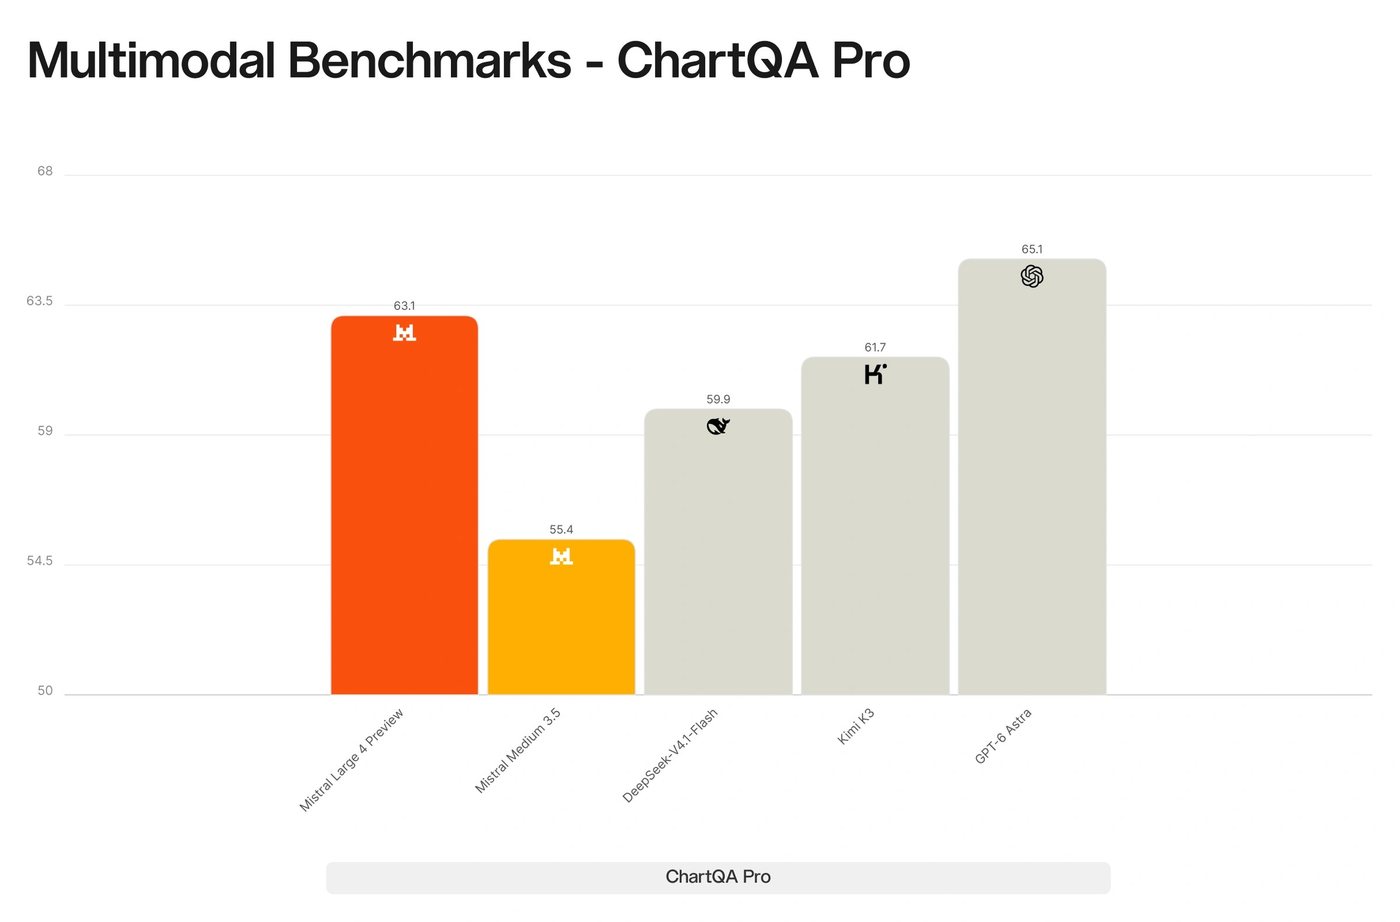
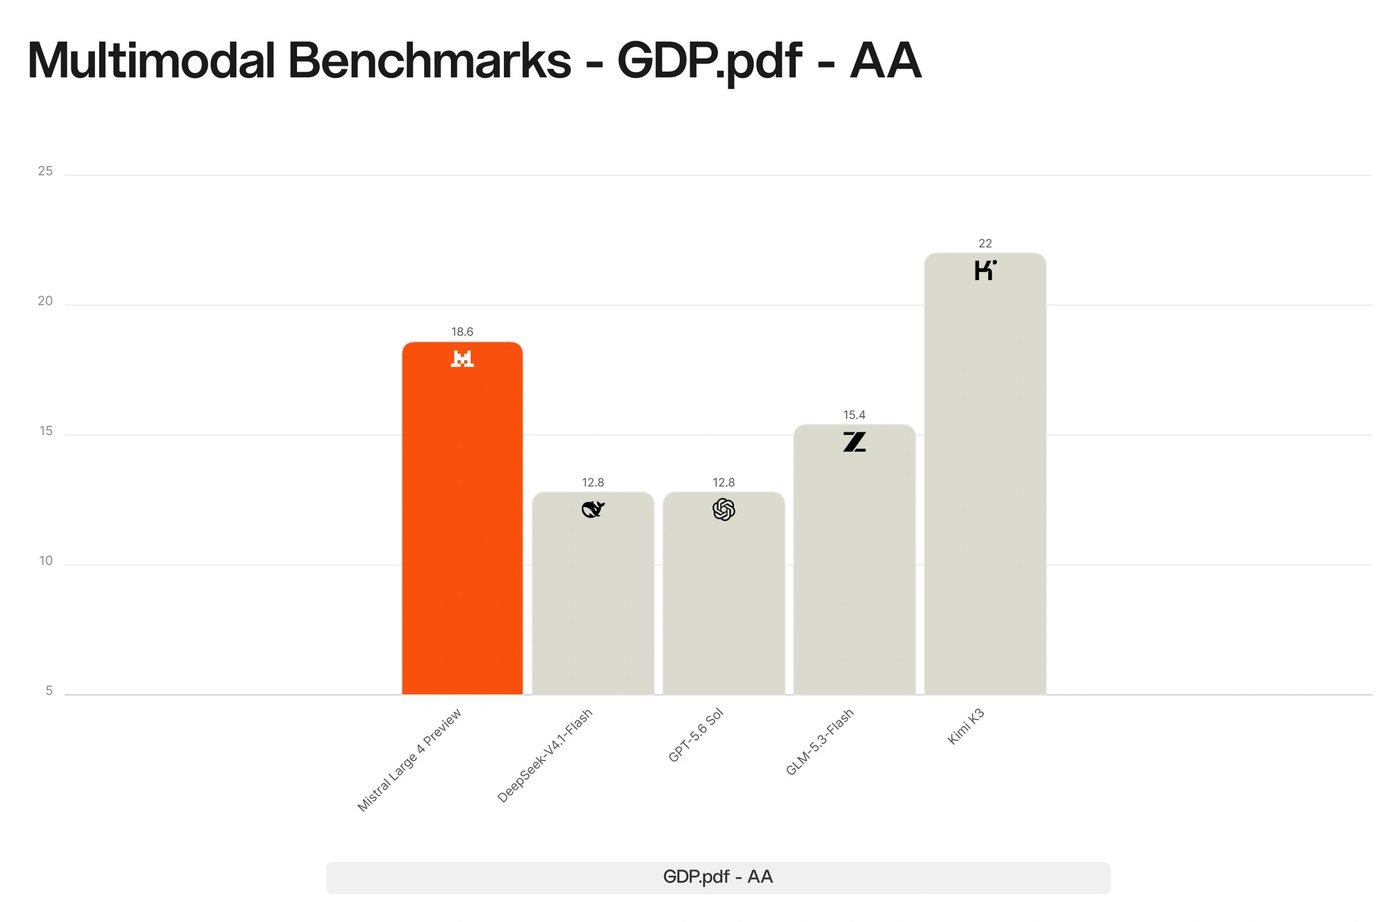
多模态方面,Mistral 称这是自家模型在图像理解上的一次跃升,能对复杂文档、图表和自然图像做推理,并把视觉与智能体能力结合:从检查千兆像素级卫星影像(帮助救灾团队抢时间),到分析工程图纸(放大、检查、验证直到答案准确)。在视觉定位上,ML4 在 Dense 200 上以 42% 对 41% 略胜 GPT-6 Astra。
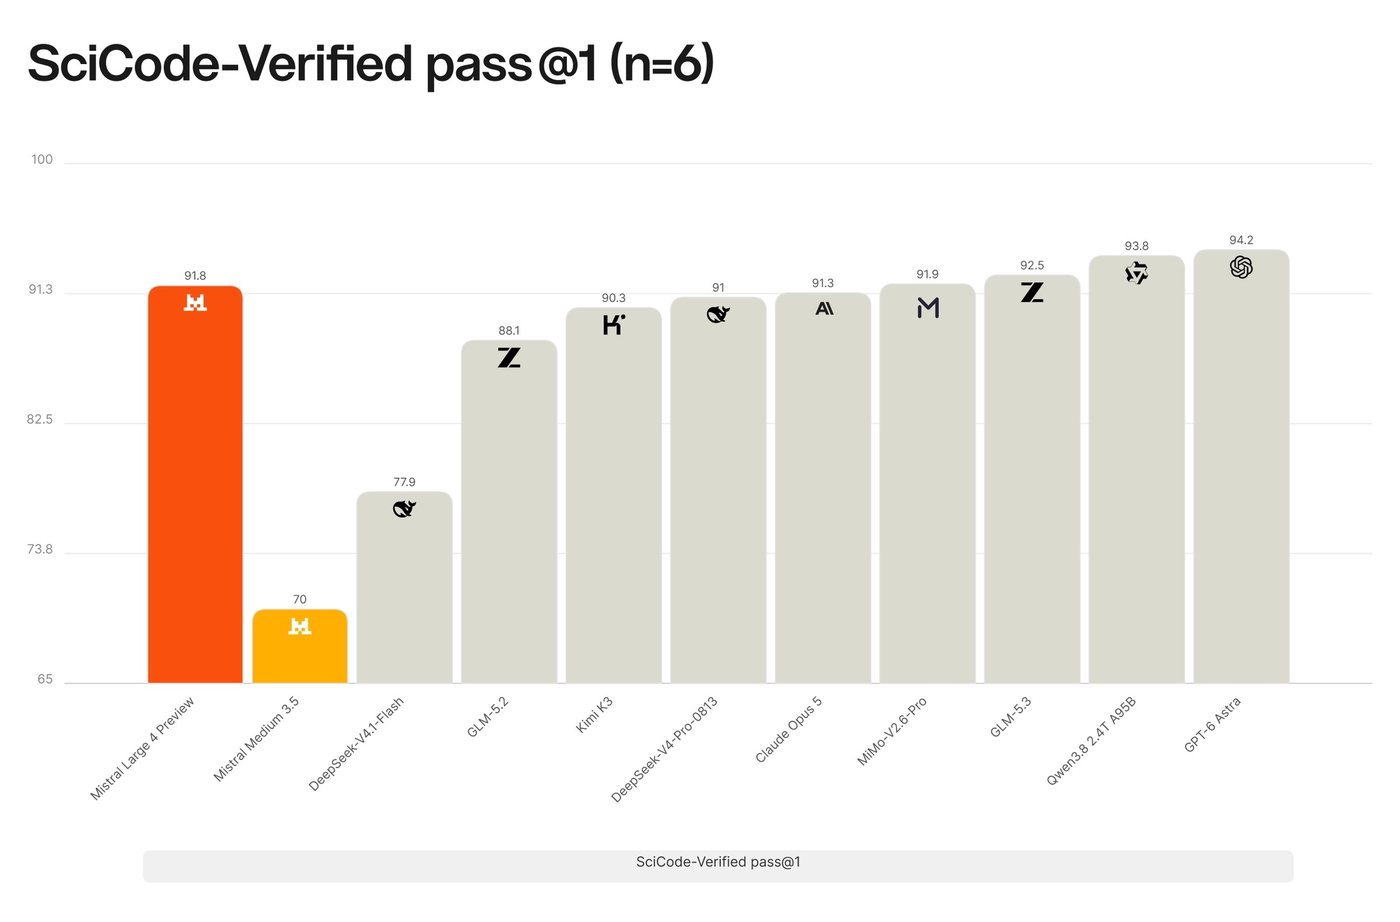
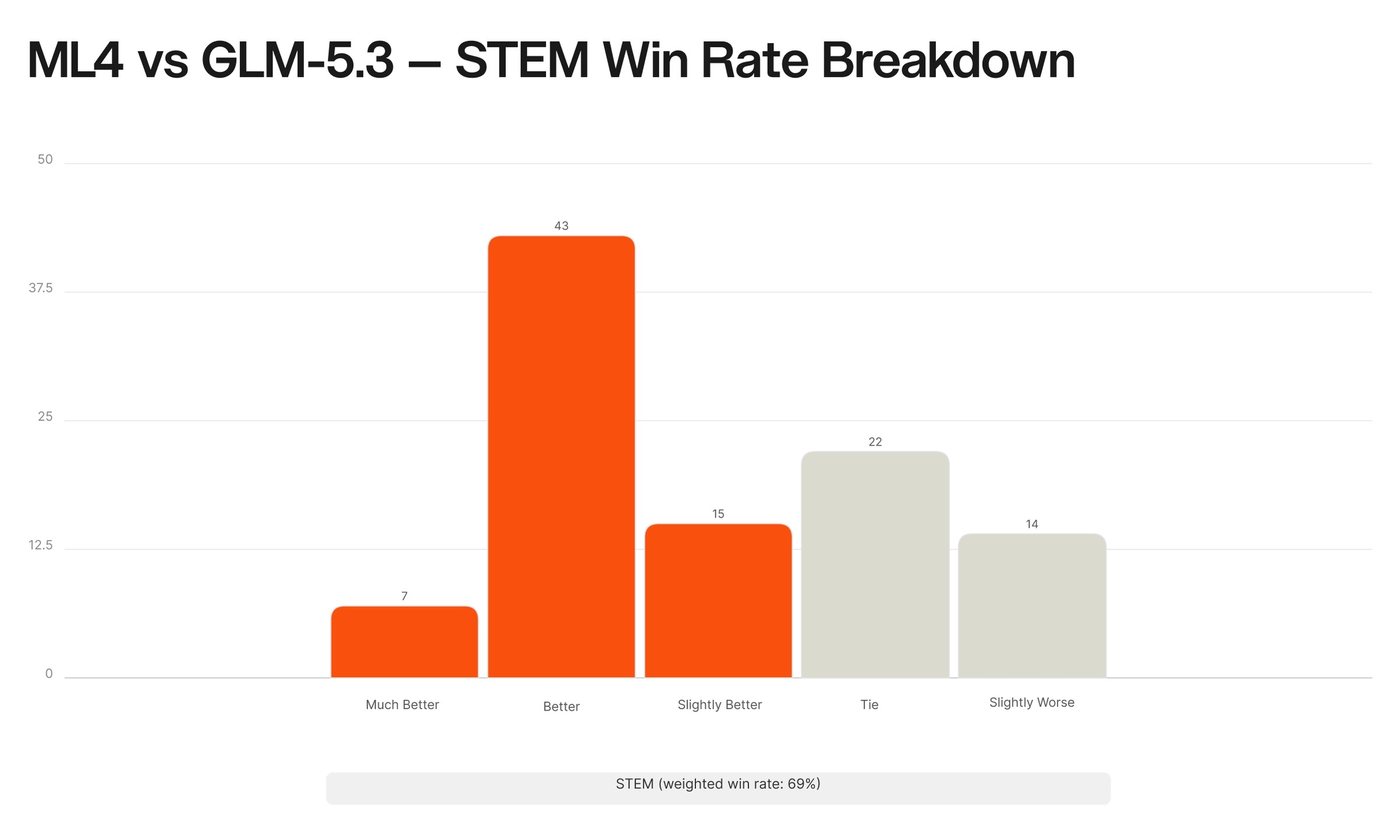
科学与数学方面,ML4 在开源权重模型中于 SciCode-Verified 上达到最优,官方称它能一次性生成完整的 Hartree–Fock 模拟——这是由一系列高级例程组合而成的复杂多步化学计算;在人工评估中,它的数学推理比 GLM-5.3 更精确、结构更清晰,并能持续处理长时间的专业应用数学任务。
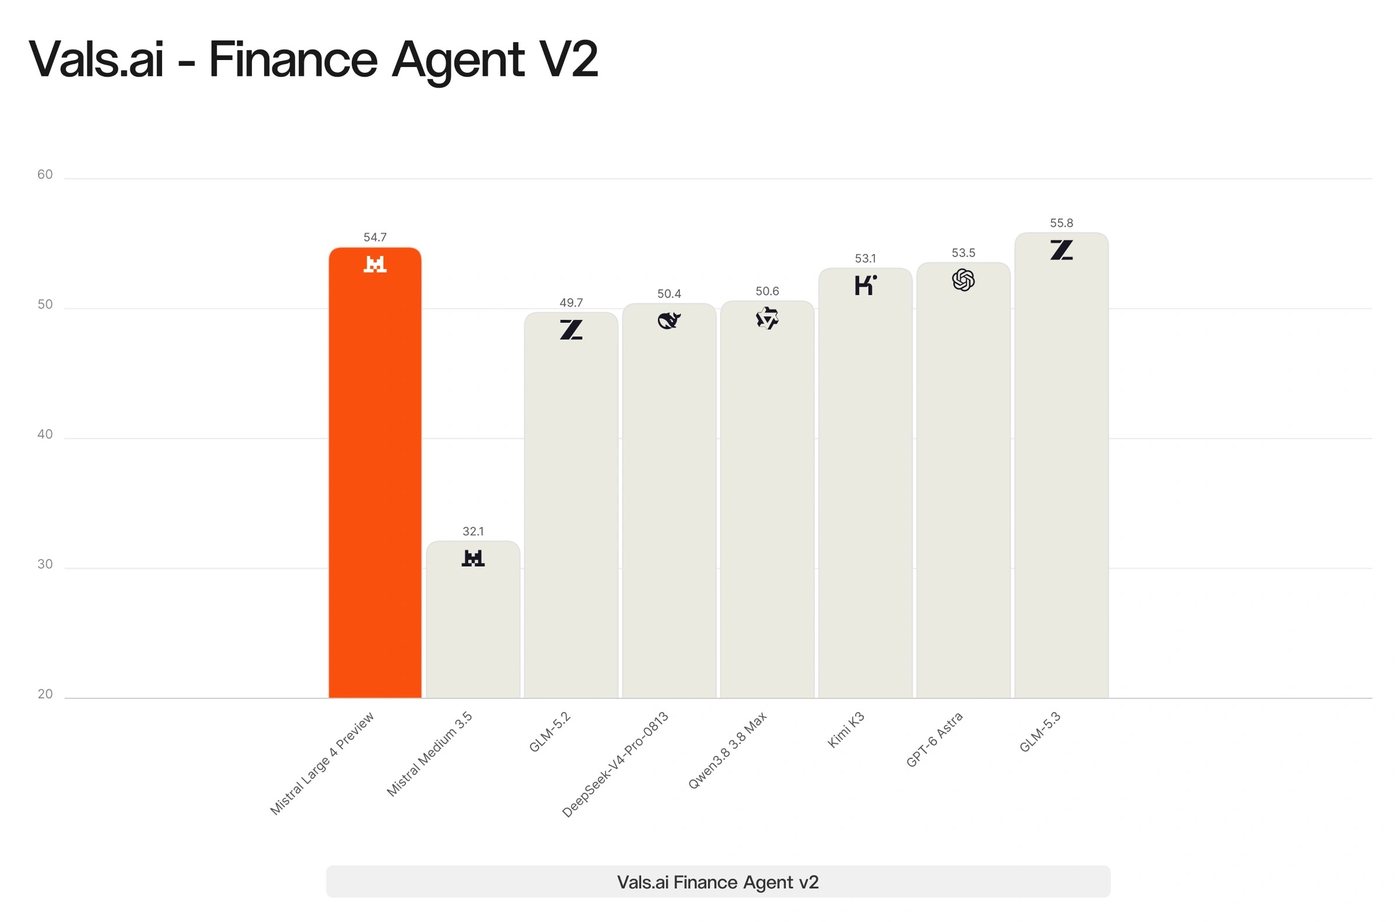
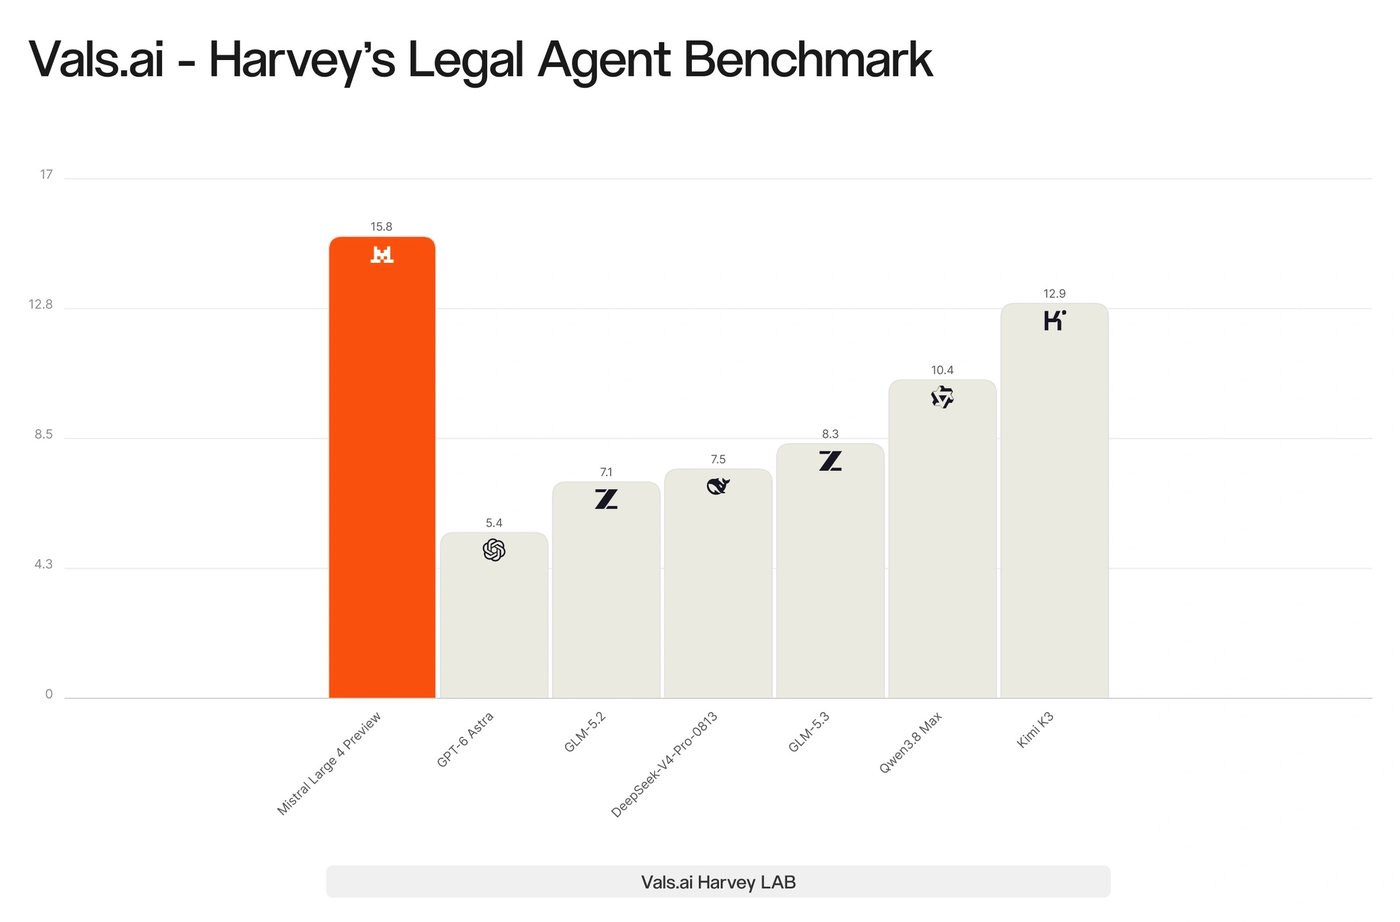
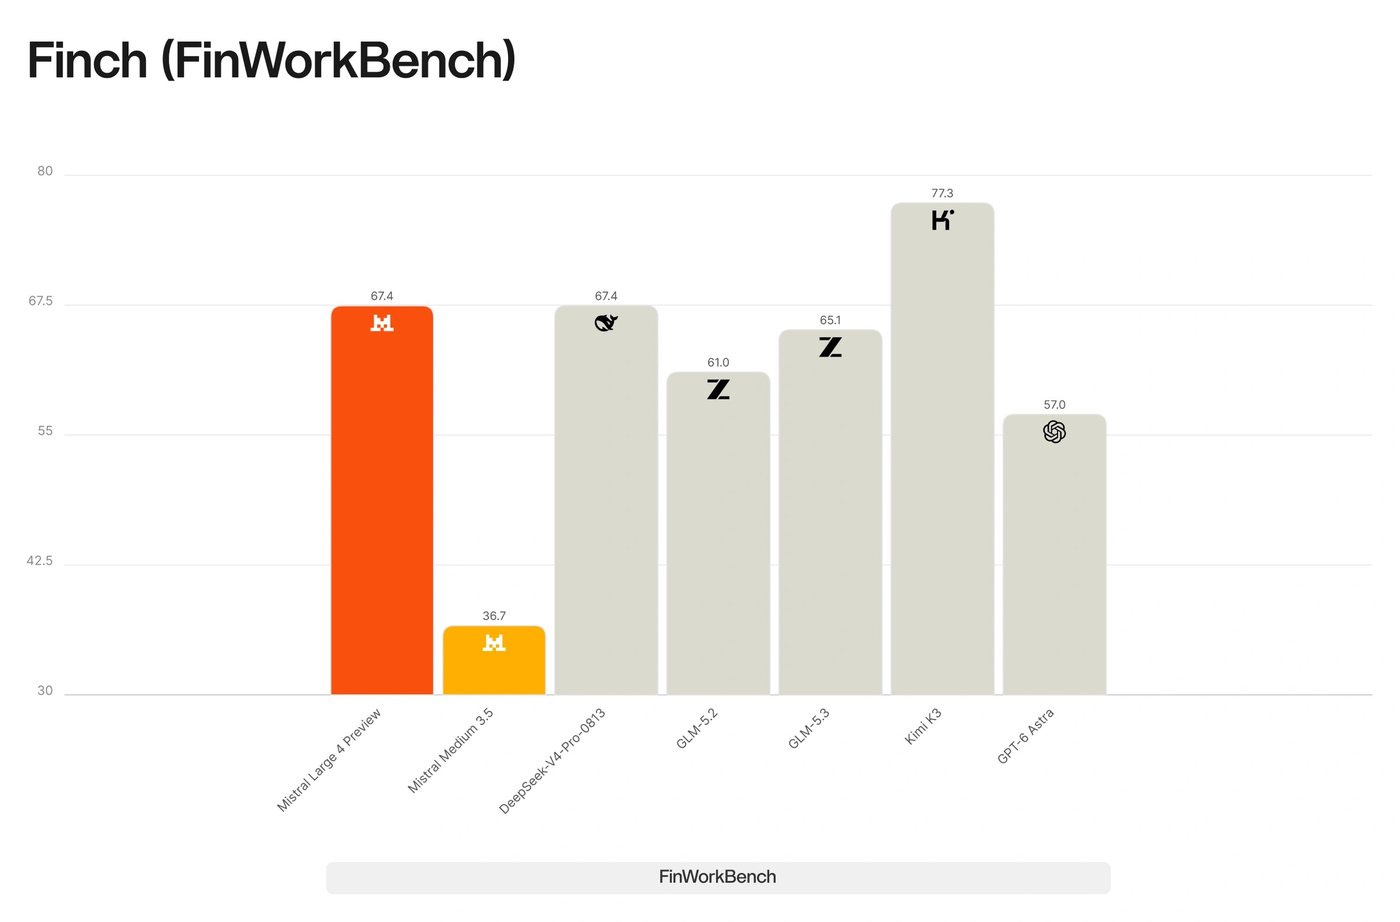
知识工作方向,Mistral 通过第三方评估方 vals.ai 在具有代表性的法律与金融任务上做了评测,称 ML4 在这两类任务上都超过 GPT-6 Astra;在 HarveyAI 的法律智能体基准上,它超过所有开源模型。
安全、人类评估与强化学习
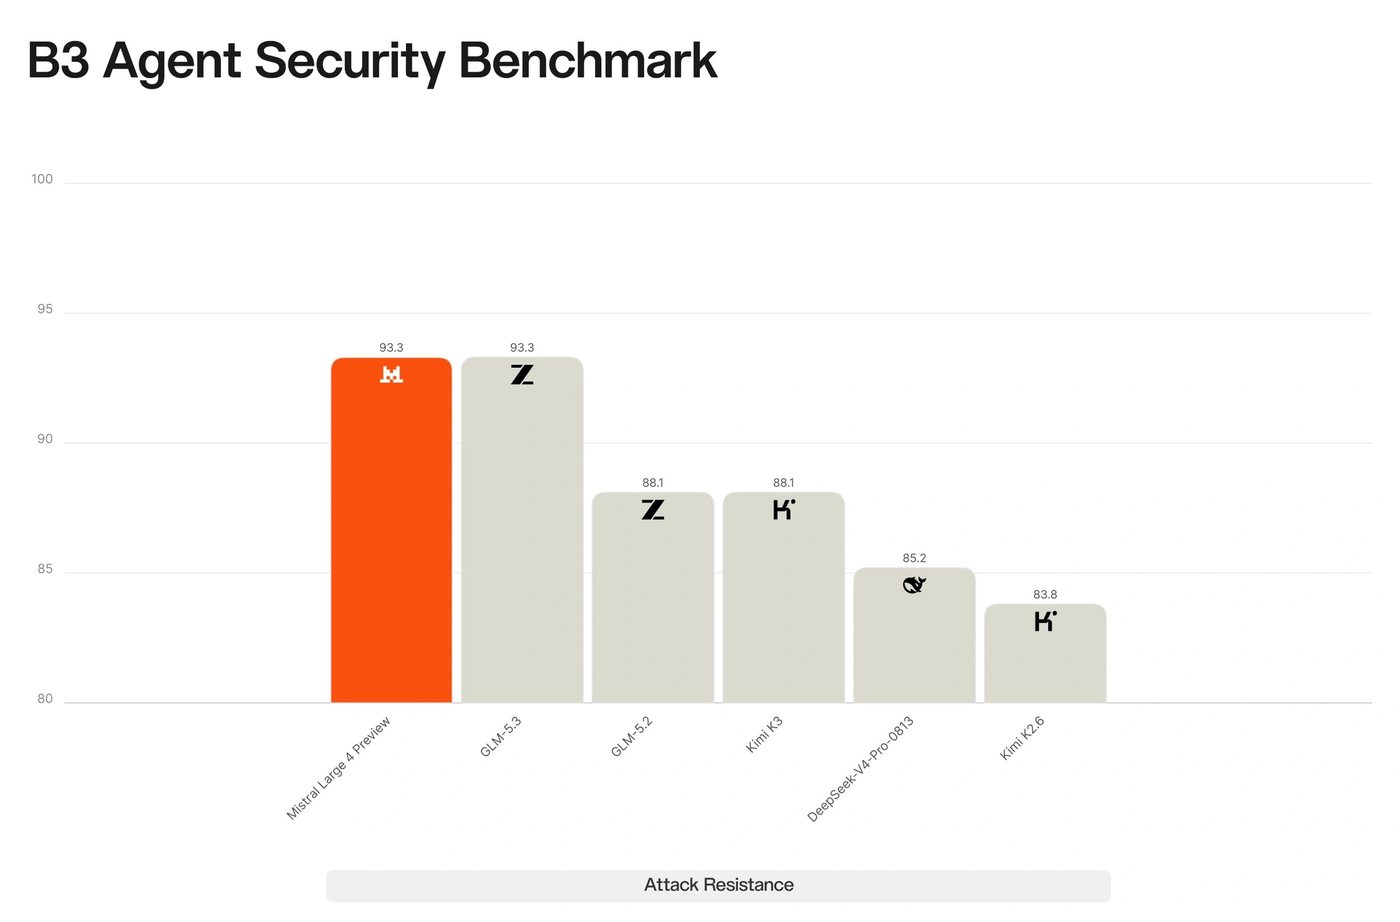
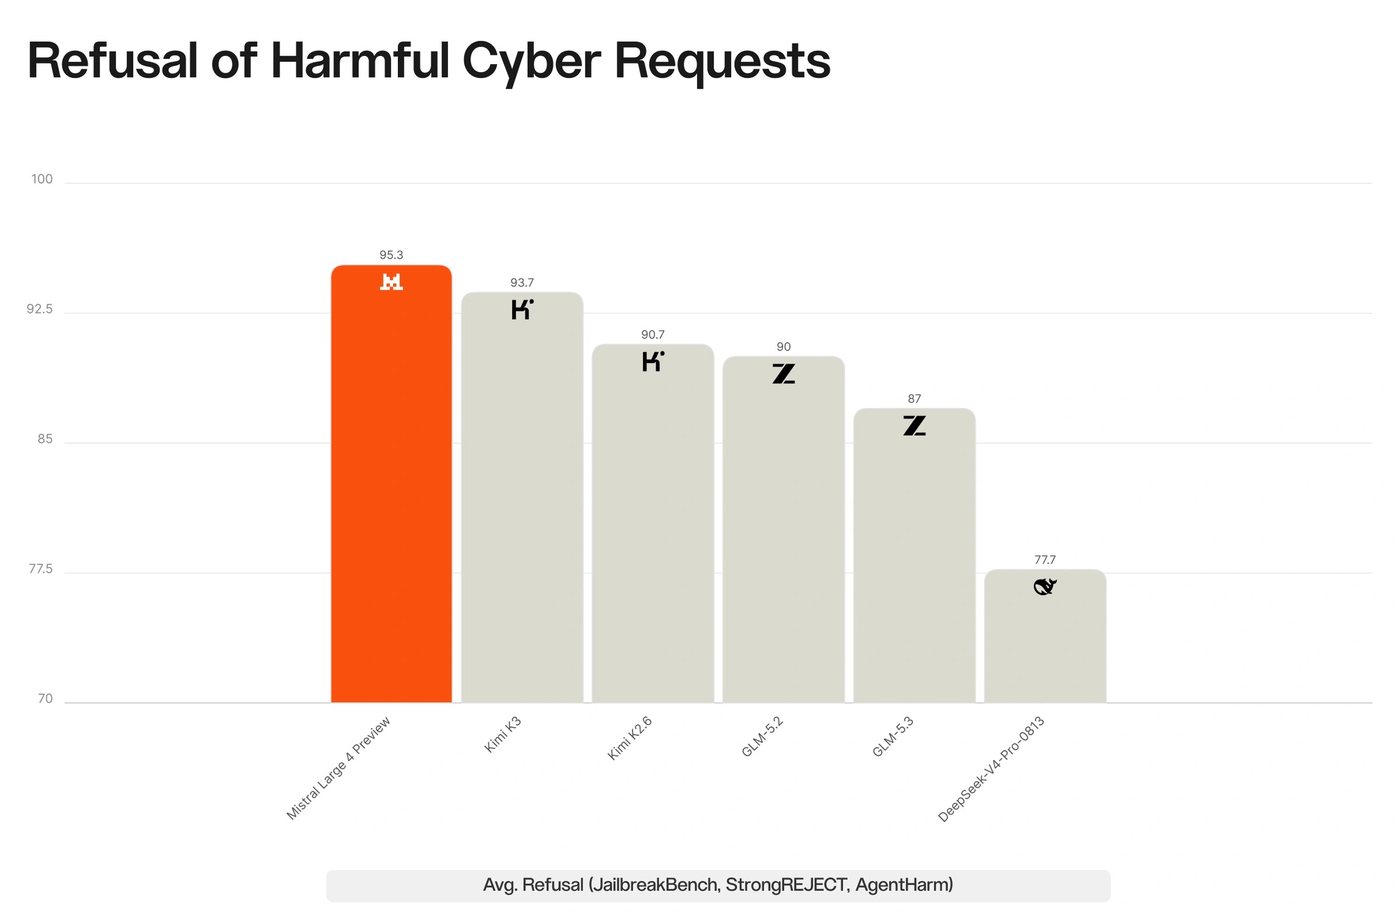
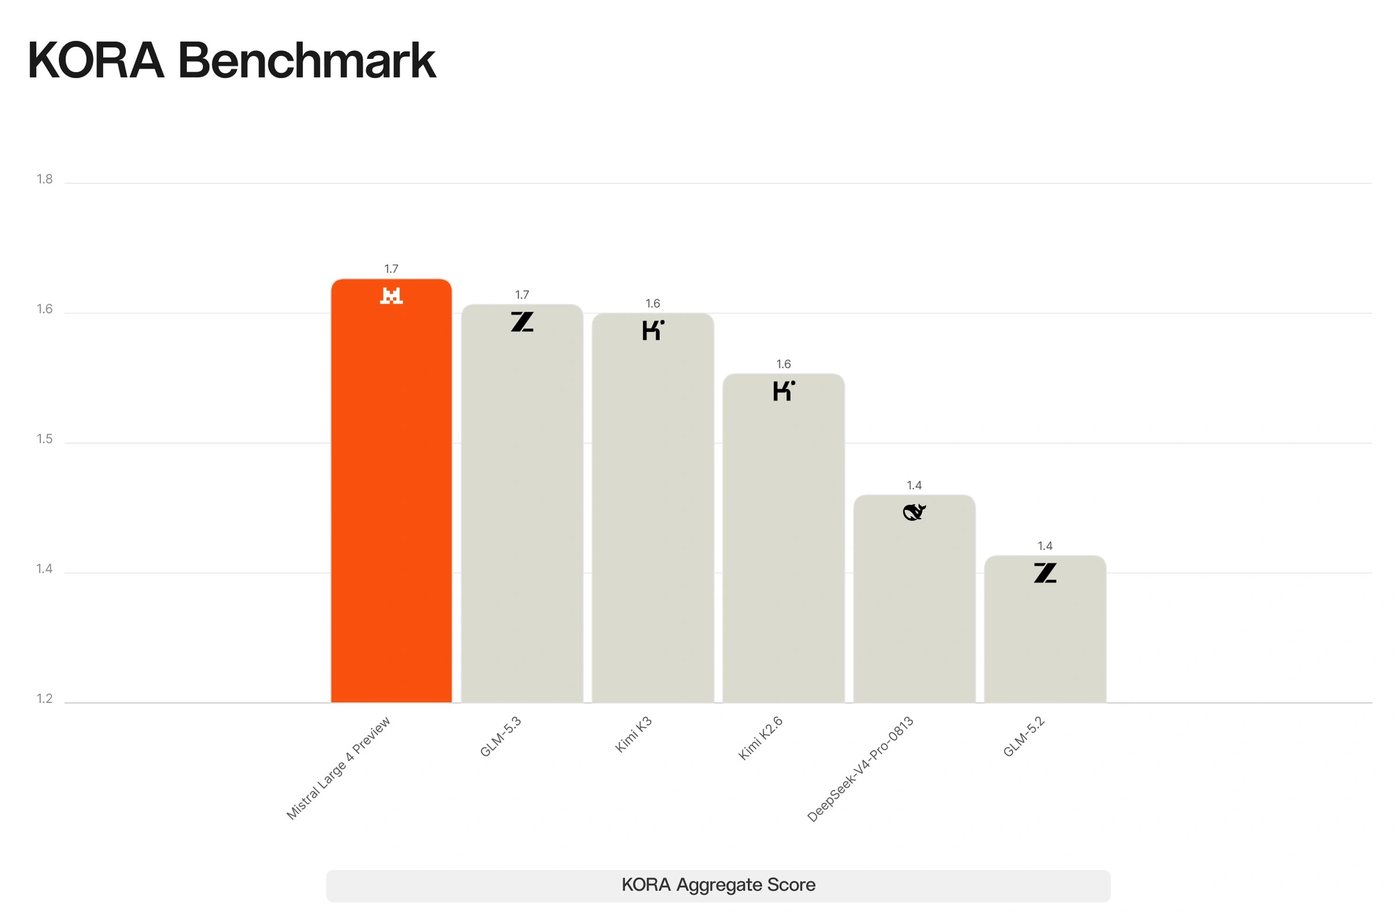
在安全上,ML4 在间接提示注入的鲁棒性上已经「打爆」了 Mistral 内部基准;在 Lakera 公开的 B3 AI 安全基准上,它抵御了 93.3% 的攻击,官方称在竞品中没有看到更高的分数。在与用户交互的责任性上,ML4 在 KORA 基准上取得该公司在开源模型中的最高分 1.691(满分 2,被描述为「典范」)。有意思的是,尽管在网络安全基准上表现强劲,ML4 对来自 JailbreakBench、StrongREJECT、AgentHarm 的恶意网络请求的平均拒绝率高于所有开源模型——「能做」与「该拒绝时拒绝」在这里被同时强调。
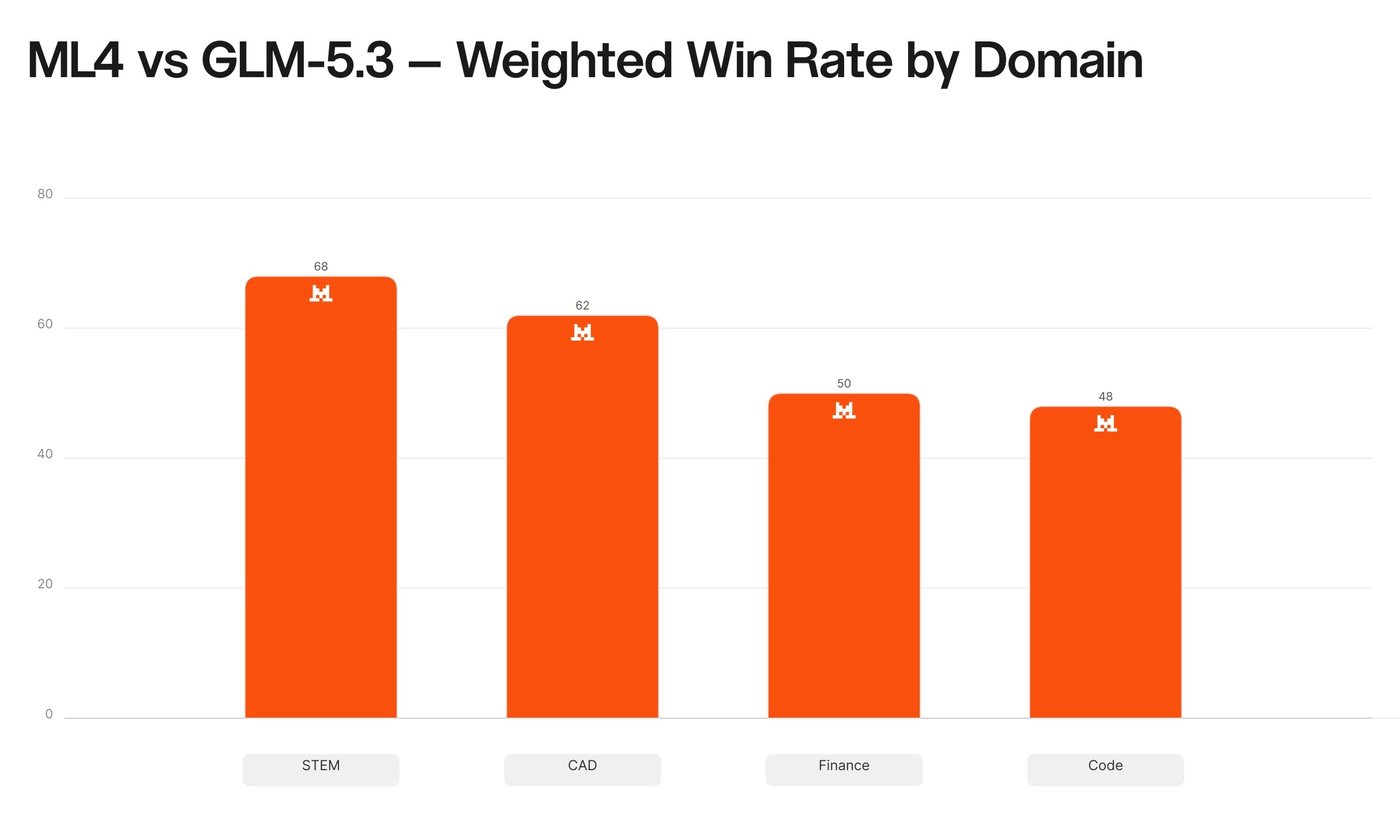
在内部人类评估中,跨编码、CAD、金融、数学与物理领域的专家标注员对比了 ML4 与 GLM-5.3:ML4 在 CAD 与 STEM 上被更偏好,在金融与编码上与 GLM-5.3 持平或接近。
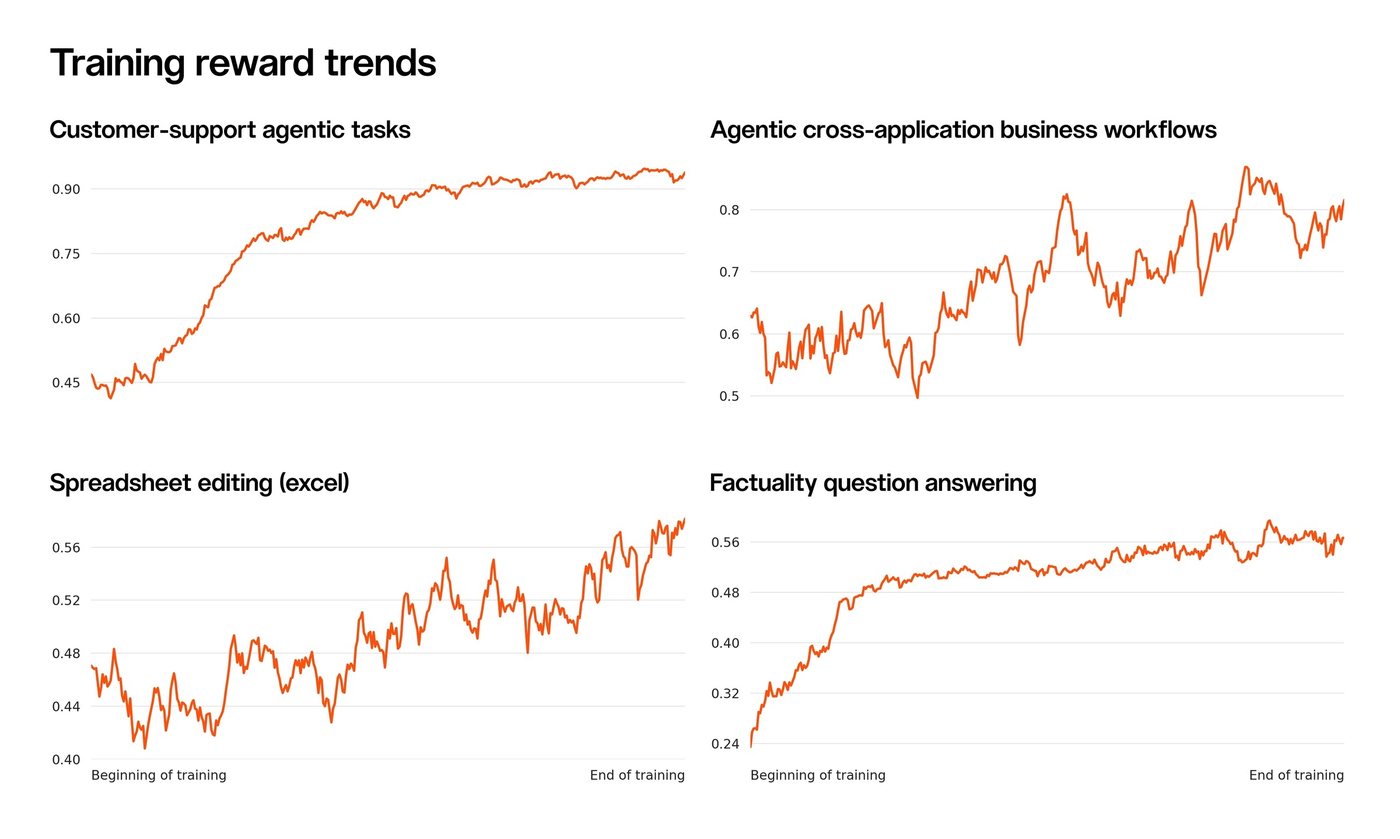
训练方法上,Mistral 强调后训练必须跟上基座模型变快的节奏:为昨天的模型调好的配方放到今天的模型上会「浪费能力」,因为曾经能推模型到极限的样本已不再困难。他们为此构建了可组合的强化学习库,让单次训练运行就能混合单轮对话、复杂科学问题求解、安全对齐、事实性与长周期工具使用等任务,并共享代码沙箱、网页搜索、外部 API 等资源;验证环节同样可组合,奖励模型、单元测试、LLM 裁判与静态检查按任务组合使用。
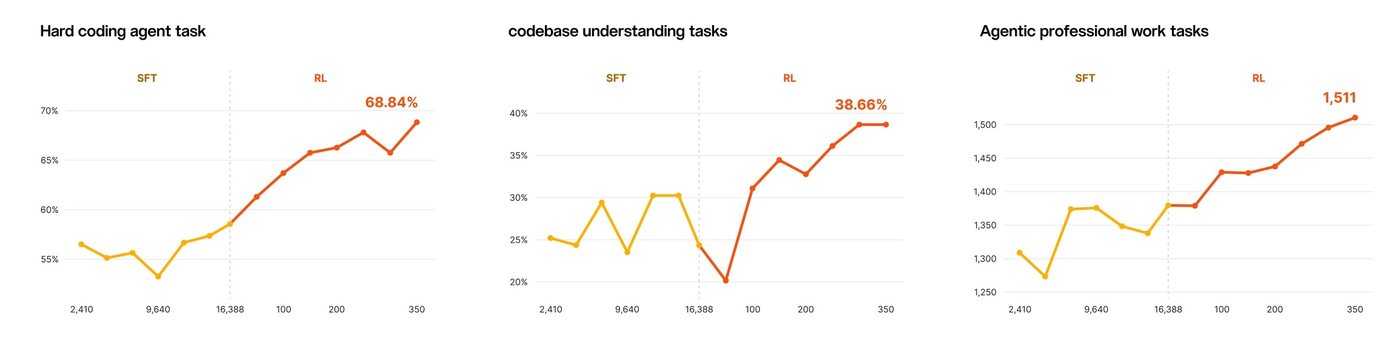
规模上,运行时由自动伸缩的 actor 集群并行生成数万条 rollout,训练异步进行;生成与训练管线针对长轨迹优化,支持跨多次压缩、数百万 token 的 rollout 预算而保持较低陈旧度。按当前的 3 千块 GPU 规模,单次训练每天产出约 330 亿 token,其中约 160 亿是过滤与掩码后可训练的补全 token。作者也展示了训练奖励曲线与 SFT/RL 两阶段的收益来源。
欧洲主权:从训练到部署都在自己的机房里
Mistral 在这篇发布里反复强调主权。ML4 是在欧洲、Mistral 自有数据中心内的 3800 块 NVIDIA Grace Blackwell GPU 上从零训练的,公开预览也跑在同一套基础设施上;模型将在全球多个区域提供,其中包括 Mistral 端到端自主运营、不受其他数字服务商影响并受欧洲法律约束的欧洲部署。训练数据中相当一部分是多语言的,覆盖 160 多种语言,包括欧盟所有官方语言。
Mistral 表示,训练 ML4 时与金融、工程、制造、物流、制药、科学、航运、公共部门等行业的企业紧密合作,模型使用的正是他们通过 Mistral Forge 提供给客户的同一套训练、定制与强化学习环境。
最后是路线图:ML4 是 30 亿欧元 D 轮融资(欧洲科技公司史上最大股权融资)所支持路线图上的第一个里程碑;资本正在用于扩大自有欧洲数据中心的算力。支撑这次预览的强化学习训练仍在进行中,模型「没有出现饱和迹象」,还有明显上升空间;权重将在月底开放,同时公布架构细节、更多基准与后训练方法。ML4 之后还会成为新一代专用与优化模型的基础。
核心总结
- 规格:1 万亿参数 / 490 亿激活的原生多模态 MoE,指令与推理一体;预览 API 已上线,权重月底开放;定价每百万输入 1.36 美元、输出 4.18 美元
- 编码与智能体:DeepSWE v1.1 61.7%、SWE-Atlas-QnA 59.4%、Terminal-Bench 4 28.3%,Coding Agent Index 49.8%;Surge 盲测人工评估 3.74 分,五模型中第二
- 网络安全:AA Cyber Index 进入全球前五,「复现并修复真实漏洞」82%(全场最高)、Cybench 93%;Claude Opus 5.5、GPT-6 Astra 因拒绝执行而接近零分
- 多模态与专业场景:Dense200 视觉定位 42% 略超 GPT-6 Astra 的 41%;Finch、Harvey 法律基准与 Finance Agent v2 表现领先开源模型
- 安全与责任:Lakera B3 抵御 93.3% 攻击,KORA 1.691;同时对恶意网络请求的拒绝率高于所有开源模型
- 主权与算力:在欧洲自有数据中心的 3800 块 Grace Blackwell 上从零训练,训练数据覆盖 160+ 语言;由 30 亿欧元 D 轮支持,RL 训练仍在继续、尚未饱和
原文:Introducing Mistral Large 4(Mistral,2026-10-06)


