10 月 23 日,Inferact 与 vLLM 团队发布博客《Serving DeepSeek-V4.1-Flash at Scale》,公布 vLLM 在 一个 NVIDIA GB300 NVL72 机柜上用 P/D 分离加 Wide-EP 服务 DeepSeek-V4.1-Flash 的实测:在 SemiAnalysis AgentX 智能体轨迹上达到单卡 954K tokens/s,P90 每用户 196 tokens/s,是其 10 月 7 日单机结果的 7.9 倍;按 DeepSeek 谷时电价折算为每 GPU 小时 38.96 美元。这里统计的吞吐包含命中前缀的输入、未命中输入与输出 token。
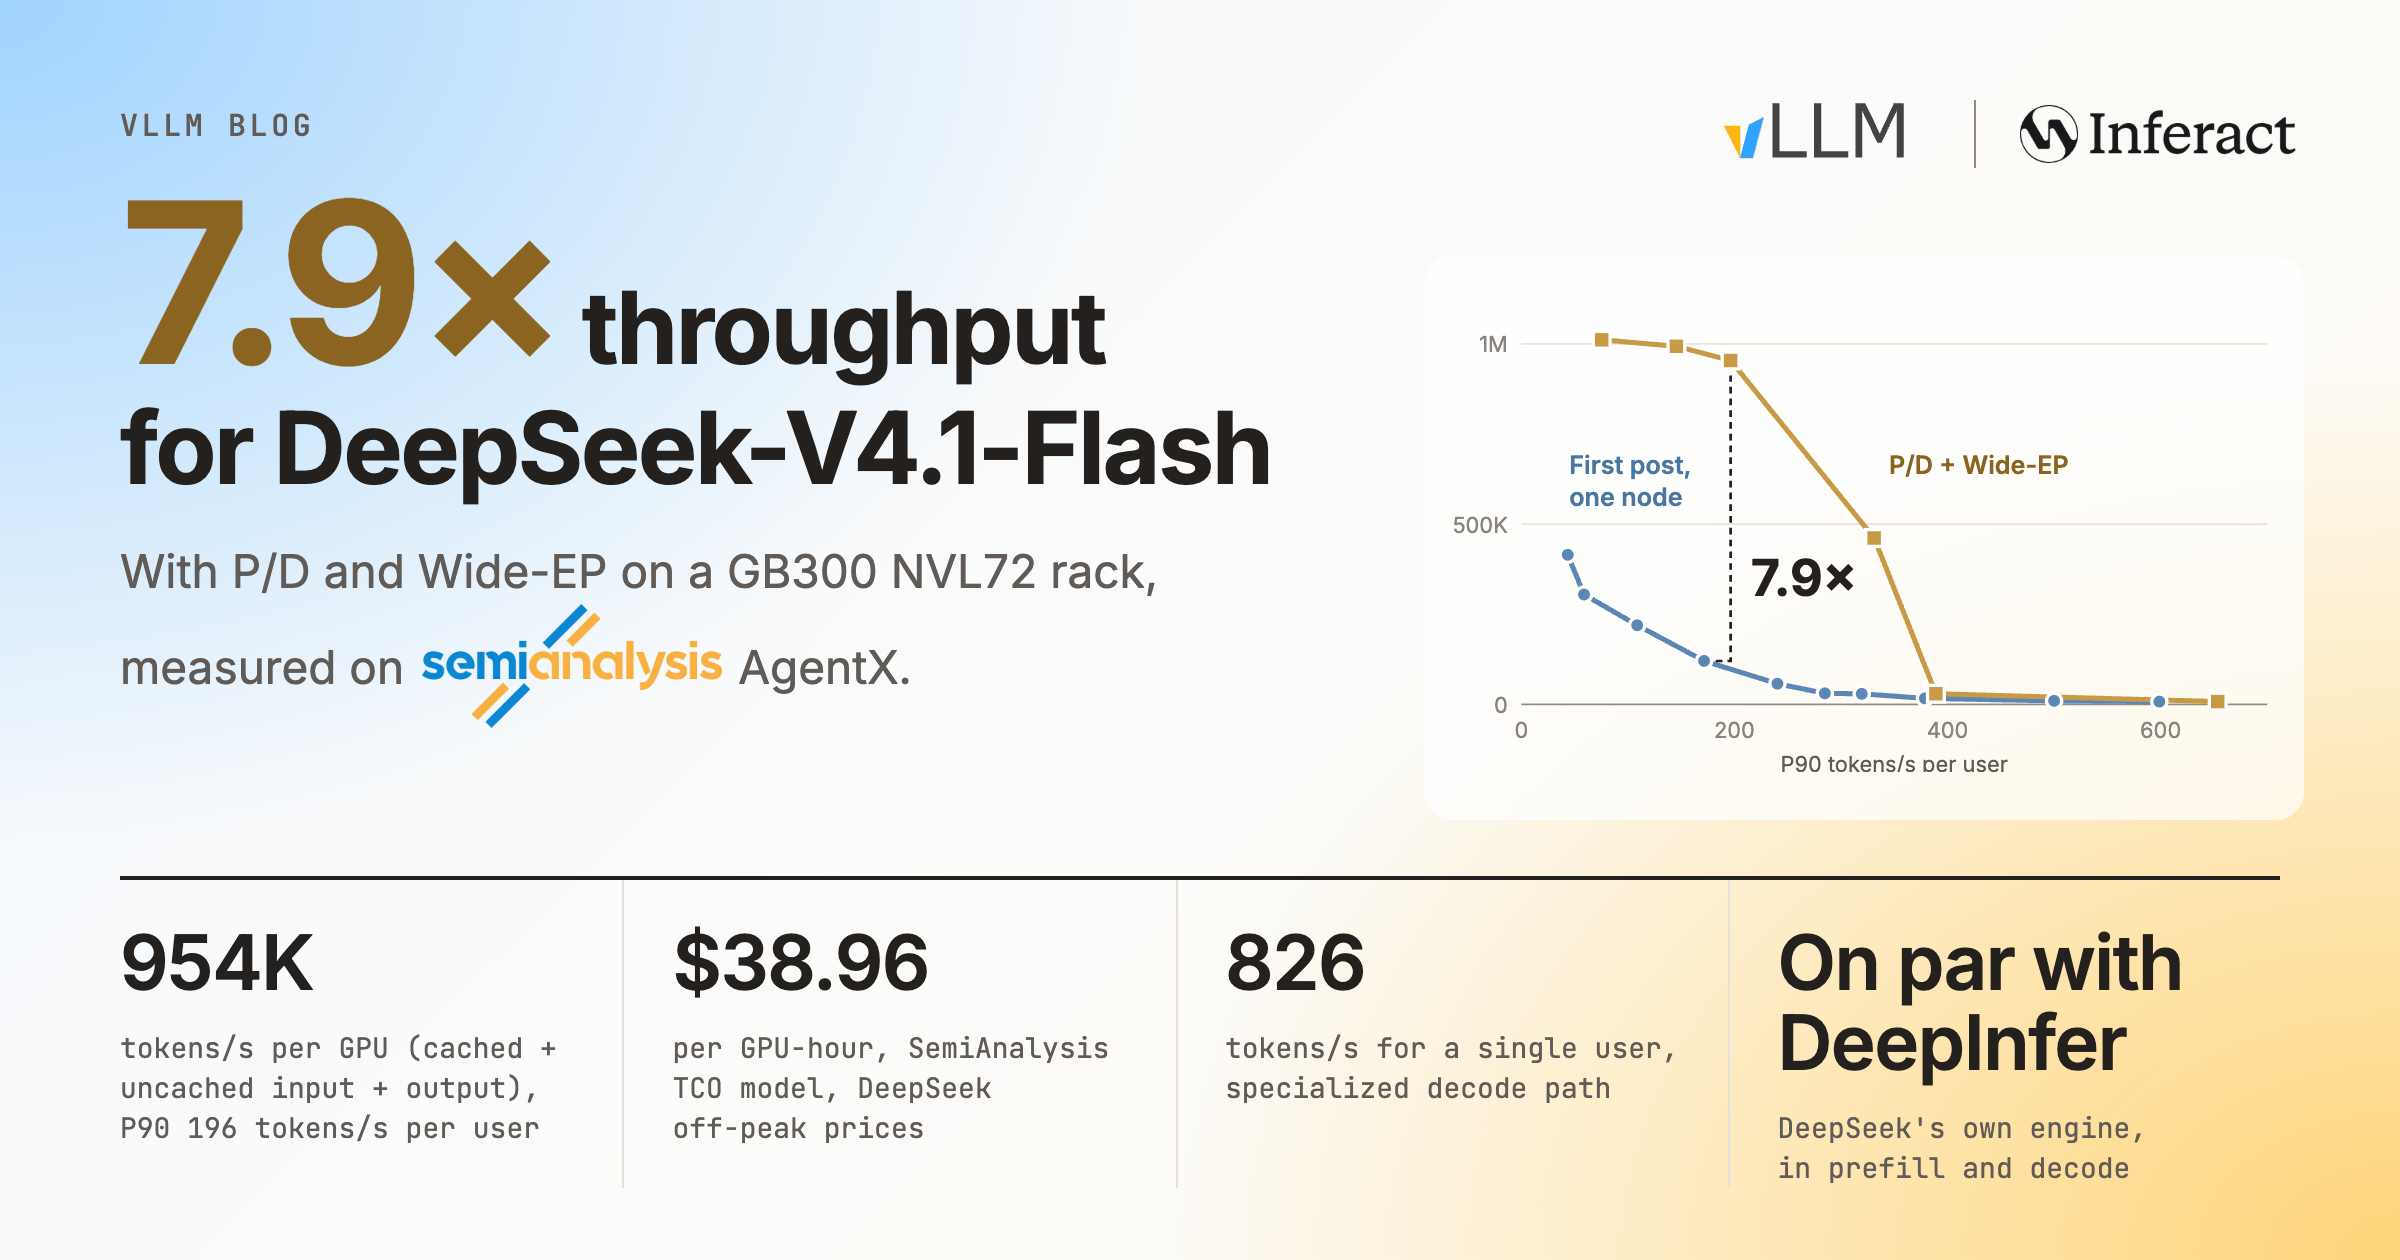
图 1:7.9 倍吞吐、954K tokens/s/卡、每 GPU 小时 38.96 美元、单用户 826 tokens/s(图源:vLLM / Inferact)。
博客的定位很直接:通用引擎能追平专用引擎。在 DeepSeek 自家 DeepInfer 的 decode 配置(131K 上下文、nextn=3)下,vLLM 于 GB200 上的吞吐在 batch 8 到 256 全区间与其公布结果相差 6% 以内;prefill 曲线则整体贴合 DeepInfer 公布的曲线。
血缘是双向的
DeepInfer 这周刚开源,是最贴近这个模型的参照。博客对此的解释是双向的:DeepInfer 最初基于 vLLM 构建,而 vLLM 一直在集成 DeepSeek 开源库里的内核(MegaAttn、MegaMoE、Mega-mHC),并围绕它们优化整条栈。
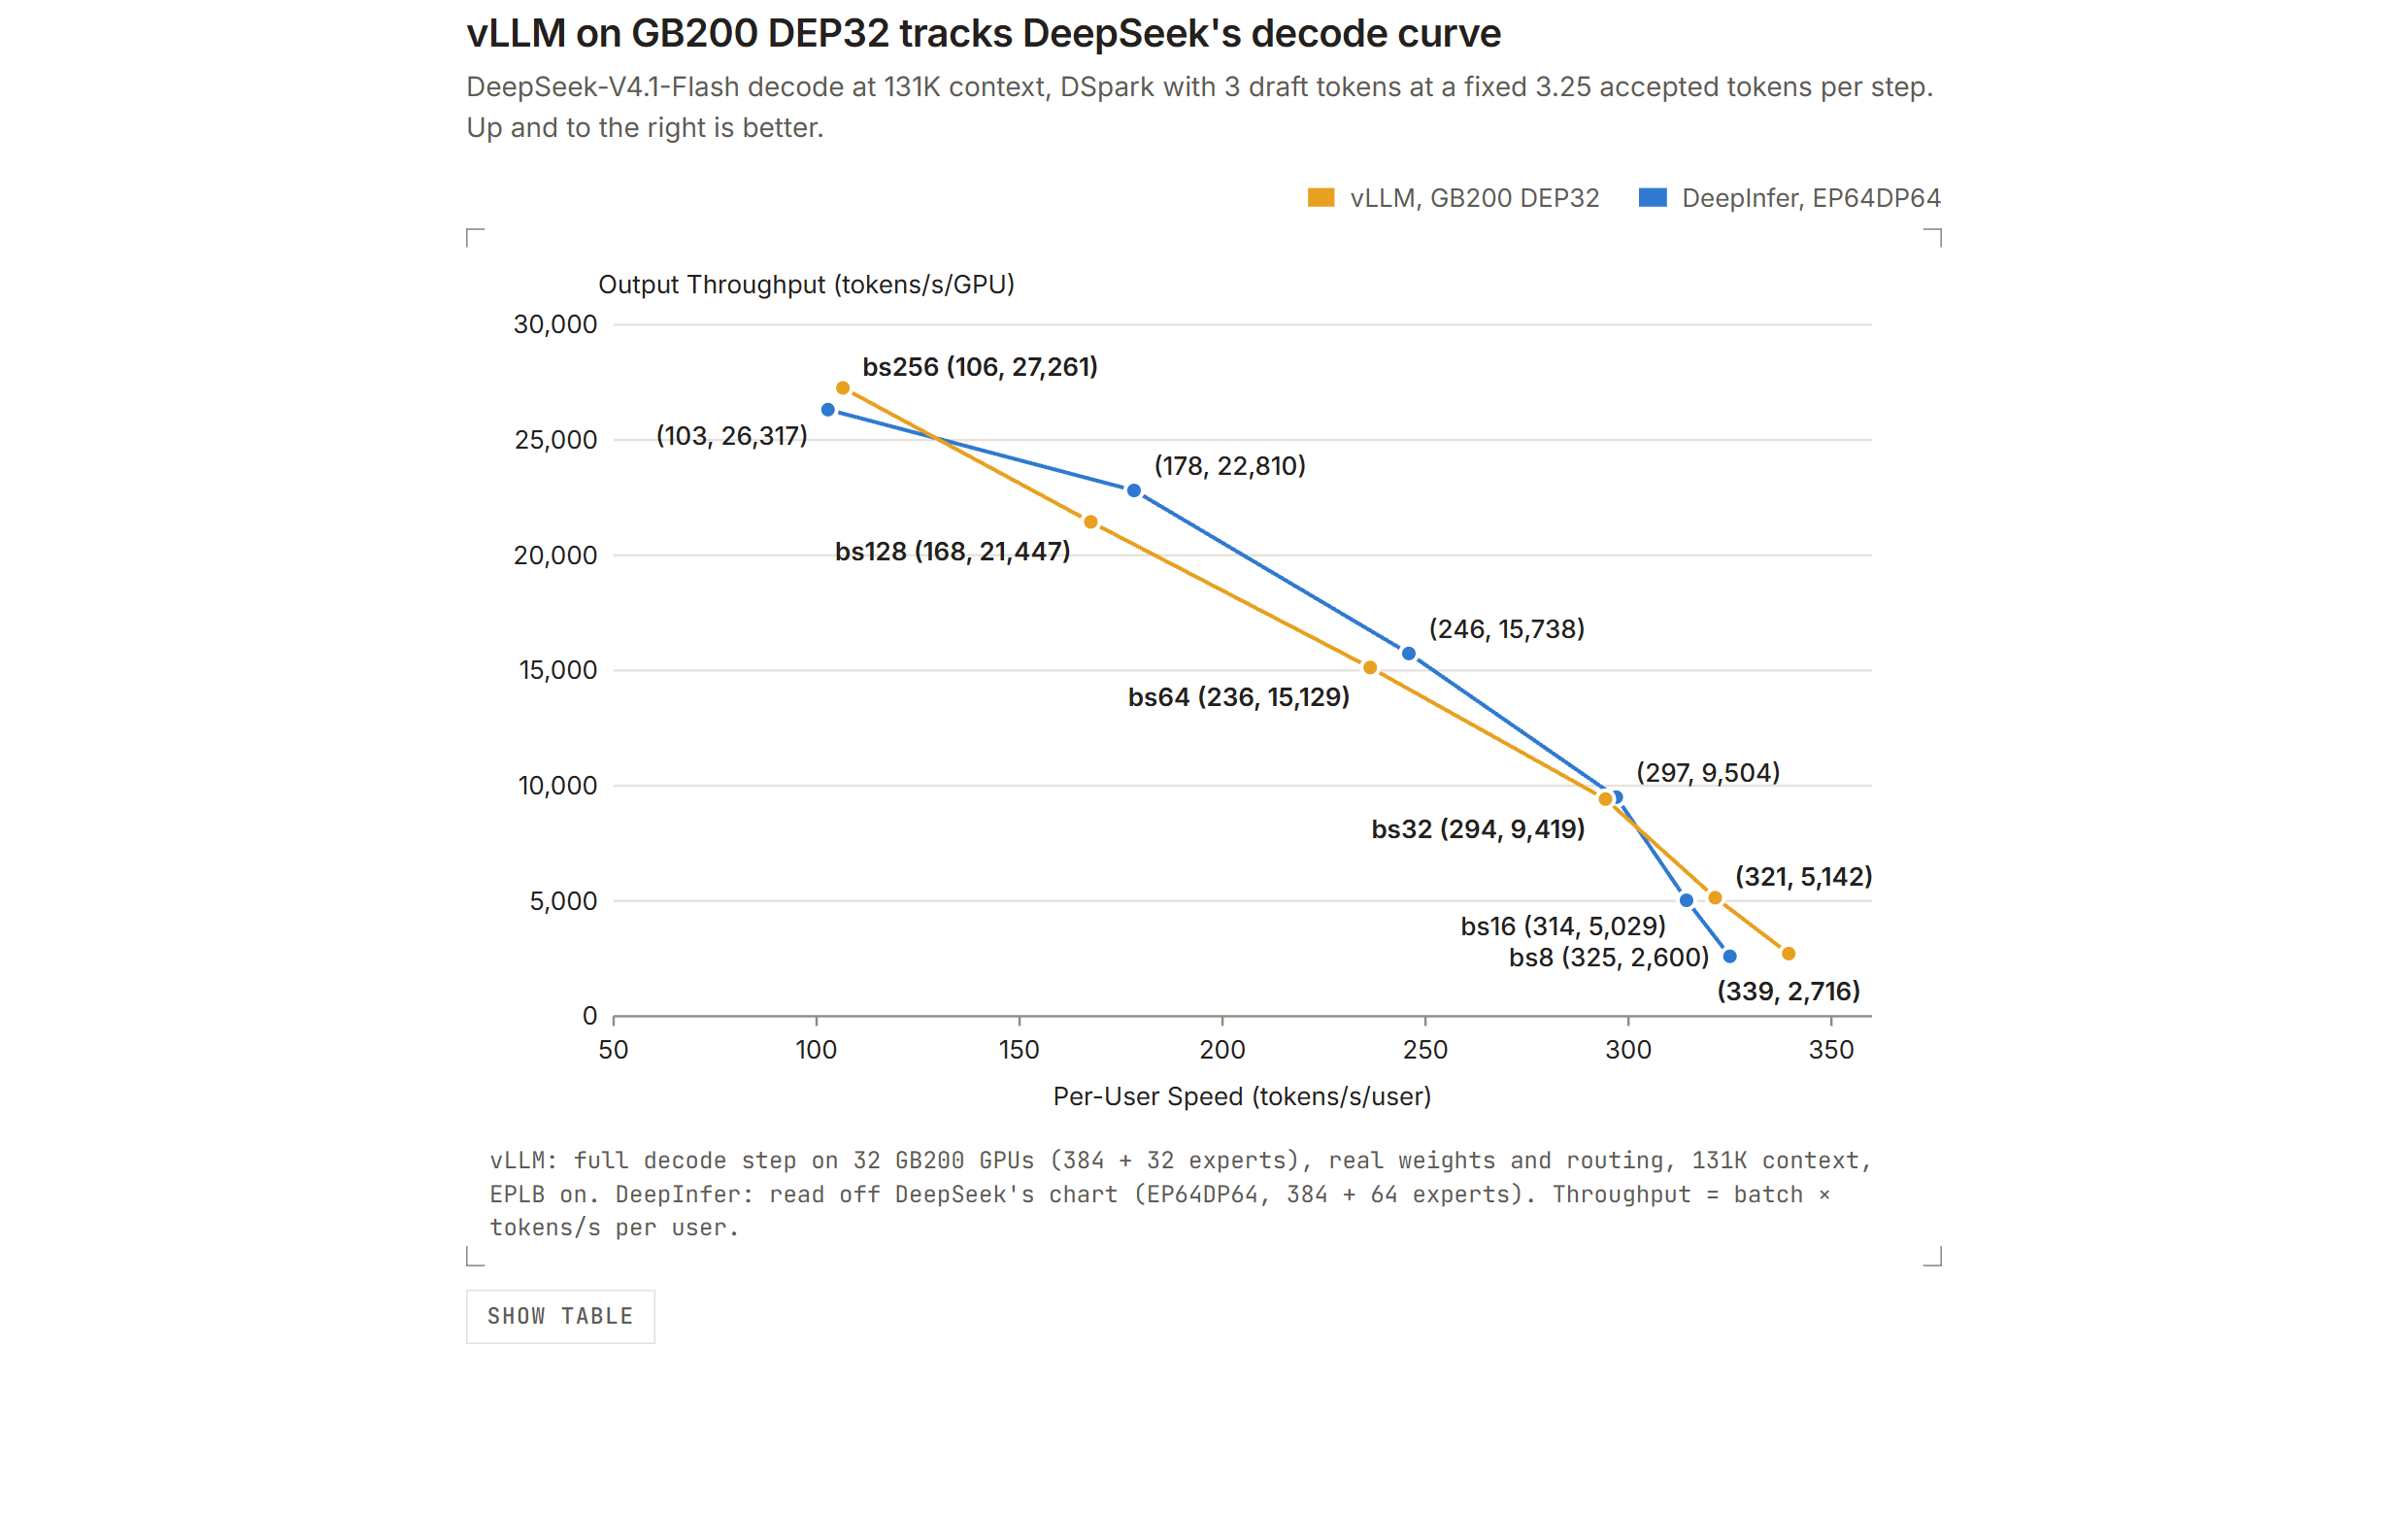
图 2:131K 上下文、3 个草稿 token、每步固定接受 3.25 个 token 下,vLLM(GB200 DEP32)与 DeepInfer(EP64DP64,从原文图表读数)的 decode 曲线(图源:vLLM)。
prefill 一侧博客主动交代了口径差异,拒绝把两条曲线的间距当作引擎间加速比:DeepInfer 的曲线是 EP4DP4、32 个冗余专家、140 token 有界重放,且图中未注明硬件、数值从图上读取;vLLM 这边是 GB300 上的 DEP2、无冗余专家、128 token 重放,prompt 也是自己的。两者只能说明「贴合」,不能说明「更快」。
另一个差别是边界:DeepInfer 是单模型的离线引擎,而同一套 vLLM 构建既能离线跑,也能在线做 P/D 分离、跨整机柜 Wide-EP 服务——后面全部数据测的都是后者。
先测模型,再调优
优化之前,团队先量化了 V4.1-Flash 的架构特性,这几条决定了后面所有取舍:
- KV 极小:全局 KV 每 token 仅 890 字节,来自跨层 KV 共享与 FP4 压缩。
- 注意力很轻:第 2、8、14 层用 2 倍压缩做全上下文索引;有界重放下第 20 层为所有 token 写全局 KV、但索引与注意力只跑最后 128 个,第 21–39 层只处理这 128 个。
- 长上下文下 decode 仍被 MoE 支配:DEP4、128K 上下文、每 rank 64 请求时,MoE 占目标模型单步的 62%,注意力与 indexer 合计只有 13%。
- 上下文长度几乎不影响 decode 步长:
| 每请求上下文 | 64K | 128K | 256K | 512K | 855K |
|---|---|---|---|---|---|
| 目标模型 forward(ms) | 8.86 | 8.93 | 9.03 | 9.25 | 9.53 |
| 相对 128K | −0.8% | – | +1.1% | +3.6% | +6.7% |
GB300、DEP32、每 rank 16 请求下,上下文从 128K 涨到 855K(6.7 倍)只让 forward 多花 0.6 ms。于是:prefill 用小 DEP 实例、KV 容量基本不构成 batch 上限、decode 用 Wide-EP 直接削减权重读取、DP 负载均衡退化为「按请求数取最闲的 rank」,合成负载就足以代表真实轨迹。
测量方法本身也值得记一笔:vllm bench forward 只测 GPU 侧 forward,DecodeBenchConnector 测引擎端到端,两者差值即为开销;prefill 的 DP 失衡用「镜像 / 滞后」两次回放隔离——每个 rank 收到同样的请求,滞后组里 rank r 晚 r×5 秒,两次之差就是失衡代价;decode 的 EP 失衡则以「token 均匀随机路由」为平衡基准(该基准自身仍有采样噪声,DEP32、每 GPU 72 请求下均匀路由的均衡度约为 target 0.96、draft 0.94),真实路由与它的差距就是专家均衡最多能挽回的空间。
Prefill:DEP2 最划算
AgentX prefill-only、并发 256 下,DEP4 的单卡吞吐只有 DEP2 的 83%(53.3K 对 64.4K tokens/s)。关闭前缀缓存做镜像/滞后回放,指向的正是 DP 失衡:
| 单实例 prefill 吞吐 | 镜像(均衡) | 滞后(失衡) | 损失 |
|---|---|---|---|
| DEP2 | 138.7K | 130.5K | 5.9% |
| DEP4 | 267.6K | 231.1K | 13.6% |
在两块 GB300 上,一个 8K token 的 prefill 无上下文时 87.9 ms、带 512K 缓存上下文时要 189.4 ms——随上下文增长的开销藏在轨迹里。三项修复:
- 把 SWA 有界重放推到第 20 层(#59894):该层为新 token 全量写 KV、其余计算只跑 128 token 重放批,32K 新 token 时 +19.9%(4K 时 +10.1%,64K 时 +23.1%)。
- 共享 Engram 主机表改用 2 MB 页(#62359):原
/dev/shm映射用 64 KB GPU 页,随机读频繁引发 TLB miss,换到 host-NUMA cuMem 后再 +2.8%。 - prefill indexer 改用 DeepSelect top-k(#62240):与 decode 路径对齐,32K 时再 +15.6%。
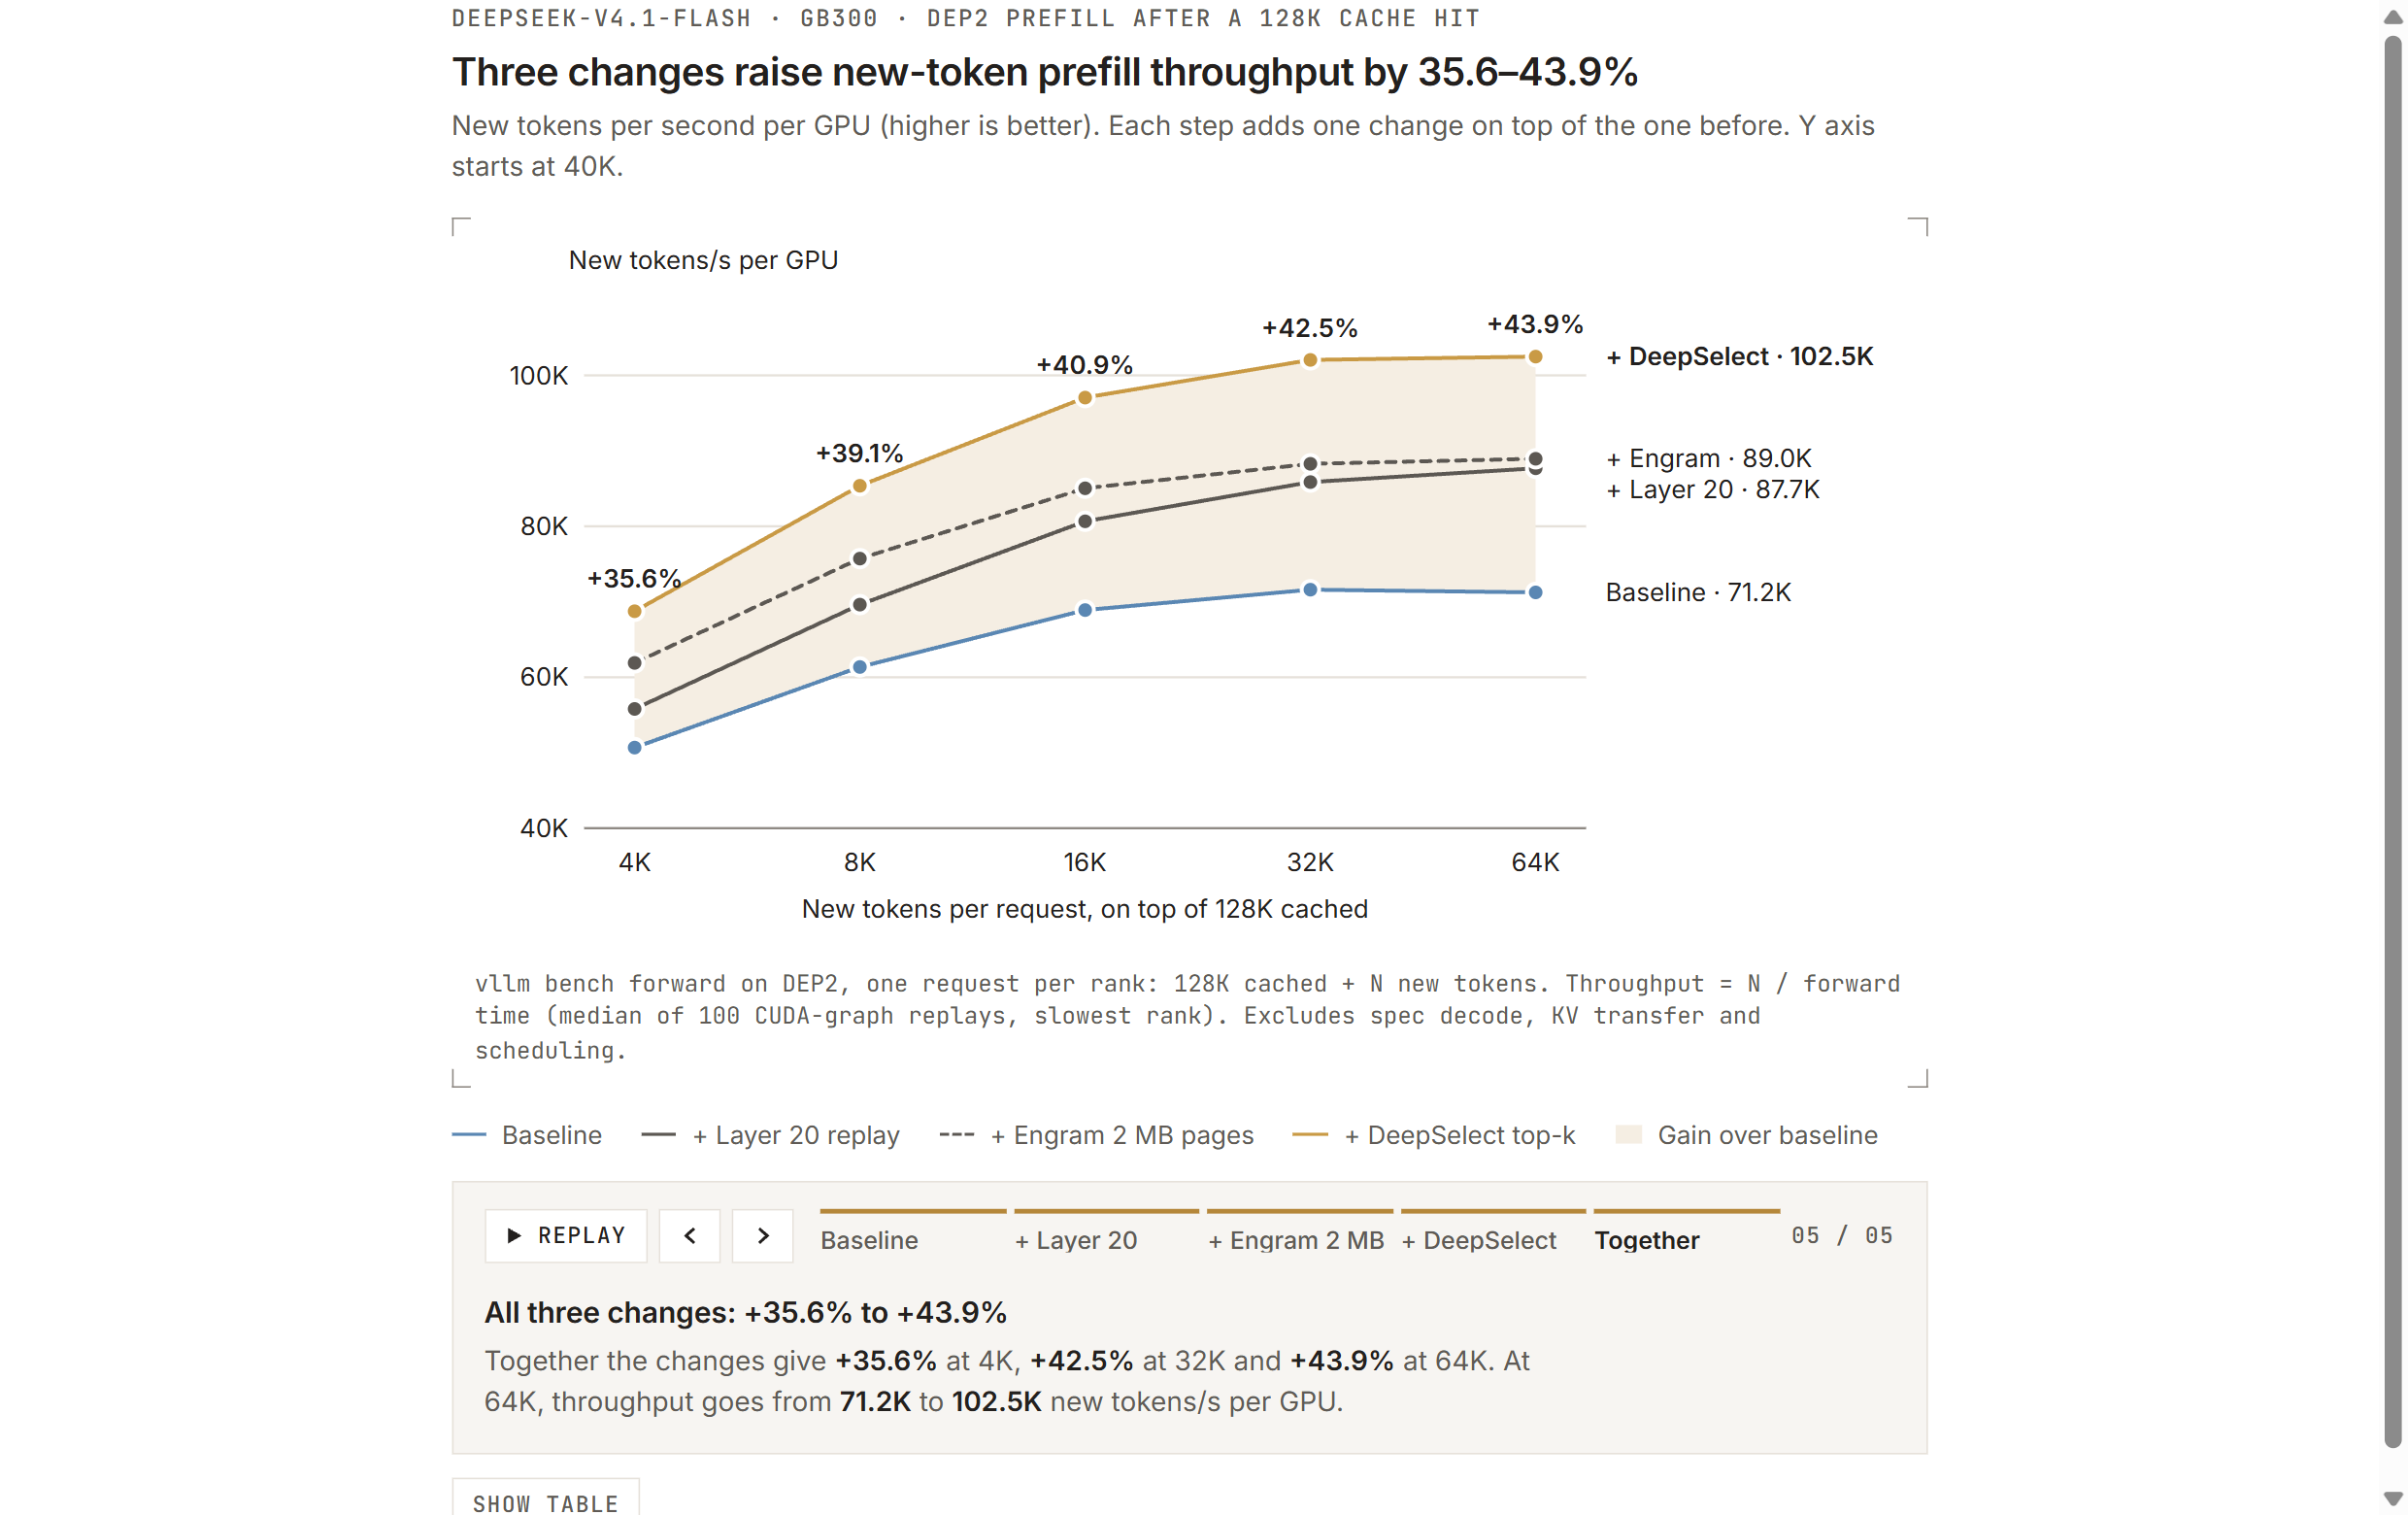
图 3:128K 缓存命中后的 DEP2 prefill,三项优化逐级叠加,64K 新 token 从 71.2K 提到 102.5K tokens/s/GPU(图源:vLLM)。
三项叠加,在 4K–64K 新 token 范围内把新 token prefill 吞吐提高 35.6%–43.9%:32K 时 +42.5%,64K 时从 71.2K 升到 102.5K tokens/s/GPU(+43.9%)。
Decode:Wide-EP 的边际与 EPLB
DEP4 到 DEP32 的扩展(GB200、每卡 64 请求、128K 上下文、开 EPLB)显示:只有 MoE 部分在变短——目标模型 MegaMoE 从 13.4 ms 降到 6.0 ms,其余工作稳定在约 10 ms,因此单卡吞吐收益递减(9,385 → 11,445 → 12,915 → 13,274 tokens/s,DEP32 只比 DEP16 高 3%),且到 DEP32 时草稿模型的通信开销开始抵消更宽并行的收益。
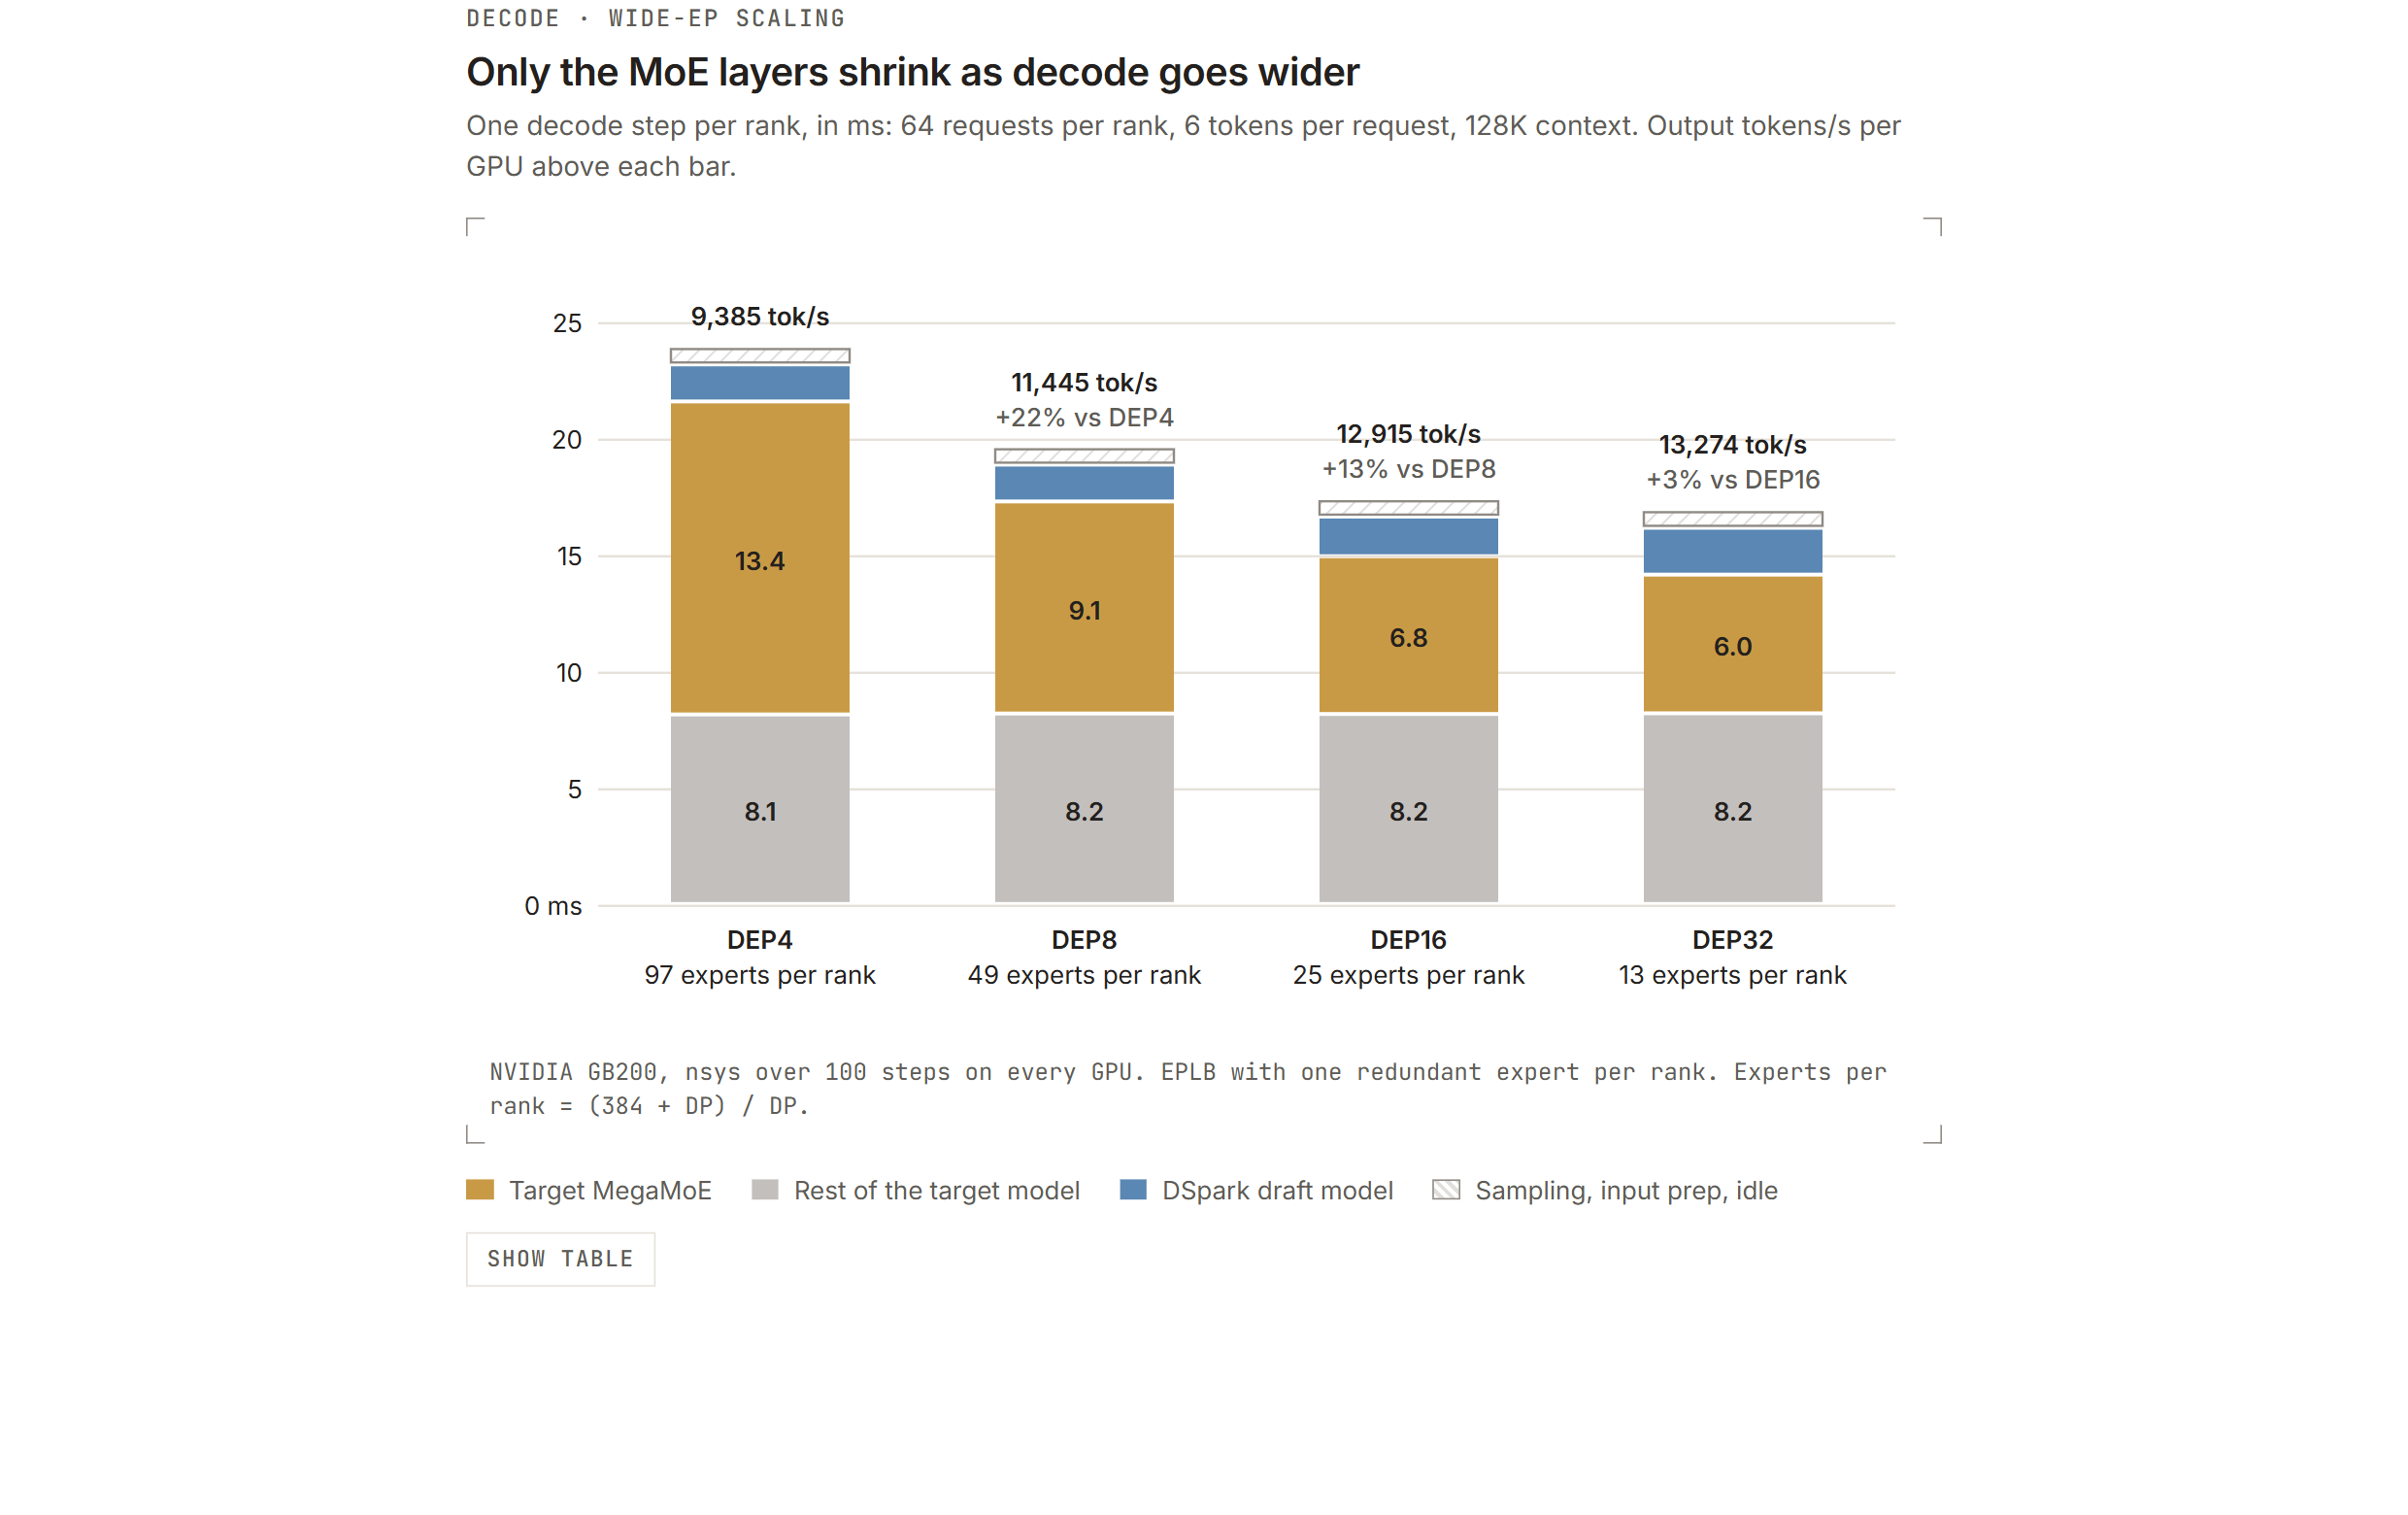
图 4:每 rank 单步时间分解,目标 MegaMoE(土黄)随并行变宽收缩,其余部分(灰)几乎不动(图源:vLLM)。
EPLB 每 3,000 步据前 1,000 步的负载重排专家,把均衡度从 0.35 提到 0.94(target)与 0.21 提到 0.89(draft),分别挽回了与均匀路由差距的约 97% 与 93%。两个 PR 支撑这一点:#62009 引入基于 NVLink 的 symm_mem 后端,不到 1 秒即可重排整个 DEP32 且不中断 decode,并把副本映射与负载记录融进 MegaMoE 内核(每步省约 0.2 ms)、去掉 decode 循环里的主机同步;#61395 让 EPLB 同时处理异构的目标模型与草稿模型——DSpark 草稿是 128 个路由专家、top-3,目标是 384 个、top-6,两者分别跟踪与重排。
机柜规模上,CPU 开销成为主要矛盾
Wide-EP 每层都要同步所有 rank,一个慢 rank 就拖住整个实例。异步调度在小规模有效,但 rank 越多 GPU 步越短、CPU 余量越小。实测中未优化的 DEP32 反而比 DEP16 慢(17.57 对 13.84 ms/步),尽管其 GPU 执行快 1.1 ms。博客列出的四条原因与效果:
| 原因 | 修复 | 效果 |
|---|---|---|
| KV 读在 decode worker 线程上同步发起 | NIXL push + UCX 散列聚合,打包 KV 行作为单个 NIXL region | 单卡 141K → 440K tokens/s,P90 每用户约 40 → 159(GB300、8P1D、并发 3,072) |
| Gloo all-reduce 延迟随 rank 数线性增长 | 递归倍增(recursive-doubling)CPU all-reduce(#61767) | DP 同步 10.8 → 1.5 ms/步,单步 16.10 → 13.15 ms |
| 接纳突发:一步内最多放进 140 条请求 | 每步最多加载 4 个新 KV(#61725,可选) | 单卡 460K → 516K tokens/s,P90 109 → 153 |
| 接纳开销随 prompt 长度增长 | prompt 收成单个 int32 缓冲、跳过滑动窗口块表空块、分块拷贝内核 | 855K prompt 的接纳 CPU 耗时 38.8 → 6.0 ms |
低延迟:单用户 826 tokens/s
小 batch 一侧,vLLM 把此前用于 Kimi K3 的低时延内核路线延伸到 V4.1-Flash(#61868、#61869)。在 4 块 B300、TP4 的真实 AgentX 会话上,专用 decode 路径单用户 P90 达到 826 tokens/s,比标准路径的 575 高 44%。
核心总结
- 规模:单个 GB300 NVL72 机柜、P/D 分离 + Wide-EP,AgentX 上单卡 954K tokens/s、P90 每用户 196 tokens/s,为单机结果的 7.9 倍,折合每 GPU 小时 38.96 美元
- 与 DeepInfer 的关系:decode 在 batch 8–256 全区间差距 6% 以内、prefill 曲线贴合;DeepInfer 基于 vLLM 构建,vLLM 也在持续集成 DeepSeek 内核,双方口径差异(EP4DP4 对 DEP2、140 对 128 token 重放)被明确写明
- 先测模型:全局 KV 每 token 890 字节;上下文从 128K 涨到 855K 只让 decode forward 多 0.6 ms;长上下文下 decode 仍由 MoE 占 62%
- prefill:DEP4 单卡吞吐只有 DEP2 的 83%,失衡代价 13.6% 对 5.9%;第 20 层有界重放、Engram 2 MB 页、DeepSelect top-k 三项叠加把新 token 吞吐提高 35.6%–43.9%
- decode:Wide-EP 收益递减(DEP32 仅比 DEP16 高 3%),EPLB 把均衡度提到 0.94 / 0.89,靠 NVLink
symm_mem后端不停机重排 - CPU 开销:未优化的 DEP32 比 DEP16 还慢;NIXL push、递归倍增 all-reduce、接纳限流与 prompt 拷贝优化把单卡吞吐从 141K 推到 440K–516K tokens/s
- 低延迟:4× B300 上专用 decode 路径单用户 P90 826 tokens/s,比标准路径高 44%
原文:Serving DeepSeek-V4.1-Flash at Scale: vLLM Matches DeepInfer and Scales to GB300 NVL72(vLLM Blog,2026-10-23)
参考:
- DeepInfer(DeepSeek-AI,Apache 2.0)
- DeepSeek-V4.1-Flash 技术报告(arXiv)
- DeepSeek-V4.1-Flash 首篇优化博客(vLLM Blog,2026-10-07)
- AgentX 上的 V4.1-Flash 曲线(SemiAnalysis InferenceX)(SemiAnalysis)


