10 月 16 日,AMD 与 Embedded LLM 在 vLLM 博客联合发文,复盘 Kimi K3 在 AMD Instinct MI355X 上的推理优化工程。结论是一组对比数字:在 SemiAnalysis 的 AgentX 智能体基准上、50 tokens/s/user 的 P90 交互性约束下,八卡 MI355X 系统交付 7,567 总 tokens/s/GPU,NVIDIA HGX B300 为 6,083,单卡吞吐高出 24.4%;按 SemiAnalysis 的成本模型(每 GPU 小时 1.50 美元对 2.26 美元),折算为每美元 1,816 万对 969 万总 token,即每美元 token 多 87.4%。
需要留意的是,这是完整服务栈之间的对比。文章逐项引用的性能数字来自各自独立的实验,用于解释单项机制,而非直接叠加成上面的结果。
AgentX:负载与结果
AgentX 用真实编码智能体会话轨迹重放,只替换 token 本身,保留请求长度、时序与前缀共享模式。该负载在缓存无限时理论前缀复用率超过 96%,投机解码则使用固定的合成接受率参考。
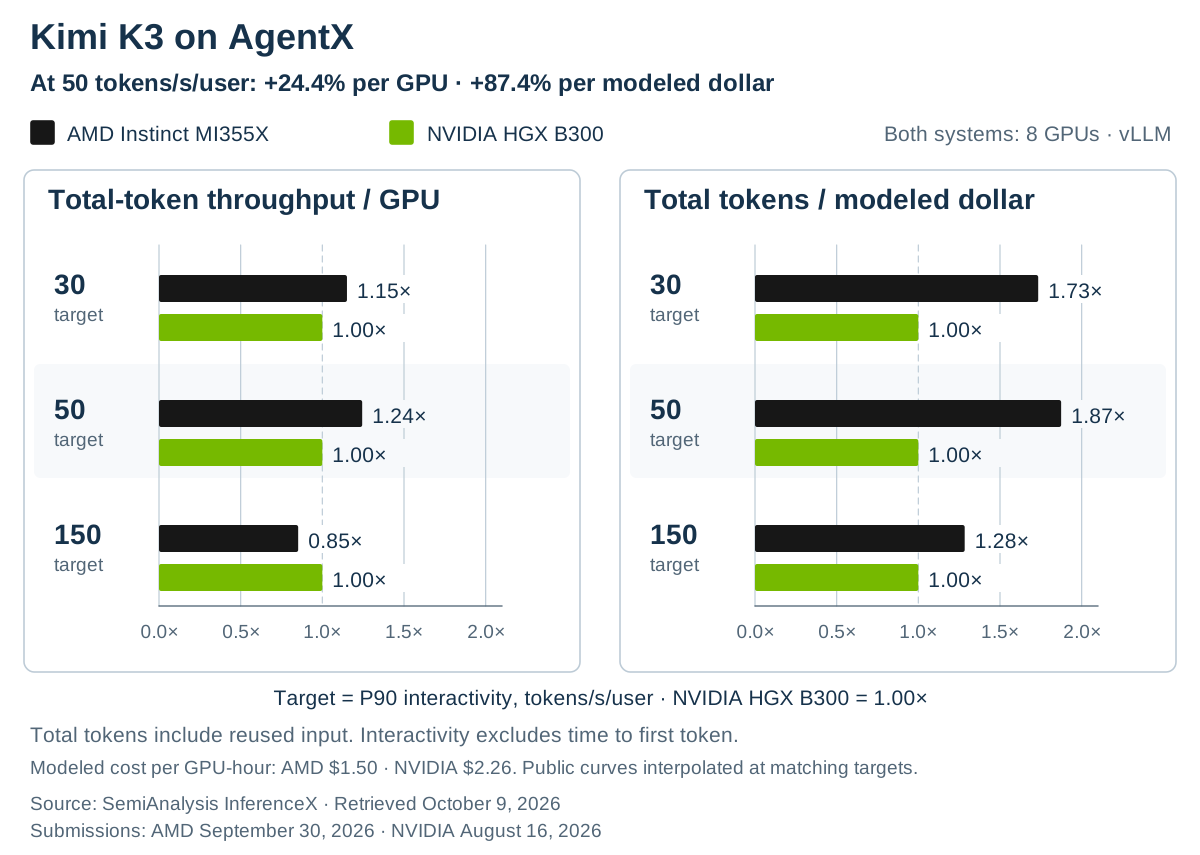
图 1:三档交互性下的吞吐与建模每美元 token 数,黑色为 AMD Instinct MI355X,绿色为 NVIDIA HGX B300。
| 单卡公开规格 | AMD Instinct MI355X | NVIDIA B300 |
|---|---|---|
| 低精度稠密矩阵峰值 | 10.1 PFLOP/s(MXFP4) | 13.5 PFLOP/s(FP4) |
| 显存 | 288 GB HBM3E | 288 GB HBM3E |
| 显存带宽峰值 | 8 TB/s | 8 TB/s |
两者显存容量与带宽持平,B300 的标称矩阵算力还高出约三成。也就是说,这 24.4% 的吞吐优势并非来自纸面参数,而是软件工程的结果——文章称这项 Kimi K3 工作涉及 50 个以上已合并的 AMD/ROCm 相关 vLLM PR,另有 AITER 的持续开发与集成。
原文附带的公开曲线同下方标注了 50 tokens/s/user 这一目标点。基准快照取自 2026 年 10 月 9 日的 SemiAnalysis InferenceX,AMD 提交日期为 9 月 30 日,NVIDIA 为 8 月 16 日;两边分别固定 vLLM 提交 36768d1bf 与 5894fdf98。
Kimi K3 为什么难跑:两类注意力加一屋子专家
一次回归的智能体轮次可以复用大部分前缀,但处理那截短的续写仍会触碰三类数据。
Kimi K3 有两类注意力:24 层 MLA 保留随对话增长的压缩 KV 历史,新查询需要回看整段历史;69 层 KDA 则携带固定维度的状态矩阵,随新 token 递推更新。MoE 层里,路由器为每个 token 挑选专家网络做变换,专家权重在所有请求间共享。Kimi K3 每 token 从 896 个专家中选 16 个。
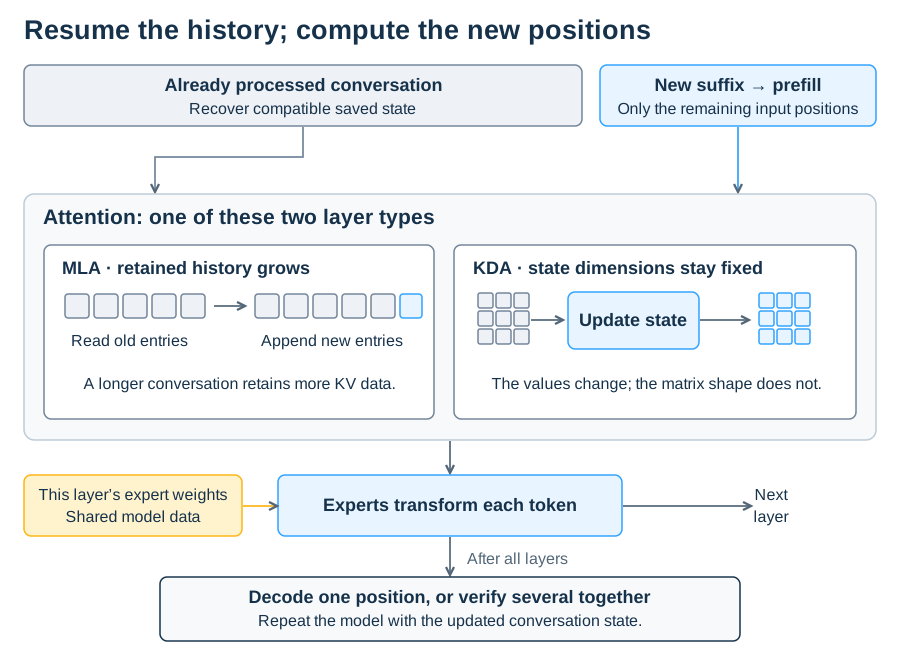
图 2:请求流程——恢复状态、处理新后缀、解码或验证。
于是优化被拆成三条线索:跨轮次看缓存复用与卸载,单步内看专家投影、内核交接与 MLA/KDA 调度,最后再决定投机解码该起草多少个 token。
一、缓存:让对话状态留在可复用的地方
TP8 下每张 GPU 只承担 96 个 MLA 查询头中的 12 个,却要存下完整的压缩 KV 历史——张量并行切的是头,不是缓存。解码上下文并行(DCP8)沿序列方向把缓存按 GPU 切八份:每张卡只存八分之一的位置,解码时各卡交换 query、对自己那段历史做计算,再用 softmax 权重合并部分结果。对一段 142,000 token 的对话,MLA 负载估算为 24 层 × 142,000 位置 × 576 字节 ≈ 每卡 1.96 GB,DCP8 降到约 245 MB(未计分配开销)。每卡处理的头数变成八倍,但各自面对的是一份八分之一的历史,前沿注意力算术量大致不变。
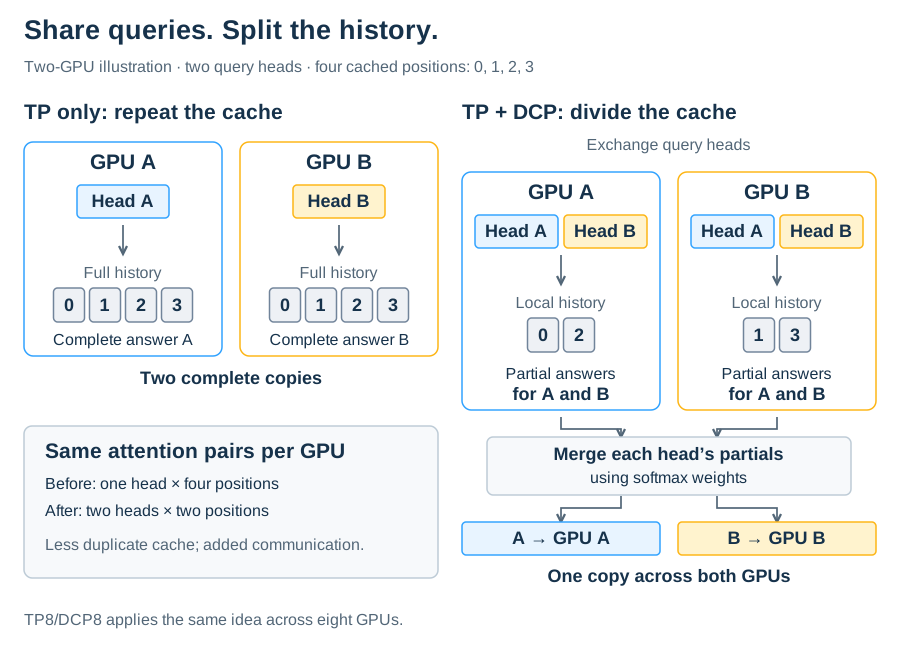
图 3:TP 复制历史,DCP 切分历史。
当状态连显存都放不下时,AMD 配方使用 vLLM 原生的 CPU 卸载,把 MLA 历史与 KDA 检查点留在主机 DRAM。这里有个隐性成本:缓存命中需要各层都存在兼容的重启点。若 MLA 历史已到 3,072,而最新的兼容 KDA 检查点停在 2,048,请求就只能从 2,048 恢复,重算剩下 1,024 个位置的前缀。
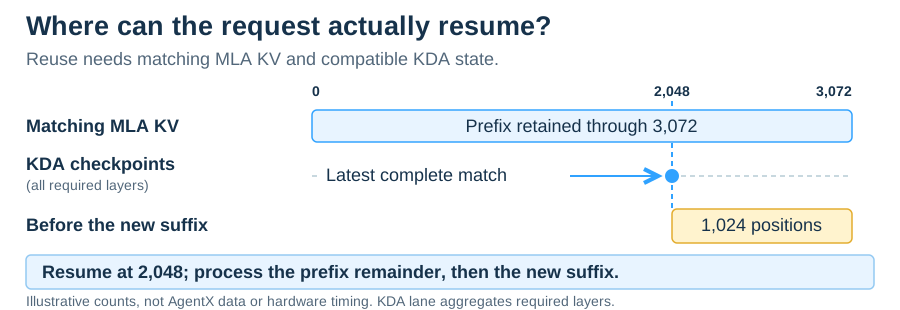
图 4:重启点必须跨所有需要的层对齐,否则回退到更早的检查点重算。
PR #54736 的做法是在保存 KDA 检查点的同时,把注意力块的尾部一并存下,让两边的重启位置对齐。这是一笔用一次回传到 GPU 的传输换前缀重算的交易。PR #51705 则把 ROCm 的 AITER DCP 路径扩展到多 token 验证。
二、MoE:删掉跨 GPU 的重复计算
在单卡视角下,路由专家的输出投影会返回消费方所需的完整向量。ROCm 原来的路径里,先有一次归约与归一化让八张卡都拿到同样的 latent 输入,而每张卡又都持有完整权重——同一个投影因此被算八遍。
输出坐标其实可以按卡切分,只是每个 rank 最终仍需完整结果。Kimi K3 本来就有一次用于共享专家部分和的 all-reduce:让每张卡只把自己负责的那部分路由输出加到共享专家部分和上,复用这次已有的集合通信即可,不引入新的 collective(PR #51253)。在八卡 MI355X、TP8、并发 8–128、随机 8K 输入 / 1K 输出、关闭前缀缓存的测试中,输出吞吐提升 3.05%–4.91%。
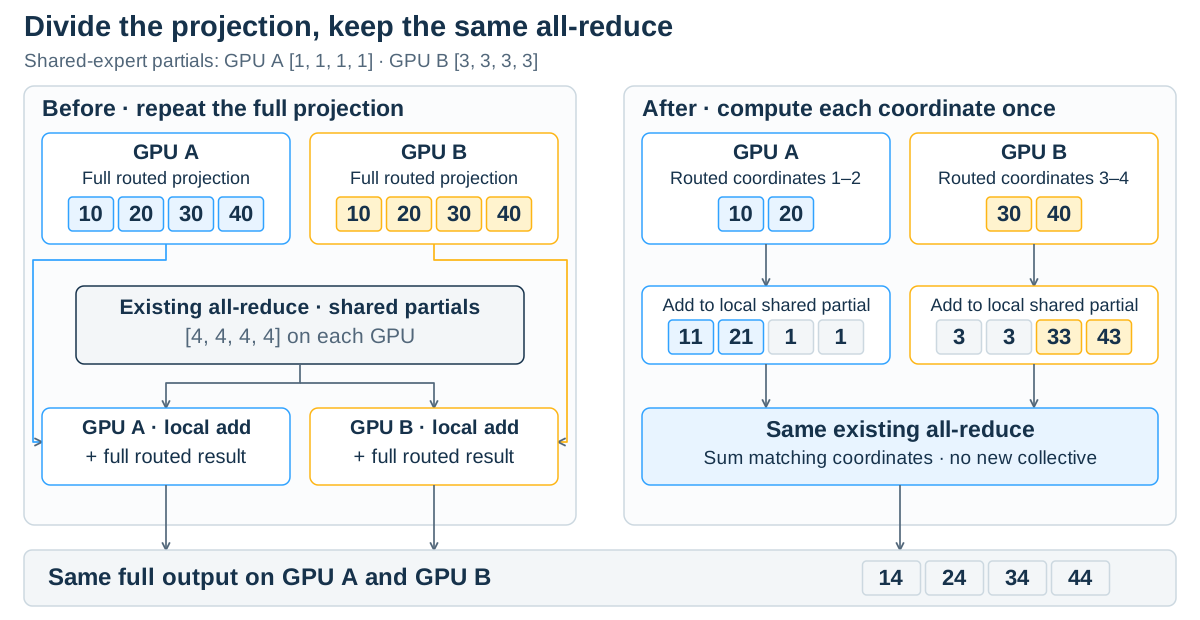
图 5:两条路径都只用一次既有的 all-reduce,并向每张 GPU 返回完整结果。
省下显存装更多缓存。既然每卡只算自己负责的坐标,就没必要加载全部权重行。只加载用得到的那部分,92 个 MoE 层在 TP8 下合计为每卡腾出约 3.85 GiB(PR #59591),空出来的空间可以装 MLA 历史与 KDA 检查点。这项改动是在头条结果所用的镜像之后才落地的:它单独的 AgentX 实验显示,并发 32 与 48 时吞吐提升不足 1%,但并发 70 时提升 28.9%,同场的前缀缓存命中率从 74.8% 升到 80.1%。
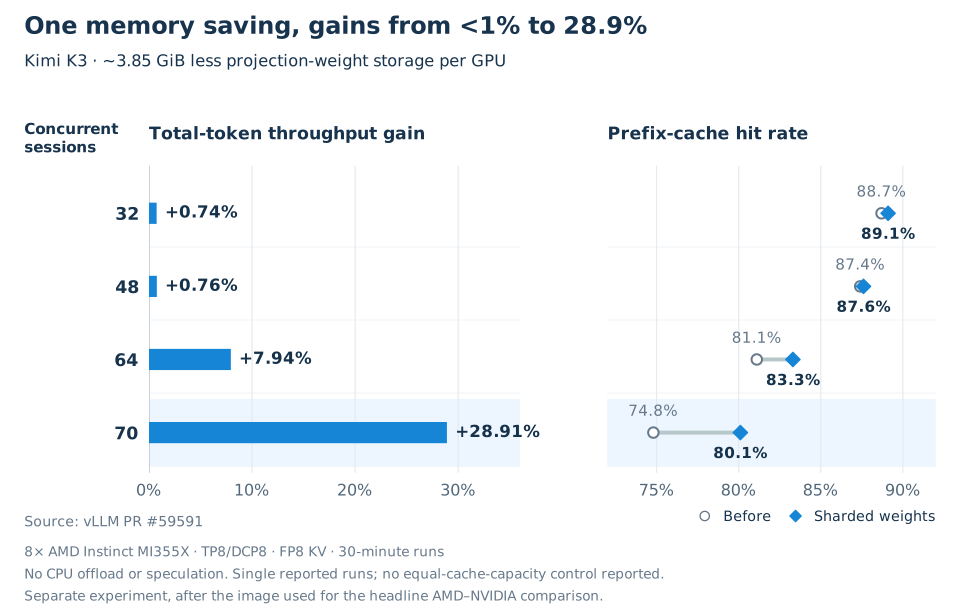
图 6:该组测量中,增益随负载上升;高并发下的大幅提升与缓存压力一致。
高并发下的增益与缓存压力相互印证,但也留下一个待解问题:文章指出,若把两种实现放在相同缓存容量下比较,才能把这一效应真正分离出来。
三、访存:融合算子,删掉没人读的拷贝
显存容量的账算完,下一个该看的是内核之间搬运的数据。
Kimi K3 的单 token KDA 路径原本要跑三个计算内核加两次输出拷贝。PR #50654 把它们合成一次 HIP 启动,并直接写入目标缓冲:卷积、已融合的 Q/K 归一化、衰减与 beta 门、循环更新、以及输出归一化,全部在一次 launch 内完成,中间交接留在片上;卷积历史与循环状态仍写回显存供下一 token 使用。另一处 PR #50593 把 AttnRes 的层块混合与 RMSNorm 合并,让临时混合留在寄存器里,在八卡 MI355X、TP8、100K 输入 / 1K 输出、关闭前缀缓存的测试中输出吞吐提升 14.2%。
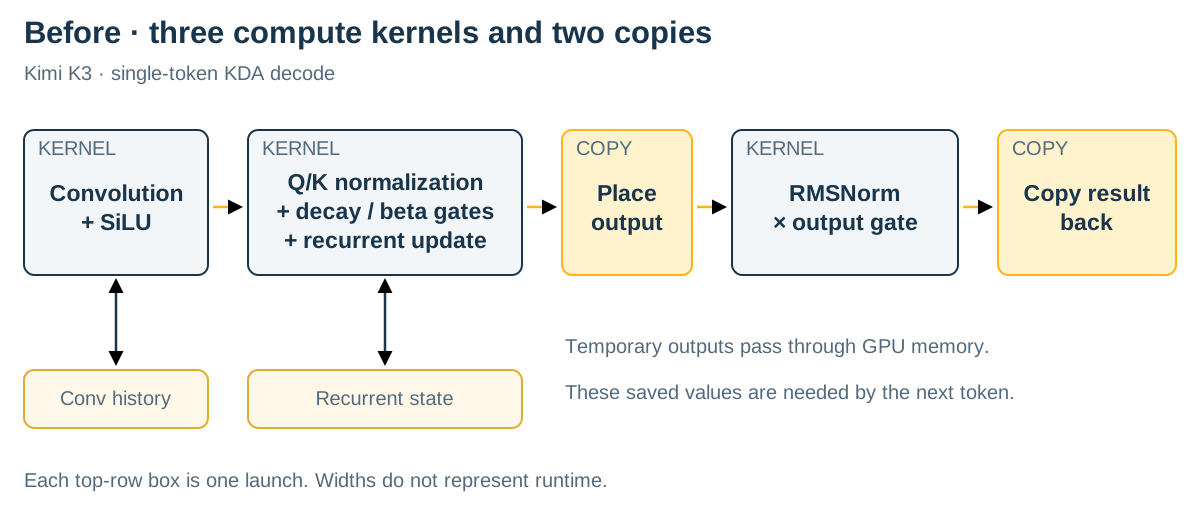
图 7:KDA 解码融合前——三个计算内核与两次拷贝。
还有一种更隐蔽的浪费:ROCm 的矩阵乘分发器在选内核之前就把输入打包好了。一旦它选中回退路径,那个内核读的是原始输入,打包好的副本从头到尾没人用。把打包移进真正会用它的专用分支即可消除这批拷贝(PR #58566)。
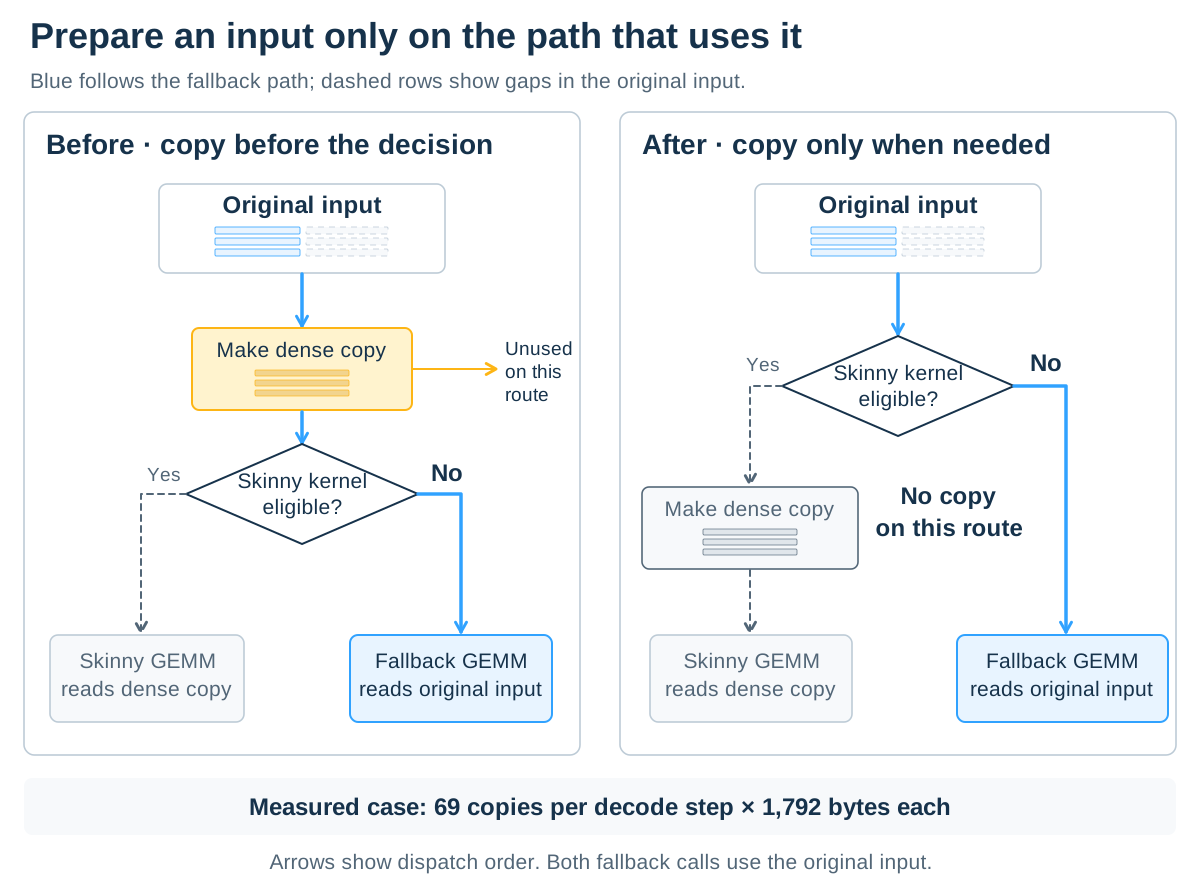
图 8:拷贝只在消费它的分支内发生。
profile 让这笔浪费现了形:每个解码步 69 次无用拷贝,正好一层 KDA 一次。每次只搬 1,792 字节,却要花约 4.8 微秒——瓶颈不是搬运带宽,而是启动开销。在 TP8、并发 1、六 draft、384K 上下文的 profile 中,这些拷贝合计占每步 0.339 ms 的拷贝内核时间。
四、MLA:用 AITER 汇编路径加速长上下文解码
TP8 下 Kimi K3 每卡只有 12 个查询头。把补到 16 个头之后,AMD AITER 的汇编解码路径就可用了:在报告的长上下文测试中,每输出 token 耗时从 43.8 ms 降到 23.6 ms。
| 输入 / 输出 token | 原 Gluon 路径 | 补齐后的汇编路径 |
|---|---|---|
| 1K / 1K | 22.9 ms/token | 22.8 ms/token |
| 32K / 1K | 43.8 ms/token | 23.6 ms/token |
差别不在数学,而在调度。历史代码里一条保守的调度提示把 Gluon 路径限制为每个请求一个 workgroup,那个 workgroup 要独自处理整段对话;汇编路径则用另一套策略把历史切成多块并行、再合并结果(检查到的策略选了 16 块)。因补齐而多出的四个头由适配层拷贝并丢弃输出(PR #50578),它不改变模型行为——每个查询头独立对缓存位置做注意力,多加一个头不会影响原有头的 softmax;被补齐的只是查询,存储的压缩 KV 大小不变。
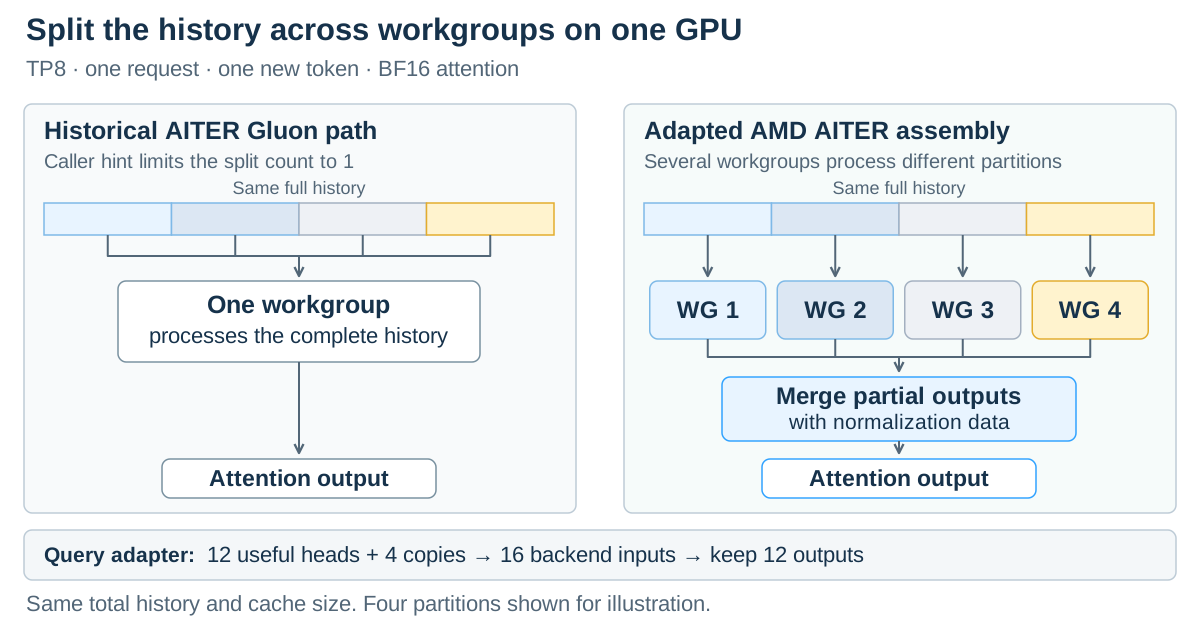
图 9:查询补齐换来的是路径切换,历史切分是单卡内的工作划分。
五、KDA:把 prefill 与投机验证拆开并行
MLA 能把历史切给多个 workgroup,KDA 面对的是更难的问题:每个 token 都依赖前一个 token 的状态。PR #54038 的融合 prefill 先算出每个 token 分组的组合变换,此时还不知道该组的入状态是什么。
以「把状态减半再加二」「再减半再加一」为例,两条规则可以合成「取起始状态的四分之一再加二」——这条规则在起始状态到达之前就能算出来。KDA 用矩阵变换做同样的事:先对分组摘要做一次有序扫描,确定各组起始状态,然后各组并行重放自己的 token;组内顺序不变,但各组不必再等前一组重放完。代价是多一遍遍历,融合 chunk 路径从两次启动变成四次,所以它在序列或头数太少、暴露不出并行度时才划算。在三后端对比中,融合 KDA 在 4K 与 16K 输入长度下比 Triton 多 5.3%–5.6% 的输入吞吐(PR #56036)。
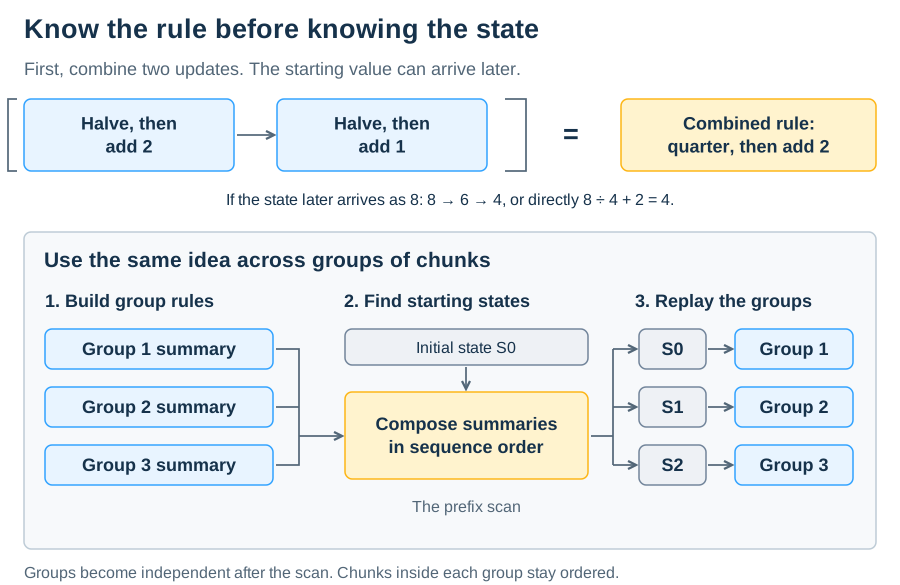
图 10:分组合成、扫描求起始状态、并行重放。
投机验证要用更小的 tile。短验证批次需要另一种切法。TP8 下每卡 12 个 KDA 头、每头 128 个 value 列,若按 32 列切开,只有 48 个 workgroup 落在 256 个计算单元上;PR #58045 改成 4 列 tile,workgroup 数升到 384。在单卡 MI355X 的图重放内核测试中(TP8 维度、一条序列、四个验证位置),每层耗时从 16.20 微秒降到 5.61 微秒(2.89 倍)。
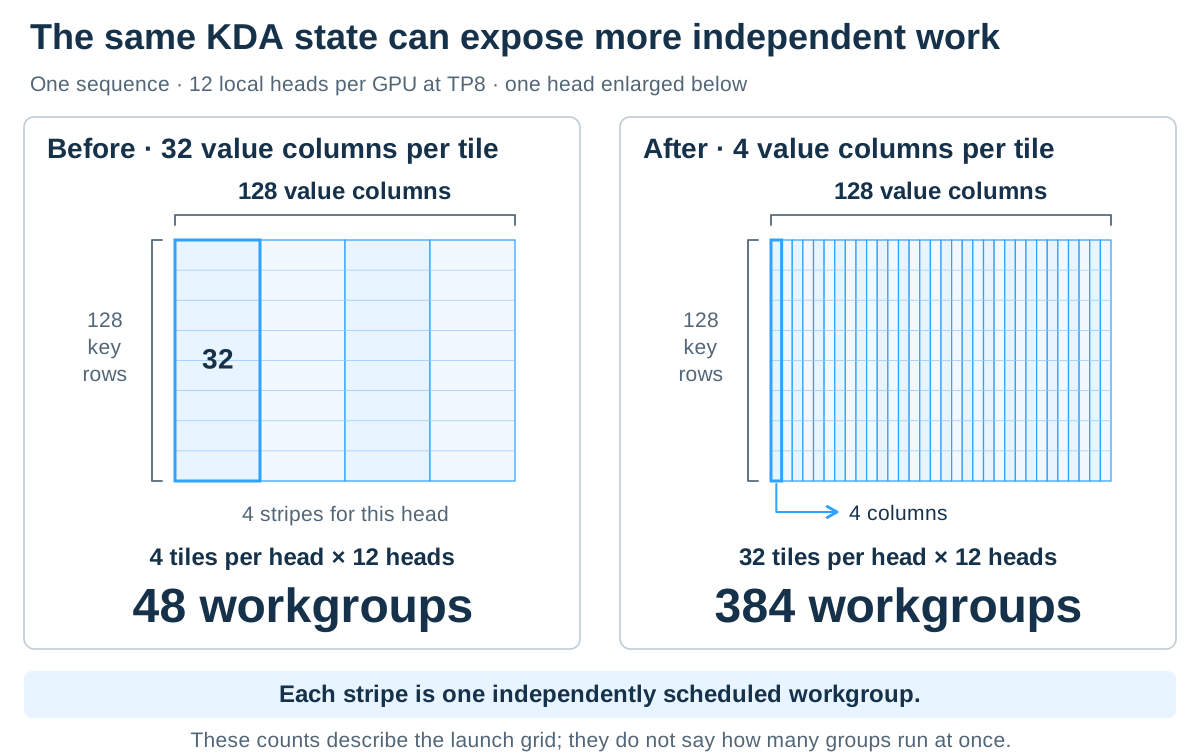
图 11:更窄的 tile 带来更多独立 workgroup,每个 tile 拥有不同的 value 列。
六、投机解码:该起草几个 token
验证变快之后,值得验证的 draft 数量也会变。真正有用的速率是已提交输出除以完整的起草—验证—提交周期耗时。
在 AgentX 的固定接受率参考下,三个 draft 每周期期望提交 3.00 个 token,四个则是 3.36 个(含恢复或奖励 token),即每周期多 12% 的已提交输出。于是判据很清楚:只有当整个周期耗时增长不到 12% 时,第四个 draft 才值得。公开的 AMD 配方在 DCP1 下使用 3 到 7 个 draft,并在 DCP8 的更大并发设置下关闭投机解码。
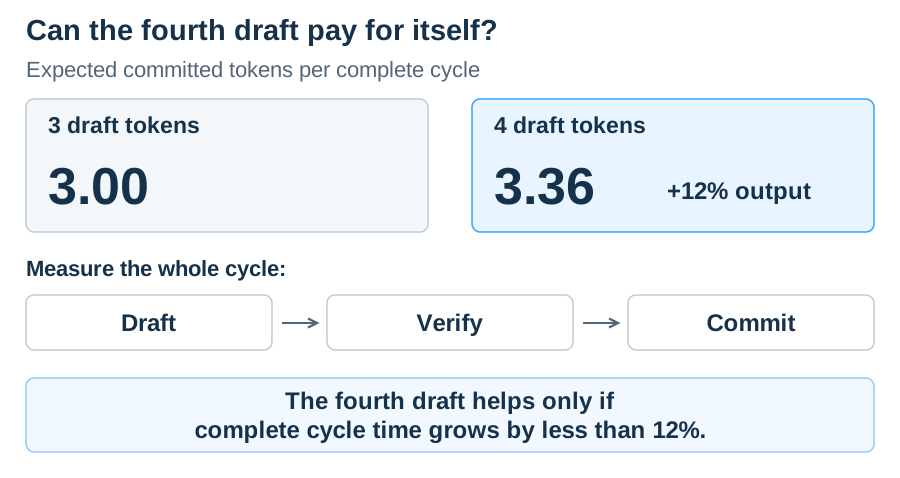
图 12:12% 是一道成本预算线,而非实测结论。
精度:为什么 FP32 累加救不回被舍入的输入
KDA 的每个 chunk 仍需解开 token 之间的依赖。内核把它们合成一个变换,供后续矩阵乘使用,随之而来两个工程问题:用什么精度保住结果,多少临时数据能留在片上?
数值上最敏感的是那个 64×64 的组内依赖矩阵求逆,它的中间值会互相放大和抵消,过早舍入会丢掉最终结果需要的信息。实现使用 AMD 原生 FP32 矩阵指令,输入与累加都保持 FP32,只把算完的逆矩阵舍入到 BF16 交给后续乘积。
文章用一个玩具例子说明为什么「FP32 累加」并不能兜底:计算 256.5 − 256 时,两个数在 FP32 下都是精确的,但如果先把 256.5舍入到 BF16,它就变成 256,减法结果从 0.5 变成 0。累加精度再高,也救不回在它开始之前就已经丢失的信息。
片上预算同样紧张。AMD 的片上共享暂存叫 LDS,Q 与 K 的 tile 因为使用时间不同而复用存储,三角输入只存十个非空 16×16 块,最终 workgroup 请求 79.5 KiB,向上取整到 80 KiB——恰好是 CDNA 4 单个计算单元 160 KiB LDS 预算的一半。这个取整很关键:两个 80 KiB 分配放得下,两个 81.25 KiB 就放不下,并行度会掉一个档。
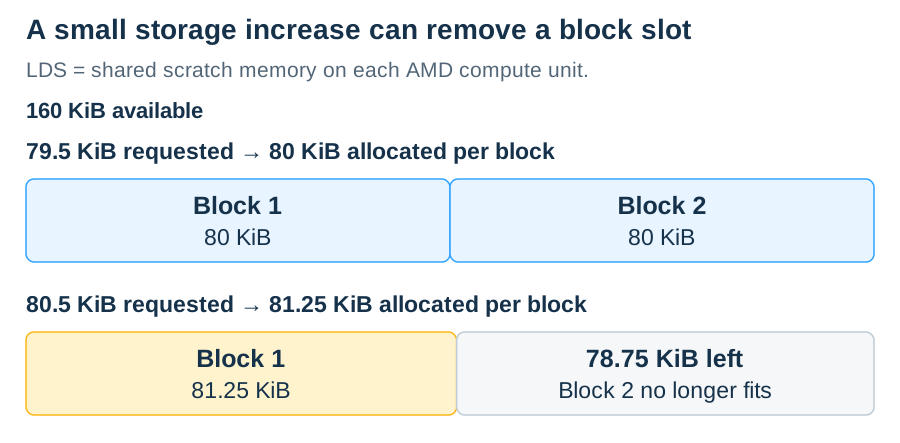
图 13:分配按 1,280 字节为单位取整,多出的那一点可能正好跨过驻留阈值。
核心总结
- 结果:50 tokens/s/user P90 交互性下,八卡 MI355X 交付 7,567 tokens/s/GPU,NVIDIA HGX B300 为 6,083,单卡吞吐高 24.4%;按每 GPU 小时 1.50 对 2.26 美元建模,每美元 token 多 87.4%
- 缓存:DCP8 把 MLA 历史按 GPU 切成八份,142K token 对话的每卡 MLA 负载从约 1.96 GB 降到约 245 MB;CPU 卸载则需让 KDA 检查点与注意力尾部对齐重启位置,否则回退重算
- MoE:输出坐标按 GPU 划分并复用既有的共享专家 all-reduce,输出吞吐 +3.05%–4.91%;只加载本 rank 用到的权重行,每卡省下约 3.85 GiB,在并发 70 时带来 28.9% 吞吐提升
- 访存:KDA 解码三内核两拷贝融合成一个 HIP 内核;AttnRes 混合融进 RMSNorm 使输出吞吐 +14.2%;矩阵乘分发器里每步 69 次无人读取的拷贝被删除
- MLA:补齐到 16 个查询头以启用 AITER 汇编解码路径,32K 输入下每输出 token 从 43.8 ms 降到 23.6 ms
- KDA:分组合成加扫描让 prefill 并行,4K/16K 输入比 Triton 多 5.3%–5.6% 输入吞吐;投机验证改用 4 列 tile,workgroup 从 48 增到 384,每层耗时降到 5.61 微秒
- 投机解码:四个 draft 比三个多 12% 的已提交输出,只有当完整周期增长低于 12% 时才值得
- 精度:依赖矩阵求逆保留 FP32 输入与累加,只把结果舍入到 BF16;FP32 累加无法恢复在它之前就被舍入的输入
这篇文章值得留意的不是某一个数字,而是它给出的诊断方法:先比较各个 rank 是否在算同一件事,再追踪每份临时张量到底有没有消费方,最后数一数实际的头、token 与 tile 是否凑得出足够多的独立 workgroup。在这类新架构上,拖住下一个 token 的往往既不算力也不是带宽,而是重复计算、没人读的拷贝,和一个恰好跨过驻留阈值的 LDS 分配。
原文:Scaling Kimi K3 on AMD Instinct MI355X: Matching NVIDIA HGX B300 Throughput per GPU on AgentX(vLLM Blog,2026-10-16)
参考:
- SemiAnalysis InferenceX:Kimi K3 的 B300 与 MI355X 对比
- AgentX:真实编码智能体轨迹基准(vLLM Blog,2026-09-08)
- vLLM 的解码上下文并行(DCP)(vLLM Blog,2026-08-07)
- Kimi K3 在 vLLM 中的性能优化之路(vLLM Blog,2026-09-13)


