调用一个开放权重模型时,不同 provider 可能用不同精度为你服务:16 位 bf16、8 位 fp8 或 4 位 fp4。量化把模型权重存成更少的位,换来更小的显存占用与更低的硬件需求,代价理应是精度。11 月 11 日,OpenRouter 发布了一篇实测文章,试图回答一个很实际的问题:作为 API 用户,选中低精度端点到底会损失多少。
测试在 10 月 20 日进行,覆盖 OpenRouter 上 1,455 个 provider 端点,质量实验则锁定 Qwen3.8 27B 的 6 个端点。结论是:在这批任务上,fp16、fp8、fp4 之间没有测出准确率差异,精度标签本身并不能预测准确率;低精度通常更便宜,但不是每个模型都如此。
位数、内存与缩放因子
量化最直接的影响是权重体积。以 27B 模型为例,bf16/fp16 约 54 GB,fp8 约 27 GB,fp4/int4 约 13.5 GB。这只是权重,运行时还要为每个 token 的注意力状态留出 KV cache。
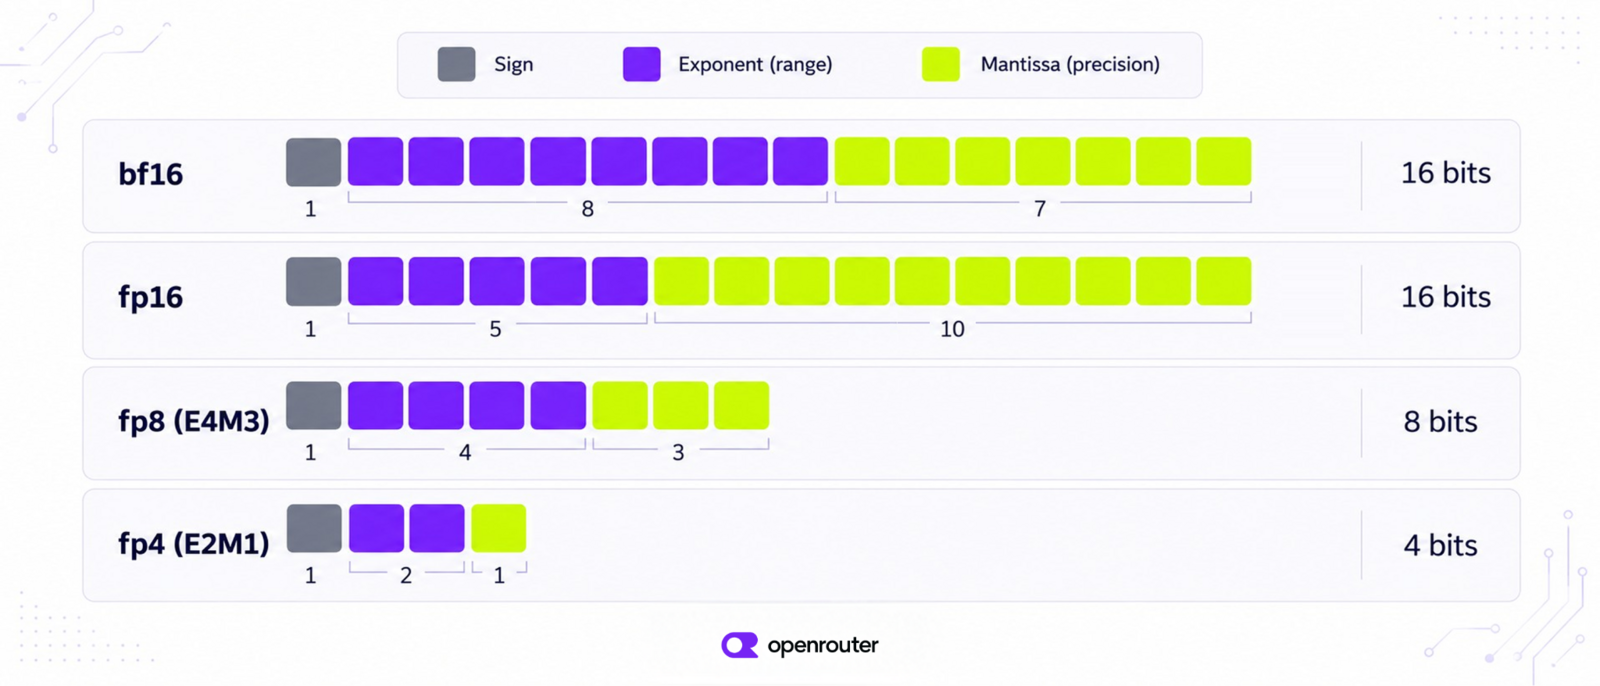
格式上的差别在于位怎么分:bf16 是 1 位符号、8 位指数、7 位尾数,范围与 fp32 相同但精度更低;fp16 是 1、5、10;OCP 的 fp8 规范定义 E4M3 与 E5M2 两种编码,分别是 4 位指数加 3 位尾数、5 位指数加 2 位尾数。fp8 同时牺牲范围与精度,所以量化模型要为每个张量或权重块存一个缩放因子——MXFP4 是每 32 个值共享一个缩放,NVFP4 是每 16 个值一个 fp8 缩放。
方法上,训练后量化(PTQ)直接转换成品模型,可再分为运行时计算激活范围的动态方案与提前用样本数据算出范围的静态方案;量化感知训练(QAT)则在训练时就模拟舍入,让权重学会容忍误差。
实验:280 道精确答案题,六个端点
研究选了 6 个端点:Cerebras 以 fp16 提供,Parasail、CoreWeave、AkashML 用 fp8,Darkbloom 与 ModelRun 用 fp4。每次请求都用 provider.only 与 quantizations 锁定端点并关闭 allow_fallbacks,temperature 设为 0、关闭推理。题目分五类:带过程的算术、短代码追踪、长代码追踪、20–30 个数字的排序、4,000 与 20,000 token 的召回、约 9,000 token 的四跳查找。全部题目由程序生成,有精确答案,不需要裁判模型。另有一组 40 道题只要求两个四位数相乘、不写过程,单独计分。
| 任务类型 | 题数 | fp16 Cerebras | fp8 Parasail | fp8 CoreWeave | fp8 AkashML | fp4 Darkbloom | fp4 ModelRun |
|---|---|---|---|---|---|---|---|
| 带过程算术 | 50 | 48 | 49 | 48 | 49 | 49 | 50 |
| 短代码追踪 | 50 | 50 | 50 | 50 | 50 | 50 | 50 |
| 长代码追踪 | 30 | 30 | 29 | 29 | 29 | 29 | 28 |
| 排序 20–30 个数 | 30 | 30 | 29 | 29 | 29 | 29 | 30 |
| 4,000 token 召回 | 20 | 20 | 20 | 20 | 20 | 20 | 20 |
| 20,000 token 召回 | 20 | 20 | 20 | 20 | 20 | 20 | 20 |
| 四跳召回 | 40 | 39 | 40 | 40 | 40 | 39 | 40 |
| 合计 | 240 | 98.8% | 98.8% | 98.3% | 98.8% | 98.3% | 99.2% |
总分的 95% 置信区间为 95.8% 到 99.8%,六个端点全部重叠。没有任何一个任务类型把不同精度区分开:每个端点在任一类型里最多错两题,且都是普通失误,比如排序结果里漏掉一个数。三个 fp8 端点彼此在 240 题中只在 2 到 5 题上不一致,两个 fp4 端点之间差 4 题;Darkbloom 与 fp16、fp8 端点分歧最多(7 到 8 题),但总分与 fp16 相差不到半个百分点。
唯一出现落差的是「不写过程直接相乘」:Darkbloom 的 fp4 端点 40 题只对 26 题,其余五个端点在 30 到 33 题之间,同为 fp4 的 ModelRun 是 30 题。作者用两比例 z 检验对比表现最好的 33 题端点,估出「实际无差异却出现这么大差距」的概率约 7.5%,因此不能认定为精度效应;所有精度下答错的乘积偏差都很小,中位误差小于 0.01%。
Cerebras 上完整的 280 道题跑了两次,两次返回的文本逐字相同。作者也承认测不出差异来源:端点间的细微差别可能来自精度,也可能来自各家硬件与推理软件,或单纯的运行波动;而且 fp16 只有 Cerebras 一个端点,没有第二家可对照。结论的适用范围因此很窄——一个模型、280 道题、一天、六个端点,换模型或换任务仍需自行验证。
谁在提供什么精度:六成端点不报
OpenRouter 拉取了全部 1,455 个端点(470 个模型)的精度标签:
| 标注精度 | 端点数 | 占全部 | 占已标注 |
|---|---|---|---|
| unknown | 865 | 59.5% | — |
| fp8 | 343 | 23.6% | 58.1% |
| fp4 | 123 | 8.5% | 20.8% |
| bf16 | 70 | 4.8% | 11.9% |
| int4 | 20 | 1.4% | 3.4% |
| nvfp4 | 13 | 0.9% | 2.2% |
| mxfp4 | 12 | 0.8% | 2.0% |
| fp16 | 8 | 0.5% | 1.4% |
| fp32 | 1 | 0.1% | 0.2% |
865 个未知端点里,610 个属于闭源权重模型——所有 Claude、Gemini,以及除 gpt-oss 之外的所有 OpenAI 模型;剩下 255 个里 253 个是 provider 未标注的开放权重模型。163 个有标注端点的模型中,只有 54 个提供了 16 位选项。换句话说,对多数开放权重模型,8 位或 4 位就是能选到的最高精度。
价格:低精度通常更便宜,但并非必然
按「三个输入 token 折算一个输出 token」的混合价,比较每个模型在各精度下的最便宜端点:
| 对比 | 模型数 | 低精度更便宜 | 差距在 2% 内 | 低精度更贵 | 价格比中位数 |
|---|---|---|---|---|---|
| 8 位 vs 16 位 | 24 | 14 | 3 | 7 | 0.94 |
| 4 位 vs 8 位 | 33 | 26 | 3 | 4 | 0.76 |
| 4 位 vs 16 位 | 11 | 9 | 0 | 2 | 0.73 |
例外很具体:gpt-oss-120b 的 8 位端点比 16 位更贵;MiniMax M3 的 4 位比 8 位更贵。五个模型的最低价(每百万混合 token):
| 模型 | 16 位 | 8 位 | 4 位 |
|---|---|---|---|
| Qwen3.8 27B | $0.581 | $0.342 | $0.140 |
| Kimi K2.6 | $1.400 | $1.079 | $0.825 |
| Gemma 4 31B | $0.205 | $0.200 | $0.160 |
| gpt-oss-120b | $0.067 | $0.100 | $0.060 |
| MiniMax M3 | 无 | $0.388 | $0.412 |
作者强调,provider 对价格的影响比精度更大:同一精度下,最贵端点的中位价格是最便宜的 1.72 倍。Qwen3.8 27B 的十个 fp8 端点从 1.137 不等。想让请求落到符合精度要求的最便宜端点,可以在模型名后加 :floor。
在那次完整测试里,最便宜的整轮运行在 fp4(Darkbloom,1.24),但中间顺序并不随精度排列:AkashML(fp8)0.77、Parasail(fp8)1.19。速度也不跟精度走:Cerebras(fp16)与 ModelRun(fp4)中位响应时间为 1.3 与 2.4 秒,其余四家在 8.4 到 15.0 秒之间。除只有一个端点的 fp32 外,各精度 24 小时可用率中位数都在 99.8% 以上。
怎么固定你拿到的精度
先查端点再设过滤。对 https://openrouter.ai/api/v1/models/qwen/qwen3.8-27b/endpoints 发 GET(文章称无需 API key),会返回每个端点的精度、价格、上下文长度与可用率;Qwen3.8 27B 当时有 21 个端点:1 个 bf16、1 个 fp16、10 个 fp8、3 个 fp4、6 个未知。要固定精度,就在请求里用 provider.quantizations 列出所有可接受的精度:
"provider": {
    "quantizations": ["fp8", "bf16", "fp16"]
}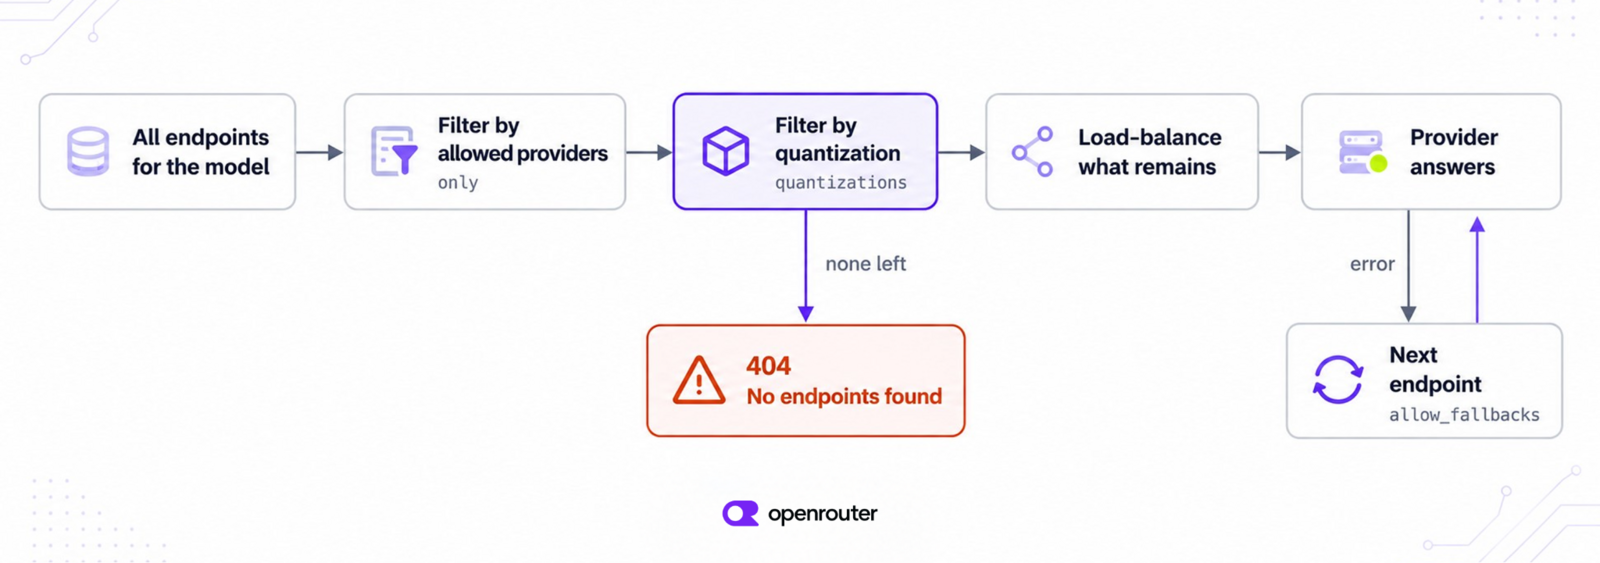
这个过滤发生在联系任何 provider 之前,候选为空会很快失败:请求 Qwen3.8 27B 的 int8(没有端点提供)在 0.4 秒内返回 404,响应里的 routing_funnel 显示端点数从 21 变 0,failed_routing_step 指明是精度过滤这一步。{"quantizations": ["fp8"], "only": ["cerebras"]} 也会 404,因为 Cerebras 是 fp16。文档还说明 fp4 包含 mxfp4 与 nvfp4,fp8 包含 mxfp8,unknown 也可以作为过滤值。
更隐蔽的问题是候选只剩一个时:测试中固定 Cerebras 并关闭回退,前 280 次请求里有 93 次连续三次失败,返回上游共享池的 429。把列表放宽到 ["fp16", "bf16"] 后,同样请求转到了 DeepInfra。另外,provider 接受请求时状态码可能已经是 200,错误藏在响应体里,所以不能只看状态码。对带工具调用的请求,OpenRouter 的 Auto Exacto 会按吞吐、工具调用成功率与基准分数排序端点,也可以在模型名后加 :exacto 对无工具请求启用。
需要说明的是,这是 OpenRouter 基于自家端点数据与路由功能做的测量,文中同时介绍了 quantizations 过滤、:floor 与 Exacto 等功能;实验只覆盖一个模型、一天、六个端点,作者也建议在自己业务的提示词上先验证再迁移流量。
核心总结
- 量化把权重存成更少位数:27B 模型从 bf16 的约 54 GB 降到 fp8 的 27 GB、fp4 的 13.5 GB(不含 KV cache)
- 240 道精确答案题上,fp16、fp8、fp4 六个端点总分在 98.3%–99.2% 之间,置信区间全部重叠,没测出精度差异
- 唯一疑似落差在「不写过程直接相乘」,但统计检验显示约 7.5% 概率只是偶然,不能归因于精度
- 六成端点不报精度,163 个有标注模型中只有 54 个提供 16 位;低精度通常更便宜,但 gpt-oss-120b、MiniMax M3 出现价格倒挂
- provider 对价格的影响大于精度:同精度最贵端点中位是最便宜的 1.72 倍,固定精度时记得列出多个可接受值以保留回退
原文:LLM Quantization: What fp8 and fp4 Do to Quality and Price(OpenRouter,2026 年 11 月 11 日)


