10 月 20 日,DeepSeek 在 GitHub 开源了 DeepInfer——驱动 DeepSeek V4.1 Flash 线上大规模服务的推理框架,Apache 2.0 许可。截至发稿仓库已有 7.3k star、606 个 fork。与代码一同发布的还有一份 28KB 的《DeepSeek V4.1 Flash 推理部署 Q&A》,逐条回答部署细节;官方同时开源了负责 API 协议与 token 序列互转的 deepseek-recipe(Rust 实现,MIT 许可)。
两个规模数字是这次开源最有分量的注脚:DeepSeek 称单个集群当前每天处理 155 万亿 token,按谷时定价折算,整体收入约每 GPU 小时 38 美元。
边界需要先说清楚:开源的是离线推理部分。README 明确列出三块「完整推理服务需要、但本次未包含」的组件——KV 缓存系统、VE/Prefill/Decode 分离部署,以及 prefill 与 decode 跨数据并行副本的负载均衡。这三块恰好是与内部基础设施耦合最深的部分。官方表示 Q&A 文档会持续更新,后续模型的推理代码与性能优化也会继续在 DeepInfer 开源。
一套栈跑两种芯片
支持硬件为 NVIDIA SM100 与华为昇腾 950,构建需要 CUDA 13 或 CANN 9.2、GCC ≥ 13、Python 3.12,用环境变量 DEEPINFER_ACCELERATOR 在 nvidia / ascend 之间切换。当前只支持一个模型:DeepSeek-V4.1-Flash,默认权重是 deepseek-ai/DeepSeek-V4.1-Flash-1017。
功能清单分两层。内核层整合了 FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 与自研的 TileLang 内核;引擎层则列出 Attention DP / 均衡 CP 与 MoE EP + EPLB 并行、DSpark 置信度调度验证、SWA 有界重放、零开销批调度器、批不变推理、确定性采样与结构化输出。README 注明批不变推理与确定性采样目前仅限 NVIDIA 平台。
解码用 Wide-EP,不用 TP/CP
架构是 VE / Prefill / Decode 分离加独立的存储节点。并行策略按阶段区分:prefill 用 EP2–8 / DP2–8,「用 HBM 允许的最小 EP/DP」;decode 用 EP64–128 / DP64–128,也就是 Wide-EP,「用可用 GPU 允许的最大 EP/DP」;视觉编码器单卡即可,建议用更便宜的卡。官方明确当前不使用 TP 与 CP。
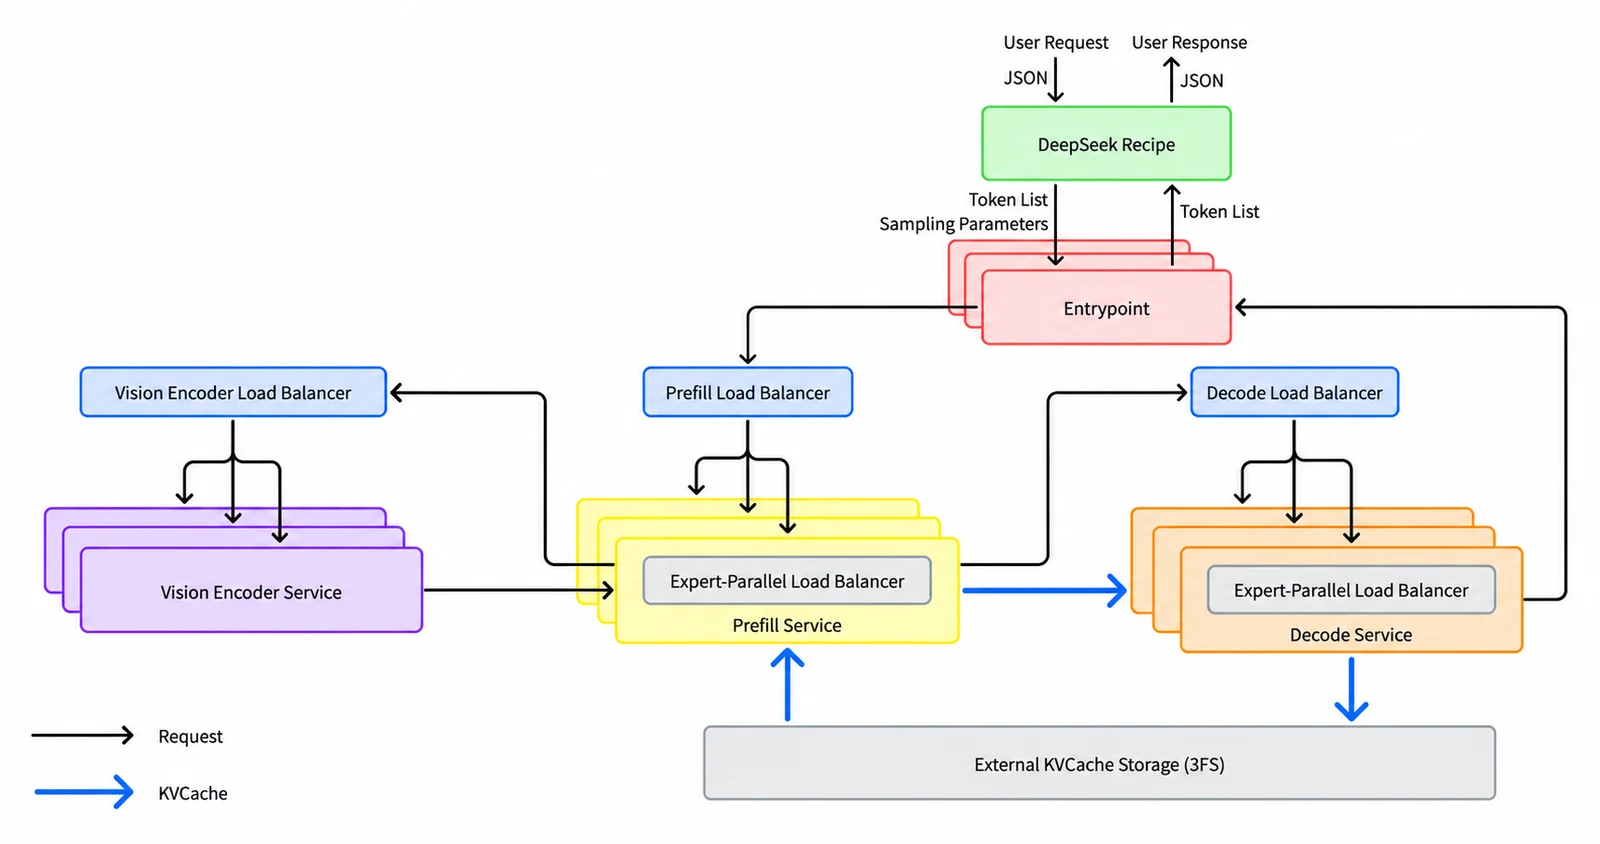
图 1:DeepSeek V4.1 Flash 推理系统架构。请求经 DeepSeek Recipe 与 Entrypoint 分发到三类负载均衡器,KV 缓存落到独立的 3FS 存储。
Wide-EP 换来的是 MoE 专家部分每步访存量的显著下降,配合 EPLB 把 TPS 抬起来。仓库给出的对比是 EP8DP8(384+32 专家)与 EP64DP64(384+64 专家)两条解码曲线:低交互性一端两者相差不大,交互性要求越高差距拉得越开,同一吞吐水平下 EP64 能撑住的每用户速度明显更高。
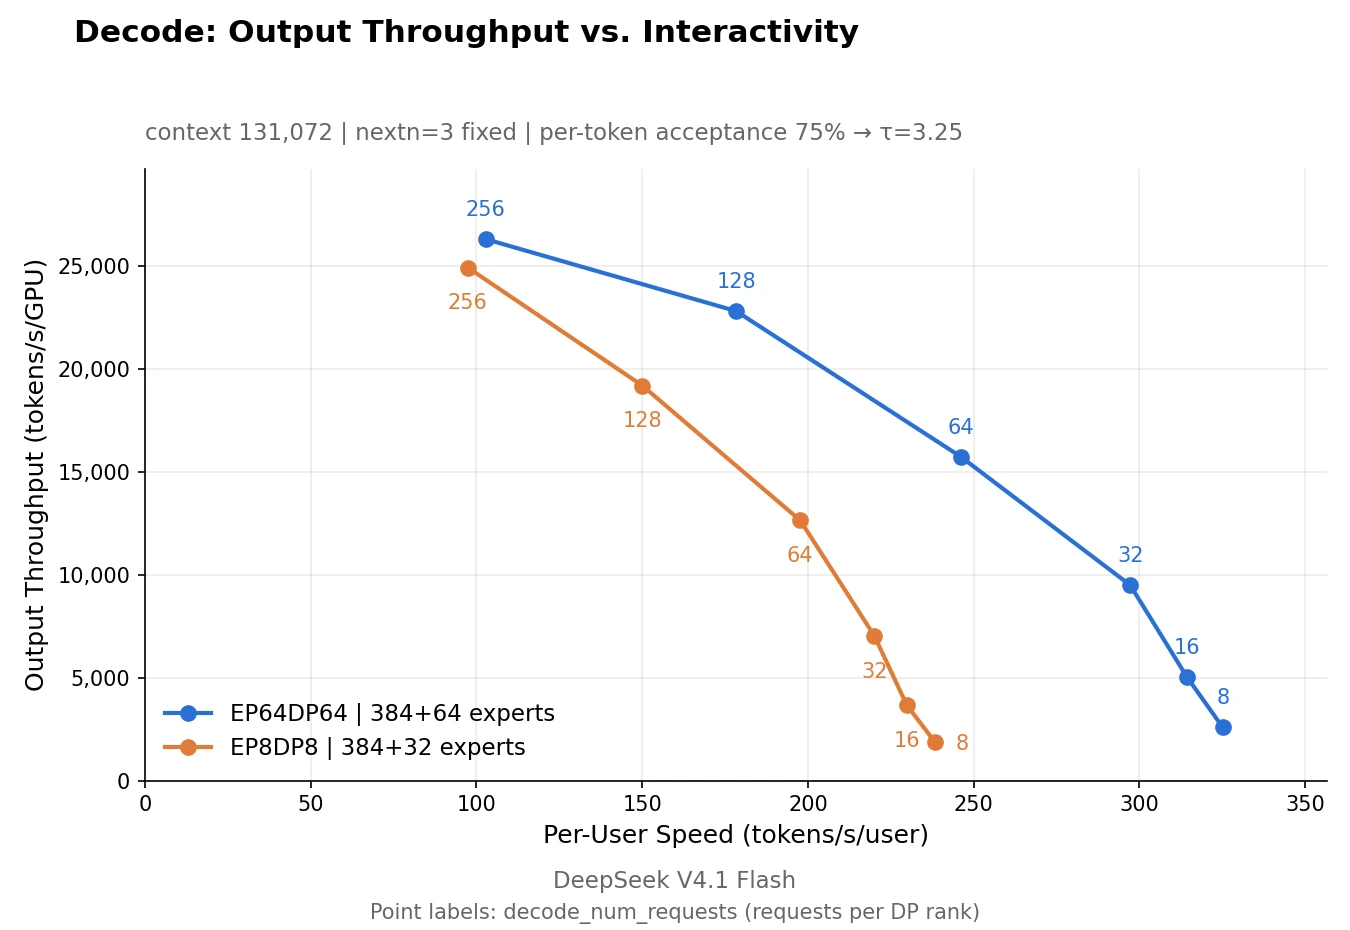
图 2:EP8DP8(橙)与 EP64DP64(蓝)的 decode 吞吐–交互性曲线,点标签为每 DP rank 的请求数。
代价落在最小部署单元上。1P+1D 虽然能跑,但 decode 推荐 EP64 起步,所以「最小的高效部署单元是 64 卡 prefill 加 64 卡 decode」。官方还提到,P 与 D 跨数据中心拆分在技术上可行——V4.1 Flash 把 KV 缓存压得足够小——每 8 卡大致需要 400 Gbps 互联带宽;实际部署中,DeepSeek 的推理节点分布在不同但相邻的数据中心里。
三层 KV 缓存,三种介质
Q&A 里信息密度最高的是 KV 缓存部分。缓存被拆成三层:
| 内容 | 介质 | 副本 | 管理者 |
|---|---|---|---|
| 在途 block KV + state KV | 推理卡显存 | — | prefill / decode 实例 |
| SWA KV | 本地主机内存 | 单副本,不进 3FS | prefill / decode 实例,跨机命中走 400G VLAN |
| 分页 block KV | 专用 3FS 存储集群 | 不做应用层副本,依赖 3FS 自身冗余 | kvcache-store |
block KV 放在专用存储集群而非本机内存,为的是让每台 prefill 机器都能命中任意前缀——否则前缀亲和与负载均衡路由会互相打架;这也让存储节点的扩缩容与计算节点解耦,并且让缓存不受计算节点故障影响(官方称计算节点的故障率比存储节点高一个数量级以上)。3FS 提供约 100 PiB SSD,采用 10+2 纠删码,每个 EC 组可容忍两个节点同时故障,读取时同时向 11 个存储节点发请求、拿到任意 10 份即可解码返回。
TTL 按流量类型分开:智能体流量 3 天,聊天流量 7 天。官方实测 3 天 TTL 会让聊天流量损失 0.5%–1% 的缓存命中率,因为聊天流量的命中长尾更重——少量 KV 缓存被反复读取,丢掉它对整体命中率的影响更明显。存储集群与在线 GPU 的比例约为每卡 14.4 TB 逻辑容量。
SWA KV 不进持久缓存,留在产出它的机器内存里,用一份逻辑统一、物理按 key 分片的 Entrypoint 内存目录记录位置。它按 128 token 粒度存储,V4.1 只存前 20 层,每条序列 1,415,040 字节(20 层 × 134 token × 528 字节,MXFP8 格式)。命中策略是:命中长度由 block KV 决定,最后一块要不要重算由 SWA KV 决定——SWA 缺失就退一个 block 重算。在 YOCO 截断约束下,长度 L 的输入最大命中长度不超过 L − 134(128 token 窗口加 6 个投机回溯位)。
有界重放:把重算成本压成常数
SWA 有界重放(SWA bounded replay)只重算最近 128 个 token,并把注意力窗口截断在重放段内——从位置 s 重放时,位置 i 的 query 只与 max(s, i−127) 到 i 之间的 key 计算。这样重算成本与上下文长度、层数都无关,代价是结果并非 bit 级精确。官方给 V4.1 的默认配置是 DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact 与 DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140。
它用在两处。编码器侧,前缀命中长度只看 block KV,SWA KV 缺失时重算命中前缀的最后 128 个 token,而 block KV 原样复用、既不重算也不覆写。解码器侧的收益更大:CED 架构里解码器层的 block KV 由最后一个编码器层的隐状态投影而来,只有解码器 SWA KV 需要逐层计算,精确重建要把最后 2,560 个 token 过一遍 20 层解码器;有界重放只重算 128 个,且结果只供 decode 使用、不进入前缀缓存——几乎把总 prefill 计算量减半。
投机解码这一侧是 DSpark:置信度头(Confidence Head)预测每个草稿 token 的接受率,调度时把验证算力分配给边际收益最高的 token。生产环境一次生成 5 个草稿 token,动态长度验证把每步验证的草稿 token 数砍掉约 30%(5.00 → 3.2–4.4),平均接受长度基本不变(3.29 对 3.20)。按 EP64/DP64 基准数据折算,在生产工作点(每 rank 约 60 条并发序列)对应 4%–7% 的吞吐提升;并发越高收益越大,96 条并发时是 +11.0%,而 16 条并发时反而是 −1.5%。
调度、确定性与结构化输出
decode 第 N 步是 schedule(N) → forward(N) → sample(N) → post-process(N),其中调度与后处理是纯 CPU 逻辑,且 post-process(N) 之前需要一次 GPU-CPU 同步去取 sample(N) 的结果,GPU 于是空转。异步调度(零开销批调度器)的做法是让 CPU 在 GPU 跑 forward(N) → sample(N) 的同时并行执行 schedule(N+1) → launch_forward(N+1) → post-process(N−1) → launch_sample(N+1),官方称沿用了 SGLang、NanoFlow 的既有实现,该功能默认开启。
其余几项机制都可以用环境变量打开:
- 批不变推理:
DEEPINFER_BATCH_INVARIANT=1(仅 NVIDIA),同一份输入在不同 batch 组合下模型结果保持一致。 - 确定性采样:在上述基础上再加
DEEPINFER_ENABLE_MTP_VARLEN=0并传入固定的seq_seed,相同输入与采样参数产出相同输出。 - 结构化输出:编译与推理解耦,格式约束在专门的 SO 机器上编译成语法自动机;解码每一步推进自动机、确定合法 token 集合、生成掩码作用于采样。支持正则、JSON Schema 与 EBNF,通过
SamplingParams的so_args传入。
性能与评测
仓库给出的吞吐–延迟曲线在 4 张 SM100 上测 prefill、64 张测 decode,两者各自处于同一个 scale-up 域内,可用 examples/sweep/run_sweep.sh 复现。
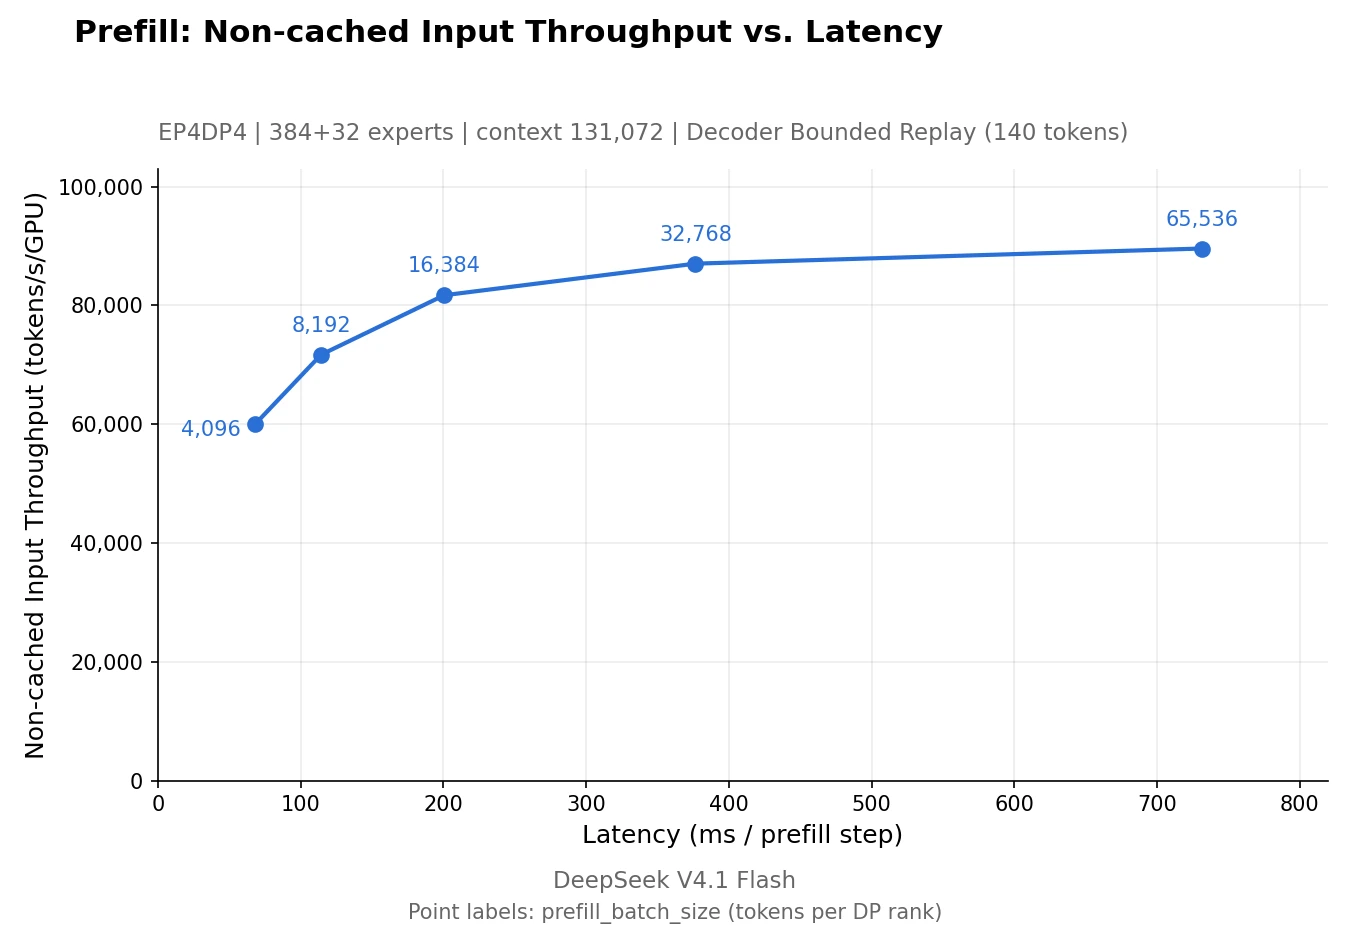
图 3:prefill 非缓存输入吞吐 vs 单步延迟(EP4DP4,131,072 上下文,解码器有界重放 140 token)。
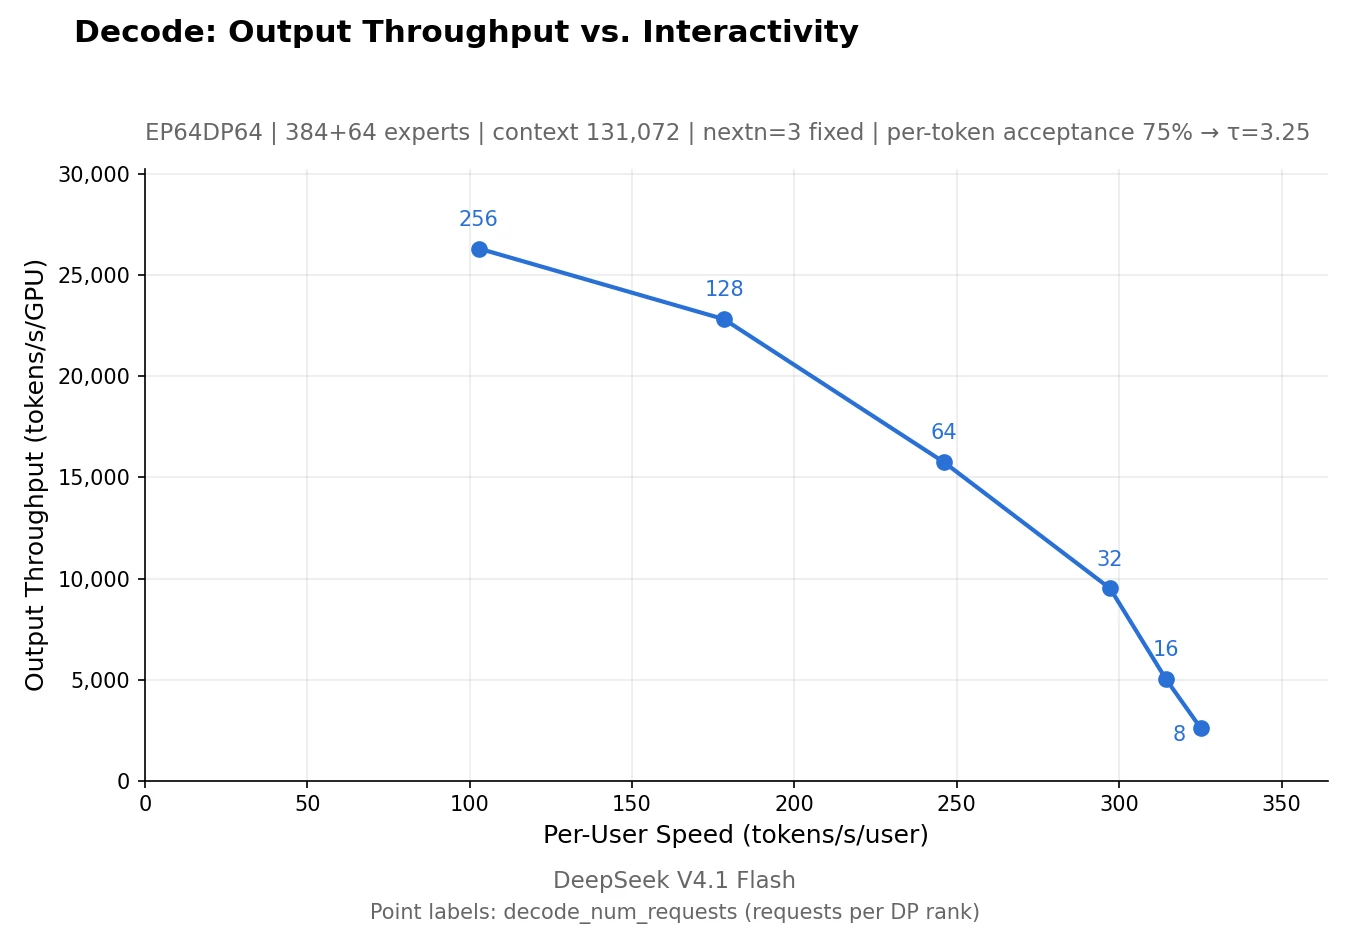
图 4:decode 输出吞吐 vs 每用户速度(EP64DP64,131,072 上下文,nextn=3,接受率 75%)。
评测侧仓库提供了 AIME 2026、HLE、GPQA Diamond 三个基准的离线批量评测脚本,生成与打分分两阶段,参考 Pass@1 为 AIME 2026 99.9%、GPQA Diamond 93.4%、HLE-Full 42.6%。
有两处细节值得一提,因为它们是官方主动交代的短板。内核方面,官方承认内部版本的 FlashMLA 少了一个手工调优的 SASS 优化,解码内核慢 5%–10%,但端到端性能最多相差 5%。负载均衡方面,DeepSeek 自己的生产系统大约达到「完美均衡的离线基准」的 80%。
核心总结
- 开源内容:DeepInfer 是驱动 DeepSeek V4.1 Flash 线上服务的推理框架,Apache 2.0;同批开源的还有 Rust 实现的 deepseek-recipe(MIT)
- 未开源部分:KV 缓存系统、VE/Prefill/Decode 分离部署、跨 DP 副本负载均衡——本次发布只覆盖离线推理
- 规模与硬件:单集群日处理 155 万亿 token;支持 NVIDIA SM100 与华为昇腾 950,当前仅支持 V4.1-Flash
- 并行策略:prefill 用 EP2–8/DP2–8,decode 用 EP64–128 的 Wide-EP,不用 TP/CP;最小高效部署单元为 64 卡 prefill 加 64 卡 decode
- 缓存设计:block KV 进专用 3FS 集群(约 100 PiB,TTL 智能体 3 天 / 聊天 7 天),SWA KV 留在本机内存并按 128 token 粒度存储
- 两项关键机制:SWA 有界重放把重算成本压成与上下文长度无关的常数,解码器侧几乎把 prefill 计算量减半;DSpark 动态长度验证在生产工作点带来 4%–7% 吞吐提升
- 参考成绩:AIME 2026 99.9%、GPQA Diamond 93.4%、HLE-Full 42.6%(Pass@1)
原文:DeepInfer(DeepSeek-AI,GitHub)
参考:
- DeepSeek V4.1 Flash Inference Deployment Q&A(DeepSeek-AI)
- deepseek-recipe(DeepSeek-AI,MIT 许可)
- DeepInfer 评测说明 eval/README.md


