10 月 15 日,Meta Superintelligence Labs 发布 Muse Spark Open 的开源权重版本:816B 总参数、每 token 激活 42B 的稀疏 MoE 模型,支持 100 万 token 上下文,原生接受文本、图像、视频与音频输入并输出文本。Meta 称其为「迄今为止最强的美国开源权重模型」。
对开发者来说,这次发布的看点不只是参数表,而是部署门槛:NVFP4 版本可以跑在 2 台 Apple M5 Ultra Mac Studio 上,这是同量级模型第一次落到桌面。这也是 10 月 12 日发布的前沿模型 Muse Wonder 之外,Meta 在开源侧的一次正面出击。
模型规格
据模型卡,Muse Spark Open 共 62 层,且每一层都是 MoE 层,隐藏维度 8192;每层 256 个专家,每 token 按 top-k 路由激活其中 8 个。注意力采用分组查询(GQA),128 个查询头配 16 个 KV 头。词表 202,048,训练数据覆盖 100 多种语言。推理深度由 reasoning_effort 控制,可选 low、medium、high、xhigh,默认 xhigh。
权重的分布也值得一看:
| 组成部分 | 规模 |
|---|---|
| 每层 256 个专家 | 799 B |
| 注意力 | 13.5 B |
| MoE 隐层投影(pooler / unpooler) | 4.2 B |
| 词嵌入与输出层 | 3.3 B |
| 视觉塔(独立) | 1.9 B |
除此之外还有一个独立的感知编码器(Perception Encoder)处理视觉输入,以及一个体积很小的音频编码器。按 vLLM 团队的 Day-0 解读,音频以 24 kHz 原始波形读取,每 1,920 个采样点(约 80 毫秒)经若干变换变成 1 个 token,整个音频编码器只有 1.18 亿参数。需要注意的是,视频自带的音轨不会被处理——想同时给模型看画面和听声音,要把视频与抽出的音频作为同一请求里两个独立的内容块发过去。
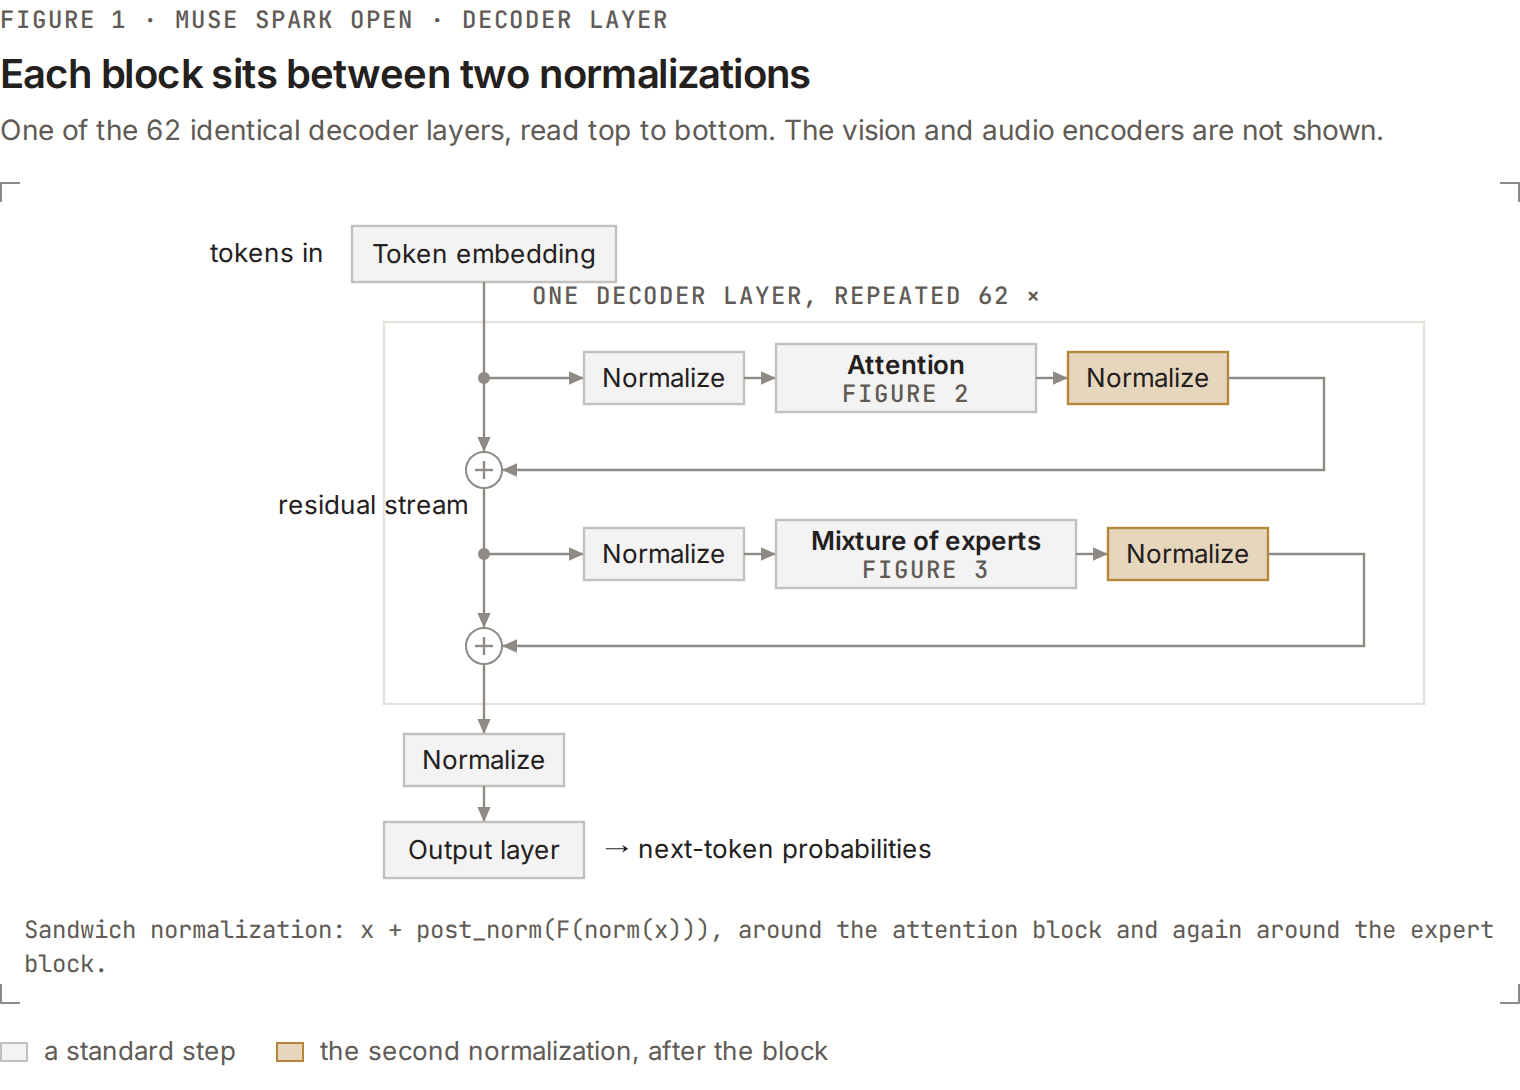
图 1:文本解码器 + 视觉塔 + 音频编码器的整体结构(图源:vLLM)。
架构上值得细看的三处
三明治归一化。多数解码器只在每个块之前放一层归一化,即 x + F(norm(x));Muse Spark Open 沿用 Muse Glimmer 的做法,在块的前后各放一层,像两片面包夹住中间的块:x + post_norm(F(norm(x)))。
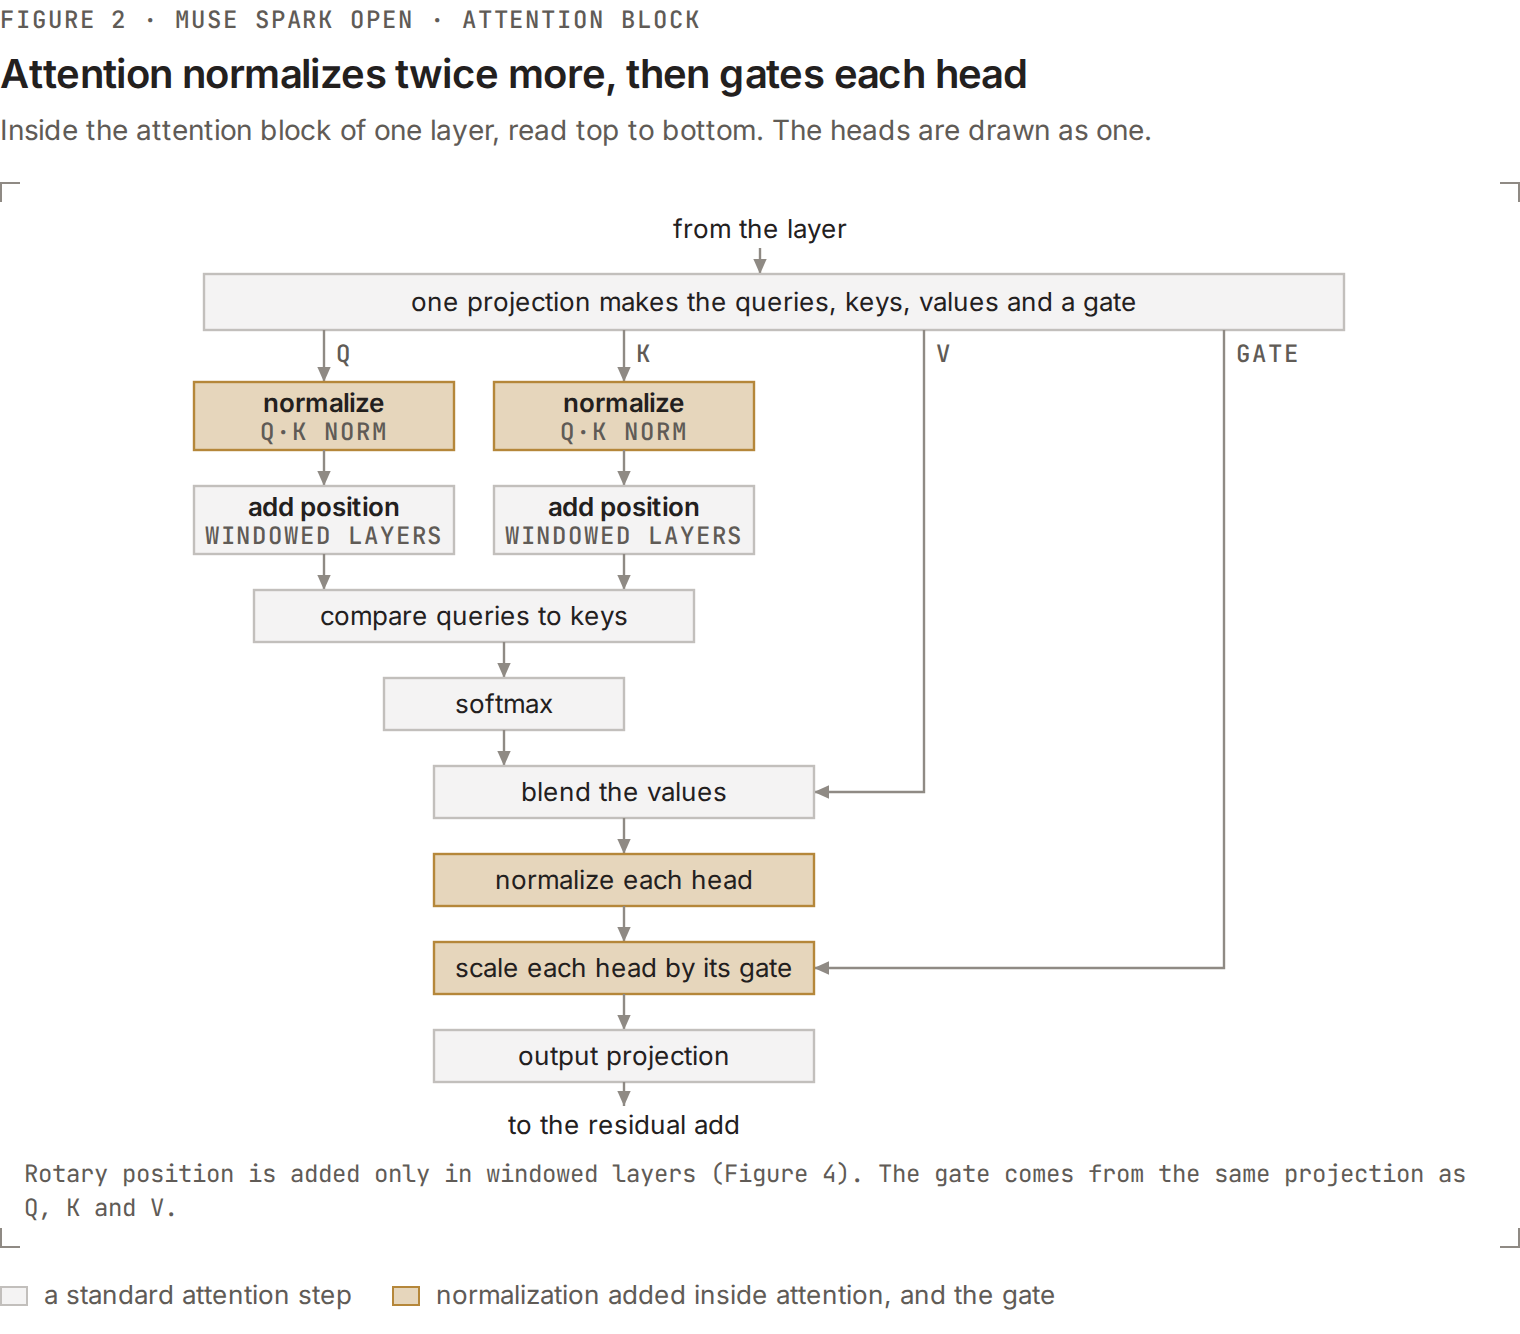
图 2:块前后各一层归一化(图源:vLLM)。
Latent MoE。每个 MoE 层多带两个由该层 256 个专家共享的矩阵,代码里叫 pooler 与 unpooler,实际都是学出来的投影:pooler 是一个 8192 × 4096 的矩阵,在 token 进入专家之前把宽度减半,unpooler 之后再把宽度还原。专家因此全程在 4096 维度上工作,两个专家投影层所需参数实际上减半。
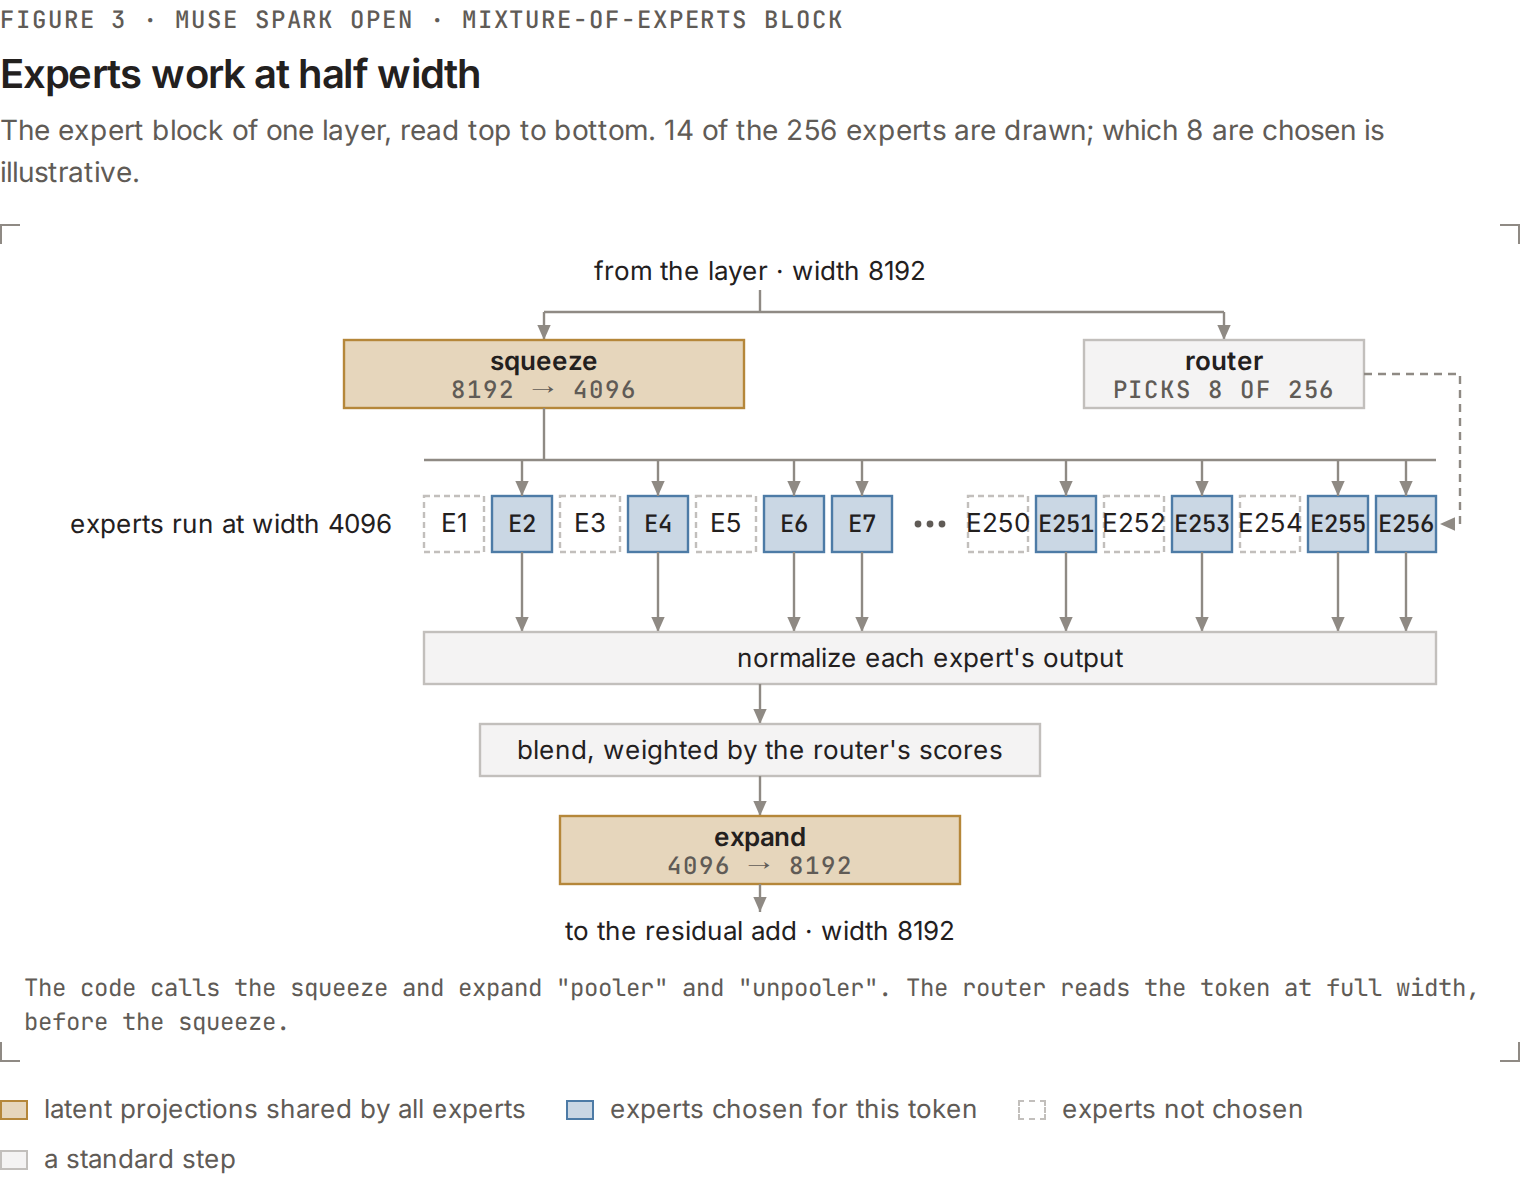
图 3:pooler 把 token 宽度从 8192 压到 4096,unpooler 在专家之后再还原(图源:vLLM)。
混合注意力。各层在全注意力与滑动窗口注意力(SWA)之间按 4 层一循环切换:其中三层只看 2048 个 token 的窗口,第四层看整个上下文,且这个循环锚定在模型末段,保证最后一层永远是全注意力。62 层下来得到 46 个窄层与 16 个宽层,窄层只保留最近的 KV。在 100 万 token 时,KV 缓存只有全注意力方案的四分之一多一点——这正是百万上下文的成本来源。
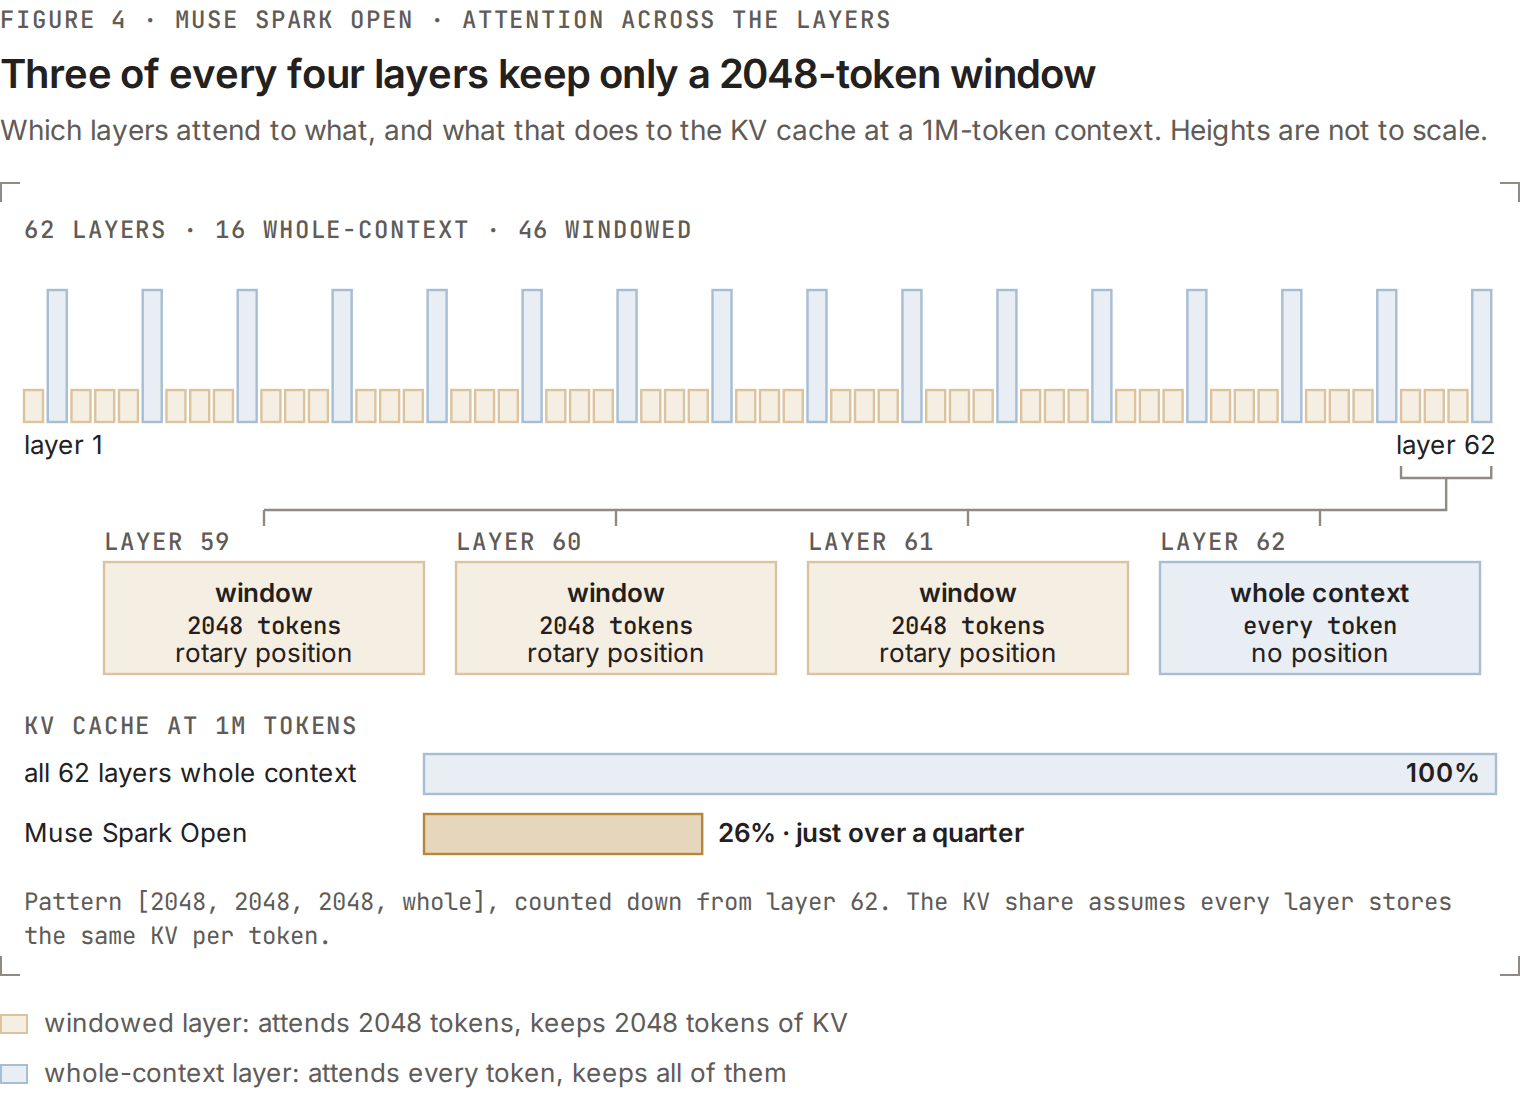
图 4:4:1 的混合注意力循环让百万级上下文的 KV 缓存降到全注意力方案的四分之一上下(图源:vLLM)。
基准:工具使用强,编码是短板
Meta 在最高推理档下,把 Muse Spark Open 与 Kimi K3、GLM 5.3、Qwen3.8-2.4T-A95B 放在一起比较。
| 项目 | Muse Spark Open | Kimi K3 | GLM 5.3 | Qwen3.8-2.4T-A95B |
|---|---|---|---|---|
| 总参数 | 816B | 2.8T | 753B | 2.4T |
| 激活参数 | 42B | 104B | ~40B | 95B |
| 上下文 | 1M | 1,048,576 | 1,048,576 | 262,144 原生 |
| 输入模态 | 文本、图像、视频、音频 | 文本、图像、视频 | 文本 | 文本 |
| AA 智能指数(Meta 引用) | 39 | 44 | 45 | 40 |
| Terminal-Bench 2.1 | 76.4 | 85.0 | 83.9 | 82.0 |
| MCP-Atlas | 89.2 | 82.3 | 84.2 | 84.5 |
它的强项集中在工具使用与知识可靠性:MCP-Atlas 89.2 高于 Qwen3.8(84.5)与 GLM 5.3(84.2);JobBench 61.8 略微领先 GLM 5.3(61.4);不带工具的 HLE-Diamond 为 26.1,Kimi K3 是 22.2;带工具的 ZeroBench 为 50.0,Kimi K3 为 41.0。
编码则是明显弱项:在 Terminus 2 执行框架下的 Terminal-Bench 2.1 上,它拿到 76.4,落后 Kimi K3(85.0)、GLM 5.3(83.9)与 Qwen3.8(82.0)。Artificial Analysis 智能指数为 39,也低于 GLM 5.3(45)、Kimi K3(44)与 Qwen3.8(40)。
换句话说,「美国最强开源」这个说法站得住,但整体上中国开源模型仍然领先。还要注意,对比表中部分对手的成绩由厂商自报,Meta 在评测方法说明里列出了每一项的来源。
需要什么硬件
BF16 权重约 1.6 TB;NVFP4 只量化专家,体积降到约 530 GB。模型卡建议 NVFP4 至少准备 700 GB 显存,BF16 则需要 2 TB。三条部署路径:
- 数据中心:NVFP4 跑在 4 张 Blackwell Ultra 或 8 张 H200 上。
- 桌面:2 台各 512 GB 统一内存的 M5 Ultra Mac Studio,通过 Thunderbolt 5 与 RDMA 互联。Apple 的统一内存架构让 M5 Ultra 的集成 GPU 可用到 512 GB,两台合起来装下整个模型;芯片 1.2 TB/s 的内存带宽足以读取每个 token 需要的那一小片。MLX 的张量并行把每一层切分到两台机器上,结果是「两台 Mac Studio 表现得像一台拥有 1 TB 统一内存的超级计算机」。
- 工作站:Unsloth 的动态 GGUF 量化到 2 bit 后,合计约 300 GB 内存即可装下。
Meta 还展示了纯本地跑智能体工作流的例子:用 Muse Code 驱动 Muse Spark Open,给开源 Mastodon 客户端 Ice Cubes 提交真实的 iOS 改动(修 bug、加功能、完整构建),以及端到端驱动 DaVinci Resolve,逐帧检查素材、挑出最精彩的片段并裁成竖版。
推理侧:Day-0 引擎与投机解码
权重发布当天,SGLang、vLLM、TensorRT-LLM、Hugging Face Transformers、MLX、llama.cpp 与 Unsloth 都已支持,并针对 AMD、Apple、Intel、NVIDIA 四种硬件做了优化。托管 API 则有 Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter 与 Together AI;OpenRouter 上的价格为每百万输入 token 1.25 美元、每百万输出 token 4.25 美元。
Meta 为开源版提供了 SGLang 里可自动调优的 Helion GPU 内核,在 NVIDIA 与 AMD 上带来 1.03–3.95 倍的内核级加速,在 AMD MI350 上端到端提升约 3%。
投机解码方面有两个草案模型:SGLang 用 DFlash V2,vLLM 用 DSpark。vLLM 的 Day-0 支持由 Inferact 训练的 DSpark 草案模型提供,它用块扩散(block diffusion)在一次前向里提出最多 7 个草案 token,并用基于置信度的调度让大步长下仍然保持收益——这正是投机解码传统上收益递减的场景。草案过程还复用模型的滑动窗口注意力,让 100 万上下文下的起草依然轻量。
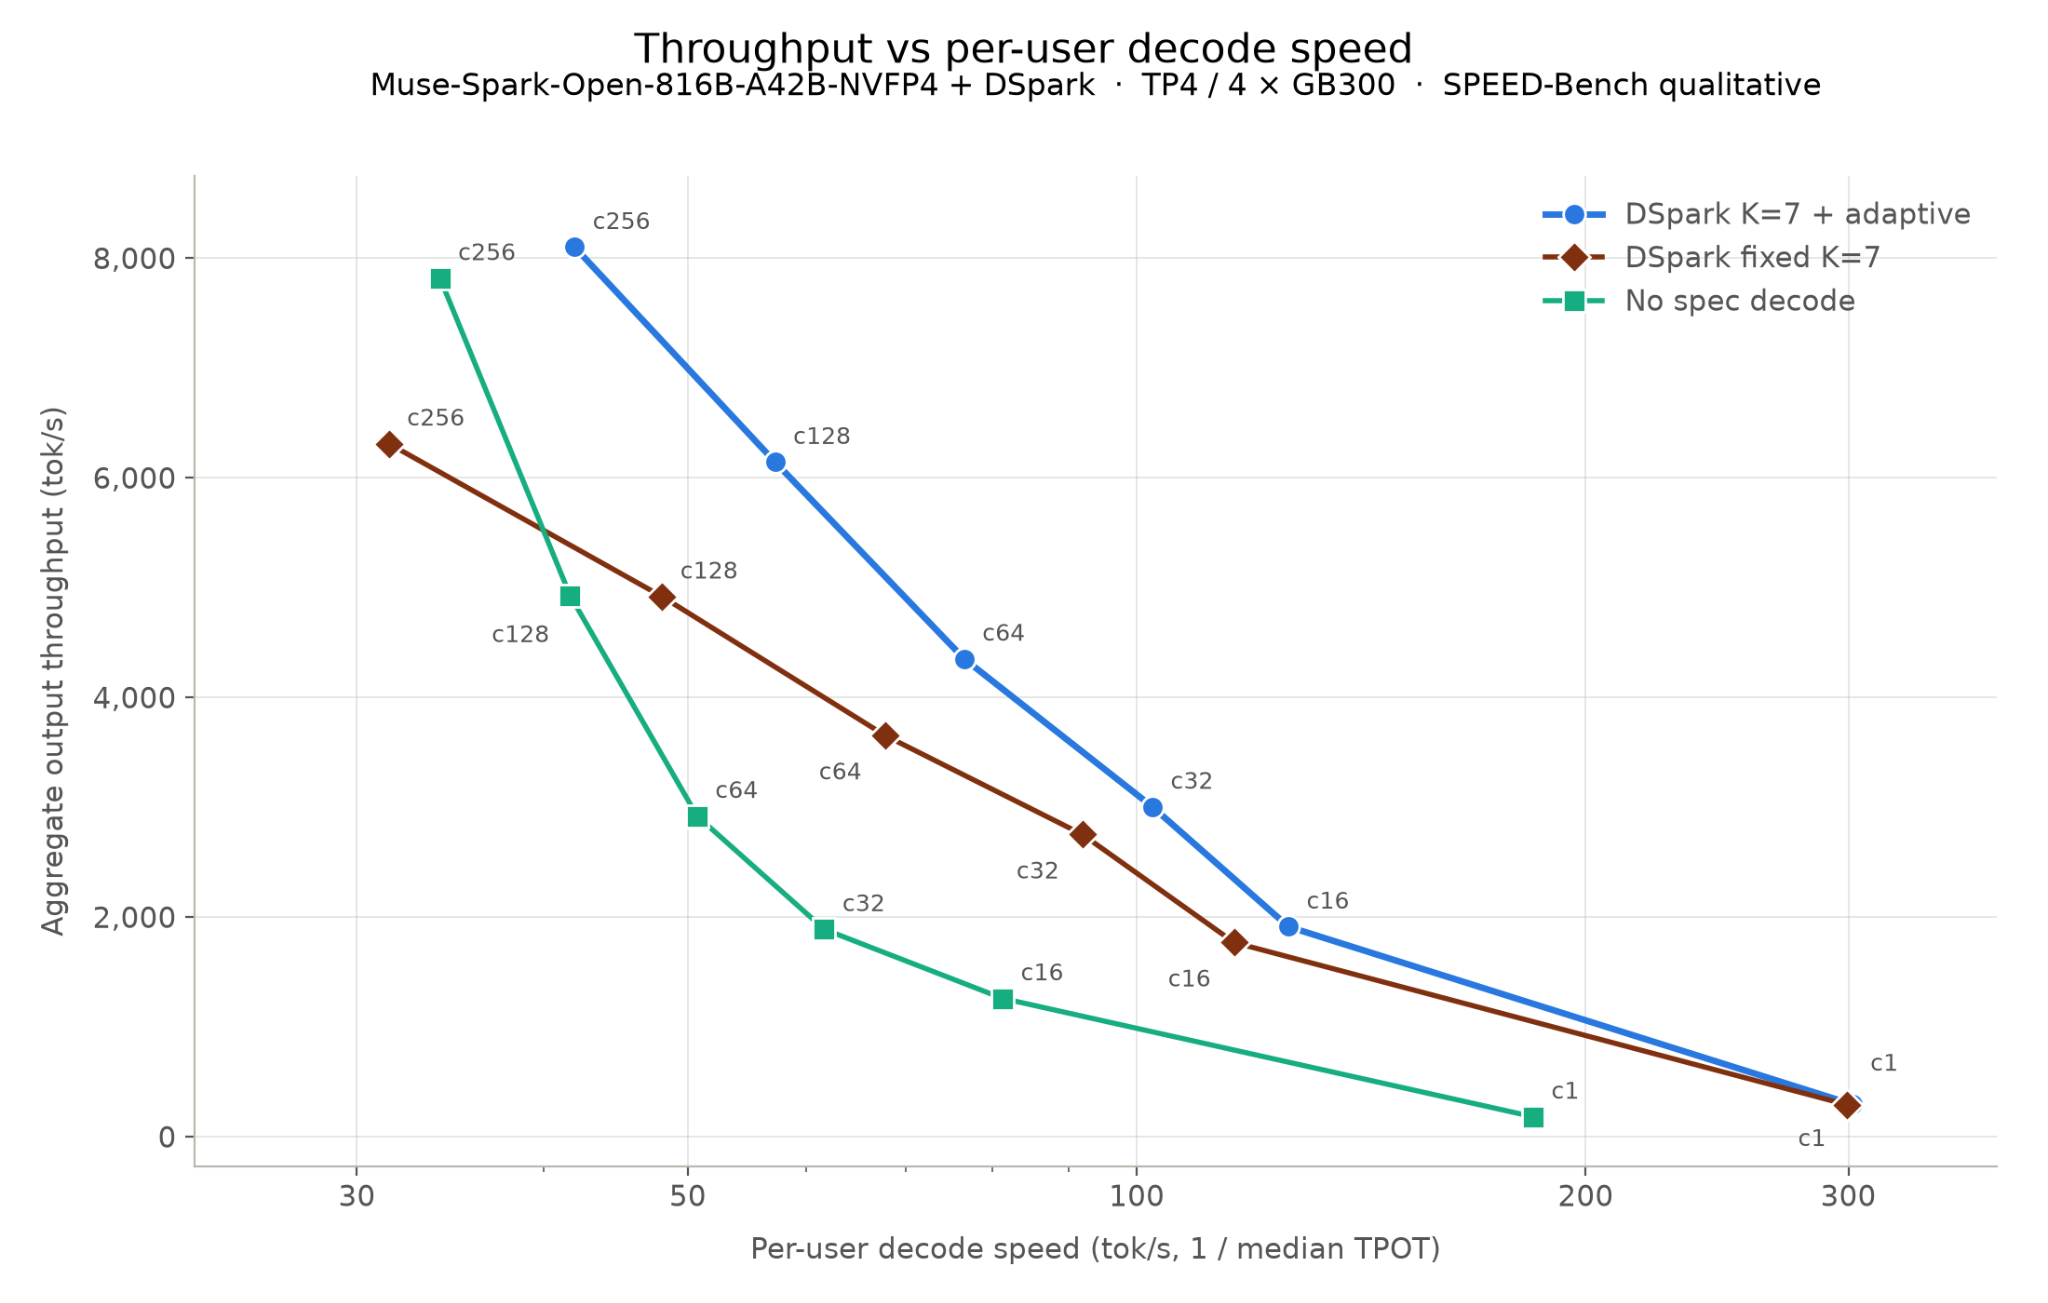
图 5:DSpark 在不同批大小下的加速结果(图源:vLLM)。
其他平台也一并跟进:AMD 在 MI355X 上同时支持 FP8 与 MXFP4,ROCm 侧已支持张量并行与流水线并行;TPU 侧基于 TorchTPU 构建了 megakernel,配合 DSpark(接受长度 6)在 4 颗 TPU v7 上超过 650 tokens/秒、8 颗上超过 960 tokens/秒,不用投机解码也分别有 270 与 350 tokens/秒。强化学习同样 Day-0:vLLM 作 rollout 引擎、Verl FSDP2 作训练器,只训练挂在 NVFP4 权重之上的 LoRA 适配器(rank 32、alpha 64),在 16 张 GB300 上用 GRPO 训 150 步,AIME-2024 的 mean@8 从 0.56 升到 0.85。
许可与安全
权重以 Muse Model License 发布:允许使用、微调、蒸馏与再分发,但有两条需要注意——产品必须展示「Built with Muse Spark Open」,以及 12 个月收入超过 2,000 万美元的模型即服务(MaaS)提供商需要与 Meta 单独签约。内部使用、研究以及用模型支撑自家产品功能不受收入条款限制。
安全性上,开源版本接受了额外的安全后训练,Meta 称这让模型在没有系统级护栏的情况下更稳健;评测按 Meta Superintelligence Scaling Framework 覆盖最高风险类别,达到了其发布阈值。
核心总结
- 发布:Meta Superintelligence Labs 开源 Muse Spark Open,816B 总参 / 42B 激活,1M token 上下文,原生支持文本、图像、视频、音频输入,输出文本
- 架构:62 层全 MoE、每层 256 专家激活 8 个、GQA 128 查询头配 16 KV 头;三明治归一化、Latent MoE 隐层压缩、4:1 混合滑动窗口注意力把 1M 上下文的 KV 缓存压到全注意力的四分之一
- 强项:MCP-Atlas 89.2、JobBench 61.8、带工具 ZeroBench 50.0、HLE-Diamond 26.1,工具使用与知识可靠性领先
- 短板:Terminal-Bench 2.1 仅 76.4,落后 Kimi K3(85.0)、GLM 5.3(83.9)、Qwen3.8(82.0);AA 智能指数 39 也低于这三者
- 部署:BF16 约 1.6 TB,NVFP4 约 530 GB;数据中心用 4 张 Blackwell Ultra 或 8 张 H200,桌面用 2 台 M5 Ultra Mac Studio,工作站用 Unsloth 2-bit GGUF 约 300 GB
- 生态:Day-0 支持 SGLang、vLLM、TensorRT-LLM、Transformers、MLX、llama.cpp、Unsloth;vLLM 侧 DSpark 草案模型一次前向提 7 个 token,AMD MI355X 支持 FP8 与 MXFP4;API 每百万输入 1.25 美元、输出 4.25 美元
- 许可:允许使用、微调、蒸馏与再分发,需标注「Built with Muse Spark Open」;年收入超 2,000 万美元的 MaaS 提供商须单独签约
这次发布最值得留意的两点:一是「能跑」本身成了卖点——把 816B 的多模态模型塞进两台桌面机器,靠的是 NVFP4 只量化专家、混合注意力压缩 KV,以及 MLX 的层间张量并行这三件事叠加;二是 Meta 自己的评测表就说明了定位——它抢下的是「美国开源最强」这个位置,而不是开源整体的第一,编码能力与智能指数都还落后中国开源模型一档。
原文:Meta Releases Muse Spark Open: 816B Open-Weight MoE With 1M Context(MarkTechPost,2026-10-15)
参考:
- Introducing Muse Spark Open, The Most Capable US Open-Weight Model to Date(Meta AI Research,2026-10-15)
- Muse Spark Open 模型卡与权重(Hugging Face)
- Day 0 support for Muse Spark Open on vLLM(vLLM Blog,2026-10-15)
- Muse Spark Open 评测方法说明(Meta)
- Build with Muse Spark Open:开发者指南(Meta)


