10 月 15 日,SGLang 团队发布博客,公布推理引擎 SGLang 与强化学习训练栈 Miles 对 Muse Spark Open 的 Day-0 支持。这是 816B 总参 / 42B 激活的多模态 MoE 模型,支持 1M token 上下文与文本、图像、视频、音频输入。
模型本身的规格已经在发布时被讲过一遍。这篇博客的价值在另一半:它把这个模型的架构对推理栈有多不友好,一条一条拆开讲清楚了——从 KV 缓存布局到专家输出的归一化顺序,再到权重在显存里的排布。对做推理优化的人来说,这是比参数表更有信息量的一份记录。
为什么这个模型不好伺候
Muse Spark Open 的 MoE 层在路由专家前后各加了一个学出来的投影:pooler 把 token 宽度压窄,unpooler 再还原。这套设计在单卡上没问题,但在张量并行(TP)下会出麻烦——每个 TP rank 都要把同一批 token 完整地过一遍 pooler、unpooler 和边界归一化,算力白白重复。
第二个麻烦是归一化的顺序。每个被选中的专家,其输出要先做 RMSNorm,再乘路由权重、与其他专家求和。博客明确点出:如果改成对求和后的结果做归一化,模型的计算就变了。这决定了它不能套用现成的 MoE kernel——后置归一化必须在 combine 阶段完成。
再叠加混合注意力(滑动窗口与全局按 4:1 循环)与 1M 上下文,以及量化上的不一致:62 层里有 60 层用 NVFP4 专家,剩下 2 层(第 0 层与第 61 层)仍是 BF16。
序列并行 + NVFP4 MegaMoE
针对第一个麻烦,SGLang 把序列并行(SP)用在了 prefill 上。做法是把激活沿 token 维度切到各 TP rank:注意力输出处做一次 reduce-scatter,每个 rank 拿到约 S/P 个 token,但保留每个 token 的完整隐向量。归一化、路由、pooling 都在本地分片上做,去掉了重复计算与冗余的激活存储。
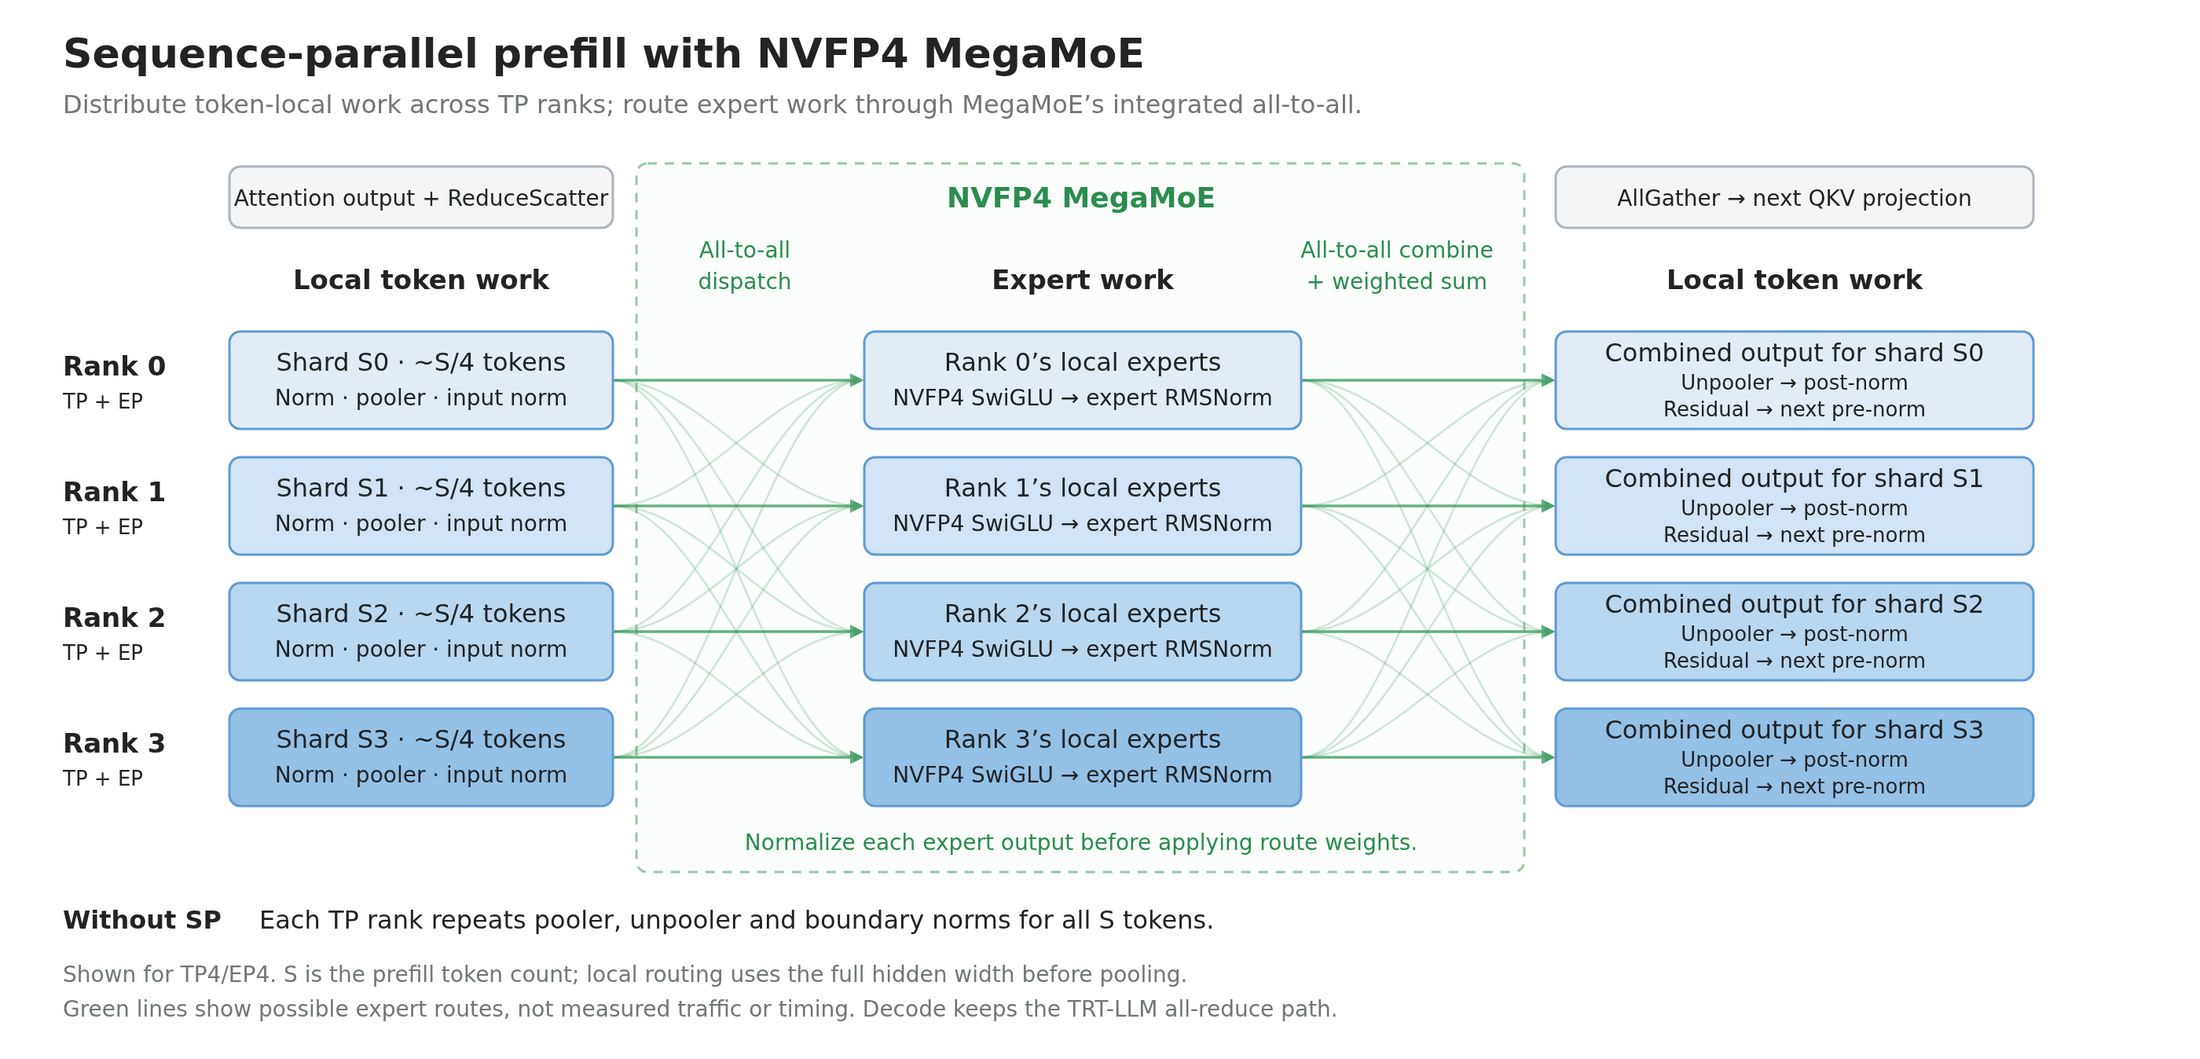
图 1:SP 负责把 token 本地的工作摊开,MegaMoE 负责把专家工作接上(图源:LMSYS)。
关键的一环是 DeepGEMM 的 MegaMoE:它把 dispatch、两次专家 GEMM、激活函数和 combine 融进一个常驻 kernel,跨 rank 传输走对称内存(symmetric memory),通信与计算重叠,不再需要单独发 all-to-all。它同时把序列并行与专家并行(EP)接了起来——dispatch 把 token 送到持有其目标专家的 rank,专家算完后先做 per-expert RMSNorm 再乘路由权重,combine 把完整结果送回 token 原本的 rank。
实测在 4 张 GB300 上(NVFP4 目标模型 + DFlash V2 草案、TP4/EP4、FP8 KV 缓存、16K prefill 分块),每档并发发 8 组请求、每组 8 条,共享 73,360 token 前缀:
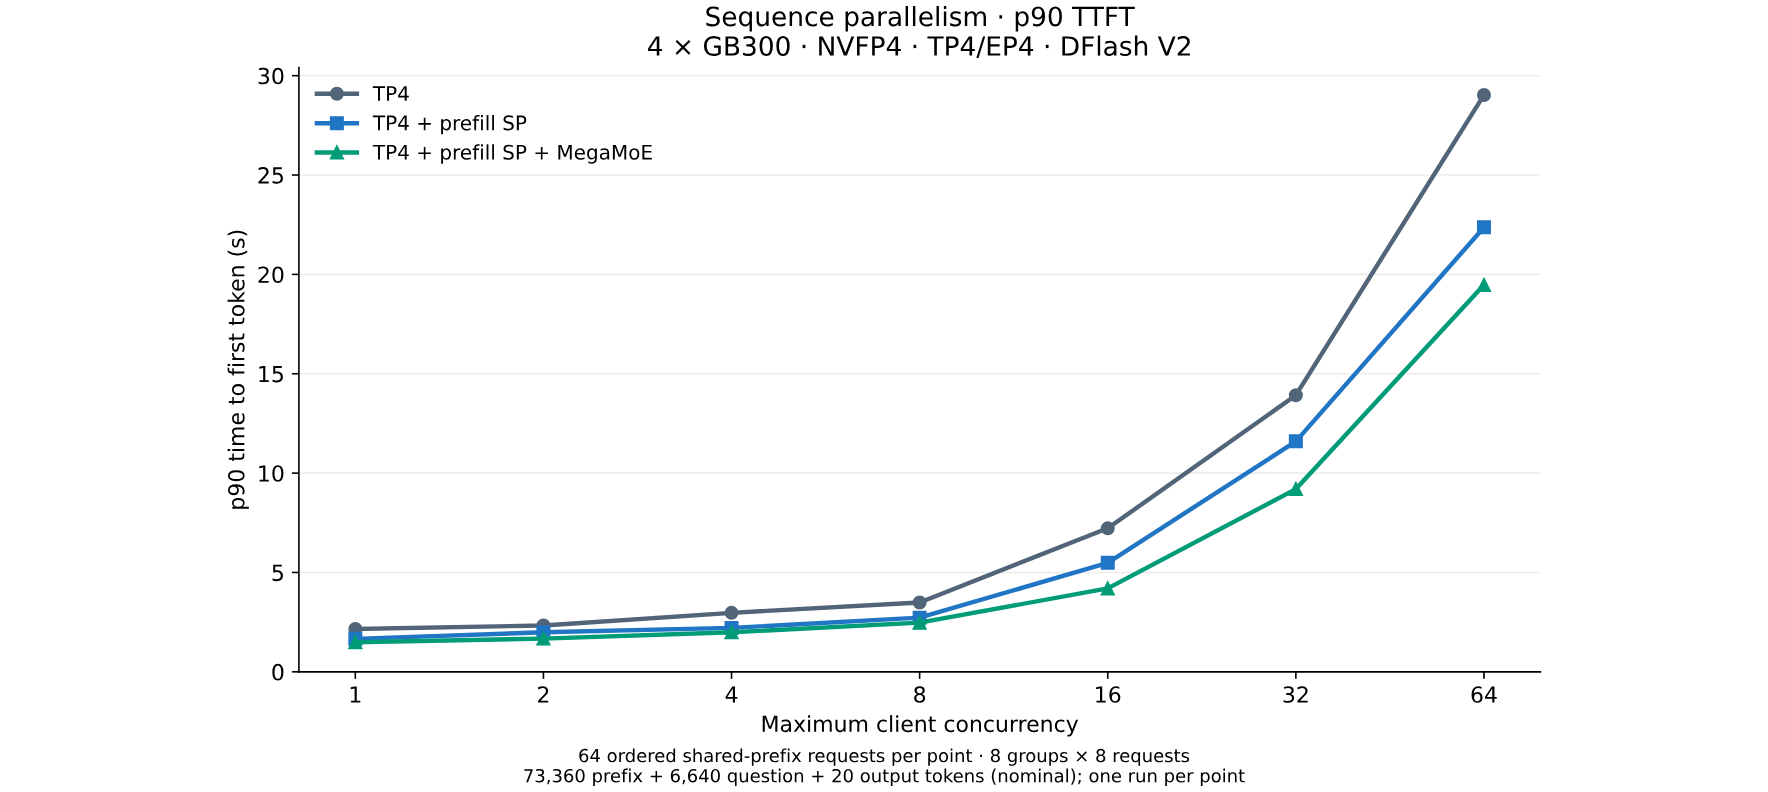
图 2:并发 64 时 p90 TTFT 从 29.03 秒降到 19.47 秒,降幅 32.9%(图源:LMSYS)。
七档并发下,SP + MegaMoE 相对纯 TP4 把 p90 TTFT 降低了 28.3% 到 41.9%。
内核优化:解码吞吐 3 倍
第二条线是常规但密集的内核工程。在 4× B300、TP4/EP4、批大小 1、8K 输入 / 1K 输出、不开投机的条件下,12 步优化把解码吞吐从 53.5 提到 161.6 tokens/秒:
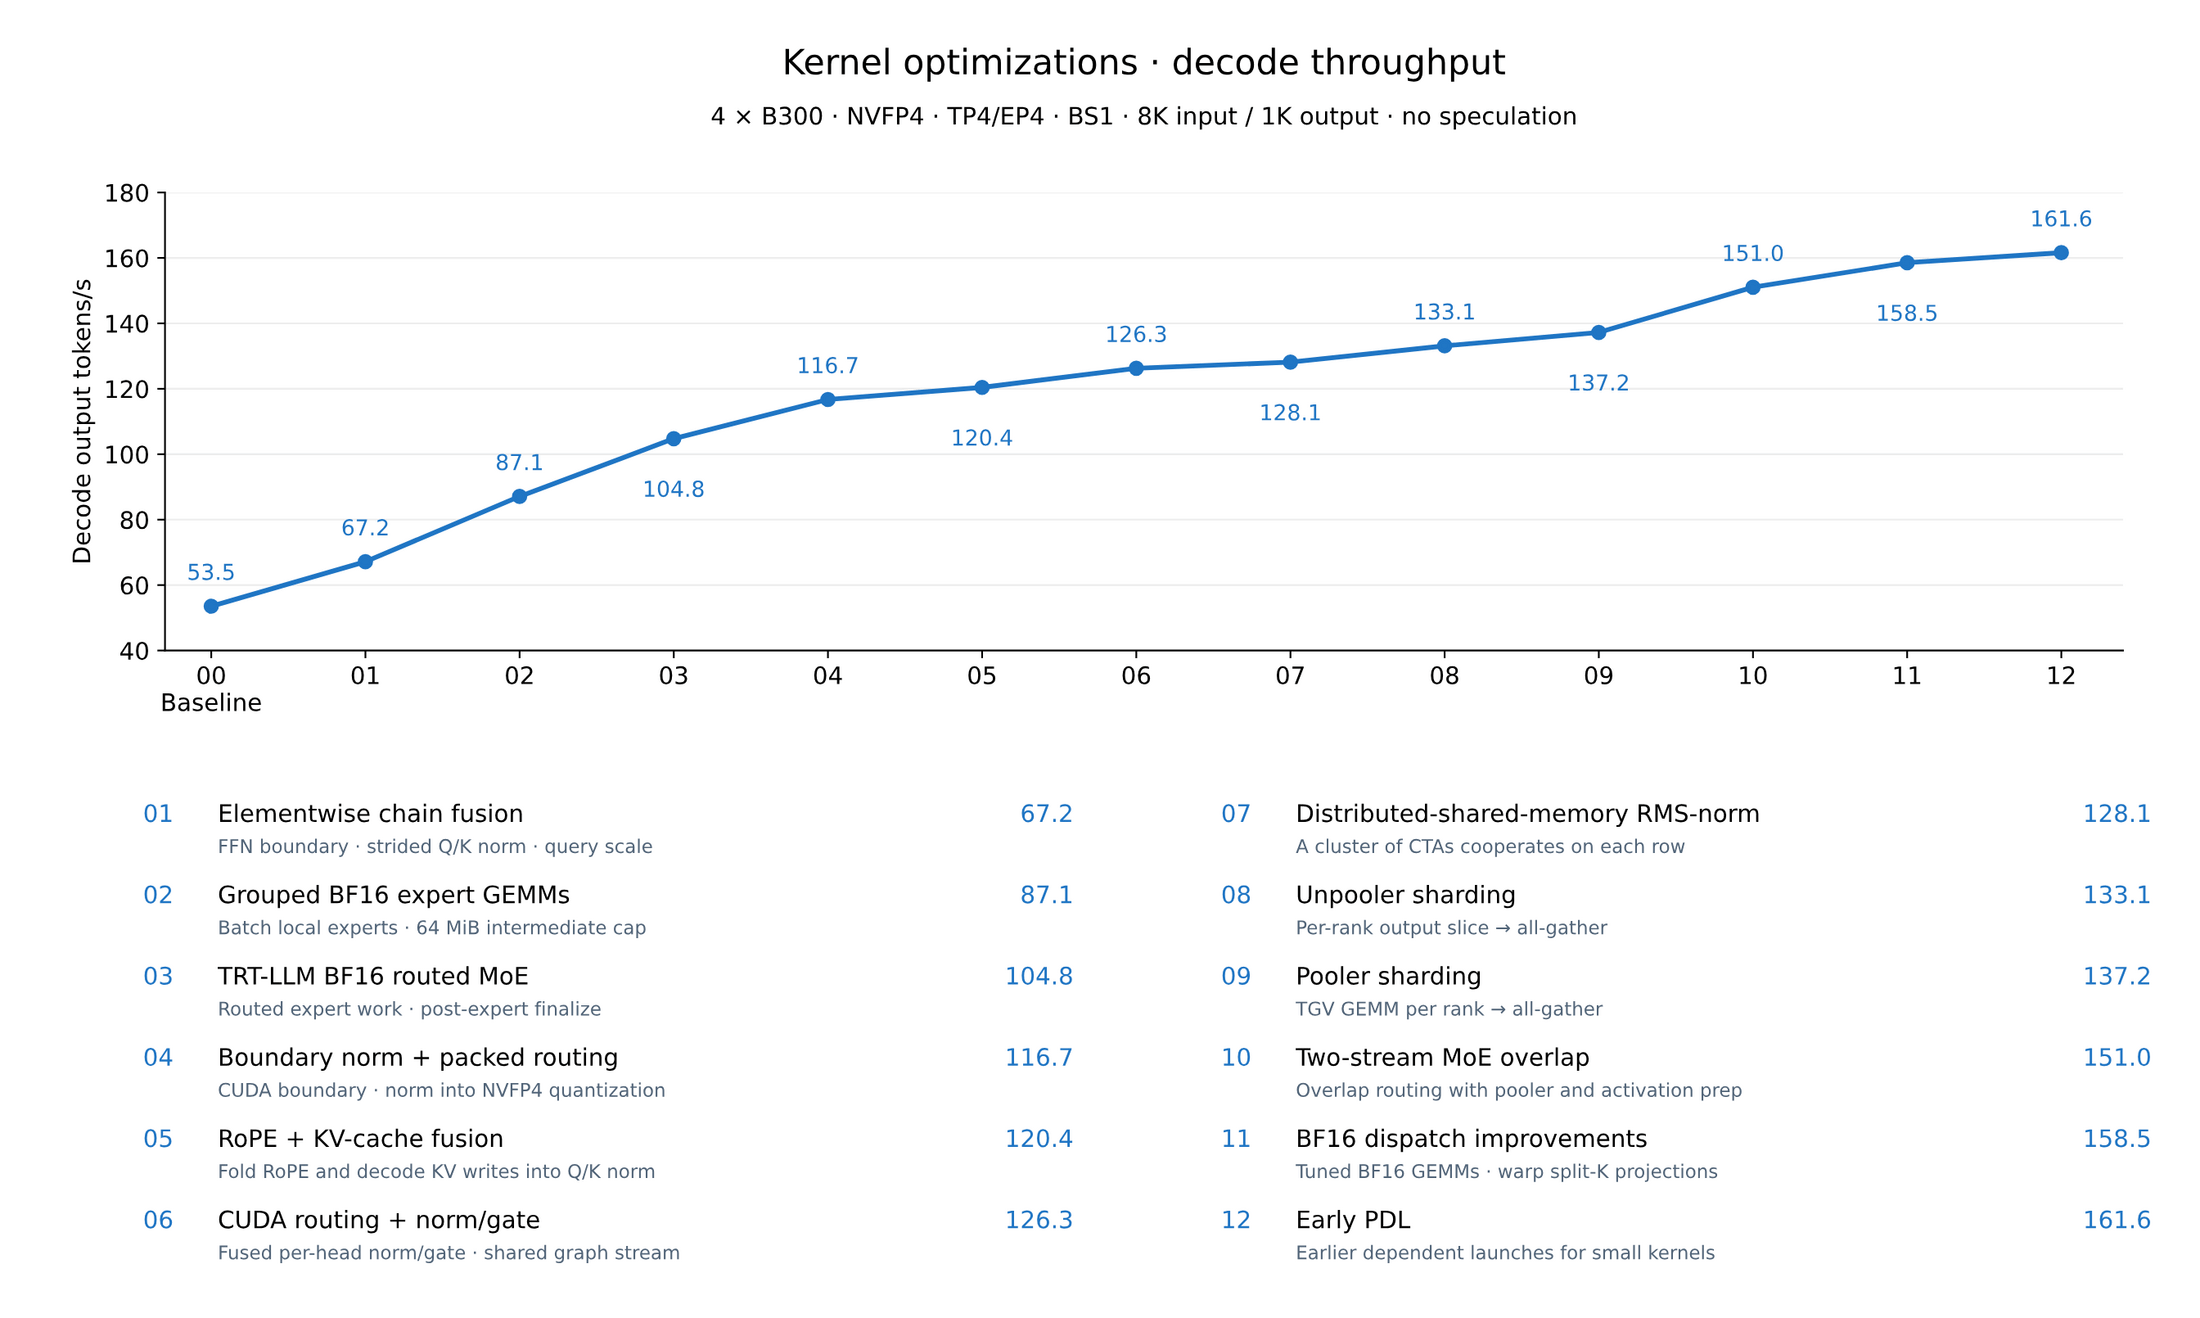
图 3:每一步的累计效果与对应做法(图源:LMSYS)。
几条值得单独拎出来:
- 元素级链条融合:把 FFN 后归一化、门控残差加法、注意力前归一化合成一个 kernel,Q/K 归一化直接用行跨距读融合后的 QKV 张量,省掉布局拷贝。
- BF16 专家循环分两步替换:先把 64 个本地专家批量成分组 GEMM(中间缓冲限制在 64 MiB),再换成 FlashInfer 的
trtllm_bf16_routed_moe只算被路由到的专家,后置归一化在加载时绑定到 finalize 上。 - pre-expert 归一化折进 NVFP4 量化:复用量化器的行访问,省掉一次独立的读写往返。
- RoPE 与 KV 缓存写入融合:Q/K 归一化同时施加 RoPE 并写解码 KV,消灭独立 kernel。
- pooler / unpooler 分片:这两个投影原本在每个 TP rank 上重复算完整矩阵,现在各自用 BF16 dispatcher 只算输出的一个切片,再 all-gather 拼回。
- 路由放旁路流:router GEMM 与 top-k 选择和 pooler、激活准备互不依赖,把路由放到旁路 CUDA 流上,直到专家执行前才汇合。
后置专家归一化怎么落地
最麻烦的一处细节是上面提到的归一化顺序。第二个 GEMM 会把一行隐向量摊到多个 CTA 上,它的 epilogue 拿不到完整的一行,算不出整行 RMS。SGLang 的做法是把归一化挪到 combine 阶段——但要避免为了算 RMS 再把整行专家输出读一遍。
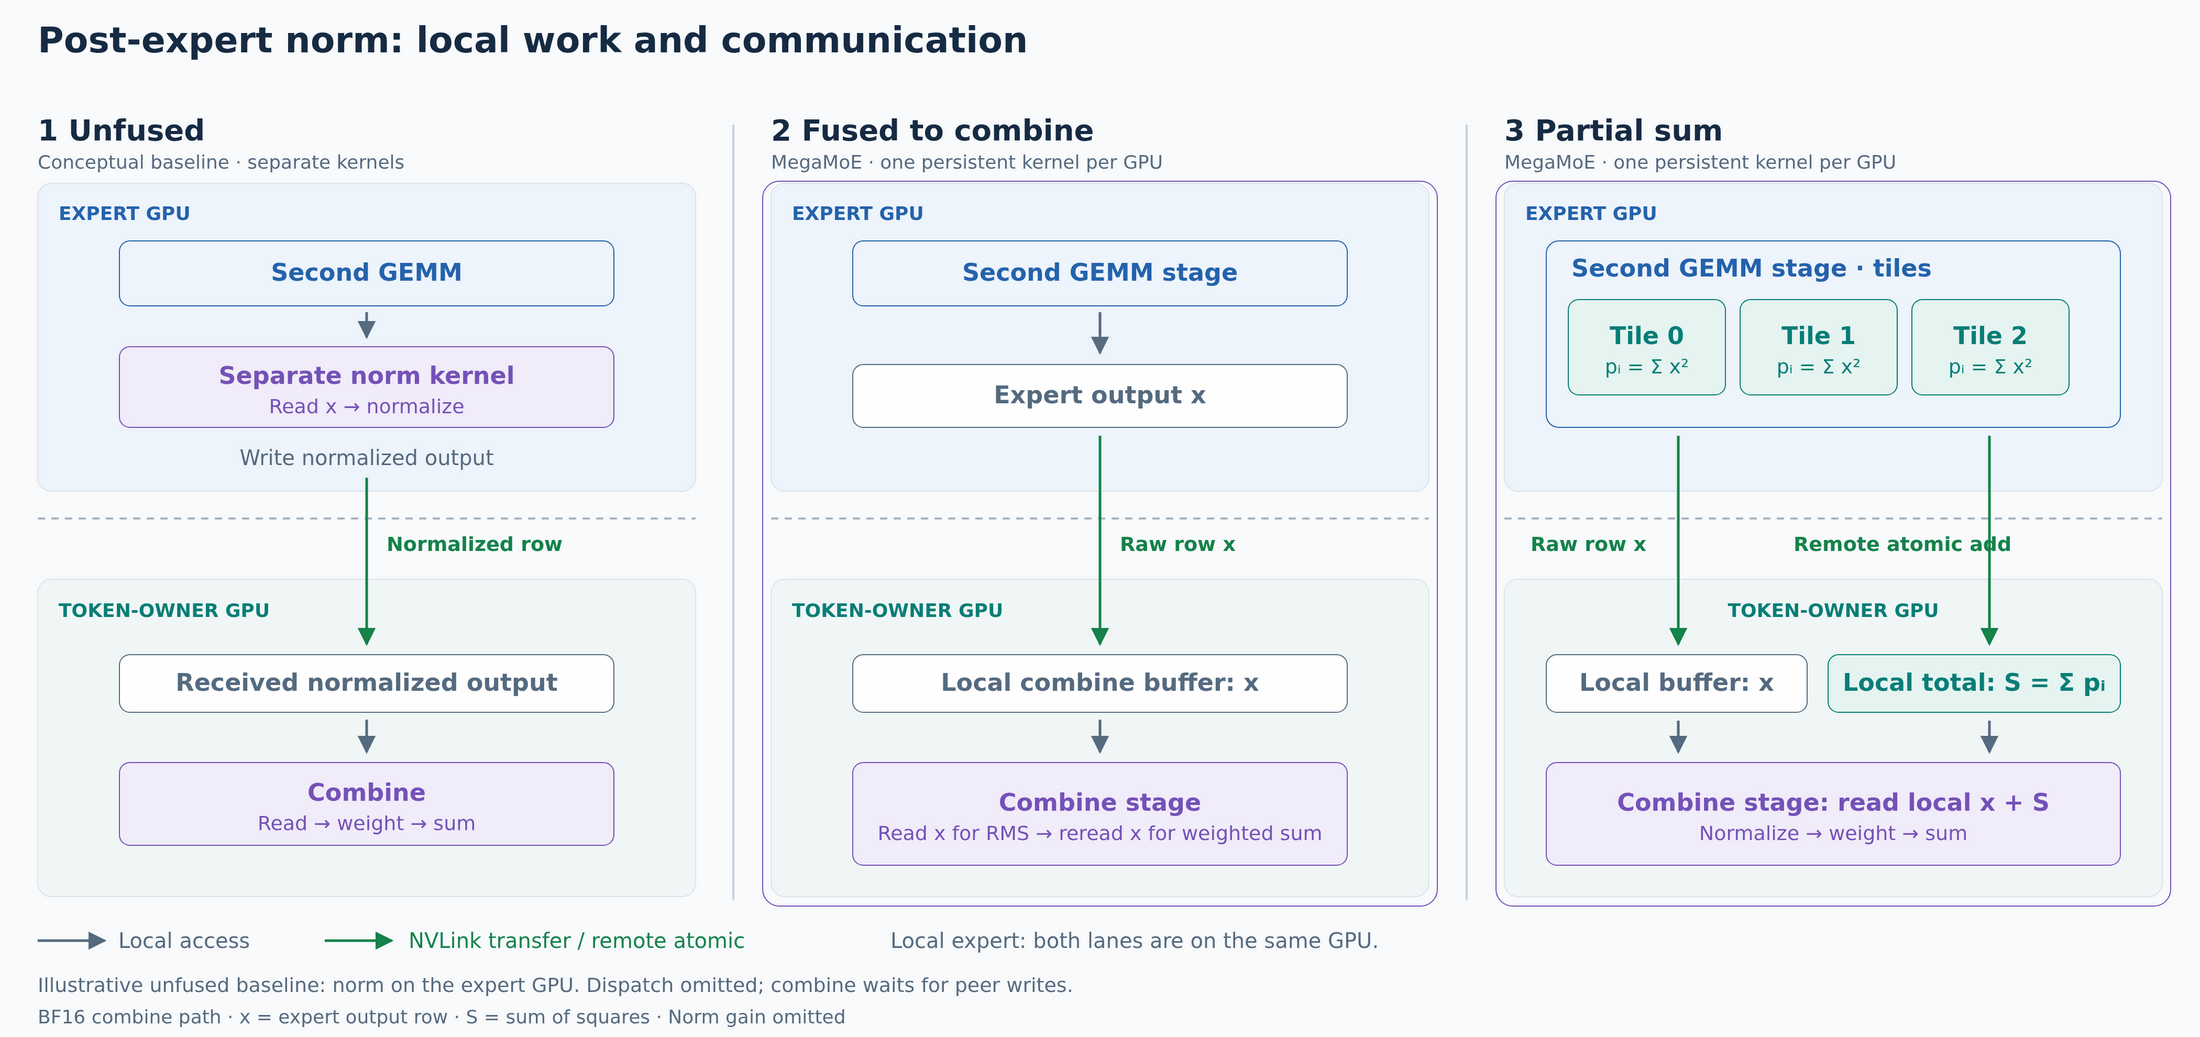
图 4:最终采用第三种,每个 tile 用寄存器里已有的 BF16 值累加部分平方和,原子累加到 token 所属 rank(图源:LMSYS)。
最终方案是:每个第二 GEMM 的 tile 从自己寄存器里已有的 BF16 值累加一个部分平方和,原子地累加到 token 的来源 rank 上,combine 时每个被选中的专家只需要读一个标量。
配套的还有两处硬件层面的工作。其一,NVFP4 被加进 MegaMoE 作为第三种 MMA 类型 nvfp4xnvfp4——与 MXFP4 不同,它用的是每 16 个元素一个 UE4M3 块缩放因子,而不是每 32 个元素一个 UE8M0。其二,MegaMoE 直接读 TensorRT-LLM 的常驻权重布局,两套后端共享同一份权重与缩放因子,不必在显存里存两份。
还有一个很小但很有意思的优化:两次 GEMM 之间,SwiGLU 的输出要重新量化成 NVFP4。原本每个 16 元素组用 __frcp_rn 算块缩放的倒数,而这是个带 MUFU 种子、牛顿迭代修正和特殊值处理的 IEEE 就近舍入操作。由于缩放因子只有 256 种编码,团队用一张 256 项的共享内存 FP32 倒数表替代了它——在 B300 微基准上,散乱访问约快 2.9 倍,warp 内一致访问约快 4.8 倍。
实测:两种智能体负载
博客给出的两组端到端数据都来自真实的多轮智能体负载,硬件是 8 张 B300、TP8/EP8:
| 负载 | 会话特征 | 并发 | 单卡吞吐 | 单用户交互性 |
|---|---|---|---|---|
| OpenHands 回放 | 首轮约 74K token,13 轮,每轮约 220 输出 token,前缀命中约 92% | 1 | 14.8K tok/s | 543 tok/s(p50) |
| OpenHands 回放 | 同上 | 128 | 80.3K tok/s | 61 tok/s(p50) |
| AgentX 回放 | SemiAnalysis 真实编码轨迹,前缀命中 96.9–98.0% | 48 | 34,509 tok/s | 73.0 tok/s(p90) |
| AgentX 回放 | 同上 | 1 | — | 457.8 tok/s(p90) |
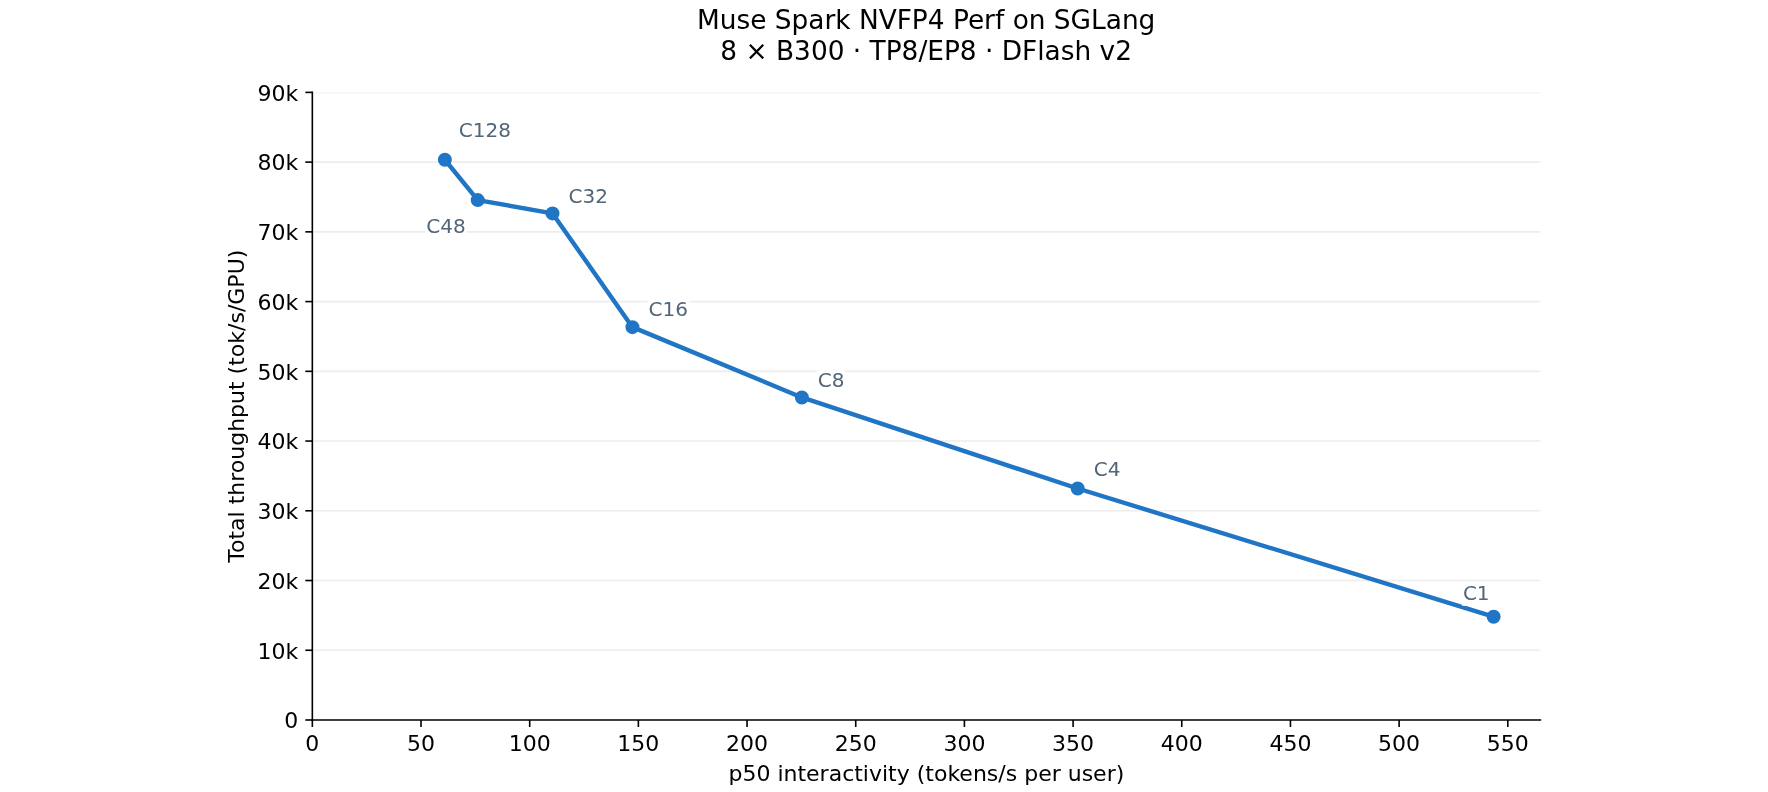
图 5:并发 1 到 128 的吞吐—交互性权衡(图源:LMSYS)。
这里有一个需要说明的地方:两组数据里的投机解码接受长度是固定的——OpenHands 用 SGLANG_SIMULATE_ACC_LEN=4.5,AgentX 用 4.16,而不是草案模型在真实文本上实测出来的。博客对此给出了理由:AgentX 保留真实轨迹的 token 数量与前缀结构,但提示词文本是合成的,草案模型在合成文本上的接受率没有参考意义,所以 4.16 这个值是从 80 条真实编码首轮提示(158–1,581 输入 token)上测出的 token 加权接受长度 1 + 96,198 / 30,415。把这一点写进附录而不是藏在脚注里,是这份记录比较可信的地方。
多平台与强化学习
AMD:8 张 MI355X、TP8/EP8 下,基线(triton 注意力 + triton MoE)在并发 4 到 32 之间是 2,384.71 → 12,396.21 tokens/秒;换成 aiter 注意力 + FlyDSL MoE(专家 GEMM 与 unpermute、per-expert RMSNorm、加权求和融成一个 kernel)后是 2,812.75 → 13,880.93;再叠加 DFlash V2 达到 4,544.71 → 17,081.46。精度上 GSM8K 在 97.42–97.95% 之间,GPQA Diamond 在 88.38–90.04% 之间,与 BF16 参考基本持平。
Intel:用 AutoRound 从 BF16 权重直接生成 INT4 只量化权重(WOQ)版本,配合 Xeon 的 AMX 加速滑动窗口注意力、BF16 GEMM 与 INT4 WOQ FusedMoE,定位是 Xeon 6 P-core 上的离线推理。
TPU:通过 SGLang-TorchTPU(原生 PyTorch 后端)首次给开源权重模型做 Day-0 支持,结合 RadixAttention 与 HiCache;具体配方「即将发布」。
强化学习:Miles 通过 Megatron-Core 后端支持全参数训练,完整保留了「每个专家输出先独立归一化、再按路由权重在 FP32 下求和」的计算顺序与精度边界。多轮 rollout 上集成了 TITO,并修掉了一个会追溯修改早前消息结束标记的模板行为。训练用 GRPO 跑 DAPO-Math-17K,64 张 H200 或 32 张 B300,每步 32 个提示各采样 16 条回复(共 512 条)。
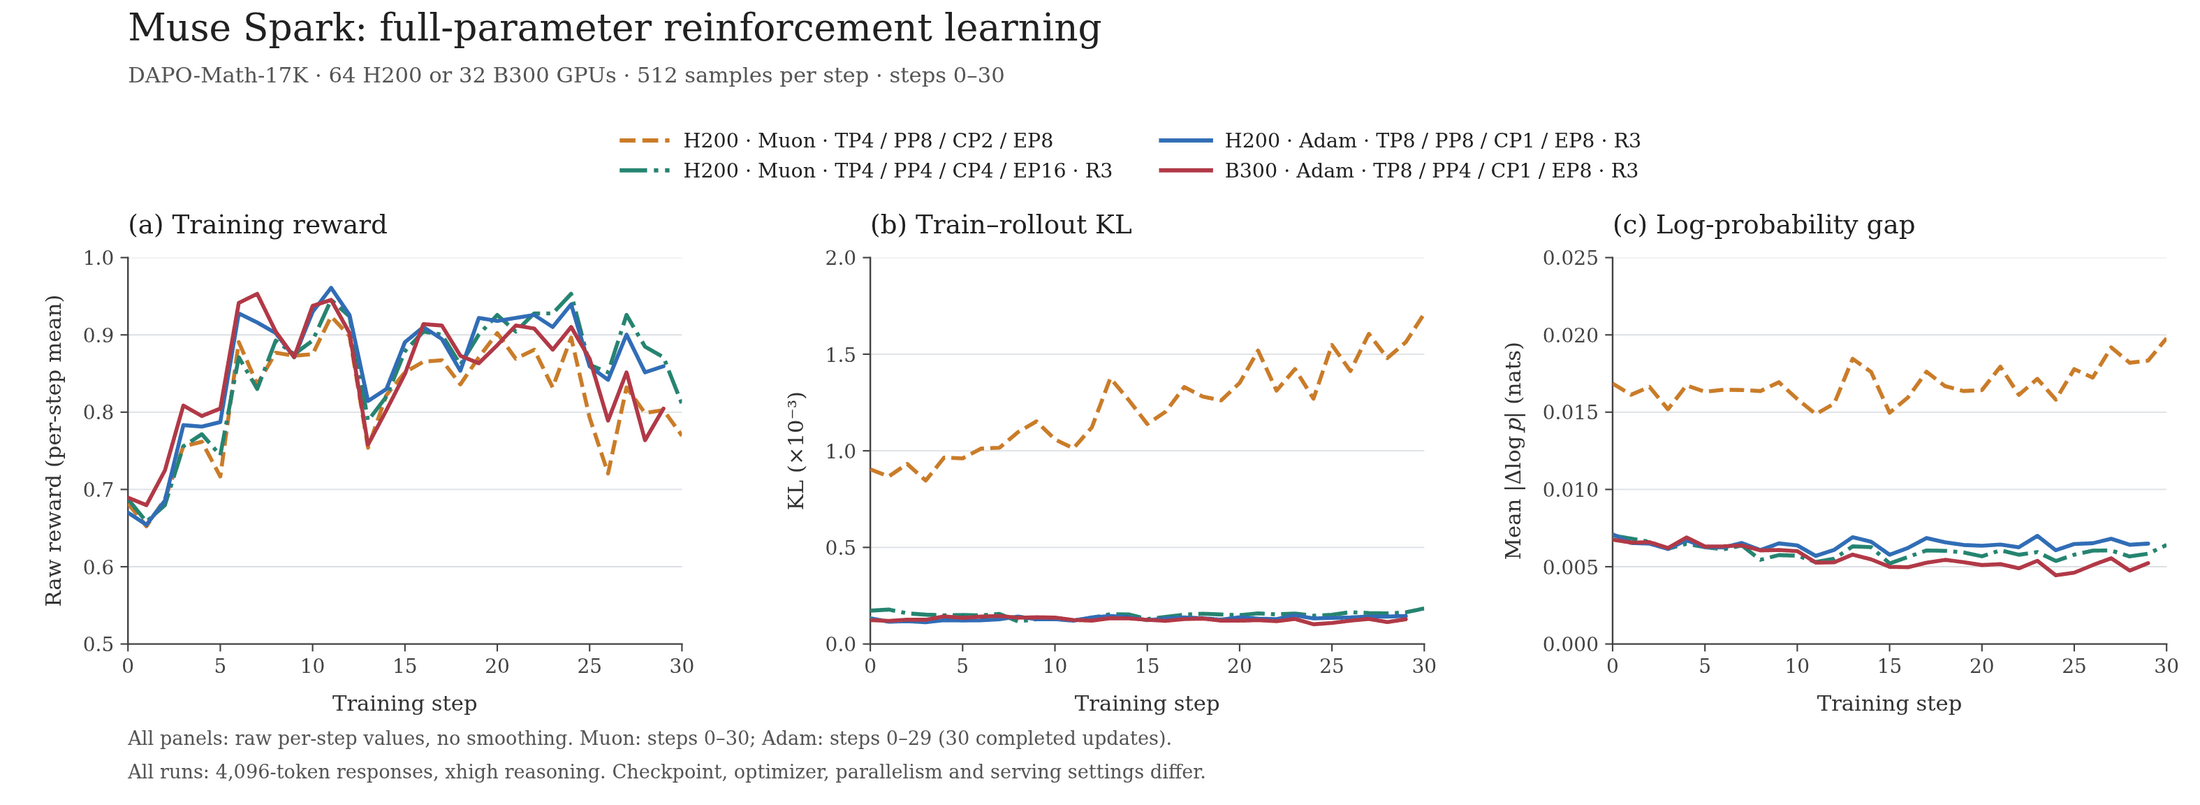
图 6:开启 R3 后 train–rollout 对数概率差降到 0.0044–0.0071,未开启的一组是 0.015–0.020(图源:LMSYS)。
值得记一笔的是 rollout routing replay(R3):训练时复用 rollout 阶段实际走过的专家路由,把训练与 rollout 之间的对数概率差从 0.015–0.020 压到 0.0044–0.0071,每次权重同步后所有 rollout 引擎的权重逐位一致。另有一个冻结 ViT 的 Geometry3K 视觉语言任务,30 次更新把测试准确率从 88.2% 提到 94.9%。
核心总结
- 发布:SGLang 团队公布 SGLang 与 Miles 对 Muse Spark Open 的 Day-0 支持,覆盖 NVIDIA、AMD、Intel、TPU 四条后端
- 序列并行:把激活沿 token 维切到 TP rank,消除 pooler / unpooler / 边界归一化在各 rank 上的重复计算;配合 NVFP4 MegaMoE 把 4× GB300 上的 p90 TTFT 降低 28.3–41.9%,并发 64 时从 29.03 秒降到 19.47 秒
- MegaMoE:把 dispatch、两次专家 GEMM、激活与 combine 融进一个常驻 kernel,走对称内存;新增
nvfp4xnvfp4作为第三种 MMA 类型,并直接复用 TensorRT-LLM 的常驻权重布局避免权重翻倍 - 归一化顺序:per-expert RMSNorm 必须在路由加权之前,因此挪到 combine 阶段;每个 GEMM tile 用寄存器内的值累加部分平方和并原子累加,combine 时每专家只读一个标量
- 内核优化:12 步把 4× B300 上的解码吞吐从 53.5 提到 161.6 tokens/秒;256 项共享内存倒数表让 NVFP4 重量化的缩放因子倒数计算快 2.9–4.8 倍
- 实测:8× B300、TP8/EP8 下,OpenHands 回放在并发 1 时达 14.8K tok/s/GPU(单用户 543 tok/s),并发 128 时 80.3K tok/s/GPU;AgentX 回放在并发 48 时 34,509 tok/s/GPU。两组的投机接受长度均为固定值而非实测,博客在附录中作了说明
- 强化学习:Miles 保留逐专家归一化顺序与 FP32 加权和;R3 把 train–rollout 对数概率差压到 0.0044–0.0071,权重同步后逐位一致
这份记录最值得留意的地方,是它展示了「Day-0 支持」这四个字背后真实的工作量分布:模型架构上三个看起来不大的设计选择——pooler/unpooler、per-expert 归一化顺序、两层 BF16 混在 60 层 NVFP4 里——每一个都往下传导成了分布式通信、kernel 融合边界和权重布局上的具体改动。对推理栈来说,模型开源的难度从来不在参数量,而在这些细节是否被讲清楚。
原文:SGLang and Miles Add Day-0 Support for Muse Spark Open(LMSYS Org,2026-10-15)
参考:
- Meta 开源 Muse Spark Open:816B 参数、100 万上下文(Meta AI Research,2026-10-15)
- Day 0 support for Muse Spark Open on vLLM(vLLM Blog,2026-10-15)


