11 月 10 日,Chips and Cheese 的 George Cozma 发布了对 AMD Zen 6 家族的微架构分析。测试主要基于两颗 EPYC:采用 12 核 CCD 的 EPYC 9686F(Zen 6)与采用 32 核 CCD 的 EPYC 9996(Zen 6c)。文章的核心结论有两层:Zen 6 相对 Zen 5 是一次扎实的世代提升;更值得注意的是,经典核与密集核第一次在乱序引擎内部出现了结构差异。
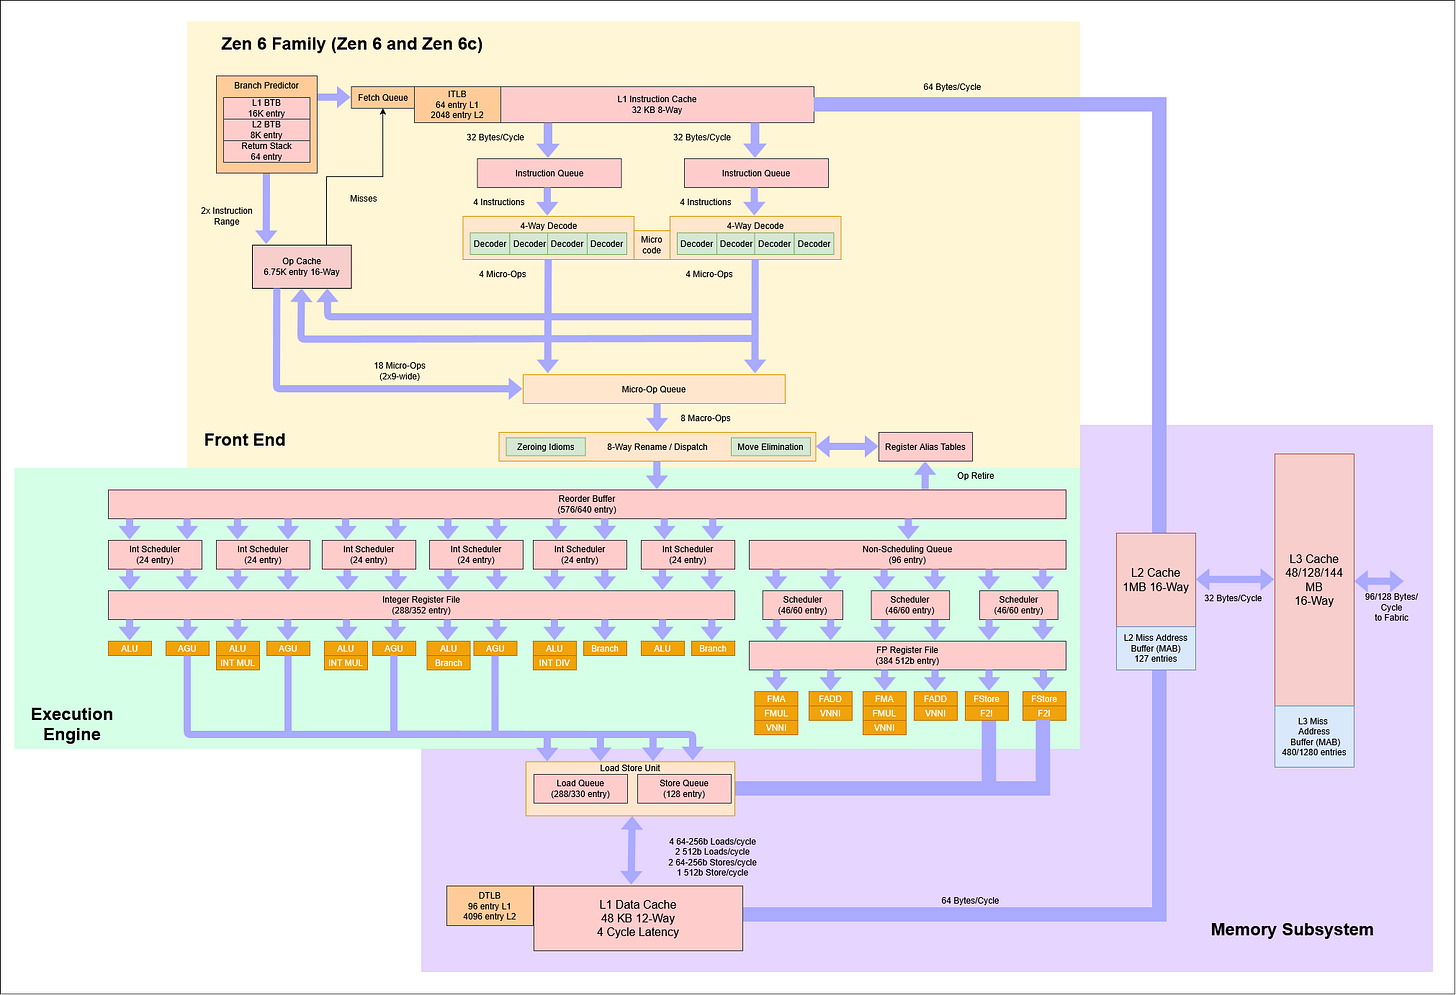
前端:预测器没变大,但猜错更便宜
Zen 5 的方向预测器是作者测过的核心中最准的一个,Zen 6 沿用了同一套预测器。真正变化的是被预测器「压垮」之后的表现:两个核心大约在同一位置撞墙,此后预测器基本在随机猜,每分支耗时反映的是从猜错中恢复的速度。这个平台期在 Zen 5 上约为每分支多 3.5–4 纳秒,Zen 6 降到 3–3.5 纳秒,即单次误预测的代价更低。
在能力上,Zen 6 能在 L1 指令缓存范围内做到每周期 2 个分支;超出 L1i 后,BTB 的其余部分退回每周期 1 个分支,只有 64B 的测试用例需要 4 个周期处理一个分支(走 L2 BTB)。与 Zen 5 相比,Zen 6 的 BTB 优化方向是更快而不是更大——准确率与 Zen 5 接近,但速度更高。
取指侧沿用了 Zen 5 的双解码簇结构,但 Zen 5 里单个线程实际只能用一个解码簇,Zen 6 允许单线程同时使用两个。L1i 之外,取指行为与 Zen 5 基本一致。
执行引擎:少一个整数乘法器,VNNI 翻倍
整数侧恢复了 Zen 4 的 NOP 配对行为,每周期最多退休 16 个 NOP;在同样六个 ALU 下,64 位加法的持续吞吐从 Zen 5 的 5.25 条/周期提升到 5.96 条/周期,更接近理论峰值。
代价是整数乘法单元从 3 个减到 2 个,PDEP/PEXT 的吞吐也从每周期 3 条降到 2 条。AMD 的说法是,Zen 5 的第三个乘法单元抵不上它的面积开销。
向量侧,浮点单元没有变化,仍是每周期两条 512 位 FADD、FMUL 或 FMA。变化在 VNNI:单元数从 2 个翻倍到 4 个,512 位 VNNI 测试从 1.99 条/周期升到 3.88 条/周期,Zen 6c 持平。VNNI 常用于量化推理内层循环,视频编解码器也用它做滤镜。另一处改动是 256 位载入从每周期 2 个提升到 4 个,512 位载入保持 2 个,两种宽度都达到每周期 128 字节——这一点重要,因为大量已发布的向量代码仍以 AVX1/2 为目标。
Zen 6 与 Zen 6c:乱序引擎第一次分家
过去经典核与密集核在架构上基本等价,差别主要体现在每 CCD 的核心数与每核 L3 容量。Zen 6 家族改变了这一点:差异发生在微操作分派之后,大致到载入队列结束。
| 乱序结构 | Zen 6 | Zen 6c |
|---|---|---|
| 重排序缓冲区(ROB) | 576 | 640 |
| 整数寄存器堆 | 288 | 352 |
| 向量调度器 | 138 | 180 |
| 载入队列 | 280 | 330 |
Zen 6c 在这些结构上全面更大,能容纳更多在途工作、吸收更多延迟。作者据此判断:Zen 6 为高频率调优,Zen 6c 则用更大容量去容忍相对更高的内存延迟。
缓存与延迟:L3 周期变慢,纳秒几乎没变
两种 CCD 分别是 12 核与 32 核,但都提供每核 4MB 的 L3,因此 12 核 CCD 是 48MB,32 核 CCD 是 128MB。L3 延迟从 Zen 5 的约 47 周期升到 Zen 6 的 55 周期、Zen 6c 的 66 周期,更大的缓存与更多 mesh 站点可能是原因。
换算成纳秒后,Zen 6 的高频抵消了大部分增幅:10.7 纳秒,对比 Zen 5 的 EPYC 9355P 的 10.3 纳秒;Zen 6c 因频率更低、CCX 更大,落在 16.4 纳秒。
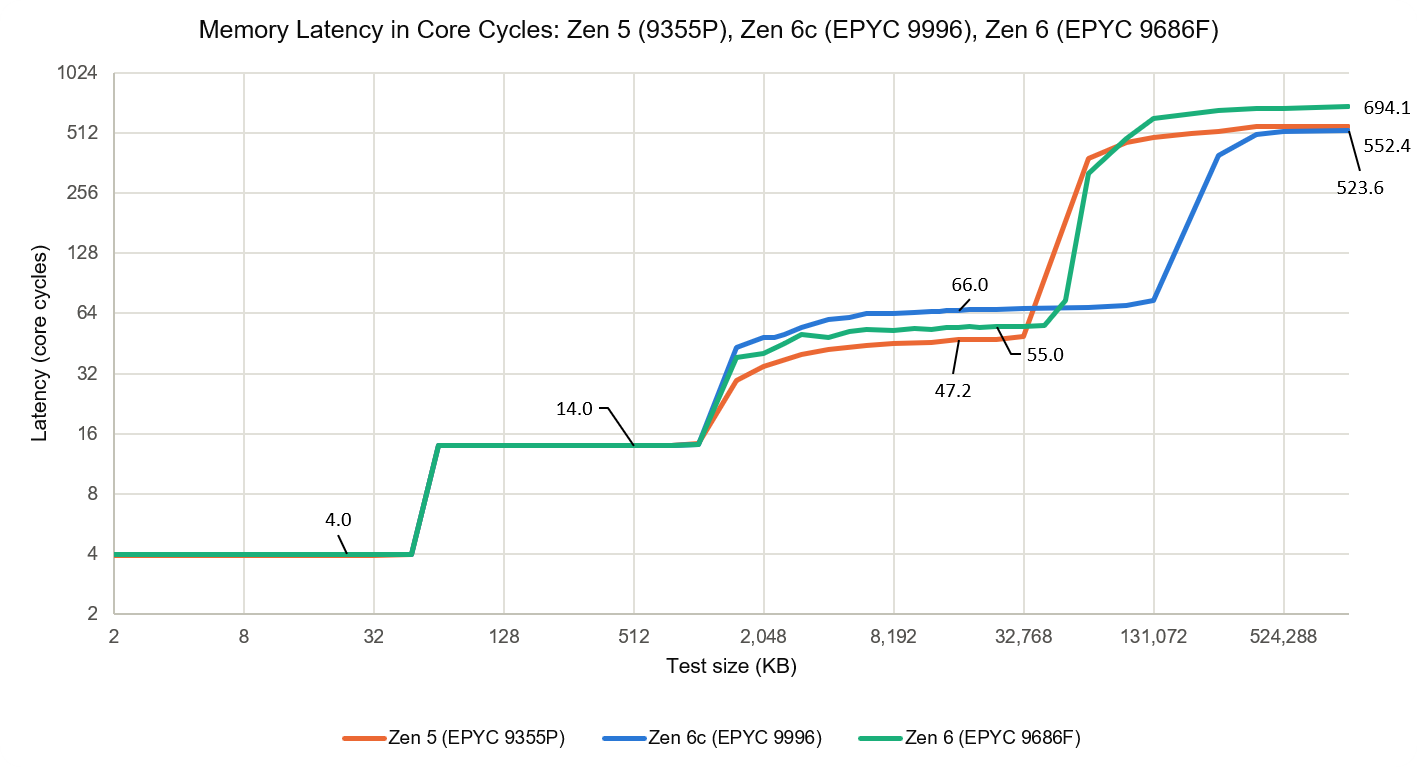
带宽方面,Zen 6 修掉了 Zen 5 的一个怪现象:此前核心在 L2 的大部分容量区间只能拉到约 42 字节/周期,Zen 6 的读路径稳定在 64 字节/周期。其余层级的每周期带宽基本不变。
存储转发(STLF)与 Zen 5 相同,也是 Zen 6 与 Zen 6c 行为重新统一的地方:与 64 位存储同地址的 32 位载入几乎零延迟,从而每周期可处理两组相关的存载对;完全包含在存储内的载入固定 7 周期(不论对齐),部分重叠则是 14 周期。
SPEC CPU 2026:单线程领先 Zen 5 约 21%
作者用 SPEC CPU 2026 估算了单线程成绩。EPYC 9686F 接近榜首,整数率与上一代客户端旗舰 Ryzen 9 9950X3D2 基本持平,浮点率更高。把两者都放到 4.1 GHz 后,9686F 在整数上领先约 4%、浮点领先约 11%——而对方还有大得多的 L3。
EPYC 9996 同样不弱:尽管频率低得多、核心数是对方的四倍,它的单线程成绩大致追平上一代 EPYC 9575F,整数略高于 NVIDIA Vera,浮点领先约 20%。
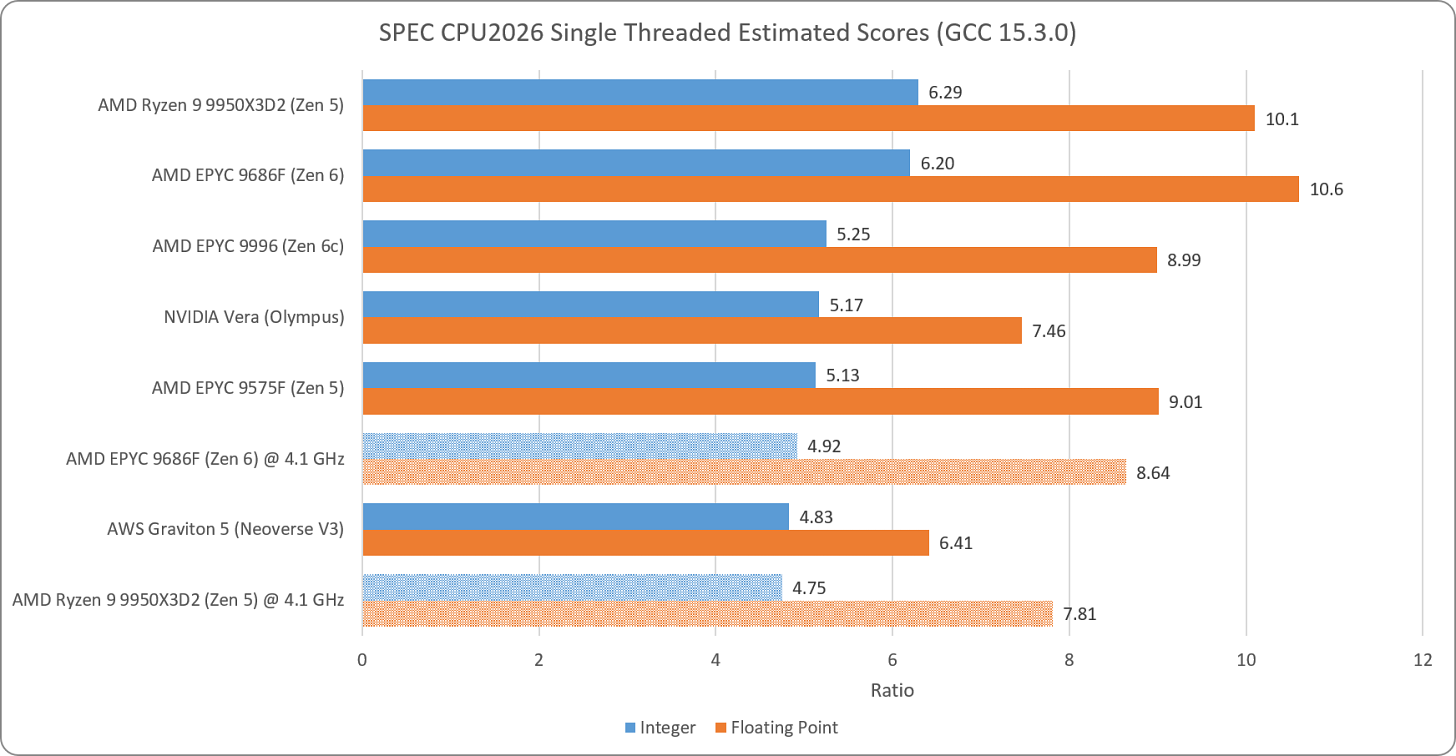
两颗 Zen 6 芯片相比,9686F 在整数与浮点两套测试中都领先约 18%,优势最大的子项是 714.cpython、766.femflow 与 772.marian。对照 Zen 5 的 EPYC 9575F,9996 在整数上是 5.25 对 5.13、浮点 8.99 对 9.01,而频率低约 900 MHz;9996 还在 721.gcc 与 765.roms 两个子项上反超了频率更高的 9686F。
差异从哪来:内存与前端停顿
把 9686F 降到 4.1 GHz 与 9996 同频后,结论反转:9686F 得分为整数 4.92、浮点 8.64,Zen 6c 每时钟约领先 6.7%(整数)与 4%(浮点)。同频下两者在核心受限的整数子项上几乎一样,例如 750.sealcrypto 的退休槽占比为 67.3% 对 67.6%。
差距集中在内存敏感的子项。从 9996 换到 9686F,后端内存停顿占流水线槽的比例在 729.abc 从 37.9% 升到 50.0%,723.llvm 从 19.0% 升到 34.1%,708.sqlite 从 24.8% 升到 33.2%;浮点侧 765.roms 从 42.5% 升到 55.3%,749.fotonik3d 从 60.9% 升到 67.6%,782.lbm 从 17.8% 升到 33.8%。作者的解读是:Zen 6c 的 128MB L3 承担了更多请求,减少了对主存的访问。
同频下最清晰的差别在前端延迟停顿:代码库较大的子项里,9686F 的占比远高于 9996,727.cppcheck 为 35.2% 对 16.6%,721.gcc 为 25.8% 对 10.0%。两者前端相同,差异更可能来自缓存与内存层级的组织方式。
核心总结
- Zen 6 的前端改进主要在于「猜错更便宜」:误预测代价从每分支 3.5–4 纳秒降到 3–3.5 纳秒,并允许单线程使用两个解码簇
- 执行引擎有增有减:整数乘法单元从 3 个减到 2 个,VNNI 单元从 2 个翻倍到 4 个,256 位载入提升到每周期 4 个
- Zen 6 与 Zen 6c 首次在乱序引擎容量上分家,Zen 6c 的 ROB、寄存器堆、向量调度器与载入队列全部更大
- 估算单线程成绩中,EPYC 9686F 比 Zen 5 的 EPYC 9575F 领先约 21%(整数)与 18%(浮点);同频下 Zen 6c 每时钟略胜
- 缓存组织是两者的关键分野:48MB 对 128MB L3,直接反映在内存密集负载的停顿占比上
原文:AMD’s Zen 6 Family: Feeding the Beast(Chips and Cheese,2026 年 11 月 10 日)