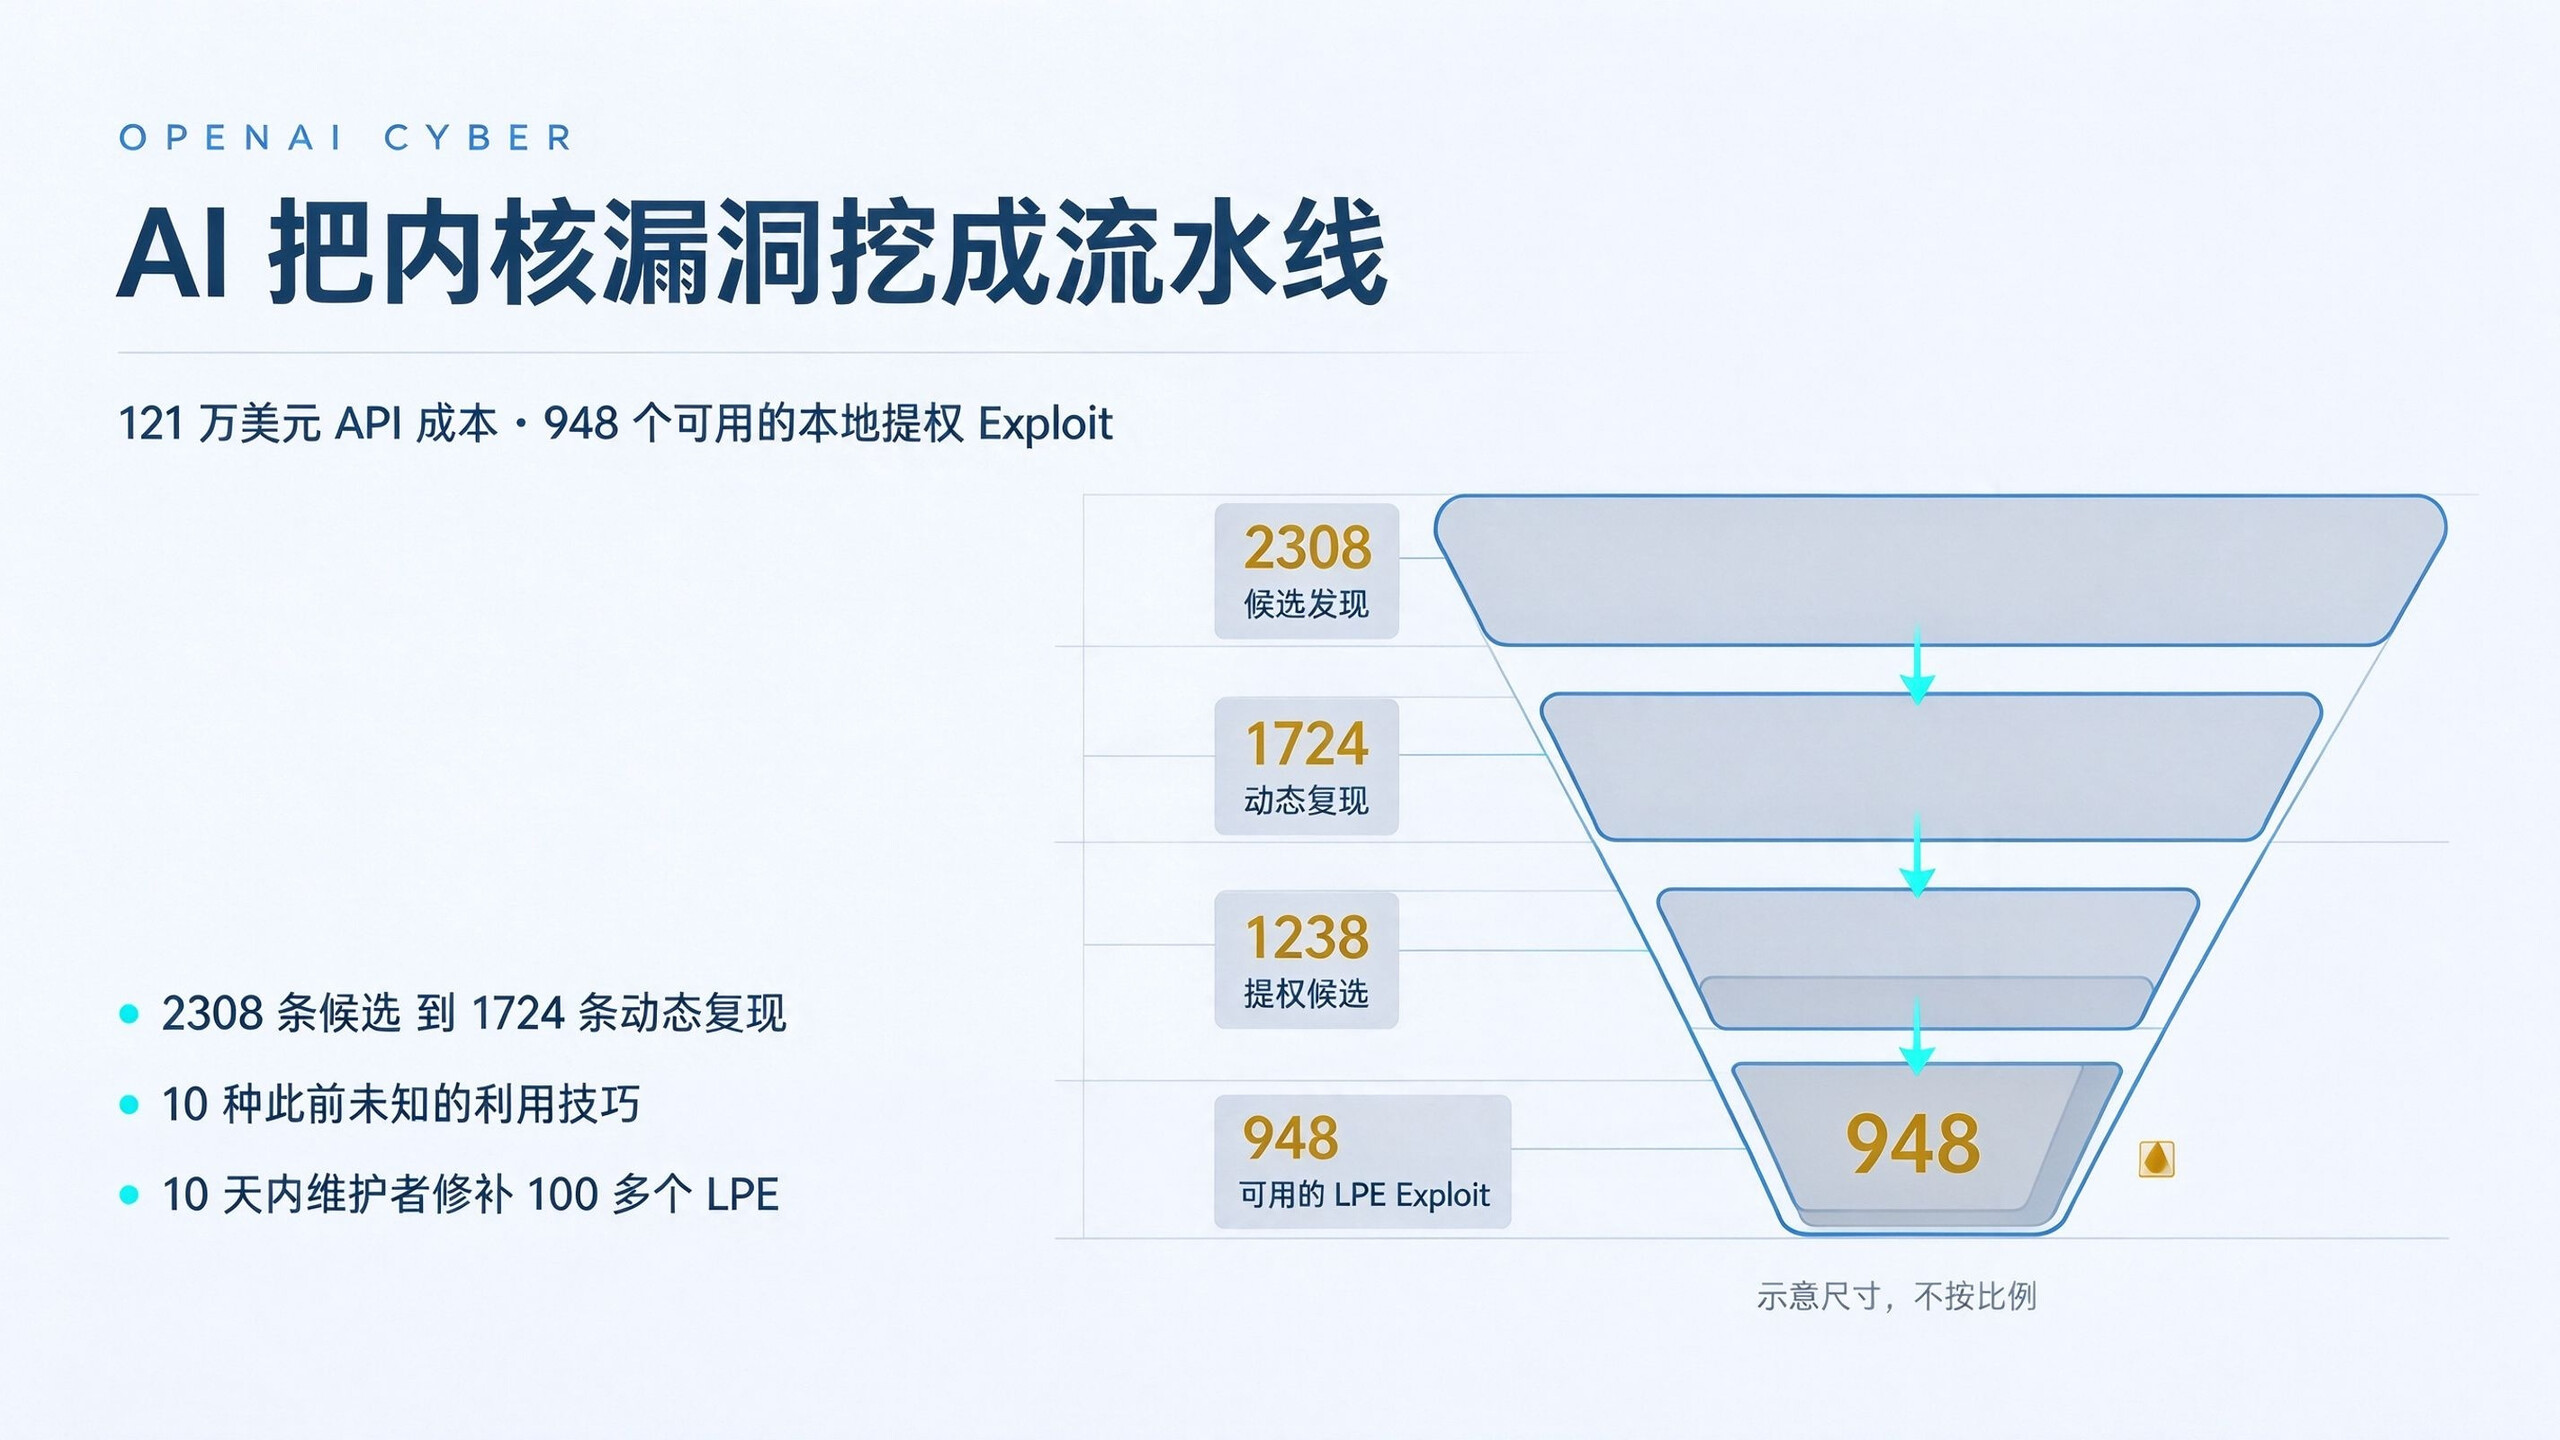
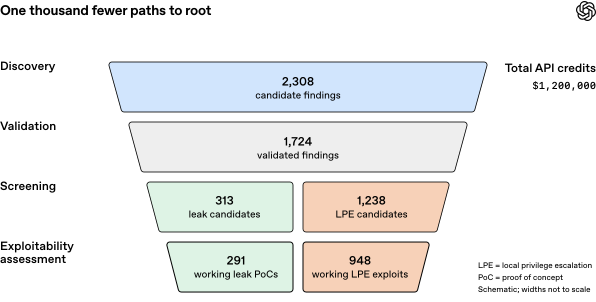
11 月 4 日,OpenAI 发布安全研究文章《A thousand fewer paths to root(通往 root 的一千条更少的路)》,首次完整披露一条自主漏洞发现、利用与修补流水线。在 2026 年 10 月中旬的一次运行中,这条流水线以一款未公开的「下一代网络模型」为核心,对主流 Linux 发行版的原版桌面系统(非削弱过的靶机)完成全流程扫描:产出 2,308 条候选发现、动态复现 1,724 个漏洞、生成 948 个可用的本地提权(LPE)Exploit,API 花费 1,213,430 美元,折合每个可用提权利用 1,279 美元。
文章同时交代了后续动作:按 Linux 内核社区的建议,OpenAI 先从严重漏洞入手,已发出数百份报告与补丁,并与 Patch the Planet 伙伴合作分批提交其余部分——这项工作属于其 Daybreak 计划下支持开源的承诺。
为什么是 Linux 内核
Linux 内核支撑着 Android 设备、云基础设施、超级计算机,代码量超过 4,000 万行,通过系统调用、网络、文件系统与设备驱动暴露了极宽的攻击面。OpenAI 选它做研究对象,正是要验证前沿模型在「这种规模与重要性」的代码库上,能否真的找出漏洞并证明其安全影响。
但初始阶段的产出多到无法人工处理。文章指出,这条流水线真正的运营难点不在「发现」,而在判断哪些发现能被复现、跨越了哪条安全边界、哪些值得维护者最先关注。
五段式流水线:每一步花了多少钱
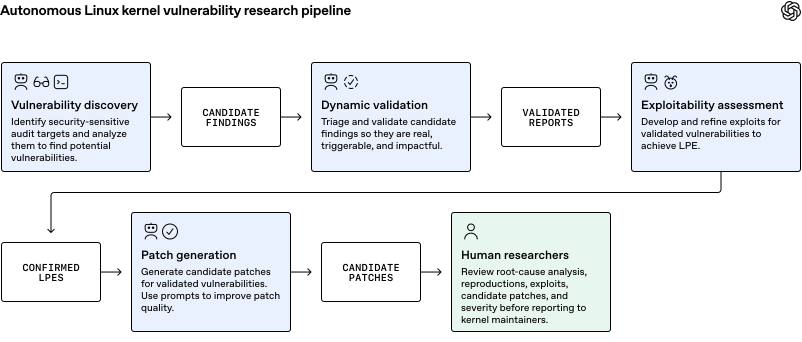
流水线分为五段,全部围绕一个即将发布的网络模型运行,最后交给人类安全研究员复核严重性并上报。
| 阶段 | 产出 | API 成本 |
|---|---|---|
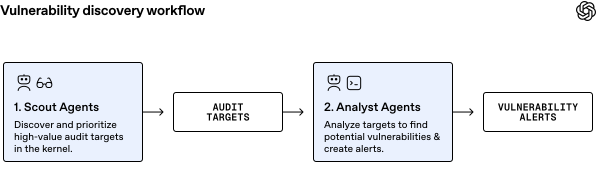
| 漏洞发现(Scout) | 5,034 个审计目标,约 280 万行代码(约为内核的 7%) | $3,426 |
| 漏洞发现(Analyst) | 12 小时内 2,308 条候选发现(已去重) | $316,549 |
| 动态验证 | 30 小时内复现 1,724 个漏洞(占候选的 74.7%) | $73,330 |
| 可利用性初筛 | 313 个信息泄露候选 + 1,238 个提权候选 | $44,194 |
| 利用开发(ExploitDev) | 291 个泄露 PoC + 1,169 个可用提权 Exploit;变体分析后归并为 948 个独立漏洞 | $775,929 |
几个细节值得注意。Scout 智能体逐目录、逐文件阅读代码,按「低权限用户可达性」与安全相关性挑选审计目标,把 4,000 万行压缩到 280 万行,成本只有 3,426 美元——这一步的杠杆率最高。Analyst 智能体则按类似 Codex Security 插件的工作流,先读懂代码、梳理威胁模型,再找漏洞。
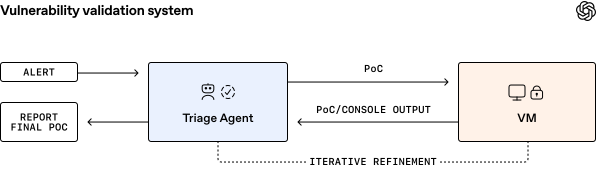
动态验证阶段只处理满足三个条件的发现:低权限用户可达、不需要特殊能力、能产生可测量的内存破坏证据。分诊智能体为每条候选写 PoC,在启用 KASAN 的隔离虚拟机里运行,同时观察程序输出与系统控制台,反复迭代直到复现或穷尽触发路径。2,308 条里只有 3.1% 属于模型分析错误(所报漏洞依赖不可能成立的条件),其余失败多是因为竞态窗口太窄、需要特定触发条件(如某一行恰好分配失败)或验证太耗时(如引用计数回绕)。
利用开发阶段把候选放进启用 SMEP、SMAP、KASLR 与 HARDENED_USERCOPY 的标准发行版虚拟机。文章算了一笔细账:处理一个提权候选平均 558 美元,是信息泄露候选(271 美元)的两倍——泄露 PoC 可从验证阶段直接沿用,而提权需要额外做利用策略规划、寻找可用对象、绕过缓解措施。成功利用平均 359 美元,但 69 次失败尝试平均 3,922 美元:少数难啃的竞态漏洞把成本拉高,作者认为设定「一小时无进展即放弃」这类退出条件本可以显著省钱。
用赏金口径反推:这门生意是净赚的
OpenAI 直言这份报告关心的是方法与能力测量,而非成本优化,因此公布的数字更像成本上限。但既然要「抬高攻击者的成本」,就得先给漏洞定价。
以网络安全竞赛的历史赏金为参照:Pwn2Own 曾为 Linux 内核提权利用开出 2 万美元,TyphoonPWN 开出 7 万美元。把这两个数字套到 948 个 Exploit 上,隐含价值为 1,890 万至 6,630 万美元,约为流水线成本的 16 到 55 倍。
第二组对照更严格:在适配后的 Google kernelCTF 环境(攻击面收窄的加固内核,因与 SLAB_VIRTUAL 缓解不兼容而将该配置移除)中,流水线在 112 小时内拿到 25 个信息泄露 PoC 与 21 个提权 Exploit,花费约 32,936 美元,其中漏洞发现占 83.7%。作为对比,2026 年迄今 kernelCTF 官方确认接收的 0-day 提权 Exploit 共 26 个——也就是说,单次自动化行动的产出接近该赛程全年的接收量。若这 21 个都被接收,按项目赏金约可获 150 万美元,约为扫描成本的 45 倍。
从运行日志里读出的六条经验
维护者跑得比想象中快。 扫描基于 2026 年 10 月中旬最新的内核主线。10 天扫描与人工分析结束时,已有 61 个 LPE 被上游修补、43 个进入 staging 补丁、299 个在公开讨论中。OpenAI 由此得出的教训是:自动分诊必须考虑这种补丁节奏,要把发现拿到最新代码上重新验证(包括扫描后新合入的代码),否则会制造重复或过时的报告,给维护者增加无谓负担。
更强的模型找到更多漏洞。 2026 年 7 月底,GPT‑5.6 Sol 端到端找出并利用了 166 个独立 LPE,成本 51.37 万美元;三个月后的新一代网络模型在同一研究框架下拿到 948 个,成本 121.34 万美元——超过 5 倍,而这三个月里内核还经历了一轮加固。结论是:模型能力提升后,应当重扫此前审计过的代码。
模型会用出人意料的利用手法。 在抽样的 166 个 Exploit 中,智能体用上了 10 种此前未知的利用技巧:两个新的持久化弹性对象(persistent elastic objects)用于在目标内核缓存里喷射对象、两个新的页整形(page grooming)技巧提升利用稳定性、五个新的纯数据(data-only)手法(直接提权或经任意写提权),还有一个涉及任意类型混淆。这些技巧对第三方内核利用专家来说也是新的。出于安全考虑,文章没有公布技术细节。
「成功」也需要验证路径。 早期一次运行报告了 200 个成功提权,人工复核发现其中 20 个是靠另一个未被分配的 0-day 拿到 root 的。后续他们收紧了任务约束,并加入独立检查,确认每个最终 Exploit 确实用了指定的那个漏洞。
更强的模型需要更轻的编排。 团队曾为 GPT‑5.5 Cyber 手工整理 103 种内核利用技巧放进环境并提示使用,在 63 个候选上把成功率从 76.2% 提升到 88.9%。换成 GPT‑5.6 Cyber 后,模型自己就能找到、挑选并应用相关技巧;去掉技巧编排的轻量工作流反而优于重度脚手架的旧版本,再把这层技巧加回去只带来 1.5 个百分点的提升。作者的建议很直接:基础模型能力变化时,要重新评估脚手架与 harness 的维护成本。
补丁需要迭代。 直接让模型生成补丁,得到的版本功能上能挡住 PoC,但常常代码过多、引入性能代价、偏离代码风格,或没有排查同一漏洞的变体而导致补丁不完整。加上「对补丁做静态检查、遵循邻近代码的开发实践、做变体分析」等指令并多轮迭代后,质量明显改善;个别情况下,他们还发现了人类专家补丁中的问题,并在合并前修掉。
顺带挖出了测试基础设施的漏洞
在 kernelCTF 那次运行中,除了 21 个内核 0-day,流水线还发现并利用了一个 QEMU TCG 漏洞:Analyst 智能体被分配分析系统调用入口代码,在写程序试验特权切换时触发了一次意外崩溃,它在没有 QEMU 源码的情况下把问题定位到 QEMU TCG 并写进报告,ExploitDev 随后做出了可用的提权利用。该漏洞在上游 QEMU 已修复,但实验所用发行版构建里没有。OpenAI 的建议是:开展攻击性漏洞研究前,先测试自己的每一层基础设施——他们已主动测试并披露了 Kata、Moby/Docker、gVisor 等项目中的多个漏洞。
对防御者意味着什么
文章的判断相当不客气:在中短期内,对一个资源充足的威胁行为者来说,一个未打最新补丁的系统上的低权限账户,功能上等同于 root。纵深防御——Firecracker、gVisor 这类沙箱与隔离方案——是限制漏洞被利用后爆炸半径的关键。
再往前看几年,作者认为如果某个软件项目里存在漏洞,前沿模型大概率能找到;而漏洞一旦披露,连能力较弱的模型也可能写出利用。在一个「没有未知漏洞」的世界里,高保障软件才是根本:默认写出安全代码的模型训练、削减不必要的功能面、以及形式化验证,都是值得投入的方向。
核心总结
- 一次 10 天的自动化行动,产出 2,308 条候选、1,724 个复现漏洞、948 个可用 Linux 提权 Exploit,API 成本 121.34 万美元,单价约 1,279 美元。
- 成本结构极不均匀:Scout 挑目标只花 3,426 美元,而 Analyst 扫代码 31.65 万美元、利用开发 77.59 万美元;失败的利用尝试比成功的贵十倍以上。
- 按 Pwn2Own / TyphoonPWN 历史赏金折算,948 个 Exploit 隐含价值 1,890 万–6,630 万美元,约为成本的 16–55 倍;kernelCTF 环境下 21 个提权利用的成本回报比约 45 倍。
- 同一框架下,模型从 GPT‑5.6 Sol 的 166 个 LPE 提升到新模型的 948 个,说明能力提升后必须重扫旧代码。
- 智能体发现了 10 种新的内核利用技巧,也出现过「用错 0-day 拿到 root」的情况——结果的验证必须包含路径的验证。
- 补丁生成需要指令与多轮迭代;维护者响应极快,自动分诊必须面向最新代码重新验证。
原文:A thousand fewer paths to root(OpenAI,2026 年 11 月 4 日)


