10 月 7 日,vLLM 团队与 Inferact 联合发文,复盘 DeepSeek-V4.1-Flash 发布后三周内完成的推理侧优化。结论是:在 SemiAnalysis 的 AgentX 智能体服务基准上,vLLM 的低并发结果比 Day-0 版本快 1.9 倍;在 150 TPS 的交互性约束下,吞吐提升 5.3 倍(正文更保守的表述是「约 5 倍」);在约 10 万吞吐的水平上,首 token 延迟(TTFT)下降近 70%。
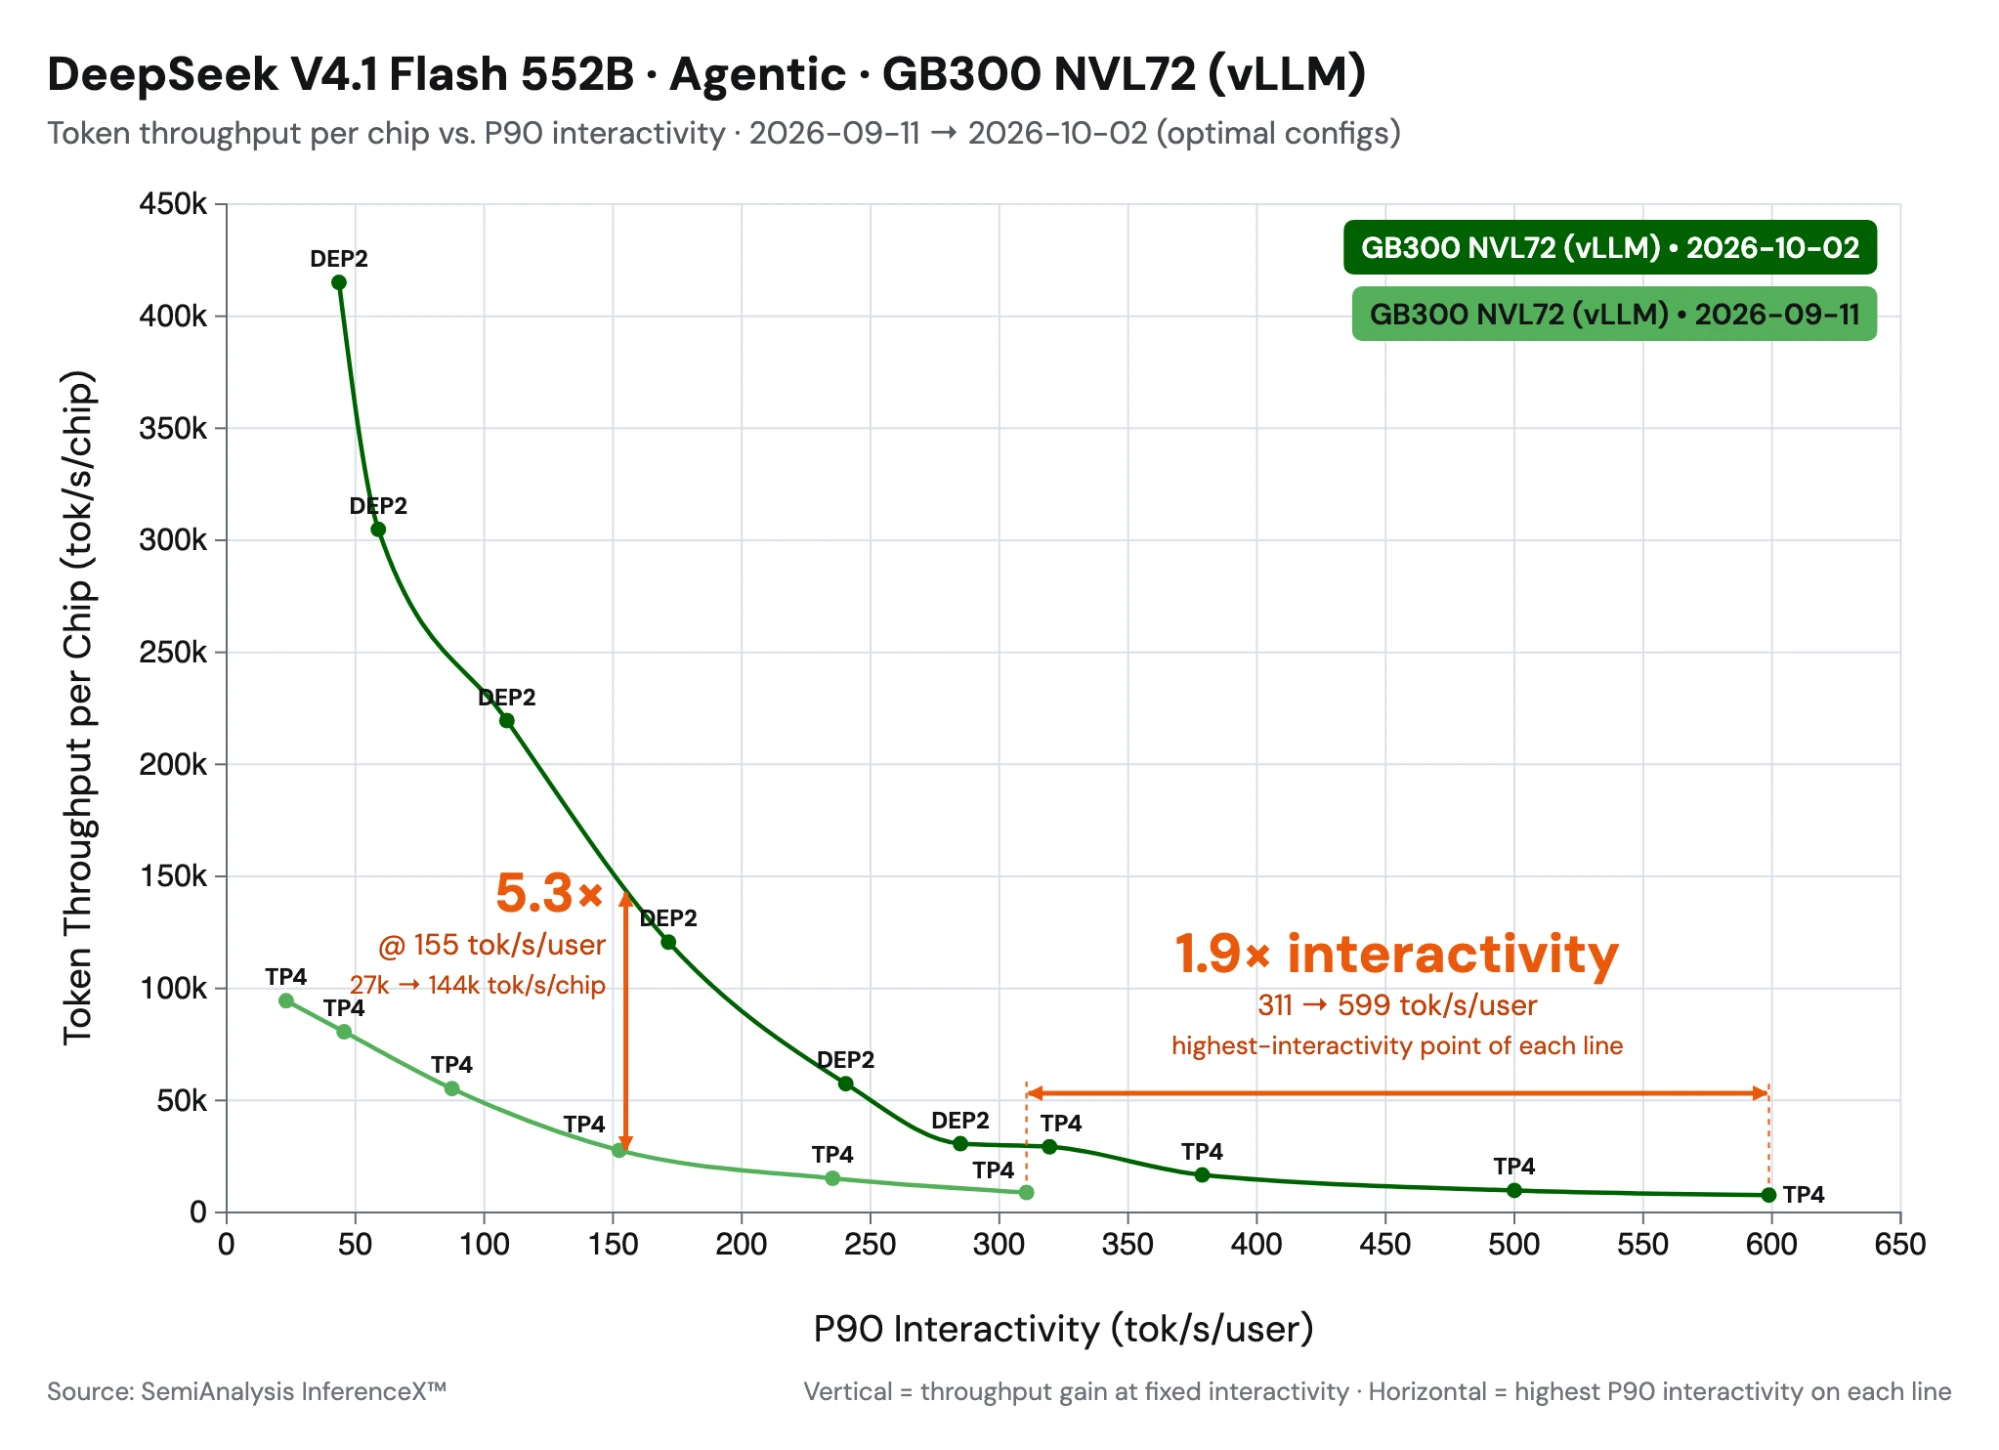
图 1:vLLM 在 SemiAnalysis AgentX 上的结果,从 Day-0 到 10 月 2 日。
优化分两类。一类是把 DeepSeek 在模型层引入的 SWA 有界重放(SWA bounded replay) 落到 vLLM 的 prefill 调度与 CUDA 图捕获上;另一类是内核层面的融合——既整合了 DeepSeek 随模型开源的 MegaAttention、Mega-mHC、Mega-Gate、DeepSelect,也把 vLLM 自己剩下的融合与并行机会一并做掉,包括 mHC 旁路流,以及把 all-reduce 与前后算子融进同一个内核。
两类 KV 缓存,两笔代价
V4.1-Flash 的 KV 缓存分成两份。全局 KV 经过压缩、跨层共享、以 FP4 存储,约 890 字节每 token;滑动窗口(SWA)KV 不压缩,用 FP8 保存最近 128 个位置,40 层各持一份。前者的压缩路径我们在此前模型发布时已有介绍,vLLM 这篇文章的重点是后者带来的两笔开销:
- 前缀缓存必须在每一个可能的命中边界上把 SWA KV 存下来,存储开销超过全局 KV 的 10 倍。
- Prefill 要在每个 prompt token 上跑第 21–39 层,而 decode 只读这些层最后 128 个位置。
一个直接的想法是干脆不缓存、改用重算。但精确重算很贵:每层 128 token 的窗口都依赖下一层更早的位置,跨 L 层重建意味着要重放约 L × 128 个 token。DeepSeek 的解法是 SWA 有界重放——只重跑最后 128 个 token,并把 SWA 窗口在重放起点处截断。它不是 bit 级精确的,但 DeepSeek 报告质量损失可以忽略。vLLM 把它用在两个地方,分别对应上面两笔开销。
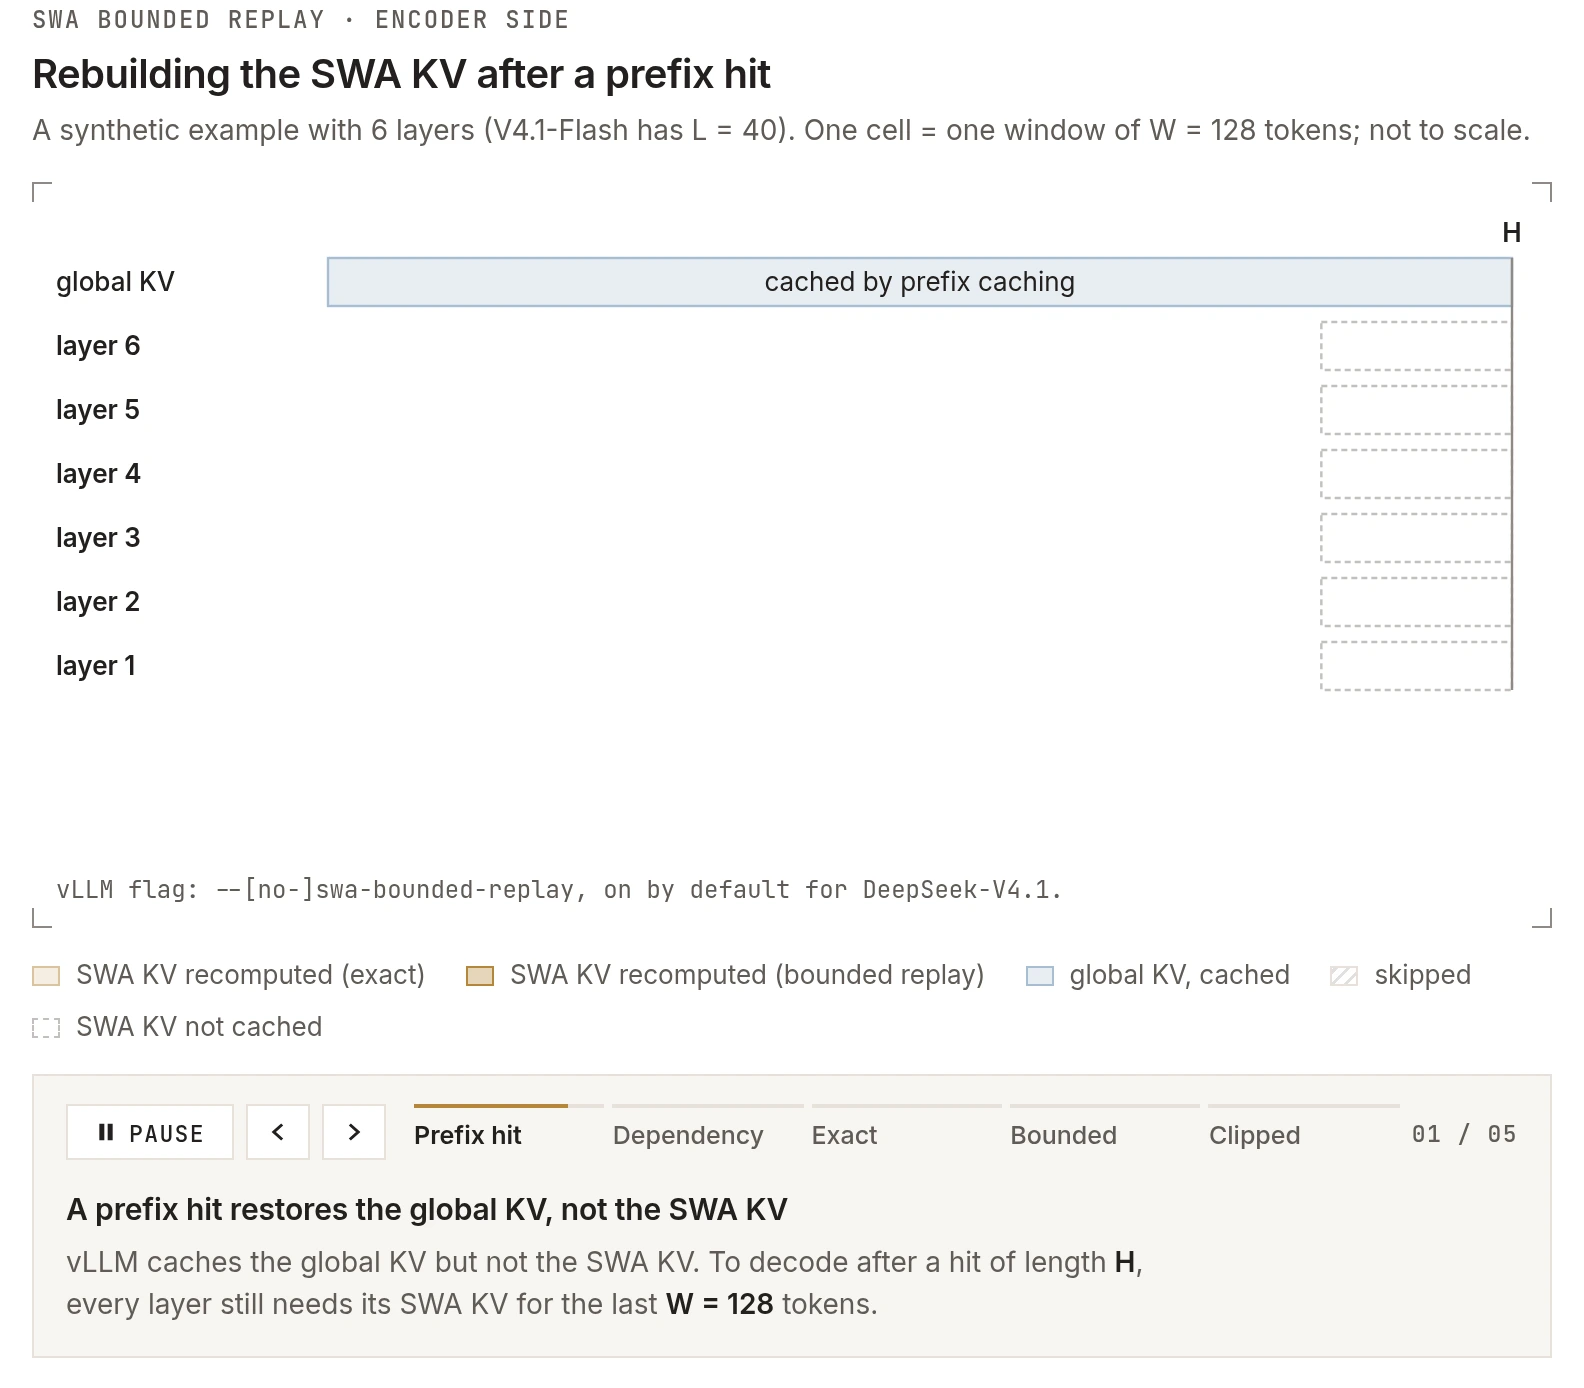
图 2:精确重建每层级联一个窗口,有界重放只重算最后一个窗口并在重放起点 s 处截断。
编码器侧重放与解码器侧裁剪
编码器侧,vLLM 只缓存全局 KV,不存 SWA KV。当前缀命中长度为 H 时,它重跑 [H − 128, H) 这段 token 来重建 SWA KV,窗口统一在 s = H − 128 处截断。这一侧换来的是缓存空间的节省,真正的性能收益来自解码器侧。
解码器侧,V4.1 的 CED 架构里第 20 层算出解码器所需的全局 KV,第 21–39 层复用它。于是 vLLM 在每个 token 上都跑第 20 层来产出全局 KV,而第 21–39 层只在每个请求的最后 128 个 token 上运行。对长 prompt 来说,这等于跳过了近半个模型。
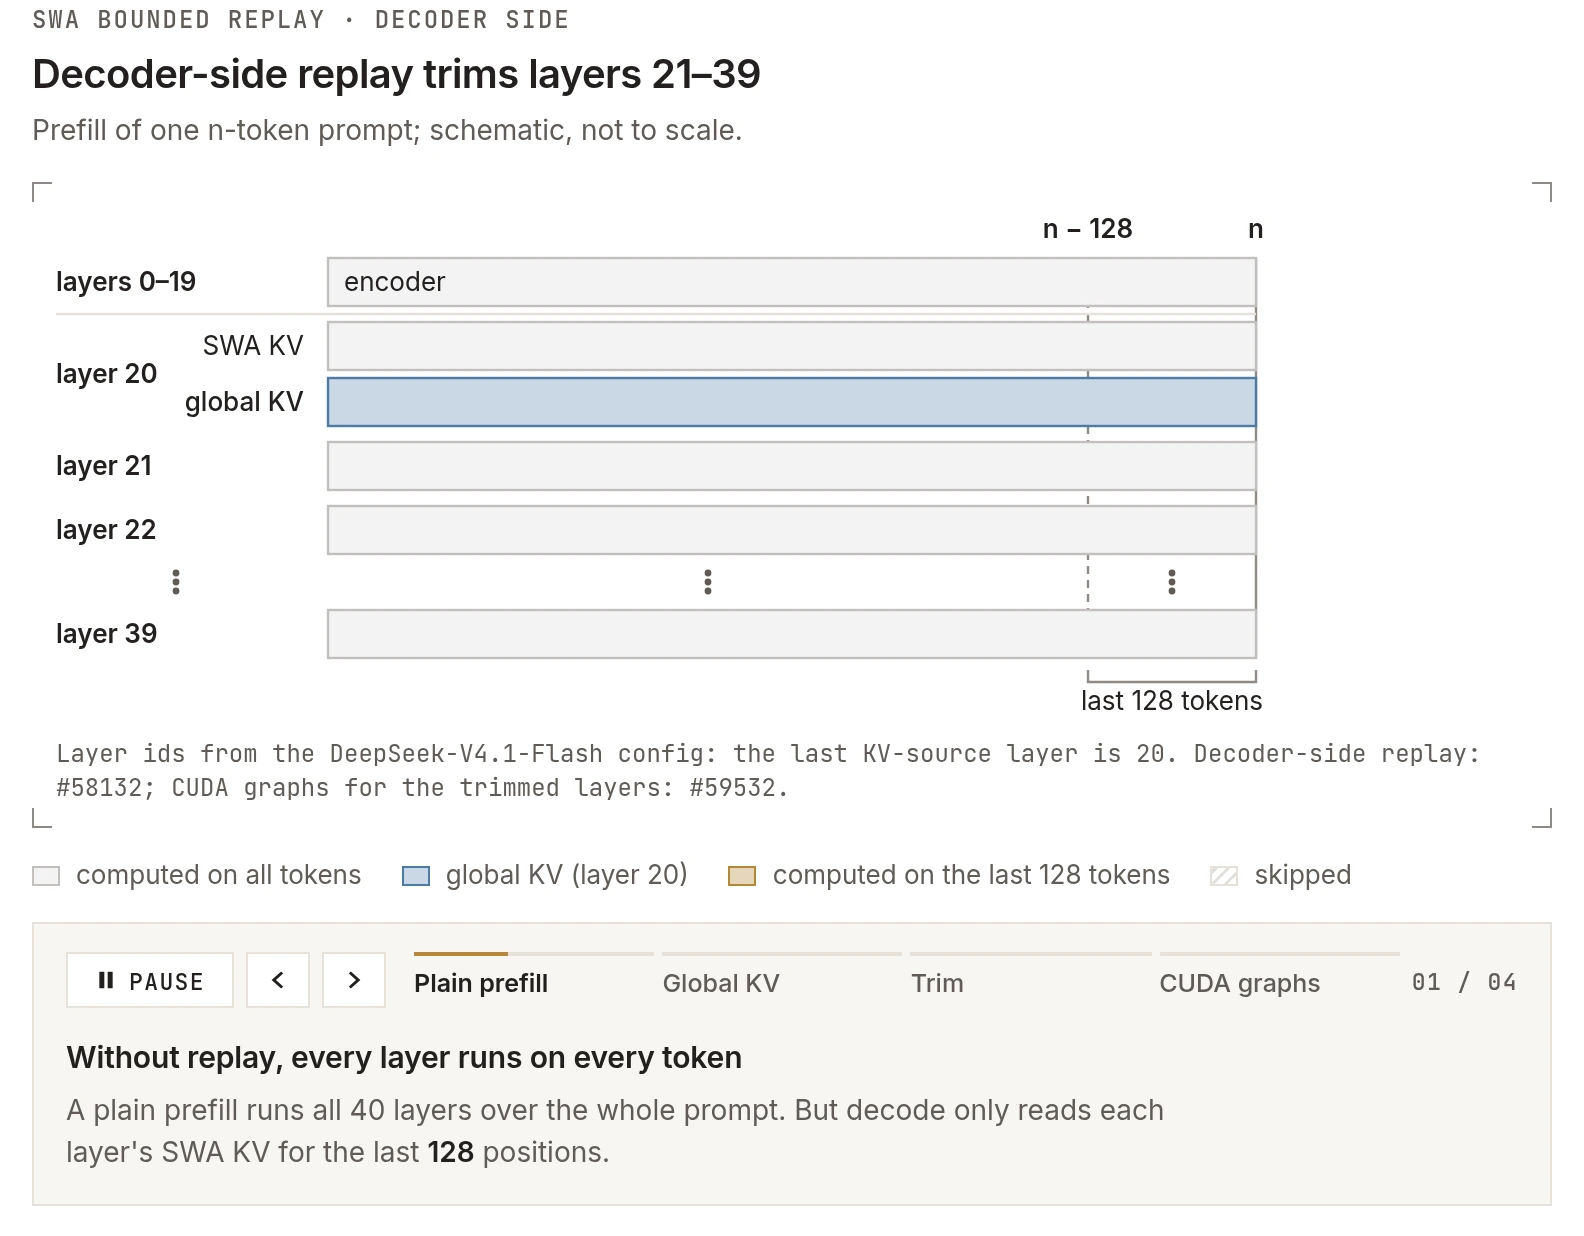
图 3:解码器中第 20 层的全局 KV 需要覆盖每个 token,第 21–39 层则只在最后 128 个 token 上运行。
被裁剪层的 CUDA 图。裁剪之后,第 21–39 层的 GPU 工作量小到一旦以 eager 模式运行,内核启动开销就会盖过计算本身,GPU 反而空转。它们的输入形状又和第 0–20 层不同,两部分没法塞进同一张 CUDA 图。vLLM 的可中断 PIECEWISE 图本来就会在模型中间断开,这正好提供了自然的切分点:第 0–20 层按完整 batch 捕获,第 21–39 层按裁剪后的 batch 单独捕获。这让 CUDA 图能用在裁剪过的 prefill 上,也让后半段可以用自己的捕获尺寸,获得更好的图覆盖率。
SWA 有界重放对 DeepSeek-V4.1 默认开启,由 --[no-]swa-bounded-replay 控制;相关进展汇总在 vLLM 的追踪 issue #57448。
准确性没有代价,TTFT 的收益要看 prompt 长短
有界重放不是精确计算,DeepSeek 报告的质量损失可以忽略。vLLM 在 GSM8K、GPQA 等基准上做了确认,没有观察到有意义的精度差异——差距都在约 1.5 个标准误以内。
性能侧的测量分三种设置:重放关闭;重放开启但解码器不用 CUDA 图(第 21–39 层 eager 运行,只裁剪 eager 步骤);重放开启且解码器使用 CUDA 图。单请求的 prefill TTFT 如下(NVIDIA GB200,3 次取中位数,前缀缓存关闭,百分比相对「重放关闭」):
| 部署 | prompt | 基线 TTFT | 重放开启(eager) | 重放开启 + CUDA 图 |
|---|---|---|---|---|
| TP4 | 1K | 160.9 ms | +3.1% | −35.8% |
| TP4 | 4K | 165.4 ms | +4.3% | −35.3% |
| TP4 | 8K | 170.0 ms | +4.6% | −33.8% |
| TP4 | 32K | 540.1 ms | −30.4% | −39.3% |
| TP4 | 128K | 2,267 ms | −32.9% | −38.6% |
| DEP2 | 1K | 103.8 ms | +11.9% | −30.2% |
| DEP2 | 4K | 135.3 ms | −13.2% | −31.8% |
| DEP2 | 8K | 246.9 ms | −33.5% | −35.4% |
| DEP2 | 32K | 983.1 ms | −37.2% | −38.0% |
| DEP2 | 128K | 3,950 ms | −36.3% | −37.7% |
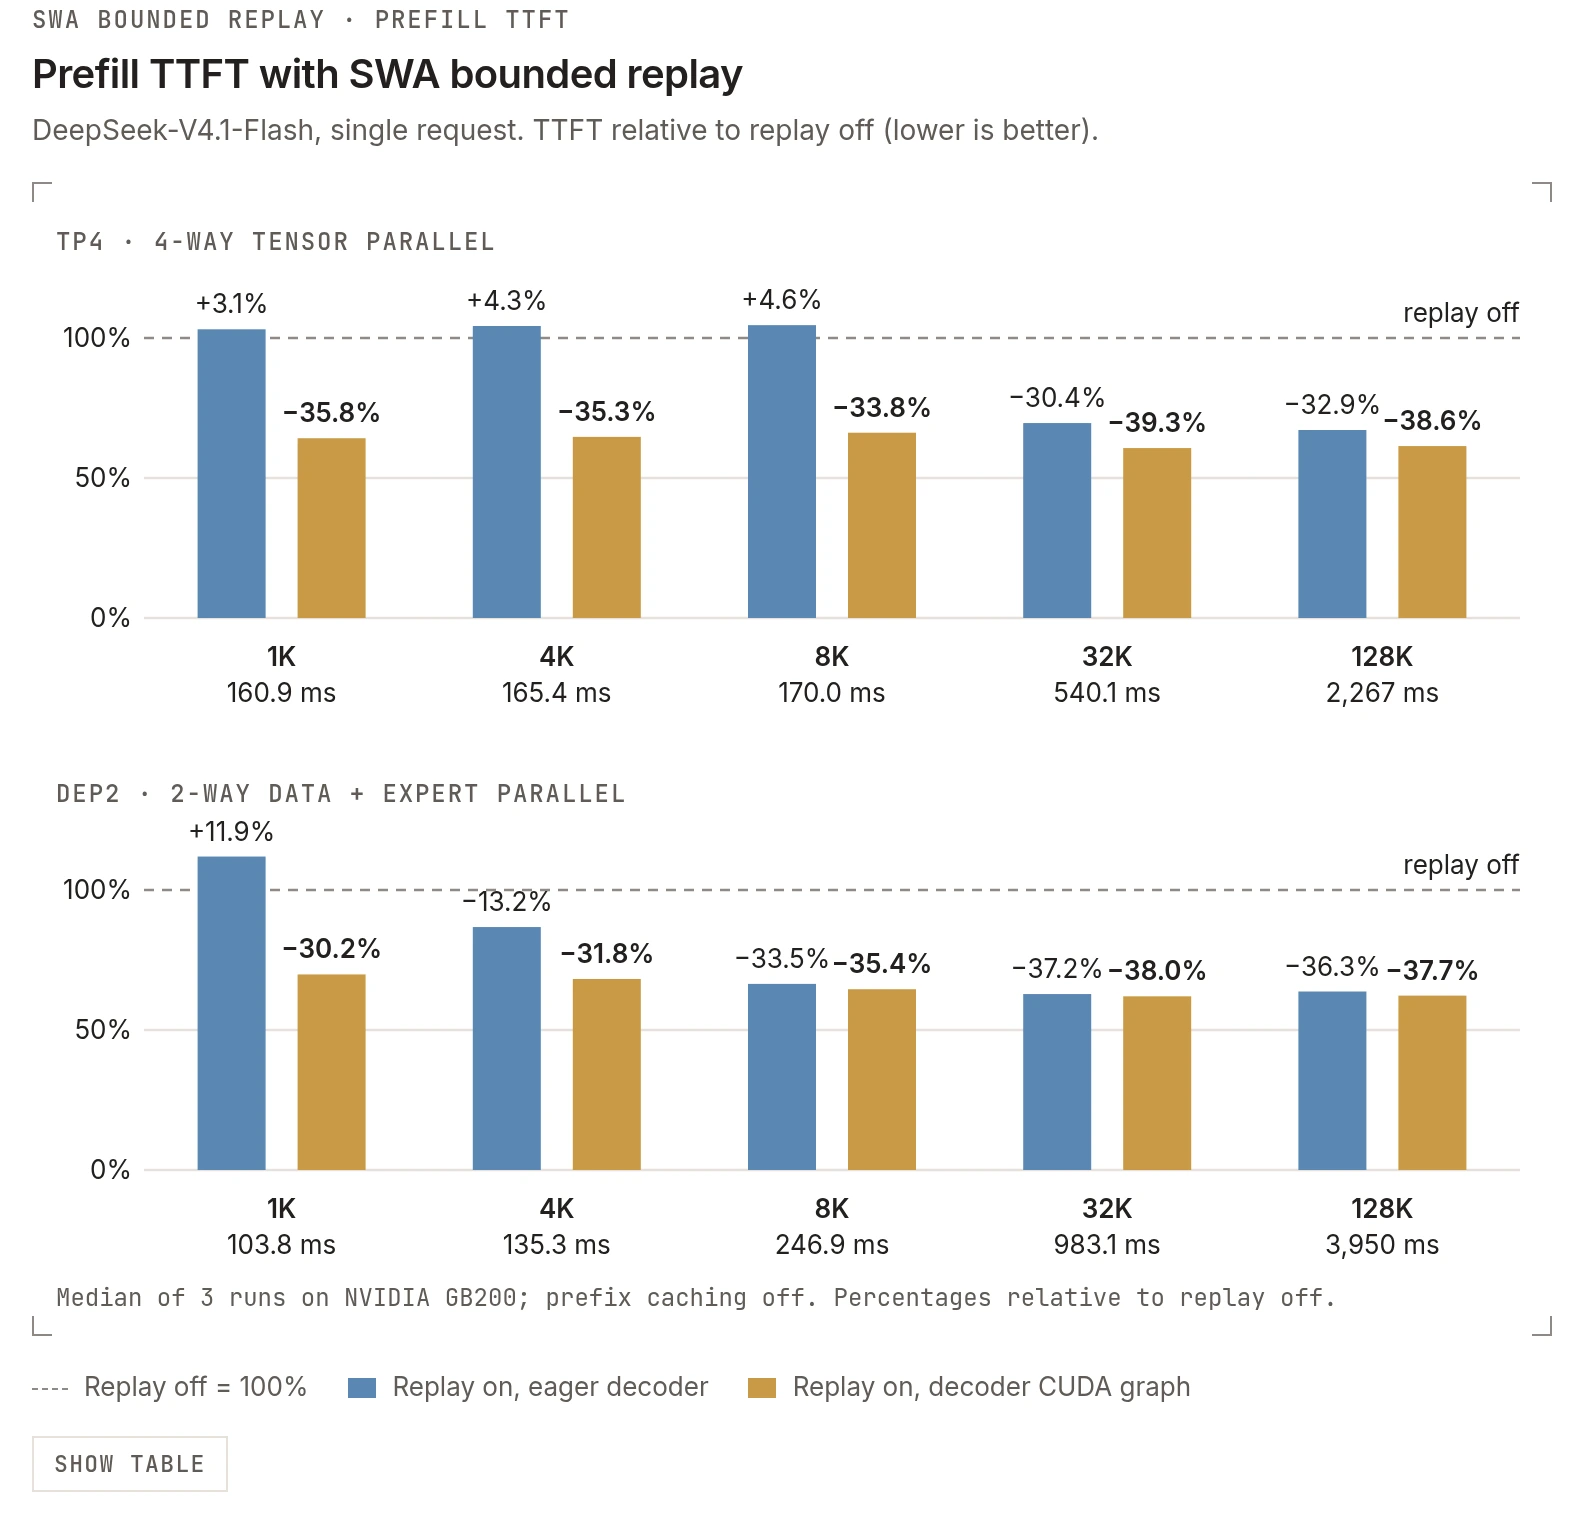
图 4:单请求 prefill TTFT,TP4 与 DEP2 两种部署,重放关闭 / 开启 eager / 开启且用 CUDA 图。
解码器重放配合 CUDA 图把 prefill 计算时间削减了 30–40%。CUDA 图对短 prompt 最关键:没有它,启动开销会盖过 GPU 节省的计算,重放反而比基线更慢——DEP2 的 1K 场景下最差慢 12%。长 prompt 的 GPU 工作量大到足以掩盖启动开销,eager 重放已能拿到大部分收益,CUDA 图再补几个点。
内核:从 DeepSeek 三仓库到 vLLM 主分支
DeepSeek 随 V4.1-Flash 发布了三个仓库的新内核:DeepSelect 是面向 DeepSeek 稀疏注意力的新 top-k 库;DeepGEMM 增加了稀疏 indexer 内核与若干 GEMM 相关的融合内核;FlashMLA 增加了 NVFP4 KV 缓存支持和融合注意力内核 MegaAttention。vLLM 把这些内核接进主分支,并补齐了剩余几处融合。
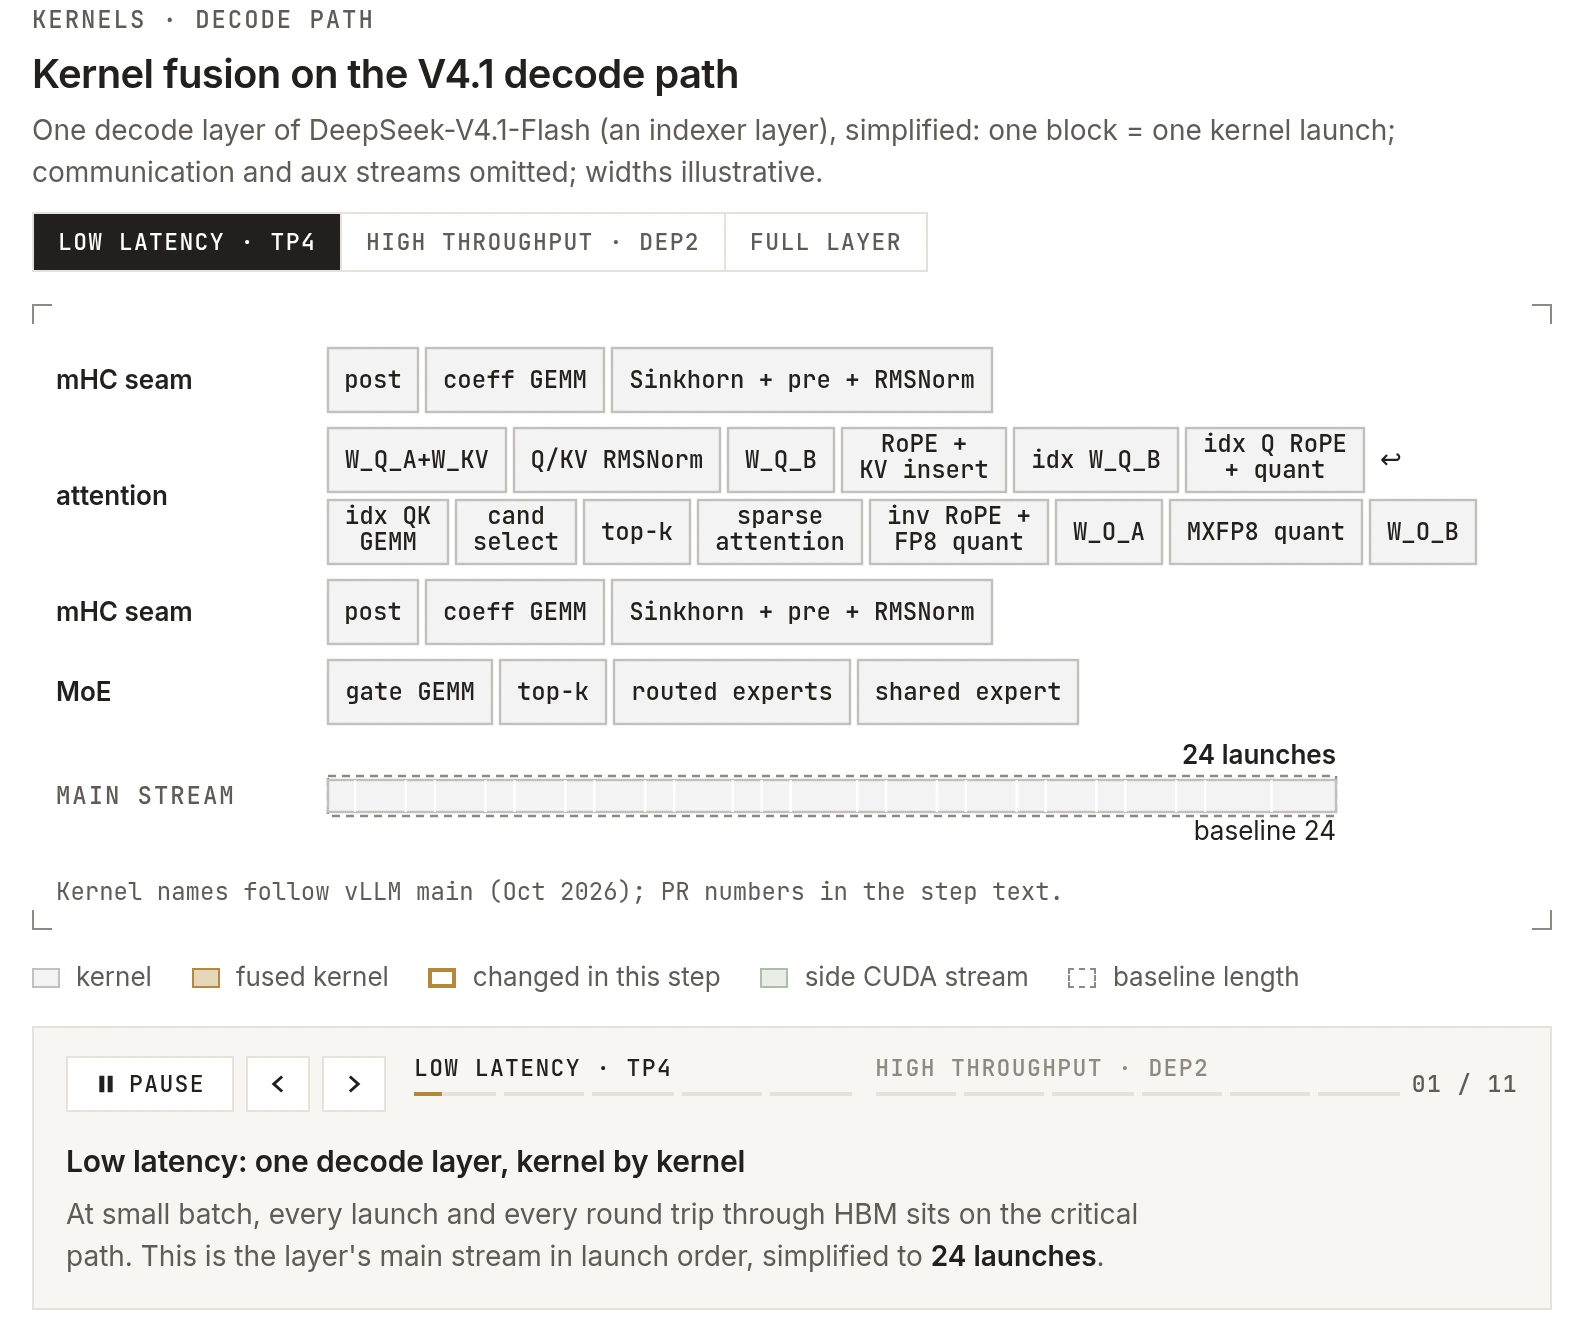
图 5:DeepSeek-V4.1 单层前向中的内核融合,金色描边对应 vLLM PR。
| 内核 | PR | 做了什么 | 效果 |
|---|---|---|---|
| Mega-mHC | #56962 | 把 mHC 链的 post 步、delayed-pre 步与 RMSNorm 融成一个内核,取代原 TileLang 融合路径 | GB200 上比 TileLang 快 1.14–1.51 倍 |
| Mega-Gate | #56266 | 把 MoE 路由(gate GEMM、专家打分、bias、top-k 选择)融成一个内核,省掉一次启动和一轮分数往返内存 | 中等 batch 下内核快 1.18–1.31 倍 |
| mHC 多流重叠 | #57603 | 在旁路 CUDA 流上算下一个 mHC 块的系数,与 attention、FFN 并行,把这部分移出延迟敏感路径 | TP4 低延迟场景延迟降约 4% |
| 稀疏 MQA logits | #56254 | 后段 indexer 层只在固定 16K 候选位置上打分,不再给整段上下文算分再掩码,成本不再随上下文增长 | GB300 单层:8K 快 1.2 倍、512K 快 14–23 倍;4×GB300 端到端 decode 提升 3–6%,prefill 在 512K 快 1.43 倍、1M 快 2 倍 |
| MegaAttention + NVFP4 KV | #56935 | 单次启动完成 query RoPE、稀疏注意力、输出逆 RoPE 与 FP8 转换,直接写入输出投影要读的缓冲,并读取新的 NVFP4 压缩 KV | NVFP4 KV 比 FP8 小 45%,内核效率提升 1.45 倍 |
| 融合 WO-A 内核 | #58634 | 用 CuTe-DSL 把逆 RoPE、FP8 量化、WO-A batch GEMM 与 MXFP8 重量化合成一个内核,让中间激活留在片上 | 融合路径最高快约 2.1 倍,低并发下 token 间隔降低约 6–7% |
| Engram | #56512 #57651 #56926 #59327 | 异步预取卸载到 CPU 的 Engram 查表;用统一的 TP/DP 分片让同址 DP 副本共享主机表;支持透明大页降低缺页开销 | prefill 的查表内核最高快 10 倍 |
两种服务配置
低延迟走 TP4 配 FlashInfer 注意力。小 batch decode 基本是显存带宽瓶颈,把权重切到 4 张 GPU 上正合适。团队也试过 MegaAttention,但它的主要优势在高吞吐场景——那里融合有更大的发挥空间;TP4 下收益小得多,实测 FlashInfer 更快。
高吞吐切到 DEP2,用 DP attention 把专家分片到各 GPU。因为 V4.1 所有 head 共享同一份 KV latent,TP 会在每张 GPU 上复制 KV 缓存;DP 避免了这种复制,每张 GPU 只存自己服务的请求的 KV,再用会话亲和(session affinity)保住跨轮次的前缀缓存局部性。MegaAttention 的 NVFP4 进一步把每请求 KV 占用几乎减半,提高单卡并发。
值得注意的一点是,整个基准测试过程中 V4.1 都不需要 KV 缓存卸载;作者预计要到更高并发、配合 P/D 分离时,卸载才会开始起作用。
智能体实测
SemiAnalysis 的 AgentX 用真实编码智能体轨迹构造负载,特征是长时程多轮、重度前缀复用——单会话中位数 43 轮,输入中位数 142K token 而输出中位数只有 444 token,前缀缓存命中率超过 96%,44% 的会话包含至少一个子智能体。
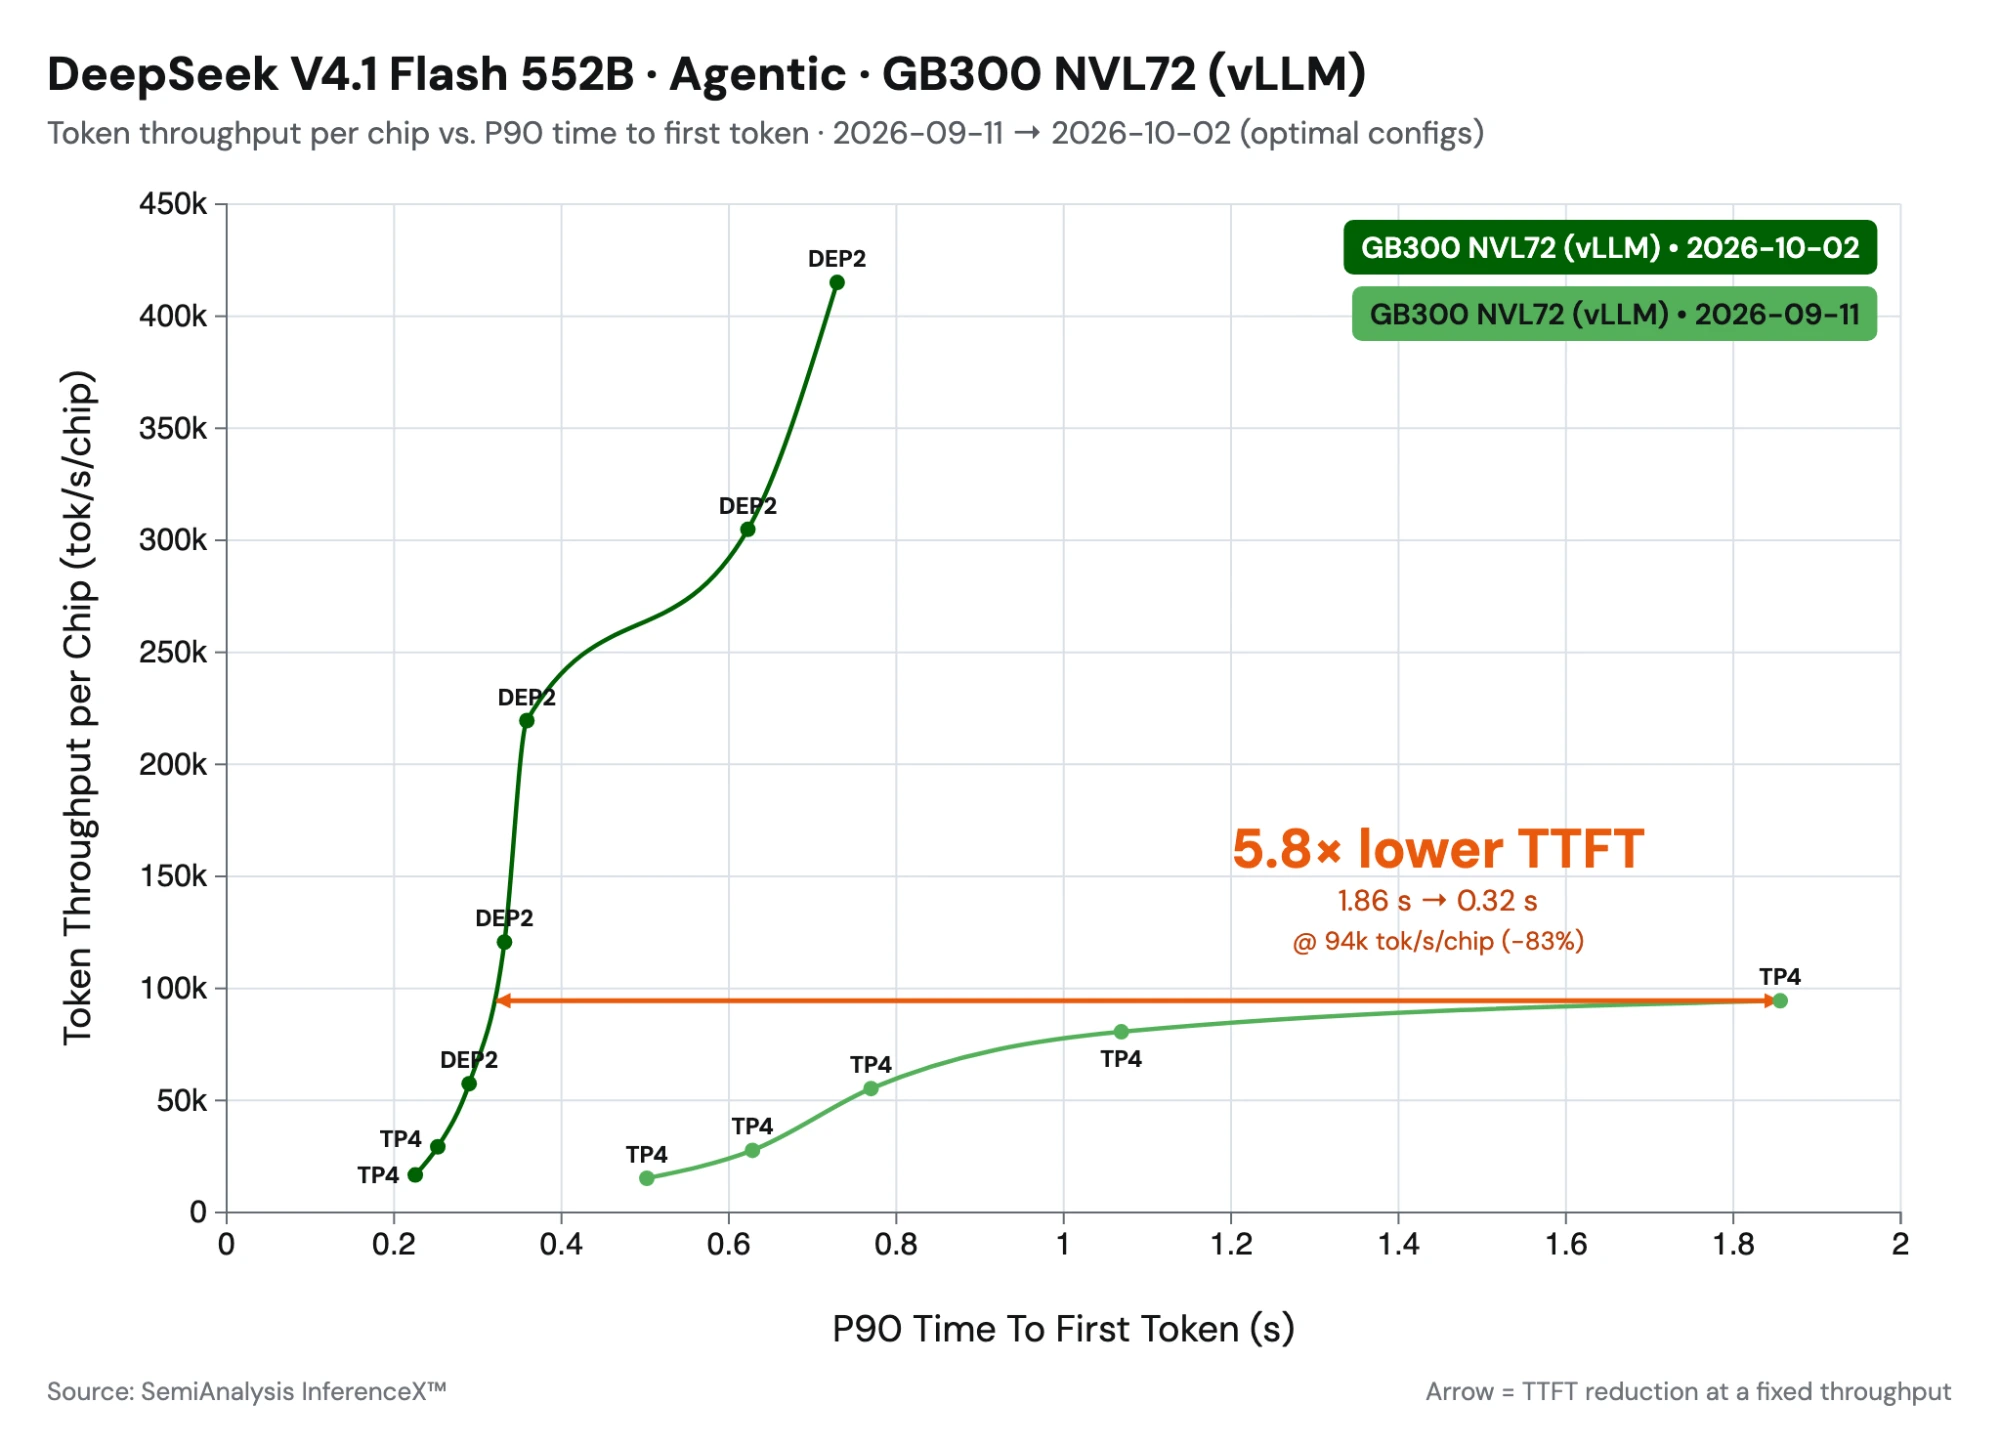
图 6:优化之后的 TTFT–吞吐权衡。
在约 10 万吞吐的水平上,TTFT 下降近 70%,来自三项优化的叠加:SWA 有界重放让模型的上半部分只处理最后 128 个 token,把 prefill 计算砍掉大约一半;CUDA 图让裁剪后的重放不再受 CPU 内核启动拖累;以及前述的内核优化本身。
结合低延迟与高吞吐两条配置,最终结果就是开头那组数字:低并发延迟改善 1.9 倍,150 TPS 约束下吞吐提升 5.3 倍。
核心总结
- 结果:DeepSeek-V4.1-Flash 发布三周内,vLLM 在 SemiAnalysis AgentX 上低并发延迟改善 1.9 倍,150 TPS 约束下吞吐提升 5.3 倍,约 10 万吞吐处 TTFT 降近 70%
- SWA 有界重放:只重跑最后 128 个 token 并在重放起点截断窗口,牺牲 bit 级精确换效率;编码器侧省缓存空间,解码器侧跳过第 21–39 层的大部分 prefill
- CUDA 图:借助可中断 PIECEWISE 图,第 0–20 层按完整 batch、第 21–39 层按裁剪 batch 分别捕获,把 prefill 计算再削 30–40%
- 精度:GSM8K、GPQA 上与精确路径无显著差异,差距在约 1.5 个标准误以内
- 内核:整合 DeepSeek 的 DeepSelect / DeepGEMM / FlashMLA 新内核,并自行融合 Mega-mHC、Mega-Gate、mHC 多流、稀疏 MQA、MegaAttention NVFP4、融合 WO-A、Engram 等七组优化
- 默认开启:
--[no-]swa-bounded-replay,对 DeepSeek-V4.1 默认生效
原文:DeepSeek-V4.1-Flash on vLLM: 5x Agentic Throughput Since Day 0(vLLM Blog,2026-10-07)
参考:
- vLLM 追踪 issue #57448
- DeepSeek-V4.1-Flash 技术报告(DeepSeek-AI,2026-09)
- SemiAnalysis InferenceX 上的 V4.1-Flash 结果


