10 月 20 日 DeepSeek 开源了自己的线上推理框架 DeepInfer(详见文末参考的第一篇),10 月 23 日 vLLM 发布在 GB300 NVL72 上的对标结果,10 月 24 日 SGLang 团队发布博客《More Than DeepInfer: What SGLang Delivers》:用 DeepInfer 自己的基准、同样的硬件,把 SGLang 和 DeepInfer 直接放在一起跑。
结论写在开头三行:prefill 在 4× GB300 与 4× B300 上最高达到 DeepInfer 的 1.04 倍吞吐;decode 在 64× GB300(EP64)上单步时间短 1.1% 到 7.4%;其余测点差距都在 1% 以内。
先把 DeepInfer 的优化搬进主干
博客用一张图列出已进 SGLang main 的内核:FlashMLA、DeepGEMM、DeepEP、DeepSelect、TileLang 算子,以及 DeepSeek 的 Mega 系列——MegaAttention、MegaMoE、MegaGate、Mega-mHC。MegaMoE 把 token dispatch、专家 GEMM 和 combine 融进一个内核;MegaAttention 已成为 B300 / GB300 上的默认注意力路径,单机与 PD 分离的 prefill、decode 服务器都走它。
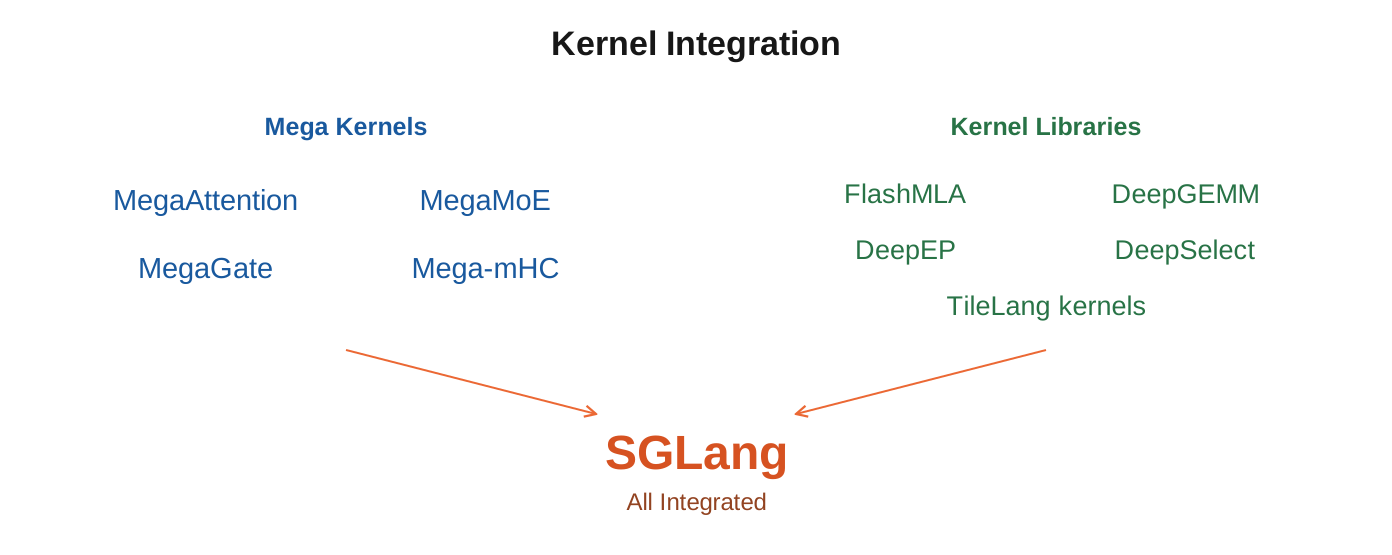
图 1:SGLang 已集成的 DeepSeek 内核(图源:LMSYS)。
其余几项与 DeepInfer 对齐的能力:
- 并行:prefill 与 decode 都用 DP 注意力加专家并行(DEP),基准里 prefill 是 DEP4、decode 是 DEP64(64 张 GB300),宽 EP 下的专家负载由 EPLB 平衡。
- DSpark 投机解码:跑检查点自带的 DSpark 草稿模型,一次提出一个 token 块、由目标模型整块验证,减少前向次数。
- SWA 有界重放:解码器重放只跑最后 128 个 prompt token 上的后段解码层,前段源层仍处理完整 prompt;前缀缓存命中时,编码器重放用最后 128 个缓存 token 重建缺失的滑动窗口 KV。
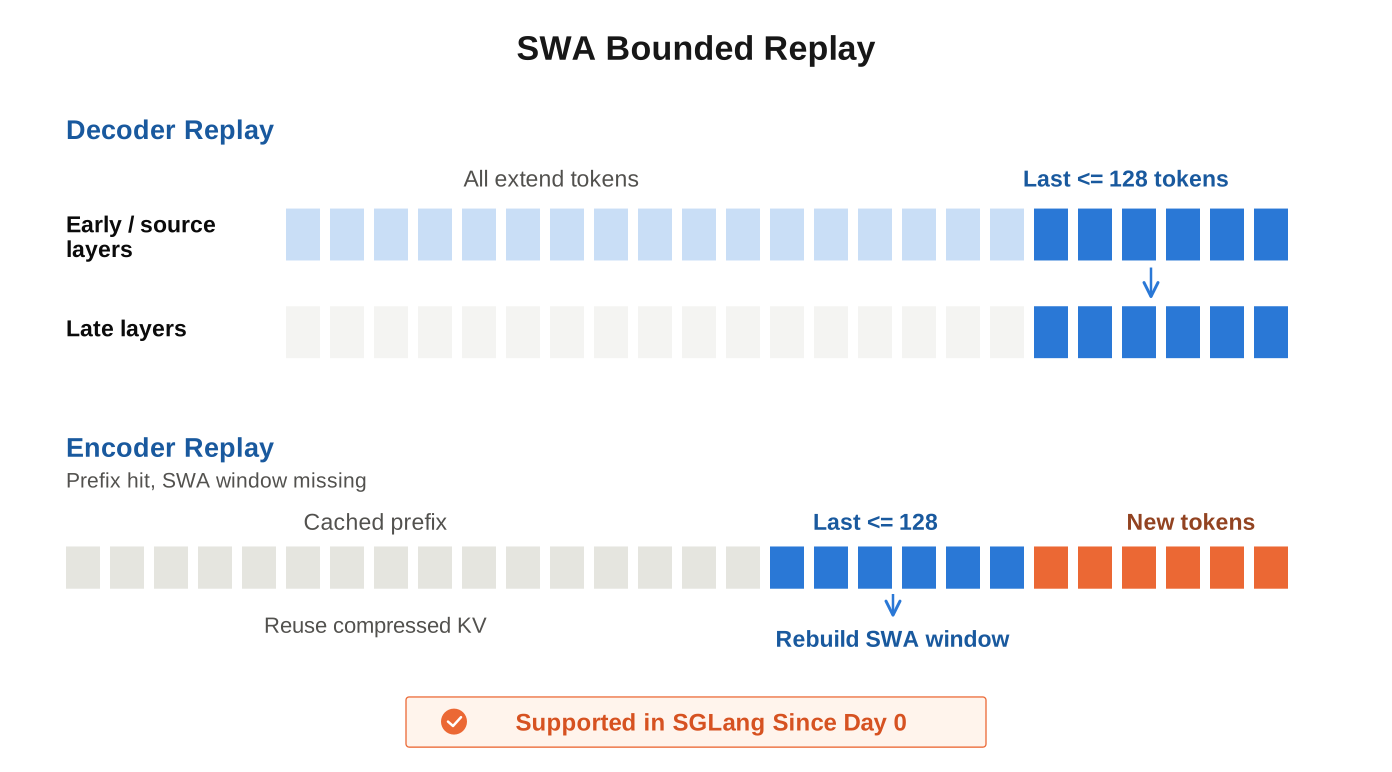
图 2:SWA 有界重放的两条路径(图源:LMSYS)。
- Engram 表两种放置:
SGLANG_ENABLE_DSV41_ENGRAM_HOST_TABLE=1让每个节点在主机内存里只留一份表,把 HBM 尽量让给 KV 缓存;SGLANG_OPT_DSV41_ENGRAM_PEER_SHARDS=1则把表按 GPU 切分,每张卡经 NVLink 直读对端所需行,查找前后不需要 all-gather / reduce-scatter。
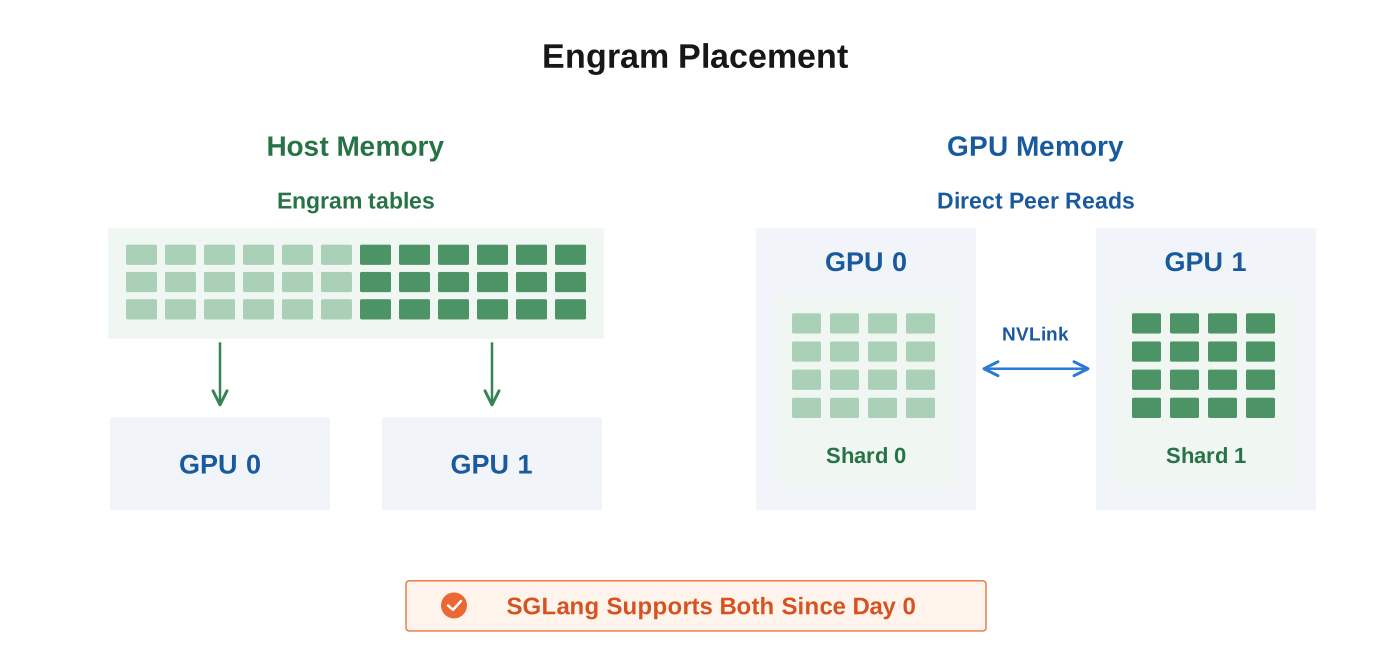
图 3:Engram 表放主机内存,或按 GPU 分片直读(图源:LMSYS)。
- 零开销调度:SGLang 自 v0.4(2024 年 12 月)起就在 GPU 跑第 N 步时由 CPU 准备第 N+1 步。博客特意点出,DeepInfer 的文档把这一设计归于 SGLang。
- DeepSeek 的对话格式:用 DeepSeek 官方的
deepseek-recipe包渲染 prompt、解析输出(PR #45315、#45907、#46219),推理与工具调用在 API 层与 DeepSeek 口径一致;语法约束解码支持 JSON Schema、正则与 EBNF。
实测:同一套基准,三组数字
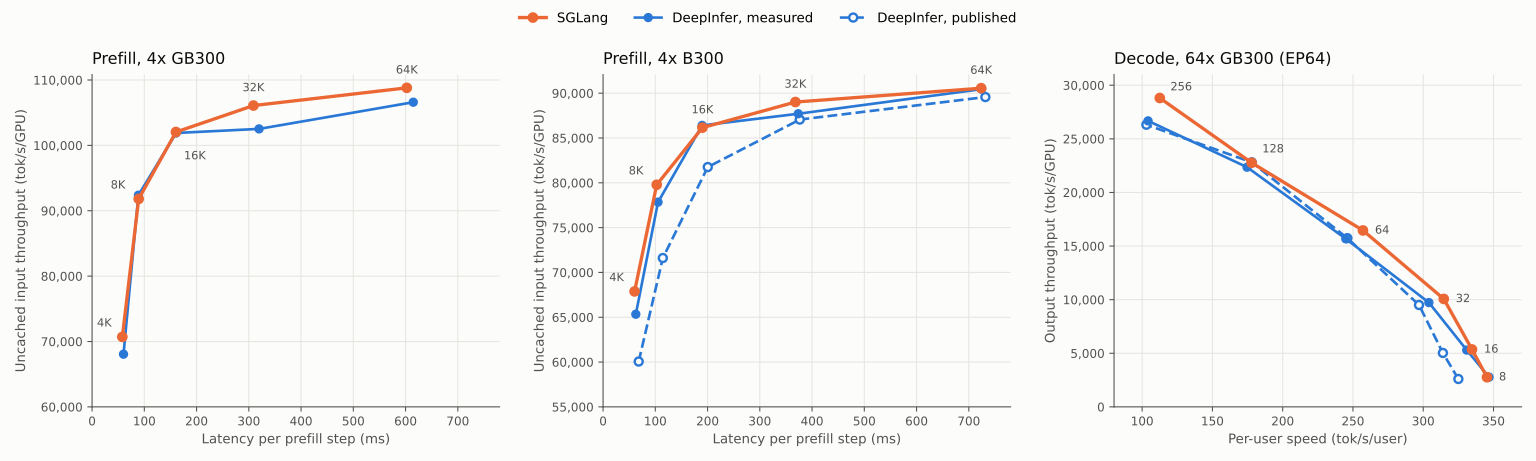
图 4:4× GB300 与 4× B300 的 prefill、64× GB300 的 decode 对比,实线为本次实测,虚线为 DeepInfer 原文公布值(图源:LMSYS)。
| 场景 | 硬件与配置 | 结果 |
|---|---|---|
| Prefill | 4× GB300,DP4/EP4 | 每卡每步 4K、32K、64K 新 token 时领先,8K、16K 持平,最高 1.04× |
| Prefill | 4× B300,DP4/EP4 | 4K、8K、32K 领先,16K、64K 持平,最高 1.04× |
| Decode | 64× GB300,DP64/EP64 | 每卡 16–256 请求下单步短 1.1%–7.4%,8 请求时持平 |
方法上的差异被写进附录,这是这份对比可信度的关键:DeepInfer 在 GPU 0 上测约 9 个 batch,SGLang 则在 20% 到 90% 请求完成之间对每张卡的全部完整 batch 取平均;DeepInfer 每个 GPU 重复同一 prompt,SGLang 给每条请求不同的新 token 数。decode 侧 SGLang 把 Engram 表放显存、DeepInfer 放主机内存,且 DeepInfer 的草稿模型带 64 个冗余专家、SGLang 的不带。图中步长时间按每步接受 3.25 个 token 折算成吞吐。
速度从哪来
三条具体的执行优化:Mega-mHC 直接喂给 MegaMoE;注意力输出以 MXFP8 进入输出投影;prefill 压缩器与请求窗口 KV 拷贝改用融合内核。共同点是减少中间张量的显存往返与 kernel 启动次数。
调度侧,可断开的 CUDA graph 覆盖到每卡 8K token 的 prefill 步,长上下文与数据并行注意力都在内;解码器重放按有界后缀单独建图,于是一次大 prefill 走 eager 执行时,那部分层仍能从 CUDA graph 里重放。
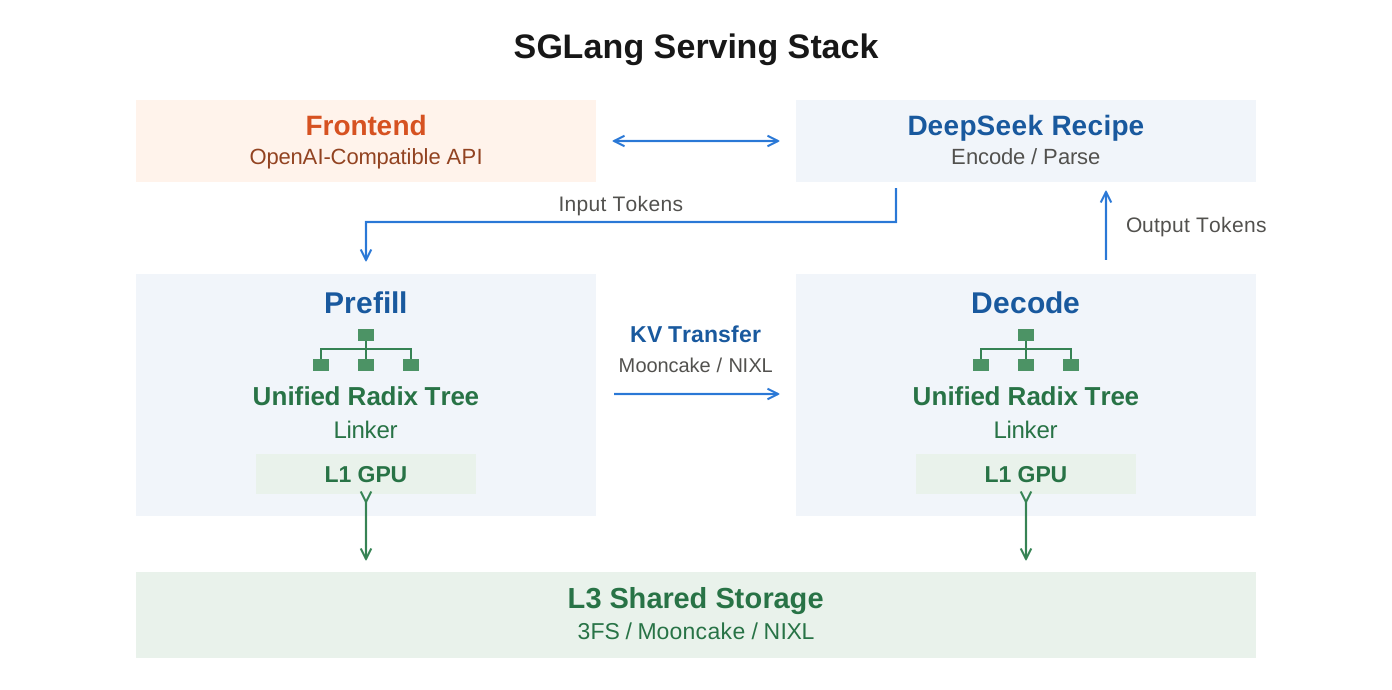
图 5:Linker 把本地 L1 GPU 缓存直接连到共享 L3 存储(图源:LMSYS)。
DeepInfer 缺的三块,SGLang 都有
DeepInfer 的 README 明确列出三件「完整推理服务需要、但开源版不含」的组件,恰好是 SGLang 已经交付的部分:
| 组件 | SGLang 的实现 |
|---|---|
| KV 缓存系统 | 统一 radix cache 跨请求、跨轮次复用 KV;配置中用 Linker 把 L1 GPU 缓存直连共享 L3(3FS、Mooncake 等),另有 HiCache 主机内存 L2 |
| Prefill / decode 分离 | 两端跑在不同服务器,KV 传输后端可选 Mooncake、NIXL 或 MORI |
| 跨副本负载均衡 | 模型网关分发请求,支持按已缓存前缀路由 |
此外 SGLang 本身是 API 服务器,带推理内容与工具调用解析,支持 NVIDIA GB300、B300、B200、H200 与 AMD MI355X。
核心总结
- 对标方式:SGLang 用 DeepInfer 自己的基准、同款硬件对跑,双方代码版本与启动命令全部公开在配套 gist 里
- 结果:prefill 在 4× GB300 / 4× B300 上最高 1.04× 吞吐;decode 在 64× GB300 上单步短 1.1%–7.4%,其余点差距 1% 以内
- 内核:Mega 系列全部进主干,MegaMoE 融合 dispatch + 专家 GEMM + combine,MegaAttention 成为 B300 / GB300 默认注意力路径
- 机制对齐:DSpark 投机解码、SWA 有界重放、Engram 表主机与分片两种放置均已支持;零开销调度是 SGLang 2024 年 12 月就有的设计
- 补齐的服务层:KV 缓存系统(radix cache + Linker + HiCache)、PD 分离(Mooncake / NIXL / MORI)、跨副本负载均衡(模型网关)
- 值得注意:DeepInfer 发布三天内,vLLM 与 SGLang 先后交出对标结果,DeepSeek 开源自家推理栈正在变成整个推理社区的公共考题
原文:More Than DeepInfer: What SGLang Delivers(LMSYS Org,2026-10-24)
参考:
- DeepInfer(DeepSeek-AI,Apache 2.0)
- Serving DeepSeek-V4.1-Flash at Scale: vLLM Matches DeepInfer and Scales to GB300 NVL72(vLLM Blog,2026-10-23)
- 基准启动命令与客户端 gist(SGLang)
- DeepSeek-V4.1 部署 Cookbook(SGLang Docs)


