10 月 21 日,蚂蚁集团与 vLLM 社区共同开源了 Humming——一个面向量化推理的通用高性能内核库,采用 Apache-2.0 许可,代码托管在 vllm-project/humming。它的核心思路是:把「一份权重被量化成什么样」和「这次乘法该怎么算」彻底拆开,前者统一成一套描述,后者交给 JIT 编译器按目标 GPU 和负载现场生成。官方称它覆盖 NVIDIA Turing 及之后的全部架构,以及 CUDA 兼容的平头哥真武 810E。
在官方测得的 GEMM 微基准中,稠密 W4A16 在小 batch 下可达到 cuBLAS 的 3–4 倍;Hopper 上的 W4A8-MXFP4 约为 DeepGEMM W8A8 的 4.2–4.5 倍。端到端服务 DeepSeek-V4.1-Flash 时,吞吐提升 14%–43%。
量化内核的组合爆炸
模型变大之后,显存容量、显存带宽和算力同时成为瓶颈。MoE 尤其明显:每个 token 只激活一部分专家,但全部权重仍要存下来——文章以 DeepSeek-V3 为例,6710 亿总参数,每个 token 激活 370 亿。
量化是应对手段,但配置空间极大。常见的组合有 WNA16、W8A8、W4A8、W4A4(W 是权重位宽,A 是激活位宽,N 表示权重位宽可变);即便名义精度相同,INT4 和 NVFP4 的数值格式与缩放方式也不一样;再叠加缩放粒度、scale 的数据类型、group size、对称与非对称方案,组合数量迅速失控。
为每一种组合单独写一个 kernel,代价不只是写 kernel 本身:每种新组合都要配一套权重重排预处理、内核选择逻辑、框架适配层和测试,已有优化还得在多个实现之间来回移植。Humming 的出发点是「把量化描述与执行选择分离,用共享组件拼装内核」。
架构:把「量化是什么」和「怎么算」拆开
一套统一的量化表示
不同量化工具导出的模型,数值格式、参数组织和权重布局各不相同。Humming 先把它们(AWQ、GPTQ、AutoRound、BitNet,以及 compressed-tensors、ModelOpt、Quark 等导出格式)解析并转换成自己的标准格式:一份统一的量化描述,加上归一化排布后的权重、scale、零点和辅助张量。
这份描述把权重格式、缩放粒度、scale 数据类型、零点、二级 scale 拆成独立参数,激活则有自己的一套数值格式和量化设置;两组参数在格式与硬件约束允许的范围内自由组合。例如 groupwise INT4 权重可以配 BF16 激活,采用不同缩放方案的低精度浮点权重则复用同一套参数体系。
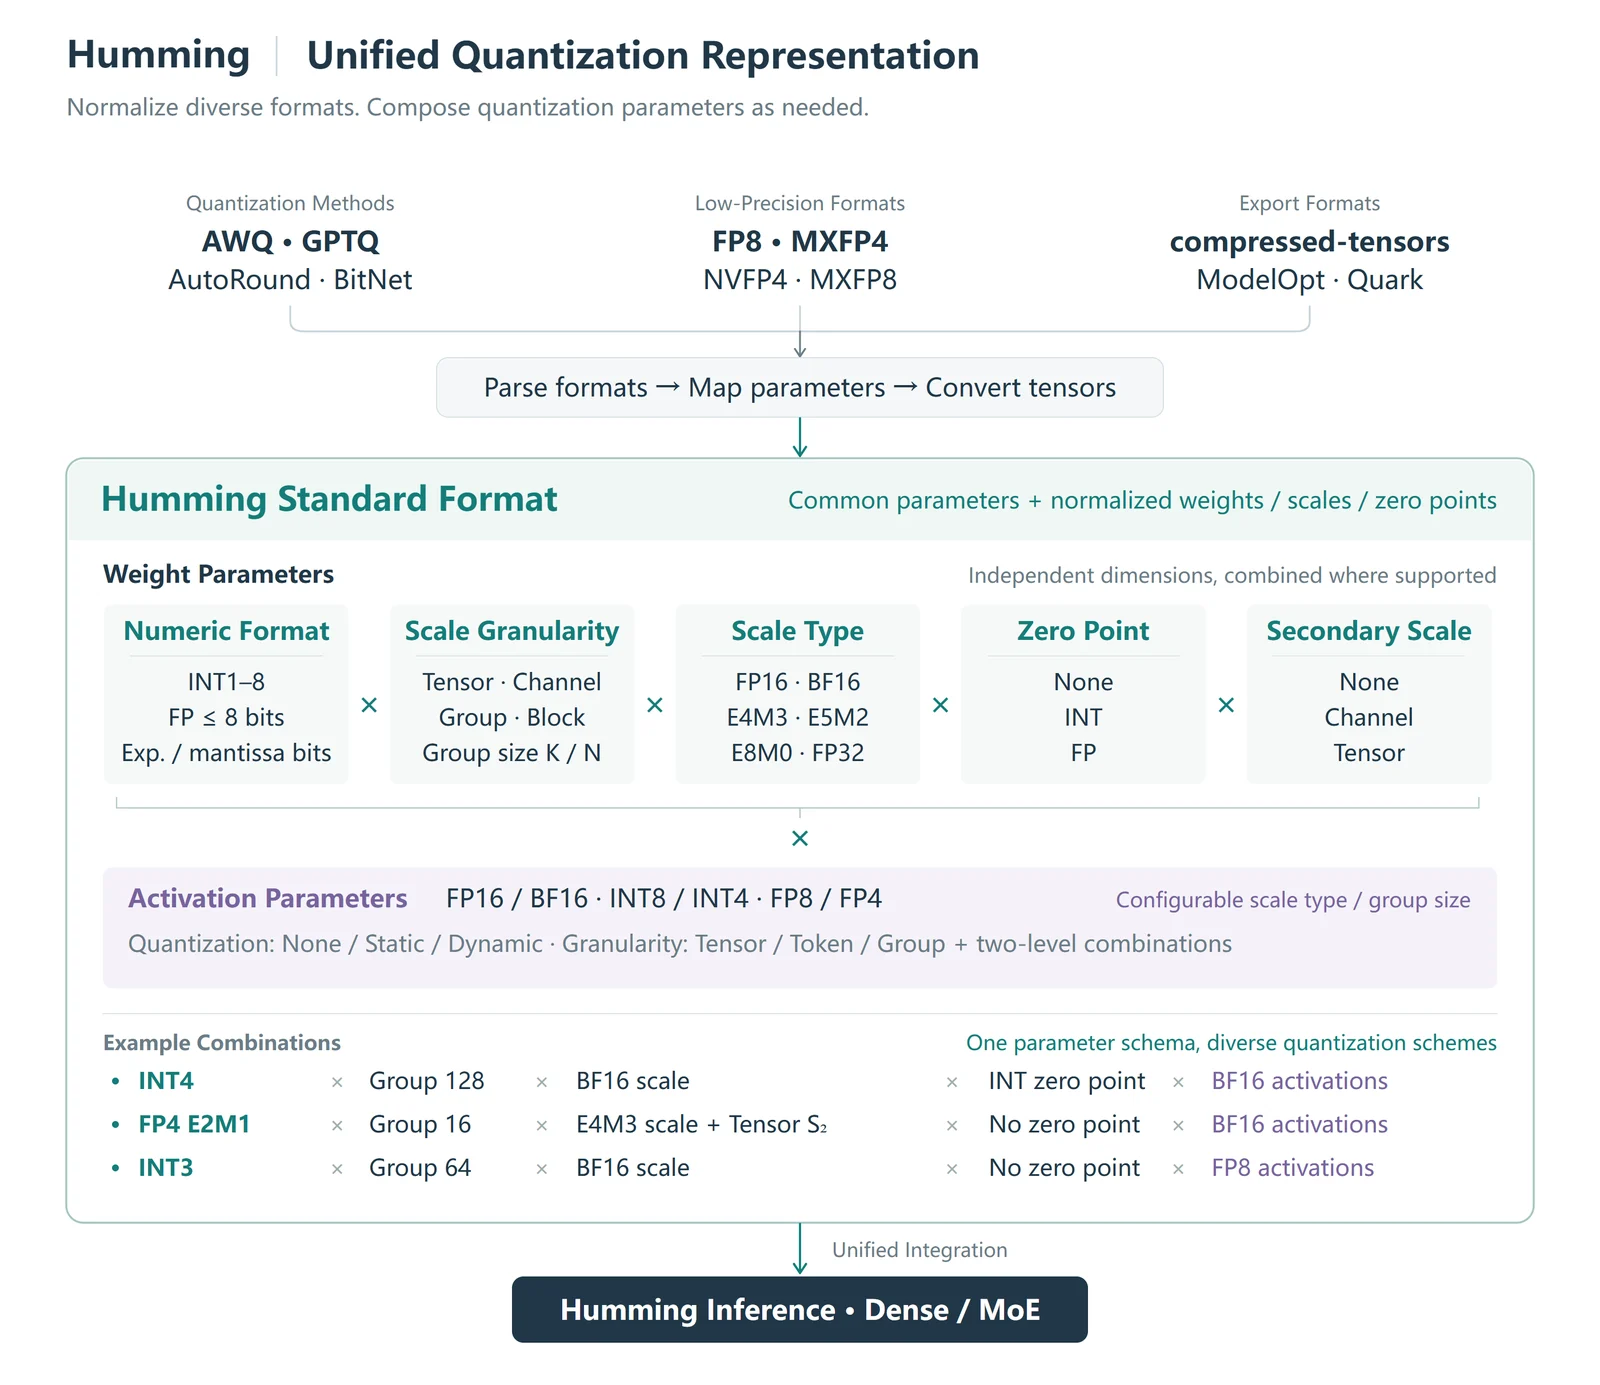
图 1:Humming 把各类量化方案归一为「权重参数 × 激活参数」的组合。图片来源:vLLM 博客
三套配置与 JIT 编译
标准化之后,预处理环节负责校验参数、补齐维度,并把张量重排成对 kernel 友好的布局。执行则由三组配置决定:
- Layer Config:张量形状、数据类型、量化参数、目标架构
- Compute Config:GEMM 类型,以及 batch invariance、输入 scale 布局等计算选项
- Tuning Config:tile 形状、流水级数、warp specialization、访存方式、MMA 指令、并发与调度,TMA 可按张量单独配置
默认情况下,Humming 用针对设备调好的启发式规则选择调优配置,也可以为若干输入尺寸区间分别准备配置、运行时再按实际尺寸分发。这种做法有实际收益:小 batch 下,基于异步拷贝(cp.async)加 MMA 的多级流水可能比 TMA + UMMA 更快;batch 变大之后,TMA 与 UMMA 的吞吐优势才显现出来——两套执行路径共用同一套配置与组件框架,按负载切换即可。
三组配置共同特化出由 NVRTC 或 NVCC 编译的 kernel,编译结果会被缓存复用。
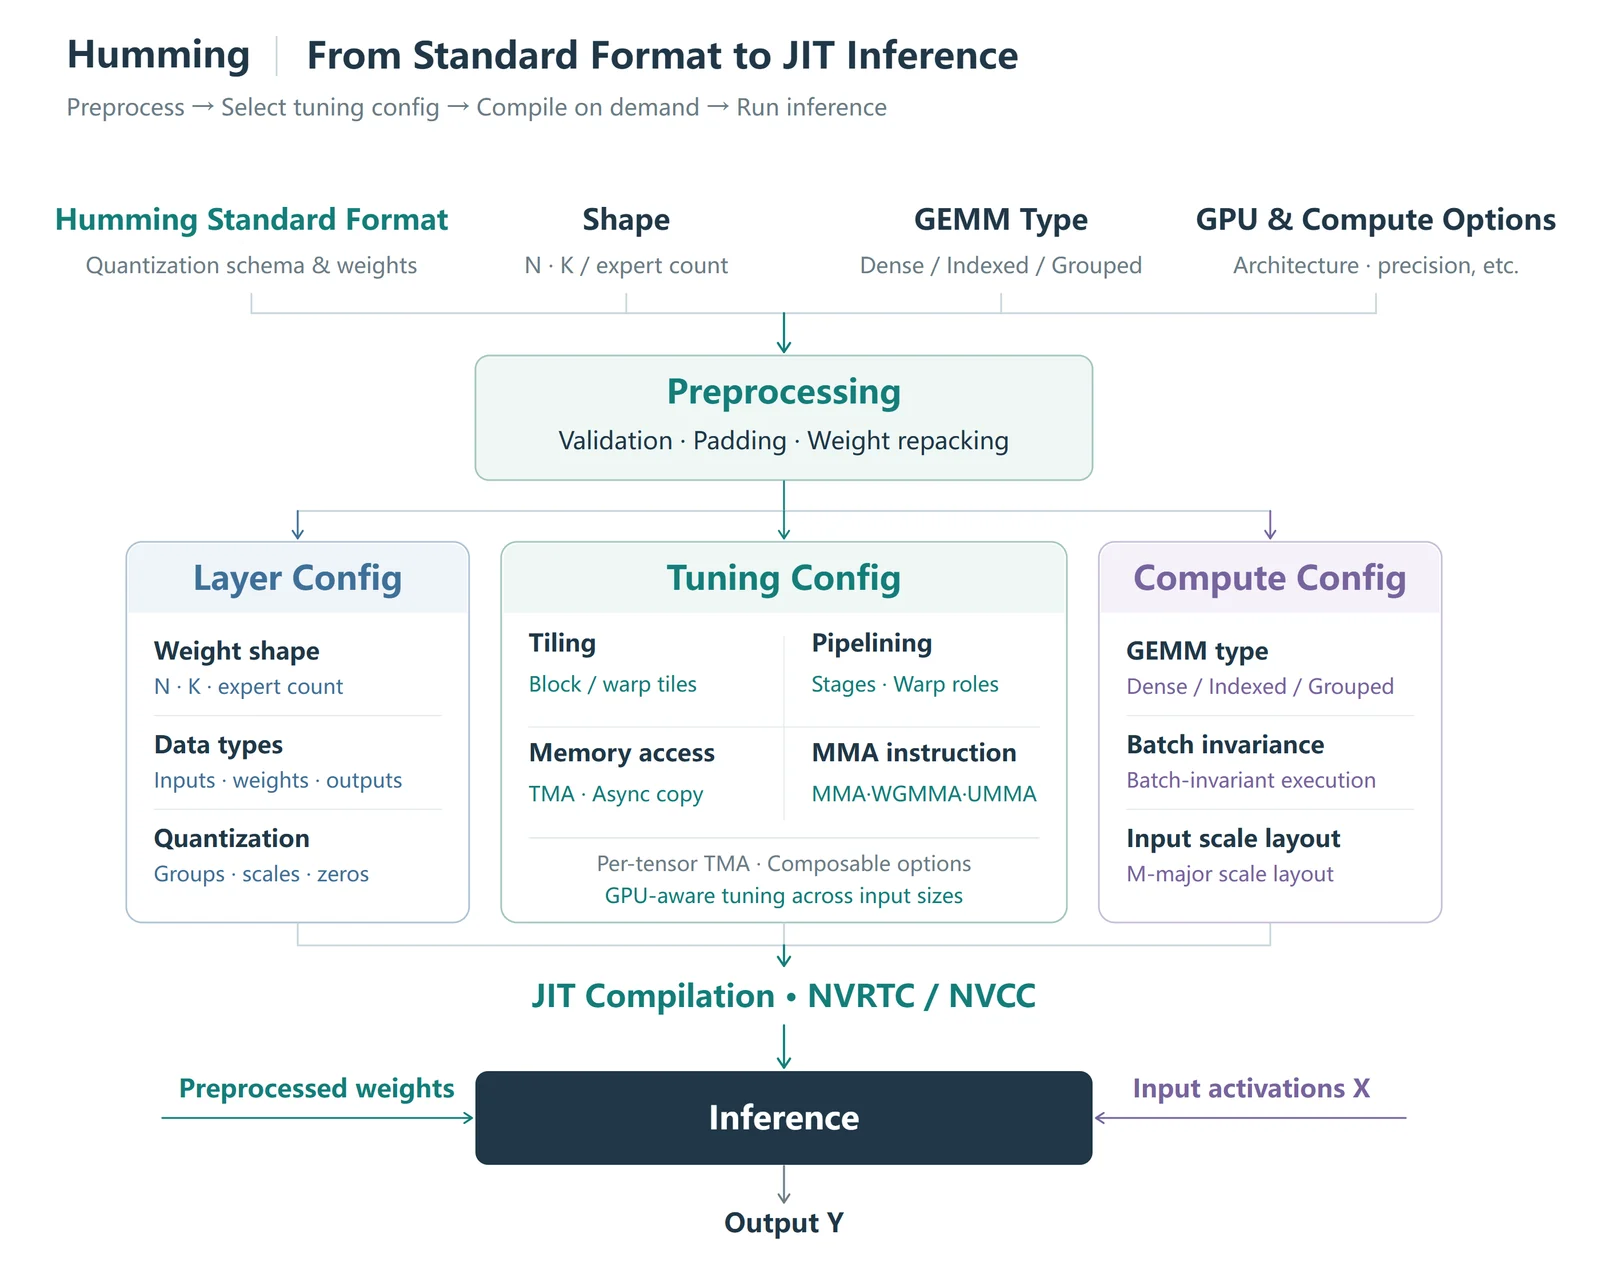
图 2:Humming 的执行流程。图片来源:vLLM 博客
编译速度是这套设计能否成立的关键。在 H200、CUDA 13.4、关闭编译缓存的条件下,单个 W4A16 kernel 用 CUTLASS + NVCC 编译需要 23.35 秒,Humming 用 NVCC 是 1.82 秒、用 NVRTC 是 1.88 秒。模型 warmup 阶段还会并行编译,单个层 GEMM 覆盖全部受支持 M 尺寸的编译加加载只需约 2–4 秒,因此「提前准备多个特化 kernel」在工程上才可行。
共享的 CUDA 组件
在 CUDA 层,Humming 把任务调度、数据搬运、反量化与缩放、Tensor Core 计算、输出处理拆成可复用的组件,并提供 standard、warp-specialized 和专用 UMMA 三条流水线——它们共享兼容组件,各自使用所需的数据流与同步方式。
- 数值处理负责位宽、整数或浮点表示、scale 与零点;反量化和缩放直接融进 kernel 的计算过程
- 访存与计算后端负责架构差异,按目标 GPU 选择异步拷贝、TMA、multicast 以及对应的 Tensor Core 实现
- 任务映射与调度负责稠密和 MoE 负载,Indexed 与 Grouped 各走各自的调度逻辑;scale 与 bias 可以融进输出阶段
JIT 编译时会把没用到的分支裁掉,所以新增一种格式或一种架构,只需要扩展对应组件,而不必维护一份独立 kernel。
覆盖的硬件与格式
设备方面,Humming 完整支持 Turing 以来的全部 NVIDIA 架构,以及平头哥真武 810E;Blackwell 的 SM100/SM103(B300 属于 SM103)与工作站/个人端的 SM120/SM121 都在列表内。文章特别指出,B300 的 UMMA 指令不再支持 INT8 计算,早期 MMA 指令仍能执行 INT8 GEMM,但性能明显更低。
格式方面,整数权重覆盖 INT1 到 INT8,浮点权重覆盖 FP4 到 FP8,并支持 MXFP4、MXFP8、NVFP4、MXINT4 等微缩放格式。此外还有一个特殊格式 float8e0m7:指数位为 0,可表示的值与同位数对称整数一致(INT8 去掉 -128 后同样是 -127 到 127);对于符合条件的对称整型权重,Humming 会自动转成这种格式以加快反量化。
更值得注意的是两个「隐藏」的 Blackwell Tensor Core 格式:float4e0m3 和 float8e3m4。它们没有暴露在 PTX 类型系统中,但 Humming 在 SM100/SM103 与 SM120/SM121 上都做了支持。文章也明确说明,Rubin 不支持这两种原生格式。
性能
基准由 vLLM 社区完成:M 取 1 到 8192 之间每一个 2 的幂,kernel 充分预热后以冷 L2 缓存独立计时,采样之间留出间隔;MoE 的加速比按 Gateup 与 Down 两个 GEMM 的延迟之和计算。
WnA16
WnA16 用低比特权重配 FP16/BF16 激活,是覆盖面最广、也最受关注的一类。以 cuBLAS 为基线,稠密 W4A16 在多数测试配置上与 vLLM Marlin 持平或更好:小 batch 下在多个设备上取得约 3–4 倍加速;batch 增大后,H200 上约为 Marlin 的 2 倍,B300 的部分场景超过 3 倍。
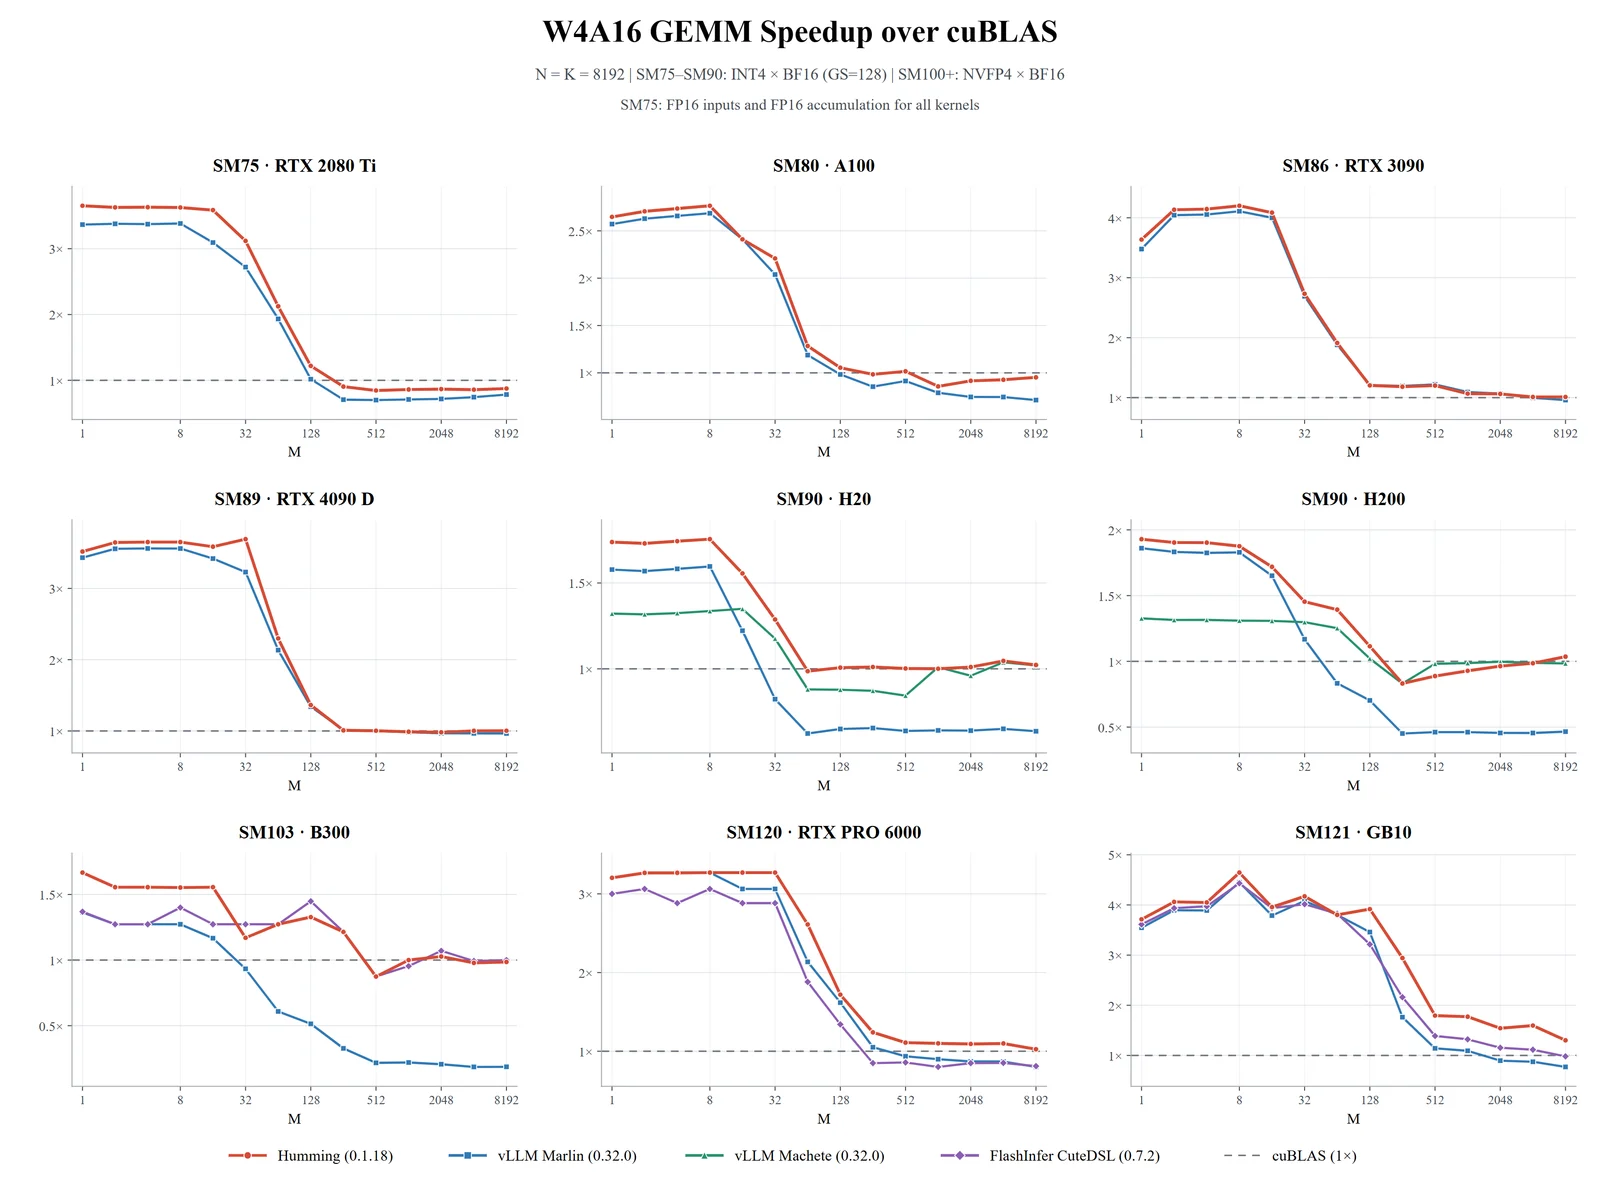
图 3:W4A16 稠密 GEMM 相对 cuBLAS 的加速比。图片来源:vLLM 博客
MoE 上,H20 与 H200 的 MXFP4 W4A16 在多个中大批次场景约为 Marlin 的 2 倍;B300 上 MXINT4 与 NVFP4 的 Grouped 路径可达约 5 倍。此外,SM120 上最低位宽的配置超过 BF16 cuBLAS 的 5 倍。
W8A8 / W4A8 / W4A4
Hopper 一代,FP8 W8A8 配合块级缩放已是主流。以 DeepGEMM Contiguous 为基线,Humming 在中小批次下于 H20 达到约 2.6 倍、H200 约 2.5 倍,Indexed 与 Grouped 两种布局都具备竞争力。
更有意思的是 W4A8-MXFP4。Hopper 架构没有原生 MXFP4 Tensor Core,常规 W4A8-MXFP4 kernel 在大 M 时会被反量化与缩放开销拖住。Humming 在 kernel 内把 MXFP4 权重快速转成 INT8/FP8 可计算格式,中小批次下达到 DeepGEMM W8A8 基线的约 4.2 倍(H20)与 4.5 倍(H200),也明显超过自己同图的 W8A8 结果。文章还提到,FlashInfer CUTLASS W4A8 正是基于 Humming 的思路实现的,而 Humming 当前版本在展示的基准中表现更好。
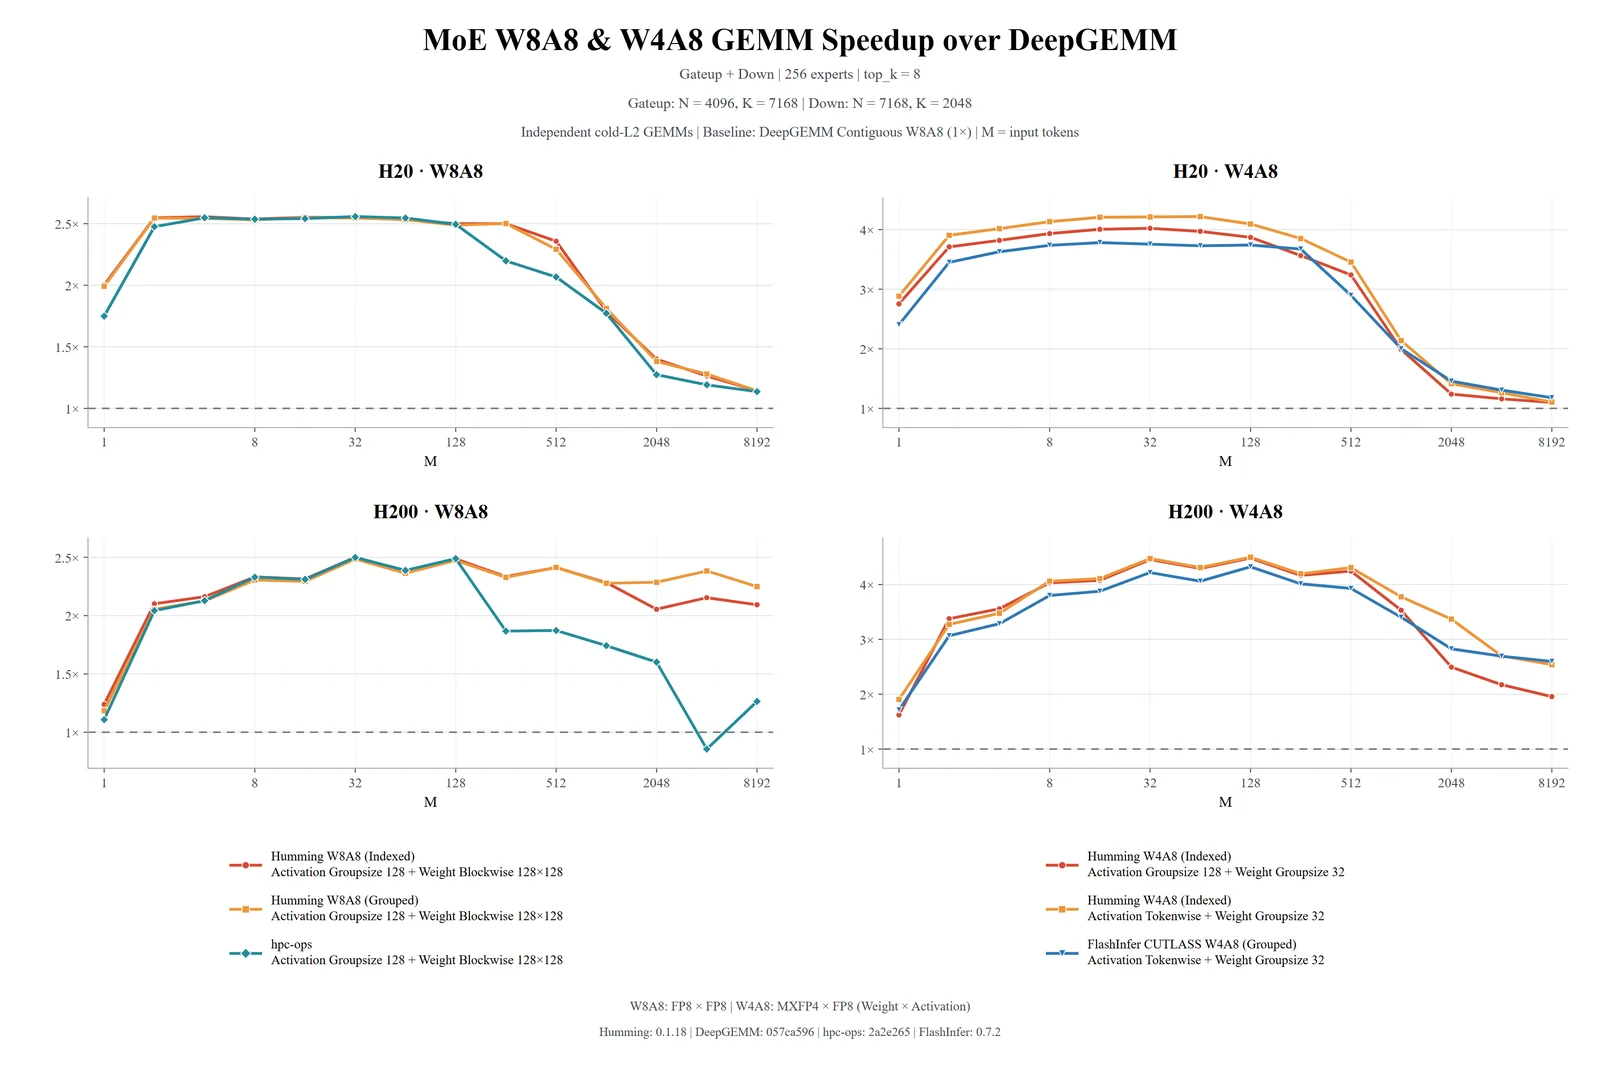
图 4:H20 与 H200 上的 W8A8(左)与 W4A8-MXFP4(右)。基线为 DeepGEMM Contiguous W8A8。图片来源:vLLM 博客
在 Blackwell 上,Humming 用同一套 kernel 和调优框架覆盖 W8A8、W4A8、W4A4。B300(SM103)上以对应精度的 DeepGEMM Contiguous 为基线,中小批次分别达到约 1.25 倍、1.6 倍、1.4 倍,并在多个负载上优于对应的 FlashInfer 实现。SM121 小批次下,W4A8 相比 FlashInfer CUTLASS 提升约 19%,W4A4 约 9%。
端到端服务
kernel 层面的收益能否传导到线上服务,是这类库最终要回答的问题。测试用 DeepSeek-V4.1-Flash,8 张 H20、TP=8,保持模型原有的 MXFP4 权重不变,只把 MoE 执行从 Marlin W4A16(BF16 激活)换成 Humming W4A8(tokenwise FP8 激活):
- 端到端吞吐提升约 14%–43%
- 平均首 token 延迟(TTFT)下降约 25%–32%
- 并发 64 时,输出吞吐从 442.37 升到 633.94 tokens/s,TPOT 下降约 31%
| 并发 | 输出吞吐(tok/s,Marlin → Humming) | TTFT(ms) | TPOT(ms) |
|---|---|---|---|
| 1 | 88.30 → 100.77(+14.1%) | 543.13 → 383.80 | 9.24 → 8.46 |
| 2 | 149.33 → 176.38(+18.1%) | 794.31 → 555.66 | 10.33 → 9.20 |
| 4 | 231.99 → 286.12(+23.3%) | 1422.32 → 971.74 | 11.72 → 10.22 |
| 8 | 287.04 → 383.04(+33.4%) | 2049.81 → 1386.91 | 19.90 → 15.49 |
| 16 | 348.96 → 475.89(+36.4%) | 2463.69 → 1844.71 | 36.28 → 26.44 |
| 32 | 398.83 → 560.49(+40.5%) | 3546.74 → 2465.47 | 66.44 → 47.48 |
| 64 | 442.37 → 633.94(+43.3%) | 5467.35 → 3882.94 | 123.25 → 85.70 |
表:DeepSeek-V4.1-Flash 在 8×H20、TP=8 下的端到端对比。
怎么用
安装只需一条命令;如果没有 CUDA 编译器,再按 CUDA 大版本装上编译依赖:
pip install humming-kernels
pip install "humming-kernels[cu12]"   # CUDA 12
pip install "humming-kernels[cu13]"   # CUDA 13
wheel 包只有约 500 KB,依赖很轻——按文章的说法,任何能跑 PyTorch 2.7 的环境原则上都能跑 Humming。
vLLM 从 0.29.0 起,CUDA 安装已默认包含 Humming,无需单独安装,NVIDIA 支持范围为 SM75 及以上。用 --linear-backend 与 --moe-backend 分别指定稠密 GEMM 与 MoE GEMM 的后端:
vllm serve deepseek-ai/DeepSeek-V4.1-Flash-1017 \
    --tensor-parallel-size 8 \
    --linear-backend humming --moe-backend humming
--quantization humming 只是兼容路径,用于 Humming 支持但 vLLM 已不再原生支持或尚未支持的格式,例如 GPTQ INT3:
vllm serve hfl/Qwen2.5-VL-3B-Instruct-GPTQ-Int3 --quantization humming激活类型默认沿用 checkpoint 里的设定,并按设备自动适配;如果设备不支持该计算类型,就回退到受支持的更高精度类型(如 FP8、BF16、FP16)。需要覆盖时通过 vLLM 的量化配置指定:
vllm serve openai/gpt-oss-20b --moe-backend humming \
    --quantization-config.moe.activation mxfp8
后续计划
- 更广的设备:支持 Rubin 的 Locality Domains 等特性;扩展到真武 M890 等更多平头哥 PPU;支持更多 CUDA 兼容平台
- 加入 autotune:在目标设备上实测候选配置,作为启发式规则的补充,减少手工调参
- 更深的框架集成:覆盖 vLLM 的量化模型加载、后端选择、并行推理、运行时调度与设备适配,并支持专家并行(EP)所需的量化 All-to-All
核心总结
- 事件:蚂蚁集团与 vLLM 社区开源量化推理内核库 Humming(Apache-2.0),把量化描述与执行选择分离,由 JIT 按设备和负载生成 kernel
- 架构:统一量化表示 + Layer/Compute/Tuning 三组配置 + 共享 CUDA 组件;小 batch 走
cp.async+ MMA,大 batch 走 TMA + UMMA - 编译速度:单 kernel 编译从 CUTLASS + NVCC 的 23.35 秒降到 1.82 秒(NVCC)/ 1.88 秒(NVRTC);warmup 阶段并行编译全部 M 尺寸约 2–4 秒
- 覆盖范围:Turing 起的全部 NVIDIA 架构与真武 810E;INT1–INT8、FP4–FP8、MXFP4/MXFP8/NVFP4/MXINT4;还支持未在 PTX 暴露的
float4e0m3与float8e3m4 - 性能:稠密 W4A16 小 batch 约 3–4× cuBLAS;Hopper W4A8-MXFP4 约 4.2–4.5× DeepGEMM W8A8;DeepSeek-V4.1-Flash 端到端吞吐 +14%–43%,TTFT −25%–32%
- 使用:
pip install humming-kernels,wheel 约 500 KB;vLLM 0.29.0 起默认内置 - 存疑之处:所有数字均来自官方基准与官方撰写的博客,尚无第三方复现;端到端结果只在 8×H20 单机单模型上测得
原文:Announcing Humming: Fast, Flexible Kernels for Quantized Inference(vLLM Blog,Ant Group and the vLLM Community,2026-10-21)
参考:
- vllm-project/humming(GitHub,Apache-2.0)


