10 月 16 日,美国 Brooklyn 的初创公司 Reflection AI 把首个模型 Beam 的权重放到 Hugging Face,采用 Apache 2.0 许可。Beam 是稀疏混合专家(MoE)模型,总参数 501B、每 token 激活 23B,主打编码、推理与长程智能体任务,支持 100 万 token 上下文,仅接受文本输入。
这比 Reflection 自己的时间表提前了约两周。10 月 5 日的预告文中,公司称模型还在做最后的红队测试与评测,权重「本月晚些时候」发布;10 月 16 日的发布则同时给出了最终模型卡、安全技术报告,以及一套被其称作「智能体开放操作系统」的生态——模型是内核,其上的参考智能体集成、部署容器、推理集成与定制流水线全部开放。
规格与架构
| 属性 | Beam 501B A23B MoE |
|---|---|
| 总参数 | 501.3 B |
| 激活参数 | 23.4 B |
| 层数 | 52:3 层稠密 + 49 层 MoE |
| 注意力 | 带门控的 GQA + 滑动窗口注意力 |
| 上下文 | 1 M token |
| 词表 | 152 k |
| 专家数 | 256 |
| 模态 | 文本 |
| 数值格式 | BF16 / FP8 / NVFP4 |
| 知识截止 | 2026 年 6 月 30 日 |
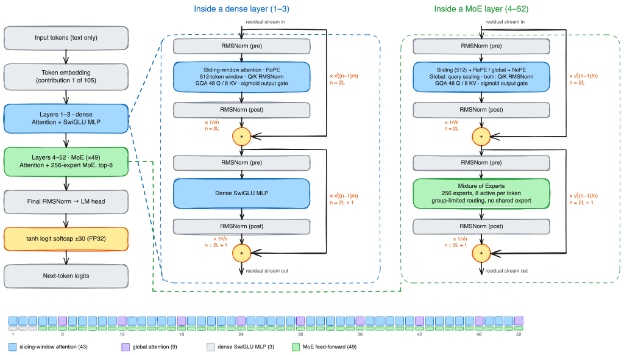
图 1:Beam 的整体结构,底部色带标出滑动窗口层、全局注意力层、稠密层与 MoE 层的分布(图源:Hugging Face)。
注意力采用 8:1 混合。52 层隐藏维度 5,120,大部分层只看前 512 个 token 的滑动窗口,每第 6 层以及最后一层做全局注意力,于是得到 43 个窗口层与 9 个全局层。两类层处理位置的方式不同:窗口层用 RoPE,因为短窗口内相对位置最重要;全局层不带任何位置编码,改为给每个查询乘一个随可见 token 数缓慢增长的缩放系数 (1 + (pos + 1) / 2048) ** 0.1。实现里称之为「可缩放 softmax 查询缩放」,作用类似温度:上下文变长时 softmax 不会逐渐平坦化,从而保住精度。注意力为分组查询,48 个查询头配 8 个 KV 头,查询与键上各加一层 RMSNorm,并用一个从层输入算出的 sigmoid 门对每个头的每个通道做缩放。
路由沿用 DeepSeek-V3 的分组方案。前 3 层是稠密 SwiGLU MLP,其余 49 层换成 256 个专家的 MoE 块,每个专家是中间维度 2,560(约 3,900 万参数)的 SwiGLU MLP——专家合计占全模型 98.4% 的参数。路由器用 sigmoid 给 256 个专家打分,切成 8 组、每组 32 个,按「组内前两名的分数之和」排序保留最好的 4 组,再在其中挑出 8 个专家。Beam 与 DeepSeek-V3 组大小相同,但没有共享专家;专家输出用归一化后的路由权重加权,再整体放大 2.5 倍。
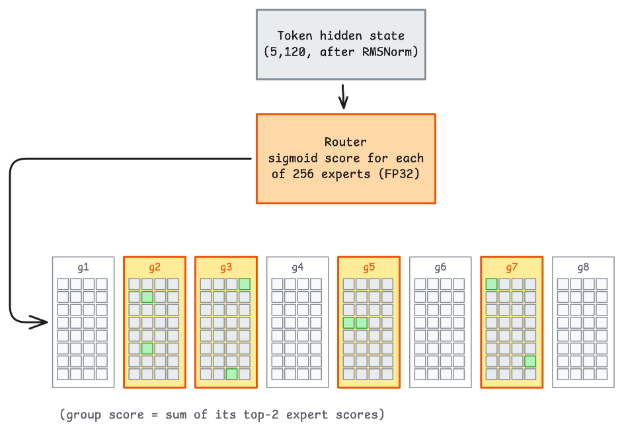
图 2:分组限定的专家路由,组分数取该组前两名专家分数之和(图源:Hugging Face)。
残差流是架构上最特别的一处。标准 Transformer 以权重 1 把每个子层输出加进残差流,流会随深度增长;Beam 把输入嵌入算作第 1 步,在第 k 步以 1/√k 的权重加入子层输出、以 √((k−1)/k) 保留原有流。两个权重平方和为 1,残差流从第一层到最后一层保持恒定尺度。104 次相加之后,每个子层输出与输入嵌入在最终隐状态里权重相同。每个子层前后各有一层归一化,最终 logits 用 ±30 的 tanh softcap 截断,且路由器、SwiGLU 乘积、各归一化、RoPE、查询缩放与 softcap 这些环节固定在 FP32 下计算。
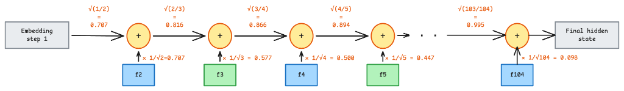
图 3:深度相关的残差权重把流稳定在常数尺度(图源:Hugging Face)。
混合注意力也直接决定了长上下文的开销。每层每 token 缓存 2 × 8 KV 头 × 128 维 = 2,048 个值;若 52 层都保留全序列,缓存按每 token 208 KiB 增长。而 43 个窗口层各自只持固定 512 token 的窗口、不再增长,于是实际增速降到每 token 36 KiB,约为前者的六分之一。
| 上下文 | 若 52 层全为全局注意力 | Beam |
|---|---|---|
| 32 K token | 6.5 GiB | 1.2 GiB |
| 128 K token | 26 GiB | 4.6 GiB |
| 满上下文(1 M) | 208 GiB | 36.08 GiB |
以上为单序列、BF16、Transformers 动态缓存下的数字。
基准表现:对标 GLM 5.2,推理算力少 3–4 倍
Reflection 把 Beam 的定位说得很直接:在编码与智能体任务上与更大的开源模型 GLM 5.2 相当、接近 Qwen 3.8-Max;在原始能力上仍落后 Kimi K3,优势在于推理时的效率。按公司的说法,Beam 在高级推理基准上取得与 GLM 5.2 相当的分数,但推理算力少 3–4 倍;与 Qwen 3.8-Max 这类 2T 以上参数家族的模型相比,效率差距更明显。
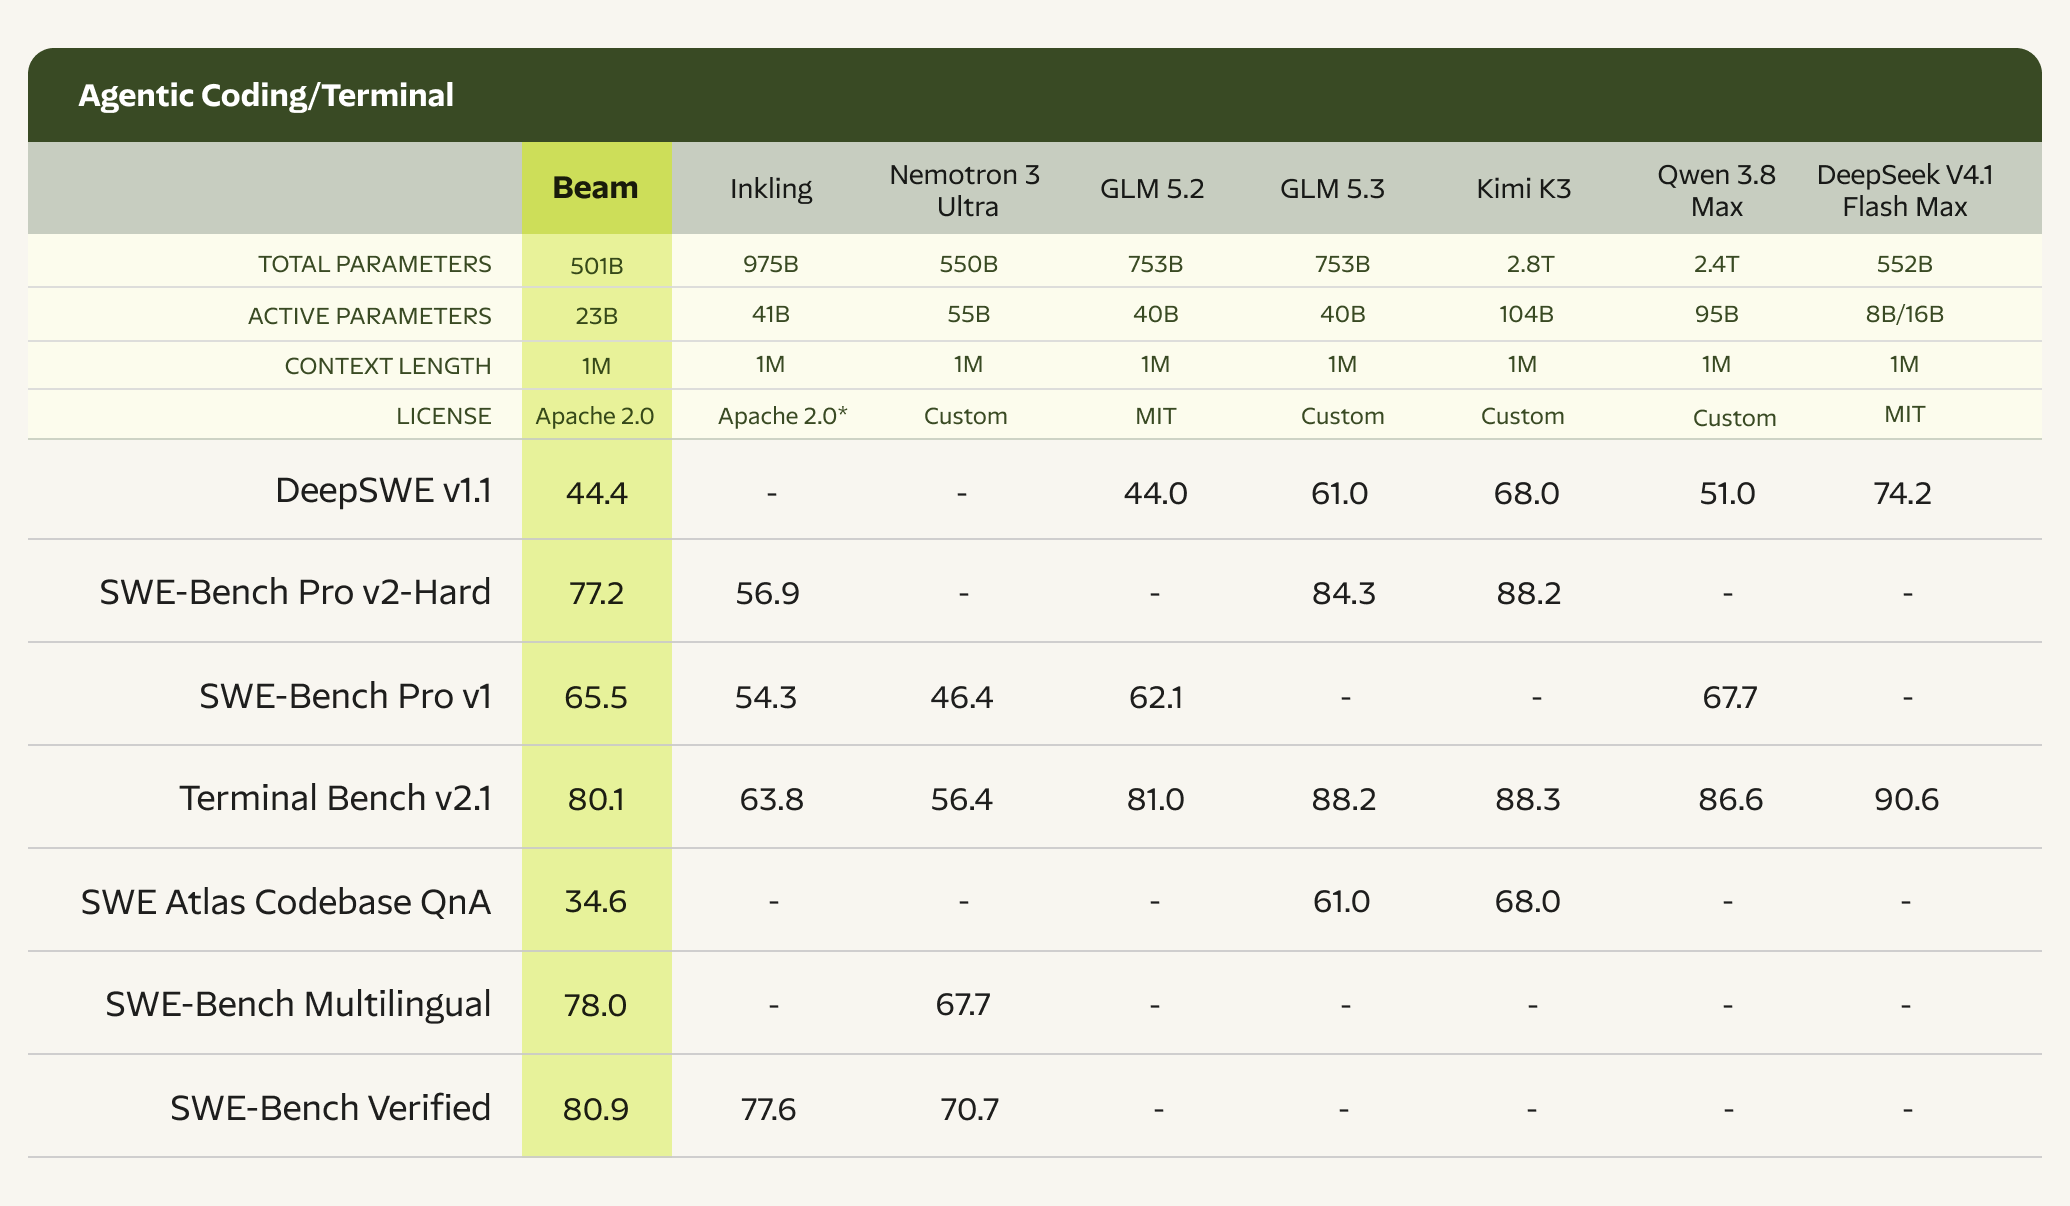
图 4:预告文中的智能体编码/终端基准对比,含参数量与许可(图源:Reflection)。
需要留意的是,同一模型在不同文档里的数字并不完全一致。10 月 5 日的预告文给出 DeepSWE v1.1 44.4、SWE Atlas Codebase QnA 34.6、SWEBench Verified 80.9;最终模型卡(BF16)则是 DeepSWE v1.1 43.3、SWE Atlas Codebase QnA 31.8、SWEBench Verified 81.6,Terminal Bench v2.1 同为 80.1。两个版本都未作独立复现,且对比表里对手的成绩多由各自厂商自报。
最终模型卡上的三档精度表现相当接近。编码与终端类:SWE Bench Pro v2-Hard 在 BF16 / FP8 / NVFP4 下分别为 76.5% / 78.4% / 78.6%(NVFP4 反而最高),SWEBench Verified 为 81.6% / 80.2% / 80.7%,Terminal Bench v2.1 为 80.1% / 78.9% / 78.4%。推理类:AIME 2026 97.7%、GPQA Diamond 90.6%、LiveCodeBench 88.3%、SciCode 49.2%,HLE 不带工具 36.0%、带工具 51.1%。工具调用与检索类:MCP Atlas 80.8%、带上下文管理的 BrowseComp 76.8%、DeepSearchQA 80.5%。通用能力:AA-LCR 78.2%、LongBench v2 67.5%、IFBench 79.6%。
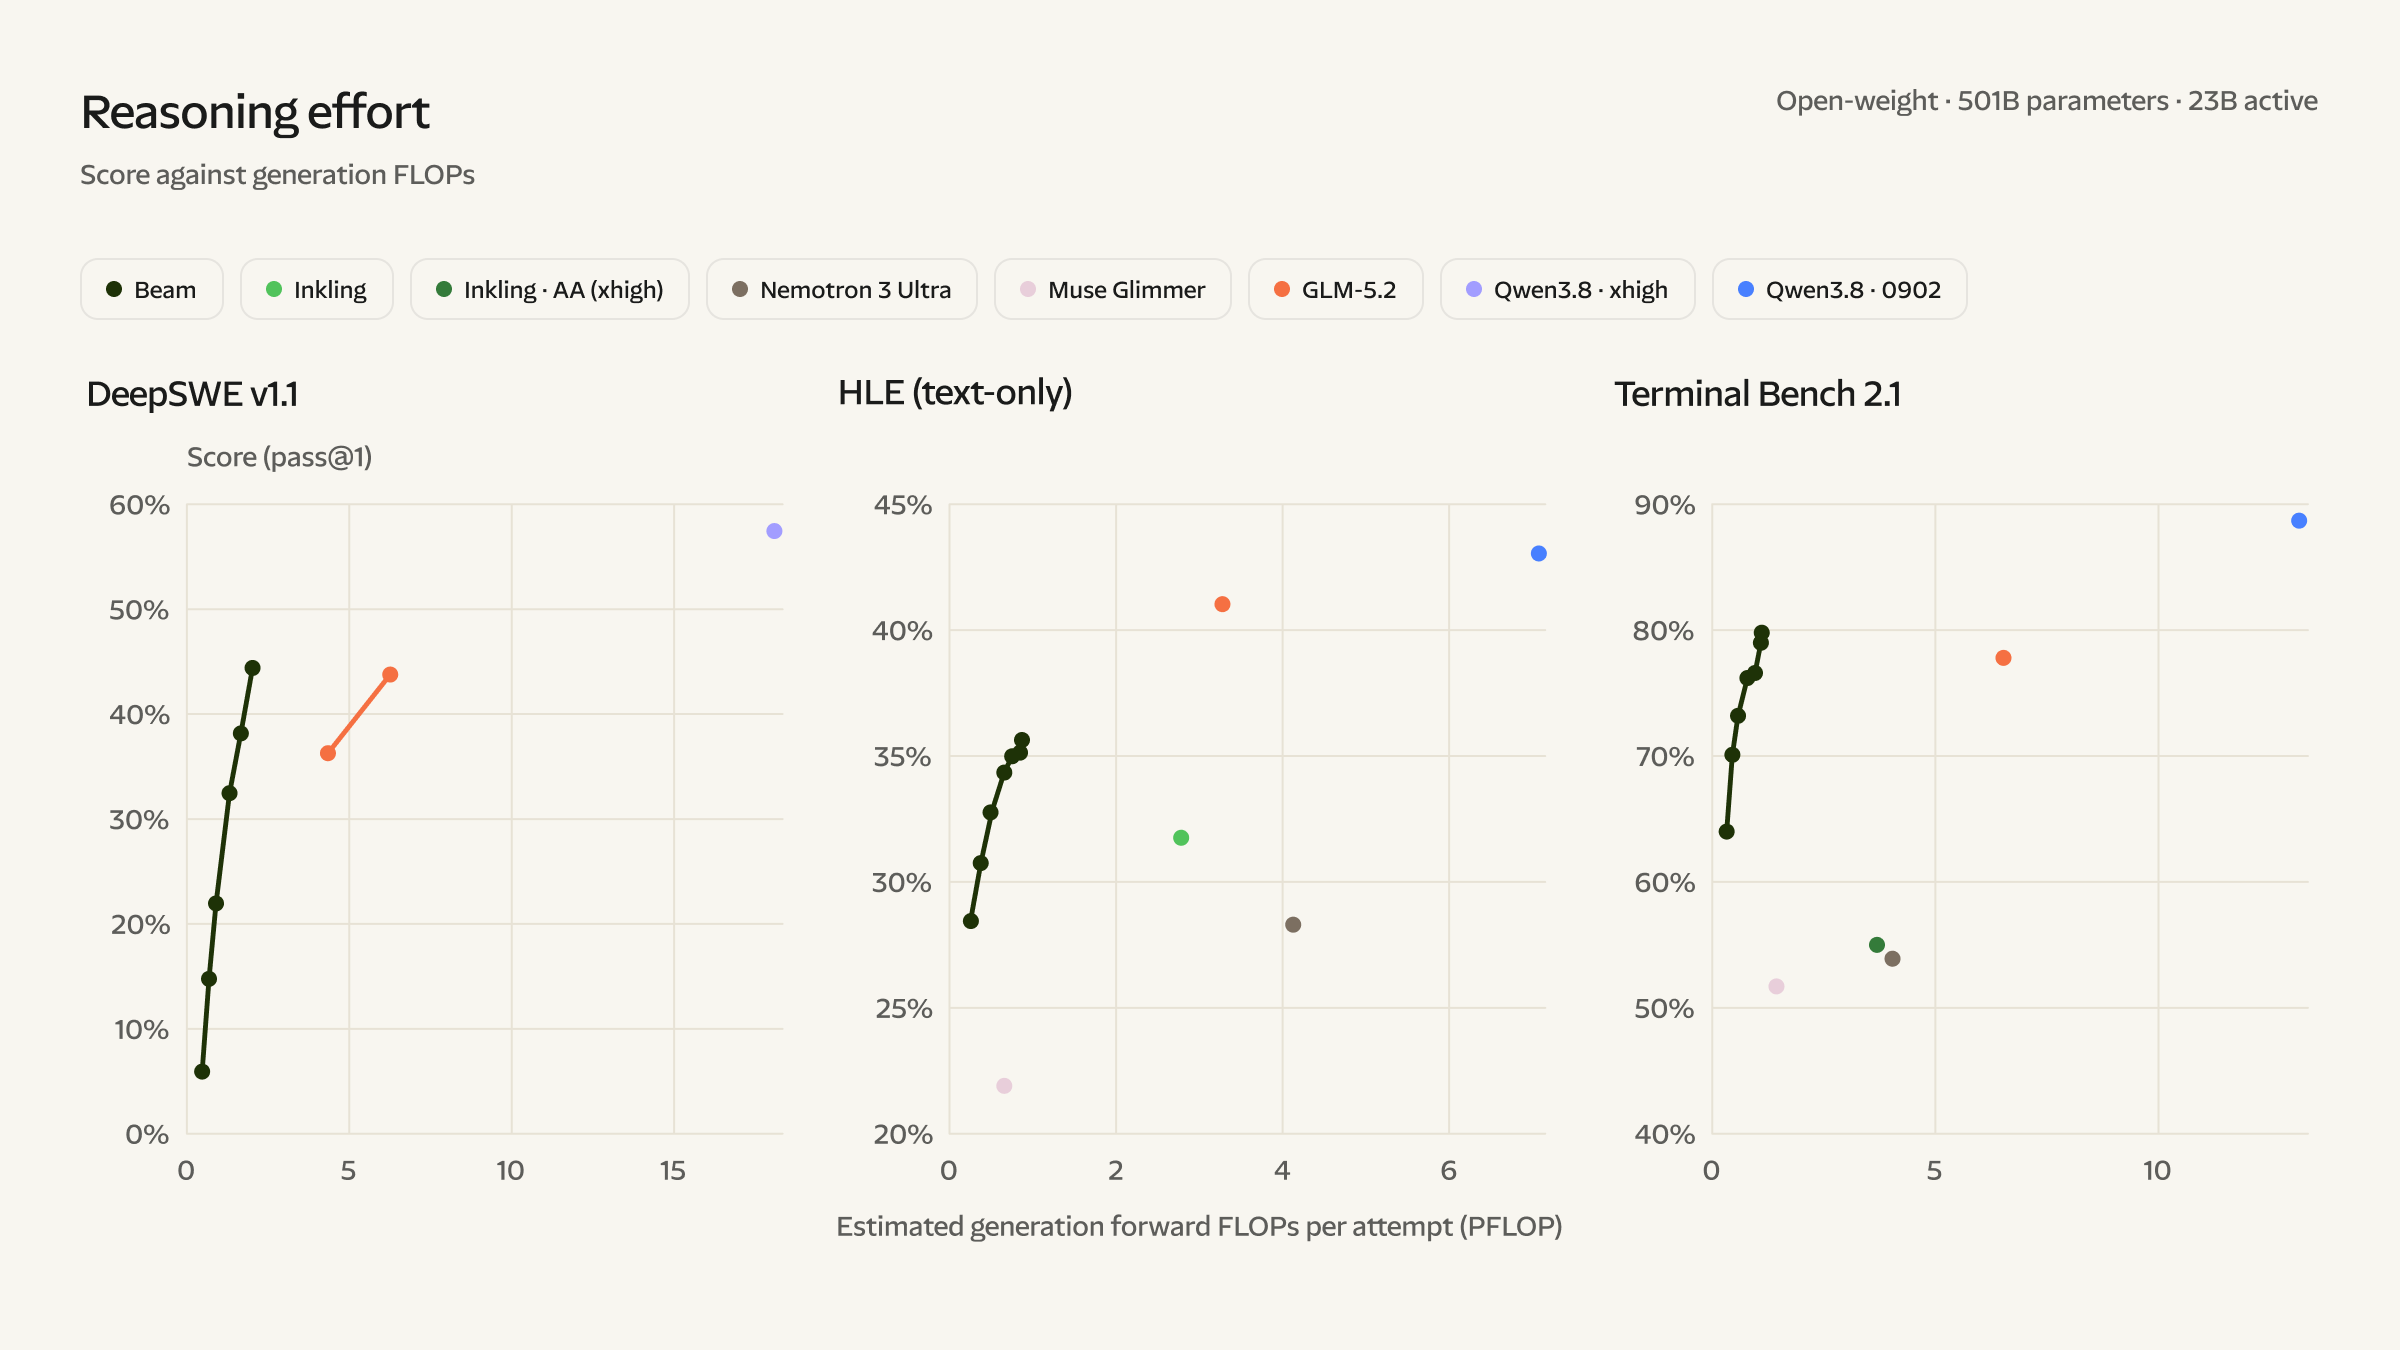
图 5:DeepSWE v1.1、HLE 与 Terminal Bench 2.1 上「得分对生成 FLOPs」,Beam 的帕累托前沿更靠左(图源:Reflection)。
Reflection 说明这张图里的算力是估算值:按 FLOPs ≈ 2 × 激活参数量 × 每次尝试平均生成 token 数 计算,MoE 用每 token 激活的参数量而非总参数量,且不计 prompt 预填充、依赖上下文的注意力运算与服务开销,因此只能作近似比较。第三方方面,据覆盖此次发布的报道,Artificial Analysis 把 Beam 列为美国开源权重模型智能指数第二(得分 30),在 Cyber 指数上则是美国开源模型第一。
高算力强化学习:以算力换能力
Beam 把高算力强化学习当作核心扩展轴。训练用了 10,500 张 NVIDIA GB300,持续 4 周,生成超过 1 亿条 rollout,最大上下文长度 256K token;训练与判分合计消耗约 13 亿个沙箱,为此准备了约 100 万个编码、智能体与 STEM 环境。Reflection 称这是迄今开放实验室中规模最大的 RL 训练之一。
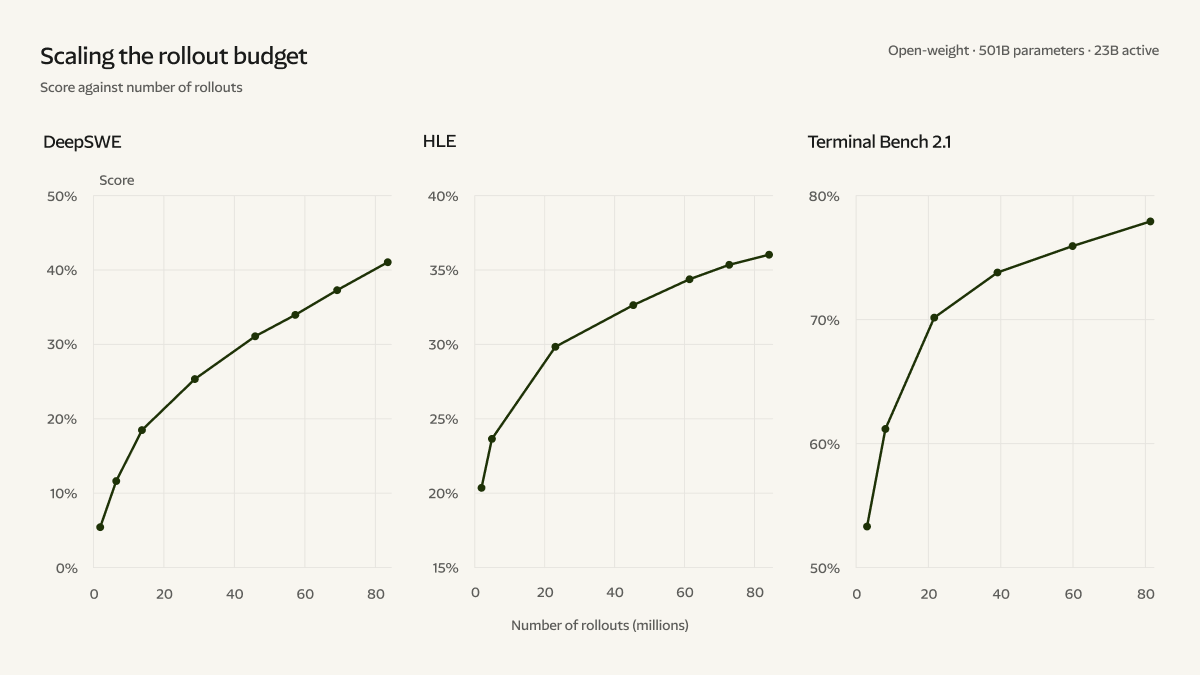
图 6:Beam 推理专家训练期间的得分曲线,覆盖全部 1 亿余条 rollout 中的 8,000 万条;作为对比,Inkling 训练用了 3,000 万条,MiMo 为 75.3 万条(图源:Reflection)。
规模化的难点在异步策略梯度。长 rollout 的 token 由多个模型检查点产生,越靠前的 token 相对当前策略越「陈旧」,训练与推理引擎之间的数值不一致又进一步放大问题。Reflection 为此开发了新算法以在这些条件下保持学习稳定,并系统性地缩小全链路的训推不匹配,声称即便从一天前生成的交互中学习也仍然稳定——训练时策略滞后 107 个权重版本仍能保持数值稳定。
长度控制是另一条线索。Beam 用一个可控的长度惩罚奖励成功解、抑制不必要 token:RL 早期完成长度下降而表现上升,说明模型学会了用更少推理解决问题;后期随着智能体能力增强,完成长度又重新变长,这些额外 token 支撑了进一步提升。用户可通过 reasoning effort(推理力度) 参数在该权衡上取舍,可选 low、medium(默认)、high、xhigh、max 五档。
Reflection 还观察到能力的跨域迁移:在一段只含推理、软件工程与终端任务的 RL 阶段里,浏览能力仍持续上升,尽管训练混合中没有浏览任务。接入网络后,Beam 自发学会了去检索并提问其他大语言模型,以及调用 OCR API 读文档。它是纯文本模型,但当其他模态的信息以文本形式给出时也能处理。
预训练与训练基础设施
Beam 在 23.8 万亿 token 上预训练,来源包括网页、公开数据与自有授权的专有数据集;整个预训练在 6,144 张 GB300 NVL72 的集群上不到四周完成。数据侧,Beam 自训了面向网页、代码与 STEM 内容的质量分类器,把数据划入细粒度质量分层并加权训练。Reflection 称约 95% 的原始互联网 token 会在解析、去重与筛选环节被淘汰,而常规做法会漏掉约 1.8 万亿 条被其保留的高质量 token,其中包含其筛选后网页代码 token 的 87%。STEM 知识则靠一条高吞吐 PDF 处理流水线补齐——用视觉语言 OCR 模型配合自研质量分类器与伪影检测器,在数千张 GPU 上处理 PB 级技术资料。
MoE 的稳定性方面,Beam 在 DeepSeek 提出的「无辅助损失负载均衡」之上引入专家偏置更新的余弦衰减,以减少训练后期的路由扰动;序列级均衡则鼓励模型在预训练分布之外的数据上仍保持专家利用均衡,为下游 RL 的分布变化做准备。
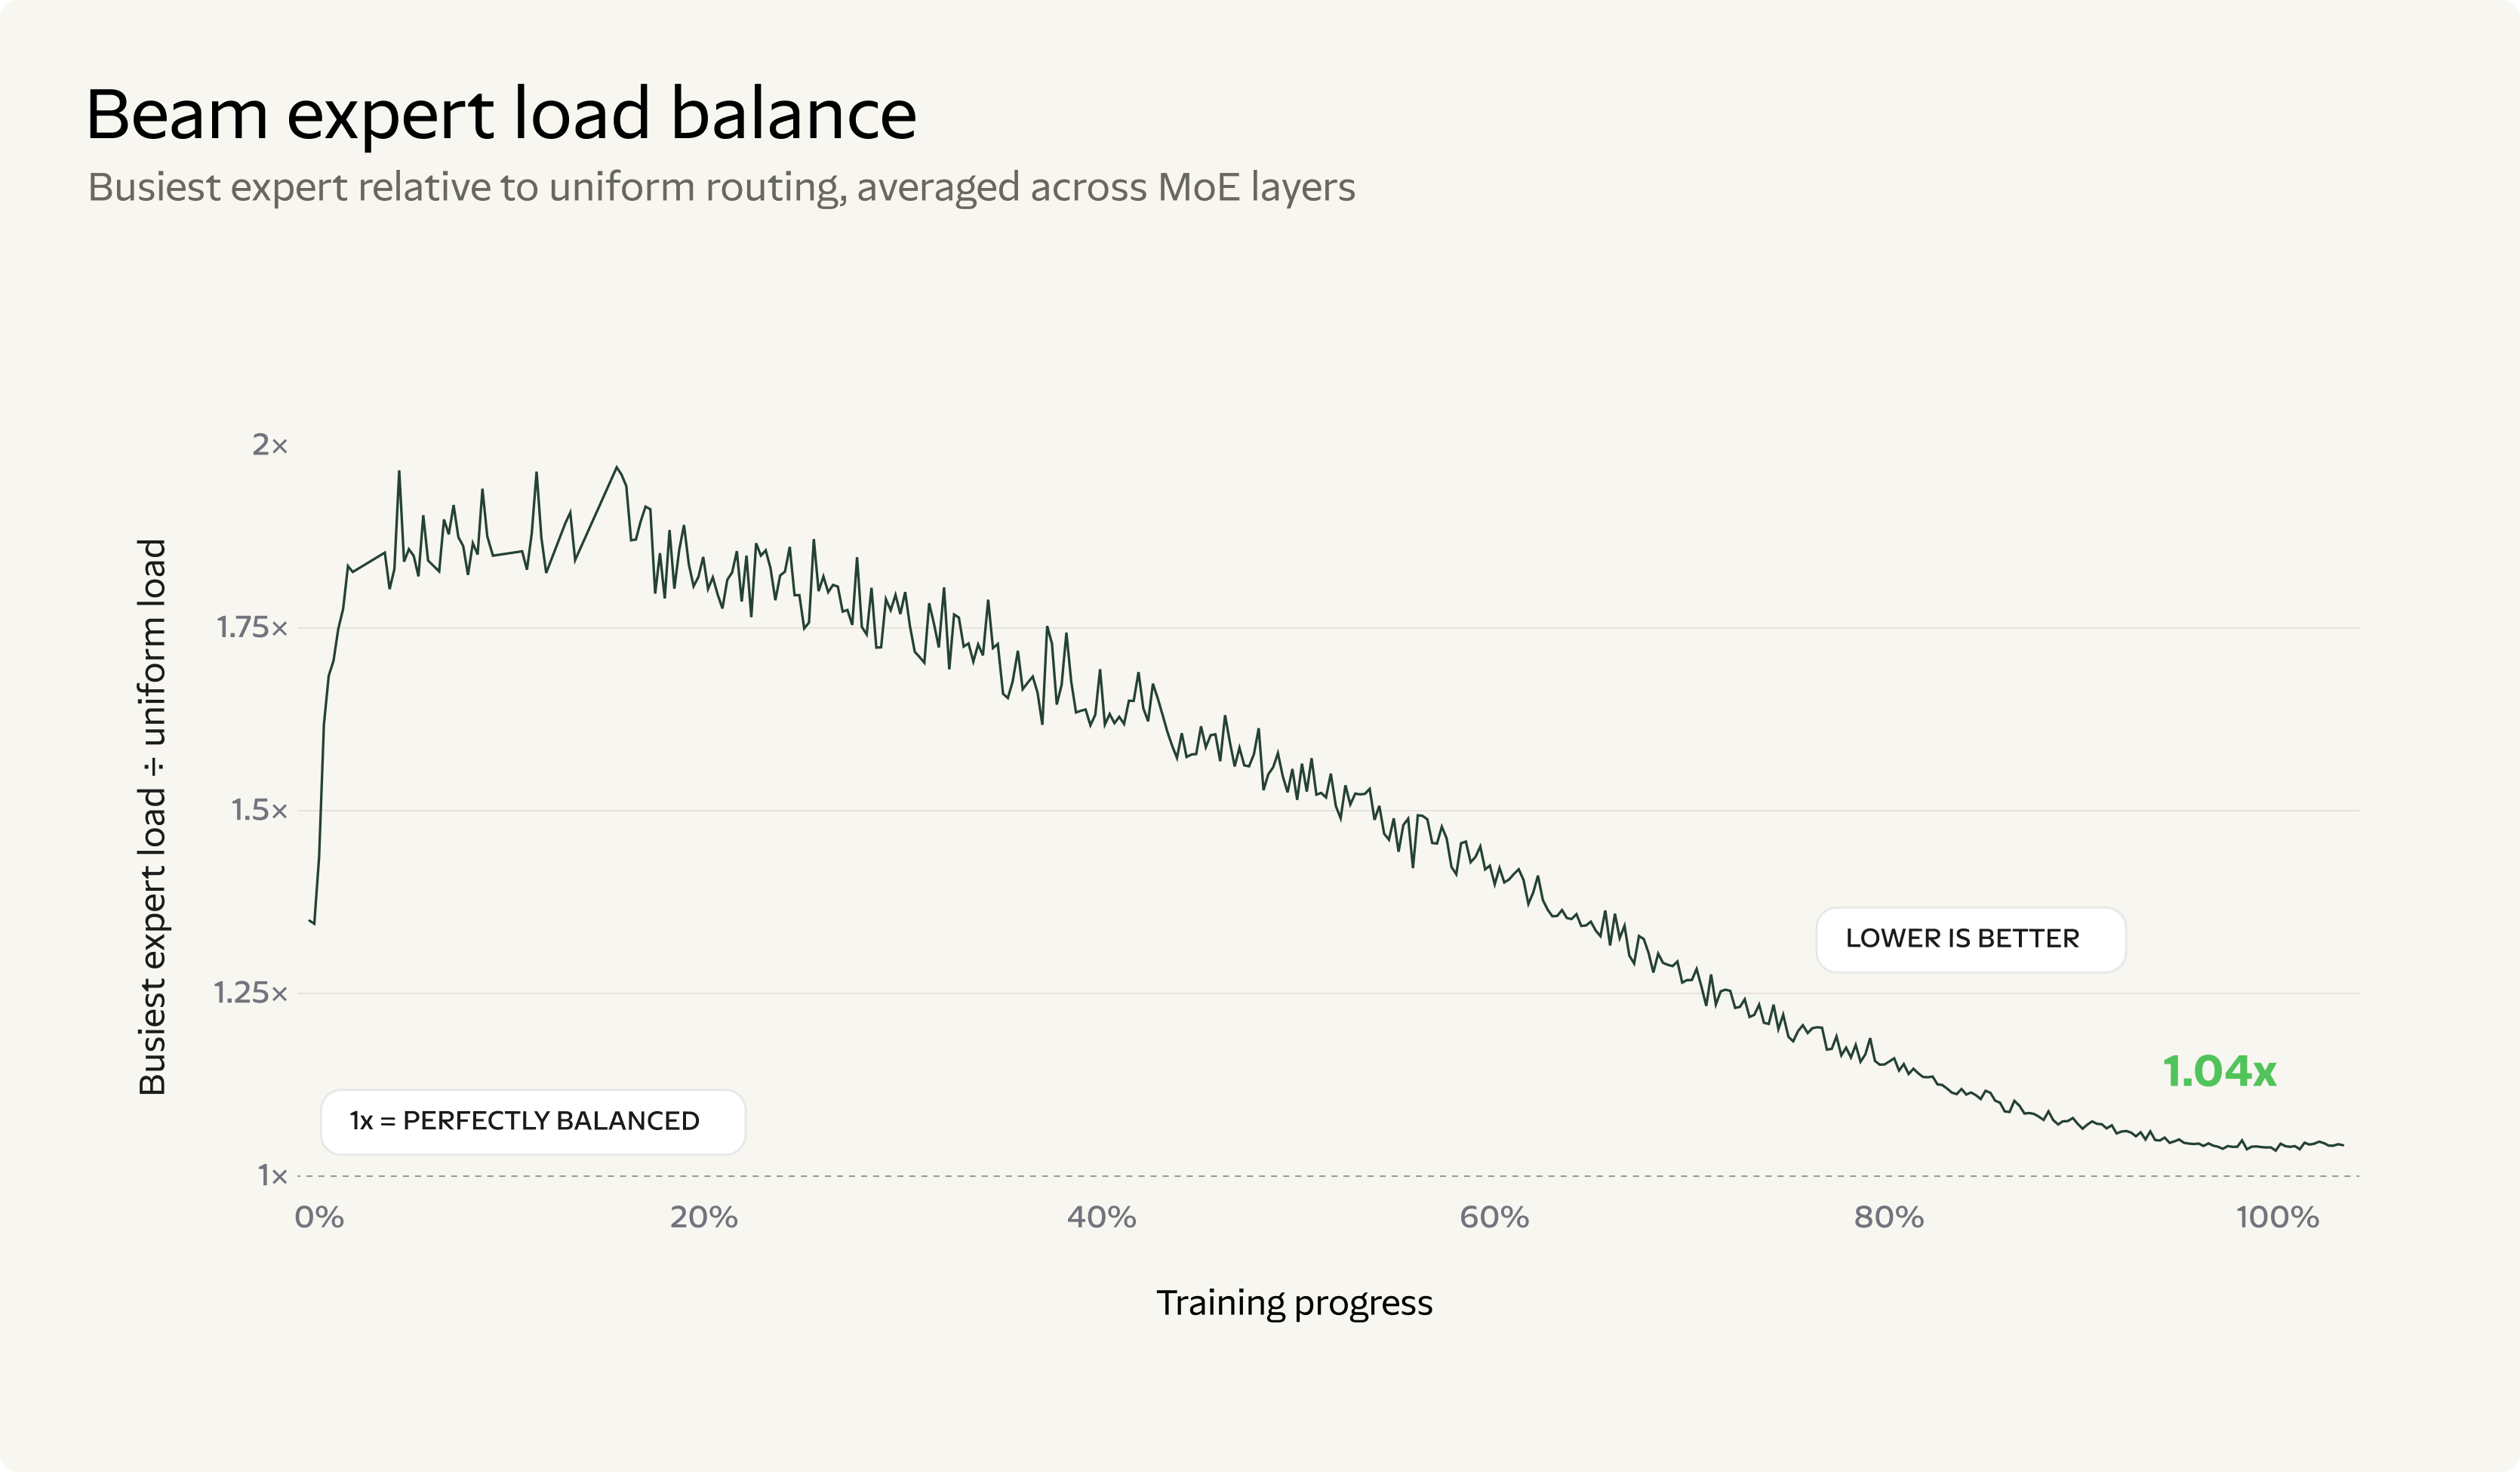
图 7:最忙专家相对均匀路由的负载(跨 MoE 层平均),预训练结束时为 1.04×(图源:Reflection)。
预训练全程执行了 9 次半自动回退(rewind),原因包括非确定性的梯度范数尖峰与疑似静默数据损坏(SDC);后期凭借检查点、故障检测与节点健康管理的改进,最终模型的有效训练时间占比(goodput)达到 92.3%。中训练阶段则专门为高算力 RL 打底,用结构化代码仓库、长程任务与长篇文档把有效上下文扩展到 100 万 token。
安全与对齐
安全对齐走的是另一条链路:从同一个预训练检查点出发,用独立的 SFT 与 RL 流水线训练第二个模型,再通过多教师在线策略蒸馏(MOPD)把「大规模 RL 教师」与「专职安全对齐教师」的能力合并。原则被组织成三层——不得打破的规则(遵循安全政策、保持 AI 智能体身份)、应持续满足的品质(善用给定上下文、陈述准确、承认不确定性、透明执行用户请求)、默认交互风格(直接、周全、高效、主动预判需求)。
对齐阶段的许多奖励由生成式奖励模型判定,属于不可验证奖励,但 Reflection 称仍能可预测地塑造行为:在跑 RL 之前先预测奖励对不同行为的影响,其预测增益的相关性 r = 0.79,优于仅用 Best-of-N 上限的 r = 0.46。安全训练采用深思式对齐(deliberative alignment),把安全政策直接写进模型的推理过程;数据集则以对抗方式迭代构建——每轮训练一个模型、生成能诱发有害或过度拒答行为的提示,再把成功的攻击折回下一轮的 SFT 混合。安全 RL 同样覆盖单轮、多轮、越狱与智能体场景,用模拟对手向会用工具的模型施压,以同时压低过度拒答与有害顺从。模型卡给出的 Iris 安全评测(合并全部危害域)结果为:有害请求的拒绝/转向率 88.9%,无害请求的合规率 81.5%(BF16)。
发布形态与落地成本
权重以 BF16、FP8、NVFP4 三种精度发布,另有 DFlash2 投机解码草案模型。三种格式各有取舍:BF16 检查点约 1 TB,NVFP4 把大部分参数压到 4 位、体积降到约 280 GB(部分参数仍保留 BF16 以保精度),FP8 则适合 Hopper 与 Ampere 系列的卡。据此,NVFP4 可以放到 4 张 B200(720 GB)上并给长上下文与并发请求留出空间,也可以放到 2 张 B300(各 288 GB)或 8 张 RTX Pro 6000 上;BF16 在 8 张 H200 上每卡要背 139 GB 权重、超过 141 GB 卡容量,因此 Hugging Face 建议用 16 张 H200 跑,每卡约 78 GB。
生态方面,Reflection 称有 40 多个合作伙伴与集成,vLLM、SGLang、Transformers、Unsloth、Axolotl、TokenSpeed、Dynamo 均为 Day-0 支持;托管渠道覆盖 AWS、Azure、Google Cloud、Oracle、Cloudflare、CoreWeave、Databricks、Baseten、Fireworks AI、Together AI、Modal、Nebius、Ollama、LM Studio、OpenRouter、Vercel 等,Dell 与 HPE 提供本地与气隙部署。配套的 Mirror CLI 是 Reflection 自研的 Rust 版智能体框架,Beam 也已在 Pi、OpenCode、Hermes 等框架上测试过。
微调与 RL 配方同样开放。Hugging Face 与 Reflection、RadixArk、NVIDIA、Anyscale、Axolotl 合作给出 TRL 与 Miles 的样例:LoRA SFT 在单节点 8 张 B300 上约 19,000 token/秒(H100 需要 4 个节点);全参数 GRPO 用 96 张 H200(64 训练 + 32 rollout),在 AIME25 上把准确率从 46.25% 提到 55.8%;LoRA GRPO 用 32 张 H200,AIME25 从 42.9% 升到 64.2%,同时平均输出长度由 3,188 降到 2,197 token。Reflection 还提到会放出自蒸馏配方:在自己的任务上生成轨迹、用验证过的轨迹训练 LoRA 适配器,再循环迭代以同时提升任务成功率与 token 效率。
核心总结
- 发布:Reflection 于 10 月 16 日在 Hugging Face 以 Apache 2.0 开源首个模型 Beam,10 月 5 日预告、提前约两周兑现
- 规格:稀疏 MoE,501.3B 总参 / 23.4B 激活,52 层(3 稠密 + 49 MoE),每层 256 专家激活 8 个,隐藏维度 5,120,词表 152k,1M 上下文,仅文本输入
- 架构:43 层 512-token 滑动窗口 + 9 层全局注意力(全局层不用位置编码,改用以可见 token 数为基准的查询缩放),分组限定路由(8 组、每组 32、保留 4 组、选 8 专家),残差流按 1/√k 加权保持恒定尺度;每 token KV 缓存 36 KiB,满上下文 36.08 GiB 对全注意力的 208 GiB
- 基准:模型卡(BF16)SWEBench Verified 81.6、SWE Bench Pro v2-Hard 76.5、Terminal Bench v2.1 80.1、DeepSWE v1.1 43.3、AIME 2026 97.7、GPQA Diamond 90.6、HLE 带工具 51.1、MCP Atlas 80.8、BrowseComp 76.8;官方定位是与 GLM 5.2 相当、接近 Qwen 3.8-Max,原始能力仍落后 Kimi K3
- RL:10,500 张 GB300 训 4 周、超 1 亿条 rollout、约 13 亿沙箱、约 100 万环境;异步策略梯度下容忍 107 个权重版本的策略滞后;长度惩罚加 reasoning effort 五档控制推理预算;浏览能力在训练混合无浏览任务的情况下自行涌现
- 预训练:23.8T token,6,144 张 GB300 NVL72 上不到四周完成,9 次回退,goodput 92.3%,专家负载均衡收敛到 1.04×
- 安全:独立 SFT + RL 教师经多教师在线策略蒸馏合并,采用深思式对齐与对抗式数据集迭代;Iris 评测有害请求拒绝率 88.9%、无害请求合规率 81.5%
- 部署:BF16 约 1 TB、NVFP4 约 280 GB;NVFP4 建议 4×B200、2×B300 或 8×RTX Pro 6000,BF16 建议 16×H200;Day-0 支持 vLLM、SGLang、Transformers 等,并配 DFlash2 草案模型
- 许可:Apache 2.0,模型卡明确不禁止蒸馏、用输出训练其他模型、微调、量化与合并
值得留意的有三件事。一是效率被当成主要卖点写进了叙事:与 GLM 5.2 相当的分数配 3–4 倍更少的推理算力,再加上每 token 只激活 23B 参数的 MoE 结构与六分之一的 KV 缓存增速,指向的是「同一张卡能扛多少并发」。二是高算力 RL 的工程细节比基准数字更具体——1 亿条 rollout、13 亿沙箱、容忍 107 个权重版本的策略滞后,这些是支撑其能力主张的实际论据,也让「开放实验室能做多大规模 RL」有了一个可参照的坐标。三是同一模型在预告文与最终模型卡上的数字存在差异,且对比表中对手成绩多为自报,因此在把它当作「美国开源最强」的证据之前,还需要第三方复现。
原文:Introducing Beam: Reflection’s 501B open-weight model(Reflection,2026-10-05)
参考:
- Beam is now available(Reflection,2026-10-16)
- Beam 模型卡(Reflection)
- Welcome Beam: a 501B open model you can own, customize, and scale(Hugging Face,2026-10-16)
- reflection/Beam-1.0-501B-A23B 权重(Hugging Face)
- Reflection debuts Beam, an open-weight AI model to rival Chinese models at lower compute cost(TechCrunch,2026-10-05)
- Reflection releases Beam’s 501 billion parameter weights under Apache 2.0(Think Facility,2026-10-16)


