10 月 14 日,LangChain 工程师 Jess Weng 在该公司博客发表《Context Engineering: How Deep Agents Remember》,系统拆解了长任务智能体的一个核心矛盾:任务越长,上下文堆得越多,模型反而越不准。文章用一个比喻开场——考前突击的人都有体会,复习到后面,前面几章已经开始模糊。
在智能体工程里,这个现象叫上下文腐化(context rot)。智能体承接长任务时会不断累积指令、工具返回结果和文件,很快超出模型窗口的舒适容量;历史、噪声与工具输出带得越多,模型的准确率与推理质量越差。这篇文章讲的就是 Deep Agents 这个开源外壳(harness)如何用五种手法对抗它,以及这些手法如何通过「中间件」注入到一次运行里。
两类手法:挡在门外,与清理屋内
文章先给了一个简化定义:智能体 = 模型 + 环绕模型的外壳。外壳能做的上下文工程大致分两类——
- 阻止不必要的信息进入上下文窗口
- 管理并过滤已经进入窗口的内容
外壳要做的是让模型在正确的时间拿到正确的上下文。Deep Agents 把上下文移出活动窗口,去向有三个:文件、摘要,或另一个智能体;主智能体只携带自己需要的那部分,需要时还能把原始数据取回来。五种手法分别是:
| 手法 | 做什么 |
|---|---|
| 卸载(Offloading) | 大块工具结果与用户消息存进文件系统,模型只看到预览 |
| 摘要(Summarization) | 接近上下文上限时,把较早的消息压缩成一段摘要 |
| 技能(Skills) | 任务 know-how 只在模型判断相关时才加载 |
| 子智能体(Subagents) | 嘈杂的活跑在独立上下文窗口里,只回传结果 |
| 长期记忆(Long-term memory) | 学到的东西写进文件,带进下一次对话 |
一个贯穿全文的例子是竞品分析智能体:每周一研究五家竞争对手,按团队模板产出报告。单次运行会先拉一份几万行的市场数据导出、搜新闻读文章做笔记、对每家公司重复一遍,最后起草、修改、排版。到第四步时,前五份原始数据、几十条搜索结果和两份过时草稿还挂在每一次模型调用上——而它们大多和「排版」这件事毫无关系。
检索手段(RAG 或文件系统搜索)能帮智能体只取所需,但只解决了一半问题;外壳还必须管理那些已经在窗口里的东西。
中间件:这些手法挂在哪里
智能体的运行是一个循环:模型决定做什么、调用工具、读取结果、重复。中间件就是插进这个循环特定位置的代码——智能体启动之前、每次模型调用前后、每次工具调用前后;在每一个点上,它都能读取上下文并在下一步执行前改写它。文章强调,上面五种手法本身就是挂在钩子上的中间件,且大多已内置,除非要做特定定制,使用者不需要自己写。
卸载:把大块数据挡在窗口之外
FilesystemMiddleware 在每次工具被调用时运行:工具结果超过约 2 万 token 时,完整结果会在进入对话之前写入 /large_tool_results/{tool_call_id};模型只看到一段短预览(首尾各几行)加一个文件路径。事后需要 B 公司的季度营收时,智能体再用 read_file 分页翻回来。体积过大的用户消息(比如粘贴进去的一整段通话记录)走同一套处理,但阈值更高——5 万 token,落到 /conversation_history/。
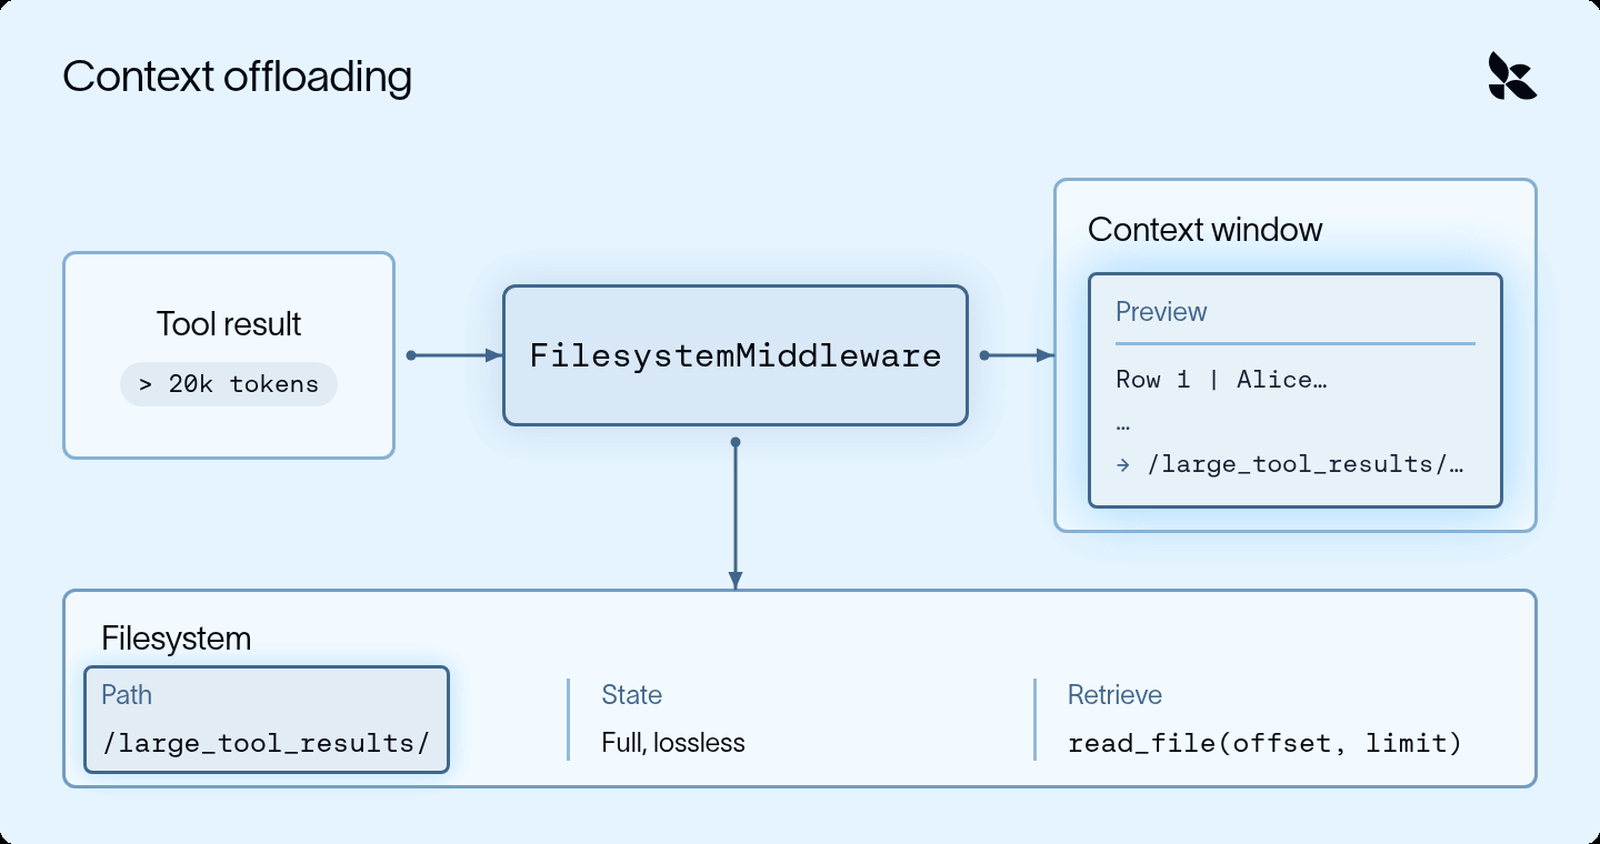
图 1:工具结果经 FilesystemMiddleware 落盘,上下文窗口里只留预览与可检索的路径。
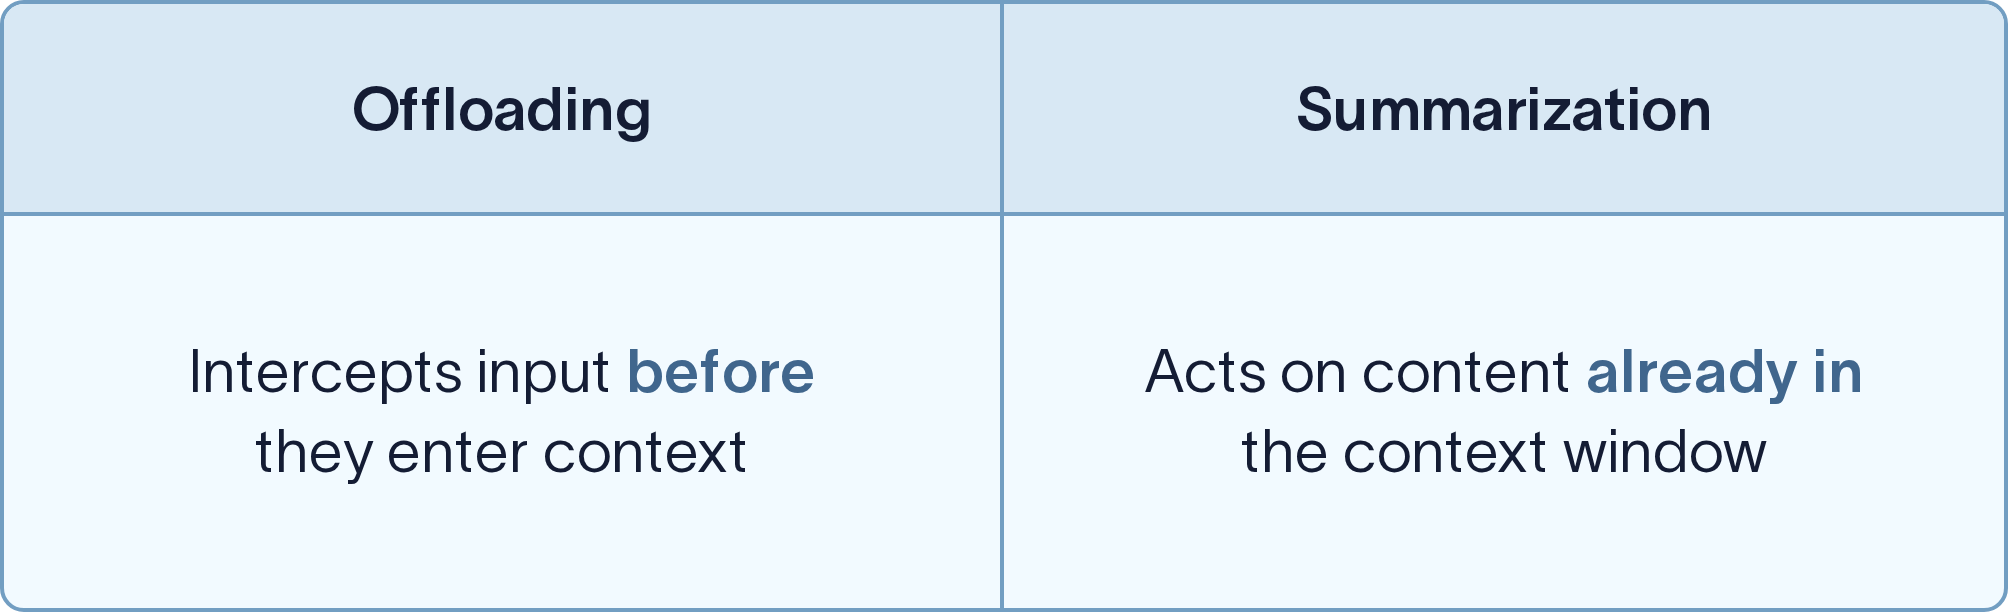
图 2:卸载拦截尚未进入上下文的内容,摘要处理已经在里面的内容。
摘要:压缩已经进去的
卸载能挡住尖峰,挡不住缓慢的爬升。摘要负责把整个上下文窗口浓缩成「到目前为止发生了什么」,SummarizationMiddleware 在每次模型调用前检查 token 用量:
- 用量越过阈值(默认是模型上下文窗口的 85%)时,另起一次 LLM 调用把较早的消息压缩成单条摘要
- 较早的消息从窗口中移除,最近的消息原样保留
- 模型先看到摘要、再看到近期消息——最近的内容不会被改写
两个细节值得注意:摘要可恢复,被压缩的消息会写进 /conversation_history/{session_id}.md,起草报告时如果想起 A 公司的某个研究细节,智能体可以读回来;摘要还会循环,运行继续下去用量会再次爬升,下一次摘要会把上一份摘要也包含进去。文章提到,除 token 阈值外,也可以在话题切换时触发摘要,定制摘要提示词往往有效。
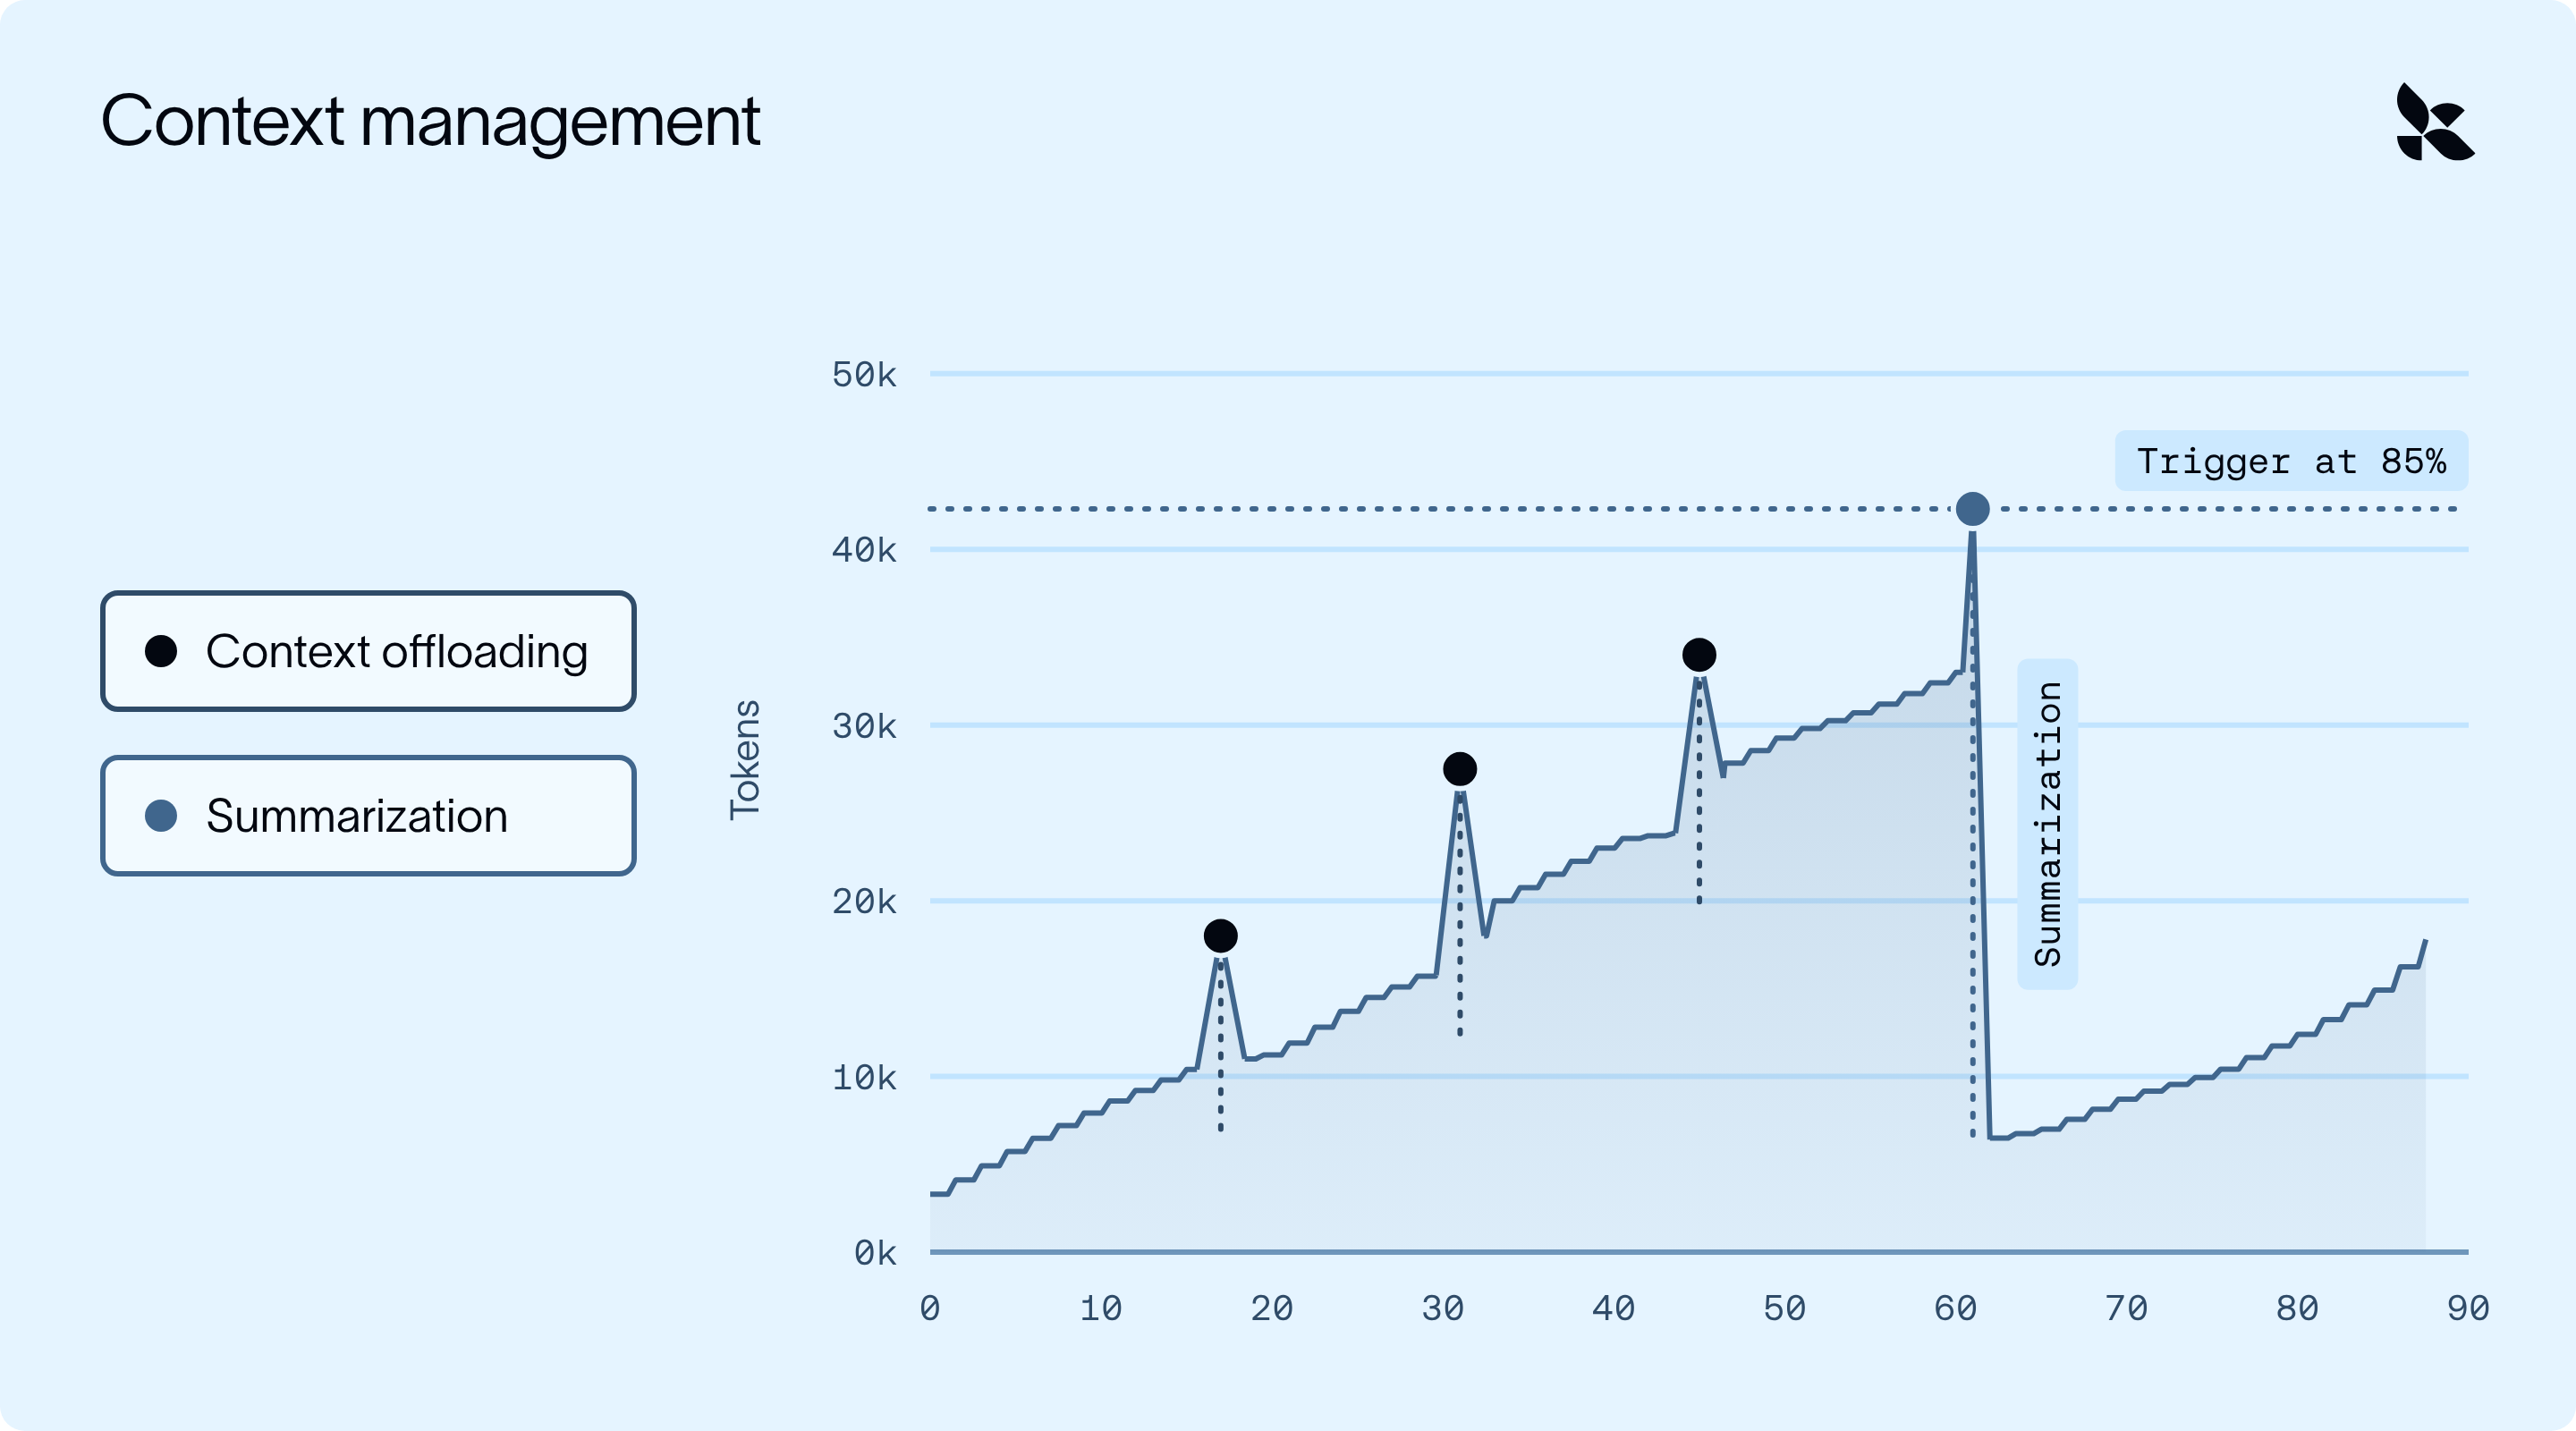
图 3:卸载压低工具结果造成的尖峰,摘要则在 85% 触发点把整体水位拉回。
技能:按需加载的 know-how
如果销售团队每季度才用一次固定的季度业务回顾(QBR)格式,把这些说明常驻系统提示词意味着每一次调用都在为它付费——token 和响应时间都是。更好的做法是打包成一个技能:一个装说明的文件夹(可选带脚本与参考文档),对应一类专门任务。
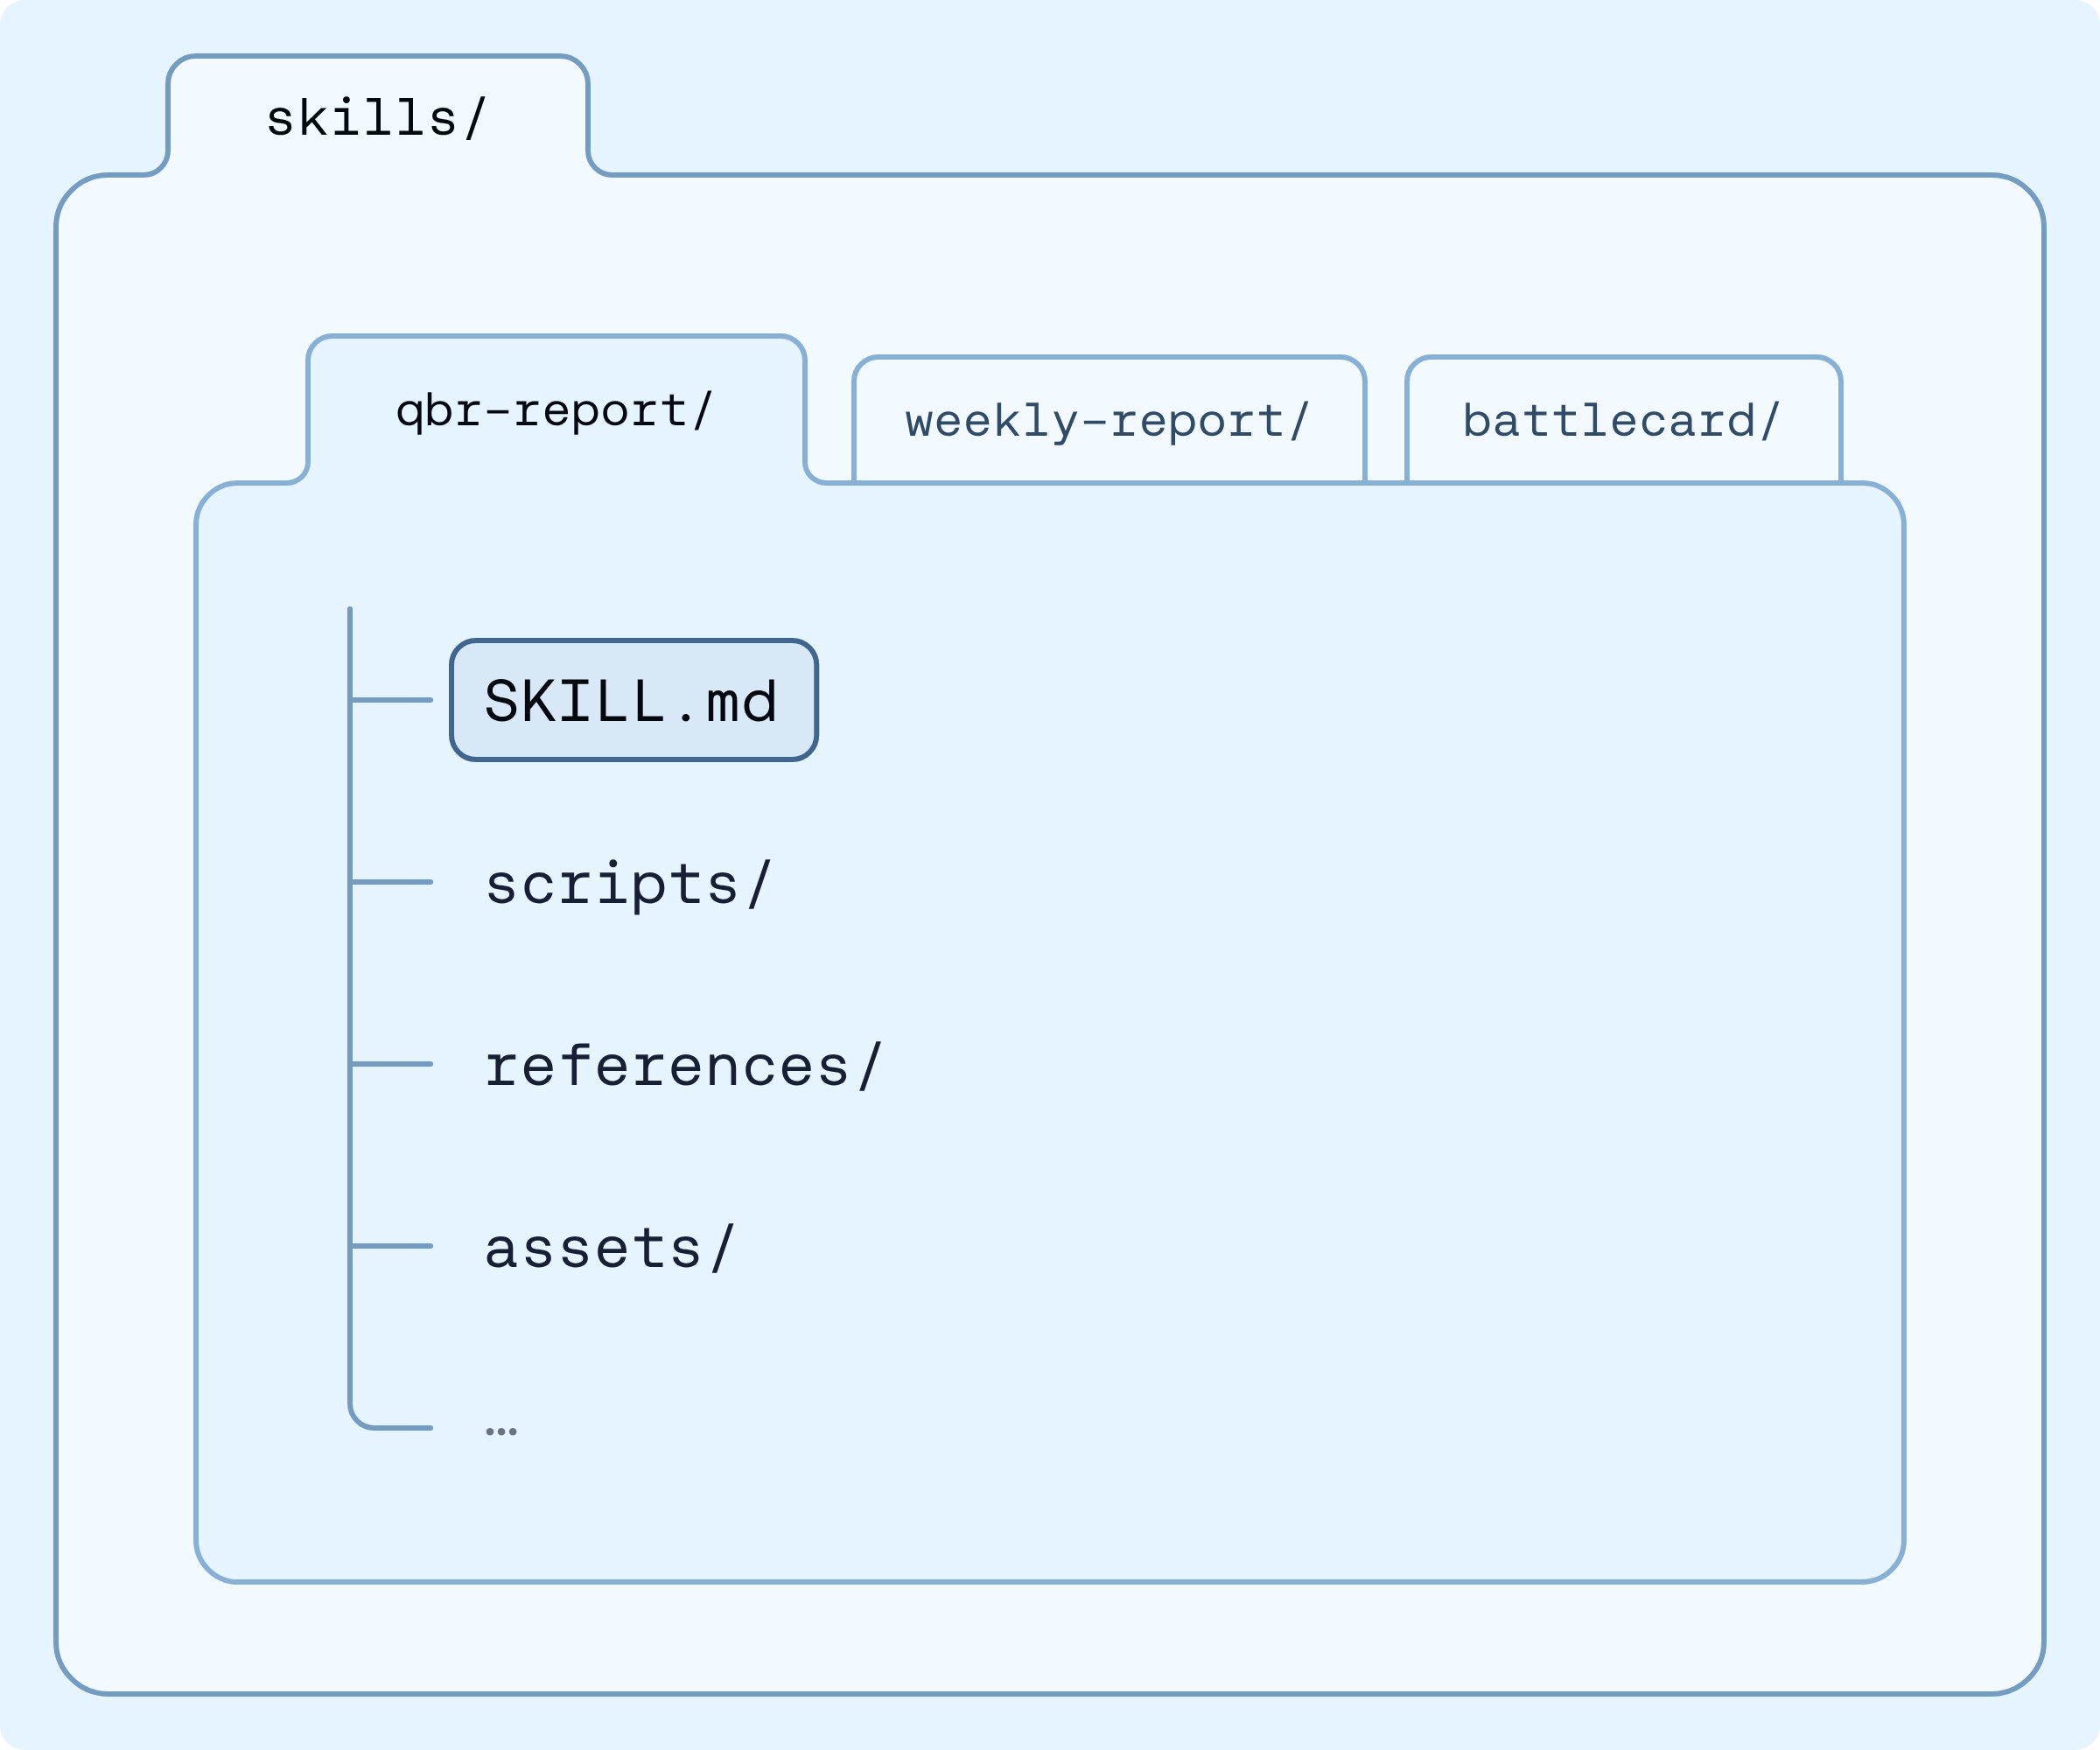
图 4:一个技能就是 skills/ 下的一个文件夹,入口是 SKILL.md。
SkillsMiddleware 用了两个钩子:启动前扫描技能目录,只读每个 SKILL.md 的头部;每次模型调用时,把这些名称与描述加进系统提示词。完整说明只有在模型判断某个技能相关时才会进入上下文(用 read_file 读取)。这种分层加载叫渐进式披露(progressive disclosure)——模型先看菜单,需要时再取完整菜谱,于是十个技能的开销约等于十行简介。
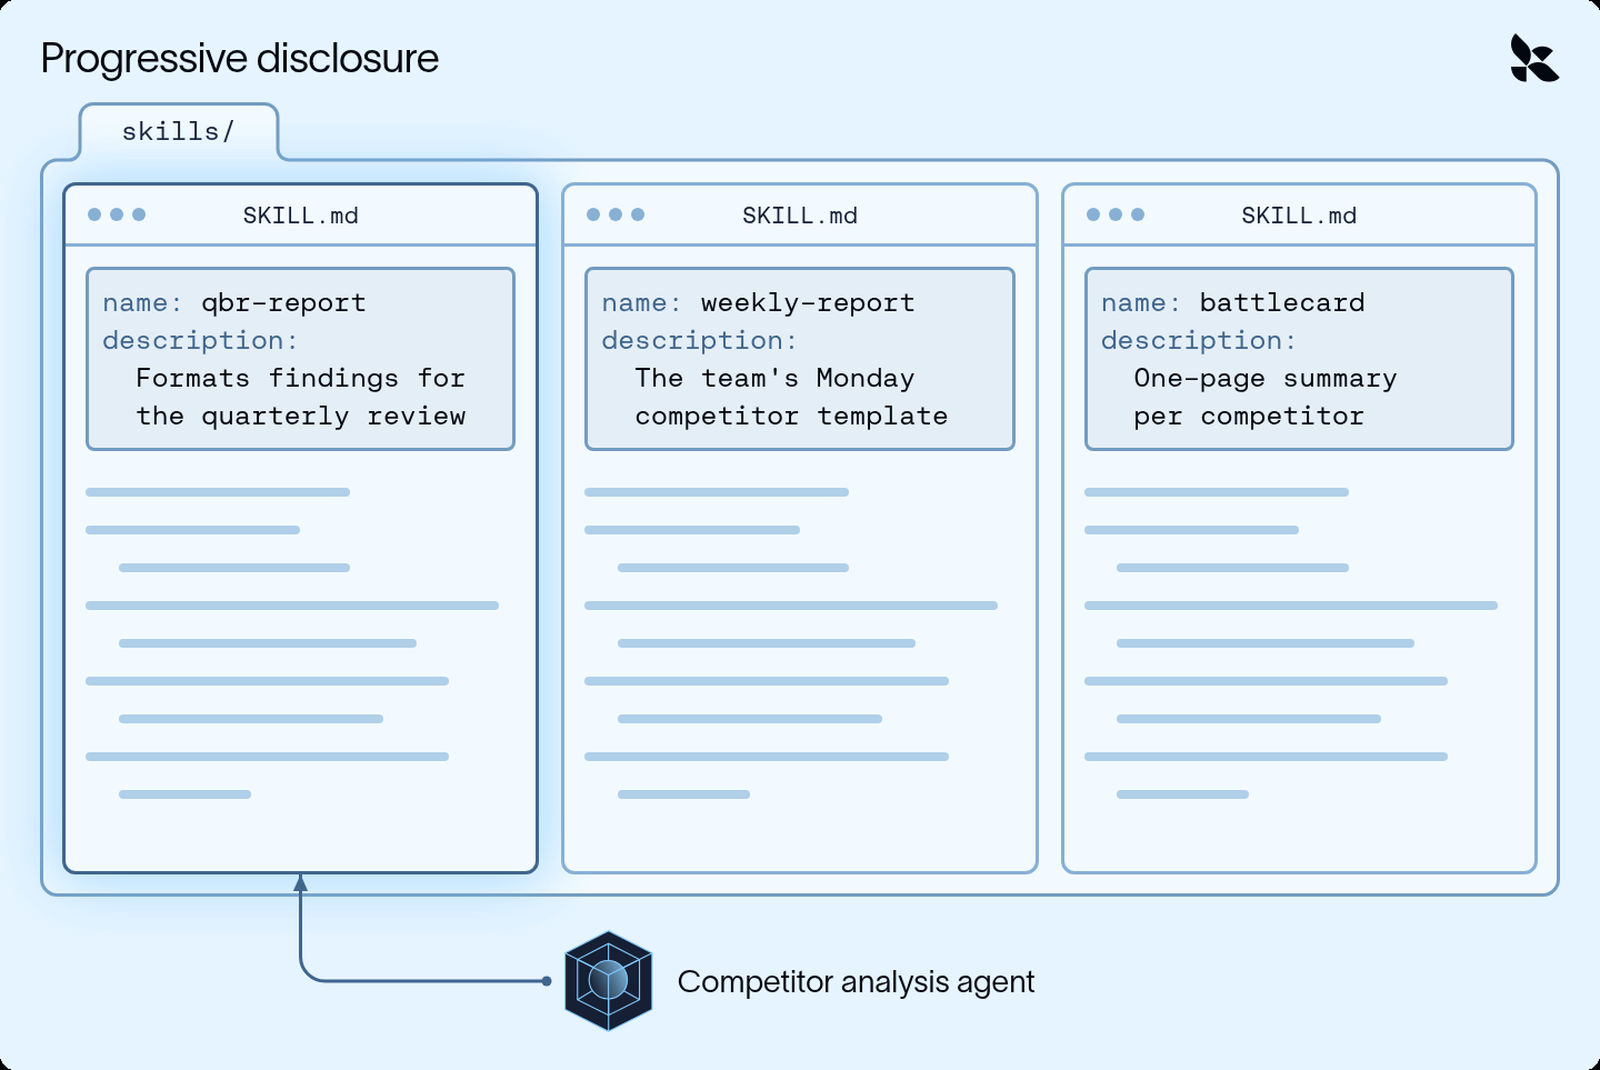
图 5:渐进式披露——菜单在前,完整说明按需展开。
子智能体:隔离嘈杂的活
卸载对付的是超规格结果,而有些活你在设计阶段就知道一定嘈杂,比如把一家公司查遍几十个搜索结果和网页。这类任务适合交给子智能体:它在自己的上下文窗口里干活,只把最终结果交回来,主智能体从头到尾看不到噪声。
market_researcher = {
    "name": "market-researcher",
    "description": "Researches a company and returns the 3 most notable developments.",
    "system_prompt": "Use pull_market_report, then return 3 short bullet points. Do not return the raw report.",
    "tools": [pull_market_report],
}

agent = create_deep_agent(model=model, subagents=[market_researcher])
主智能体把每家公司派给 market-researcher 子智能体,后者在自己的上下文里读完整份报告,只交回三条要点——主智能体连原始报告的预览都看不到。文章还指出,由于子任务通常小而边界清晰,它们往往可以跑在更便宜的模型上,也可以并行。
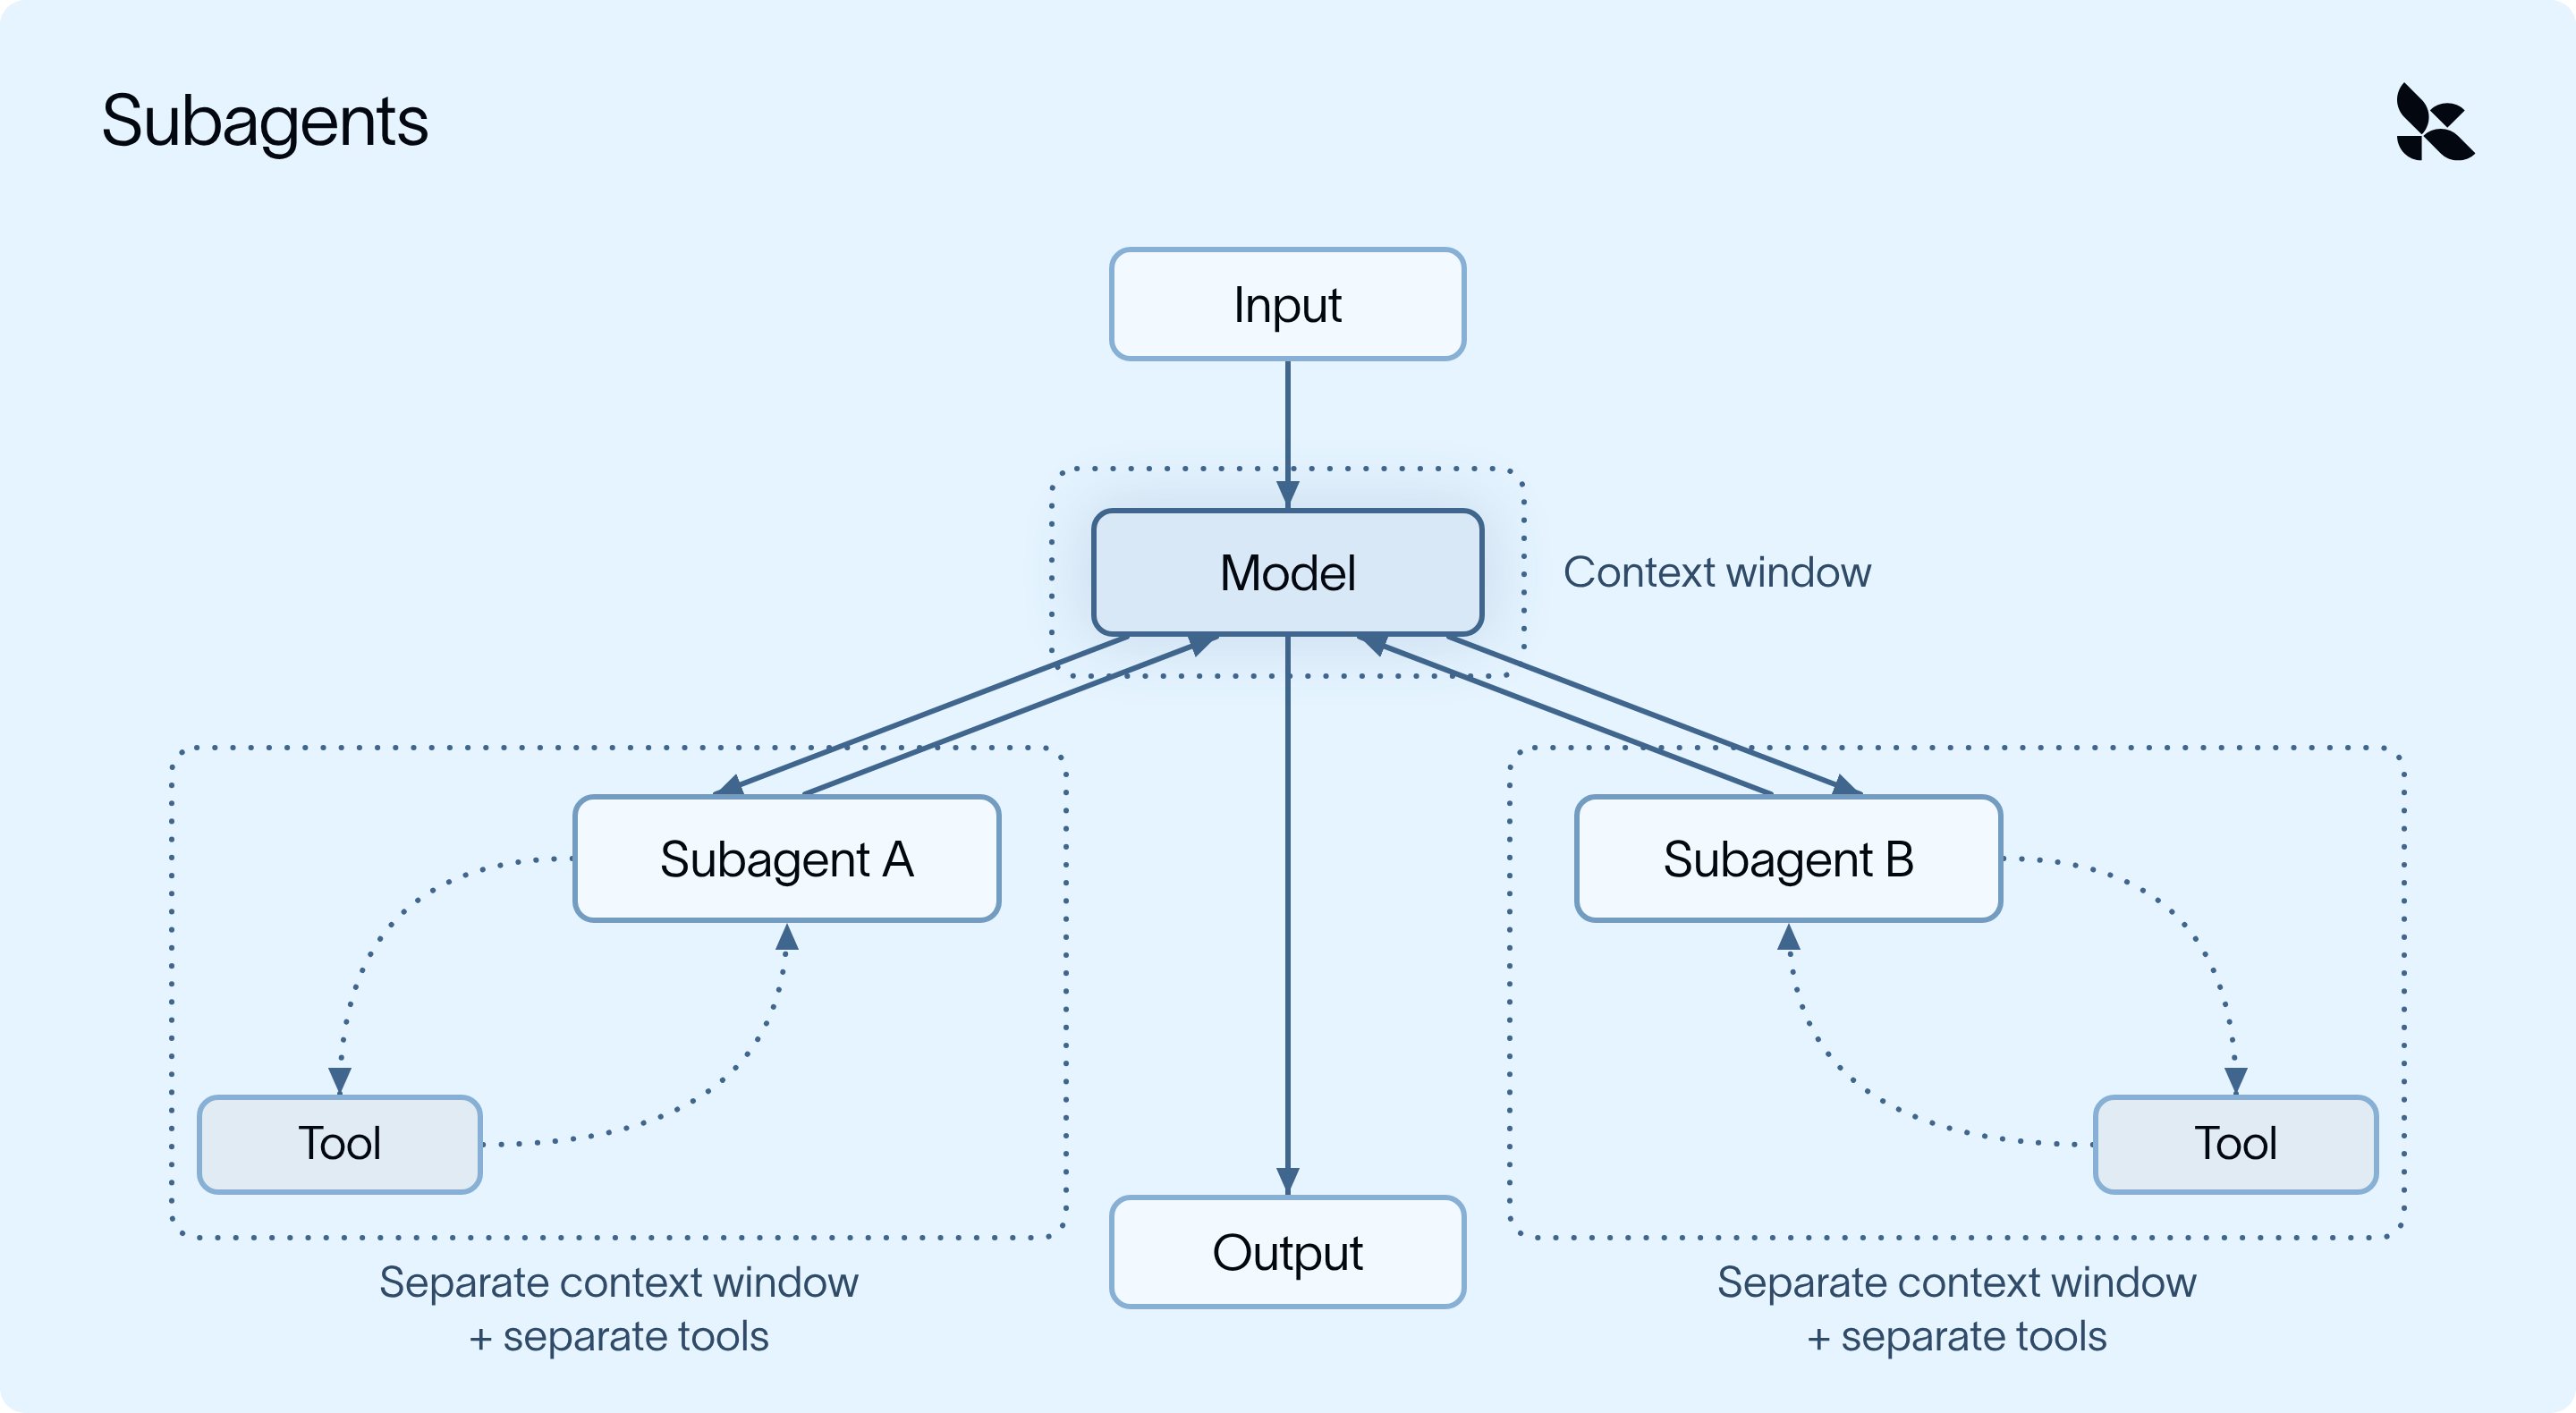
图 6:子智能体各有独立上下文窗口与独立工具,主智能体只接收结果。
长期记忆:跨对话存活,并且归你
跑到最后,智能体总会学到一些东西,有用的和没用的混在一起。比如你告诉它「摘要用要点,不要写成段落」——没有记忆机制的话,这句话每周都要重复一次。在 Deep Agents 里,长期记忆就是一个 Markdown 文件,用一个参数把智能体指过去,剩下的交给 MemoryMiddleware:加载(Load)在每次运行开始时读取该文件;注入(Inject)在每次模型调用时把内容加进系统提示词;更新(Update)则在智能体学到值得留下的东西(比如你的排版偏好)时改写这个文件。
记忆的归属也很关键。Deep Agents 不绑定模型供应商,这一点同样体现在记忆上:因为记忆是你自己存储里的一份普通文件,而不是供应商替你保管的,所以可以把同一个后端指向另一个模型:
agent = create_deep_agent(
    model="openai:gpt-6",  # different provider, same memory
    memory=["/memories/AGENTS.md"],
    backend=backend,
    store=store,
)
下周换一个模型,它照样读这份文件,照样把摘要写成要点。
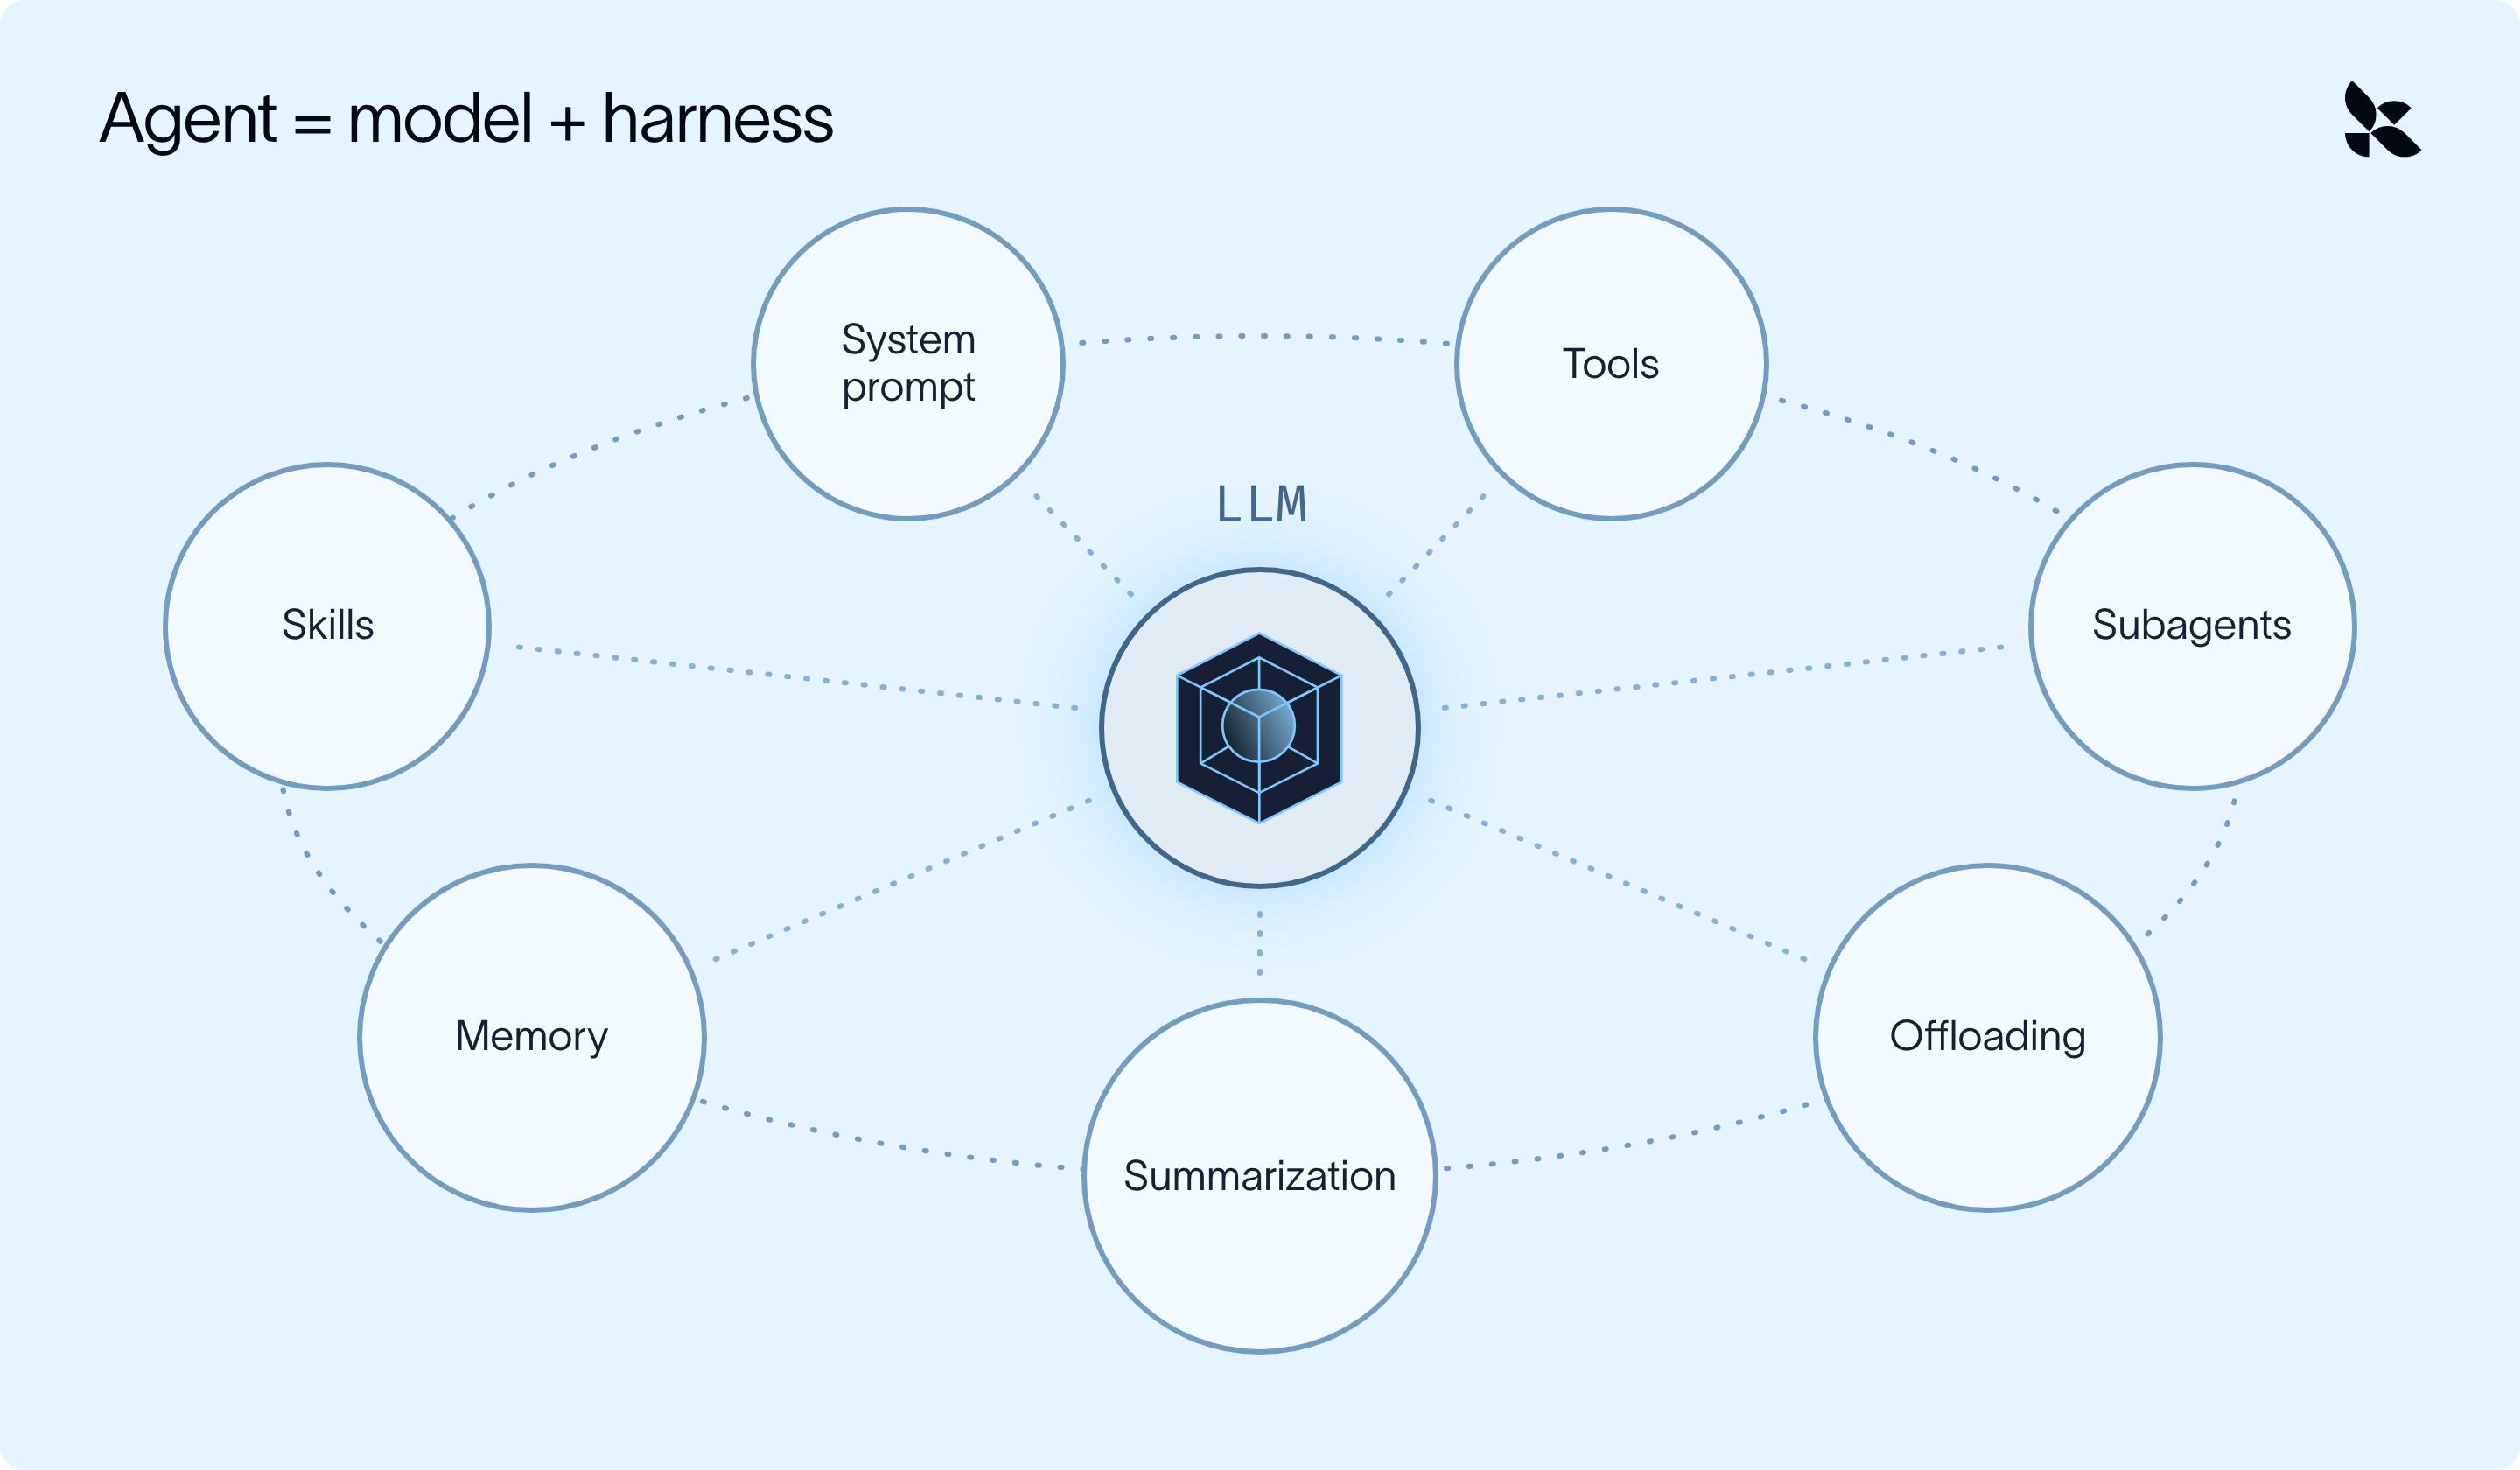
图 7:智能体 = 模型 + 外壳,上下文工程的手法都挂在这层外壳上。
六条可以直接带走的原则
文章最后给出了六条不依赖 Deep Agents 的通用建议,无论用哪个外壳或自建都适用:
- 大块输入应该被卸载,而不是被截断:截断是有损的,卸载保留了可检索性。
- 压缩应当可恢复:摘要之后,智能体仍然能找回细节。
- Know-how 应当按需加载:把每个任务的说明都写进系统提示词,等于每次调用都在付费。
- 嘈杂的活应当被隔离:让子智能体用自己的上下文,主智能体才能保持专注。
- 记忆的所有权应当归你:放在自己存储里的记忆,才能在换模型或换供应商时存活。
- 默认值应当可定制:适合一个任务的阈值,很少适合所有任务。
核心总结
- 问题:长任务智能体的上下文窗口会被指令、工具结果与中间产物塞满,产生上下文腐化,准确率与推理质量同步下降
- 两条主线:阻止无用信息进入窗口,以及管理和过滤已经进入窗口的内容
- 五种手法:卸载(20k token 工具结果 / 50k token 用户消息落盘,只留预览)、摘要(85% 阈值触发,可恢复、会循环)、技能(渐进式披露)、子智能体(独立窗口与工具,只回传结果)、长期记忆(Markdown 文件,跨对话、跨模型)
- 实现方式:全部作为中间件挂在启动前、模型调用前后或工具调用前后,且大多已内置,无需自己写
- 记忆归属:记忆是纯文件,存在你自己的存储里,因此换模型、换供应商都不影响智能体已经学到的东西
上手方式是 uv add deepagents。文章还提到作者将在 11 月 3 日做一场直播课,LangChain Academy 上另有一门免费的 Deep Agents 自学课程。
原文:Context Engineering: How Deep Agents Remember(LangChain,2026-10-14)


