10 月 8 日,Anthropic 的 Lance Martin 与 CJ Avilla 在 claude.dev 博客发表《Building effective agent automations》,切入的是一个已经很普遍的场景:AI 加快了工作节奏,人反而更难跟上信息。他们推荐的办法是「智能体自动化」——按日程在后台收集上下文,然后主动告诉你需要知道的事。
但这类自动化并不好做。文章开门见山列了两个典型翻车方式:某个数据源悄悄失联,却没有一个人察觉;或者智能体压根没按你的偏好办事。为此,作者用Claude Managed Agents(测试版)搭了一个参考实现——按日程读取自定义来源(Slack 频道、GitHub 仓库),跟踪自上次运行以来的变化,再把要点发到 Slack。代码在 GitHub 的 claude-quickstarts/managed-agents/daily-brief 仓库,也可以在 Claude Code 里用 /claude-api managed-agents-onboard 命令照着文章自动把智能体配好。
六个组成部分
参考实现被拆成六个部件,文章也按这个顺序展开:
- 来源(Sources):一份命名的可读取位置清单
- 目的地(Destination):唯一允许写入的一个地方
- 智能体(Agent):模型、工具,以及
agent.md里的运行步骤 - 排期(Schedule):一个 cron 表达式
- 记忆(Memory):你的偏好,加上智能体自己的状态
- 护栏(Guardrails):只读的地方一律只读,每次运行有花费上限
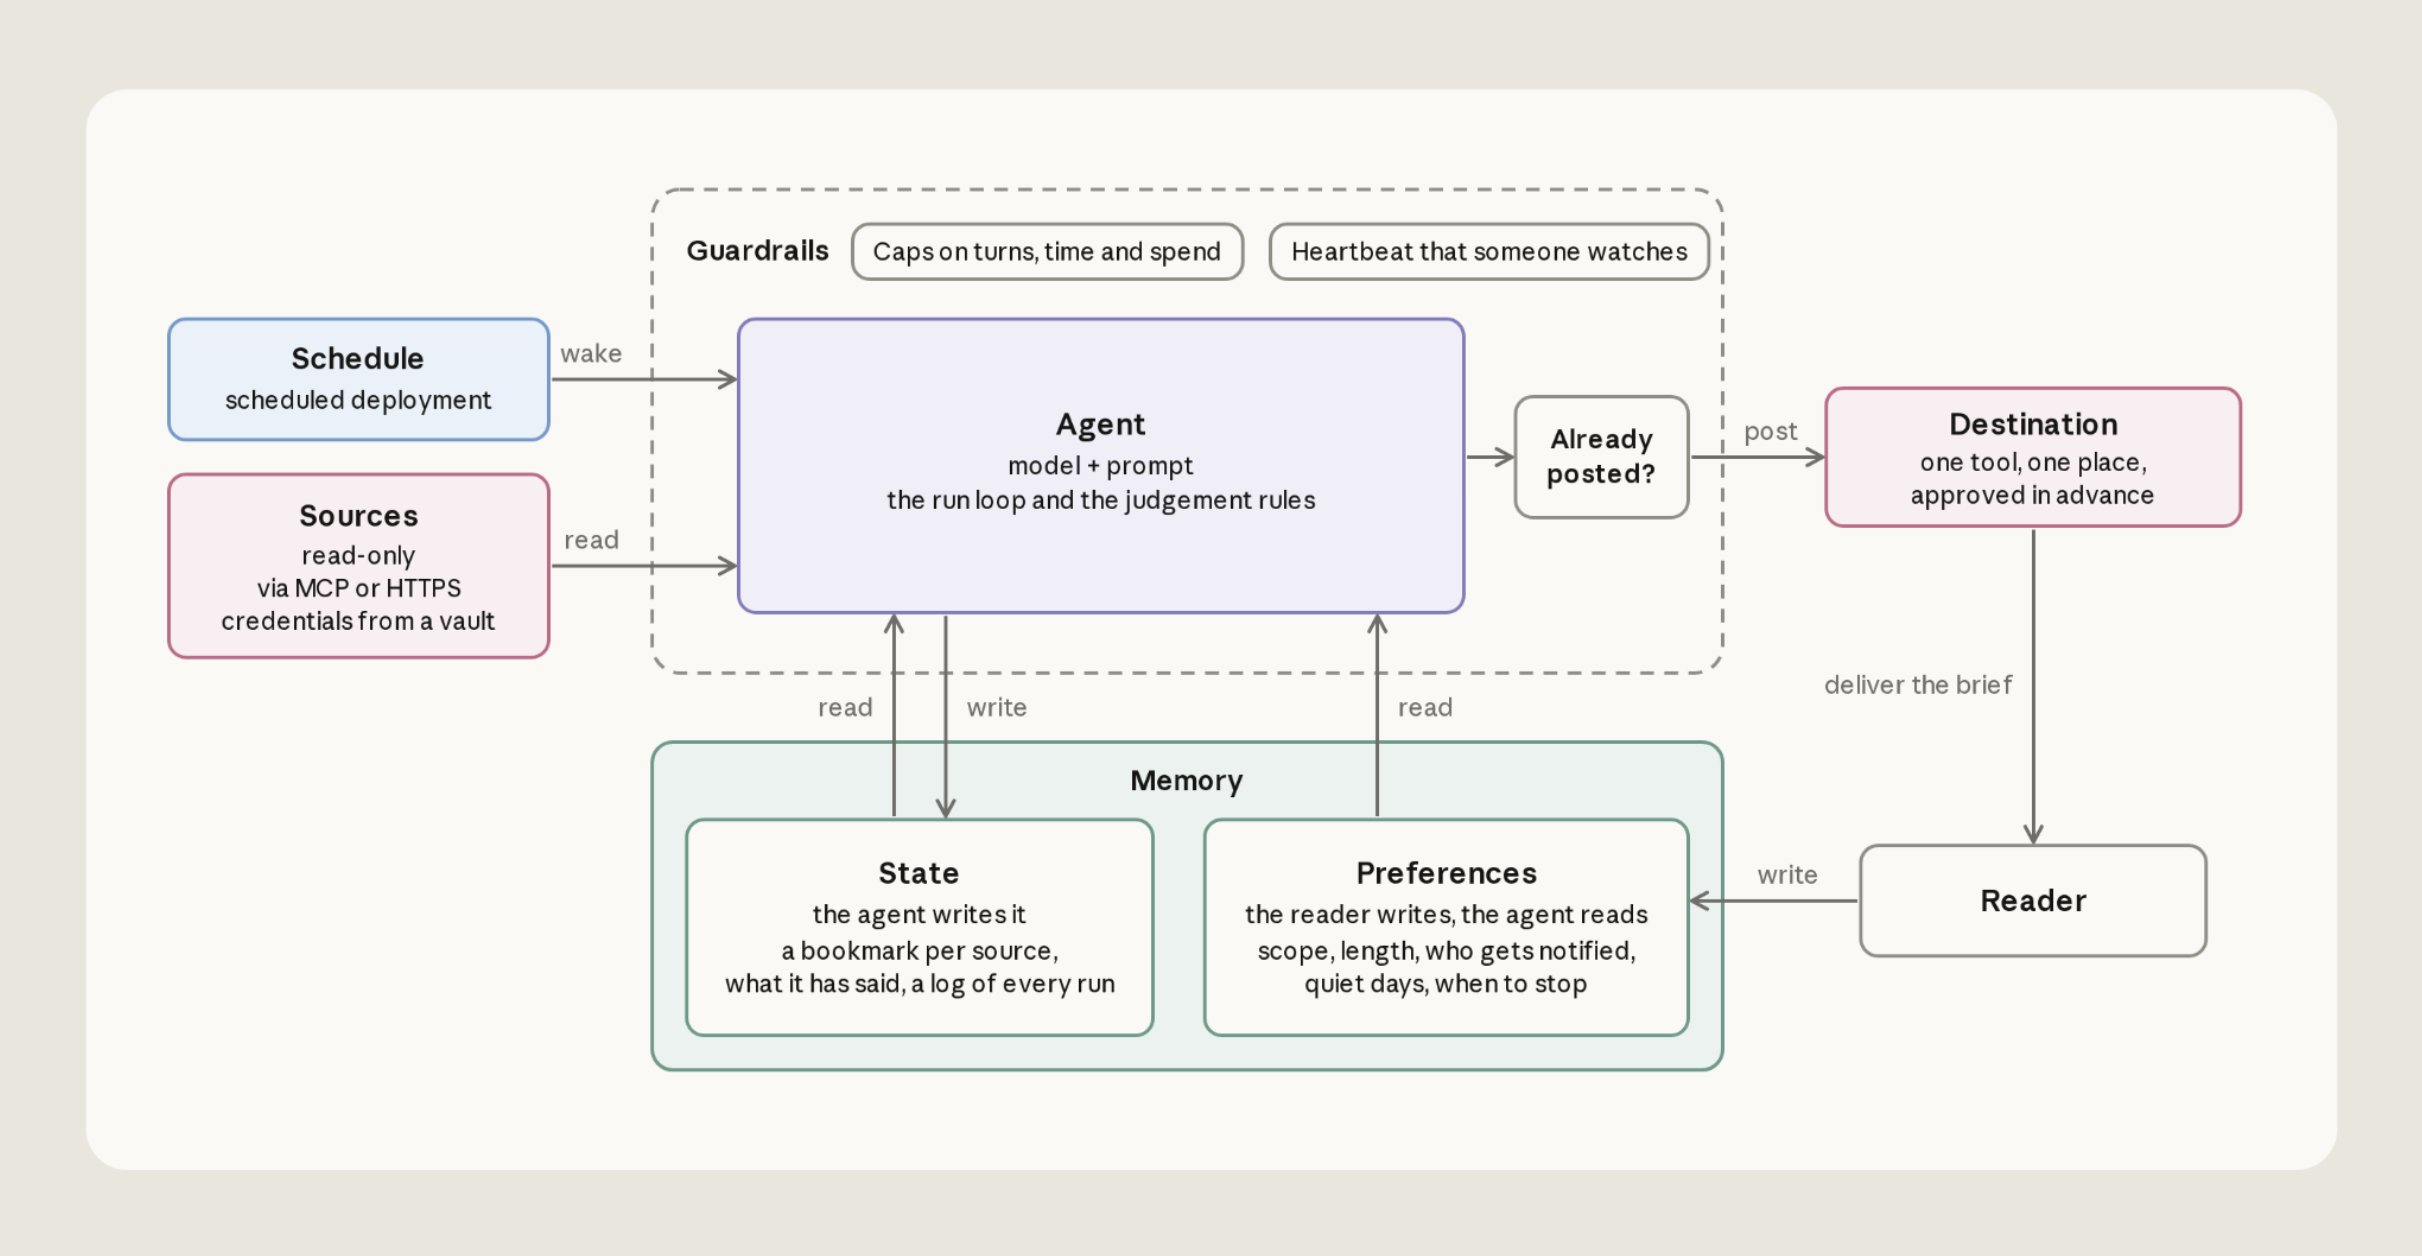
图 1:六个部件的分工——排期唤醒、来源只读、目的地唯一、记忆分偏好与状态、护栏收紧权限与预算。
配置以一组文件的形式存在 daily-brief/ 目录里:agent.md 放模型、工具与指令,deployment.md 放日程、时区、预算与首条消息,environment.yaml 是网络允许清单,两个 memory store 分别是偏好与状态,vault.yaml 装凭据。用 ant CLI 的 ant apply 读取这些文件,在 Claude API 工作区里创建资源,再把资源 ID 写进 claude-lock.json。配置完成后,自动化跑在 Anthropic 的基础设施上,本机不需要一直开着任何东西。
来源:给智能体自己的、收窄的凭据
Managed Agents 把凭据存在 vault 里。智能体可以引用它们,但真实值留在运行代码的沙箱之外,有两种取用方式:
- MCP 服务器(GitHub):智能体通过运行在沙箱外的代理调用 MCP 工具,代理按服务器 URL 匹配到 vault 里对应的凭据
- shell(Slack):智能体在沙箱内用 bash 工具配合 curl 调 Slack API,沙箱里只有一个不透明的占位符
$SLACK_BOT_TOKEN;请求离开沙箱时,平台才会把它替换成真 token,而且只对你允许的主机生效
从上次读到的位置接着读
文章点出一个很常见的错误:让智能体读固定窗口,比如「过去 24 小时」。跑晚了会留下一段空档,跑早了会把同样的条目再报一遍。正确做法是给每个来源一个书签(bookmark):每次运行结束时,智能体把每个来源读到的最新条目的时间戳写进 bookmarks.json,形如 "slack": "2026-09-14T13:02:11Z"。
下次运行就从这些书签出发,窗口自动伸缩以覆盖上次运行以来的全部内容。书签放在名为 state 的 memory store 里——那是一文件夹文本文件,平台在每次运行时把它挂载到沙箱的 /mnt/memory/,并在运行之间保留,智能体用普通的文件工具读写。
不要把读取失败当成「今天没什么事」
如果 MCP 服务器宕机或 token 过期,这次运行依然会启动,只是少了那个服务器的工具。会话日志里记了错误,但智能体看到的是「这个来源没有任何内容」,于是向你汇报「没有新内容」。作者用 agent.md 里的三条规则来兜底:来源失败时,保留该来源的书签不动;用其他来源正常出简报;并在简报末尾用一行说明这次读不到什么(比如「这次没能读取 pull request」),让读者知情。
目的地:确认发出去了,再更新记录
模板只发一个 Slack 频道,每次运行发一条带日期的消息。发帖不经过任何审批——内置 bash 工具默认不询问许可,slack.com 也在沙箱环境的允许清单上,一次 curl 请求就能发出。
风险出在记录与事实不一致。作者列了两种后果:如果智能体记了一次其实没发出去的帖,书签会继续往前走,那些条目就永远不会被报出来;如果它不确定第一次是否成功、于是又发一遍,读者就会收到两条一样的简报。对应的三条规则是:
- 先在频道近期消息里找今天这期的标题,如果已经在,就不重复发
- 只有 Slack 返回
"ok": true和消息 ts,才算发送成功 - 只有确认之后,才更新台账与书签;如果结果不明确,把这次运行标记为「可能已发送」(maybe posted),其他什么都不改
agent.md 还要求智能体在 memory store 里留下运行记录(runs/<date>.md):发帖前标记为 posting,发帖后标记为 posted 并记下消息 ID,或者标记为 maybe posted。
智能体:八步运行循环与判断规则
在 Managed Agents 里,一个 agent 就是一份带版本的配置:模型、系统提示词和工具。每次运行按运行步骤走完就结束。前言的字段提供名称、模型、工具与 MCP 服务器,正文则是指令。因为 MCP 工具默认会请求审批,而定时自动化没有人守在旁边点同意,所以 GitHub 工具集被设为 always_allow,而 GitHub token 本身是只读的。
为了让简报短,agent.md 给出一条判断标准:一个条目值得占一行,是因为读者今天会对它采取行动,或者它会改变读者正在做的决定;拿不准就别写。多数日子只有几条,有时一条都没有。「12 个待审」这种计数不算条目,要直接给出被卡住的那几个链接。已报过且仍未关闭的,只保留一行并标注状态(如「仍在等待,第 3 天」);已经关闭的直接丢掉,不做评论。
还有一条关于时效的规则:从读完来源到发帖之间,世界会变。发帖前要重新核对每一个即将报告的条目的实时状态——已经解决的就丢掉,仍然打开但情况变了的就修正措辞,无法确认的干脆丢掉、并写进运行记录的「裁掉」清单里。文章的原话很直接:「一条过期的『仍在等你』比十条漏报更伤信任,所以要么断言其状态,要么丢掉它。」所有链接必须从来源自身的字段复制(pull request 的 html_url、Slack 的 permalink),不能自己拼。
排期:日期要按读者的时区算
agent 只是一份配置,真正跑它的是 deployment。deployment 指明 agent、环境与每次运行的首条消息,也承载日程、vault、memory store 和预算;日程一触发,平台就开一个全新的会话。参考实现里的表达式是 32 7 * * 1-5,时区 America/New_York,即工作日上午 7:32 运行。
这里有个常见 bug:服务端按自己的时区算日期,于是智能体把今天早上叫成「昨天」。deployment 的 timezone 字段决定运行何时触发,正文第二行则告诉智能体按哪个时区推算日期。想不等日程手动试跑,可以用 ant beta:deployments run --deployment-id <id>。
记忆:偏好只读,状态读写
每次运行都在全新的沙箱里开始,上次的记忆一概不在。没有记忆,反馈就留不下来;但过时的记忆同样有害——它会把已经解决的条目说成仍在等待,或者因为「已经报过」而漏掉仍在打开的问题。模板因此用两个 memory store:
| 存储 | 归属 | 内容 |
|---|---|---|
preferences | 读者写,智能体只读 | 读哪些频道和仓库、排除什么、篇幅上限、目的地、何时停止 |
state | 智能体读写 | 书签、已报条目的台账、每次运行的记录、对偏好的修改提案、各来源的行为笔记 |
ant apply 会创建 preferences 存储,但不会创建里面的文件,首次运行前要用仓库里的 scripts/seed-preferences.sh 写入 preferences.md。
文章特别提醒:不要把偏好抄一份烤进提示词里,那样会把早已改掉的规则一直执行下去。让智能体每次运行都重新读文件;如果读不到,它应该停下来并说明,而不是退回默认值继续跑。
状态里的台账(ledger)用来避免重复报告。每一行记录报告时间、来源、一个不变的 ID(Slack 消息时间戳或 pull request 编号)以及最近一次已知状态,例如:
2026-09-09 slack:C0123456789 1788963600.000100 refund thread: customer waiting on a decision
2026-09-11 github 481 review blocked, day 2 (still waiting)
2026-09-11 slack:C0234567891 1789117333.000300 enterprise escalation: owner named, in progress
护栏:限定它能做什么、能花多少
因为自动化是在后台按日程跑的,作者给它加了两类限制。
一是能力边界。智能体读的消息和 issue 都是别人写的,那些文本可能被当成指令来理解。所以要假设最坏情况:示例里 GitHub token 与 preferences 存储都是只读的,环境只能访问允许清单上的主机。即使有人植入指令,最多也只能改变简报的措辞,改不了 GitHub 上的内容,也改不了你的规则。Slack 是唯一的例外——读和发用的是同一个 token,所以只把机器人邀请到确实需要读或发的地方。
二是花费上限。文章建议先按正常运行成本的 3 到 5 倍设,看到真实数字后再收紧。达到上限的运行会暂停而不是失败,因此上限设得太低,表现就是简报突然安静了。上限写在 deployment 的 budget 里,每次运行拿到全额,用尽时以 budget_reached 为停止原因:
budget:
  type: limit
  max_list_cost:
    amount: "500" # 字符串,单位是美分:"500" 即 5.00 美元
    currency: USD
六条可以直接带走的规则
文章最后把整个参考实现收敛成六条规则:
- 每个来源都从书签开始读,而不是固定时间窗口
- 读取失败要如实报告为「读不到」,绝不能当成「今天很安静」
- 发帖前,重新核对每一个条目
- 只有 Slack 确认之后才算发送成功,然后才更新书签与台账
- 每次运行都重读偏好,而且放在智能体改不了的存储里
- 只读的地方就给它只读权限,并给每次运行设花费上限
核心总结
- 参考实现:Claude Managed Agents 上的每日简报智能体,读 Slack 与 GitHub,按日程把要点发到一个 Slack 频道;配置写成文件,用
ant apply创建资源,运行在 Anthropic 的基础设施上 - 六个部件:来源、目的地、智能体、排期、记忆、护栏;凭据存 vault,沙箱里只有占位符
- 三条最容易被忽略的规则:按书签而非固定窗口读取、读取失败必须显式报告、确认发送成功后才更新记录
- 记忆的职责分离:偏好由读者写、智能体只读且每次重读;状态由智能体读写,含书签、台账与运行记录
- 护栏:只读权限 + 网络允许清单抵御提示注入,预算上限保护成本,达到上限时运行会暂停而非失败
- 成本调参:预算初值取正常运行的 3 到 5 倍,据实测收紧
原文:Building effective agent automations(claude.dev,2026-10-08)


