10 月 18 日,Browser Use 的 Nik Tomazic 发布了一篇面向选型与落地的指南《What Is a Browser Agent? How It Works and When to Use One》。文章没有讲新模型,而是把「浏览器智能体」这个概念拆成可操作的三层结构、一张选型决策图、一份来自自家云端产品的真实任务分布,以及五类必须提前想清楚的失效模式。它的核心结论其实相当克制:有 API 就用 API,流程可预测就用脚本,只有当下一步取决于页面上出现什么的时候,才轮到智能体。
它就是一个「花哨的循环」
按文章的说法,浏览器智能体本质上「只是一个花哨的循环」(basically just a fancy loop):打开页面、观察、选一个动作、执行、检查结果,反复直到达成目标。
while goal is not reached:
    observe the page
    choose an action
    execute the action
    check the result
循环中途可能要停下来等人:登录、补一个缺失的信息、或者批准某个敏感操作。执行框架(harness)还应该在达到时间、步数或成本上限时终止运行——这一点常被忽略,但它是成本可控的前提。
三层:模型、执行框架、浏览器
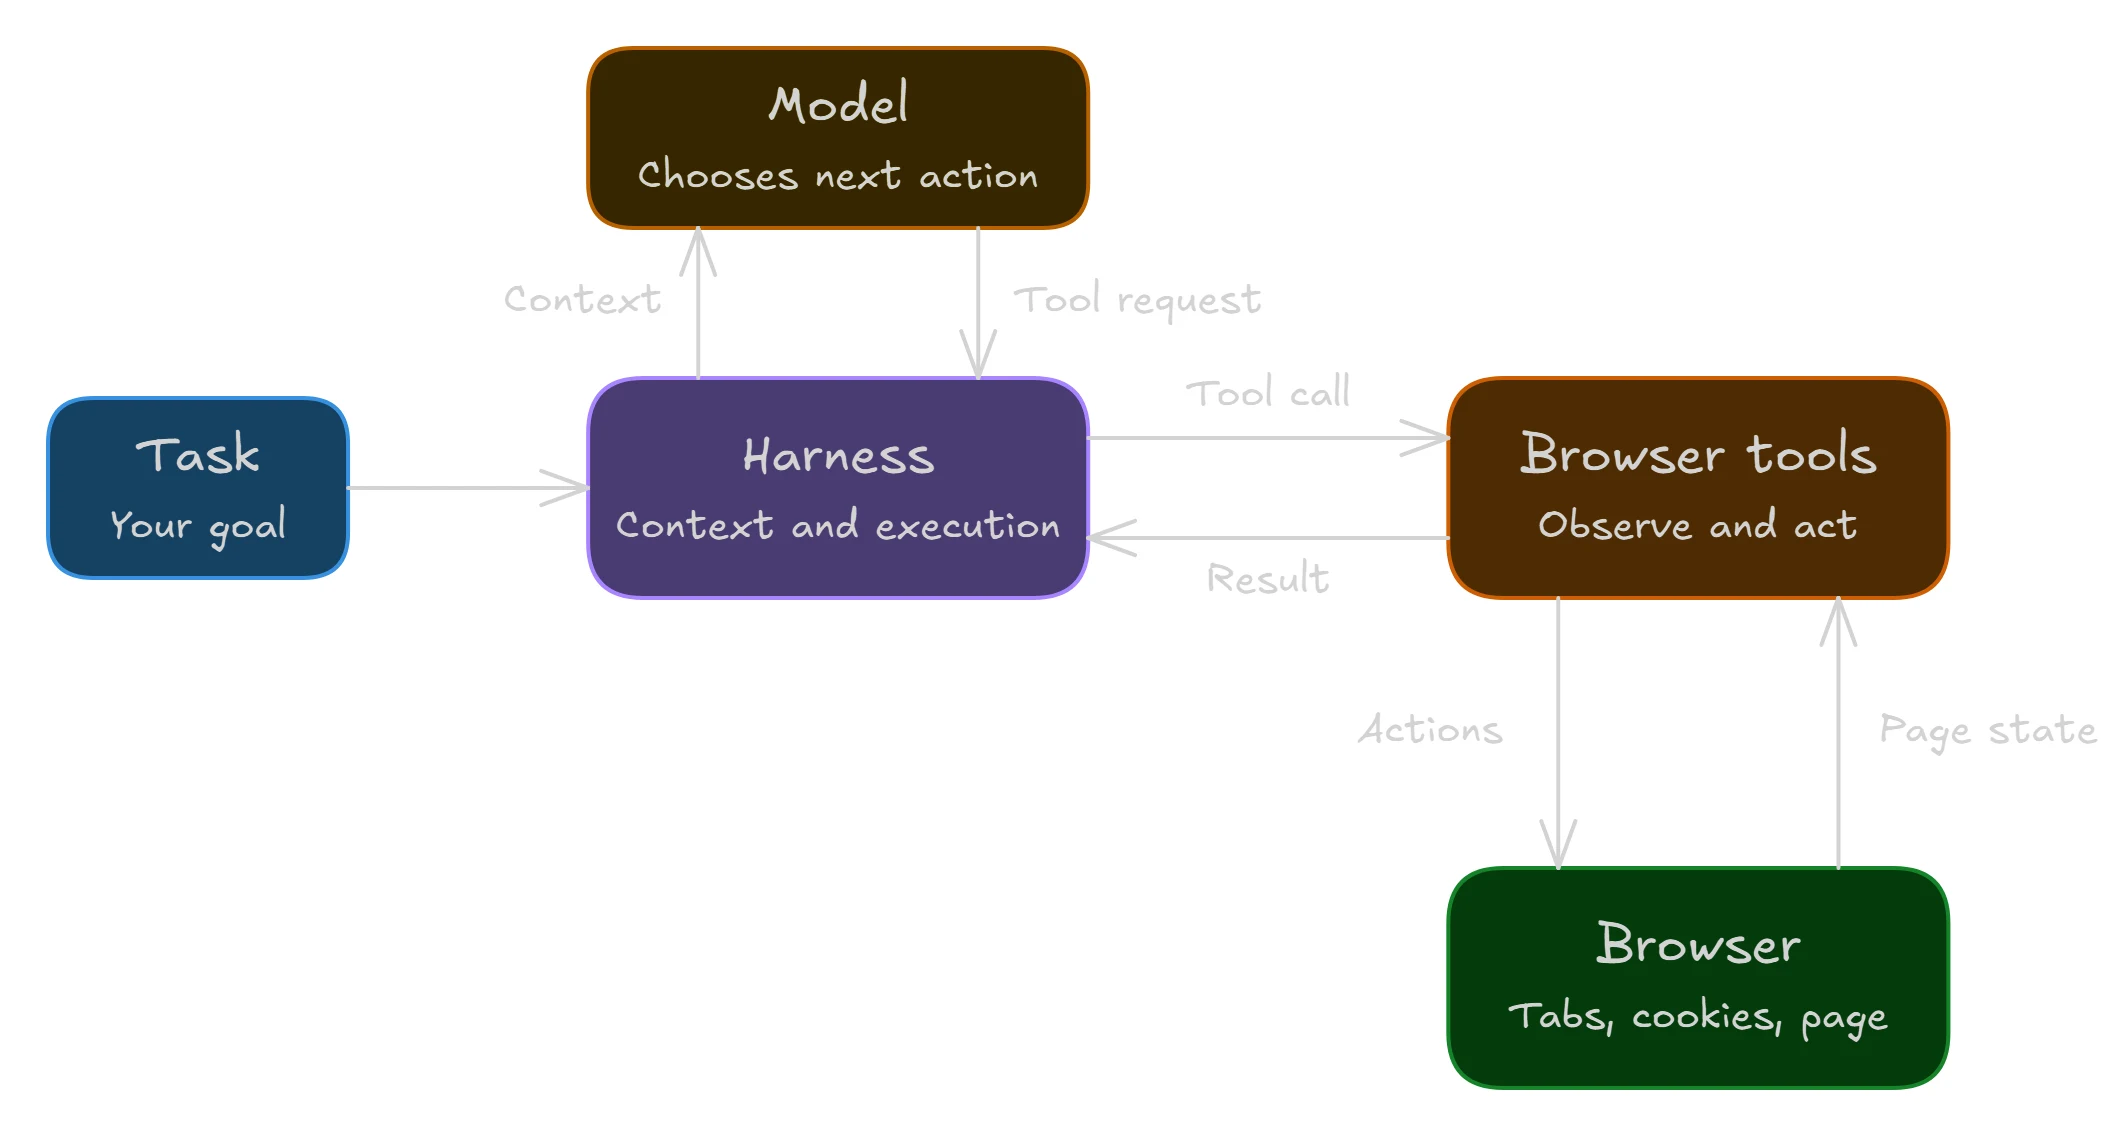
图 1:模型、执行框架与浏览器的分工,以及动作与页面状态的往返。图片来源:Browser Use
- 模型:根据任务描述和当前页面状态决定下一步做什么。页面信息可以以文本、结构化数据或截图的形式提供给它。
- 执行框架:维持循环、给模型提供上下文、执行它请求的工具,并把结果回传。Browser Use 的 Browser Harness 走的是另一条路——它给已有的编码智能体开放浏览器访问权限,允许它在运行过程中现场编写缺失的辅助函数,而循环本身仍由编码智能体的运行时管理。
- 浏览器:加载网站,维护标签页、cookie 与登录态。它通常通过浏览器协议控制,例如 Chrome DevTools Protocol(CDP)或 WebDriver BiDi。
智能体也可以经由 MCP 服务器调用浏览器工具——文章点名 Playwright MCP 作为例子,它把 Playwright 的自动化能力暴露成智能体可以调用的工具。在服务端场景下,浏览器通常以无头(headless)模式运行,没有可见窗口,但照样渲染页面并截图给模型。
智能体怎么「看」页面
有两种常见做法,而且可以混用:
- 结构化页面数据:通过 DOM 或无障碍树(accessibility tree)读取元素。无障碍树用名称、角色和状态描述元素,比如一个名为「Search」的按钮、一个已勾选的复选框。这样模型不必靠猜图片里的位置来定位控件。
- 截图:由具备视觉能力的模型直接读渲染后的页面,再选择点击坐标。这对 canvas 之类没有可用标签或结构的内容很有用,但小控件很难点准,尤其是截图被缩小之后。
无论用哪种方式,页面一变就必须重新观察:菜单可能弹开、对话框可能盖住表单、新结果可能替换掉刚读过的那一屏。
智能体、脚本还是 API
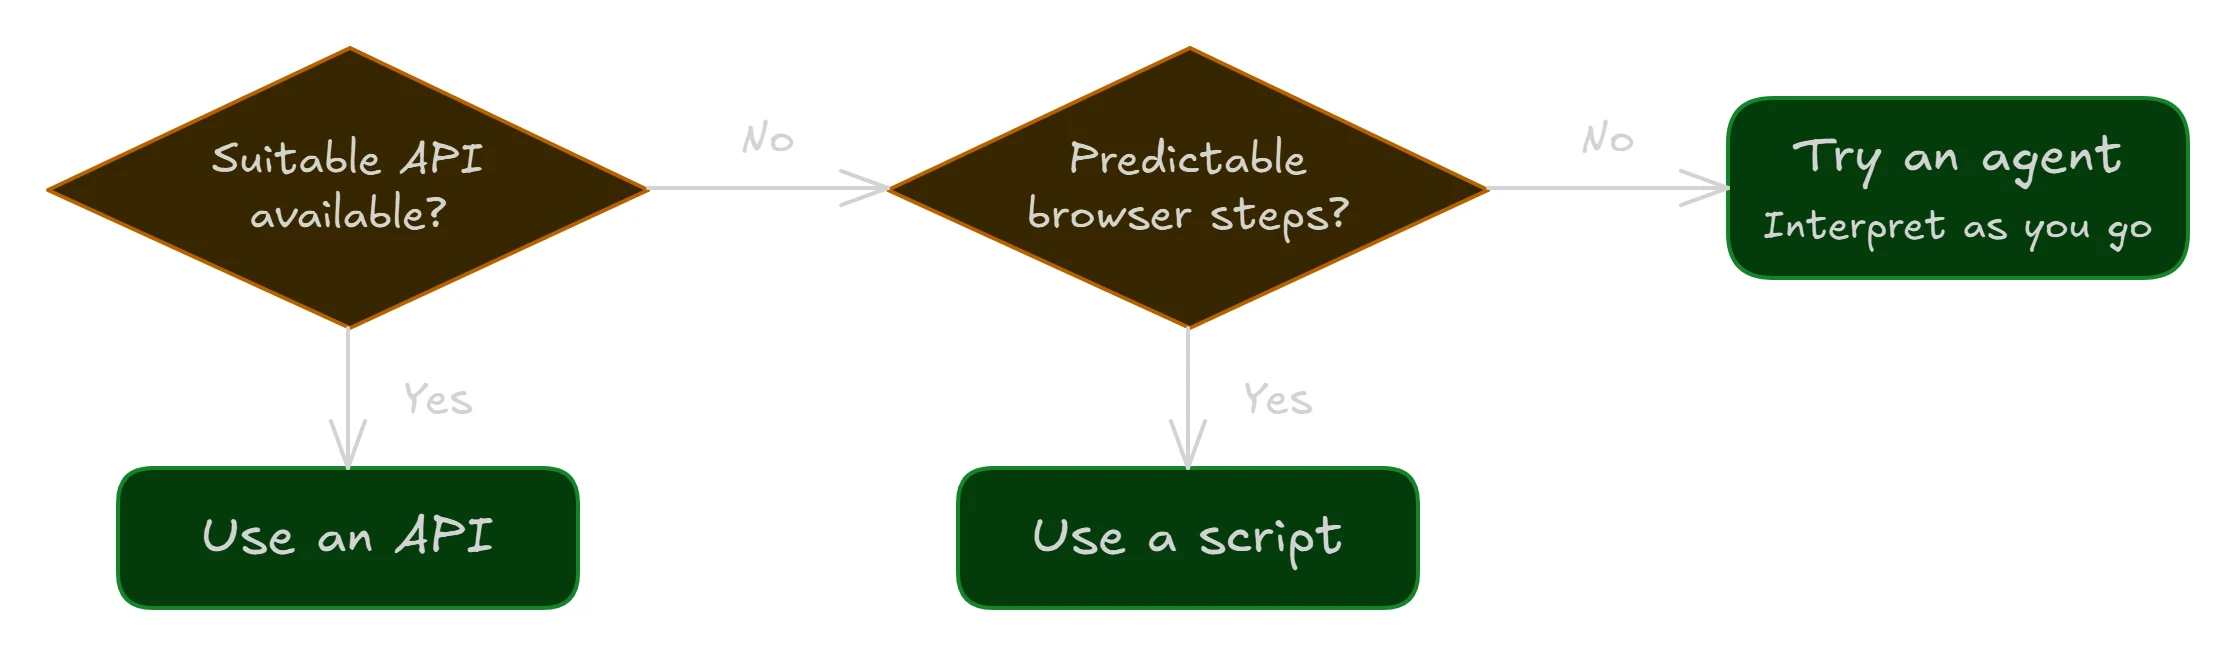
图 2:三种自动化方式的决策顺序。图片来源:Browser Use
文章给了一个明确的顺序:
- 有合适的 API 就用 API。例如直接拉取订单,而不是去仪表盘里翻。
- 没有 API、流程可预测就用脚本。Playwright、Selenium、Puppeteer 都行,「每周一下载同一份报表」是典型例子。步骤由你控制,代价是网站一改就要更新。
- 流程不可预测、或者无法把具体步骤写死时才用智能体。它能在陌生的网站上找报表,也能应付结构各不相同的表单,但结果和模型成本都会波动。
关键区别在于确定性:脚本和常规 API 流程遵循确定规则,同样的输入和状态会得到同样的决策;智能体的决策是随机的(stochastic),同一个任务两次运行可能走不同的路径。文章也提醒,智能体还是很不错的原型工具——不必把每个交互都写出来,就能先试一遍流程。
人们真的在拿它做什么
文章公开了 Browser Use Cloud 上 V2、V3、V4 智能体的使用数据,统计口径为 2026 年 10 月 18 日的快照,按运行次数占比四舍五入:
| 任务或流程环节 | 运行占比 |
|---|---|
| 通过登录 | 18% |
| 抽取结构化数据 | 14% |
| 研究开放性问题 | 6% |
| 求职申请 | 6% |
| 查找财报与文件 | 5% |
| 预订与购买 | 3% |
分母是数据集里的全部运行,其中还包括 15% 未分类的运行。上述六类合计约 52%,其余部分属于文中未列出的类别。文章特别说明,这份分布既包含「抽取数据」这样的最终任务,也包含「处理登录」这样的支撑步骤;它描述的是人们在跑什么,而不是成功率。
五类失效模式
网站限制
站点会用 bot 管理系统挑战或拦截自动化流量,也会用速率限制约束请求频率;同一个站点可能在公开浏览时放行,而在登录或结账环节收紧检查。文章直言,换一个更强的模型并不能解决所有访问限制。
认证与访问
会话会过期,多因素认证往往需要人来输入。智能体可能需要暂停,等你提供验证码或批准登录。复用已认证的会话能减少重复登录,但流程仍然要处理会话失效。
结果错误或不完整
智能体可能选错商品、漏填必填项,或者在表单尚未保存时就报告完成。文章的原话是:「一次没有报错地跑完,并不代表任务成功了。」重试还有额外风险——如果上一次其实已经成功,重试可能造成重复下单或重复投递。建议先检查已保存的记录或确认页再决定是否重试;做数据抽取时,要把返回值和源页面对照,因为「合法的 JSON 本身并不证明数据是对的」。
提示注入
页面里可能藏有试图把智能体引向别处的指令,这就是提示注入。文章的建议是三层:把页面内容当作不可信输入;限制智能体可访问的账号与可执行的动作;在应用层对敏感操作强制审批。这些措施能降低风险,但不能消除风险。
运行成本不可预测
因为跑在 LLM 上,一个任务到底要一步、两步还是许多步,事先并不确定;按用量计费意味着额外的模型调用和浏览器时长都会推高成本。更麻烦的是失败重跑——完成一个任务的成本可能高于单次运行的成本。文章给了一个衡量口径:把包含失败与重试在内的全部花费,除以经过验证的成功任务数,得到每个成功任务的成本;人工复核的时间则单独统计。
怎么开始
文章建议从一个只读任务起步,比如收集商品价格,并在运行前明确定义四件事:
- 智能体可以访问哪些页面
- 必须返回哪些字段
- 什么算作成功
- 时间、步数或成本上限
任务可以交给托管智能体,也可以自己跑。开源的 Browser Use 库支持用 Python 构建智能体,模型和本地/云端浏览器都可自选;托管方案负责执行,应用只需提供目标并校验输出。如果你已经在用编码智能体,那么加上浏览器工具可能就够了,因为它现有的运行时已经能管理推理循环——单独一个远程浏览器只提供了浏览器环境,还得有智能体或脚本来操控它。
最后是验证节奏:重复跑同一个任务,把结果与源页面比对,记录验证通过率、耗时、总成本与人工纠正次数;只有当你清楚它在哪些地方需要人帮忙之后,再扩展到更多站点或任务。
核心总结
- 定义:浏览器智能体是用 AI 模型操作浏览器、朝目标推进的软件,本质是「观察 → 选动作 → 执行 → 检查结果」的循环
- 三层结构:模型负责决策,执行框架维护循环并提供工具,浏览器承载标签页、cookie 与登录态,通过 CDP 或 WebDriver BiDi 控制
- 读页方式:DOM / 无障碍树提供结构化信息,截图配合视觉模型处理 canvas 等视觉界面;页面一变就要重新观察
- 选型顺序:有 API 用 API,流程可预测用脚本,只有下一步取决于页面内容时才用智能体;脚本是确定性的,智能体是随机的
- 真实用量:登录占 18%、结构化抽取 14%、研究 6%、求职 6%、财报查找 5%、预订购买 3%,另有 15% 未分类;这是使用分布,不是成功率
- 五类失效:网站反爬、认证与会话过期、结果错误或未落盘、提示注入、成本不可预测
- 衡量口径:每个成功任务的成本 = 全部尝试(含失败与重试)的总花费 ÷ 已验证成功数,人工复核时间另计
原文:What Is a Browser Agent? How It Works and When to Use One(Browser Use,Nik Tomazic,2026-10-18)
参考:
- Browser Use 开源库(GitHub)
- Playwright MCP(GitHub)


