DSpark 深度解读:半自回归草稿与置信度调度的投机解码
研究2026年8月4日
DeepSeek 开源 DSpark:并行草稿骨干配轻量自回归头,置信度调度按负载裁剪验证,线上单用户速度提升 60%–85%。
DeepSeek 开源 DSpark:并行草稿骨干配轻量自回归头,置信度调度按负载裁剪验证,线上单用户速度提升 60%–85%。
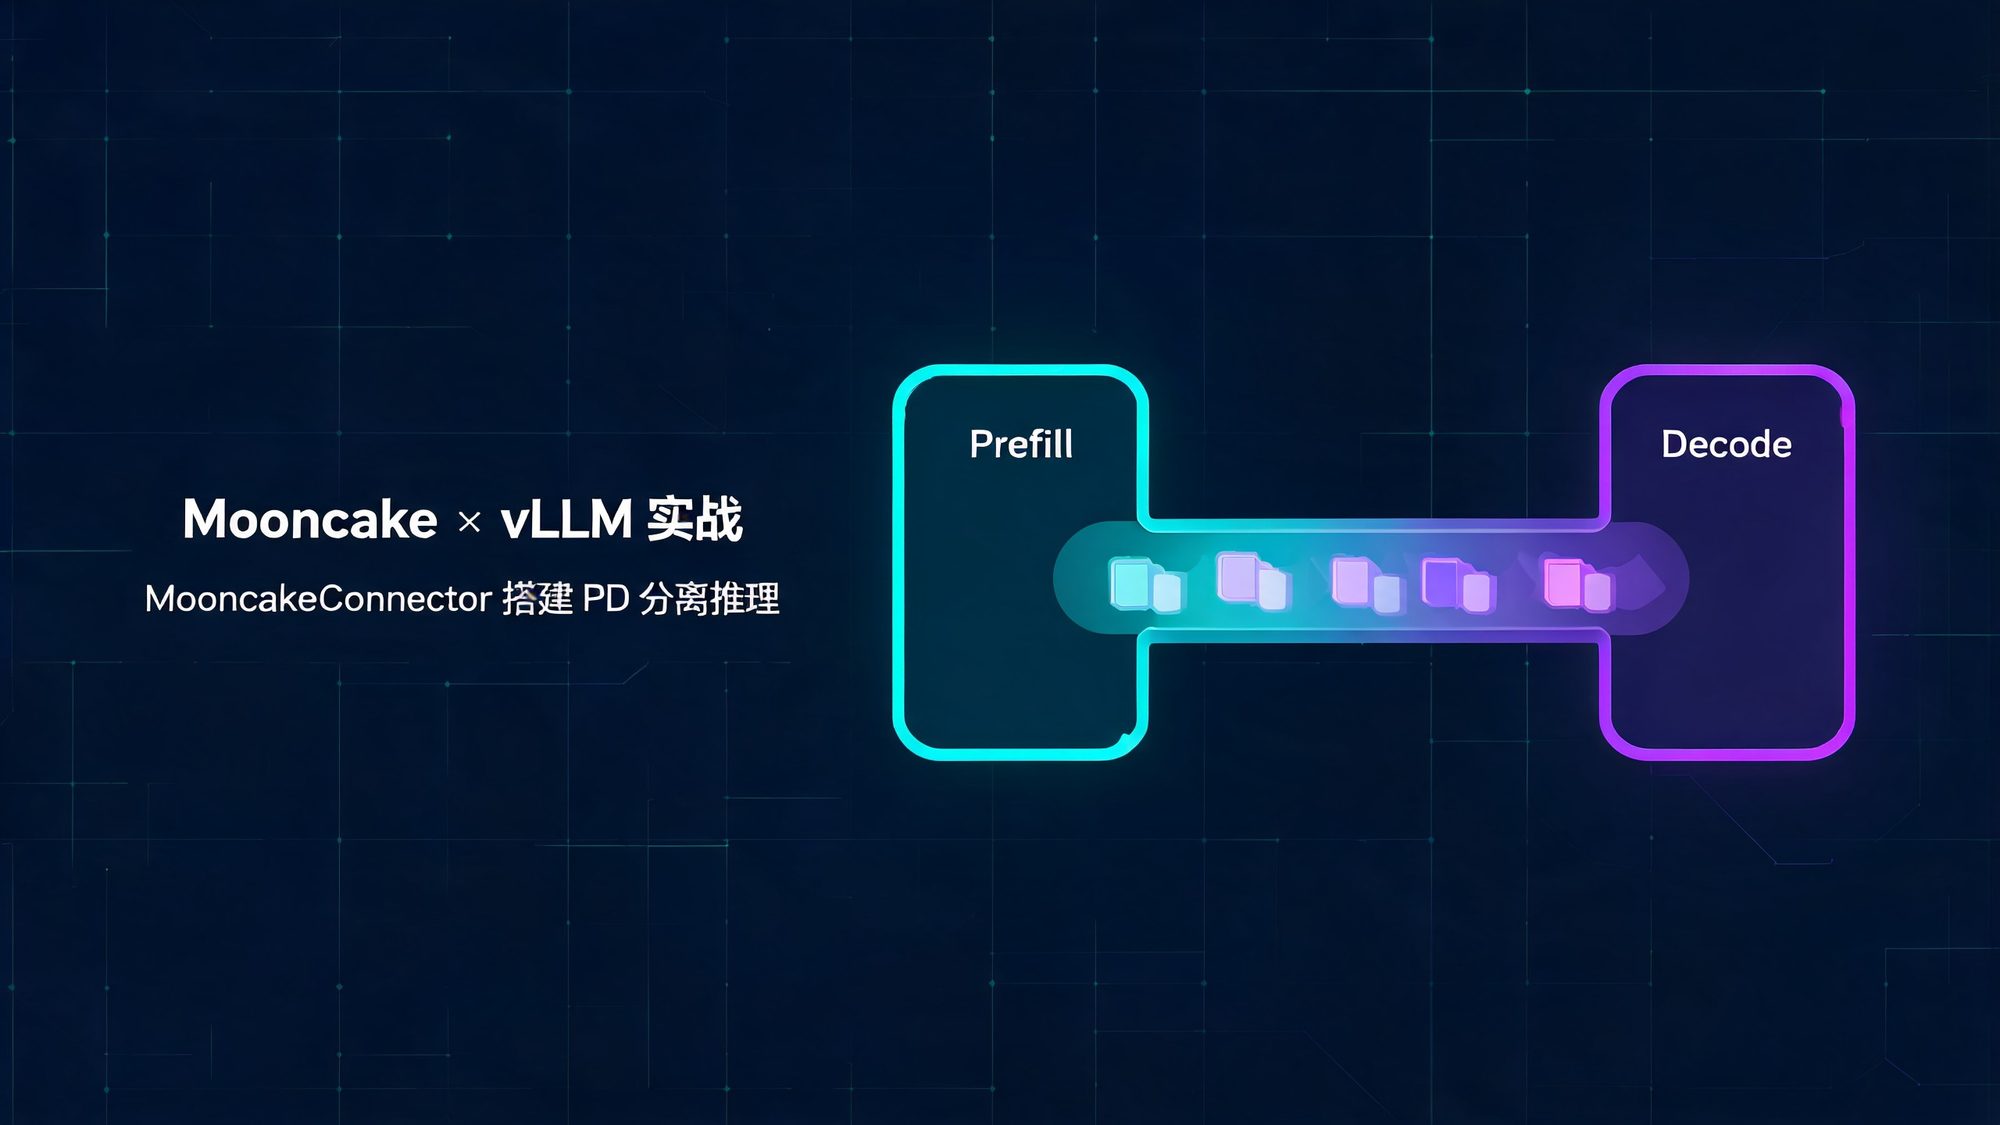
手把手部署 vLLM 与 Mooncake 的 PD 分离推理:MooncakeConnector 通过 RDMA 跨节点直传 KV 缓存,峰值带宽 142.25 GB/s,覆盖 V1 与 V0 两种后端。
手把手部署 vLLM + MooncakeStore 分布式 KV 缓存池:CPU/SSD 卸载、跨实例前缀缓存共享、XpYd 灵活编排,覆盖 V1 与 V0 两种后端。
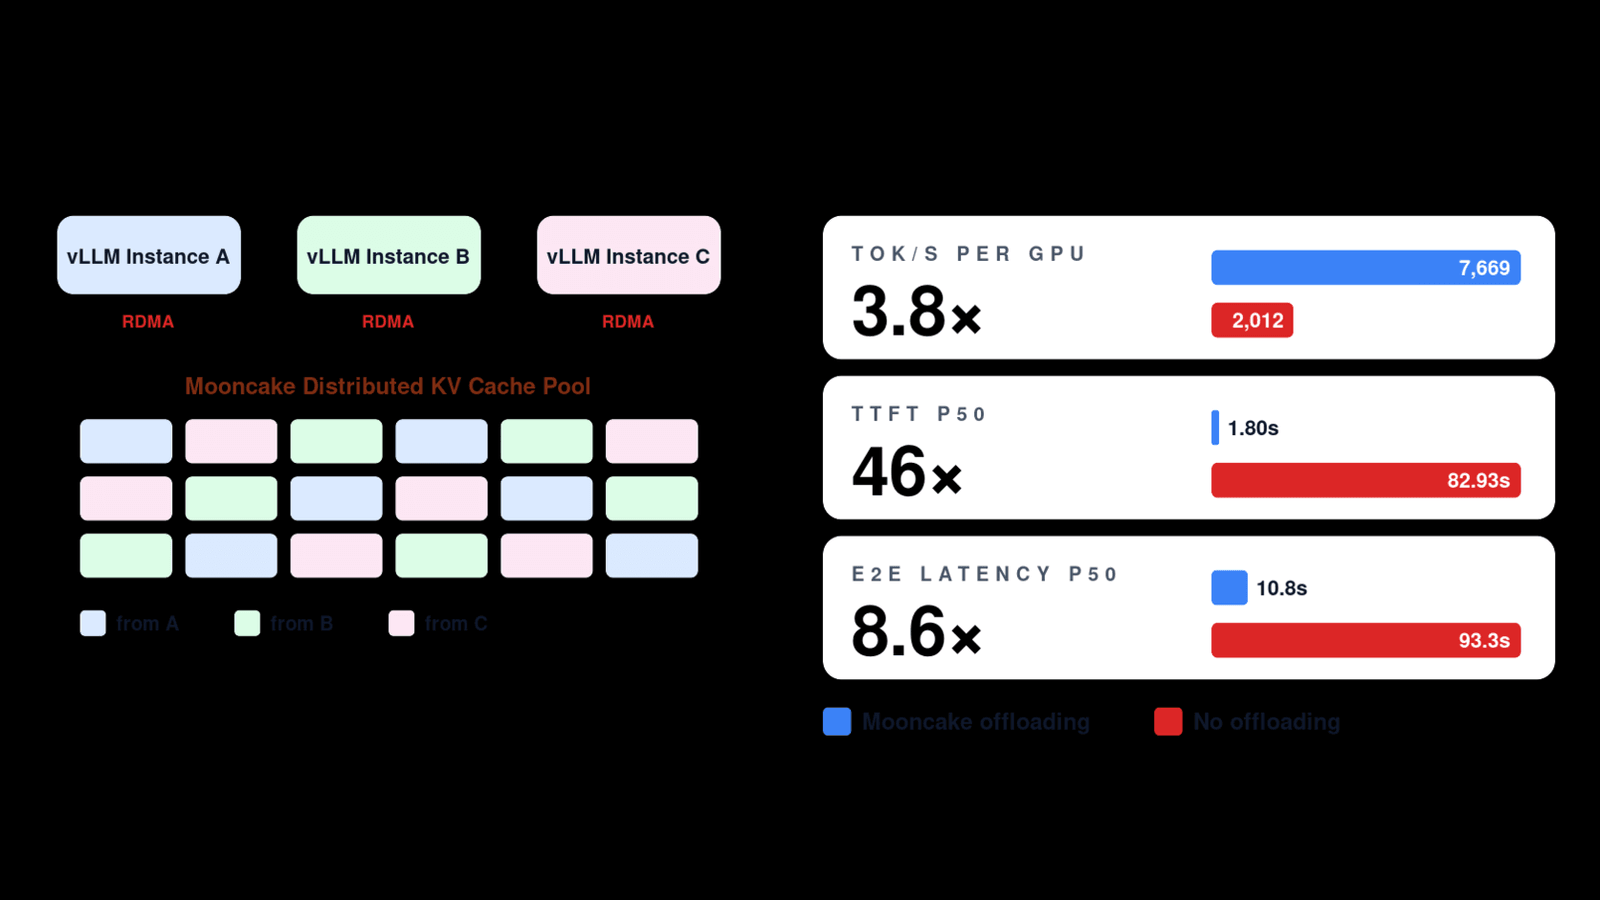
vLLM 集成 Mooncake Store 构建分布式 KV 缓存池:真实智能体负载下吞吐提升 3.8 倍、TTFT 降低 46 倍,近乎线性扩展到 60 块 GB200。
CUDA Graph 强大但限制不少:捕获期间不能同步、图拓扑与参数静态冻结、流捕获必须自包含、内存生命周期等九类约束详解。
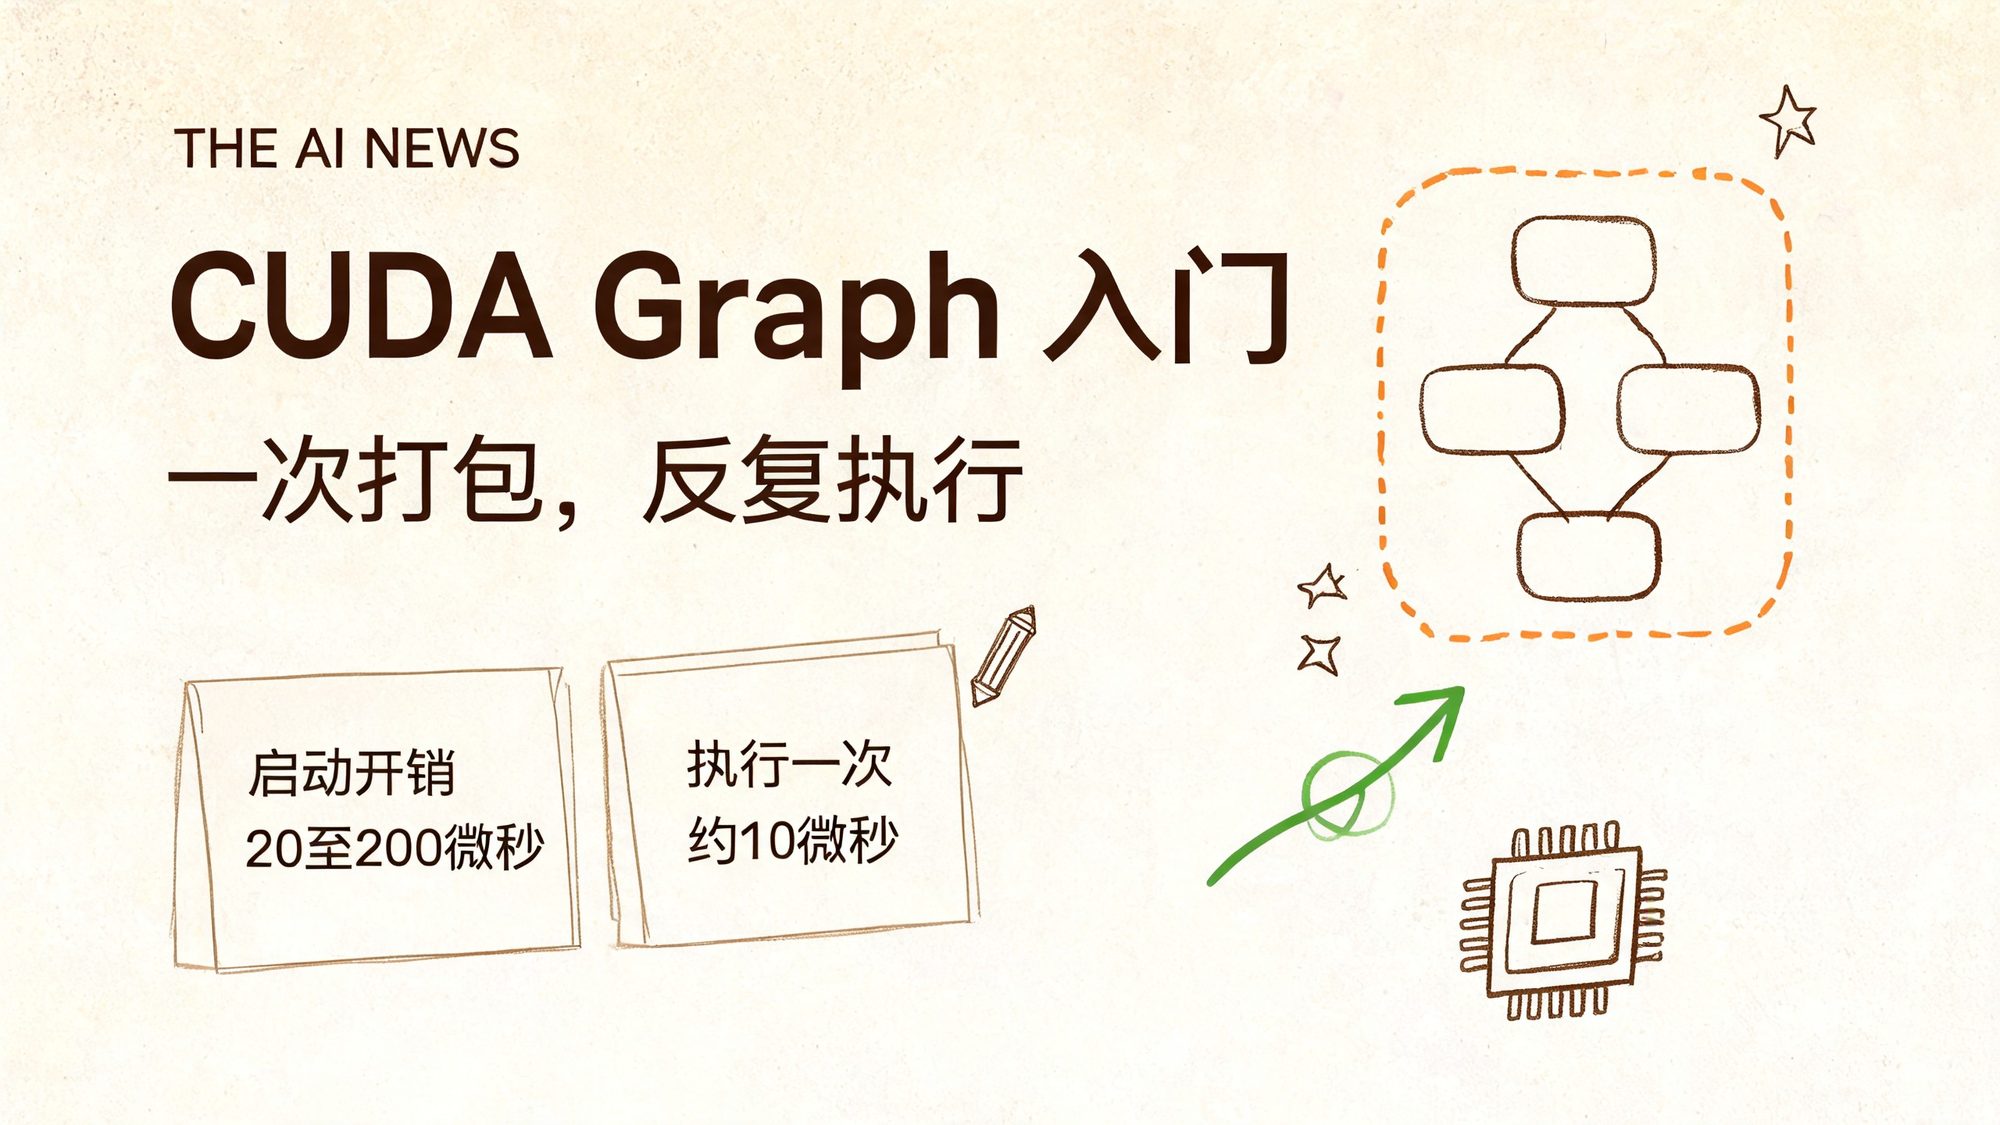
一份面向深度学习开发者的 CUDA Graph 中文介绍:启动开销从哪来、图如何定义与执行,以及 PyTorch 里怎么用。
DeepSeek 官方提供一键脚本和手动配置两种方式接入 Codex,CLI、ChatGPT 桌面端、VS Code 插件共用一份配置。
DeepSeek-V4-Flash-0731 的 Gilded Gnosis r16 镜像通过全部门禁:内置 DSpark K5 投机解码、InstantTensor 加载与可选原生 CPU KV 卸载。