vllm-backport:让 DeepSeek-V4-Flash 跑上 A6000 与 A100
工具2026年8月7日
面向 Ampere 显卡的 vLLM 分支:把 DeepSeek-V4-Flash-0731 的推理支持回移植到 A6000、A100、RTX 30 系,8×A6000 实测 prefill 3435 tok/s、decode 948 tok/s。
面向 Ampere 显卡的 vLLM 分支:把 DeepSeek-V4-Flash-0731 的推理支持回移植到 A6000、A100、RTX 30 系,8×A6000 实测 prefill 3435 tok/s、decode 948 tok/s。
Codex Security 是 OpenAI 的应用安全代理,从 Aardvark 走向开源,已扫描 3000 万+ 提交、修复 7 万+ 漏洞,推动行业转向补丁自动化。
开源生产栈在单块 MI300X 部署 DeepSeek-V4-Flash:FNUZ FP8 修复、DSpark-7 投机解码,单流 168.6 tok/s。
DeepSeek 开源 DSpark:并行草稿骨干配轻量自回归头,置信度调度按负载裁剪验证,线上单用户速度提升 60%–85%。
手把手部署 vLLM 与 Mooncake 的 PD 分离推理:MooncakeConnector 通过 RDMA 跨节点直传 KV 缓存,峰值带宽 142.25 GB/s,覆盖 V1 与 V0 两种后端。
手把手部署 vLLM + MooncakeStore 分布式 KV 缓存池:CPU/SSD 卸载、跨实例前缀缓存共享、XpYd 灵活编排,覆盖 V1 与 V0 两种后端。
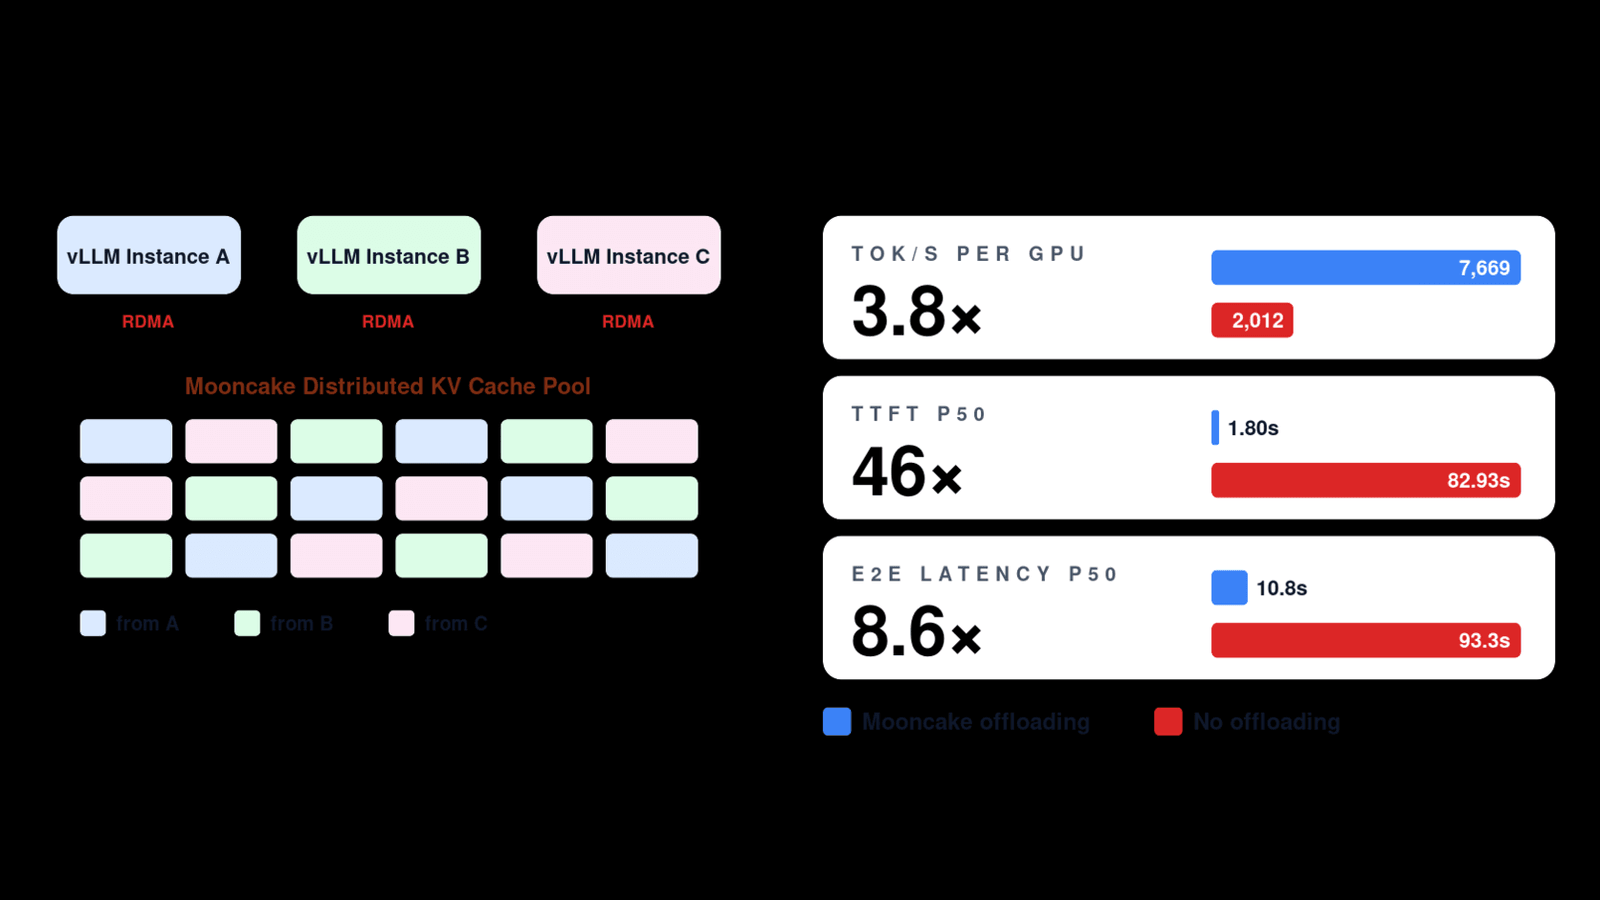
vLLM 集成 Mooncake Store 构建分布式 KV 缓存池:真实智能体负载下吞吐提升 3.8 倍、TTFT 降低 46 倍,近乎线性扩展到 60 块 GB200。
CUDA Graph 强大但限制不少:捕获期间不能同步、图拓扑与参数静态冻结、流捕获必须自包含、内存生命周期等九类约束详解。