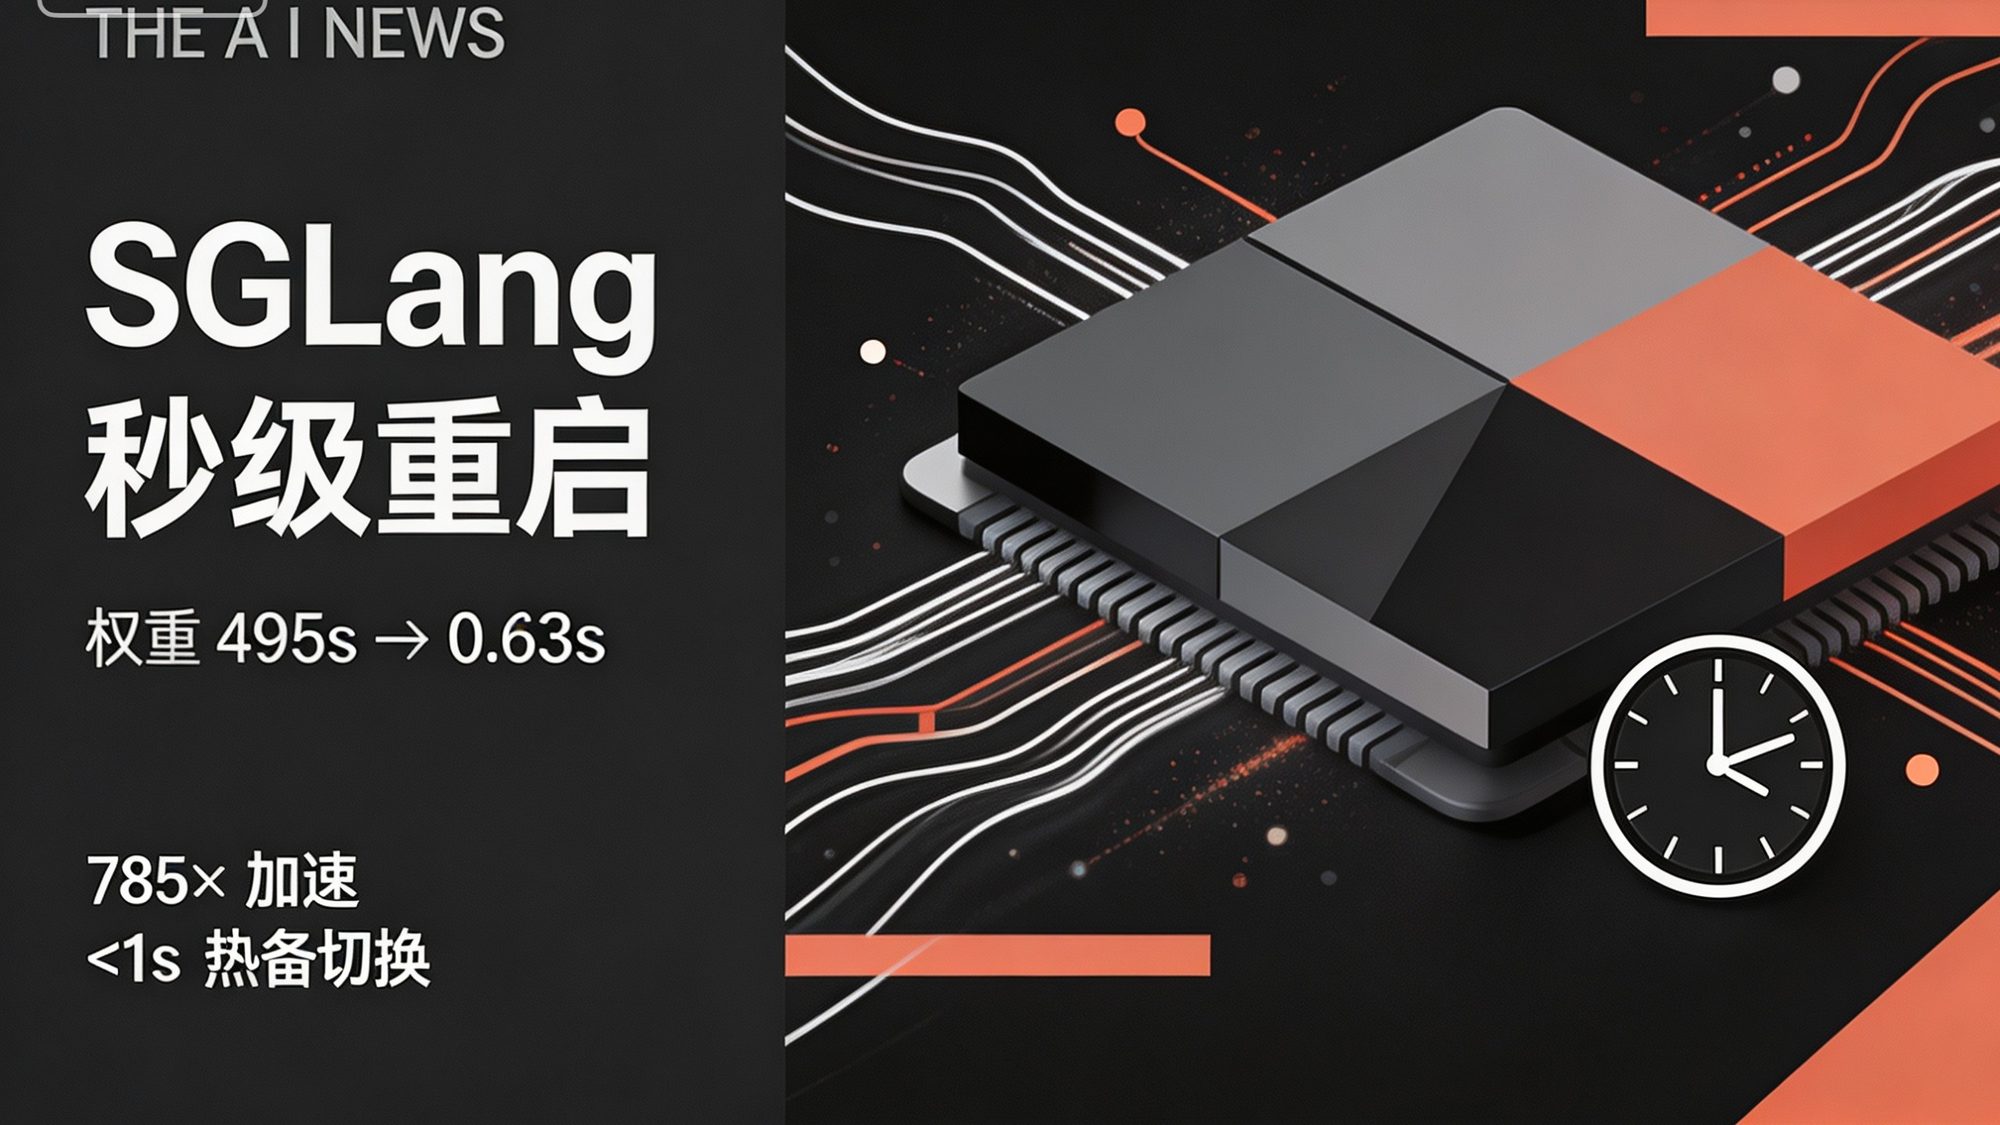
SGLang 秒级重启:Weight Cache Daemon 把权重加载从 495s 压到 0.63s
工具2026年8月22日
SGLang 引入 Weight Cache Daemon:常驻 GPU 进程用 CUDA IPC 零拷贝复用权重,加载提速约 785 倍、端到端启动缩短 93.9%,目标 <10s 冷启动、<1s 热备切换。
SGLang 引入 Weight Cache Daemon:常驻 GPU 进程用 CUDA IPC 零拷贝复用权重,加载提速约 785 倍、端到端启动缩短 93.9%,目标 <10s 冷启动、<1s 热备切换。
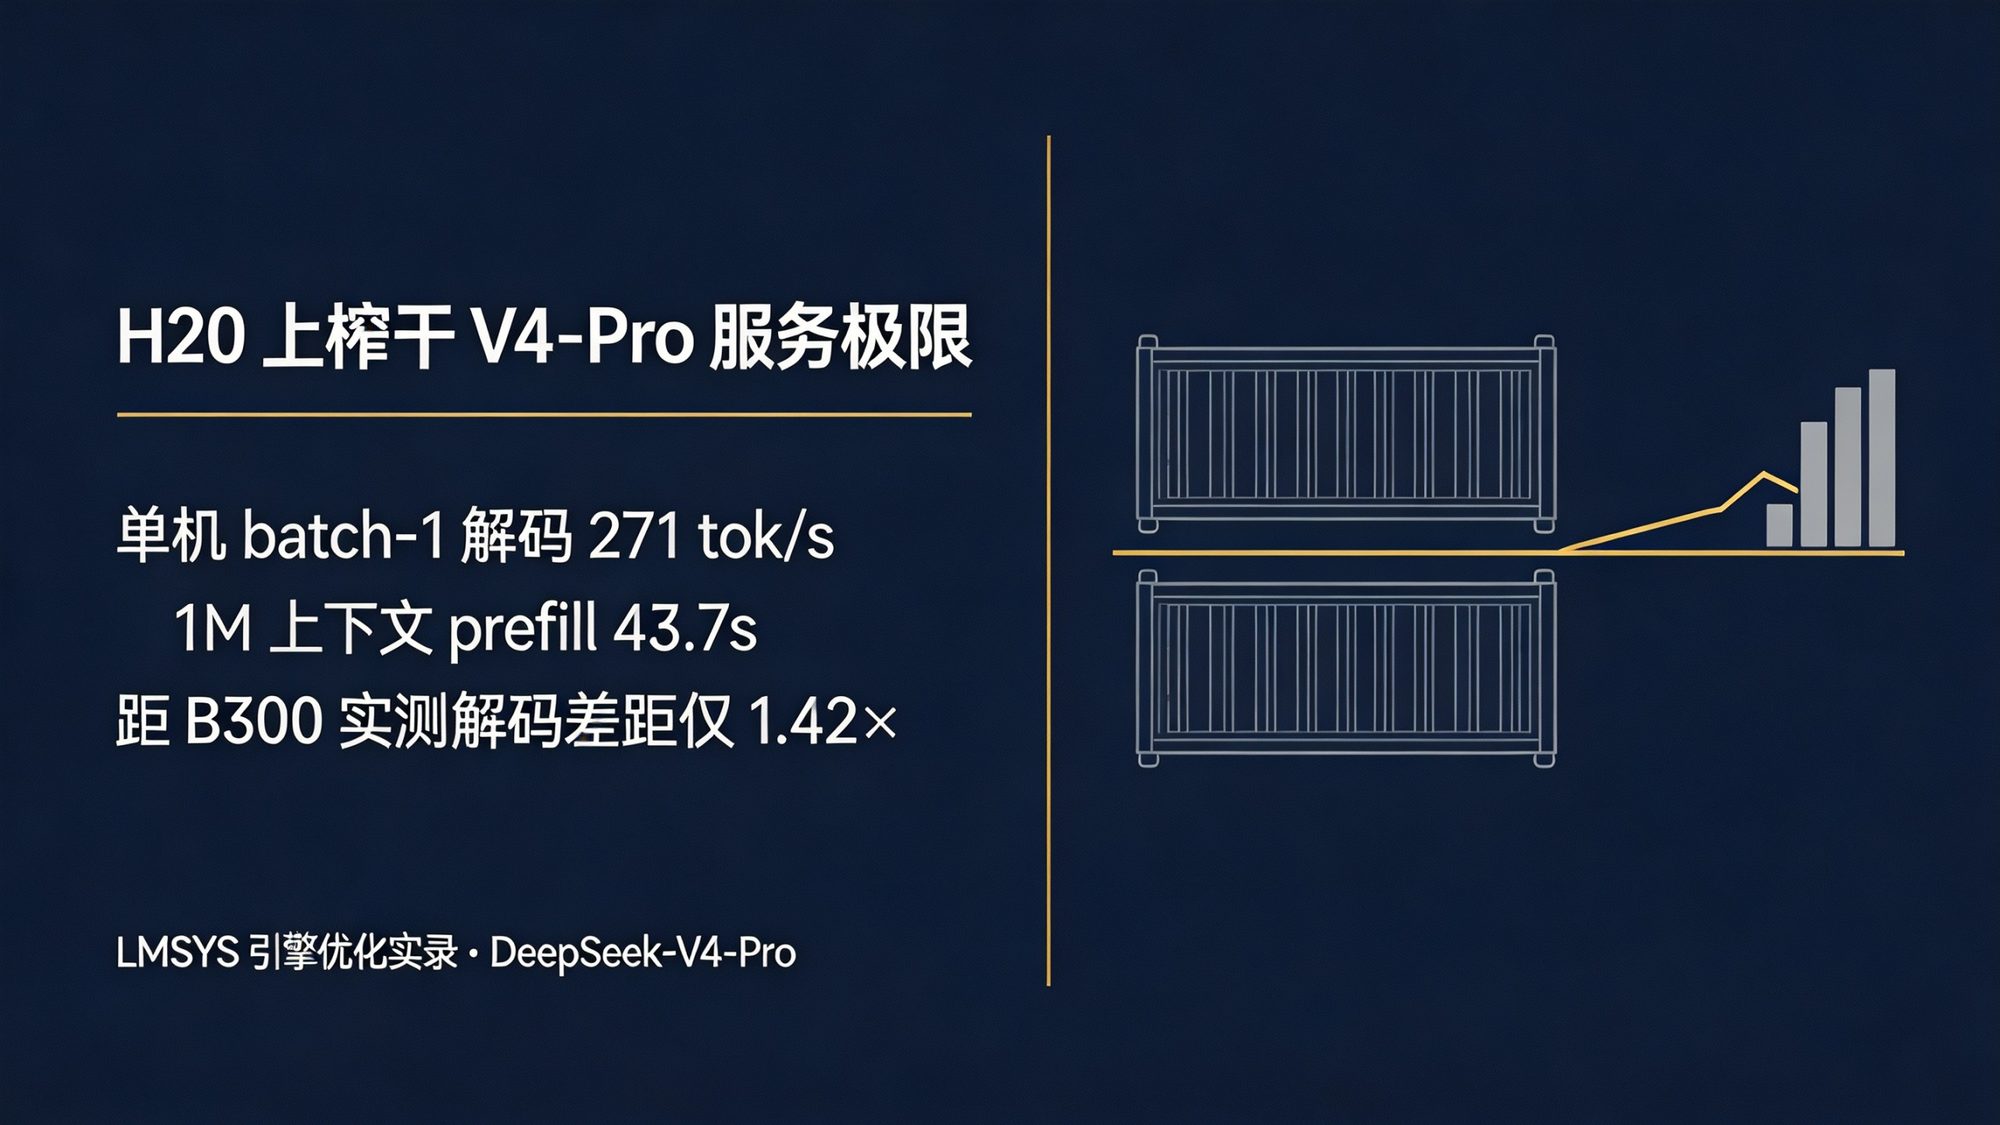
LMSYS 详解在 H20 上调度 1.6T 参数 MoE 模型 V4-Pro:单机 batch1 解码 271 tok/s(距 B300 仅 1.42×)、1M 上下文 prefill 43.7 秒、高吞吐单节点 4.67k tok/s。
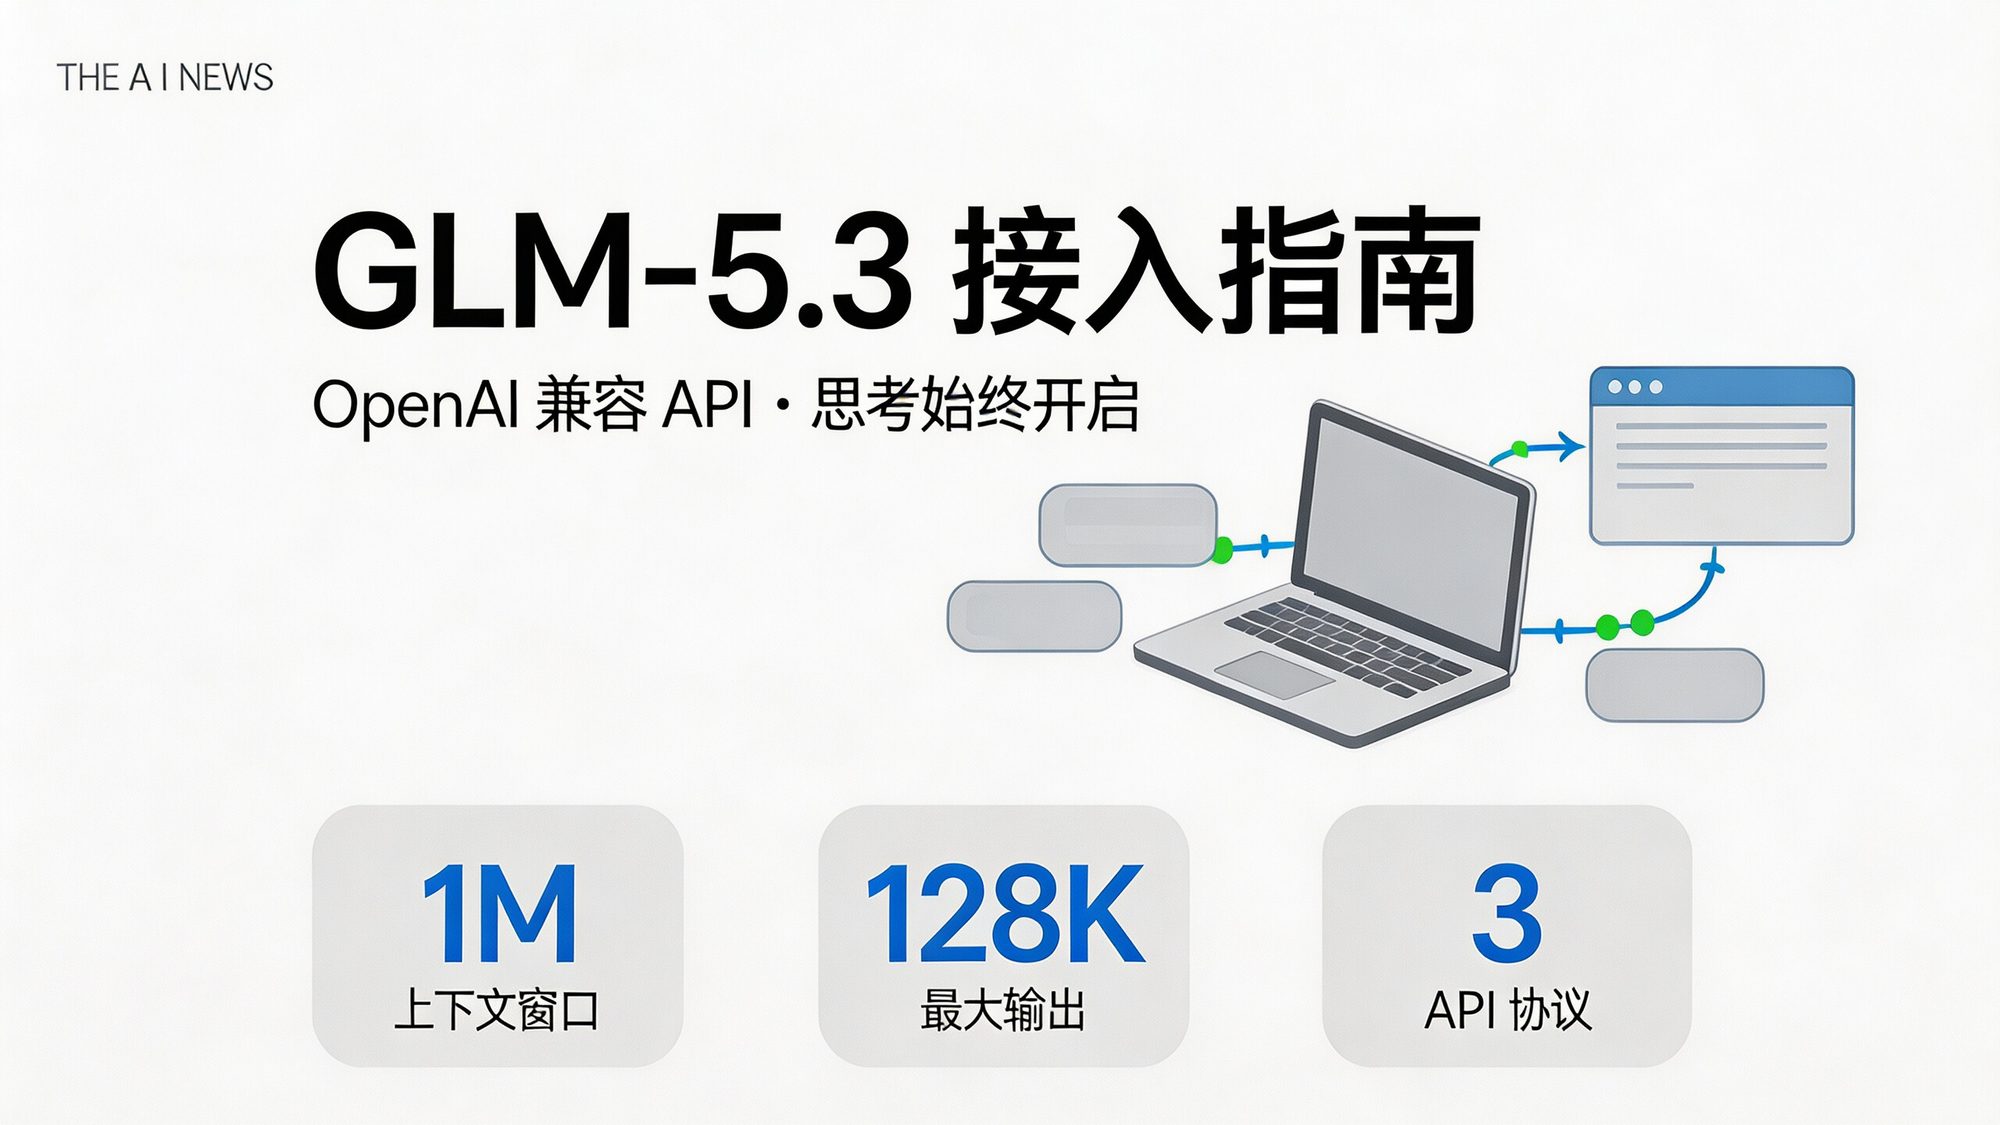
GLM-5.3 已全量开放:1M 上下文、128K 输出、思考模式始终开启。一文理清 API 协议、迁移要点与调用示例。
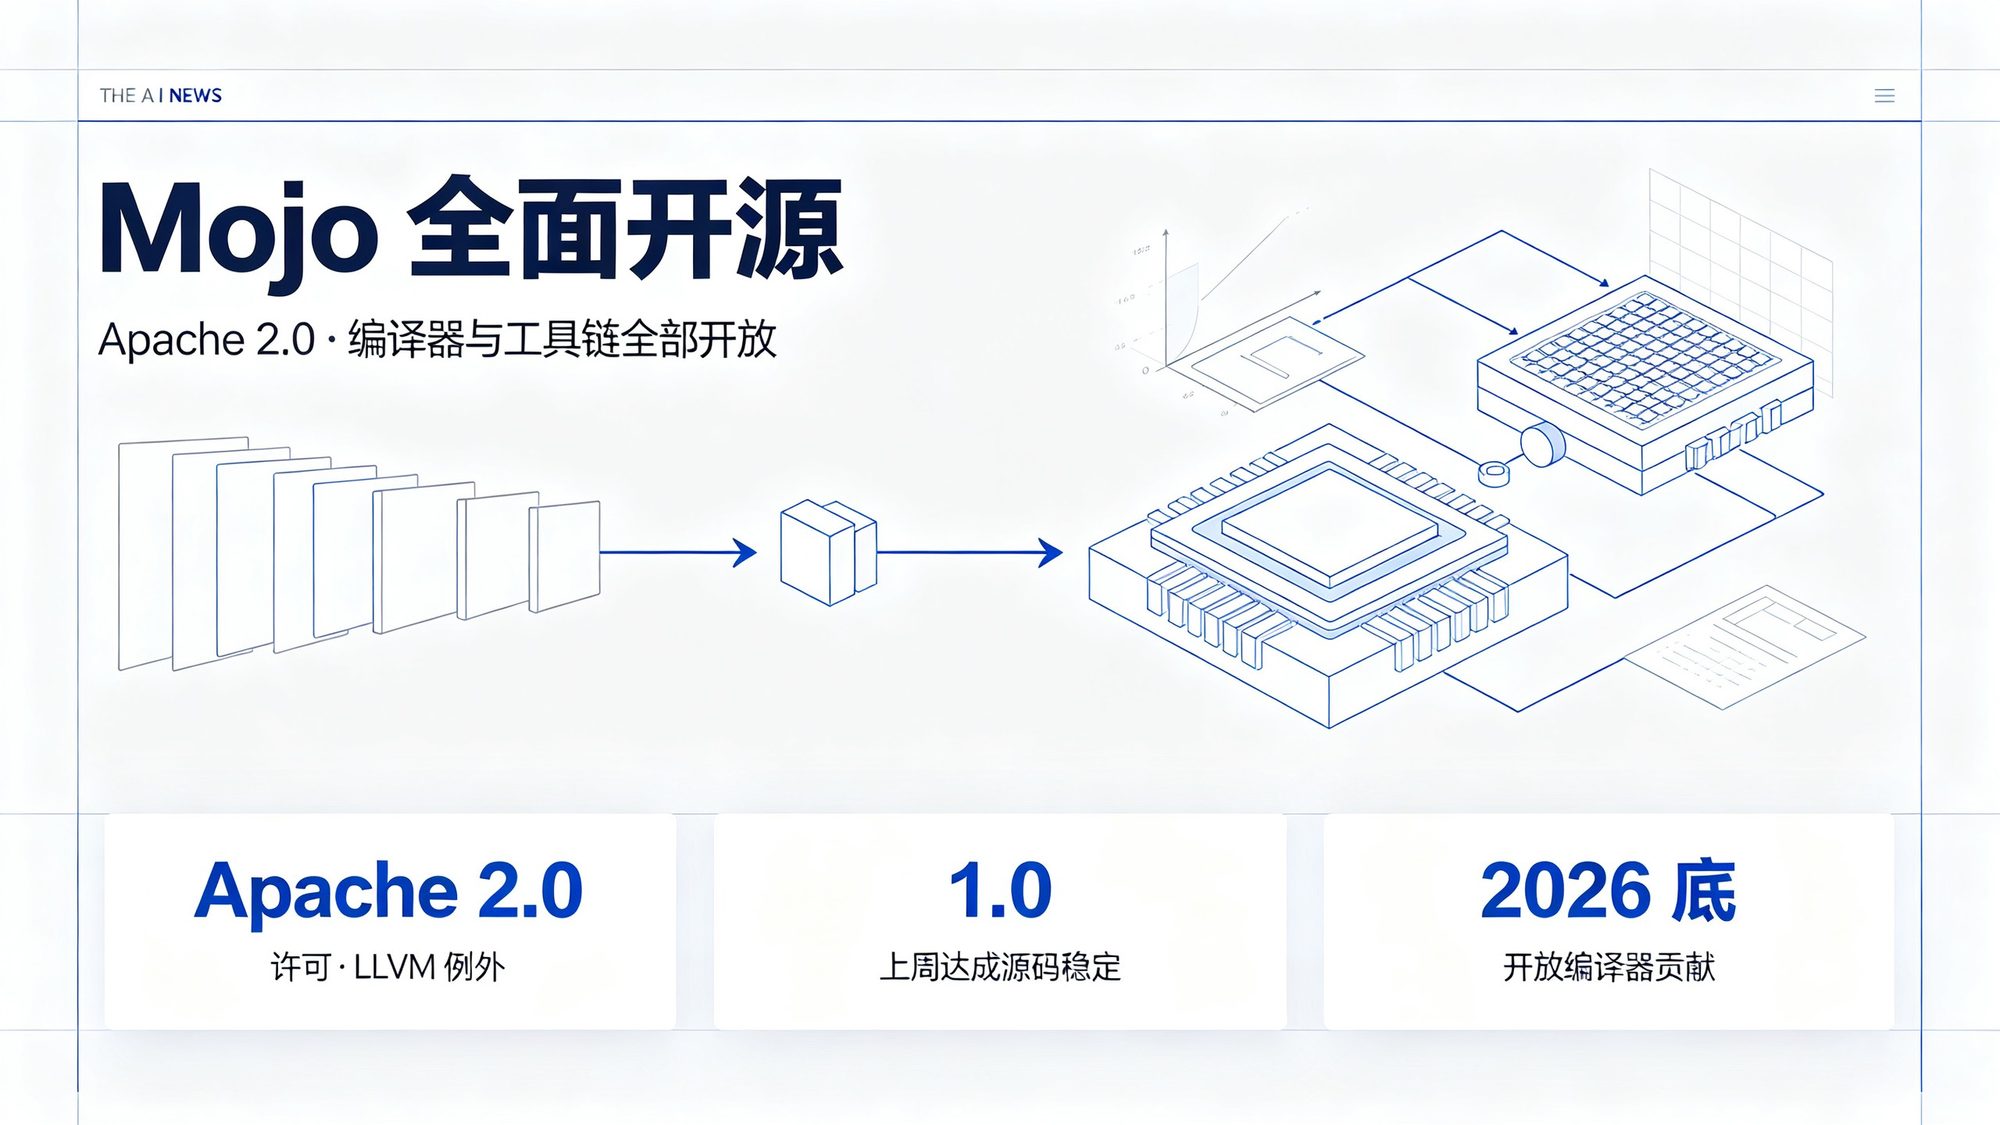
Modular 宣布 Mojo 全面开源:编译器与工具链以 Apache 2.0(含 LLVM 例外)发布到 GitHub,上周 Mojo 1.0 已实现源码稳定,可从源码自行构建。
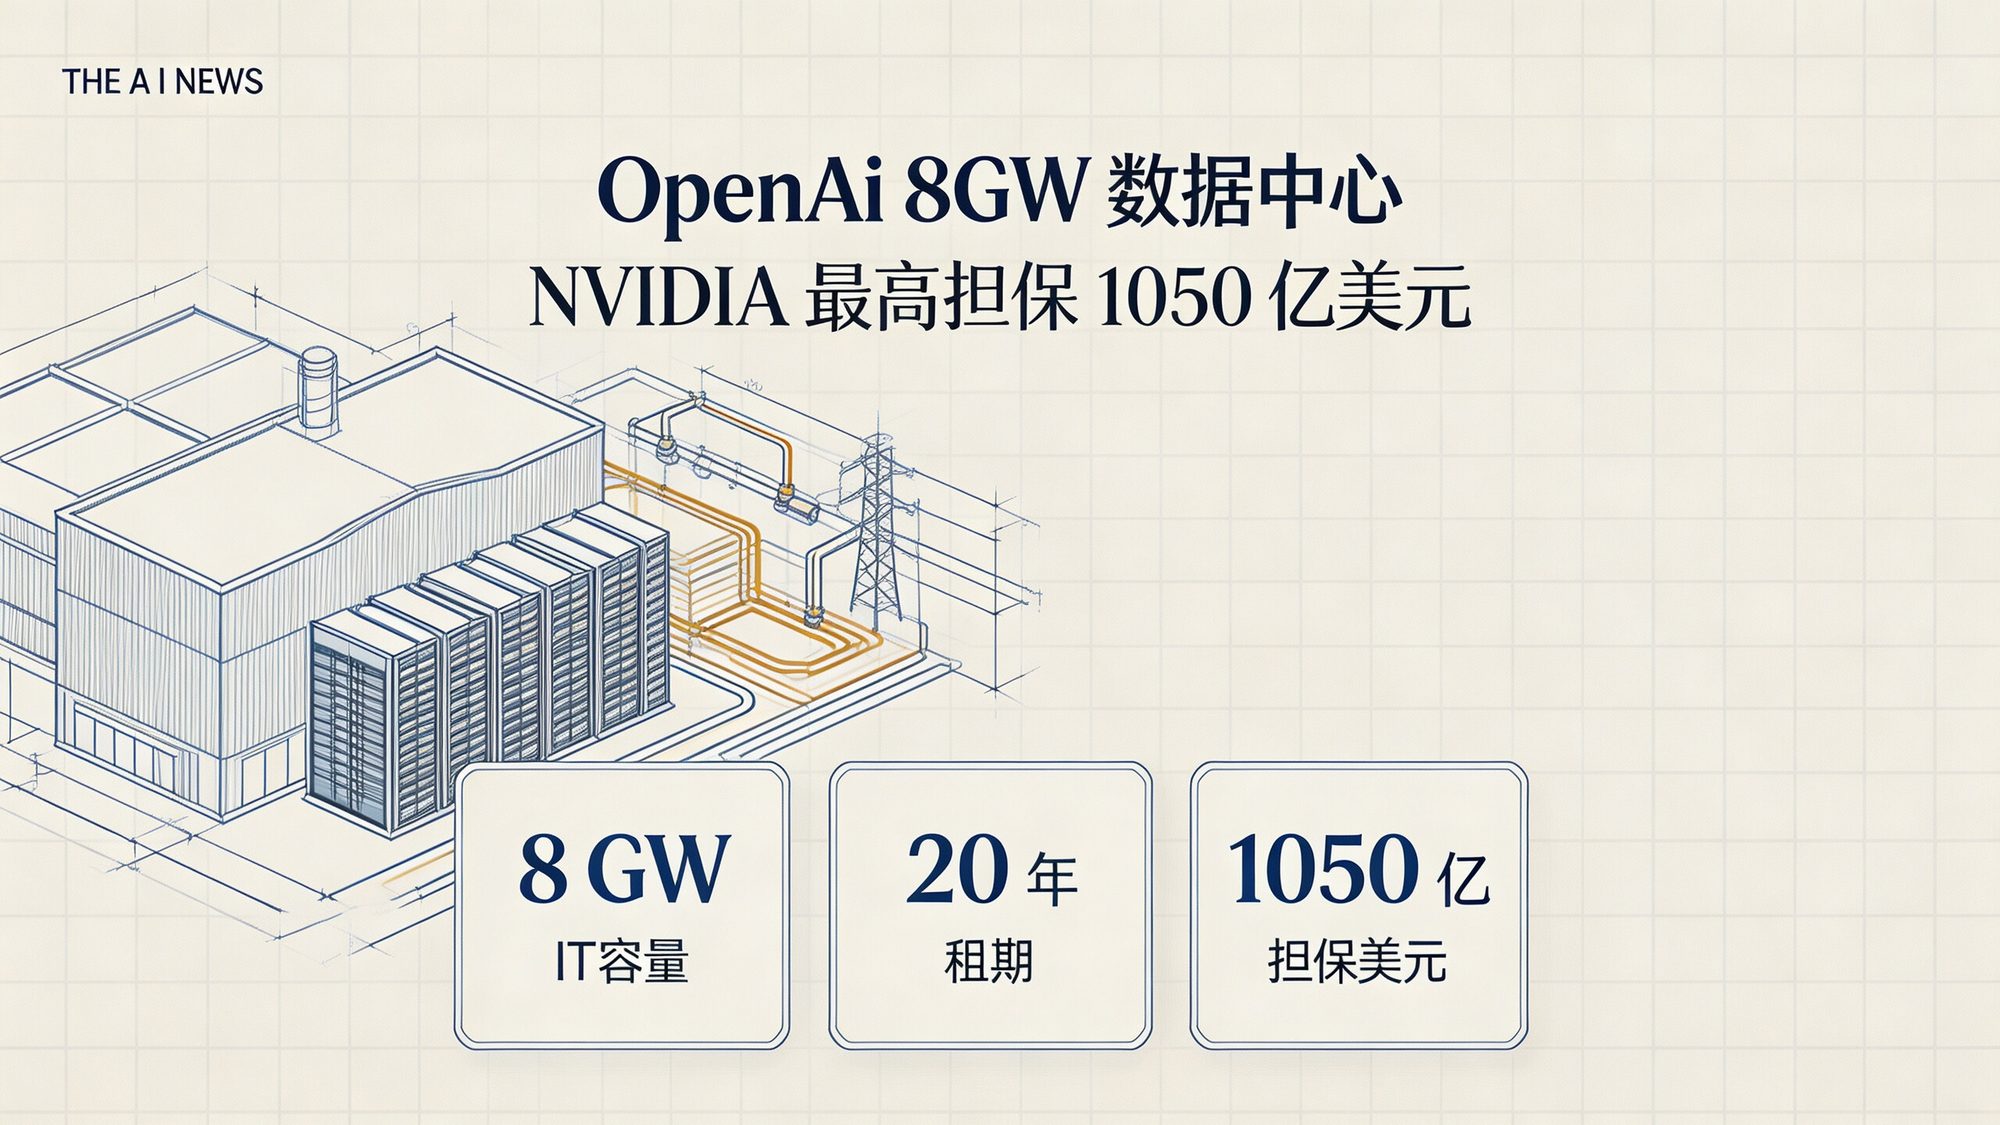
OpenAI 与软银旗下 SB Energy 签下俄亥俄约 8GW 数据中心 20 年租约,NVIDIA 最高担保 1050 亿美元并任独家芯片供应商。
OpenAI 发布网络安全博文:援引其遭入侵事件,主张用 AI 让防御者抢在攻击者之前——Codex 审码、告警自动分流、持续枚举攻击路径,并给出十条行动清单。
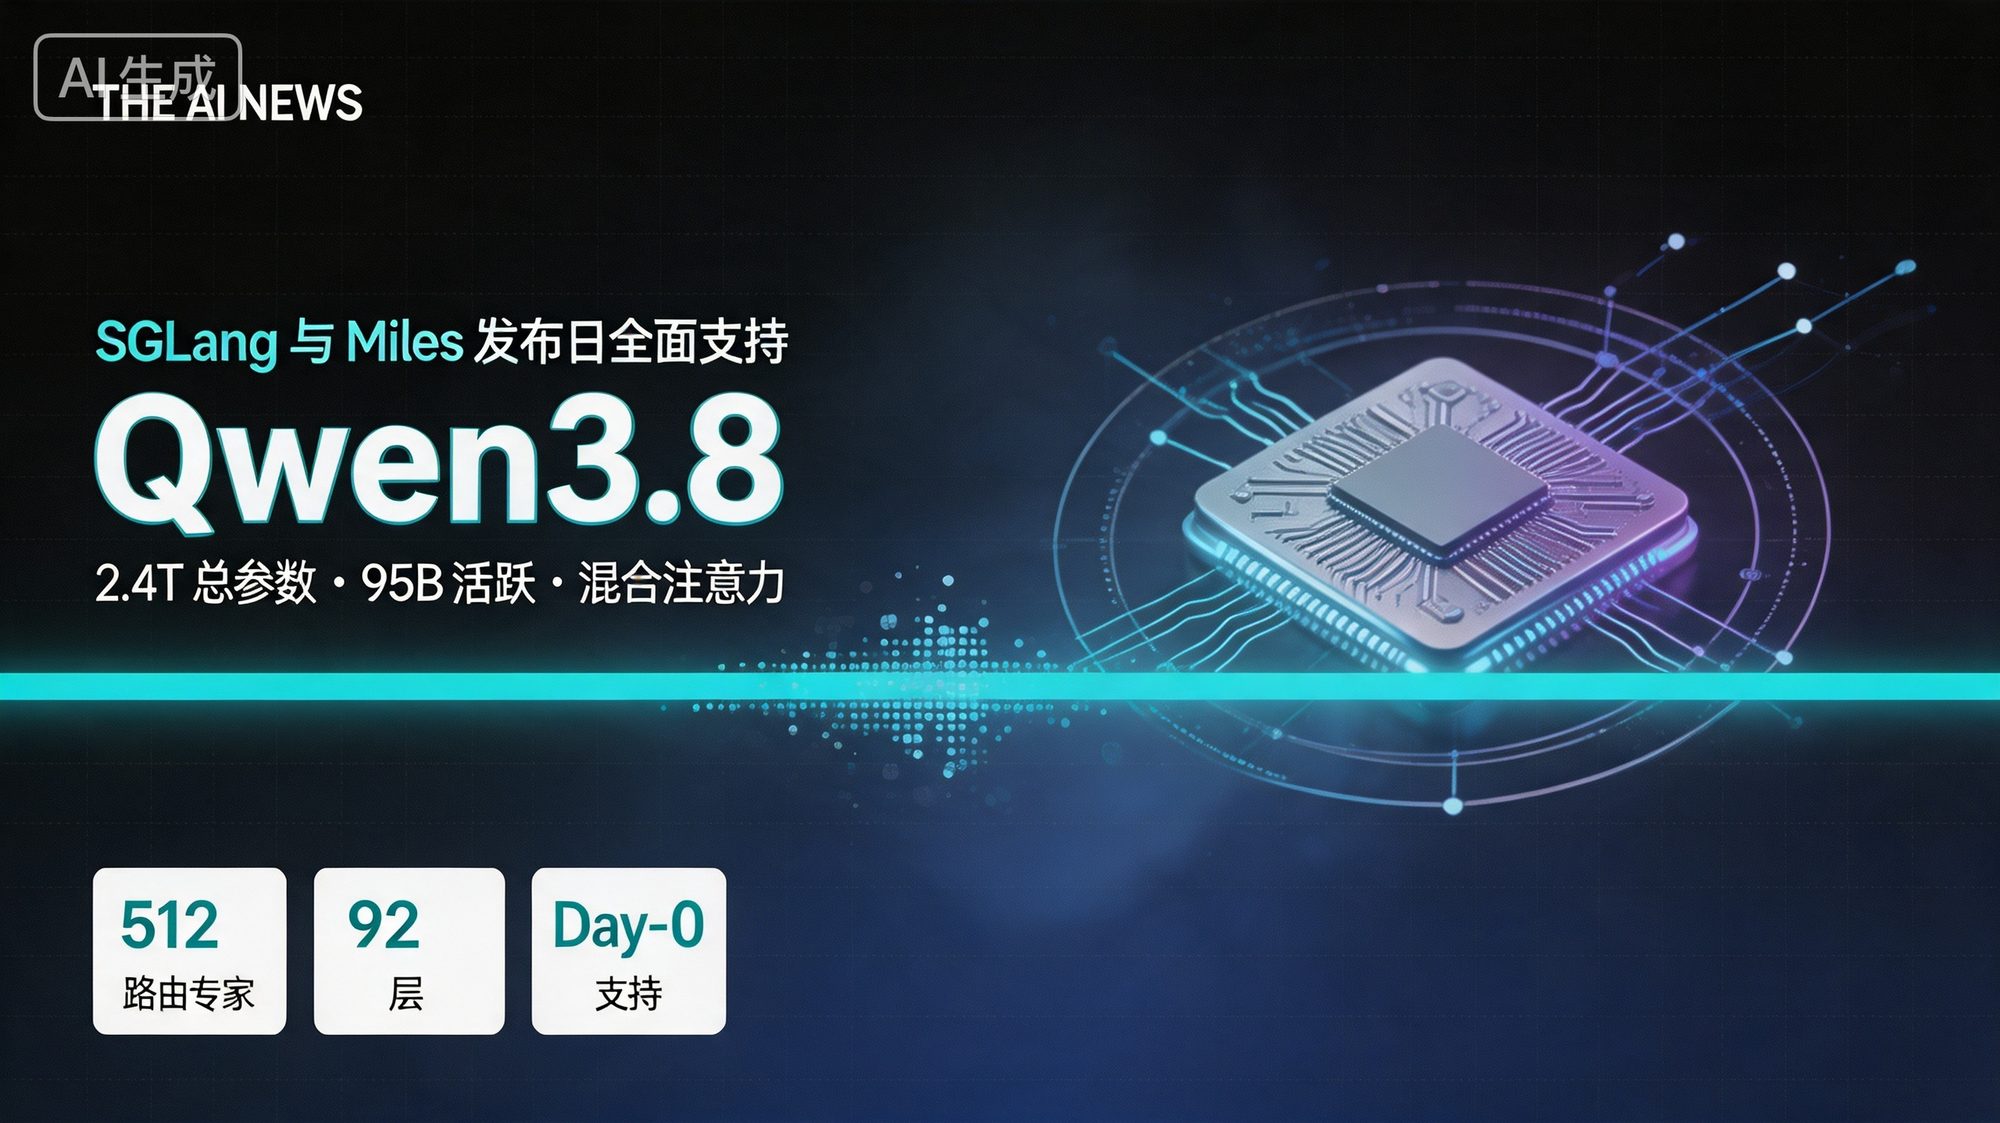
LMSYS Chatbot Arena 团队宣布 Qwen 最大开源模型 Qwen3.8-2.4T-A95B 获 SGLang 与 Miles 发布日即全面支持,涵盖混合注意力状态管理、PD 分离与 Day-0 RL。
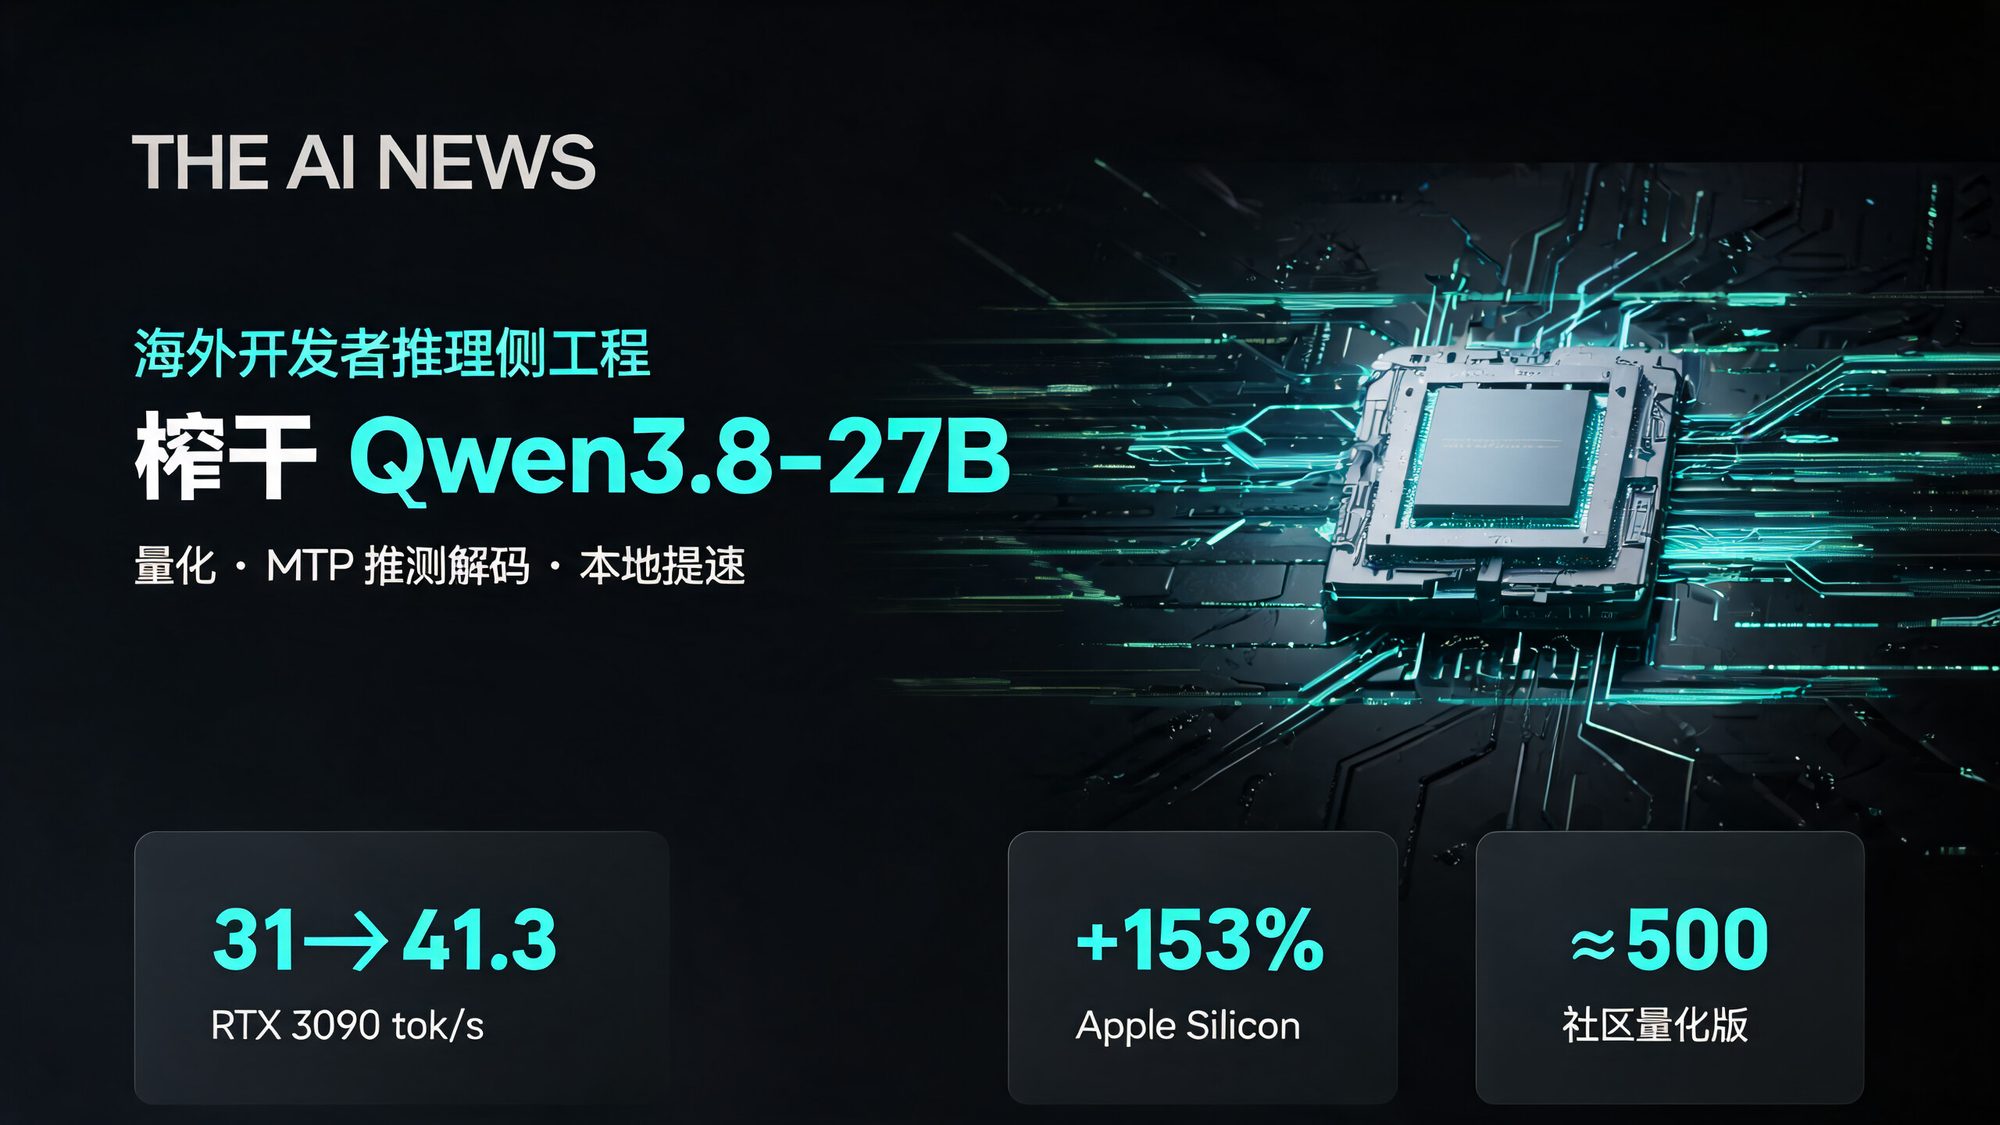
Qwen3.8-27B 开源不到 12 小时登上 Hugging Face 历史最受欢迎 TOP4,两天下载破百万。开发者围绕量化精度、推理配置与 MTP 推测解码展开优化:RTX 3090 解码从 31 提到 41.3 tokens/s,Apple Silicon 挑战 16 小时内提升 153%。